💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 北京市药品批准信息数据可视化分析系统介绍
- 北京市药品批准信息数据可视化分析系统演示视频
- 北京市药品批准信息数据可视化分析系统演示图片
- 北京市药品批准信息数据可视化分析系统代码展示
- 北京市药品批准信息数据可视化分析系统文档展示
北京市药品批准信息数据可视化分析系统介绍
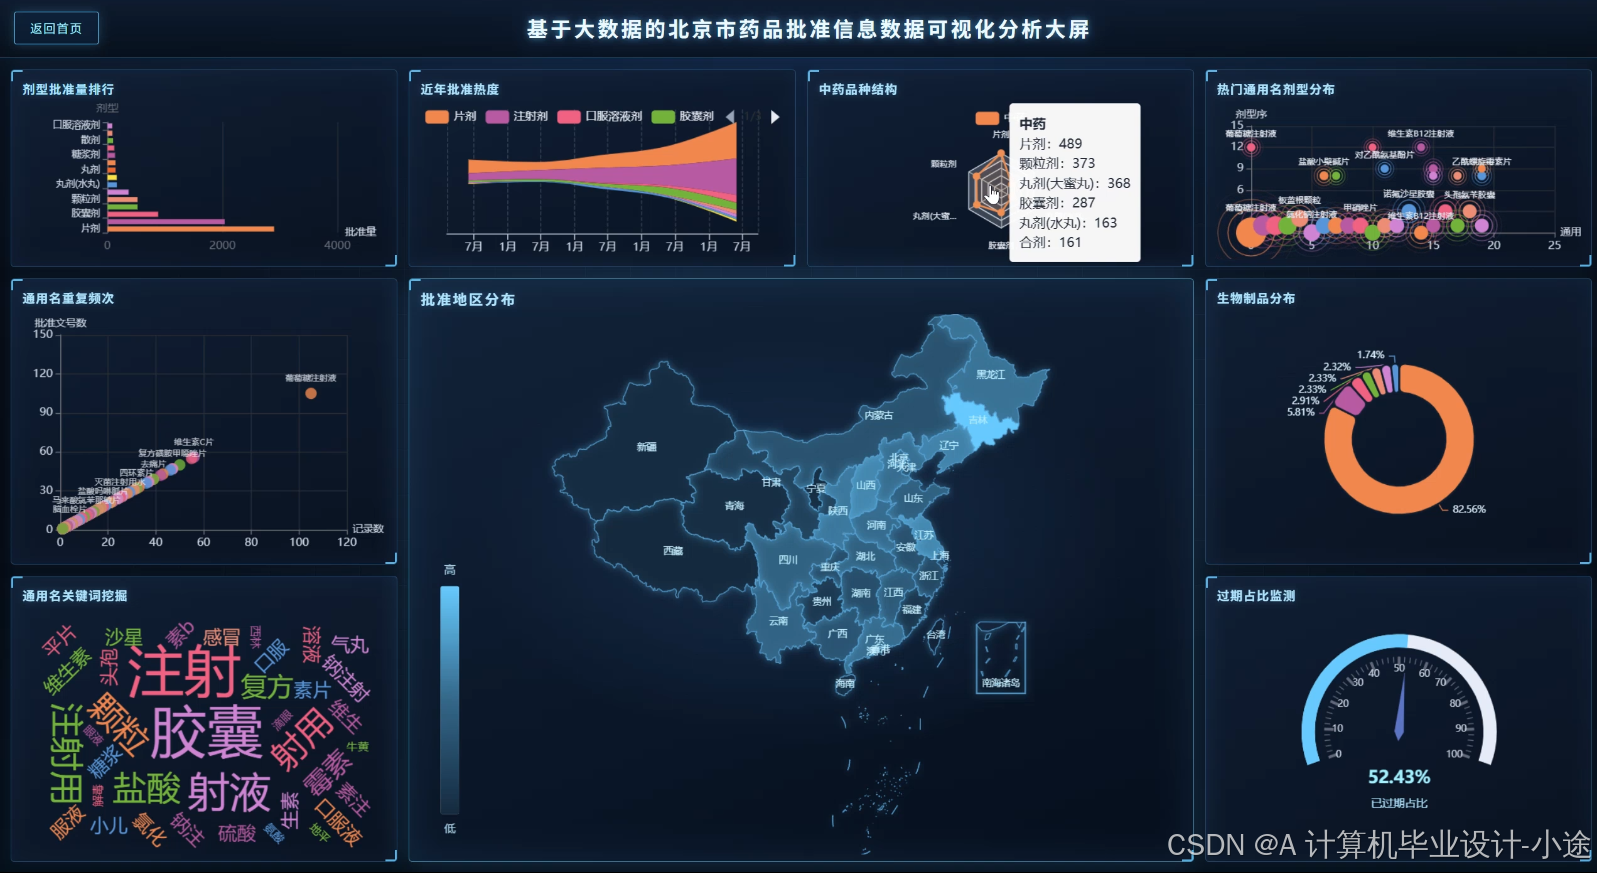
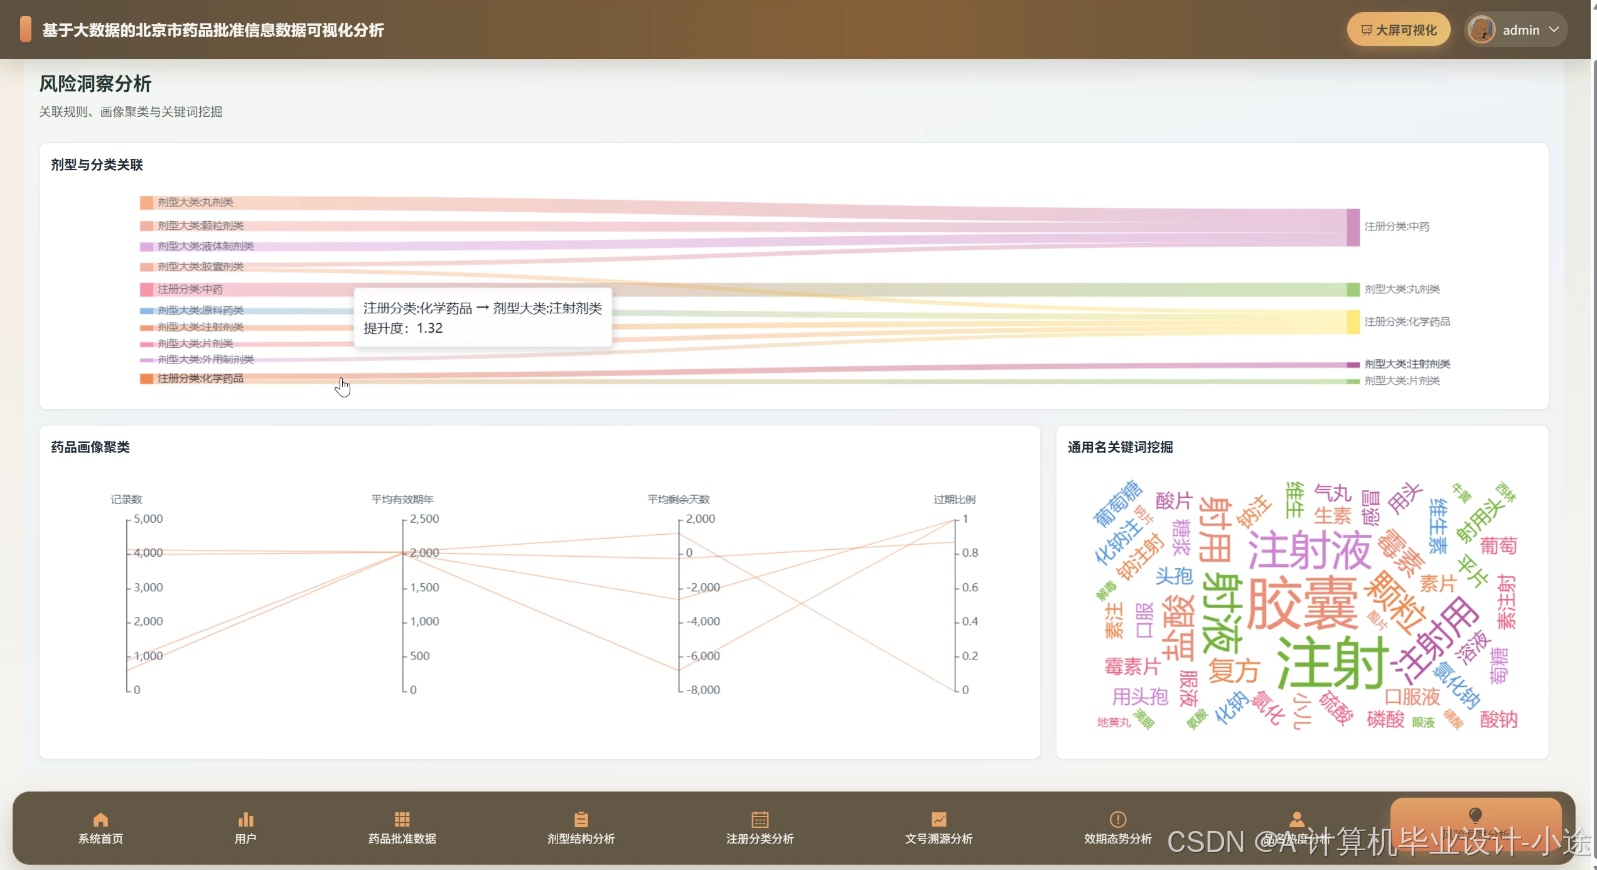
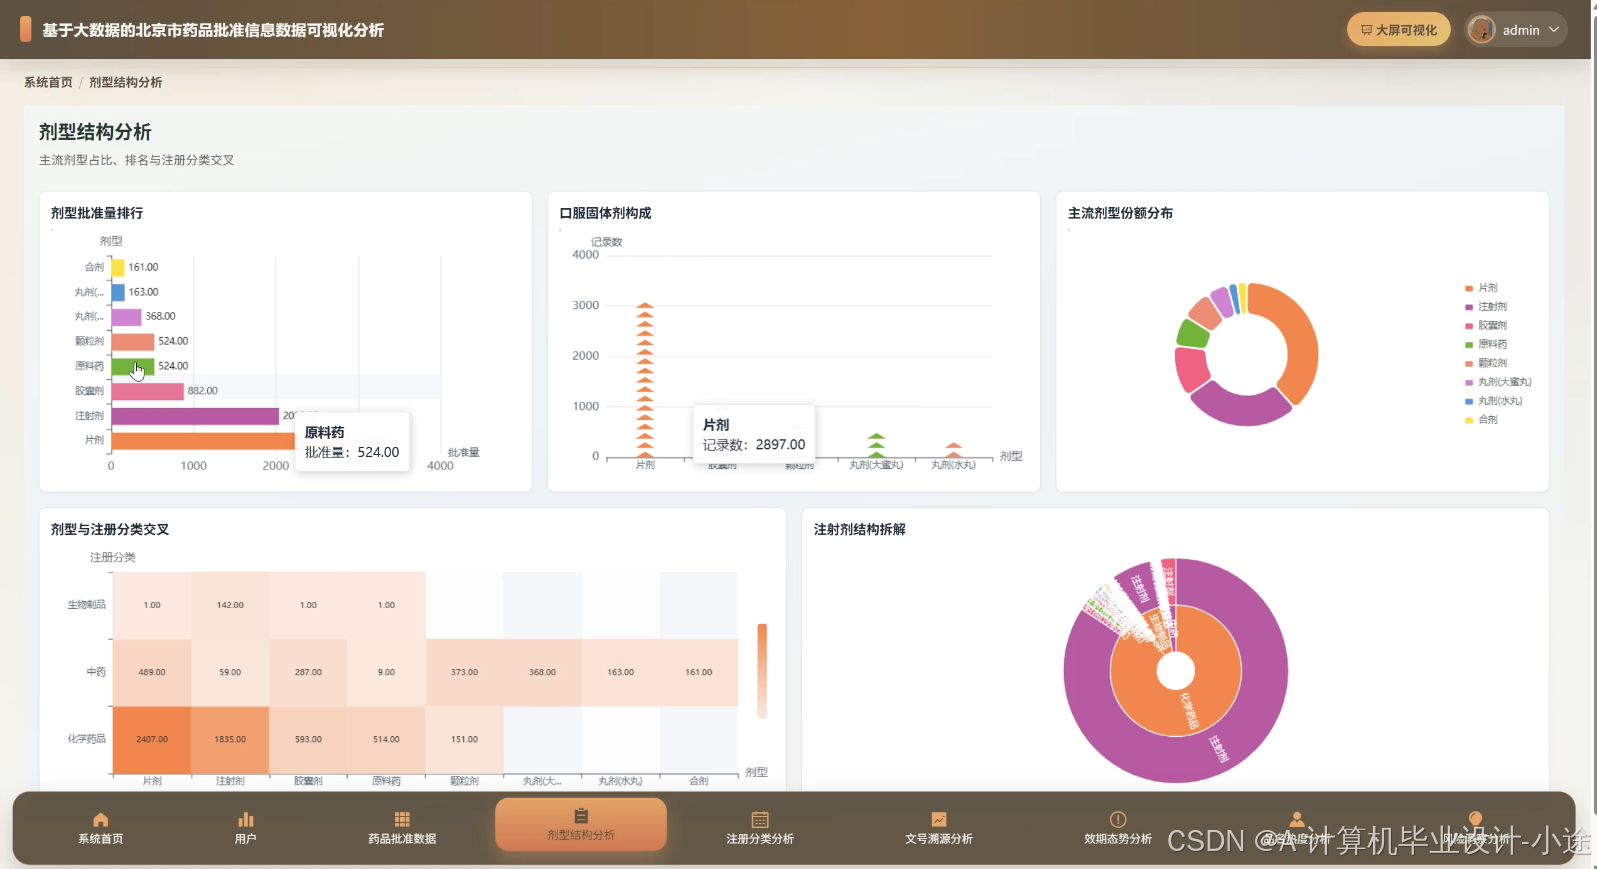
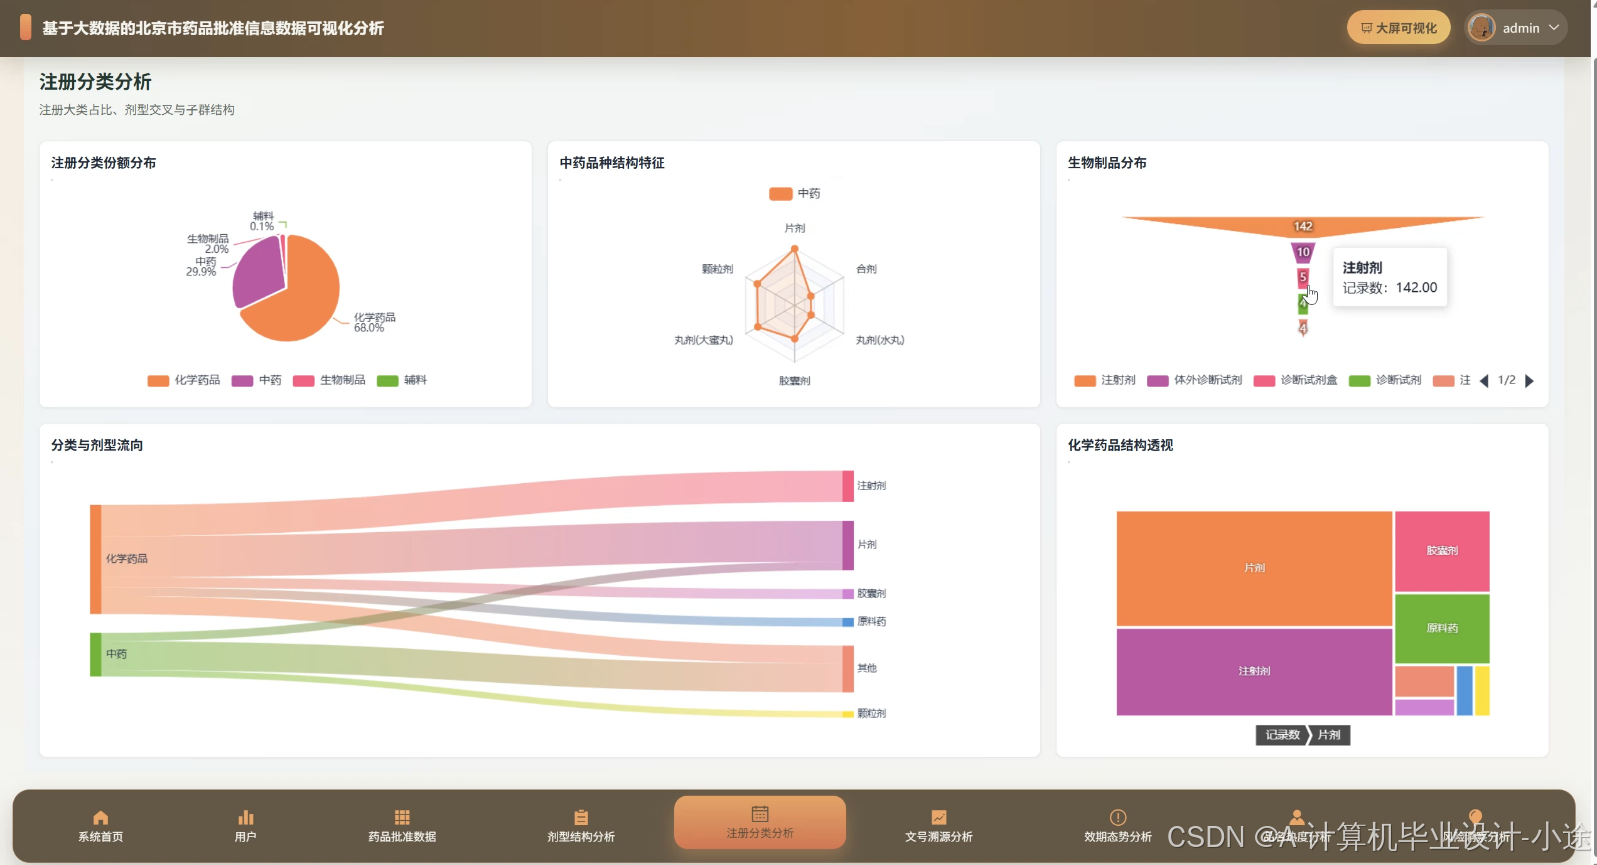
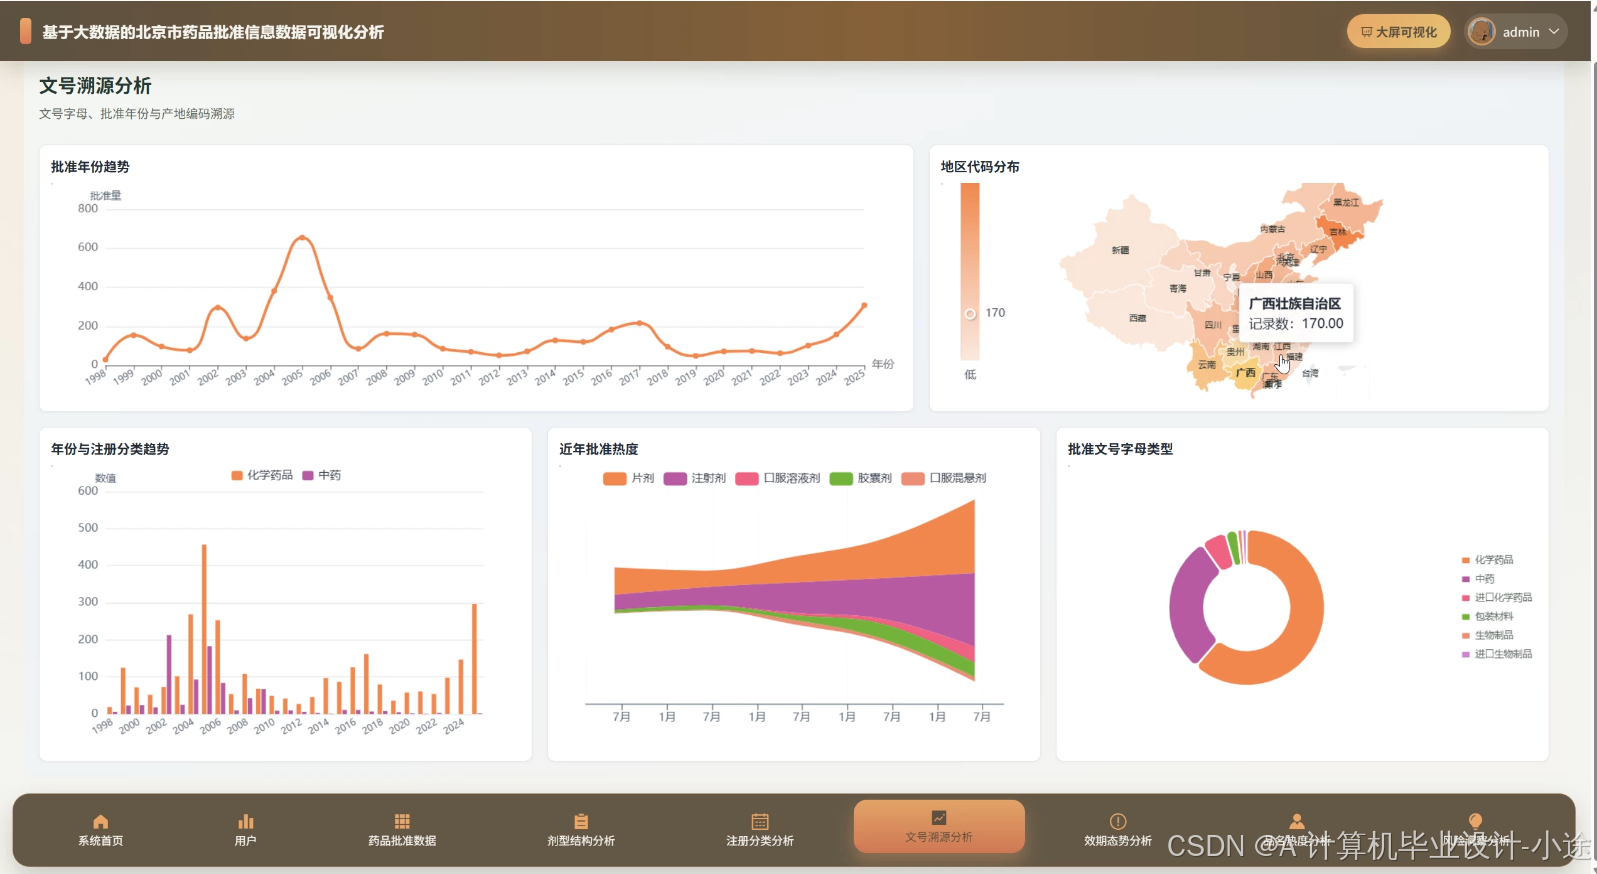
本系统名为《基于大数据的北京市药品批准信息数据可视化分析》,主要面向大四计算机专业毕设场景,围绕北京市药品批准信息做数据采集、清洗、统计分析与可视化展示。系统采用Hadoop+HDFS+Spark作为大数据处理框架,用Spark SQL和Pandas、NumPy完成数据清洗、字段整理和指标计算,后端提供Python+Django与Java+Spring Boot两个版本,前端使用Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery,数据库使用MySQL。功能上包含系统首页、大屏可视化、药品批准数据、剂型结构分析、注册分类分析、文号溯源分析、效期态势分析、品名热度分析、风险洞察分析、个人信息和修改密码等模块。用户可以在大屏上直观看到北京市药品批准信息的整体分布、剂型结构、注册分类占比、文号来源链路、效期变化趋势、品名热度排名以及风险洞察结果,从而对药品批准数据有一个比较完整的认识。系统重点不在堆砌复杂业务,而是把大数据处理流程和可视化分析链路讲清楚,适合作为计算机专业毕设选题参考。
北京市药品批准信息数据可视化分析系统演示视频
项目演示视频
北京市药品批准信息数据可视化分析系统演示图片
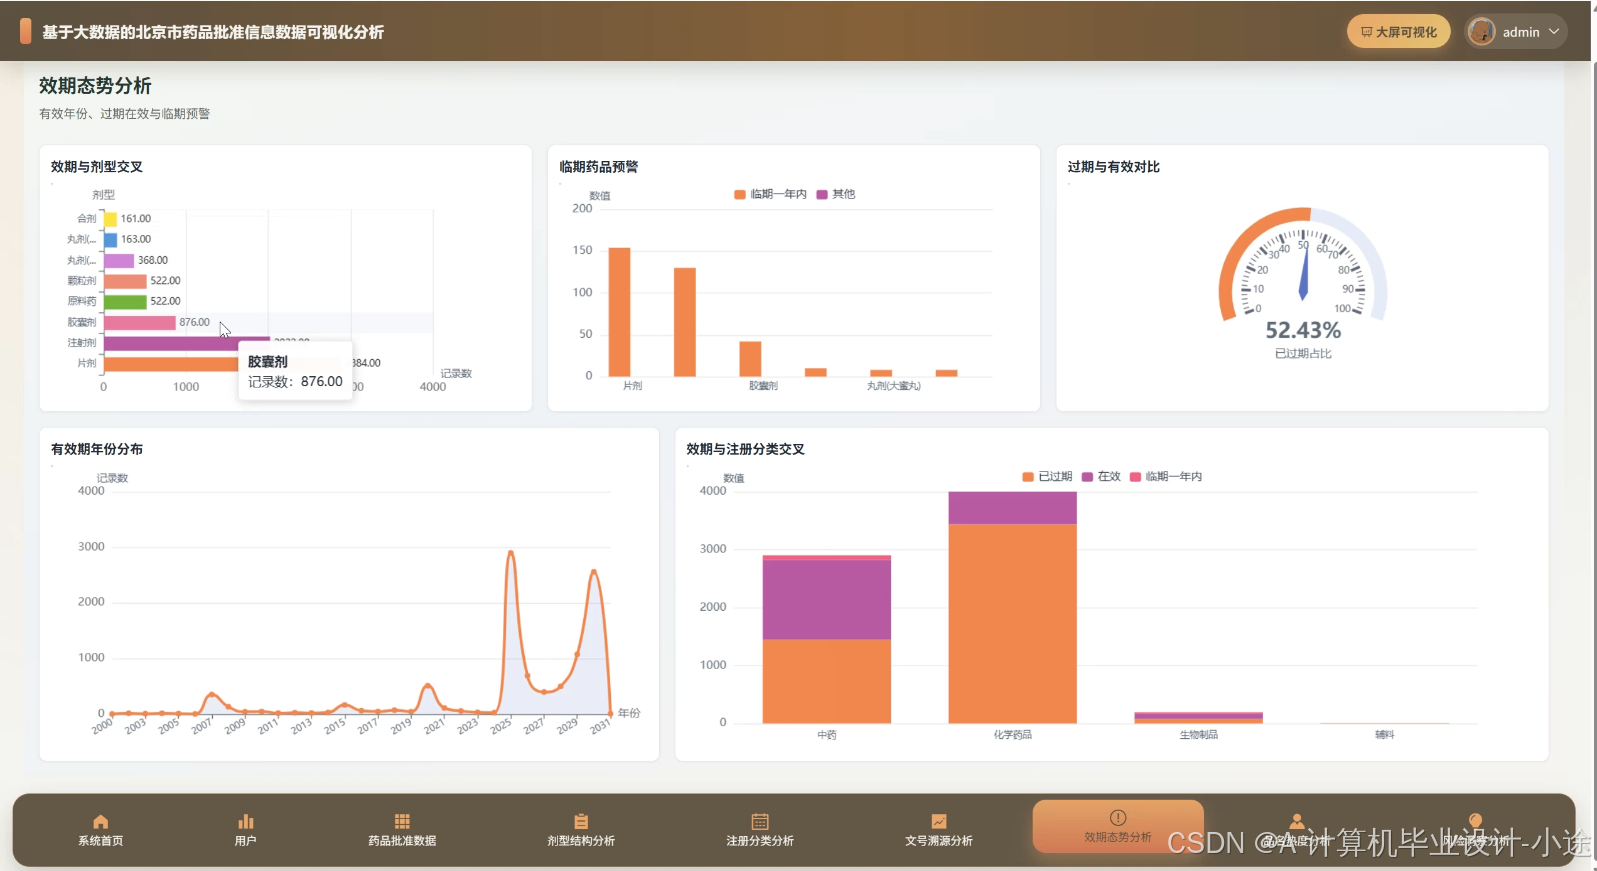
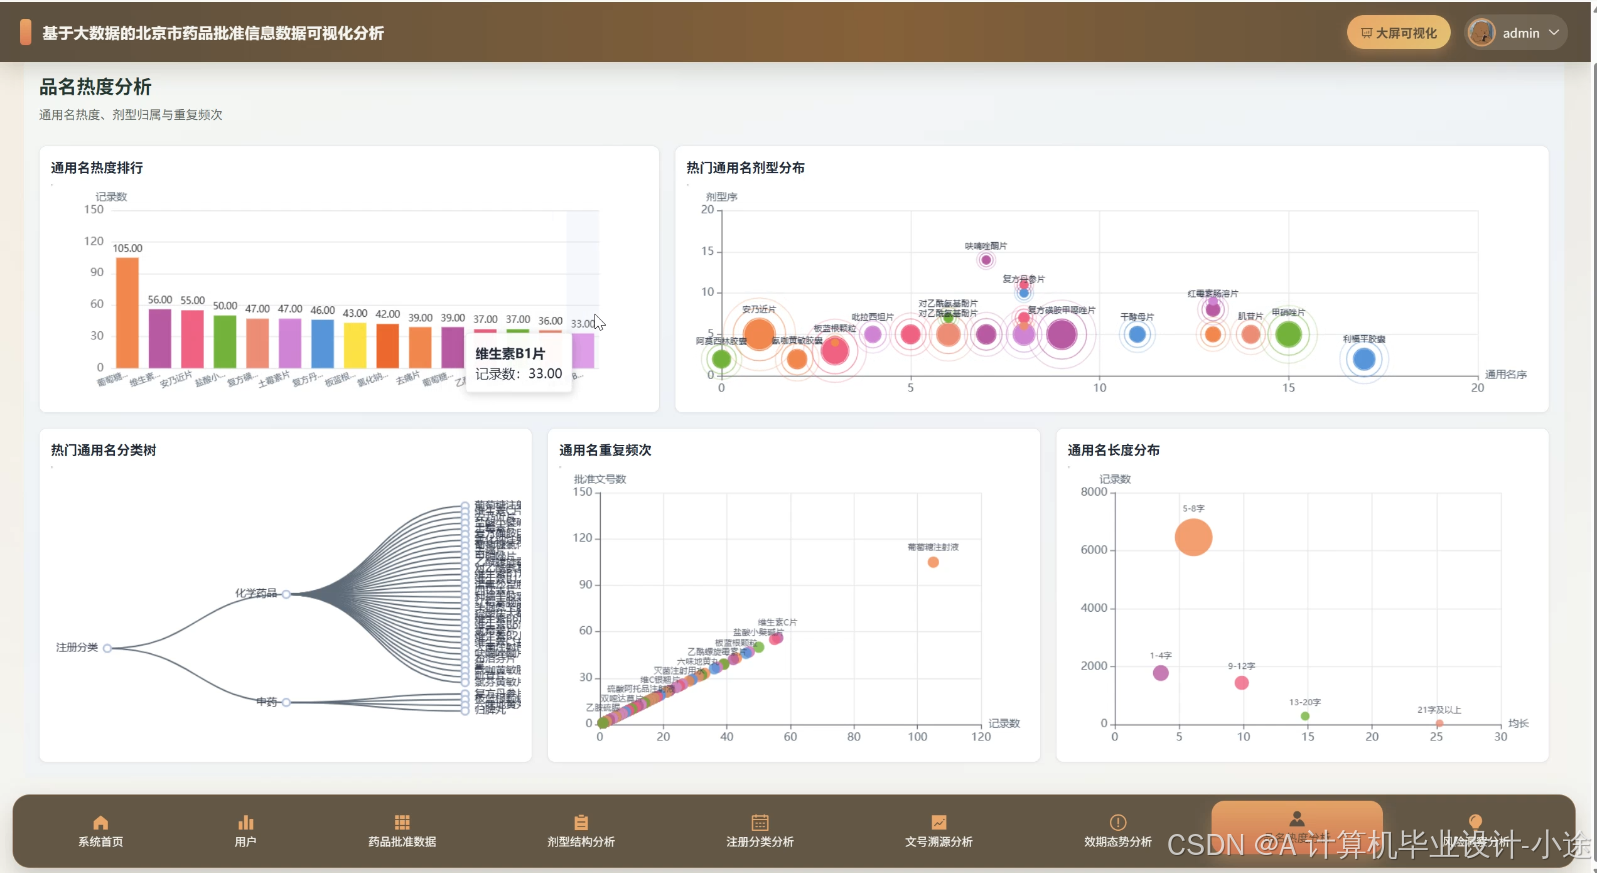
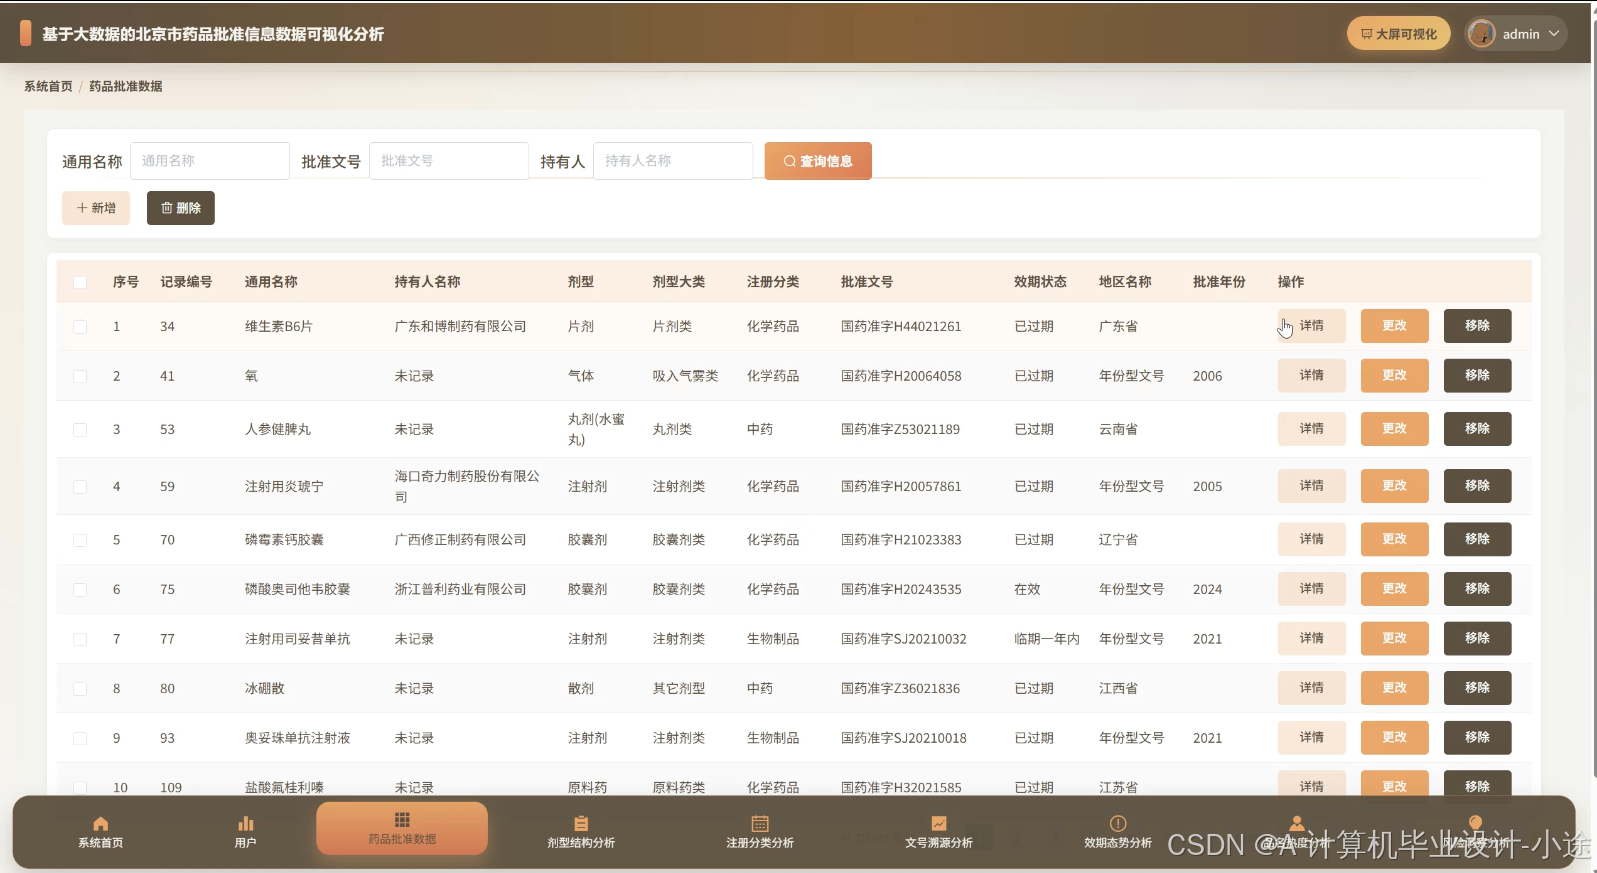
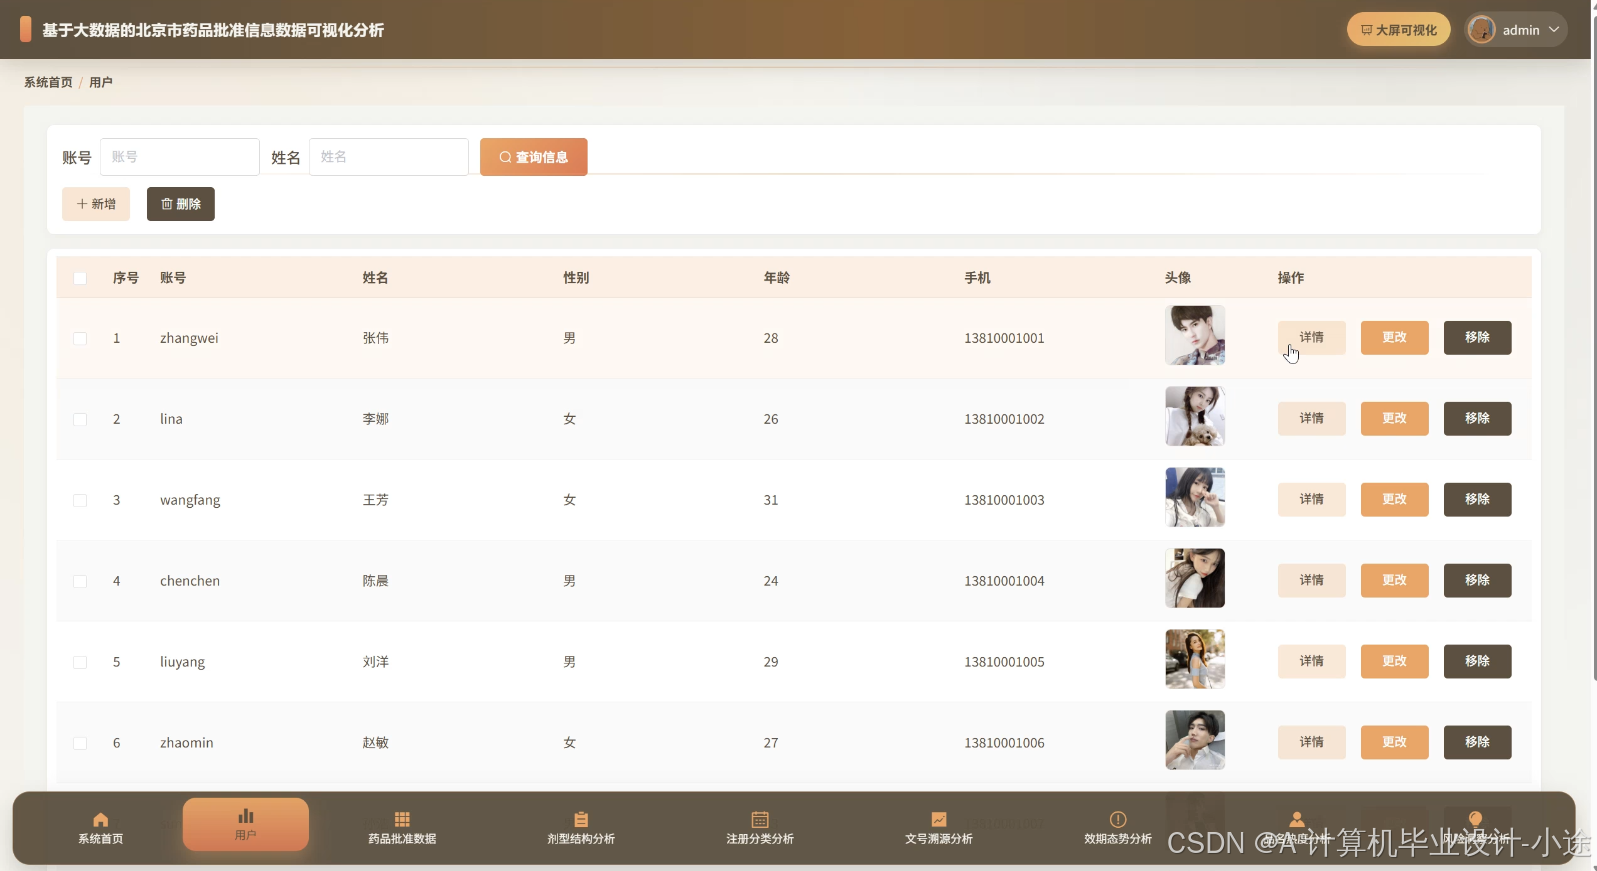
北京市药品批准信息数据可视化分析系统代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, desc, when, sum as _sum
spark = SparkSession.builder.appName("BeijingDrugApprovalAnalysis").master("local[*]").getOrCreate()
drug_df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/drug/beijing_drug_approval.csv")
drug_df.createOrReplaceTempView("drug_approval")
def dosage_structure_analysis():
dosage_df = spark.sql("""
SELECT dosage_form, COUNT(*) AS total_count
FROM drug_approval
WHERE dosage_form IS NOT NULL AND dosage_form != ''
GROUP BY dosage_form
ORDER BY total_count DESC
""")
total = dosage_df.agg(_sum("total_count")).collect()[0][0]
result = dosage_df.withColumn("ratio", col("total_count") / total * 100)
result = result.withColumn("ratio", when(col("ratio") > 10, "高占比").otherwise("一般占比"))
dosage_list = result.collect()
return [{"dosage_form": row["dosage_form"], "total_count": row["total_count"], "ratio": round(row["ratio"], 2), "level": row["ratio"]} for row in dosage_list]
def approval_category_analysis():
category_df = spark.sql("""
SELECT register_category, COUNT(*) AS category_count
FROM drug_approval
WHERE register_category IS NOT NULL
GROUP BY register_category
ORDER BY category_count DESC
""")
category_df = category_df.withColumn("category_level", when(col("category_count") >= 100, "重点分类").otherwise("普通分类"))
category_list = category_df.collect()
return [{"register_category": row["register_category"], "category_count": row["category_count"], "category_level": row["category_level"]} for row in category_list]
def risk_insight_analysis():
risk_df = spark.sql("""
SELECT drug_name, approval_number, valid_date, register_category,
CASE WHEN valid_date < current_date() THEN '已过期' ELSE '有效期内' END AS valid_status
FROM drug_approval
WHERE valid_date IS NOT NULL
""")
risk_df = risk_df.withColumn("risk_level", when(col("valid_status") == "已过期", "高风险").otherwise("低风险"))
risk_count = risk_df.groupBy("risk_level").count().collect()
risk_detail = risk_df.filter(col("risk_level") == "高风险").orderBy(desc("valid_date")).limit(20).collect()
return {"risk_count": [{"risk_level": row["risk_level"], "count": row["count"]} for row in risk_count], "risk_detail": [{"drug_name": row["drug_name"], "approval_number": row["approval_number"], "valid_date": str(row["valid_date"]), "risk_level": row["risk_level"]} for row in risk_detail]}
北京市药品批准信息数据可视化分析系统文档展示
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目

-171主机测评](https://www.171host.com/wp-content/uploads/2026/09/20260916123009-6aaa8bd17c4de-220x150.png)