【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
3、【数学】【基础】内积、欧氏距离与梯度
背景
上篇 blog 2、【数学】【统计】均方根、方差与标准差 把"离均差之和恒为 0 → 绝对值/平方 → MAD/方差/标准差/RMS → RMSNorm"这条线讲清了,但里面顺手提到"内积"“欧氏距离”"梯度"时并没有展开。本篇把这三个基础概念补齐,并补上方差等价形式的完整推导。
向量:把一组数看成一个整体
一组数
x
=
(
x
1
,
x
2
,
…
,
x
n
)
x=(x_1,x_2,\\dots,x_n)
x=(x1,x2,…,xn) 可以看成一个
n
n
n 维向量:既可以理解成空间里的一个点,也可以理解成从原点出发的一支箭头。
例如
x
=
[
3
,
1
,
4
,
2
]
x=[3,1,4,2]
x=[3,1,4,2] 就是四维空间里的一个点。后面要讲的内积、距离、梯度,都建立在这个"把一组数当成一个整体"的视角上。
内积(点积)
两个向量逐项相乘再求和,得到内积(Inner Product,也叫点积 Dot Product):
a
⋅
b
=
∑
i
=
1
n
a
i
b
i
a\\cdot b=\\sum_{i=1}^{n}a_i b_i
a⋅b=i=1∑naibi 例如
(
1
,
2
)
⋅
(
3
,
4
)
=
1
×
3
+
2
×
4
=
11
(1,2)\\cdot(3,4)=1\\times3+2\\times4=11
(1,2)⋅(3,4)=1×3+2×4=11。
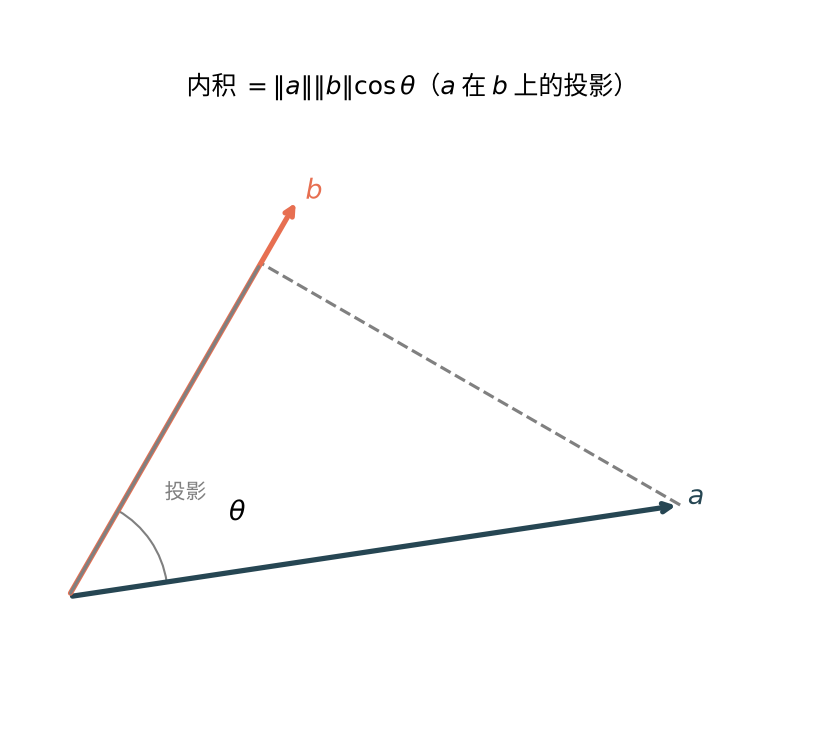
内积有明确的几何意义:
a
⋅
b
=
∥
a
∥
2
∥
b
∥
2
cos
θ
a\\cdot b=\\lVert a\\rVert_2\\lVert b\\rVert_2\\cos\\theta
a⋅b=∥a∥2∥b∥2cosθ 其中
θ
\\theta
θ 是两个向量的夹角。它衡量两个向量的对齐程度:同向时最大,垂直时为
0
0
0。
内积还可以反过来定义长度:
a
⋅
a
=
∥
a
∥
2
2
=
∑
a
i
2
a\\cdot a=\\lVert a\\rVert_2^2=\\sum a_i^2
a⋅a=∥a∥22=∑ai2。也就是说,"平方和"本质上就是内积,而内积是双线性、处处可导的运算——这正是上一篇文章说"平方与内积天然契合"的原因。
欧氏距离
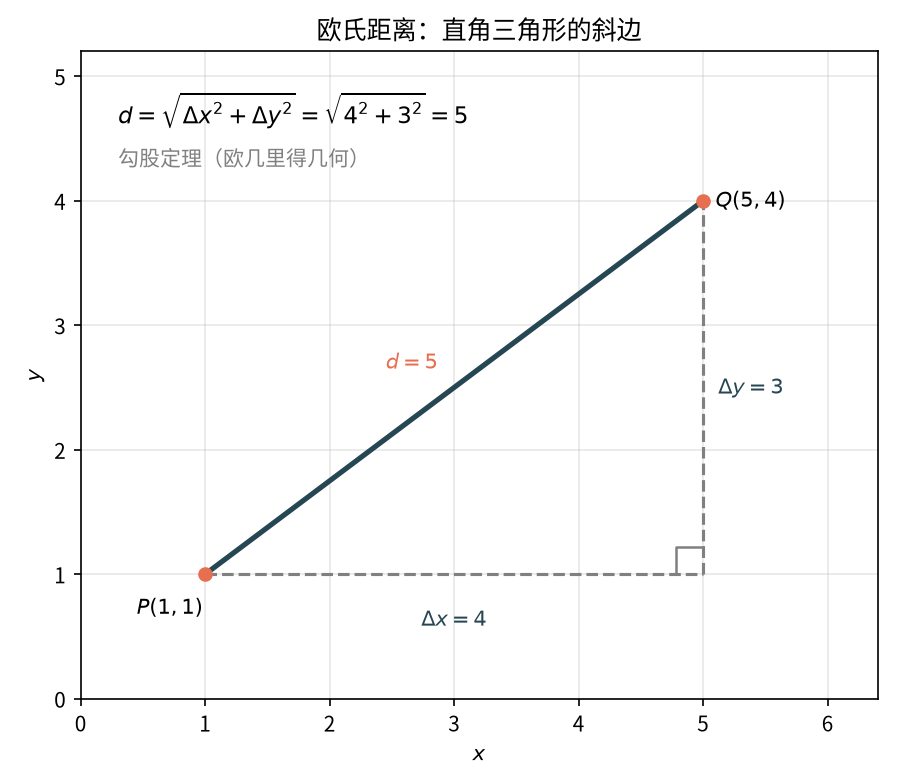
欧氏距离(Euclidean Distance)就是两点之间的直线距离。二维平面上,两点
(
x
1
,
y
1
)
(x_1,y_1)
(x1,y1)、
(
x
2
,
y
2
)
(x_2,y_2)
(x2,y2) 的距离是:
d
=
(
x
1
−
x
2
)
2
+
(
y
1
−
y
2
)
2
d=\\sqrt{(x_1-x_2)^2+(y_1-y_2)^2}
d=(x1−x2)2+(y1−y2)2
推广到
n
n
n 维:
d
(
a
,
b
)
=
∑
i
=
1
n
(
a
i
−
b
i
)
2
=
∥
a
−
b
∥
2
d(a,b)=\\sqrt{\\sum_{i=1}^{n}(a_i-b_i)^2}=\\lVert a-b\\rVert_2
d(a,b)=i=1∑n(ai−bi)2
=∥a−b∥2
顺便说下名字的由来:欧氏距离得名于古希腊数学家欧几里得(Euclid)——他在《几何原本》里把平直空间的几何系统化成公理体系,后来称为欧几里得几何,欧氏距离正是这套几何里的直线距离,用来与后来的非欧几何(球面、双曲空间)相区分。其他距离的命名方式也各不相同:曼哈顿距离源自纽约曼哈顿的方格路网,切比雪夫距离、闵可夫斯基距离则源自数学家姓氏。
它也可以用内积表达:
∥
a
−
b
∥
2
2
=
(
a
−
b
)
⋅
(
a
−
b
)
\\lVert a-b\\rVert_2^2=(a-b)\\cdot(a-b)
∥a−b∥22=(a−b)⋅(a−b) 把一组数
x
x
x 的均值铺成向量
μ
1
=
(
μ
,
…
,
μ
)
\\mu\\mathbf{1}=(\\mu,\\dots,\\mu)
μ1=(μ,…,μ),那么
∥
x
−
μ
1
∥
2
\\lVert x-\\mu\\mathbf{1}\\rVert_2
∥x−μ1∥2 就是"数据点到均值点的欧氏距离",于是
σ
2
=
1
n
∥
x
−
μ
1
∥
2
2
\\sigma^2=\\frac{1}{n}\\lVert x-\\mu\\mathbf{1}\\rVert_2^2
σ2=n1∥x−μ1∥22 即方差 = 数据点到均值点的平均平方距离。
梯度
一元函数
f
(
x
)
f(x)
f(x) 的导数是曲线在某点的斜率,表示"往哪边走函数变大、往哪边走变小"。多元函数
f
(
x
1
,
…
,
x
n
)
f(x_1,\\dots,x_n)
f(x1,…,xn) 对每个变量分别求偏导,拼成一个向量,称为梯度(Gradient):
∇
f
=
(
∂
f
∂
x
1
,
…
,
∂
f
∂
x
n
)
\\nabla f=\\Bigl(\\frac{\\partial f}{\\partial x_1},\\dots,\\frac{\\partial f}{\\partial x_n}\\Bigr)
∇f=(∂x1∂f,…,∂xn∂f) 梯度指向函数增长最快的方向;取负号,就是下降最快的方向。训练模型时沿负梯度更新参数:
θ
←
θ
−
η
∇
L
(
θ
)
\\theta\\leftarrow\\theta-\\eta\\nabla L(\\theta)
θ←θ−η∇L(θ) 其中
η
\\eta
η 是步长(学习率),
L
L
L 是损失函数。

这里也解释了上一篇文章为什么选"平方"而不是"绝对值":
∣
d
∣
\\lvert d\\rvert
∣d∣ 在
d
=
0
d=0
d=0 处左导数为
−
1
-1
−1、右导数为
+
1
+1
+1,不相等,梯度不存在;而
d
2
d^2
d2 的导数是
2
d
2d
2d,处处存在,做梯度优化更方便。
回到方差:等价形式怎么来
上一篇文章直接给出了
σ
2
=
1
n
∑
x
i
2
−
μ
2
\\sigma^2=\\frac{1}{n}\\sum x_i^2-\\mu^2
σ2=n1∑xi2−μ2,这里补上推导。前提是均值定义
μ
=
1
n
∑
i
=
1
n
x
i
\\mu=\\frac{1}{n}\\sum_{i=1}^{n}x_i
μ=n1∑i=1nxi,所以
∑
i
=
1
n
x
i
=
n
μ
\\sum_{i=1}^{n}x_i=n\\mu
∑i=1nxi=nμ。
从方差定义出发,把平方展开:
σ
2
=
1
n
∑
i
=
1
n
(
x
i
−
μ
)
2
=
1
n
∑
i
=
1
n
(
x
i
2
−
2
μ
x
i
+
μ
2
)
\\sigma^2=\\frac{1}{n}\\sum_{i=1}^{n}(x_i-\\mu)^2=\\frac{1}{n}\\sum_{i=1}^{n}\\bigl(x_i^2-2\\mu x_i+\\mu^2\\bigr)
σ2=n1i=1∑n(xi−μ)2=n1i=1∑n(xi2−2μxi+μ2) 把求和拆成三项:
=
1
n
(
∑
i
=
1
n
x
i
2
−
2
μ
∑
i
=
1
n
x
i
+
∑
i
=
1
n
μ
2
)
=\\frac{1}{n}\\Bigl(\\sum_{i=1}^{n}x_i^2-2\\mu\\sum_{i=1}^{n}x_i+\\sum_{i=1}^{n}\\mu^2\\Bigr)
=n1(i=1∑nxi2−2μi=1∑nxi+i=1∑nμ2) 代入
∑
x
i
=
n
μ
\\sum x_i=n\\mu
∑xi=nμ 与
∑
μ
2
=
n
μ
2
\\sum\\mu^2=n\\mu^2
∑μ2=nμ2:
=
1
n
(
∑
i
=
1
n
x
i
2
−
2
μ
⋅
n
μ
+
n
μ
2
)
=
1
n
∑
i
=
1
n
x
i
2
−
μ
2
=\\frac{1}{n}\\Bigl(\\sum_{i=1}^{n}x_i^2-2\\mu\\cdot n\\mu+n\\mu^2\\Bigr)=\\frac{1}{n}\\sum_{i=1}^{n}x_i^2-\\mu^2
=n1(i=1∑nxi2−2μ⋅nμ+nμ2)=n1i=1∑nxi2−μ2 用
x
=
[
3
,
1
,
4
,
2
]
x=[3,1,4,2]
x=[3,1,4,2]、
μ
=
2.5
\\mu=2.5
μ=2.5 验证:
1
4
(
9
+
1
+
16
+
4
)
−
6.25
=
7.5
−
6.25
=
1.25
\\frac{1}{4}(9+1+16+4)-6.25=7.5-6.25=1.25
41(9+1+16+4)−6.25=7.5−6.25=1.25,与直接算的结果一致。
这个等价形式的意义是"二阶原点矩减一阶矩的平方":
σ
2
=
E
[
x
2
]
−
(
E
[
x
]
)
2
\\sigma^2=E[x^2]-(E[x])^2
σ2=E[x2]−(E[x])2
三者怎么串起来
把这一篇的几个概念连起来看:
| 内积 |
a ⋅ b = ∑ a i b i a\\cdot b=\\sum a_i b_i a⋅b=∑aibi |
a ⋅ a = ∥ a ∥ 2 2 a\\cdot a=\\lVert a\\rVert_2^2 a⋅a=∥a∥22 |
| 长度 |
∥ a ∥ 2 = a ⋅ a \\lVert a\\rVert_2=\\sqrt{a\\cdot a} ∥a∥2=a⋅a |
由内积导出 |
| 欧氏距离 |
∥ a − b ∥ 2 \\lVert a-b\\rVert_2 ∥a−b∥2 |
∥ a − b ∥ 2 2 = ( a − b ) ⋅ ( a − b ) \\lVert a-b\\rVert_2^2=(a-b)\\cdot(a-b) ∥a−b∥22=(a−b)⋅(a−b) |
| 梯度 |
∇ f = ( ∂ f / ∂ x i ) \\nabla f=\\bigl(\\partial f/\\partial x_i\\bigr) ∇f=(∂f/∂xi) |
依赖函数可导;平方/内积处处可导 |
| 方差 |
1 n ∑ ( x i − μ ) 2 \\frac{1}{n}\\sum(x_i-\\mu)^2 n1∑(xi−μ)2 |
到均值向量的平均平方距离 |
一条主线是:内积 → 长度 → 距离,而平方和与距离都能写成内积;又因为内积和平方处处可导,才能用梯度去优化它们。方差正是"到均值向量的平均平方距离",所以它天然适合放进梯度下降的框架里。
小结
内积是"逐项相乘再求和",几何上等于两个向量长度与夹角余弦的乘积;由它可以导出长度
∥
a
∥
2
=
a
⋅
a
\\lVert a\\rVert_2=\\sqrt{a\\cdot a}
∥a∥2=a⋅a
和欧氏距离
∥
a
−
b
∥
2
\\lVert a-b\\rVert_2
∥a−b∥2;梯度是多元函数偏导拼成的向量,指向增长最快的方向,沿负梯度即可下降。方差既可写成"到均值向量的平均平方距离",也可展开成
1
n
∑
x
i
2
−
μ
2
\\frac{1}{n}\\sum x_i^2-\\mu^2
n1∑xi2−μ2——这几个概念在 RMSNorm、注意力打分、梯度训练里反复出现,是读懂后面内容的基础。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!! 【数学】【基础】归一化的数学原理:LayerNorm、RMSNorm 与 BatchNorm