9 月 4 日,彭博社抛出一条消息,把整个 AI圈炸醒了。
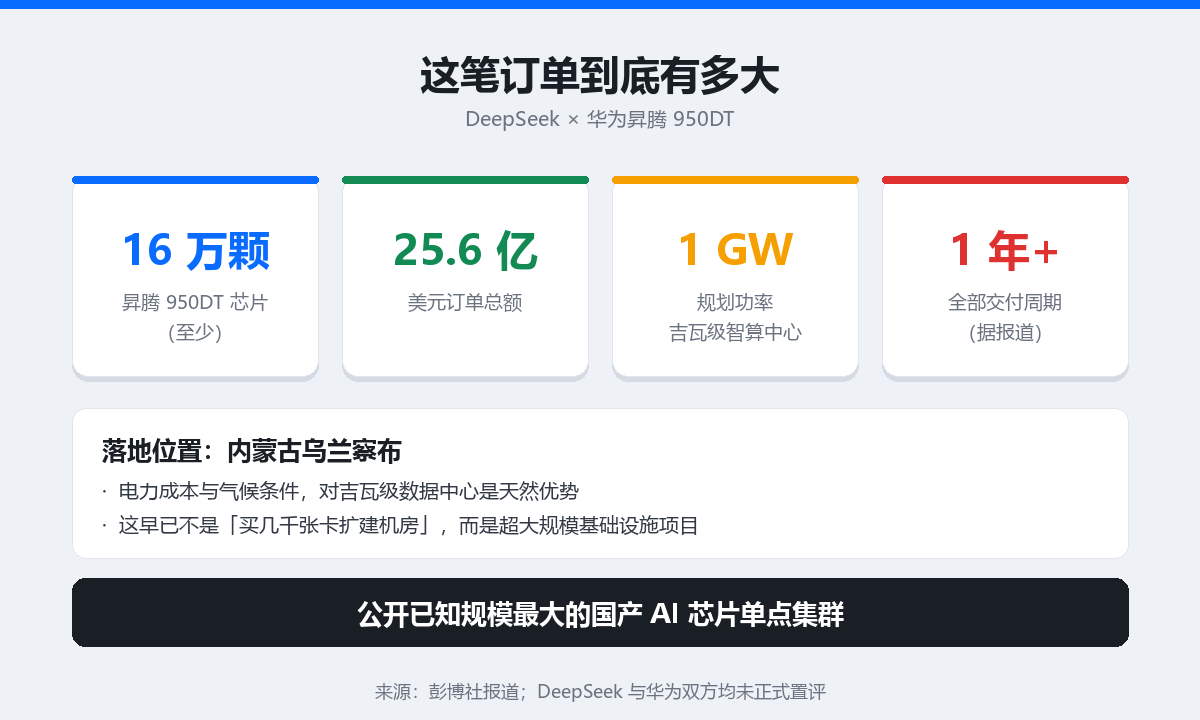
DeepSeek 计划在内蒙古乌兰察布的超大型智算中心,部署至少 16 万颗华为昇腾 950DT 芯片。
订单总价值约 25.6 亿美元。
规划功率 吉瓦级(GW)—— 10 亿瓦是什么概念?这个智算中心的体量,足以与全球任何一座顶级算力中心放在同一张桌子上比较。
如果落地,这将是公开已知的全球最大规模国产 AI 芯片单点集群。截至发稿,DeepSeek 与华为双方均未正式置评。
这篇文章想聊的不是「国产芯片能不能行」这种情绪问题,而是三个更实在的事:这笔钱花在哪、为什么是推理、以及它意味着什么。
一、先搞清楚这笔订单有多大
 把数字摊开,你才能感受到它的分量:
| 芯片数量 | 至少 16 万颗 昇腾 950DT |
| 订单总额 | 约 25.6 亿美元 |
| 规划功率 | 吉瓦级(GW) |
| 落地地点 | 内蒙古乌兰察布 |
| 交付周期 | 据报道,全部交付可能需要一年以上 |
16 万颗是什么概念?这早就不是「一家 AI 公司买几千张卡扩建机房」的问题了。这是一个真正意义上的超大规模基础设施项目 —— 从机房、供电、散热到网络互联,全都要按吉瓦级重做一遍。
选址在乌兰察布也不意外。内蒙古本身的电力成本和气候条件,对这种耗电巨兽来说是天然优势;而「东数西算」工程推进这几年,当地的数据中心产业配套已经成体系。
但数字背后有个更值得注意的细节:这批芯片主要用于运行 DeepSeek 的模型,也就是推理,而不是训练。
二、为什么是「推理」,不是「训练」
这是整件事里最关键的一个判断,也是很多人看漏的地方。
大模型公司的算力需求,大致分两块:
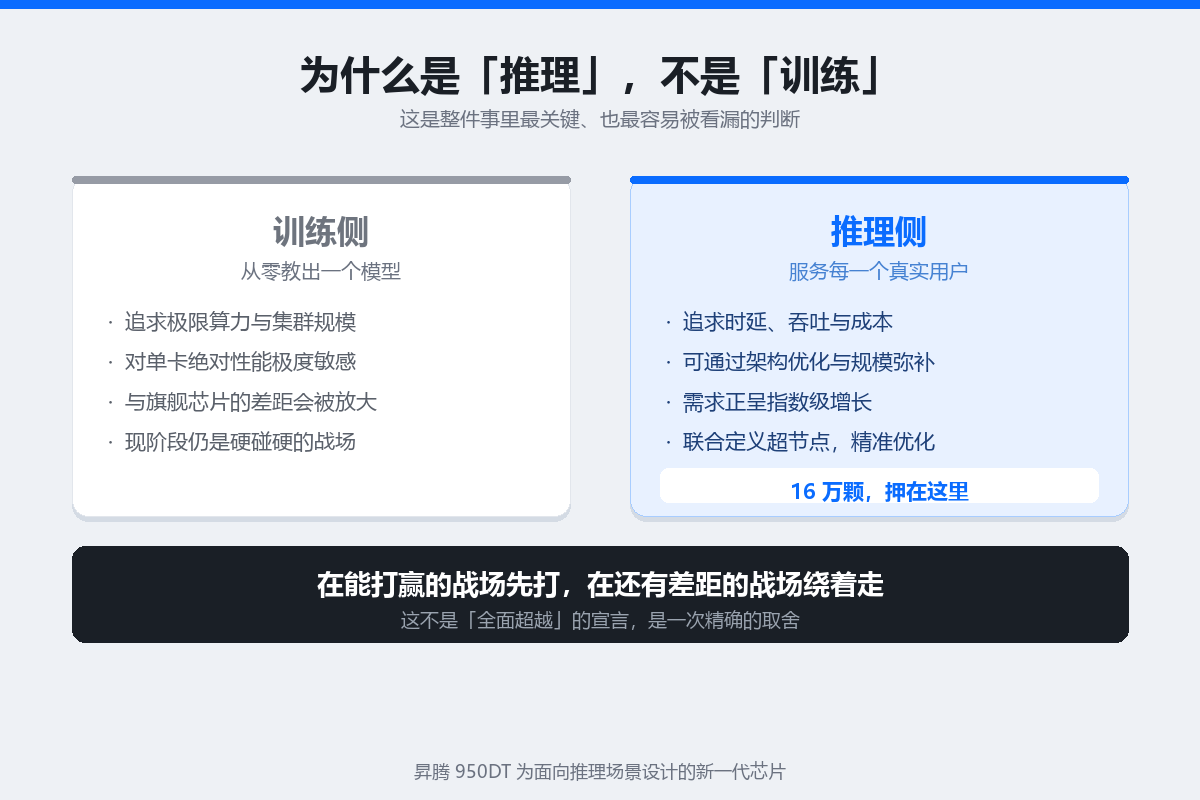
· 训练:从零教出一个模型,追求的是极限算力和集群规模,对单卡性能极度敏感;
· 推理:模型训练好之后,服务每一个真实用户,追求的是时延、吞吐和成本。
DeepSeek 把 16 万颗国产芯片押在推理侧,这个选择背后有非常清晰的商业逻辑:
第一,推理需求正在指数级增长。
随着大模型从「训练竞赛」转向「应用落地」,真正消耗算力的地方从实验室搬到了线上。每多一个用户问一句,就要多跑一次推理。这个量级的增长曲线,比训练陡峭得多。
第二,训练侧对单卡绝对性能的要求更高。
昇腾 950DT 与英伟达最新一代旗舰在绝对性能上仍有差距,尤其在训练侧。在推理场景,这个差距可以通过架构优化、集群规模和工程手段去弥补;但在训练场景,差距会被放大。
第三,这也是一条务实路径。
在能赢的战场先打,
在还有差距的战场绕着走。
换句话说,这不是「国产芯片已经全面超越」的宣言,而是一次精确的取舍:在能赢的战场先打,在还有差距的战场绕着走。
我认为这是整件事里最值得学习的地方 —— 在约束条件下做工程决策,而不是等条件完美了再动。
三、不只是买芯片,是联合定义架构
如果这只是一笔采购,那它的意义会小很多。真正让它不一样的,是另外一句:
DeepSeek 与华为联合定义了「昇腾超节点」。
围绕长文本推理的两个核心痛点 ——降低时延和提升吞吐—— 做针对性优化,同时兼顾向万卡级集群扩展的能力。
这意味着什么?意味着这不是「我买你的卡、跑我的模型」,而是模型方把自己的场景需求,直接写进了芯片和系统的设计里。
DeepSeek 作为头部大模型公司,最清楚推理场景的真实瓶颈在哪;华为有芯片设计和系统工程能力。两边互补,做出来的是一套为特定负载定制的架构,而不是通用硬件的堆砌。
这一点在产业上非常关键。英伟达真正的护城河从来不只是芯片性能,而是 CUDA 生态—— 全球开发者围绕它构建的工具链和优化经验,构成了极高的迁移成本。
而「模型公司 + 芯片公司联合定义架构」,本质上就是在从零构建一套国产算力的软件栈。当一家头部大模型公司愿意把自己的推理基础设施建在上面,并投入工程资源做深度适配,这种示范效应远超订单本身。
四、三个信号,比订单本身更重要
跳出 DeepSeek 一家公司,这件事向整个行业传递了三层信息。
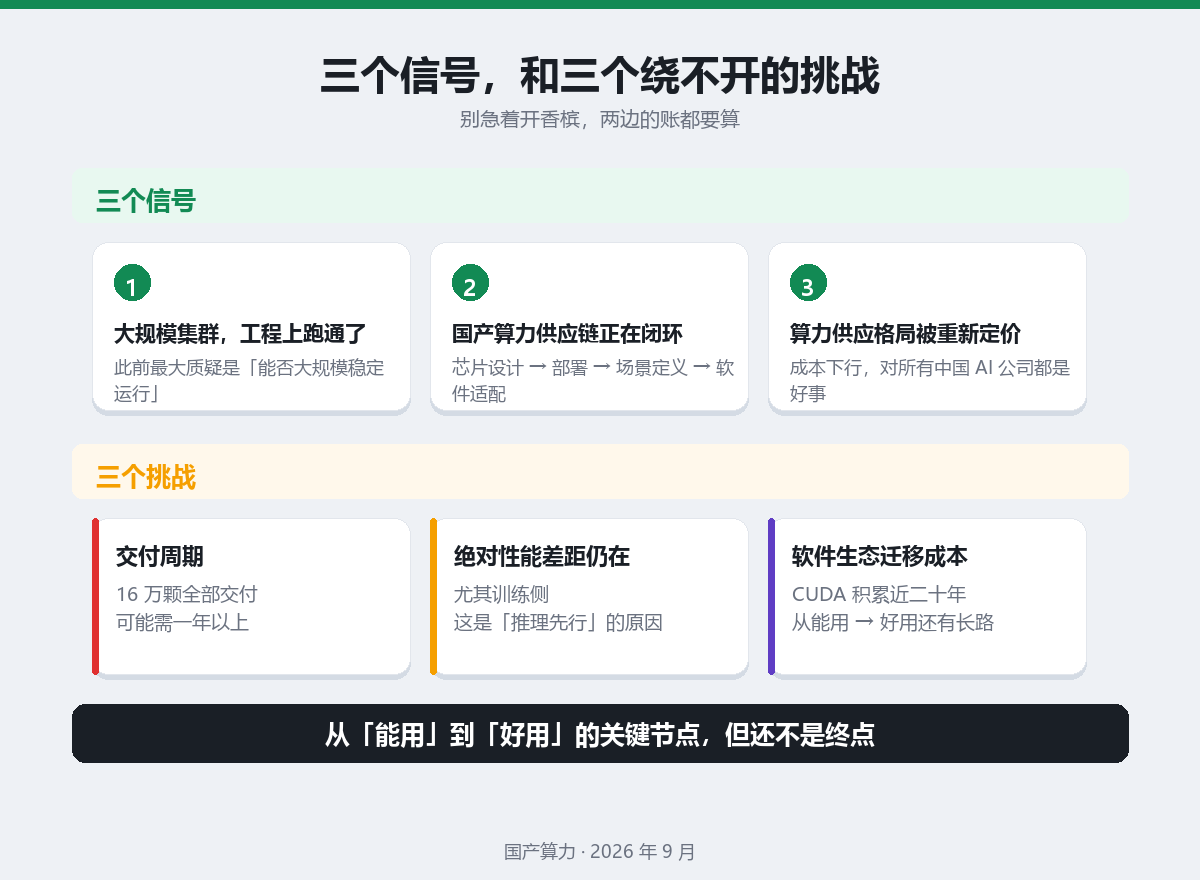
信号一:国产 AI 芯片的大规模集群部署,工程上跑通了。
此前市场对昇腾最大的质疑,不是「单卡行不行」,而是「能不能大规模稳定运行」。万卡集群的互联、调度、故障恢复、散热,每一步都是工程地狱。16 万颗的部署规模,本身就是对这个质疑最直接的回应 —— 如果工程上不可行,没人敢这么下单。
信号二:国产算力供应链正在闭环。
从芯片设计(华为)到大规模部署(DeepSeek),再到场景定义和软件适配,一条完整的价值链正在成型。这不是单点突破,是链条成型。
信号三:算力供应格局正在被重新定价。
当国产替代方案在推理侧能支撑吉瓦级集群时,外部供应商在中国市场的定价空间就会被压缩。这对所有中国 AI 公司都是好事 —— 不管你用谁的卡,成本都会往下走。
五、挑战依然在那儿,别急着开香槟
说了这么多好话,得把冷水也端上来。
挑战一:交付周期。
据报道,16 万颗芯片全部交付可能需要一年以上。这意味着项目本身仍面临产能爬坡的考验 —— 计划能不能如期落地,取决于供应链的实际能力。
挑战二:绝对性能差距仍在。
昇腾 950DT 与英伟达最新旗舰在绝对性能上仍有差距,尤其训练侧。DeepSeek 选「推理先行」,本身就是对这一现实的承认。
挑战三:软件生态的迁移成本。
CUDA 生态积累了近二十年。工具链、算子库、调试经验、开发者习惯 —— 这些东西不是砸钱能在短期内补齐的。联合定义超节点是好的开始,但从「能用」到「好用」再到「开发者主动想用」,还有很长的路。
从「能用」走向「好用」的关键节点 ——
但还不是终点。
六、约束驱动创新
这件事让我想到一个挺有意思的规律。
DeepSeek 创始人此前曾表示,受限于高端算力获取,公司在训练侧不得不做出诸多妥协。但正是在这种约束下,团队展现出了惊人的工程效率 —— 用更少的资源,做出了有竞争力的模型。
现在在推理侧大规模部署国产芯片,可以看作这种「约束驱动创新」逻辑在基础设施层面的延伸。
我越来越觉得,这是中国 AI 产业一个被低估的特征:不是因为条件好才跑得快,而是因为条件受限,被迫把工程效率卷到了极致。
当别人靠堆算力解决问题时,你只能靠优化算法、优化架构、优化调度来补 —— 短期看是吃亏,长期看这套能力反而更难被复制。
七、说回我们:算力变便宜,跟你有什么关系
关系其实很直接。
推理成本,最终会传导到你我付的钱上。
大模型从「实验室里的昂贵工具」变成「人人可用的服务」,中间最大的一道坎就是推理成本。谁把推理成本打下来,谁就能把价格打下来 —— 这也是为什么这两年 AI 服务的价格在快速下降,免费额度越来越多。
而国产算力规模化,正是这条成本曲线继续下行的一个新增动力。
AI 会越来越便宜,现在正是用起来的好时候。
这一点我最近体感特别明显。现在已经有工具可以帮你直接干活:丢一句话过去,它自己拆解步骤、读写你的本地文件、批量整理、生成文档表格、跑完数据分析再把结果交给你。
我自己最近在用腾讯的 WorkBuddy 干这些活 —— 整理下载文件夹、把一堆乱七八糟的 Excel 汇总成带图表的报告、一句话生成整套 PPT。
对新用户来说,现在入场其实挺划算:注册就有初始积分,日常签到和做任务还能持续领,普通人的使用量基本够用。
想试试?走我的邀请链接注册,初始积分比直接注册多不少
国内版:https://www.workbuddy.cn/events/invite?inviteCode=kdactlrpmqwgfh
国际版:https://workbuddy.ai/invite?code=HRAXZJXU
八、写在最后
回到开头那笔订单。
16 万颗芯片、25.6 亿美元、1GW —— 这些数字很抓眼球,但它们真正重要的地方不在于大。
而在于它证明了一件事:在外部供应环境不确定的情况下,中国 AI 公司没有停下来等,而是用工程效率和规模优势找到了另一条路。
这条路不完美:交付要等一年以上,绝对性能还有差距,软件生态还在补课。但它已经在跑了。
而所有的产业变化,最后都会落到一件很朴素的事上 —— 让 AI 变得更便宜、更普及,让更多普通人真的用得上。
到那时候,今天这条新闻的意义,才真正显现出来。
如果这篇对你有启发,点个赞、转发给同样在关注 AI 的朋友。
你觉得国产算力多久能追上来?留言聊聊你的判断。