一、CNN 基本组件回顾
在纵览历史前,先统一几个核心概念:
- 卷积(Convolution):用 k\\times k 卷积核在特征图上滑动,提取局部特征。参数共享 + 局部连接,使 CNN 比全连接大幅省参。
- 通道(Channel):输入 RGB 是 3 通道;每层输出若干通道,每个通道学一种特征响应。
- 步长(Stride)与填充(Padding):控制输出尺寸与边界信息保留。
- 池化(Pooling):最大/平均池化降分辨率、增平移不变性。
- 感受野(Receptive Field):输出一个像素"看到"的原始输入区域大小。越深越大,越能捕获全局语义。
输出尺寸公式(方形输入、same 语义下):
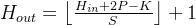
二、LeNet 到 AlexNet:从理论到工程
LeNet-5(1998,LeCun)
CNN 的"祖辈"。结构:输入 → 卷积 → 池化 → 卷积 → 池化 → 全连接 → 输出,用于手写数字识别(MNIST)。它确立了"卷积提取特征 + 池化降维 + 全连接分类"这一至今仍在用的范式。
AlexNet(2012,Krizhevsky)
深度学习引爆点的标志性模型,在 ImageNet 2012 把 Top-5 错误率从 ~26% 骤降到 ~15.3%。关键创新:
历史意义:AlexNet 证明了"大数据 + 深网络 + GPU"的可行性,开启了现代深度学习时代。
三、VGG 与 GoogLeNet 的设计哲学
VGG(2014,Simonyan)
VGG 的洞见很纯粹:用多个 3×3 小卷积替换一个大卷积。
- 两个 3×3 堆叠 = 一个 5×5 的感受野,但参数量 2\\times 3^2 = 18 < 5^2 = 25;
- 多了非线性(两个激活),表达力更强;
- VGG-16/19 结构极度规整,成为后续特征提取器的常用 backbone。
代价是参数量大(VGG-16 约 1.38 亿参数,多集中在全连接层)。
GoogLeNet / Inception(2014,Szegedy)
GoogLeNet 追求参数效率,核心是 Inception 模块:在同一层并行做 1×1、3×3、5×5 卷积与 3×3 池化,再把结果拼接。
- 1×1 卷积是其灵魂:先降维再升维,大幅减少计算量;
- 引入辅助分类器缓解深层梯度消失;
- 参数量仅约 500 万,却比 VGG 更深更准(Top-5 错误率 ~6.7%)。
四、ResNet 残差连接突破深度极限
为什么要残差?
理论上网络越深越好,但实践中深层网络反而精度下降(不是过拟合,是优化困难)。第 2 篇讲过的梯度消失 + 退化问题,让 50 层以上的网络难以训练。
残差块(Residual Block)
何恺明等人提出"跳过连接":
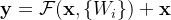
若x与y 维度不同,用 1×1 卷积做投影 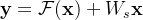 。
反向传播时梯度多了一条恒等捷径,信号可直接回传,使训练 152 层甚至 1000 层成为现实。ResNet-152 在 ImageNet 上 Top-5 错误率降到 ~3.57%,甚至超过人类水平。
现代回响:ConvNeXt(2022)用纯卷积重新吸收 Transformer 的设计(大核、LN、GELU),证明经典 CNN 思想在新时代依然能打。
五、五代架构横向对比
|
模型 |
年份 |
参数量(约) |
ImageNet Top-1 |
核心贡献 |
|
LeNet-5 |
1998 |
0.06M |
—(MNIST) |
卷积+池化范式 |
|
AlexNet |
2012 |
60M |
63.3% |
ReLU/Dropout/GPU |
|
VGG-16 |
2014 |
138M |
71.6% |
3×3 堆叠 |
|
GoogLeNet |
2014 |
5M |
69.8% |
Inception 多尺度 |
|
ResNet-18 |
2015 |
11.7M |
69.8% |
残差连接 |
注:Top-1 为各模型在 ImageNet-1k 上的典型 published 精度,不同复现略有浮动;ResNet-18 与 GoogLeNet 同代但设计取向不同(残差 vs 多尺度)。
六、PyTorch 复现 ResNet-18 分类
下面演示加载预训练 ResNet-18 做图像分类——这是迁移学习的入口,也是工程落地最常用的姿势:
import torch
from torchvision import models, transforms
from PIL import Image
# 1. 加载预训练模型(自动下载权重)
model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)
model.eval() # 切到推理模式,关闭 Dropout/BN 更新
# 2. 与训练时一致的图像预处理
preprocess = transforms.Compose([
transforms.Resize(256),
transforms.CenterCrop(224),
transforms.ToTensor(),
transforms.Normalize(mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225]),
])
img = Image.open("cat.jpg").convert("RGB")
input_tensor = preprocess(img).unsqueeze(0) # 加 batch 维
# 3. 推理
with torch.no_grad():
logits = model(input_tensor)
probs = torch.nn.functional.softmax(logits, dim=1)[0]
# 4. 读取类别标签并取 Top-5
with open("imagenet_classes.txt") as f:
labels = [l.strip() for l in f]
top5 = torch.topk(probs, 5)
for idx, score in zip(top5.indices, top5.values):
print(f"{labels[idx]:<20} {score.item():.4f}")
关键点:
- model.eval() 与 torch.no_grad() 是推理必备,否则 BN/Dropout 行为不一致;
- 预处理均值/方差必须与预训练时一致,否则精度暴跌;
- 想做自己的分类任务,只需把最后一层 model.fc 换成对应类别数的线性层再微调(详见本专栏后续《迁移学习》篇)。
七、架构演进总结
把五代串起来,是一条清晰的"问题—解法"主线:
LeNet (确立范式)
└─ AlexNet (ReLU/Dropout/GPU 引爆)
└─ VGG (证明深度 + 小卷积)
└─ GoogLeNet (多尺度 + 参数效率)
└─ ResNet (残差打破深度天花板)
每一代都在解决前一代的瓶颈:算不动 → 训不动 → 参太多 → 太浅,而残差连接几乎是"训不动"这一终极难题的钥匙。
参考资料
往期回顾
- 第 1 篇:神经网络基础——从感知机到多层网络的数学原理
- 第 2 篇:反向传播算法详解与梯度消失实战
📚 本篇出自专栏《深学之路:从感知机到智能体》 —— 从感知机到大模型智能体的完整深度学习连载(基础+工程化 、扩散模型 / RAG / Agent 等)。每篇附可运行代码与原创实验,收藏专栏不迷路。