概述
BM1688 把两个独立的计算核封装在一颗芯片里,每个核有自己的指令队列、局部存储和 L2
理解“双核(双 die)”是什么
BM1684X 的架构(对比基准)
BM1684X 是单核组、64 Lane:
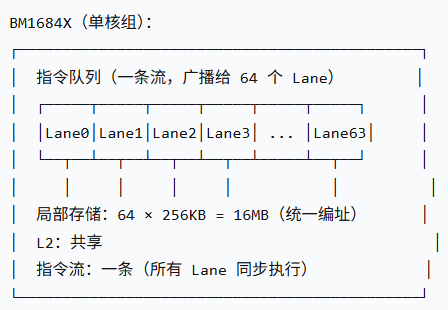
- 一条指令流,同时广播给 64 个 Lane。
- 64 个 Lane 的局部存储统一编址(16MB),但每个 Lane 只能访问自己那份。
- 所有 Lane 同步执行,SIMD 模式。
BM1688 的架构(双核)
BM1688 是双核组,每核 8 TOPS:
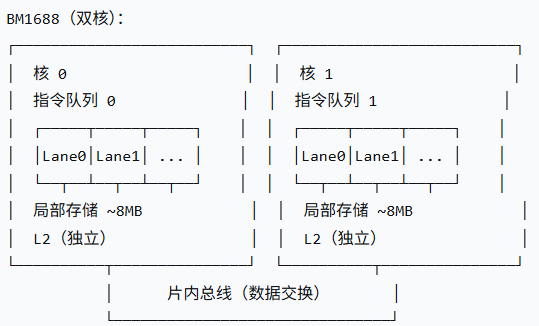
关键区别:
| 指令流 | 1 条 | 2 条(各自独立) |
| 局部存储 | 统一 16MB | 每核约 8MB,独立编址 |
| L2 | 共享 | 各自独立 |
| 核间通信 | 不需要(同一核内) | 需要(通过片内总线) |
| 编程模型 | 写一份代码,64 Lane 自动铺开 | 需要显式决定两个核各做什么 |
双核的好处:两个核可以独立跑不同的任务,灵活性更高;低功耗场景下可以只开一个核。
双核的代价:核间同步、数据交换、负载均衡都需要编译器处理,复杂度高。
统一例子:一个 4 层 CNN 模型
假设我们要在 BM1688 上跑一个简单的 CNN:
输入 x [1, 3, 224, 224]
│
▼
Conv1 (3→64, 3×3, stride=2) → [1, 64, 112, 112] → ReLU
│
▼
Conv2 (64→128, 3×3, stride=2) → [1, 128, 56, 56] → ReLU
│
▼
Conv3 (128→256, 3×3, stride=2) → [1, 256, 28, 28] → ReLU
│
▼
Conv4 (256→512, 3×3, stride=2) → [1, 512, 14, 14] → ReLU
│
▼
输出
我们来看看四种策略分别怎么把工作分给两个核。
策略一:流水切分(Pipeline Split)
思路
核 0 跑前一半层,核 1 跑后一半层,两核之间传递中间结果。
核 0:Conv1 → ReLU → Conv2 → ReLU
│
▼ 中间结果(经过 DDR 或片上互连)
核 1: Conv3 → ReLU → Conv4 → ReLU
具体执行过程
时间线:
时刻 t0: 核 0 开始算 Conv1
时刻 t1: 核 0 算完 Conv1,开始算 Conv2
时刻 t2: 核 0 算完 Conv2,把中间结果 [1,128,56,56] 写到 DDR
时刻 t3: 核 1 从 DDR 读中间结果,开始算 Conv3
时刻 t4: 核 1 算完 Conv3,开始算 Conv4
时刻 t5: 核 1 算完 Conv4,输出结果
负载均衡问题
如果核 0 的工作量是 60%,核 1 是 40%:
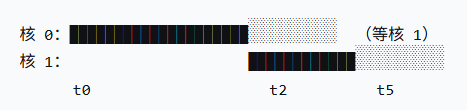
核 0 先算完,等核 1 完成,加速比只有 1/(0.6) ≈ 1.67×,而不是 2×。
适合场景:层内计算量均衡的模型,两核工作量差不多。
策略二:数据切分(Data Split)
思路
两核各跑一半 batch。 适合批量推理(batch=2 或 4)。
假设 batch = 2:
核 0:处理样本 0 的完整前向
核 1:处理样本 1 的完整前向
具体执行过程
核 0:Conv1 → ReLU → Conv2 → ReLU → Conv3 → ReLU → Conv4 → ReLU (样本 0)
核 1:Conv1 → ReLU → Conv2 → ReLU → Conv3 → ReLU → Conv4 → ReLU (样本 1)
两个核完全独立,不需要交换数据,不需要同步。
优缺点
优点:
- 实现最简单,两核完全独立。
- 负载天然均衡(每个样本的计算量相同)。
- 加速比接近 2×。
缺点:
- 只适合 batch ≥ 2 的场景。batch=1 时无法用。
- 如果 batch 是奇数(如 3),最后一个样本只能一个核跑,负载不均衡。
适合场景:批量推理,如视频解析(多帧同时处理)。
策略三:算子切分(Op Split)
思路
大算子内部按通道/空间分给两核,各算一半,最后合并。 需要跨核同步与部分和交换。
以 Conv2 为例(输出 128 个通道):
核 0:计算输出通道 0~63 的卷积
核 1:计算输出通道 64~127 的卷积
具体执行过程
Conv2 的输入:[1, 64, 56, 56](所有核都需要完整的输入)
Conv2 的权重:[128, 64, 3, 3](按输出通道分成两半)
核 0:
权重 [0:64, :, :, :]
计算输出 [1, 64, 56, 56](通道 0~63)
核 1:
权重 [64:128, :, :, :]
计算输出 [1, 64, 56, 56](通道 64~127)
合并:将两核的输出拼成 [1, 128, 56, 56]
同步与数据交换
时刻 t0: 两核各自从 DDR 读输入 [1, 64, 56, 56]
时刻 t1: 两核各自计算自己负责的 64 个输出通道
时刻 t2: 两核各自把输出写到 DDR 的不同区域
时刻 t3: 后续算子需要完整输入时,从 DDR 读合并后的结果
关键问题:两核都需要完整的输入(64 个通道),所以输入要读两遍。如果输入很大,这会增加访存量。
优缺点
优点
适合单个大算子,batch=1 也能用。
缺点:
实现最复杂(需要跨核同步、部分和交换)。
输入可能被重复读取,增加访存。
如果算子本身已经用了所有 Lane,切分后每个核算力减半,需要仔细设计。
适合场景:单个大算子(如大 GEMM、大卷积)需要并行时。
策略四:混合模式
思路
不同层用不同策略,由编译器的多核调度器决定。
Conv1:数据切分(batch=2,两核各一个样本)
Conv2:算子切分(输出通道分半)
Conv3:流水切分(核 0 算前半,核 1 算后半)
Conv4:数据切分
具体执行过程
时间线:
t0: Conv1(数据切分)→ 核 0 算样本 0,核 1 算样本 1
t1: Conv2(算子切分)→ 核 0 算通道 0~63,核 1 算通道 64~127
(两核需要交换部分和)
t2: Conv3(流水切分)→ 核 0 算前半层,核 1 算后半层
t3: Conv4(数据切分)→ 核 0 算样本 0,核 1 算样本 1
tpu-mlir 的多核调度
tpu-mlir 的 –multi_core 选项就是在做这件事:
# 启用双核调度
tpu-mlir –multi_core=2 model.mlir
编译器会分析模型结构,自动决定每层用哪种策略,生成两个核各自的指令流。
为什么多核加速不是线性的?
三座大山
| 核间同步 | 两核需要等待对方完成才能继续 | 同步开销直接吃掉加速比 |
| 负载均衡 | 两核工作量不相等时,一个核等另一个 | 加速比 = 1/max(核0时间, 核1时间) |
| 数据交换 | 中间结果需要通过 DDR 或片内总线传递 | 增加访存和延迟 |
具体计算
假设理想情况是 2× 加速,但:
- 同步开销:每次同步 5% 时间
- 负载不均衡:核 0 占 55%,核 1 占 45%
- 数据交换:中间结果传递占 10% 时间
实际加速比:
加速比=10.55+0.05+0.10≈1.43
加速比 = \\frac{1}{0.55 + 0.05 + 0.10} \\approx 1.43
加速比=0.55+0.05+0.101≈1.43
如果优化得更好(负载均衡、减少同步):
加速比=10.50+0.02+0.05≈1.75
加速比 = \\frac{1}{0.50 + 0.02 + 0.05} \\approx 1.75
加速比=0.50+0.02+0.051≈1.75
这就是为什么宣传 16 TOPS,实测吞吐可能只有 1.5~1.9× 的加速——编译器多核调度水平的差距。
总结
| 流水切分 | 核 0 跑前半层,核 1 跑后半层 | 层内计算量均衡 | 1.5~1.8× |
| 数据切分 | 两核各跑一半 batch | batch ≥ 2 | 接近 2× |
| 算子切分 | 大算子按通道/空间分半 | 单个大算子,batch=1 | 1.3~1.7× |
| 混合模式 | 不同层用不同策略 | 复杂模型 | 1.5~1.9× |
一句话:BM1688 的双核架构给编译器提供了灵活性,但也带来了同步、负载均衡、数据交换三座大山。
编译器的多核调度水平,直接决定了实际加速比是接近 2× 还是只有 1.5×。这就是为什么同样 16 TOPS 的芯片,不同工具链跑同一模型性能能差 30%。