文章目录
- AI Coding 落地实践手记
-
- 1. 先承认一个扎心的事实
-
- 1.1 五个问题
- 1.2 工具的三种形态
- 2. 第一阶段:普及,先把 80% 的下限抬起来
-
- 2.1 统一工作台
- 2.2 培训四板斧
- 3. 第二阶段:规范驱动,让 AI 按规矩写
-
- 3.1 SDD 五步产线
- 3.2 spec 会自我进化
- 4. 第三阶段:AI Native,让闭环真的闭上
- 5. 度量:怎么算才不是自说自话
-
- 5.1 AI 代码占比
- 5.2 全链路 Trace
- 5.3 首次正确率 FPY
- 6. 三个坑,我们帮你踩过了
-
- 6.1 坑一:杀鸡用牛刀
- 6.2 坑二:上下文塞得越多越好?假的
- 6.3 坑三:AI 幻觉,得靠第二只眼睛
- 7. 收个尾:AI 提效的终局
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看,传送门https://blog.csdn.net/qq_34419312
AI Coding 落地实践手记
AI 编码工具发下去那天,团队士气达到了历史高点:感觉公司给每人发了一个不会累、不要工资、不会离职的实习生。一个月后我们发现,这个实习生确实不会累,但它特别擅长一本正经地胡说八道。更扎心的是,工具人人都有,交付效率却纹丝不动——像办了健身卡,肉还在。
1. 先承认一个扎心的事实
1000 多个工程师、10 多个技术栈、几十条业务线。这个体量下,靠自觉是撑不住的。工具铺开之后,问题冒得比雨后春笋还快,而且个个长得都很眼熟。
1.1 五个问题
- 用法各自为政:有人把 AI 当搜索引擎,有人当许愿池,还有人当免费实习生——不发工资,还不用请吃饭的那种。
- 上下文重复建设:同一个项目的资料,每个人整理一遍,仿佛每个人都得重新发明一次轮子,而且发明出来的还是正方形。
- 代码风格不统一:有人写驼峰,有人写下划线,AI 生成第三种风格——它自己发明的。
- 效果说不清:问 AI 到底提效了多少,口径比菜市场还乱。
- 成本没人管得住:大家用 AI 像用公司 Wi-Fi,不看流量,只看心情。
这些问题的答案其实就一句话:个人提效,攒不成组织提效。就像你把全公司的人都教会了游泳,也不等于公司会游泳。
1.2 工具的三种形态
| 补全式 | 人主导,AI 补全 | Copilot / 通义灵码 |
| 对话式 | 人 prompt,AI 起草 | Cursor Chat / Qoder |
| Agentic | 人定目标,AI 多步闭环 | Cursor Agent / Claude Code |
补全式是你说一句 AI 接一句;对话式是你指挥 AI 干活;Agentic 是 AI 自己干活,你在后边喊"慢点慢点"。还有异步云端 Agent:派个任务进去,它在沙箱里自己跑,跑完提交 PR——像雇了个远程外包,你永远不知道它中间经历了什么。
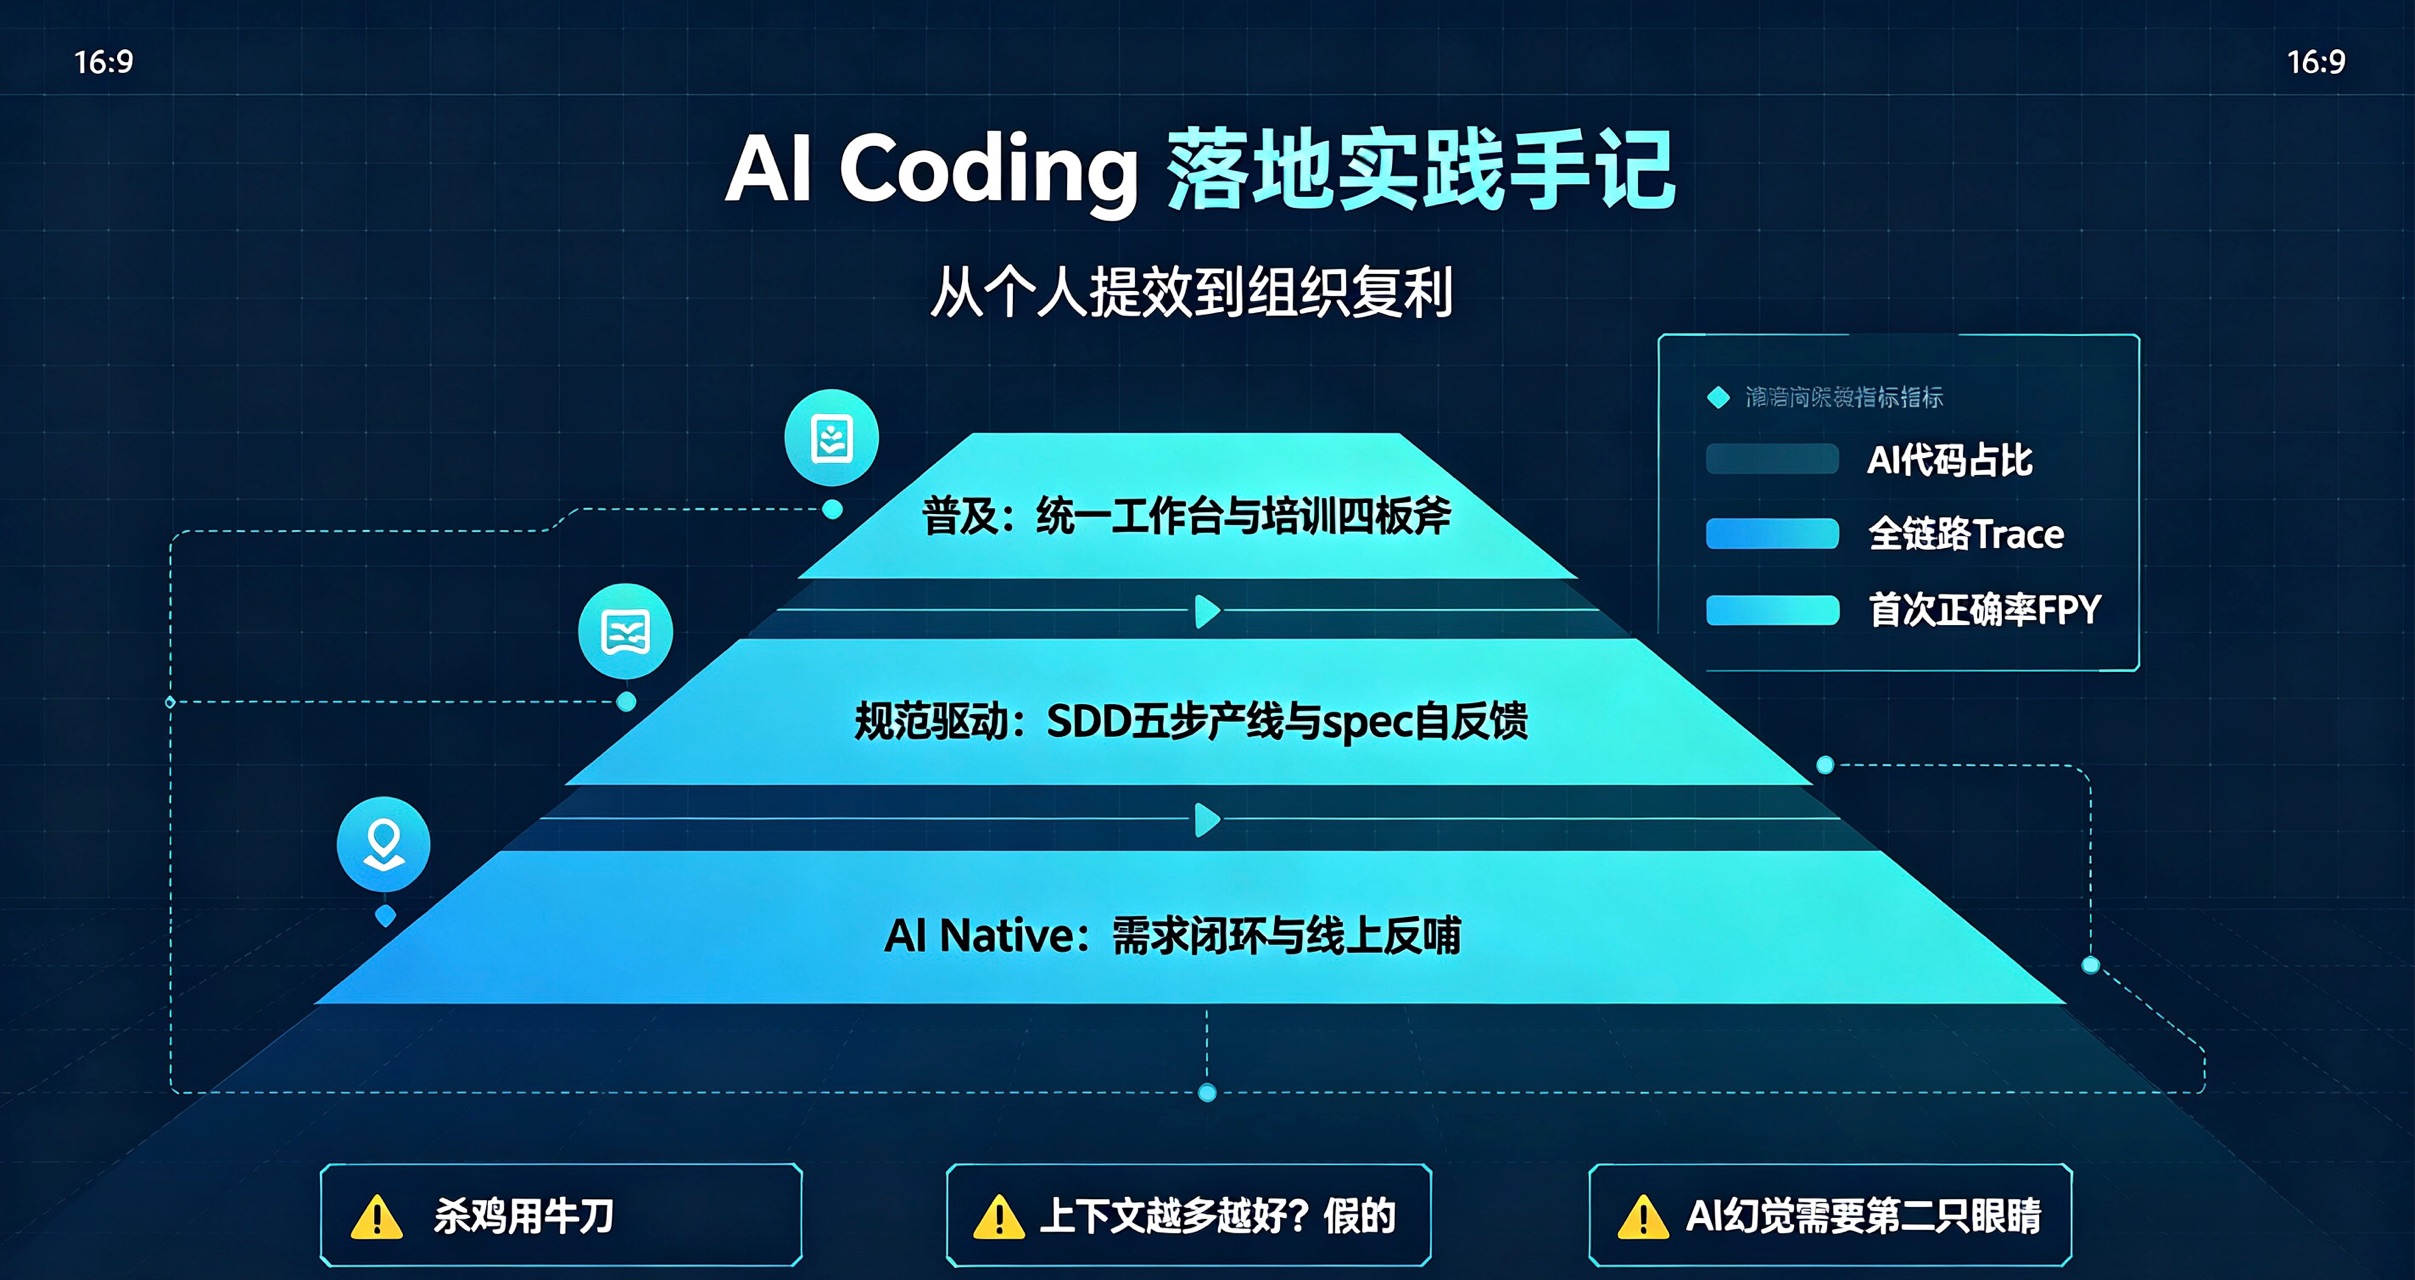
2. 第一阶段:普及,先把 80% 的下限抬起来
最早看到的不是效率,是分化。同一套工具,20% 的人用得风生水起,80% 的人用得一问三不知,差距大到不像在用一个软件。
深度用户接需求会自己整理上下文喂给 AI;普通用户打开 IDE,手一摊,直接开干。深度用户写方案用 MCP 加模板加多轮对话;普通用户让 AI 凭空想,AI 想了半天,想出来一个看起来很有道理、但完全不能用的方案。
所以我们决定:先不追那 20%,先把 80% 的底线抬起来。追不上学霸,就先保证不挂科。
2.1 统一工作台
我们的解法是一个统一工作台,管四样东西:Rules(规范)、Commands(命令)、Skills(技能)、MCP(工具)。一个人调好的上下文,全员复用。说人话就是:不是工具堆叠,是把个人的 AI 工作流,变成组织的 AI 资产。听起来很高级?说白了,高手配置一次,菜鸟直接抄作业。
2.2 培训四板斧
知道 AI 能干什么,和知道手上的活该怎么让 AI 干,中间差着一层。所以我们把日常研发拆成一批实战场景,每个场景配一个能照着跑的真实例子:读代码、加字段、做评审、写单测……先找一个接近的跟着做一遍,再拿去用。说白了,先抄,再超。
3. 第二阶段:规范驱动,让 AI 按规矩写
普及解决的是"能用",没解决"稳定可用"。普通研发写不好方案?那就把方案模板化,让 AI 按规范生成。规模化之后最稀缺的东西也变了:代码行数不缺,缺的是结构化的领域知识。
3.1 SDD 五步产线
每一步的产物都是下一步的输入:
最关键的是第一步。传统流程里,该读哪些上下文全靠人脑补,也最容易翻车。现在 AI 自动从四个库里召回候选 spec,打包成清单,人只负责勾——等于把"考试全靠背"变成了"开卷考,还帮你标好了重点"。
第四步也有讲究。一次变更牵动多个文件,AI 一口气写完,失败就全废。拆成 N 个原子 delta,跑前跑后各校验一次,出问题只回退那一步——像做手术,一刀一刀来,出了事只缝那一刀,不用把整个病人重做一遍。
3.2 spec 会自我进化
spec 不是写完了就摆在那吃灰。每次被召回,审查环节给它打分:命中了没、误导了没。命中率低、误导率高的进 backlog 修订,长期不命中的下架。跑得越多越准,而不是越用越烂。
这招有个朴素的名字:自反馈闭环。AI 跑题了,留下痕迹;打过分,低分的回炉;回炉完,下一轮用新版。像养宠物,越养越熟,前提是你真的在养,而不是摆着。
4. 第三阶段:AI Native,让闭环真的闭上
一个需求交付完,开发中积累的经验、上线后发现的问题,不能就这么散了,得喂给下一轮需求。
- 资产沉淀:需求、实现、CR、评审、修复,每一步自动入档;踩过的坑变成新的 Rule 和 CR 检查项,下一轮自动生效。
- 线上反哺:线上报警了,回溯当初的过程档案,把根因反向生成一条规则,下次同类需求自动生效。
说白了,团队不能靠记忆力活着。人都会忘,AI 也会忘,但写进档案和规则里的不会忘。
5. 度量:怎么算才不是自说自话
要说清 AI 到底干了多少活,得回答三件事:写了多少、过程能不能看见、第一次写得准不准。注意,具体数值各家口径不同,没有可比性,值钱的是算法本身能不能逐行对账。
5.1 AI 代码占比
公式长这样:
AI 代码占比 = AI 生成且最终合入主干的代码行
÷ 主干新增代码总行
关键在"最终合入主干"六个字。IDE 里显示 AI 生成了 1000 行,最后留下的可能只有 300 行,中间 700 行去哪了?删了、改了、覆盖了——像极了我们那些被否掉的方案,存在感很强,结局很惨。
为了对账,做三层采集:
跑完三层签名,才敢说这一行确实是 AI 写的。
5.2 全链路 Trace
我们把 spec 工作流当成 SkyWalking 一样跑:每一次生成都打点,每一次采纳都可追溯。一条脱敏的真实 trace:一个订单批量导出的需求,1.5 小时,20 个 span,AI 生成了 20 次,采纳了 14 次。生成了几次、采纳了几次,这两个数之间的差,就是 AI 还有多大改进空间的信号。
5.3 首次正确率 FPY
FPY = (commit 终版行数 – diff(v1, commit) 改动行数)
÷ commit 终版行数
翻译一下:AI 第一次写的代码,最后活下来了多少。一条需求里不同任务的 FPY 差别可能很大,总值看着还行,里面往往藏着一两个特别差的。那些低分任务,就是下一轮要补 spec 的地方。
这个指标有两个坑:第一,FPY 衡量的是生成质量,不是代码质量;第二,FPY 高,可能是 AI 写得准,也可能是你懒得改了直接提交——你以为是 AI 进步了,其实是人躺平了。
6. 三个坑,我们帮你踩过了
6.1 坑一:杀鸡用牛刀
最初的判断很天真:把最强的 Agent 发给所有人,效率自然就上去了。跑了一个月发现,杀鸡用牛刀,牛刀还很贵。补全一个单函数的活,让 Agent 启动整个流程,又慢又烧 token——鸡是杀了,牛也没了。
后来改成按任务步数分通道:
if 任务步数 <= 2 and 单文件 and 语义清晰:
走 Vibe Coding # IDE 里 tab 补全,零学习成本
else:
走 Agentic Workflow # AiBox 工作台,全流程留痕
标准要硬,不然大家凭手感选,最后要么全用重的,要么全用轻的。任务步数这种一眼能判断的标准,比任何描述性的定义都管用。
6.2 坑二:上下文塞得越多越好?假的
早期我们觉得喂得越多越好,单次 prompt 塞十万 token。结果两个问题同时出现:注意力被稀释,质量不升反降;token 成本涨得飞快。
后来改成精准召回:场景化上下文包按 PRD 类型和业务域召回,不一锅烩;关键词触发知识点,命中才注入,不全量塞;三维联评,盯住覆盖度、准确率、自动化注入率。每加一条规范,先回答一个问题:它什么条件下注入、命中率多少。答不上来的规范,加进去就是噪声。
6.3 坑三:AI 幻觉,得靠第二只眼睛
AI 最擅长写出看起来很对的代码:API 不存在,字段是编的,依赖是错的。读起来逻辑通顺,跑起来当场去世。人工评审最容易漏,因为逻辑是通的,错的是事实。
解法是主从双 Agent:主 Agent 按 spec 实现,读源码 grounding,不凭想象;副 Agent 独立读真实源码、跑测试,只干一件事——核对 API、字段、依赖是不是真的存在。不过就驳回,带上反馈,主 Agent 改完再验。
关键在"独立"两个字。副 Agent 不能复用主 Agent 的上下文,不然它俩会一起幻觉,错得还挺整齐,像合唱团。
7. 收个尾:AI 提效的终局
我们对人和 AI 的分工有个三层描述:L1 全部人工,慢但可控;L2 人定义目标、AI 起草、人做决审——我们在这;L3 AI 自己闭环,人只做兜底抽查。
从 L1 到 L3 不是一步跳过去的,卡住的地方不只是模型能力,还有两个硬约束:一是交付稳定性,AI 加速了变更流入,测试和反馈跟不上就会被冲垮;二是决策权划分,哪些环节 AI 可以自己闭环、哪些必须人签字,得一个场景一个场景地划,划错了要么出事故,要么等于没自动化。
这一年的经验就一句话:把个人摸索出来的好用法,整理成团队能共用的配置、规范和流程。Vibe Coding 是单局的爽,Agentic Engineering 是长期的复利——翻译一下,前者像喝奶茶,后者像健身。你猜大多数人选哪个。
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看,传送门https://blog.csdn.net/qq_34419312