从生产者消费者到池化技术
在之前的生产者消费者模型中,在任务体系下:
-
生产者要获取生产任务,获取过程比较耗时
-
消费者要消费处理任务,处理过程也比较耗时
而在这个体系中,我们允许生产者和消费者同时进行生产消费——也就是说,生产者获取任务的同时,消费者可以处理任务,这就是效率高的来源。
问题:来一个任务就创建一个线程
但今天,如果来一个任务才创建一个线程去处理:
任务到达 → 创建线程 → 处理任务 → 线程退出
创建线程就要调用系统调用(clone),而系统调用是有成本的:
-
要把系统调用号通过寄存器传递给内核
-
要从用户态通过 syscall 或 int 0x80 陷入内核
-
内核要完成权限切换、现场保护、调度等
频繁创建销毁线程,效率低下。
类比:池化技术
这就解释了为什么: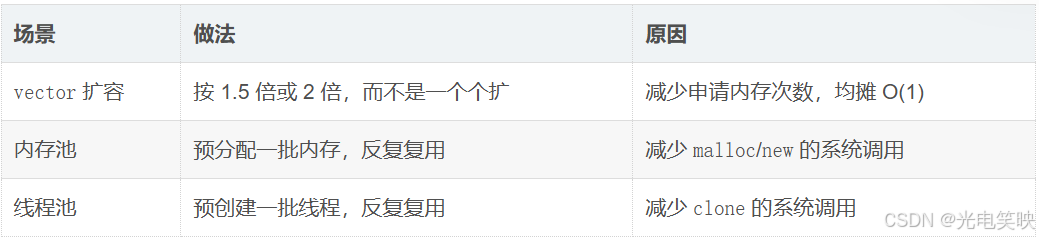
它们都是池化技术——提前准备好资源,避免频繁申请释放带来的系统调用开销,从而提高效率。
总结
生产者消费者模型让"获取任务"和"处理任务"并行,提高效率。但如果每个任务都创建新线程,频繁的系统调用又成了瓶颈。于是有了池化技术:内存池复用内存、线程池复用线程、vector 按倍数扩容——核心都是减少系统调用次数,用复用换效率。
所以我们能不能先创建一批线程,有任务处理没任务休眠呢
1.线程池
1-1 日志与策略模式
设计模式与日志
什么是设计模式?
IT 行业涌入的人很多,大佬和菜鸡两极分化越来越严重。为了让菜鸡不太拖大佬后腿,大佬们针对一些经典的常见场景,给出了一些对应的解决方案,这就是设计模式。
日志认识
计算机中的日志是记录系统和软件运行中发生事件的文件,主要作用是监控运行状态、记录异常信息,帮助快速定位问题并支持程序员进行问题修复。它是系统维护、故障排查和安全管理的重要工具。
日志有现成的解决方案,如 spdlog、glog、Boost.Log、Log4cxx 等,这里我们采用自定义日志的方式,用策略模式来设计。
日志格式
[时间] [日志等级] [进程pid] [文件名] [行号] – 消息内容
[2024-08-04 12:27:03] [DEBUG] [202938] [main.cc] [16] – hello world
[2024-08-04 12:27:03] [WARNING] [202938] [main.cc] [23] – hello world
| 时间戳 | 必须 |
| 日志等级 | 必须 |
| 日志内容 | 必须 |
| 文件名、行号 | 可选 |
| 进程、线程 ID | 可选 |
日志等级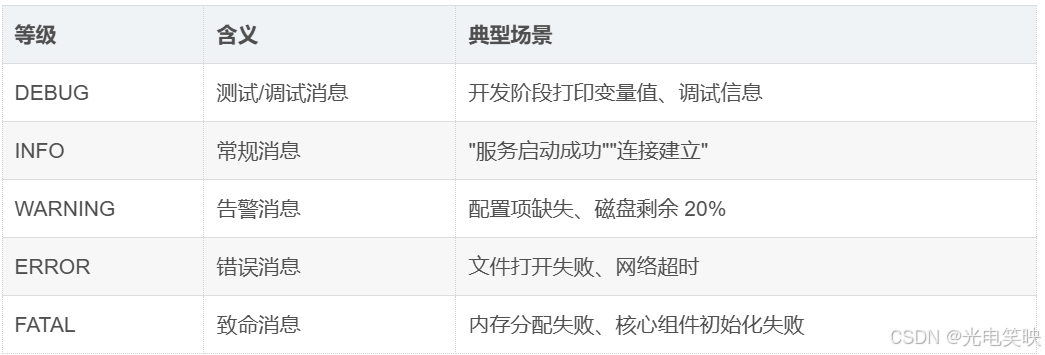
日志等级是衡量软件健康状态的重要量化指标。10 个产品汇总分析日志:没有 WARNING 以上就健康;大量 FATAL 说明服务器有问题,需要运维介入。
策略模式
日志的核心功能只有两个:
形成一条完整的日志
刷新到目标(显示器、指定文件等)
为了让"刷新到哪"可定制,引入策略模式:
也就是说将来你想让日志向哪里刷,可以定制自己的策略,在我们这个情形下就是定义一个基类LogStrategy两个派生类ConsoleLogStrategy,FileLogStrategy即两种策略派生类重写基类的策略函数,将来可以利用多态快速切换策略模式
class LogStrategy // 策略基类
{
public:
virtual ~LogStrategy() = default;
virtual void SyncLog(const std::string &message) = 0;
};
class ConsoleLogStrategy : public LogStrategy // 策略1:显示器
{
virtual void SyncLog(const std::string &message) override
{
MutexModule::LockGuard guard(_lock);
std::cerr << message << gsep;
}
};
class FileLogStrategy : public LogStrategy // 策略2:文件
{
virtual void SyncLog(const std::string &message) override
{
MutexModule::LockGuard guard(_lock);
std::ofstream out(file, std::ios::app);
out << message << gsep;
}
};
将来想往哪刷,make_unique 对应的策略即可,调用方代码不变。
核心知识点
一、虚析构就是多态
class LogStrategy
{
public:
virtual ~LogStrategy() = default; // ← 虚析构
};
class FileLogStrategy : public LogStrategy { … };
为什么必须虚析构?
LogStrategy* p = new FileLogStrategy();
delete p;
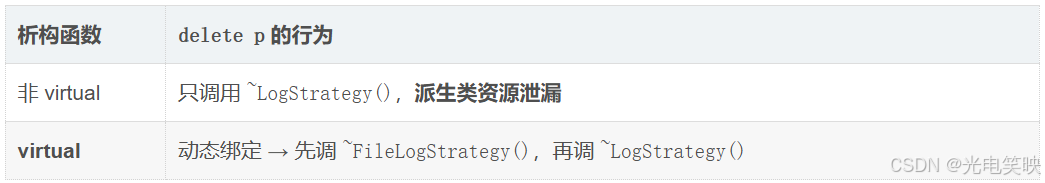
虚析构就是多态:
-
编译时:p 是 LogStrategy*
-
运行时:动态绑定到 FileLogStrategy::~FileLogStrategy()
和普通虚函数一样——通过基类指针调用,运行时决定执行哪个版本。
关于这个知识点我在C++ 多态详解_c++中什么是多态-CSDN博客有非常详细的解释,有兴趣可以看看
二、返回临时对象与对象析构时机
仿函数返回临时对象
LogMessage operator()(LogLevel level, std::string src_name, int line_number)
{
return LogMessage(level, src_name, line_number, *this);
}
展开:
LOG(DEBUG) << "hello world";
// 等价于
logger(DEBUG, __FILE__, __LINE__) << "hello world";
// 等价于
LogMessage(DEBUG, __FILE__, __LINE__, logger) << "hello world";
执行流程: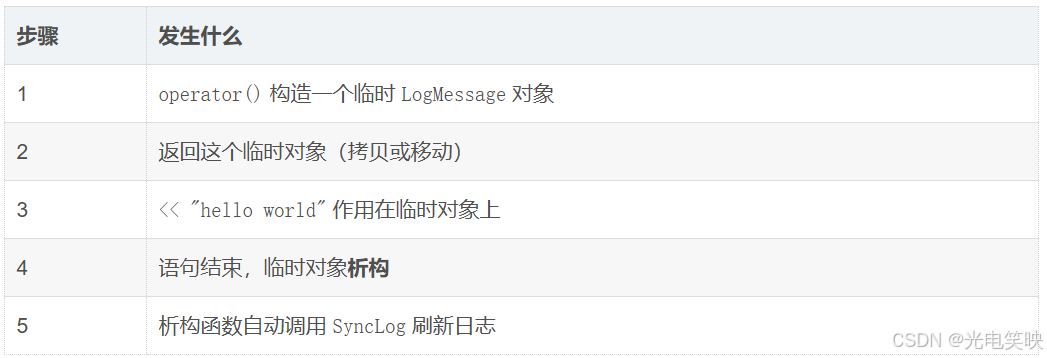
析构时机
~LogMessage() // 临时对象析构自动刷新
{
if (_logger._fflush_strategy)
_logger._fflush_strategy->SyncLog(_log_info);
}
这是 RAII 的核心:
-
对象创建 = 资源获取(拼日志、准备刷新)
-
对象销毁 = 资源释放(自动刷新输出)
-
用户不用手动调 Output(),语句结束自动完成
不管发生什么(正常结束、异常、return),析构函数都会执行,日志不会丢。
三、RAII 管理
RAII(Resource Acquisition Is Initialization):资源获取即初始化。
核心思想:把资源的生命周期绑定到对象的生命周期。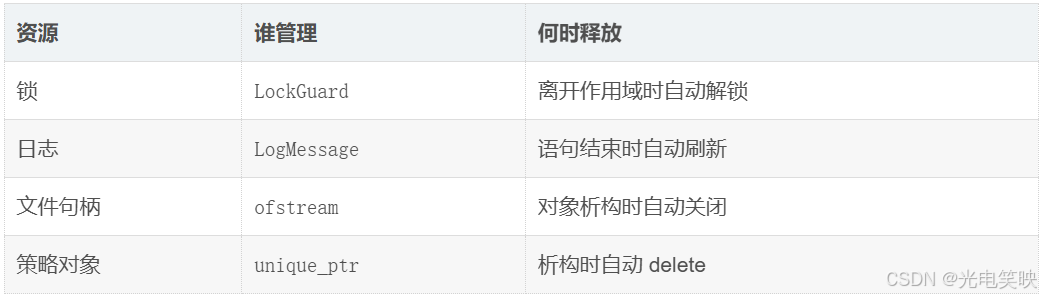
在日志系统中的体现:
LOG(DEBUG) << "hello";
│
▼
创建 LogMessage 临时对象 ← 资源获取
│
▼
<< 追加内容
│
▼
语句结束,析构 ← 资源释放(自动刷新)
好处:不会忘记刷新、异常安全、代码简洁
四、链式调用
template <class T>
LogMessage &operator<<(const T &info)
{
std::stringstream ss;
ss << info << " ";
_log_info += ss.str();
return *this; // ← 返回自身引用,链式调用的关键
}
为什么 return *this 能链式调用?
LOG(DEBUG) << "a" << 1 << 2.5;
展开:
LogMessage(…).operator<<("a") → 返回 LogMessage&
.operator<<(1) → 返回 LogMessage&
.operator<<(2.5) → 返回 LogMessage&
每次 << 都返回当前对象本身,供下一次 << 使用。
如果没有 return *this:
LOG(DEBUG) << "a" << 1; // 错误 第二个 << 没有对象可调
类比标准库:
std::cout << "a" << 1 << 2.5;
std::cout 的 operator<< 也是返回 ostream&,原理一样。
五、内部类 LogMessage
为什么要设计内部类?
把"一条日志"的生命周期封装成一个对象: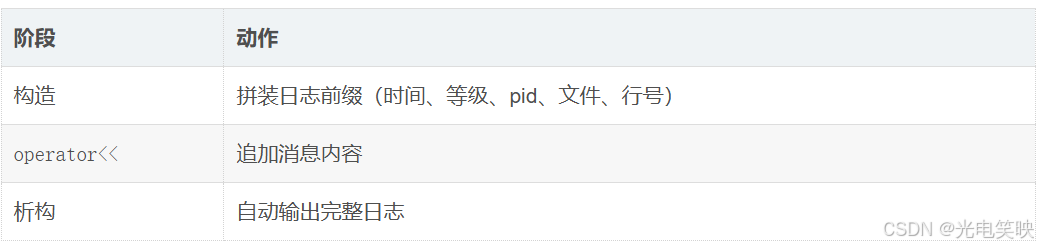
放在 Logger 内部的原因:
-
逻辑上属于日志系统
-
能访问 Logger 的私有成员 _fflush_strategy
-
不污染外部命名空间
为什么成员用引用 Logger&?
代码场景
class Logger
{
public:
class LogMessage
{
private:
Logger &_logger; // 引用,可以
// Logger _logger; // 对象,报错
};
private:
std::unique_ptr<LogStrategy> _fflush_strategy;
};
原因:因为在 LogMessage 定义时,Logger 还没有定义完成。
class Logger // ← Logger 开始定义
{
class LogMessage // ← LogMessage 开始定义
{
Logger _logger; // ← 此刻 Logger 还在定义中,不完整
}; // ← LogMessage 结束
…
}; // ← Logger 到这里才完整
编译器处理到 Logger _logger; 时,Logger 是不完整类型,不知道它占多少字节,无法分配空间。
不完整类型的限制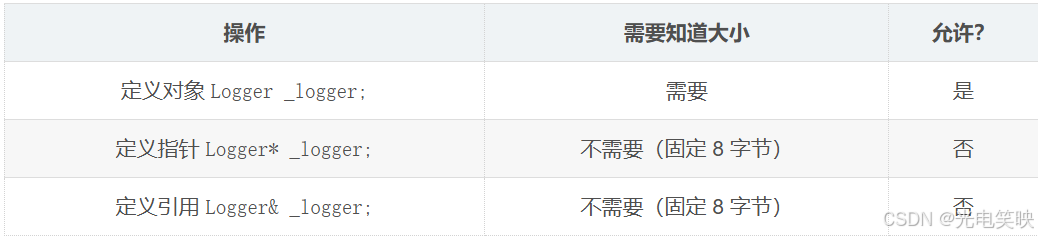
指针和引用的大小是固定的,编译器不需要知道 Logger 多大就能分配空间,所以可以。
六、宏简化
#define LOG(level) LogModule::logger(level, __FILE__, __LINE__)
#define Enable_Console_Log_Strategy() LogModule::logger.EnableConsoleLogStrategy()
#define Enable_File_Log_Strategy() LogModule::logger.EnableFileLogStrategy()
__FILE__ 和 __LINE__ 是预处理器宏,自动替换为当前文件名和行号。
使用:
Enable_File_Log_Strategy();
LOG(LogModule::LogLevel::DEBUG) << "hello world" << 3.14;
展开:
LogModule::logger.EnableFileLogStrategy();
LogModule::logger(LogModule::LogLevel::DEBUG, "Main.cc", 29) << "hello world" << 3.14;
七、完整调用链
用户:LOG(DEBUG) << "hello" << 3.14;
↓
宏展开:LogModule::logger(DEBUG, __FILE__, __LINE__) << "hello" << 3.14;
↓
operator():构造临时 LogMessage,拼前缀
↓
operator<<:追加 "hello "、"3.14 "
↓
语句结束,临时对象析构
↓
~LogMessage:调用 _fflush_strategy->SyncLog(_log_info)
↓
ConsoleLogStrategy:加锁 → 打印到屏幕
或
FileLogStrategy:加锁 → 追加写入文件
总结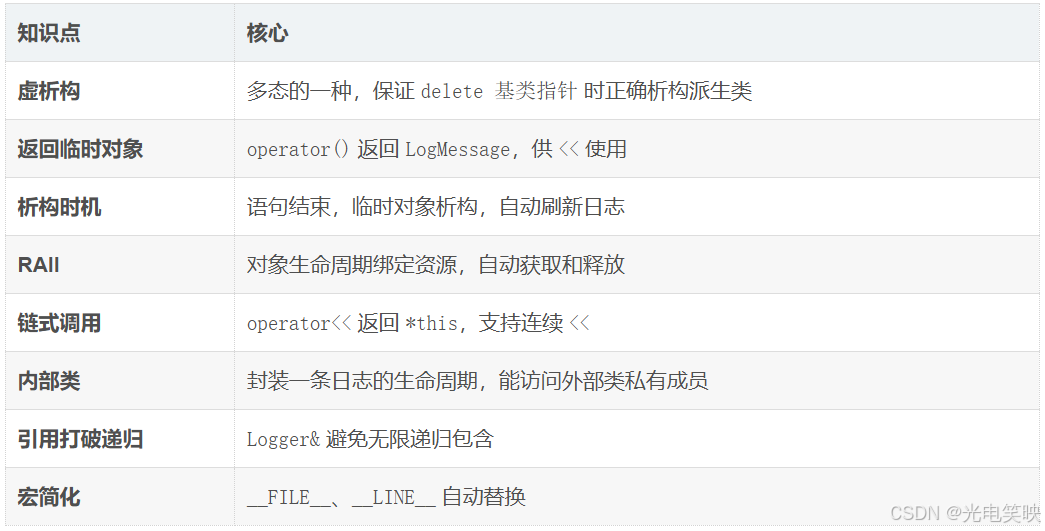
完整代码与测试:
Log.hpp
#pragma once
#include <iostream>
#include <string>
#include "Mutex.hpp"
#include <filesystem> //C++17
#include <fstream>
#include <memory>
#include <unistd.h>
#include <sys/types.h>
#include <sstream>
#include <cstdio>
#include <time.h>
namespace LogModule
{
const std::string gsep = "\\r\\n";
// 刷新策略 a.向显示器打印 b.向指定文件打印
// 刷新策略基类
class LogStrategy
{
public:
virtual ~LogStrategy() = default; // 虚析构实现多态
virtual void SyncLog(const std::string &message) = 0;
private:
};
// 显示器打印策略
class ConsoleLogStrategy : public LogStrategy
{
public:
~ConsoleLogStrategy() override = default;
ConsoleLogStrategy() = default;
virtual void SyncLog(const std::string &message) override
{
// 由于显示器是文件,当多线程向显示器打印,显示器也是临界资源,所以也要加锁保护
MutexModule::LockGuard guard(_lock);
std::cerr << message << gsep;
}
private:
MutexModule::Mutex _lock;
};
// 向指定文件打印打印策略
const std::string defaultpath = "./log";
const std::string defaultfile = "log.txt";
class FileLogStrategy : public LogStrategy
{
public:
~FileLogStrategy() override = default;
// 文件不存在没关系可以append模式自动创建,路径就要我们自己创建了
FileLogStrategy(const std::string &path = defaultpath, const std::string &file = defaultfile)
: _file(file), _path(path)
{
// 防止多线程并发使用构建FileLogStategy就要加锁
MutexModule::LockGuard guard(_lock);
if (std::filesystem::exists(_path)) // 存在返回真,不存在就为假
{
return;
}
try
{
std::filesystem::create_directories(_path); // 创建可能失败,比如没权限等
}
catch (const std::filesystem::filesystem_error &e)
{
std::cerr << e.what() << std::endl;
}
}
virtual void SyncLog(const std::string &message) override
{ // 文件操作也要是原子的
MutexModule::LockGuard guard(_lock);
std::string file = _path + (_path.back() == '/' ? "" : "/") + _file; //_path + "/" + _file = "./log/log.txt"
std::ofstream out(file, std::ios::app); // 追加方式打开
if (!out.is_open())
{
return;
}
out << message << gsep;
out.close();
}
private:
MutexModule::Mutex _lock;
std::string _file; // 日志文件本身
std::string _path; // 日志文件所在路径
};
// 形成一条完整的日志,根据策略选择不同的刷新方式
// enum class 是强类型枚举,不是类。它只是借用了类的"作用域"和"封装"特性,
// 让枚举值必须通过 XXX:: 访问,且不能隐式转成整数。本质还是枚举,比 C 的 enum 更安全。
enum class LogLevel // 形成日志等级
{
DEBUG,
INFO,
WARNING,
ERROR,
FATAL
};
std::string GetTimeStamp()
{
time_t curr = time(nullptr);
struct tm curr_time_struct;
localtime_r(&curr, &curr_time_struct);
char timebuff[128];
snprintf(timebuff, sizeof(timebuff), "%4d-%02d-%02d %02d:%02d:%02d",
curr_time_struct.tm_year + 1900,
curr_time_struct.tm_mon + 1,
curr_time_struct.tm_mday,
curr_time_struct.tm_hour,
curr_time_struct.tm_min,
curr_time_struct.tm_sec);
return timebuff;
}
std::string LevelToString(const LogLevel &level)
{
switch (level)
{
case LogLevel::DEBUG:
return "DEBUG";
case LogLevel::INFO:
return "INFO";
case LogLevel::WARNING:
return "WARNING";
case LogLevel::ERROR:
return "ERROR";
case LogLevel::FATAL:
return "FATAL";
default:
return "UNKNOWN";
}
}
// 功能:1.形成日志,2.根据不同策略,完成刷新
class Logger
{
public:
// 内部类,表示的是未来完整的一条日志
class LogMessage
{
public:
//[可读性很好的时间] [⽇志等级] [进程pid] [打印对应⽇志的⽂件名][⾏号] – 消息内容,⽀持可变参数
//[2024-08-04 12:27:03] [DEBUG] [202938] [main.cc] [16] – hello world
//[2024-08-04 12:27:03] [WARNING] [202938] [main.cc] [23] – hello world
LogMessage(const LogLevel &level, const std::string &src_name, int line, Logger &logger)
: _curr_time(GetTimeStamp()), _level(level), _pid(getpid()), _src_name(src_name), _line_number(line), _logger(logger)
{
// 日志的左半部分
std::stringstream ss; // stringstream 可以把各种类型"格式化到流里",最后用 .str() 取出字符串。
ss << "[" << _curr_time << "] "
<< "[" << LevelToString(_level) << "] " // 是 enum class类型,类型安全,禁止隐式转换,则根本不能直接输出。所以这边提供一个接口
<< "[" << _pid << "] "
<< "[" << _src_name << "] "
<< "[" << _line_number << "] "
<< "" << "-" << " ";
_log_info = ss.str();
}
// LogMessage()<<"hello world";//要支持重载,
// LogMessage()<<"hello world"<<"你好"<<3.14<<666;
// 右半部分:
template <class T> // 泛型:T 可以是 int、double、string、任何类型。
LogMessage &operator<<(const T &info)
{
std::stringstream ss;
ss << info << " ";
_log_info += ss.str();
return *this; // 返回自身引用,这是链式调用的关键。
}
// LogMessage(…).operator<<("hello") → 返回 LogMessage&
// .operator<<(3.14) → 返回 LogMessage&
// .operator<<(666) → 返回 LogMessage&
// LOG(INFO) << "a" << 1 << 2.5 能一行写下去——每次 << 都返回对象自己,供下一次 << 使用。
~LogMessage() // 临时对象析构自动刷新
{
if (_logger._fflush_strategy)
_logger._fflush_strategy->SyncLog(_log_info);
}
private:
std::string _curr_time;
pid_t _pid;
LogLevel _level;
std::string _src_name;
int _line_number;
std::string _log_info; // 合并之后完整的信息
Logger &_logger; // 需要引用,不然Logger 包含 LogMessage,LogMessage 包含 LoggerLogger 包含 LogMessage,…,无限递归包含,编译器无法确定 Logger 的大小
};
// 为什么要设计一个内部类
// 设计内部类 LogMessage 是为了把"一条日志"的生命周期封装成一个对象:
// 构造时拼前缀,<< 追加内容,析构时自动输出。这是 RAII 的经典应用——
// 用户只写一行,背后自动完成全部工作。而放在 Logger 内部,是因为它逻辑上属于日志系统,
// 还能访问 Logger 的私有成员,不污染外部命名空间。
Logger()
{
EnableConsoleLogStrategy();
}
~Logger() = default;
// 开启刷策略
void EnableFileLogStrategy()
{
_fflush_strategy = std::make_unique<FileLogStrategy>();
}
void EnableConsoleLogStrategy()
{
_fflush_strategy = std::make_unique<ConsoleLogStrategy>();
}
// 仿函数,故意返回构造临时对象,链式调用结束后,LogMessage临时对象就会自动被析构,调用析构函数刷新数据
LogMessage operator()(LogLevel level, std::string src_name, int line_number)
{
return LogMessage(level, src_name, line_number, *this);
}
private:
std::unique_ptr<LogStrategy> _fflush_strategy;
};
// 全局日志对象
Logger logger;
}
// 下一个阶段,使用宏简化用户操作,用预处理符获取文件名和行号,替换完后就是当前文件名和行号
#define LOG(level) LogModule::logger(level, __FILE__, __LINE__) // 仿函数像函数一样调用
#define Enable_Console_Log_Strategy() LogModule::logger.EnableConsoleLogStrategy()
#define Enable_File_Log_Strategy() LogModule::logger.EnableFileLogStrategy()
Main.cc
#include "Log.hpp"
// //for debug
// int main()
// {
// //std::unique_ptr<LogModule::LogStrategy> Strategy=std::make_unique<LogModule::ConsoleLogStrategy>();
// std::unique_ptr<LogModule::LogStrategy> Strategy=std::make_unique<LogModule::FileLogStrategy>();
// Strategy->SyncLog("hello log");
// return 0;
// }
// int main()
// {
// LogModule::log.EnableConsoleLogStrategy();
// LogModule::log(LogModule::LogLevel::DEBUG, "main.cc", 10) << "hello world" << 666;
// return 0;
// }
// int main()
// {
// LogModule::log.EnableFileLogStrategy(); //链式调用
// LogModule::log(LogModule::LogLevel::DEBUG, "main.cc", 10) << "hello world" << 666<<"aaaa"<<3.14<<'c';
// return 0;
// }
// 定义宏简化后
int main()
{
Enable_File_Log_Strategy();
LOG(LogModule::LogLevel::DEBUG) << "hello world" << 3.14;
LOG(LogModule::LogLevel::DEBUG) << "hello world" << 3.14;
Enable_Console_Log_Strategy();
LOG(LogModule::LogLevel::DEBUG) << "hello world" << 3.14;
LOG(LogModule::LogLevel::DEBUG) << "hello world" << 3.14;
return 0;
}
线程池设计
一、什么是线程池
线程池是一种线程使用模式。线程过多会带来调度开销,进而影响缓存局部性和整体性能。而线程池维护着多个线程,等待着监督管理者分配可并发执行的任务。这避免了在处理短时间任务时创建与销毁线程的代价。线程池不仅能够保证内核的充分利用,还能防止过分调度。可用线程数量应该取决于可用的并发处理器、处理器内核、内存、网络 sockets 等的数量。
应用场景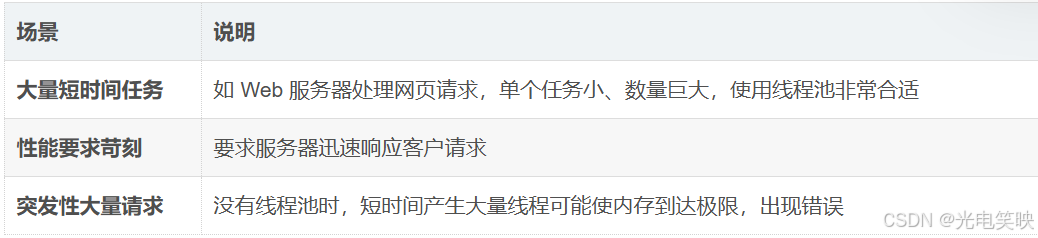
对于长时间任务(如 Telnet 连接),线程池的优点就不明显了——会话时间比线程创建时间大得多。
线程池的种类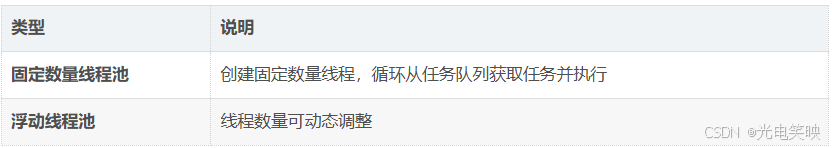
此处我们选择固定线程个数的线程池。
二、设计思路
核心架构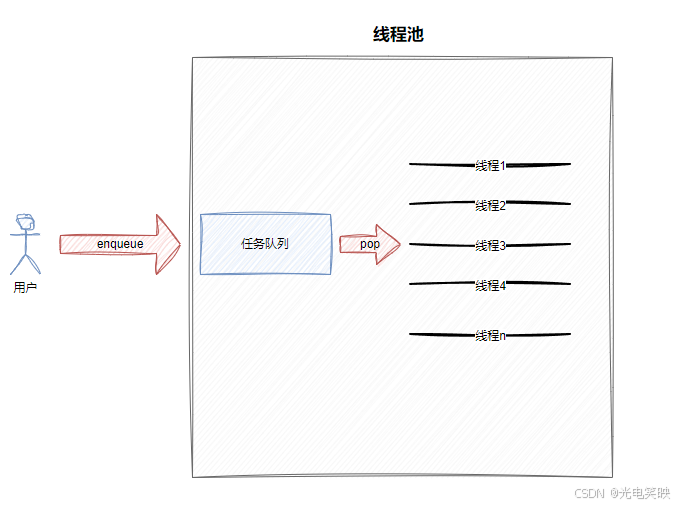
三、模块解耦:回调设计
问题
Thread 是线程封装模块,ThreadPool 是线程池模块。线程池希望线程启动后执行 ThreadPool::HanederTasks(),那么 Thread 怎么调用 ThreadPool 的方法?
解决方案:回调
Thread 的构造函数接受一个 func_t:
using func_t = std::function<void()>;
Thread(func_t func);
我们把 HanederTasks 包装成回调传进去:
_threads.emplace_back(
[this]() // 捕获 this
{
HanederTasks(); // 等价于 this->HanederTasks()
});
为什么解耦?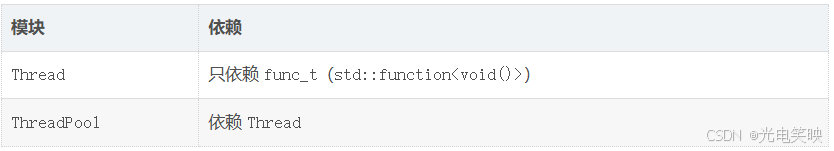
Thread 不需要知道 ThreadPool 长什么样,也不需要接收 ThreadPool* 参数。它只拿到一个 func_t,回调里封装了 this 指针,调用时自然能访问 ThreadPool 的成员。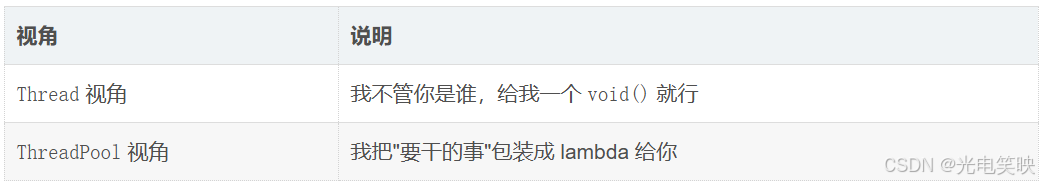
两个模块通过"回调"这个中间层通信,而不是直接互相依赖。
这就是"模块调用转化为类与类的关系,用回调实现"的含义——依赖接口,不依赖具体实现。
四、核心代码
ThreadPool.hpp
#pragma once
#include "Mutex.hpp"
#include "Thread.hpp"
#include "Log.hpp"
#include <vector>
#include <queue>
#include "Cond.hpp"
namespace ThreadPoolModule
{
// 这里采用简单的固定数量线程池
static const int gnum = 5;
template <class T>
class ThreadPool
{
public:
ThreadPool(int num = gnum)
: _num(num), _isrunning(false), _sleepnum(0)
{
for (int i = 0; i < _num; i++)
{
_threads.emplace_back(
[this]() // 设置回调函数
{
HanederTasks();
});
}
}
void HanederTasks() // 处理任务模块
{
// for debug
// char namebuff[128];
// pthread_getname_np(pthread_self(), namebuff, sizeof(namebuff));
// while (true)
// {
// LOG(LogModule::LogLevel::DEBUG) << namebuff <<"thread is running";
// sleep(1);
// }
char namebuff[128];
pthread_getname_np(pthread_self(), namebuff, sizeof(namebuff));
while (true)
{
T task;
{
MutexModule::LockGuard guard(_mutex);
while (_taskq.empty() && _isrunning)
{
_sleepnum++;
_cond.Wait(_mutex);
_sleepnum–;
}
// 线程被唤醒
if (!_isrunning && _taskq.empty())
{
LOG(LogModule::LogLevel::INFO) << namebuff << " 退出了,线程池退出&&任务队列为空";
break; // 线程池退出条件:queue里面已经没有任务了即队列为空同时_isrunning为false
}
// 一定有任务,即任务队列不为空
// T task = _taskq.front();
task = _taskq.front();
_taskq.pop();
// task(); // 处理任务
// 处理任务不需要在临界区里面处理,因为获取任务后,这个任务已经是线程私有的
}
task(); // 临界区外处理
// 把锁的范围缩到"只保护取任务",取出后立刻解锁,任务在锁外执行。这样多个线程可以同时执行任务,真正的耗时工作在锁外并行,这就是线程池高效的核心。
}
}
void Start()
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning)
return;
_isrunning = true;
for (auto &thread : _threads)
{
thread.Start();
}
}
void Stop()
{
MutexModule::LockGuard guard(_mutex);
if (!_isrunning)
return;
_isrunning = false;
WakeUpAllThreads();
}
~ThreadPool()
{
Stop();
Join();
}
ThreadPool(const ThreadPool &) = delete;
ThreadPool &operator=(const ThreadPool &) = delete; // 同时禁止浅拷贝
int Join()
{
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning)
return -1;
}
int count = 0;
if (_isrunning)
return -1;
for (auto &thread : _threads)
{
if (thread.Join(nullptr))
{
count++;
}
}
return count;
}
bool Enqueue(const T &in)
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning) // 当把线程关闭后,就不允许进入新任务了,此时应该要处理剩余的任务
{
_taskq.push(in);
if (_sleepnum > 0)
WakeUpOneThread();
return true;
}
return false;
}
private:
int _num; // 线程数量
std::vector<ThreadModule::Thread> _threads;
MutexModule::Mutex _mutex;
CondModule::Cond _cond;
std::queue<T> _taskq; // 任务队列
bool _isrunning;
int _sleepnum; // 当前休眠线程数
// WakeUpAllThreads 的作用是:Stop() 只改了标志位,但线程还在 _cond.Wait() 里睡觉,不知道要退出。
// 必须用 Broadcast 把所有线程唤醒,它们才能醒来检查退出条件并退出。没有这个函数,线程池就退不掉。
void WakeUpAllThreads()
{
if (_sleepnum > 0)
{
_cond.Broadcast();
LOG(LogModule::LogLevel::INFO) << "唤醒所有休眠线程";
}
}
void WakeUpOneThread()
{
_cond.Signal();
LOG(LogModule::LogLevel::INFO) << "唤醒一个休眠线程";
}
};
}
Main.cc
#include "ThreadPool.hpp"
#include "Task.hpp"
// int main()
// {
// Enable_Console_Log_Strategy();
// ThreadPoolModule::ThreadPool<int>*tp =new ThreadPoolModule::ThreadPool<int>();
// tp->Start();
// sleep(100);
// return 0;
// }
int main()
{
Enable_Console_Log_Strategy();
ThreadPoolModule::ThreadPool<task_t> *tp = new ThreadPoolModule::ThreadPool<task_t>();
tp->Start();
int cnt = 10;
while (cnt–)
{
tp->Enqueue(Download);
}
tp->Stop();
tp->Join();
return 0;
}
为了减小篇幅其他模块如Mutex.hpp等可以在这个链接下查看:
module8/ThreadPool · 光电笑映/Linux – 码云 – 开源中国 https://gitee.com/xuquanquan3376259230/linux/tree/master/module8/ThreadPool
五、关键设计点
1. 循环条件:什么时候等待?
while (_taskq.empty() && _isrunning)
{
_cond.Wait(_mutex);
}
线程只有在同时满足以下两个条件时才继续等待: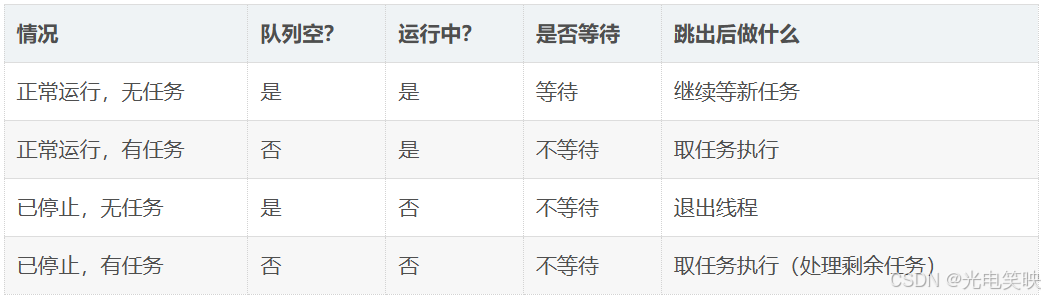
只要任意一个条件不成立,就跳出等待。
2. Stop() 必须唤醒线程
void Stop()
{
MutexModule::LockGuard guard(_mutex);
if (!_isrunning)
return;
_isrunning = false;
WakeUpAllThreads(); // ← 关键:唤醒所有休眠线程
}
Stop() 只改标志位,但线程还在 _cond.Wait() 里睡觉,不知道要退出。必须用 Broadcast 唤醒它们,才能检查退出条件。
3. 锁的位置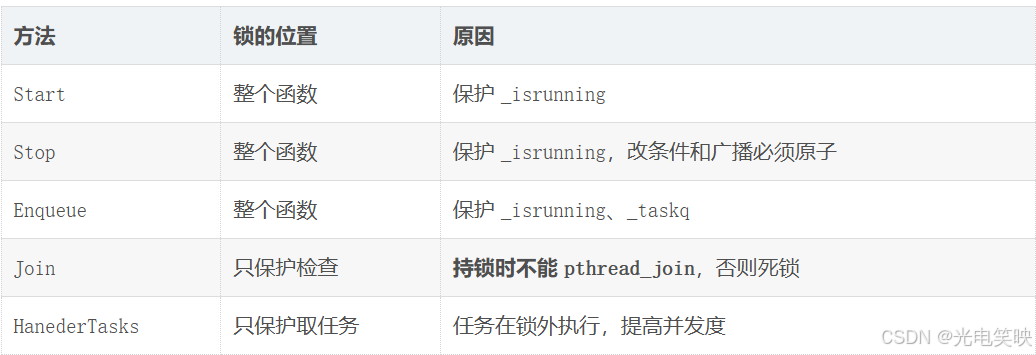
4. Join() 为什么不能持锁?
int Join()
{
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning)
return -1;
} // ← 先解锁
for (auto &thread : _threads)
{
thread.Join(nullptr); // 不持锁,工作线程可以拿锁退出
}
}
如果持锁 pthread_join:
主线程:持有 _mutex,等线程退出
工作线程:想拿 _mutex 才能退出
↓
互相等 → 死锁
先解锁再 join,工作线程能顺利拿到锁退出。
5. 唤醒条件
if (_sleepnum > 0) // 只要有线程在睡,就唤醒
WakeUpOneThread();
不能写成 _sleepnum == _threads.size()——线程还没全部进入等待时,条件不成立,任务会堆到 Stop() 才批量处理,响应不及时。
六、Debug 方式
在另一个终端持续监控线程:
while :; do ps -aL; sleep 1; done
初始阶段:6 个 LWP(1 主线程 + 5 工作线程)
PID LWP TTY CMD
815883 815883 pts/0 test ← 主线程
815883 815884 pts/0 test ← 工作线程 1
815883 815885 pts/0 test ← 工作线程 2
815883 815886 pts/0 test ← 工作线程 3
815883 815887 pts/0 test ← 工作线程 4
815883 815888 pts/0 test ← 工作线程 5
调用 Stop() 后:线程逐个消失
PID LWP TTY CMD
815883 815883 pts/0 test ← 只剩主线程
七、运行结果
[2026-09-12 23:06:05] [INFO] [827757] [Thread.hpp] [54] – thread – 1 create success
[2026-09-12 23:06:05] [INFO] [827757] [Thread.hpp] [54] – thread – 2 create success
[2026-09-12 23:06:05] [INFO] [827757] [Thread.hpp] [54] – thread – 3 create success
[2026-09-12 23:06:05] [INFO] [827757] [Thread.hpp] [54] – thread – 4 create success
[2026-09-12 23:06:05] [INFO] [827757] [Thread.hpp] [54] – thread – 5 create success
[2026-09-12 23:06:05] [DEBUG] [827757] [Task.hpp] [11] – 我是一个下载任务…
(10 条任务日志)
[2026-09-12 23:06:05] [INFO] [827757] [ThreadPool.hpp] [58] – test 退出了,线程池退出&&任务队列为空
(5 条退出日志)
[2026-09-12 23:06:05] [INFO] [827757] [Thread.hpp] [94] – pthread_join success
(5 条 join 日志)
结果分析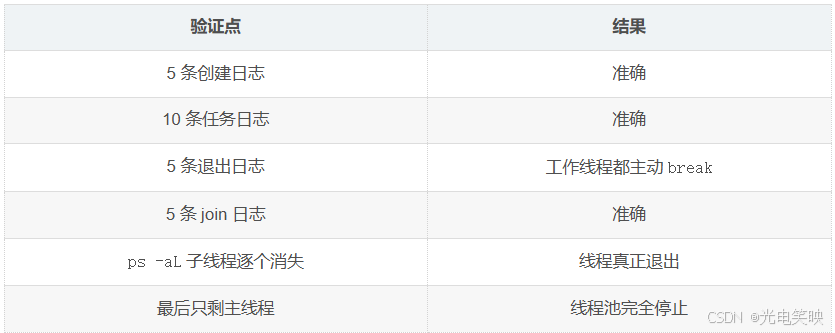
八、总结
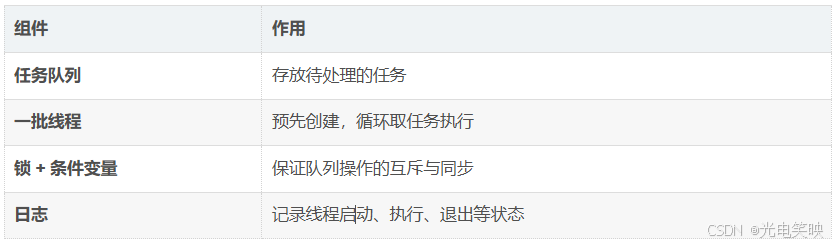
线程池是"一批线程 + 一个任务队列 + 同步机制"的组合。预先创建一批线程,循环从任务队列取任务执行,避免频繁创建销毁线程的开销。
关键设计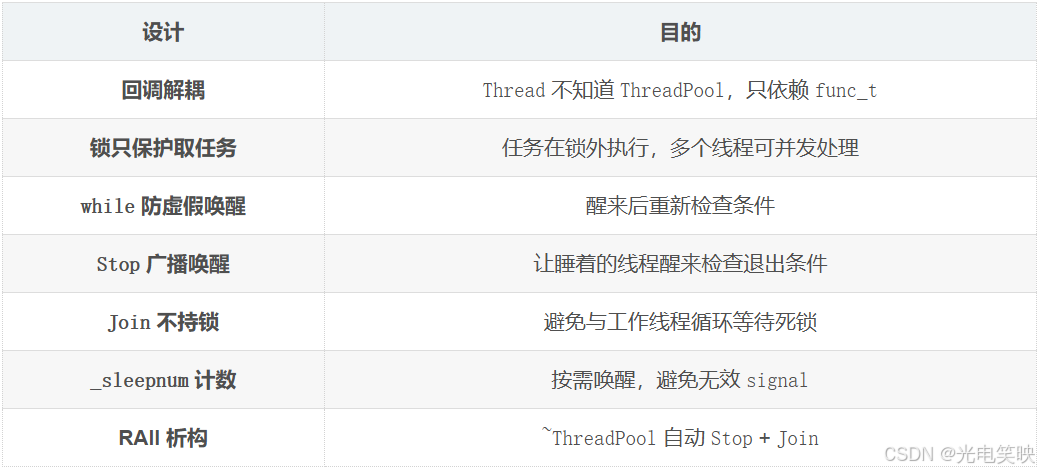
线程池通过固定数量的工作线程 + 共享任务队列 + 锁和条件变量,实现了任务的异步并发处理。Thread 和 ThreadPool 通过回调彻底解耦,Stop 通过广播唤醒所有线程优雅退出,Join 通过先解锁再 join 避免死锁。整个设计把"创建线程""任务分发""同步控制""优雅退出"四件事清晰地分离开来。
3-3 线程安全的单例模式
3-3-1 什么是单例模式
单例模式:某些类只应该具有一个对象(实例),就称之为单例。
比如一个男人只能有一个媳妇。
应用场景:用来定义一些属于公共部分的对象,这类对象体积往往很大,希望在内存中只创建一次,不重复创建。
很多服务器开发场景中,经常需要让服务器加载很多数据(上百 G)到内存中,此时往往要用一个单例来管理这些数据。
如何实现单例?
实现一个"不能创建对象"的类有很多做法:
| 构造函数私有 | 外部无法直接构造 |
| 禁用拷贝构造 | 禁止通过拷贝创建 |
| 禁用赋值 | 禁止通过赋值创建 |
这样类就不能被外部创建对象了。那怎么创建一个对象呢?
在类内以静态方式创建对象,用静态成员创建一个单例。
3-3-2 单例模式的特点
| 唯一性 | 全进程只有一个实例 |
| 全局访问 | 通过一个静态接口获取 |
| 禁止拷贝 | 不能拷贝、不能赋值 |
| 延迟或提前创建 | 饿汉或懒汉 |
3-3-3 饿汉实现方式
生活类比:洗碗
| 饿汉 | 吃完饭立刻洗碗,下一顿直接拿碗吃饭 |
| 懒汉 | 吃完饭先把碗放下,下一顿用到碗时再洗 |
饿汉 = 提前创建;懒汉 = 延迟创建。
代码实现
template <typename T>
class Singleton
{
private:
static T data; // 静态成员:类加载时就创建
Singleton() {}
Singleton(const Singleton&) = delete;
Singleton& operator=(const Singleton&) = delete;
public:
static T* GetInstance()
{
return &data;
}
};
为什么类加载时就创建了对象?
关键在于 static 的存储位置和生命周期: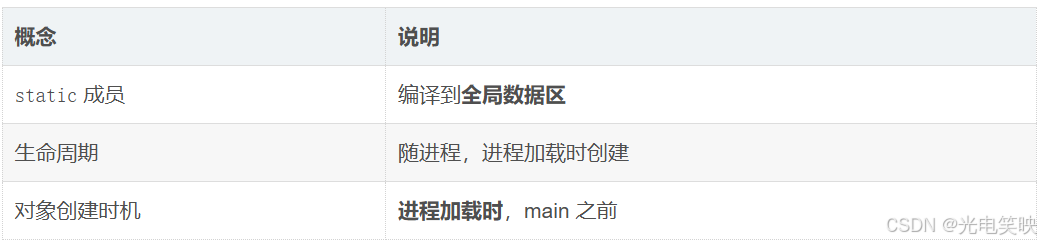
static 修饰局部变量时,作用域不变,但生命周期变为全局;修饰全局变量时,在进程地址空间的全局数据区开辟。进程加载时,代码区和全局数据区直接创建;堆区和栈区是程序运行期间才创建的。所以 static 成员变量在进程加载时就创建出来了。
这就是饿汉模式的本质:代码编译好、加载到内存时,对象就已经存在了,访问时直接用,不用创建。
总结
只要通过 Singleton 这个包装类使用 T 对象,则一个进程中只有一个 T 对象的实例。
缺陷
| 启动慢 | 类体积大时,加载时要创建和初始化静态变量,load 时间长 |
| 可能浪费 | 如果一直没用到,白创建了 |
除非单例体积不大,否则不太常用。
3-3-4 懒汉实现方式
核心思想:延时加载
懒汉方式最核心的思想是 "延时加载":
-
真正调用 GetInstance 时才创建对象
-
调用这个函数时,程序一定已经运行起来了
-
需要时才创建,优化服务器启动速度
这种思想在 new/malloc 的延迟申请空间方案里也有体现。
代码实现
template <typename T>
class Singleton
{
private:
Singleton() {}
static T* inst; // 只定义指针,体积小(4/8 字节),加载快
Singleton(const Singleton&) = delete;
Singleton& operator=(const Singleton&) = delete;
public:
static T* GetInstance()
{
if (inst == NULL)
{
inst = new T();
}
return inst;
}
};
执行过程
第一次调用 GetInstance:
inst == NULL → 创建对象 → inst 覆盖为对象地址
第二次调用 GetInstance:
inst != NULL → 直接返回,不再创建
创建单例的两个条件
为什么 new 能调用私有构造?
GetInstance 是类内静态方法,可以访问类的私有成员,包括私有构造函数。所以 new T() 在类内调用是合法的。
饿汉 vs 懒汉对比
new/malloc 的类比
就像 vector 扩容后不会立即填入数据,new/malloc 申请了空间也不一定立即使用。申请空间和使用空间存在时间差——已经有空间了,但暂时不用,别人也用不了。这就是"提前创建"的缺陷。
3-3-5 懒汉方式(线程安全问题)
问题:线程不安全
static T* GetInstance()
{
if (inst == NULL) // ← 多线程同时判断,可能都进来
{
inst = new T(); // ← 创建了多份实例
}
return inst;
}
场景
线程 A:判断 inst == NULL → 是
线程 B:判断 inst == NULL → 是(A 还没创建完)
线程 A:inst = new T() → 创建实例 1
线程 B:inst = new T() → 创建实例 2
创建了两份实例,单例被破坏。
注意:只有第一次调用时有问题。后续 inst 不为空,就不会再创建。
根源
static T* inst; 是类的静态成员,所有线程共享:
| 读(检查是否为空) | 所有调用者 |
| 写(创建实例) | 第一个发现的线程 |
多个线程读 + 至少一个写 → 数据竞争 → 必须加锁。
为什么要保证单例只创建一次?
因为线程池是 "一个"共享资源,不是每个线程一个:
调用者 A ─┐
调用者 B ─┼─→ 同一个线程池 → 共享队列 → 同一批工作线程
调用者 C ─┘
加锁保证:只有一个线程池被创建出来,所有调用线程共享它。
3-3-6 懒汉方式(线程安全版本)
问题:锁本身怎么来?
单例是为了创建线程池,创建时线程池对象还不存在,那么它的成员锁也不存在。
所以锁必须是 static 的——它属于类,不依赖对象。
代码实现
template <typename T>
class Singleton
{
private:
volatile static T* inst; // 需要 volatile 防止过度优化
static std::mutex lock; // 锁必须是静态的
Singleton() {}
Singleton(const Singleton&) = delete;
Singleton& operator=(const Singleton&) = delete;
public:
static T* GetInstance()
{
if (inst == NULL) // 第一次检查(无锁)
{
lock.lock(); // 加锁
if (inst == NULL) // 第二次检查(锁内)
{
inst = new T();
}
lock.unlock();
}
return inst;
}
};
三个注意事项
为什么需要双重检查?
| 第一次调用 | 有意义,保护创建 |
| 后续调用 | 无意义,实例已存在,只是读一下 |
全加锁版本能工作,但第一次之后每次调用都白白加锁解锁,降低效率。
优化方式:
| 双重检查锁(DCL) | 已创建后走无锁路径 |
| C++11 局部静态变量 | 编译器自动保证线程安全,代码最简洁,最推荐 |
为什么 volatile?
new T() 分三步:
① 分配内存
② 调用构造函数
③ 把地址赋给 inst
编译器和 CPU 可能重排 ②③。多线程下,别的线程可能拿到"指针有效但对象没构造完"的实例,访问就崩溃。
volatile 防止指令重排。
C++11 后更推荐 std::atomic,从编译器层面和 CPU 层面都保证正确。
更推荐的方案:C++11 局部静态变量
static Singleton& GetInstance()
{
static Singleton instance; // C++11 保证线程安全
return instance;
}
| 线程安全 | C++11 标准保证 |
| 延迟加载 | 首次调用才创建 |
| 代码简洁 | 不用锁、不用双检 |
| 自动析构 | 程序结束自动析构 |
| 已创建后无锁 | 无额外开销 |
3-4 单例式线程池
使用单例模式是否合理?
在线程池中,是合理的:
-
不能让线程池过多——创建一个线程池对象就包含了若干个线程
-
所有调用者应该共享同一个线程池
核心设计
获取接口
static ThreadPool<T>* GetThreadPoolInstance()
{
if (instance == nullptr) // 第一次检查
{
MutexModule::LockGuard guard(mutex);
if (instance == nullptr) // 第二次检查
{
instance = new ThreadPool<T>();
instance->Start();
}
}
return instance;
}
静态成员类外定义
template <class T>
ThreadPool<T>* ThreadPool<T>::instance = nullptr;
template <class T>
MutexModule::Mutex ThreadPool<T>::mutex;
类内 static Mutex mutex; 只是声明,必须在类外定义。定义时自动调用默认构造函数,不需要手动初始化。只有构造函数需要参数时,才要显式传参。C++17 用 inline static 可以在类内直接定义,更简洁。
总结
单例的三种实现
单例模式保证一个类只有一个实例,并提供全局访问点。饿汉在进程加载时创建,启动慢但线程安全;懒汉首次使用时创建,启动快但需处理线程安全问题。最推荐的写法是 C++11 局部静态变量——线程安全、延迟加载、代码简洁、自动析构,一举多得。线程池是单例的典型应用:所有调用者共享同一个线程池,用单例保证只创建一次。
ThreadPoolSingleton.hpp
#pragma once
#include "Mutex.hpp"
#include "Thread.hpp"
#include "Log.hpp"
#include <vector>
#include <queue>
#include "Cond.hpp"
#include <cstdlib>
namespace ThreadPoolSingletonModule
{
static const int gnum = 5;
template <class T>
class ThreadPool
{
private:
////////////////////1.私有化构造函数//////////////////
// 这个函数还是要有的因为单例模式毕竟还是有一个对象
ThreadPool(int num = gnum)
: _num(num), _isrunning(false), _sleepnum(0)
{
for (int i = 0; i < _num; i++)
{
_threads.emplace_back(
[this]()
{
HanederTasks();
});
}
}
void Start()
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning)
return;
_isrunning = true;
for (auto &thread : _threads)
{
thread.Start();
}
}
void HanederTasks()
{
char namebuff[128];
pthread_getname_np(pthread_self(), namebuff, sizeof(namebuff));
while (true)
{
T task;
{
MutexModule::LockGuard guard(_mutex);
while (_taskq.empty() && _isrunning)
{
_sleepnum++;
_cond.Wait(_mutex);
_sleepnum–;
}
if (!_isrunning && _taskq.empty())
{
LOG(LogModule::LogLevel::INFO) << namebuff << " 退出了,线程池退出&&任务队列为空";
break;
}
task = _taskq.front();
_taskq.pop();
}
task();
}
}
public:
void Stop()
{
MutexModule::LockGuard guard(_mutex);
if (!_isrunning)
return;
_isrunning = false;
WakeUpAllThreads();
}
~ThreadPool()
{
}
/////////////////2.不允许拷贝或者赋值///////////////
ThreadPool(const ThreadPool &) = delete;
ThreadPool &operator=(const ThreadPool &) = delete; // 同时禁止浅拷贝
int Join()
{
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning)
return -1;
}
int count = 0;
for (auto &thread : _threads)
{
if (thread.Join(nullptr))
{
count++;
}
}
return count;
}
bool Enqueue(const T &in)
{
MutexModule::LockGuard guard(_mutex);
if (_isrunning)
{
_taskq.push(in);
if (_sleepnum > 0)
WakeUpOneThread();
return true;
}
return false;
}
//////////////////////4.获取单例函数接口///////////////////////
// 没有static时,这个接口是类内成员函数,要访问就要有对象才可以访问,
// 但是我们将构造函数私有化后创建不了对象啊,所以我们要将这个函数设置成静态成员函数
// 这样就可以不创建对象情况下直接用,因为函数属于类,所以直接就可以访问到类内静态成员变量
static ThreadPool<T> *GetThreadPoolInstance()
{
// ①全锁版本,第一次创建时没问题,但后续获取时没必要加锁了
// MutexModule::LockGuard guard(mutex);
// if (instance == nullptr) // 没有实例就创建实例
// {
// LOG(LogModule::LogLevel::DEBUG) << "首次创建单例";
// instance = new ThreadPool<T>();
// instance->Start(); // 启动线程池
// }
// ②双重检查锁
if (instance == nullptr)
{
MutexModule::LockGuard guard(mutex);
LOG(LogModule::LogLevel::DEBUG) << "获取单例";
if (instance == nullptr) // 没有实例就创建实例
{
LOG(LogModule::LogLevel::DEBUG) << "首次创建单例";
instance = new ThreadPool<T>();
instance->Start(); // 启动线程池
atexit([]()
{ instance->Stop(); instance->Join(); }); // atexit 是 C/C++ 标准库函数,用于注册程序正常退出时要执行的回调函数。
// 原型: #include <cstdlib>
// int atexit(void (*func)(void)); 程序正常退出时(return、exit()、main 结束),会逆序调用所有通过 atexit 注册的函数。
}
}
return instance;
}
private:
int _num;
std::vector<ThreadModule::Thread> _threads;
MutexModule::Mutex _mutex;
CondModule::Cond _cond;
std::queue<T> _taskq;
bool _isrunning;
int _sleepnum;
///////3.static单例指针/////////
static ThreadPool<T> *instance;
// C++17 开始,静态成员可以在类内直接用 inline 定义:
// inline static ThreadPool<T>* instance = nullptr; // C++17
/////5.我们已经有一个单例了,如果线程池本身会被多线程获取呢?//////
static MutexModule::Mutex mutex;
void WakeUpAllThreads()
{
if (_sleepnum > 0)
{
_cond.Broadcast();
LOG(LogModule::LogLevel::INFO) << "唤醒所有休眠线程";
}
}
void WakeUpOneThread()
{
_cond.Signal();
LOG(LogModule::LogLevel::INFO) << "唤醒一个休眠线程";
}
};
///////// 3.类内静态成员要在类外初始化/////////////
template <class T>
ThreadPool<T> *ThreadPool<T>::instance = nullptr;
////////5.类内 static Mutex mutex; 只是声明,必须在类外定义。/////////////
// 这里定义会自动调用默认构造函数,不需要手动初始化。只有构造函数需要参数时,才要显式传参。
// C++17 用 inline static 可以在类内直接定义,更简洁。
template <class T>
MutexModule::Mutex ThreadPool<T>::mutex;
}
Main.cc
#include "ThreadPoolSingleton.hpp"
#include "Task.hpp"
int main()
{
Enable_Console_Log_Strategy();
// 不能构造
// ThreadPoolSingletonModule::ThreadPool<task_t> tp;
// error: ‘ThreadPoolSingletonModule::ThreadPool<T>::ThreadPool(int) [with T = std::function<void()>]’ is private within this context
// 5 | ThreadPoolSingletonModule::ThreadPool<task_t> tp;
// 不能拷贝构造
// ThreadPoolSingletonModule::ThreadPool<task_t>tp2=tp;
// error: use of deleted function ‘ThreadPoolSingletonModule::ThreadPool<T>::ThreadPool(const ThreadPoolSingletonModule::ThreadPool<T>&) [with T = std::function<void()>]’
// 9 | ThreadPoolSingletonModule::ThreadPool<task_t>tp2=tp;
ThreadPoolSingletonModule::ThreadPool<task_t>*p= ThreadPoolSingletonModule::ThreadPool<task_t>::GetThreadPoolInstance();
int cnt = 10;
while (cnt–)
{
p->Enqueue(Download);
sleep(1);
}
// p->Stop();
// ThreadPoolSingletonModule::ThreadPool<task_t>::GetThreadPoolInstance()->Join();
//等价的,用atexit就自动调用了
return 0;
}
4. 线程安全和重入问题
4-1 概念
线程安全
就是多个线程在访问共享资源时,能够正确地执行,不会相互干扰或破坏彼此的执行结果。
一般而言,多个线程并发同一段只有局部变量的代码时,不会出现不同的结果。但是对全局变量或者静态变量进行操作,并且没有锁保护的情况下,容易出现该问题。
重入
同一个函数被不同的执行流调用,当前一个流程还没有执行完,就有其他的执行流再次进入,我们称之为重入。
一个函数在重入的情况下,运行结果不会出现任何不同或者任何问题,则该函数被称为可重入函数,否则,是不可重入函数。
4-2 重入的两种情况
学到现在,其实我们已经能理解重入可以分为两种情况:
4-3 常见情况汇总

4-4 可重入与线程安全的联系
重入和线程安全其实是一个硬币的两面,侧重点不同:
-
线程安全表示线程本身的健康或者安全状态
-
重入描述的是函数的特征
是看待不同问题的角度罢了。

4-5 可重入与线程安全的区别
核心结论
可重入函数是线程安全函数的一种。
线程安全不一定是可重入的,而可重入函数则一定是线程安全的。
经典例子:GetThreadPoolInstance
我们之前的 GetThreadPoolInstance 函数就是"线程安全但不可重入"的典型:
场景:信号导致重入死锁
为什么是线程安全的?
多个线程同时调用 GetThreadPoolInstance,锁会保证只有一个线程能进入临界区创建单例,其他线程会阻塞在锁上等待,不会出现实例被创建多次的问题。所以多线程环境下它是安全的。
为什么不是可重入的?
信号处理函数重入时,锁已被自己持有,再次申请会死锁。
总结
如果将对临界资源的访问加上锁,则这个函数是线程安全的,但如果这个重入函数若锁还未释放则会产生死锁,因此是不可重入的。
4-6 总结
如果不考虑"信号导致重入"这种情况
线程安全和重入在安全角度不做区分。但它们的侧重点不同:
可重入函数一定是线程安全的,线程安全函数不一定是可重入的。GetThreadPoolInstance 用锁保证了多线程安全,但在信号重入时会自己把自己锁死——这是"线程安全但不可重入"的经典案例。加锁让函数线程安全,却让它不可重入;不加锁让它可重入,却可能线程不安全。 两者的取舍,取决于具体场景。
5. 常见锁概念
5-1 死锁
先讲一个故事
小胖和小瘦去商店买零食,各自带了 5 元,想买薯片,但薯片要 10 元。
-
小胖对小瘦说:"我现在有 5 元,把你的 5 元给我,就可以买一包薯片了。"
-
小瘦对小胖说:"我也有 5 元,把你的 5 元给我,我也可以买。"
在老板看来,就是两个小孩互相持有自己的 5 元,不释放,却不断申请对方的 5 元——你不给我就不买,双方一直竞争对方的资源,最后死锁了。
| 小胖、小瘦 | 线程 A、线程 B |
| 薯片 | 临界资源 |
| 各自的 5 元 | 各自持有的锁 1、锁 2 |
| 想买薯片 | 必须同时持有锁 1 和锁 2 |
死锁的定义
死锁是指在一组进程中的各个进程均占有不会释放的资源,但因互相申请被其他进程所占用、不会释放的资源,而处于的一种永久等待状态。
假设现在线程 A、线程 B 必须同时持有锁 1 和锁 2,才能进行后续资源的访问。
申请一把锁是原子的,但申请两把锁就不一定了。
结果就是:
死锁的四个必要条件
图解
请求与保持条件
不剥夺条件
循环等待条件
四个条件同时满足,才会死锁。破坏任意一个,死锁不成立。
5-2 避免死锁
破坏四个必要条件
死锁避免算法(了解)
6. STL、智能指针和线程安全
6-1 STL 中的容器是线程安全的吗?
不是。 默认都是单线程访问 STL 容器。
原因:
-
STL 的设计初衷是将性能挖掘到极致
-
一旦涉及加锁保证线程安全,会对性能造成巨大影响
-
对于不同的容器,加锁方式不同,性能可能也不同(例如 hash 表的锁表和锁桶)
因此 STL 默认不是线程安全的。如果需要在多线程环境下使用,往往需要调用者自行保证线程安全。
6-2 智能指针是否是线程安全的?
注意:unique_ptr 本身没有线程安全问题,不代表它指向的对象没有。
对于 shared_ptr:
-
多个对象需要共用一个引用计数变量,所以存在线程安全问题
-
但标准库实现时考虑到了这个问题,基于原子操作(CAS)保证 shared_ptr 能高效、原子地操作引用计数
7. 其他常见的各种锁
CAS 操作
当需要更新数据时,判断当前内存值和之前取得的值是否相等:
-
如果相等,则用新值更新
-
若不等,则失败
-
失败则重试,一般是一个自旋的过程,即不断重试
悲观锁 vs 乐观锁
总结
死锁的根源是"互相持有、互相申请",四个条件同时满足才会发生。STL 为了性能默认不加锁,shared_ptr 的引用计数用 CAS 保证原子,unique_ptr 本身无并发问题。悲观锁先锁后做,乐观锁先做后验证。理解这些,才能在实际工程中写出既高效又安全的并发代码。