Apache Airflow 动态 DAG 生成模式深度实战:从配置驱动反模式到基于 Jinja2 预编译模板工厂的架构演进
在大型企业数仓建设与数据集成中枢(Data Integration Platform)中,数据工程团队常常面临需要接入 上千张业务数据库表、数百个第三方 SaaS API 的海量搬砖场景。
面对成百上千个结构高度相似的“抽取(Extract)➔ 清洗(Transform)➔ 入湖(Load)”流水线,传统的开发模式暴露出了巨大的工程瓶颈:
- 手工复制粘贴数百个 .py 脚本的代码维护地狱:修改一个公共重试参数或脱敏逻辑,需要批量修改 500 个独立的文件,极易产生遗漏与配置不一致;
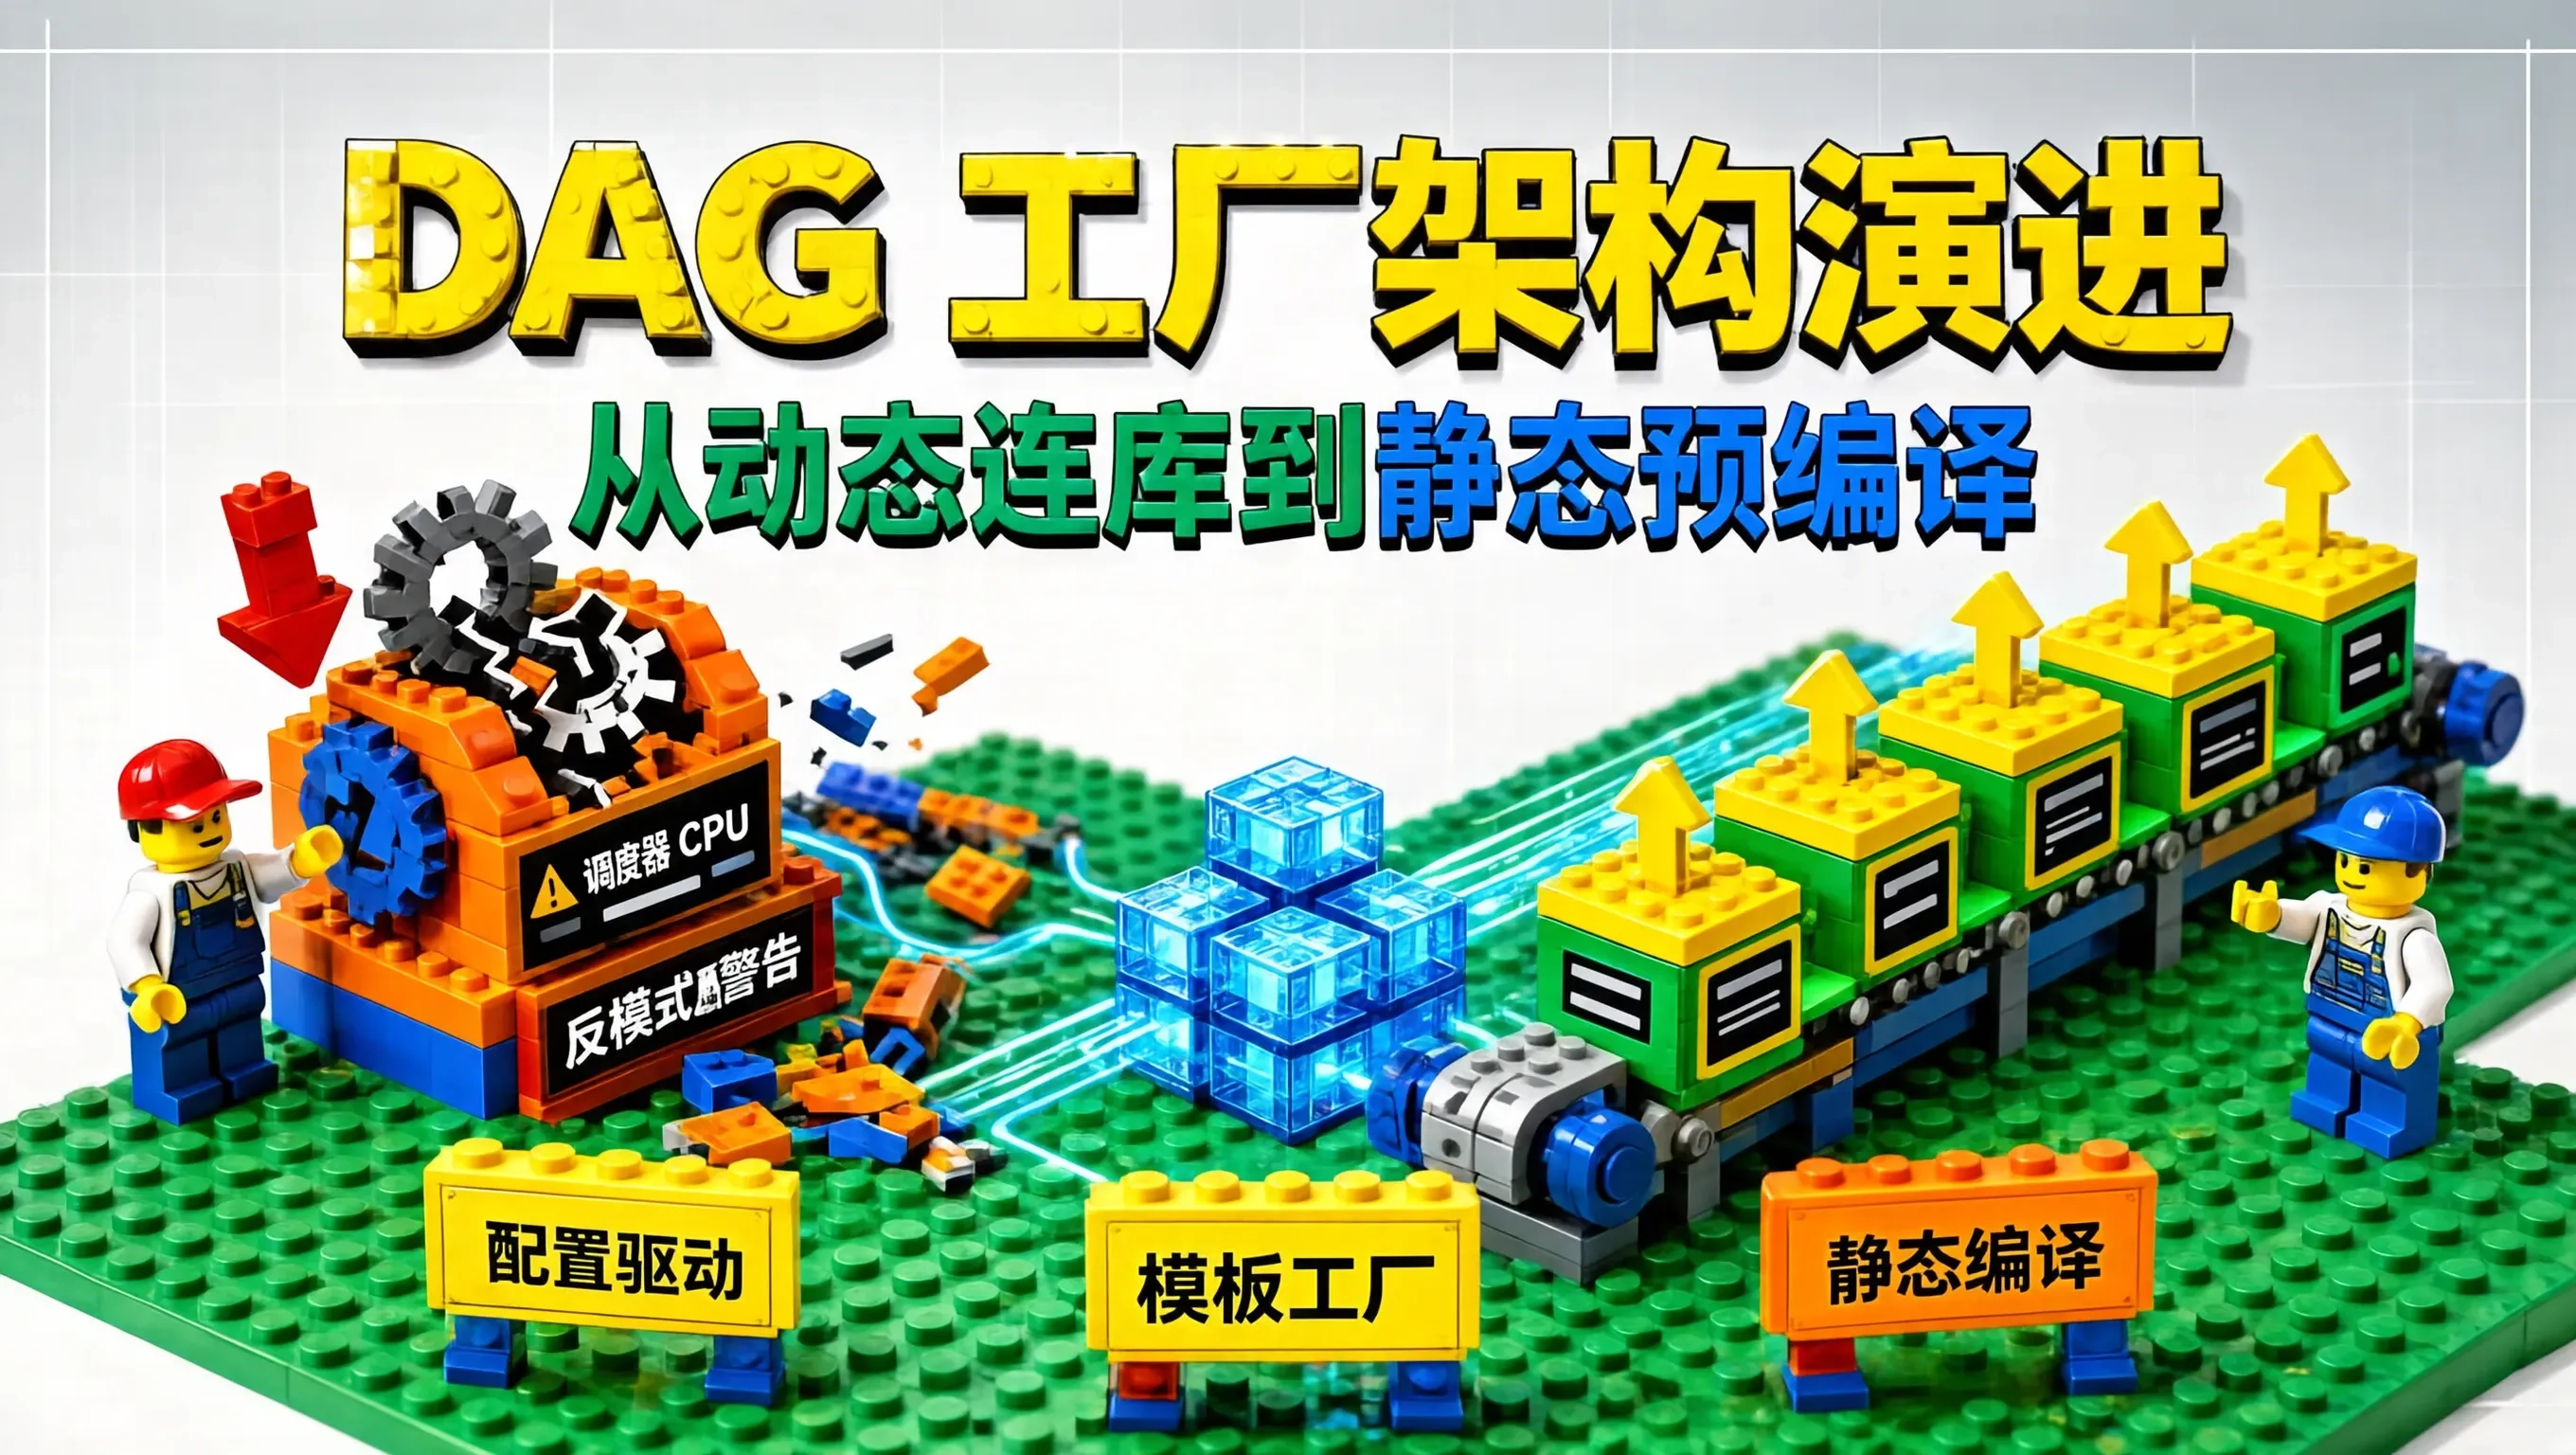
- 致命的反模式:顶层动态连库生成 DAG(Top-Level DB Query):许多开发者自作聪明地在 DAG 脚本顶层写下 for table in db.query("SELECT * FROM t_source_tables") 动态创建 DAG。结果,Airflow 调度器(Scheduler)在每隔几秒的轮询解析中,成百上千个工作进程同时向元数据库发起几十万次高频查询,直接将 MySQL 打爆,并导致调度器 CPU 持续 100% 卡死!
如何优雅、安全地实现 DAG 的动态自动化生成?配置驱动工厂(DAG Factory) 与 基于 Jinja2 的 CI/CD 静态预编译生成模式 如何彻底化解调度器解析开销?
本文深度剖析 Airflow 顶层解析机理、三大动态 DAG 模式对比,并给出生产级 YAML 配置驱动与 Jinja2 代码自动生成工厂实战。
一、三大动态 DAG 生成模式全景对比矩阵
| 1. 顶层连库动态循环 (Top-Level DB Query) | 在 Python 顶层直接发起 DB/API 请求动态生成 | ❌ 极其致命(调度器 CPU 100% 暴涨,DB 被打崩) | 极高 | ❌ 严禁在生产中使用的严重反模式 |
| 2. 本地 YAML 配置文件工厂 (DAG Factory) | 调度器解析时读取本地静态 YAML 配置文件动态组装 | 中等(需解析本地文件,无外部网络 I/O) | 较高(修改 YAML 即刻生效) | 中小型团队(DAG 数量 $\\le 300$) |
| 3. CI/CD 静态预编译生成 (Jinja2 Template Engine – 黄金标准) | 在 Git Commit / CI 阶段通过模板引擎批量编译生成纯静态 .py 文件 | ✅ 极低(调度器纯静态加载,解析耗时 $\\le 0.05\\text{s}$) | 最高(享受 Git 版本控制、审查与纯静态解析性能) | 企业级大规模数仓(数千至上万个 DAG)的首选方案 |
二、顶层 DB 解析反模式 vs CI 静态预编译工厂时序对比
[❌ 致命反模式: 顶层连库动态生成 DAG]
Scheduler (每 30 秒轮询)
|
| 1. 执行 Python 脚本顶层代码: `SELECT * FROM meta_tables;`
v
[元数据库 MySQL / API Gateway] (每秒承受成千上万次高频重复打扰,最终被打爆!)
(调度器解析单个 DAG 耗时突破 15 秒,全集群排队卡死!)
=================================================================================
[🌟 推荐标准: 基于 Jinja2 模板与 CI/CD 静态预编译工厂]
[数据工程师修改配置: `tables_config.yaml`]
|
v (Git Push 触发 CI 流水线)
+——————————————————————————-+
| 🌟 CI/CD 代码生成器 (Jinja2 Template Compiler Engine): |
| 1. 读取 YAML 规则列表: 包含 500 张待同步表的元数据 |
| 2. 填充模板 `dag_template.jinja2` |
| 3. 一键编译并生成 500 个轻量、纯静态的 `dag_table_001.py` … `dag_table_500.py` |
| 4. 自动推送并同步至生产 `dags/` 目录 |
+——————————————————————————-+
|
v
[Airflow Scheduler 极速零开销解析]:
直接读取纯静态 Python AST 代码,零数据库请求,零网络 IO,解析耗时从 15s 暴跌至 0.01s!
三、生产级 YAML 配置与 Jinja2 模板化 DAG 工厂实现
1. 业务配置描述文件:pipeline_configs.yaml
# pipeline_configs.yaml: 声明待接入的源表元数据与调度策略
pipelines:
– table_name: "t_order_events"
schedule_interval: "@hourly"
owner: "trade_team"
retries: 3
source_db: "mysql_trade_master"
target_iceberg_table: "lakehouse_prod.dwd.t_order_events"
primary_key: "order_id"
– table_name: "t_user_profiles"
schedule_interval: "@daily"
owner: "user_growth_team"
retries: 2
source_db: "pg_user_master"
target_iceberg_table: "lakehouse_prod.dim.t_user_profiles"
primary_key: "user_id"
2. 标准通用 DAG 模版文件:dag_template.jinja2
# Auto-generated DAG for table: {{ table_name }}
# DO NOT EDIT THIS FILE DIRECTLY! Generated by DAG Factory.
from datetime import datetime, timedelta
import logging
from airflow import DAG
from airflow.operators.python import PythonOperator
default_args = {
'owner': '{{ owner }}',
'depends_on_past': False,
'start_date': datetime(2026, 8, 1),
'retries': {{ retries }},
'retry_delay': timedelta(minutes=3),
}
def execute_ingestion_{{ table_name }}(**context):
logging.info("⚡ [INGESTION] 正在将 {{ source_db }}.{{ table_name }} 同步入湖至 {{ target_iceberg_table }}…")
# 执行基于主键 {{ primary_key }} 的增量数据抽取与校验逻辑
return "SUCCESS"
with DAG(
dag_id='auto_etl_{{ table_name }}',
default_args=default_args,
description='Automated Ingestion Pipeline for {{ table_name }}',
schedule='{{ schedule_interval }}',
catchup=False,
tags=['auto_generated', '{{ owner }}']
) as dag:
ingest_task = PythonOperator(
task_id='sync_to_lakehouse',
python_callable=execute_ingestion_{{ table_name }},
provide_context=True,
)
3. 生产级 Python 预编译编译器:dag_compiler.py
"""
dag_compiler.py
生产级 DAG Factory 预编译编译器:基于 Jinja2 将 YAML 批量转化为静态 Python DAG 脚本
"""
import os
import yaml
from jinja2 import Environment, FileSystemLoader
TEMPLATE_DIR = "./templates"
CONFIG_FILE = "./configs/pipeline_configs.yaml"
OUTPUT_DAG_DIR = "./dags/generated_dags"
def compile_dags_from_yaml():
print("=== 🚀 启动 Airflow DAG Factory 静态预编译流水线 ===")
# 1. 加载 YAML 配置
with open(CONFIG_FILE, 'r', encoding='utf-8') as f:
config_data = yaml.safe_load(f)
pipelines = config_data.get('pipelines', [])
print(f"📖 成功读取配置: 包含 {len(pipelines)} 个数据抽取管线声明。")
# 2. 初始化 Jinja2 模板环境
env = Environment(loader=FileSystemLoader(TEMPLATE_DIR), trim_blocks=True, lstrip_blocks=True)
template = env.get_template("dag_template.jinja2")
os.makedirs(OUTPUT_DAG_DIR, exist_ok=True)
# 3. 批量编译生成静态 Python DAG 脚本
for p in pipelines:
table_name = p['table_name']
rendered_code = template.render(p)
target_file_path = os.path.join(OUTPUT_DAG_DIR, f"dag_auto_{table_name}.py")
with open(target_file_path, 'w', encoding='utf-8') as out_f:
out_f.write(rendered_code)
print(f" * 成功生成静态 DAG 文件: [{target_file_path}]")
print("\\n=======================================================")
print("🎉 🌟 预编译完成!生成的静态 DAG 拥有极速解析性能,彻底消除调度器 CPU 暴涨隐患!")
print("=======================================================")
if __name__ == "__main__":
compile_dags_from_yaml()
四、生产避坑与动态 DAG 治理红线
在生产中实施动态 DAG 工厂模式时,必须坚守以下四项落地原则:
通过彻底告别顶层动态连库的粗放反模式,全面转向“YAML 配置驱动 + Jinja2 模板静态预编译生成”的现代化 DAG 工厂架构,企业数据工程团队能够以极低的维护成本轻松支撑数千张表的自动化调度,同时保障调度器集群在毫秒级内完成极速解析与高并发流转。