NMS 分簇 + OpenCV 几何验证:让一个目标只留一条观测
一、为什么要做这件事
原来的 NMS 是留 top-2 的:通过 conf 排序选出前两个,来进行后续的逻辑。
因为我们要从模型部署的 YOLO 再接入 OpenCV 的几何验证,几何验证需要两个候选去比对。但到了滤波这一步,一次只需要喂一个目标,所以我们需要 NMS 返回分组信息,再加上几何验证,最后才到滤波算法。
NMS 的行为没变化,只是把过程里面已经知道的分组信息返回出来了。
目标很明确:滤波一次只能喂一个目标,一个目标只能有一个观测。如果还和以前一样一个目标有两条,那两个输进去之后就会被当成两个目标,后面的数据处理和输出会非常麻烦。
这个不是 bug,是当初故意留下的 —— 为了保留两个候选,让召回率高一些。
二、原来的 NMS 长什么样
原来的 NMS,输入的是用 lambda 降序排列好的候选表格 dets。
逻辑就是:拿出第一个当簇首,后面凡是和它 IoU 大于阈值的,就算同一个簇。
输出是 vector<int>,只保留返回的下标,但是不分类,不知道是哪个簇的。
也就是说,原来的方法只知道"识别出来的是在第几个位置",但是不知道识别出来的 dets 是哪一个簇、哪一组的。
为什么「只知道留了哪些」不够用?
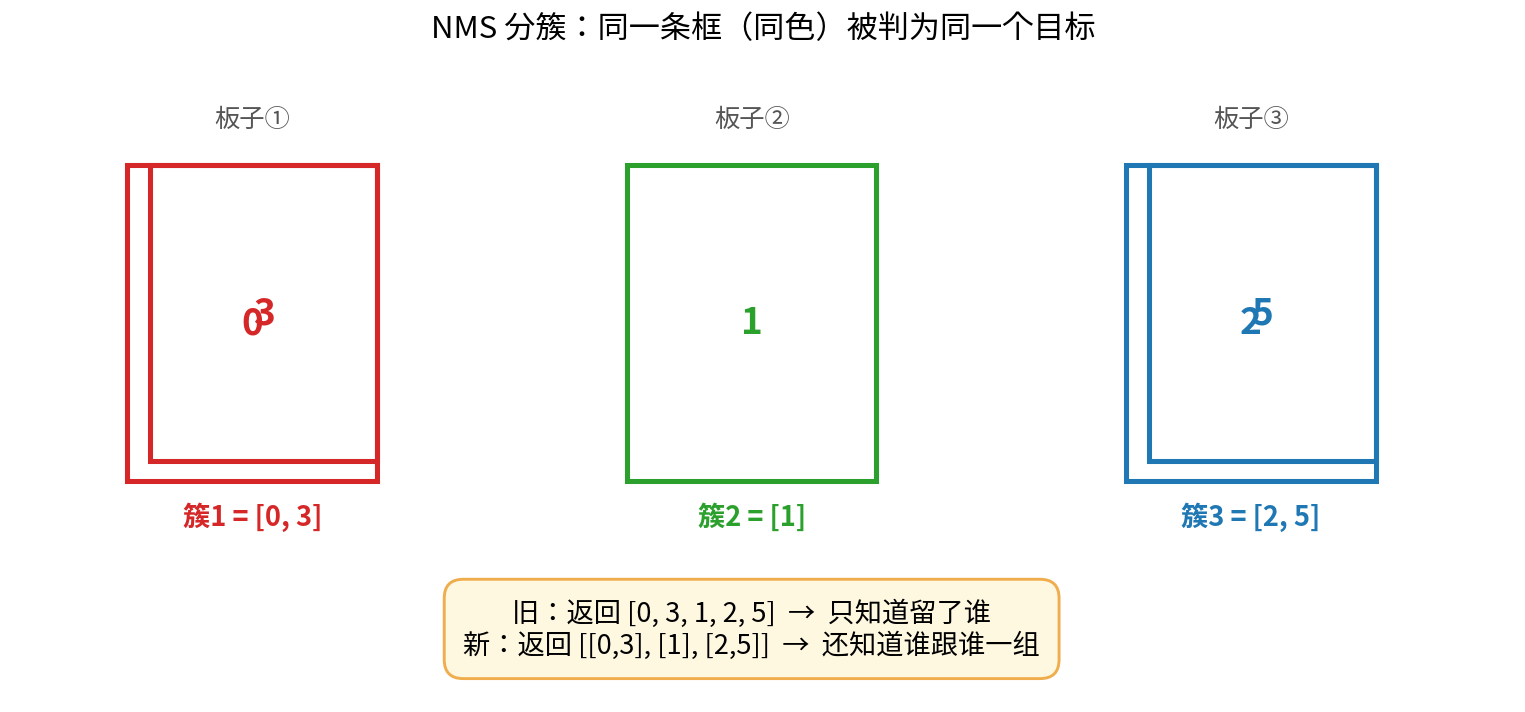
因为下游要做的事是「每一簇挑一个最好的」。如果只拿到一堆扁平的下标,比如 [0, 3, 1, 2, 5],你根本不知道 0 和 3 是同一组的、1 是自己一组的、2 和 5 是一组的。
那样就没法保证「一个目标只出一条」——你可能会从同一组里挑两个出来,也可能从两组里各挑一个,却不知道它们其实指的是同一个目标。
有了分组信息,才能做到「每簇只挑 conf 最高的那一个」。
三、改动:把分组信息暴露出来
改动就是在 NMS 里面把分组的信息暴露出来,所以返回类型改成了:
std::vector<int> → std::vector<std::vector<int>>
所以就出现了新旧的返回变化:
旧(vector<int>): kept = [0, 3, 1, 2, 5]
↑ 5 个下标,但你不知道谁跟谁一组
新(vector<vector<int>>): kept = [[0, 3], [1], [2, 5]]
↑ 一眼看出分成了 3 组
注意:旧版其实也留了这 5 个,差别不在「内容」,在「分组」。
还有一点:某个簇只有一个成员是正常的。比如上面的 [1],说明那个目标只被模型报了一次,没有第二个候选和它 IoU 大于 0.5。kKeepTop = 2 是「最多留 2 个」,不是「必须凑满 2 个」。
其实 NMS 的行为没变化,只是多了一个 vector 用来装每一簇,分簇完再输出。这样下游接收和处理数据的时候,就能清楚地知道是哪一个簇的,可以在每一簇里挑一个好的,而不是像以前一样只知道"在第几个"。
就比如在快递站里面一样:
- 第一次没有分簇的时候,只告诉你快递在第几个
- 第二次分了簇,就告诉你在第几组第几个,把你的快递放成一个组别,你直接去那个组就可以拿到你的快递了
四、怎么判断两个候选属于同一个目标
阈值:IoU 就是 0.5。
跟谁比?跟簇首比。 因为排列过后,簇首都是 conf 最高的那个,最可信。
判断标准是:如果还没有簇,就创建一个;其他的候选和这个簇首的 IoU 大于阈值,就算同一个簇。
(这里不用"跑聚类",是因为聚类要让算法自己迭代去找分组、还要调参;而我们已经有一个现成的先验——conf 最高的就是最可信的簇首。一趟遍历就分完了,简单得多。)
为什么不是两两互相比较
比如有 100 个候选的数据,两两互相比较就是两层循环,要比较 4950 次。
但如果用簇首法,知道组长有几个,你只需要和组长比较就行——候选很多,真正 conf 高的目标比较少,所以比对的次数少得多。
链式效应
先说什么是链式效应:A 和 B 重合、B 和 C 重合,但是 C 和 A 不重合,这三个数据还是会被合并成一个簇里面。
只要不是 100% 重合,在链式效应的作用下一直往后走,原本的特征就会被一直稀释掉。
但是我们是簇首法,只和簇首比较,就不会发生链式效应了。
在这个场景里,我们查看数据得出的结果是:同一个目标的两个框,差别很小,只有 0.12 ~ 0.27 像素,也就是几乎重合的样子,这样的 IoU 已经很大了。
风险一:漏合并
如果簇首是 A,第二个是 B,B 和 A 比较小于 IoU 阈值,但是 B 和 C 比较就可以——这样就漏掉了一个(该合的没合上)。
不过我认为,链式效应的严重程度是跟簇的数量有关的。可以遍历簇里任何一个,只要 IoU 过阈值就算同一簇;但是得限制簇里面的数据数量,并且提高 IoU 阈值,保证簇内的原始组员和组长的 IoU 是很高的。
风险二:错误合并
当训练模型的时候,你给它的是很大的训练集合,假设不同物体都会有框选,拉框的时候拉大了,或者物体本身就很小——在多目标的实际工程问题里面,就需要考虑得更多。
但是在 RM 里面的装甲板就是分开的,装甲板不会贴得很近,所以这个风险在我们的场景里很小。
五、OpenCV 的几何二次验证
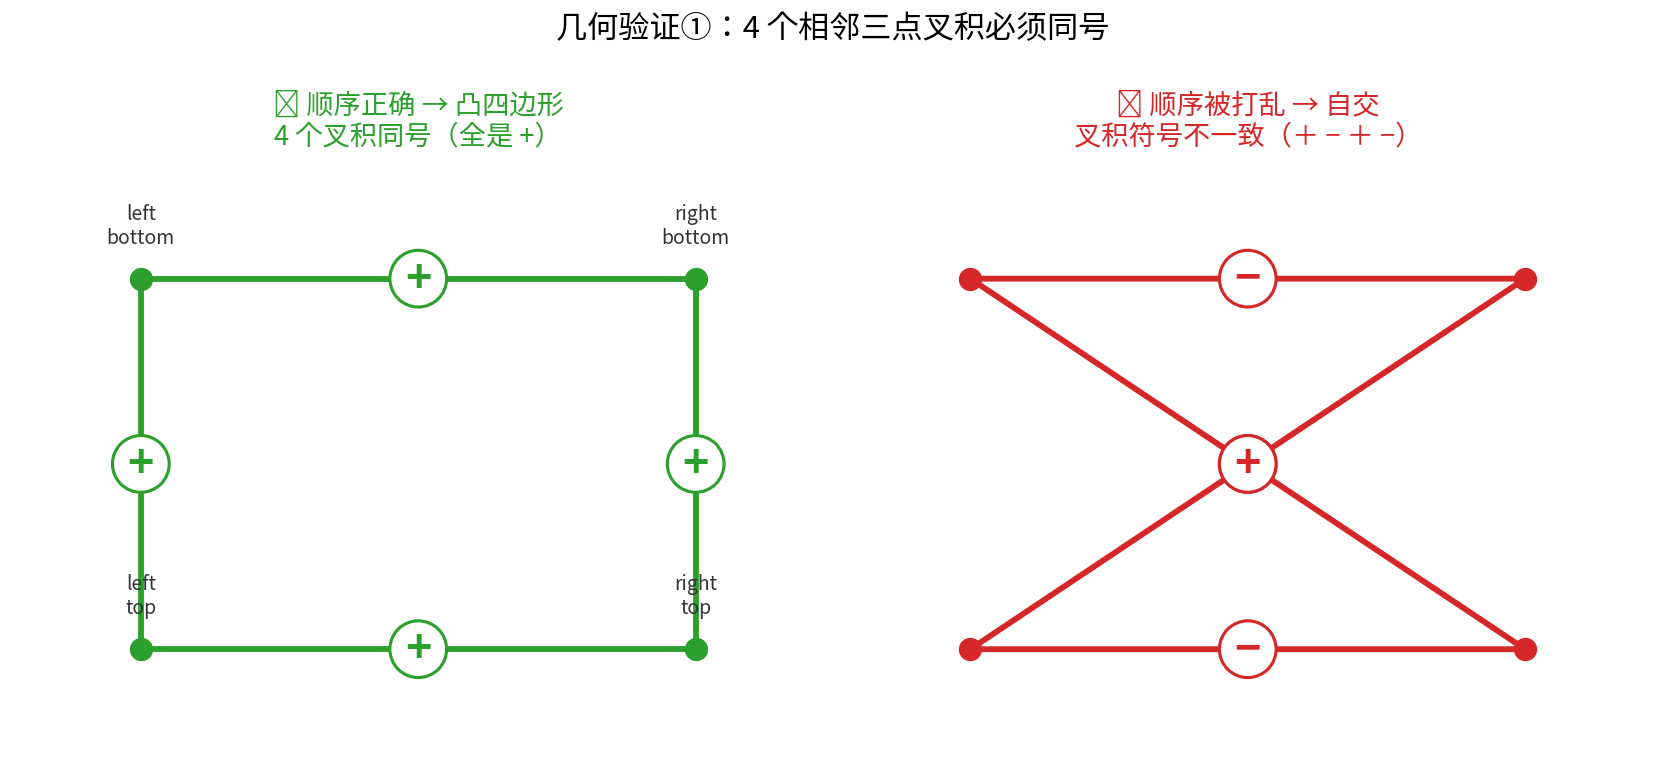
1. 凸四边形
4 个角点要按照顺序连线(数据统一性前面提到过)。
取相邻 3 个点的叉积,四个叉积需要是同号的——这说明它是凸四边形,而且角点的顺序没有被打乱。
如果前面输出的时候把角点顺序搞反了,四边形就会自交,计算出来的结果就是符号不一致。
2. 对边的长度相近
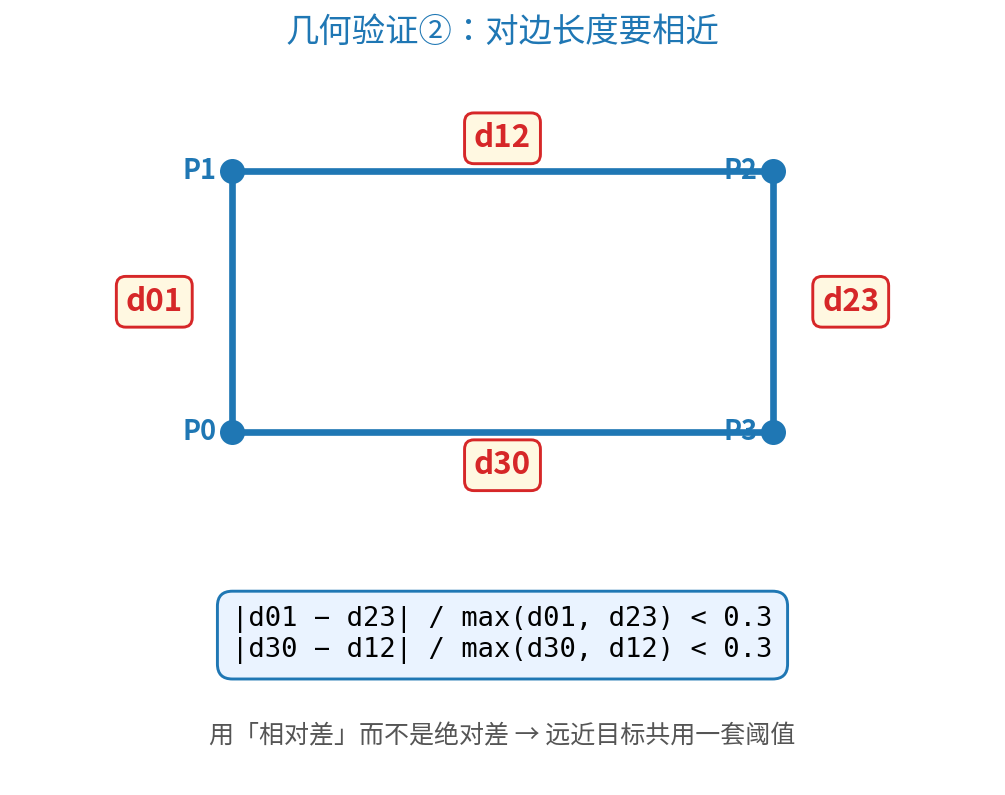
对于我们的 RM 装甲板识别,它是标准的矩形。但是在其他情况下,就要根据现实的情况来变化算法。
判据是:
|d01 − d23| / max(d01, d23) < 0.3
|d30 − d12| / max(d30, d12) < 0.3
又因为有远近的影响,我们不直接用尺寸,而是用分数比例的相对值来量化差距:远处的像素差别可能很小,如果是近一点的,像素差别可能很大。
就算是斜着看,装甲板也是对称的,两个灯条(或者角点连起来的线)是平行的,没有影响。
阈值 0.3 的来历:这个阈值不是"越严越好",因为它有两个方向的作用——
- 阈值太松(比如 0.8):斜着看的装甲板会被误判成"不合格" → 漏掉真目标
- 阈值太严(比如 0.05):歪七扭八的四边形也能通过 → 放进错误目标
0.3 的意思是「对边长度差在 30% 以内就算像矩形」。透视角度的变化本来就会让对边产生差异,所以不能设得太小。
要定得更准,可以这么做:
不过我觉得,自己跑这个阈值分析挺麻烦的。我的想法是直接指挥 AI 来做——给它一组"烂的数据"和一组"好的数据",让它先划分出三个层次,再按这三层生成直方图,用分布来定阈值;或者干脆让它帮我想有没有更好的几何约束。
六、对照实验:留两条真的有用吗
留下两条多的 top-2 数据有没有用处呢?这个多一个"保险",真的起作用了吗?
做法是:在前面的全局变量里面改,把 kKeepTop 从 2 改成 1,就可以把原来留两个数据改成留一个。
如果这个保险真的起作用了,那么改成 1 之后,过滤后的观测数量应该比留 2 个的时候少才对——因为如果只保留 1 个,恰好那个不合格,那么这个簇就没有数据流到后面了,救不回来了。
实测结果:
| kKeepTop = 2 | 1002 |
| kKeepTop = 1 | 1002 |
救回的数据为 0 个,说明没起到作用——簇首的几何基本都合格了,第二轮只是保险。说明模型还是很厉害的,保留 kKeepTop 作为一个保险的后背。
这个测试没测出差别,但 0 个结果也是一个结果。因为不做测试,说出来的就是背书的、讲概念的;真正做一遍,哪怕没有差别,也比只讲概念好一些。
七、实测效果
用 short.mp4 来进行测试:
| 观测总数 | 1002 条 |
| 平均 | 2.0 条 / 帧 |
| 去重前 | 约 2000 条 → 正好减半 |
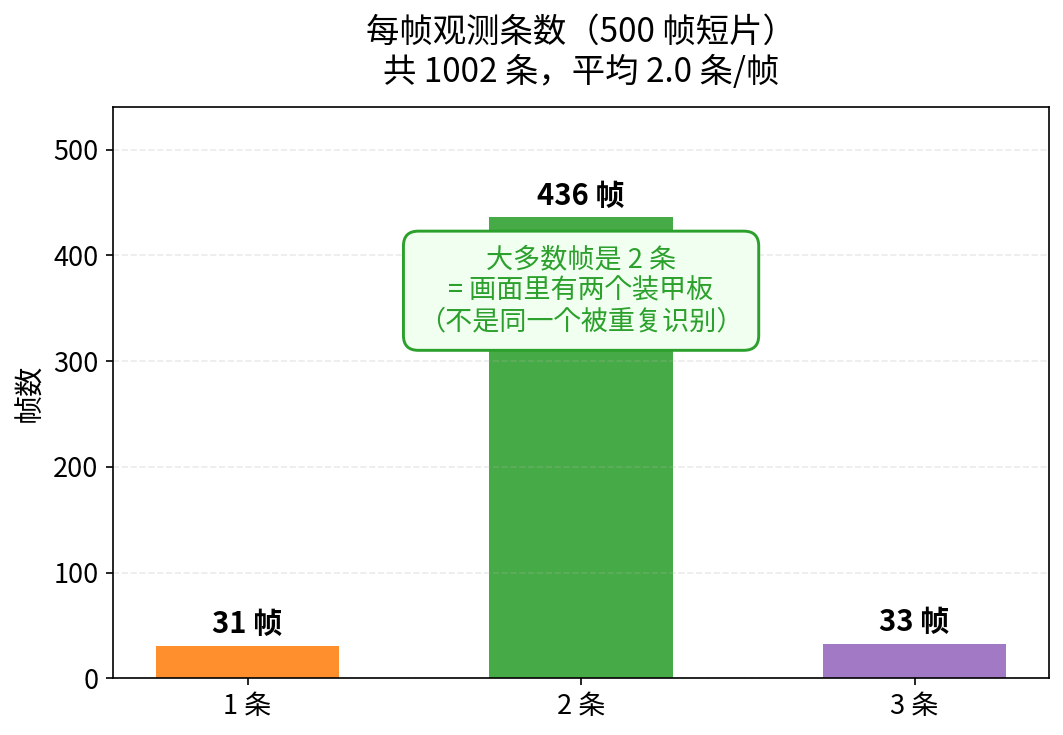
每帧条数分布:
| 1 条 | 31 帧 |
| 2 条 | 436 帧 |
| 3 条 | 33 帧 |
每一帧有 2 条,是说画面里有两个装甲板,不是一个装甲板被重复识别出来的数据。
八、踩到的坑
1. build.sh 假成功(老问题了,前面的博客也出现过一次)
跑完 build.sh,后面打印出来的 CSV 只有前面那一行表头,没有数据???
原来是我一直用旧的可执行文件在跑。
教训:改完代码可以看时间戳,或者重新生成可执行文件。
2. 判断逻辑写反了
我写的是:
!(r1 > 0.3) && !(r2 > 0.3)
应该是:
!(r1 < 0.3 && r2 < 0.3)
搞的全部数据都被排除掉了。
教训:写完布尔式子,可以带入一个正确的数据让它走一遍——让 AI 代数据走一遍也行。如果可以,全部代码写完之后,带入一个正确的数据进去跑流程,再加上打印日志,来排查错误。
3. 文件里存在同名函数
自己改的时候忘记删掉了。
还有在改函数内部的时候,写了 belong = kept[g][0],才发现存错东西了。每一个变量的名字都要知道它在存什么东西——和上一篇的 auto 一样,最好是能说出来,或者写注释。不然改的时候、升级的时候、或者报错的时候都很麻烦,代码就不稳定了。
因为这几次引入了太多变量,我前面又经常用 auto 写,所以经常默认都是 int 啊什么什么的,大概这个意思,导致在变量类型的计算和逻辑上出现了很多问题。
下一篇:卡尔曼滤波——把角度的抖动压下去。