论文题目:BearingPGA-Net: A Lightweight and Deployable Bearing Fault Diagnosis Network via Decoupled Knowledge Distillation and FPGA Acceleration(BearingPGA-Net:基于解耦知识蒸馏与 FPGA 加速的轻量可部署轴承故障诊断网络)
期刊:IEEE Transactions on Instrumentation and Measurement,2024
DOI:10.1109/TIM.2023.3346517
源码:GitHub – asdvfghg/BearingPGA-Net · GitHub
摘要:深度学习在轴承故障诊断中表现出色,但模型越来越大,很难直接部署到要求低功耗、高实时性和强可移植性的工业端侧设备。本文提出 BearingPGA-Net:先利用 Decoupled Knowledge Distillation(DKD)把大型 Teacher 的知识迁移到只有一层卷积的轻量 Student,再将网络从 PyTorch 的 32-bit 浮点实现转换成 16-bit 定点形式,并使用 Verilog 在 Kintex-7 FPGA 上逐层实现 FFT、卷积、ReLU/Max-Pooling 和全连接运算。BearingPGA-Net 只有 2.83K 参数,在 CWRU、HIT 和 PU 三个轴承数据集上保持较强的噪声鲁棒性;16-bit FPGA 相比 32-bit PyTorch 在 HIT 数据集上的 F1、Recall 和 Precision 损失均低于 0.4%,在线 100 次真实轴承测试的 Macro-F1 达到 96.98%。
一、研究背景:轻量模型不等于“真的能部署”
轴承故障通常会在振动信号中形成异常冲击,因此最常见的监测方式是把加速度传感器安装在机械表面,再通过信号处理和诊断模型识别 Healthy、Inner Race、Outer Race、Ball Fault 等状态。
深度 CNN 可以取得很高的诊断性能,但工业现场的问题并不只是 Accuracy:如果每台旋转设备都需要配一台高性能计算机,成本、空间、布线和功耗都会迅速增加。FPGA 具备并行计算和低功耗优势,但它的 LUT、BRAM、DSP 等资源又十分有限。
因此本文关注两个必须同时解决的问题:
第一,怎样把故障诊断网络压缩到 FPGA 能放得下;第二,怎样把这个网络真正翻译成硬件逻辑并高速运行。
作者指出,以往不少“轻量轴承诊断网络”只在 CPU/GPU 上验证,并没有真正部署到嵌入式硬件。BearingPGA-Net 的重点正是把“轻量算法”和“FPGA 端侧实现”连起来。
二、整体框架:FFT + DKD + 单层 1D-CNN
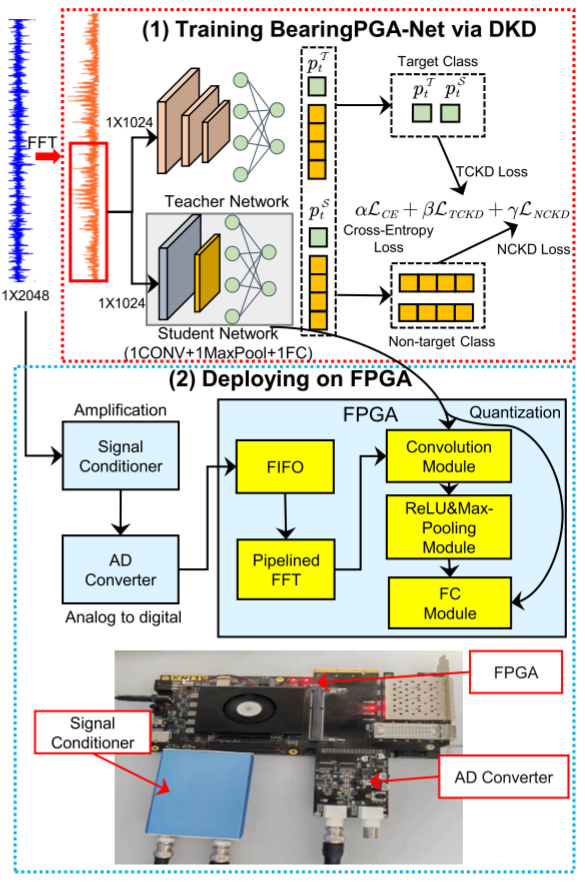
论文 Figure 1:BearingPGA-Net 从训练到 FPGA 在线诊断的完整流程
论文采用两阶段方案:
离线阶段:Teacher → DKD → BearingPGA-Net Student
在线阶段:加速度信号 → Signal Conditioner → AD Converter → FIFO → FFT → BearingPGA-Net → LED 诊断结果
Teacher 使用 WDCNN,由 6 个 CNN Block 和全连接层组成;Student 则极度精简,只保留:
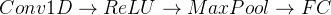
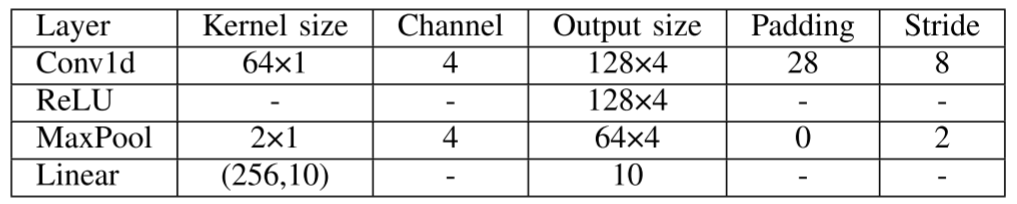
论文 Table I:BearingPGA-Net 的网络结构
这个网络总参数只有 2.83K。为了弥补单层 CNN 特征提取能力不足,作者并不是直接把原始时域信号送进去,而是先对 2048 点振动片段进行 FFT,再把频域特征作为网络输入。也就是说,BearingPGA-Net 本质上采用了:
传统信号处理增强特征表达 + 极浅神经网络降低硬件成本。
三、DKD:为什么一层 CNN 还能保持较好的诊断能力?
普通 Knowledge Distillation 使用 Teacher 的 Soft Label 指导 Student,但传统 KL Loss 会把目标类别和非目标类别的知识耦合在一起。
DKD 将蒸馏知识拆成两部分:
-
TCKD(Target Class KD):关注目标类别;
-
NCKD(Non-Target Class KD):描述其他类别之间的关系。
最终 Loss 为:
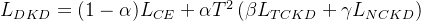
在轴承任务中,作者发现应当提高目标类别知识的权重,即通常采用 ( )。

论文 Table X:Teacher 与 Student 的规模和计算量比较
Teacher 有 50.09K 参数、0.83M FLOPs;BearingPGA-Net 只有 2.83K 参数、78.34K FLOPs。因此参数量减少约 17×,FLOPs 减少约 10.6×,1000 个样本的离线推理时间由 1.5703 s 降至 0.6431 s。
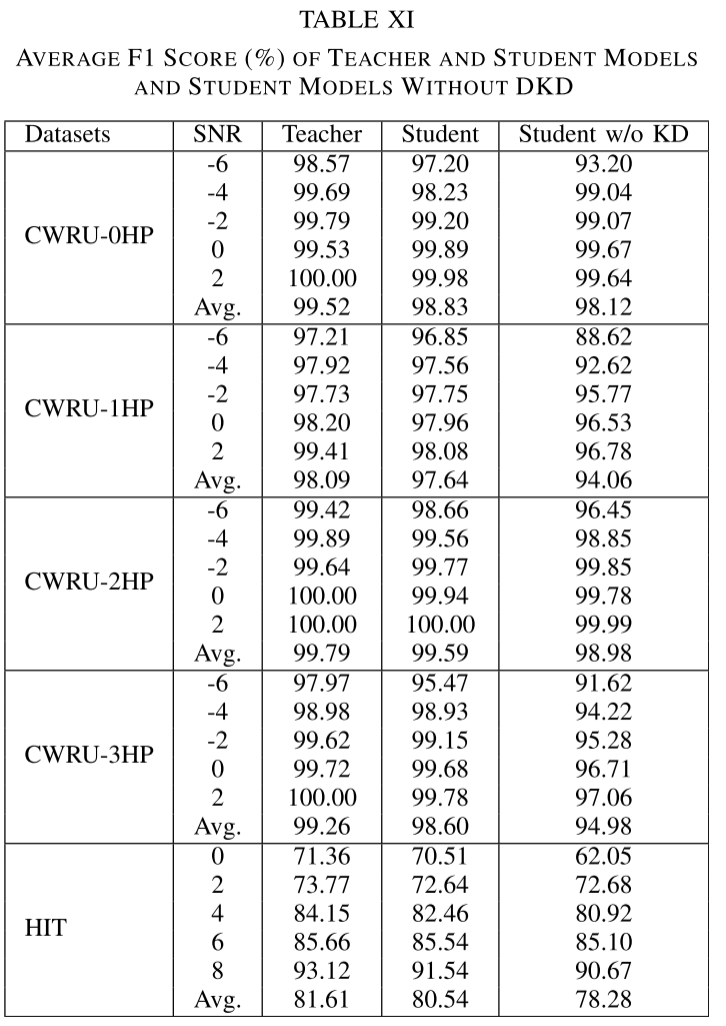
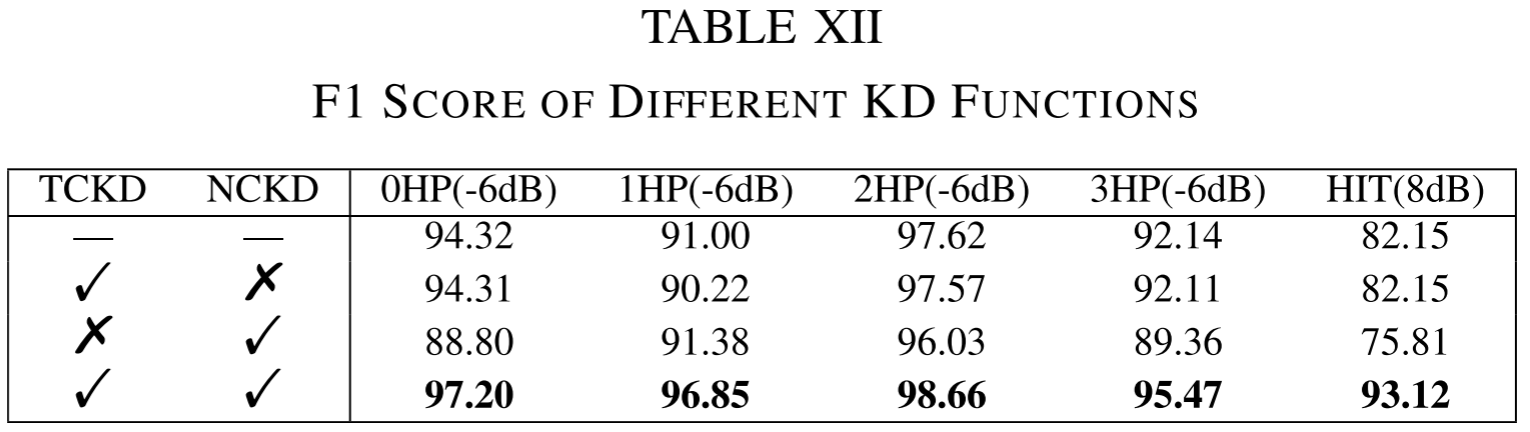
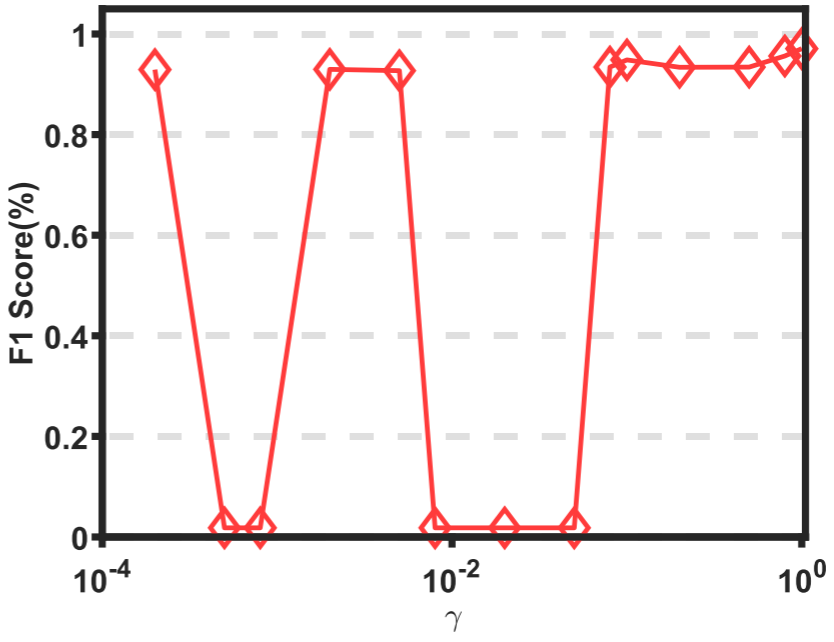
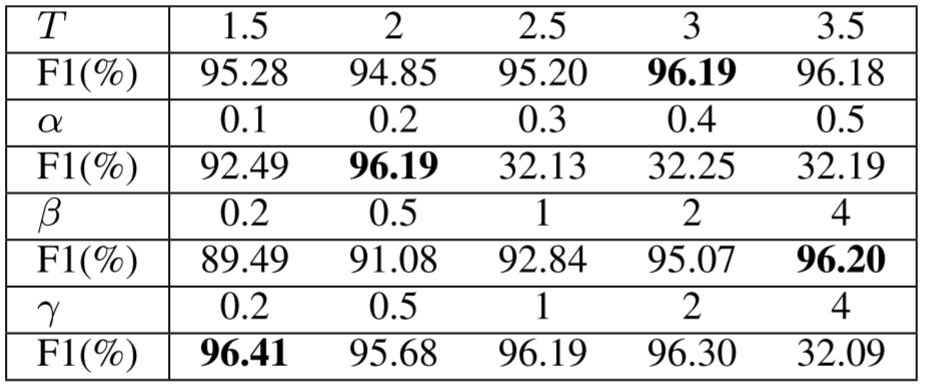
论文 Table XI–XIII、Figure 10:DKD 增益、消融实验及超参数敏感性
DKD 的意义尤其体现在噪声场景。例如 CWRU-2HP 在 −6 dB 下,DKD 相比不使用蒸馏提高约 8.23% F1;HIT 在 0 dB 下提高约 8.46%。消融实验也表明 TCKD 是主要贡献项,而完整 DKD 效果最好。
所以这里的“轻量化”不是直接把网络删到一层,而是先让大型 Teacher 学会复杂判别边界,再把这部分知识迁移到极小 Student。
四、FPGA 部署:不是把 PyTorch 文件直接丢进开发板
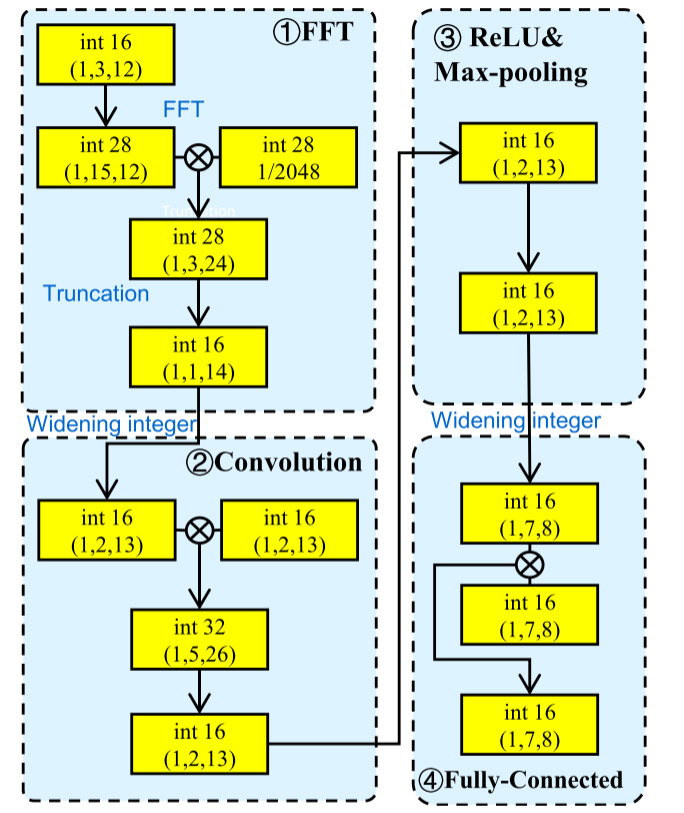
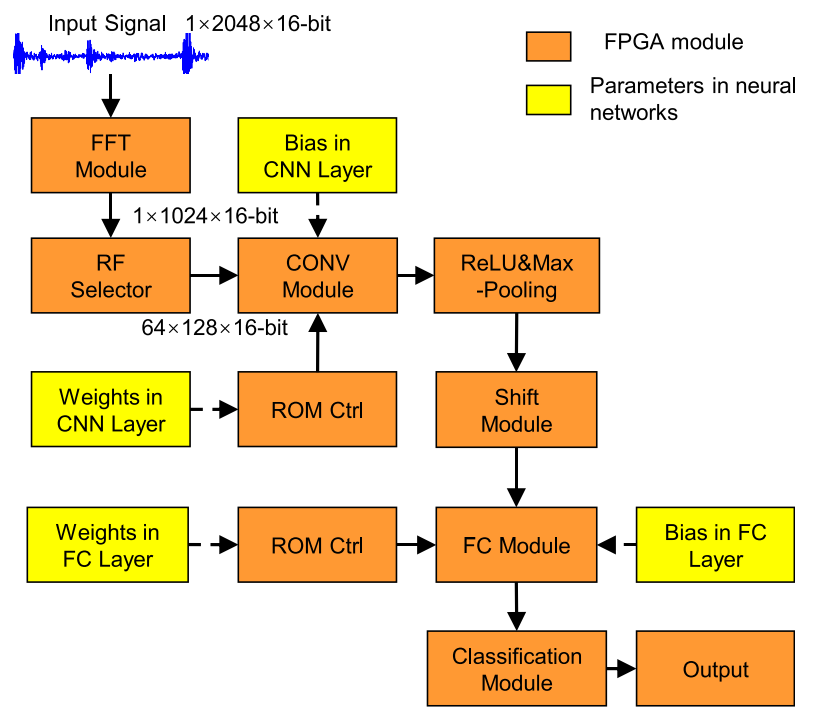
论文 Figure 2–3:逐层定点量化以及 FPGA 上的完整数据流。
Fig2.:BearingPGA-Net每层整数和小数的位宽示例,其中(S,X,Y)分别表示符号位数、整数位数和十进制位数。
Fig3.:BearingPGA-Net部署到现场可编程门阵列的总体框图。
Python 网络原本使用 32-bit Float。作者将参数转换成 16-bit Fixed Point,并根据每一层数据的最大值、最小值动态分配整数位和小数位,以兼顾量化范围与分辨率。
这与简单的“全网络统一 INT16”不同:不同层可以采用不同的整数/小数位配置,从而降低 Overflow 和 Quantization Error。
部署使用 ALINX 7325B 开发板,核心芯片为 Kintex-7 XC7K325T,运行频率 100 MHz。作者没有使用 PYNQ 自动转换,而是在 Vivado 2018.3 中直接通过 Verilog 设计硬件模块。
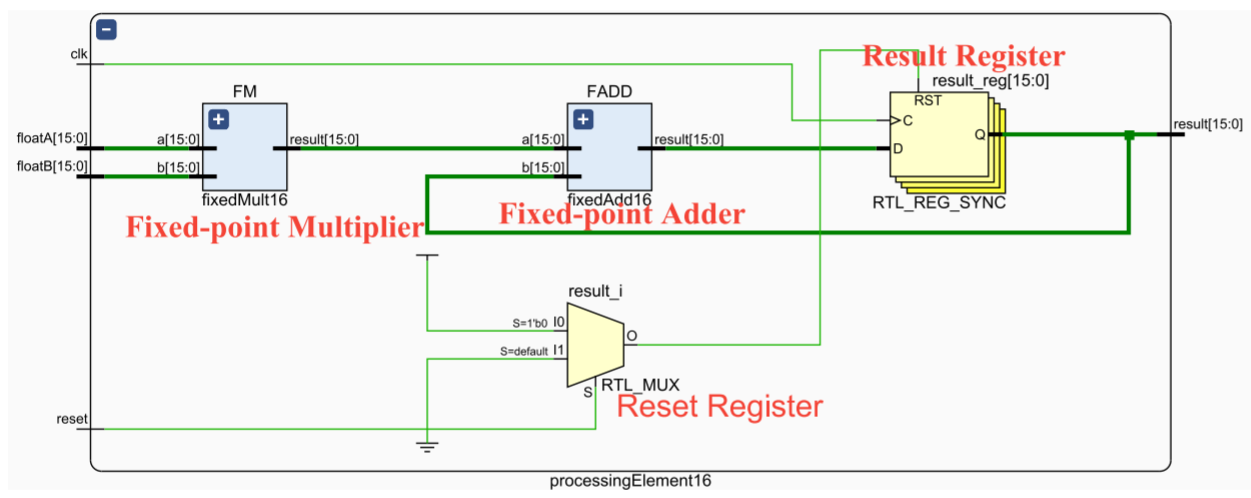
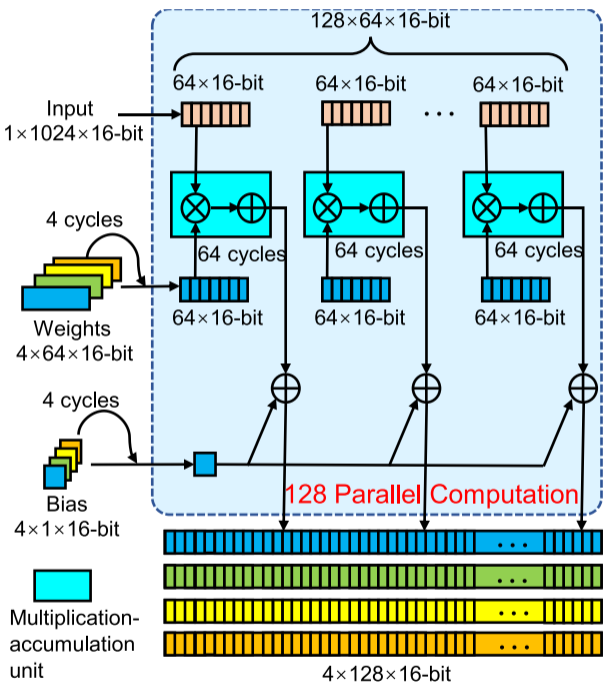
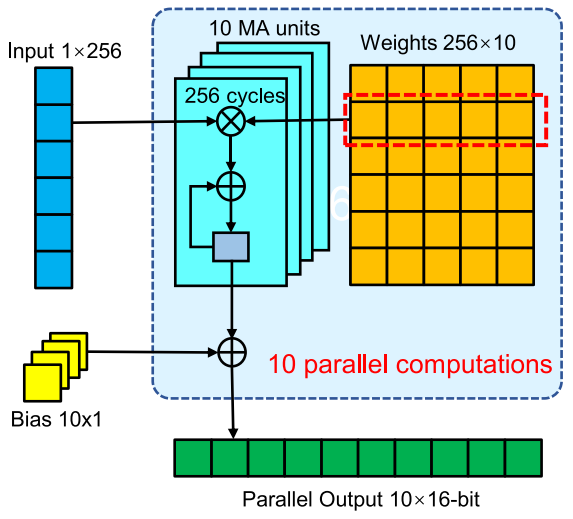
论文 Figure 4–6:MAC、卷积层和全连接层的硬件实现
卷积是主要计算瓶颈。输入经过 RF Selector 后形成 128 个长度为 64 的片段,作者实例化 128 个并行 MAC 单元。每个 MAC 在 64 Cycle 内完成一次长度 64 的乘加,因此一个卷积 Kernel 可以在 64 Cycle 内完成全部窗口计算;4 个 Kernel 总计约 256 Cycle,相比普通串行方式形成约 128× 的卷积级并行加速。
ReLU 与 Max-Pooling 也被融合为同一个比较模块。因为二者都依赖最大值判断,作者通过符号位先过滤负数,约节省 2/3 的 LUT 资源。
全连接层则采用“模块复用”:不是同时放置全部乘法器,而是用 10 个 MAC 单元循环 256 Cycle,在资源和速度之间折中。
这正是 FPGA 部署与 MCU 部署最大的差别:MCU 主要优化软件执行,而 FPGA 是把神经网络算子直接重新组织成并行数字电路。
五、实验结果:从模型精度一直测到 FPGA Power
论文使用三个数据源:
-
CWRU:10 类,12 kHz 驱动端振动信号,并测试不同负载和 −6~2 dB 噪声;
-
HIT 自采数据:HC7003 轴承,Healthy + Ball/OR/IR 三种位置、三种严重程度,共 10 类,12 kHz;
-
PU 数据集:真实损伤数据,3 类,并跨不同转速、载荷和径向力测试。
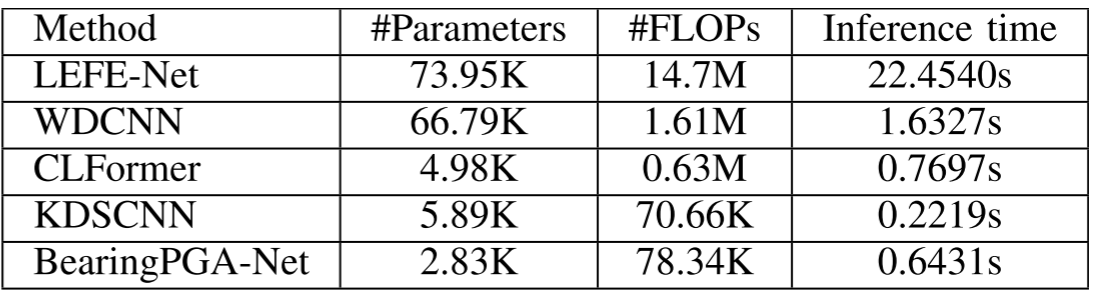
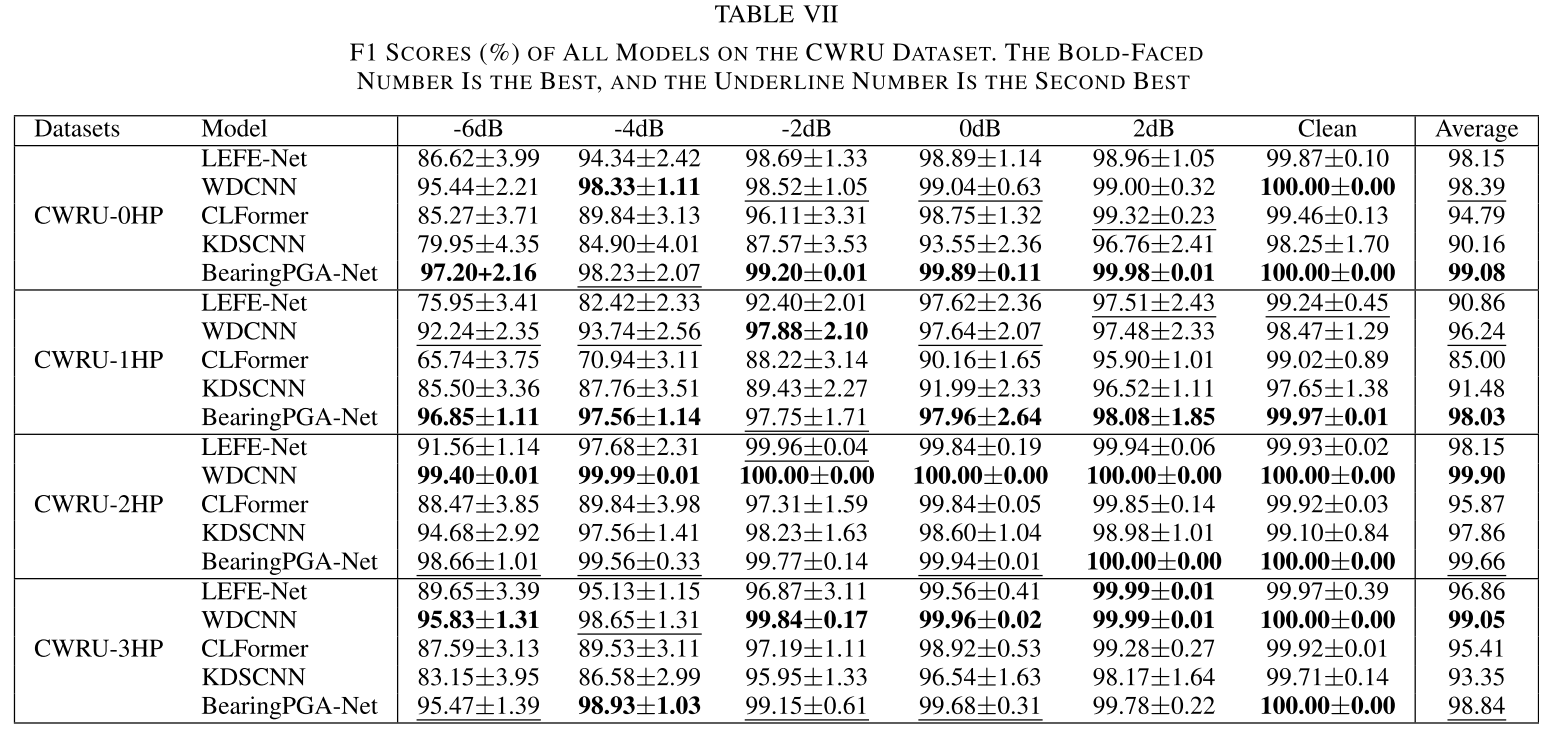
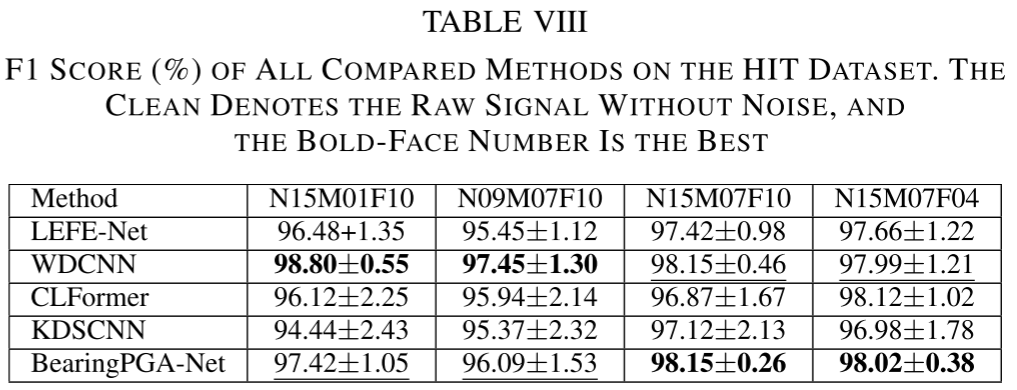

论文 Table V、VII–IX:轻量模型规模及 CWRU/HIT/PU 分类结果
BearingPGA-Net 仅 2.83K 参数,明显小于 WDCNN、LEFE-Net 等网络。在 CWRU 的 −6 dB 强噪声下仍能维持超过 95% 的 F1;在 HIT 噪声实验中平均 F1 为 80.54%,高于 CLFormer 的 76.37% 和 KDSCNN 的 74.98%。
5.1 32-bit PyTorch → 16-bit FPGA 会损失多少?
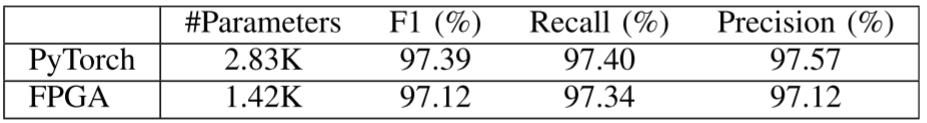

论文 Table XIV、Figure 11:量化前后的指标与混淆矩阵
HIT 测试集中:
-
PyTorch:F1 97.39%、Recall 97.40%、Precision 97.57%
-
FPGA:F1 97.12%、Recall 97.34%、Precision 97.12%
因此三项指标下降均低于 0.4%。2500 个测试样本中,FPGA 相对原模型只额外产生 24 个错误。
5.2 FPGA 资源用了多少?


论文 Table XV、Figure 12:Kintex-7 的资源占用
整个网络占用:
-
LUT:74.40%
-
BRAM:58.20%
-
FF:44.19%
-
DSP:22.02%
其中卷积模块约占 LUT 的 50%,FFT 模块约占 23%。这也说明为什么作者把 Student 限制为单卷积层:即使只有一层 Conv,已经消耗了大约一半 LUT。
5.3 推理时间和功耗

论文 Table XVI:CPU 与 FPGA 单样本 Inference Time / Power Consumption
实测数据为:
-
Intel i5-1135G7 @ 2.40 GHz:3001.9 μs,28 W
-
Kintex-7 XC7K325T @ 100 MHz:60.3 μs,0.67 W
按 Table XVI 直接计算,FPGA 的单样本推理时间约为 CPU 的 1/50,功率约为 1/42。这也是正文对 Table XVI 的明确表述。
需要注意一个论文内部的口径差异:摘要和结论写的是“over 200× faster diagnosis speed compared with CPU”,但 Table XVI 的 3001.9 μs / 60.3 μs 实际约为 49.8×。 论文没有在表格附近进一步解释“>200×”采用了什么不同的速度定义。因此如果后续引用端侧 Latency,建议直接采用 Table XVI 的原始实测值,并单独说明这一差异。
六、在线测试与启示:真正把振动信号送进 FPGA

论文 Figure 13:真实在线轴承诊断平台
最后的实验不是把保存好的测试数据离线送入 FPGA,而是在真实轴承台架上安装加速度计,振动信号经过 Signal Conditioner 和 AD Converter 后实时进入 FPGA;诊断类别由 4 个 LED 以二进制形式显示。
每个轴承重复测试 10 次,共进行 100 次在线诊断。

论文 Figure 14:Online Test Confusion Matrix
最终 Macro-F1 为 96.98%,Precision 为 97.27%,Recall 为 97.00%。主要错误集中在 Ball Fault:两个轻微滚动体故障被判为中等,一个中等故障被判为严重。作者认为这与滚动体故障存在随机滑移、周期特征不稳定有关。
如果把这篇论文压缩成一句话:
先用 FFT 把振动信号变成浅层网络更容易处理的频域特征,再用 DKD 把深模型的判别能力压进单层 CNN,最后通过 16-bit 定点量化、并行 MAC、算子融合和模块复用,把整个诊断网络变成 Kintex-7 上可实时运行的数字逻辑。
对于“信号处理 + 端侧部署”的研究,这篇文章最值得借鉴的是完整证据链:
Raw vibration → FFT → Lightweight Model → Knowledge Distillation → Quantization → FPGA RTL → Resource Utilization → Latency → Power → Online Test
同时论文也给出了清晰的限制:单层 CNN 的跨设备泛化能力有限,如果为了 Domain Adaptation、Transfer Learning 增加网络分支和 Loss,就会重新增加 FPGA 资源压力。因此 BearingPGA-Net 的核心并不是“网络越小越好”,而是在诊断性能、可部署性、并行度、硬件资源和功耗之间做系统级折中。