发布时间:2026-09-3 标签:AI Agent|工程实践|调试|Debugging Loop
上一篇我建立了一棵失败分类树,七类错误各归其位。
但光有分类还不够。我见过太多人(包括以前的我)是这样调 Agent 的:
Agent 错了 → 改 Prompt → 再试 → 还错 → 继续加 Prompt → 加着加着,Prompt 从 50 字涨到了 500 字,结果更糟了。
这种调试方式,有个很形象的名字:盲人摸象。
这一篇,我要把这套瞎试,换成一个有章法的循环。
系列导航
- 上一篇:AI Agent 工程实践(40):第一次失败——Agent 为什么会做错
- 下一篇:AI Agent 工程实践(42):Agent Trace——完整还原一次失败执行
问题背景
这是第五阶段的第六篇。上一篇解决了"它错在哪一类",这一篇解决"知道错了之后,怎么系统地改"。
先立个靶子:为什么"改 Prompt"是 Agent 调试里最流行的、也是最无效的方法?
因为它跳过了最关键的一步——定位。你不知道这次失败到底发生在哪一层(是选工具?传参数?读文件?还是下结论?),就急着改 Prompt,等于闭着眼睛调参。改对了是运气,改错了是常态,而且你根本无法判断"改对了"到底是哪一次改动的功劳。
真正专业的调试,和医生看病是一个逻辑:先诊断,再开药,最后复查。
错误尝试:改 Prompt 的死亡螺旋
我用一个真实经历还原"改 Prompt 调试法"是怎么失败的。
第一次失败:Agent 该用 grep 却用了 git_log(Tool Selection Error)。 我的反应:在 Prompt 里加一句"调查代码请优先使用 grep"。 结果:这个案例过了,但"解释代码"的任务变差了——因为它现在不管什么都先 grep 一通,该直接读文件的时候也去搜。
第二次失败:Agent 读文件读太多,Token 爆炸(Retrieval Error)。 我的反应:在 Prompt 里加一句"每次最多读两个文件"。 结果:bug 定位的任务废了——有些 bug 明明需要读第三个文件才能找到根因,它被自己的 Prompt 卡死了。
看出来了吗?每一次 Prompt 修补,都是在用一个局部问题,去换一个全局回归。 而因为没有定位到根因,我永远不知道下一次会撞到什么。
关键观察:调试要"定位到层"
转折点来自一个朴素的问题:我能不能,像调试传统代码那样,先定位到出错的那一行,再改?
传统软件调试,你不会"程序错了就随机改代码",你会看堆栈、加断点、定位到具体函数。Agent 调试也应该是这样——只不过 Agent 的"堆栈",就是它的 Trace(执行轨迹)。
于是我把调试过程,收敛成了一个六步循环: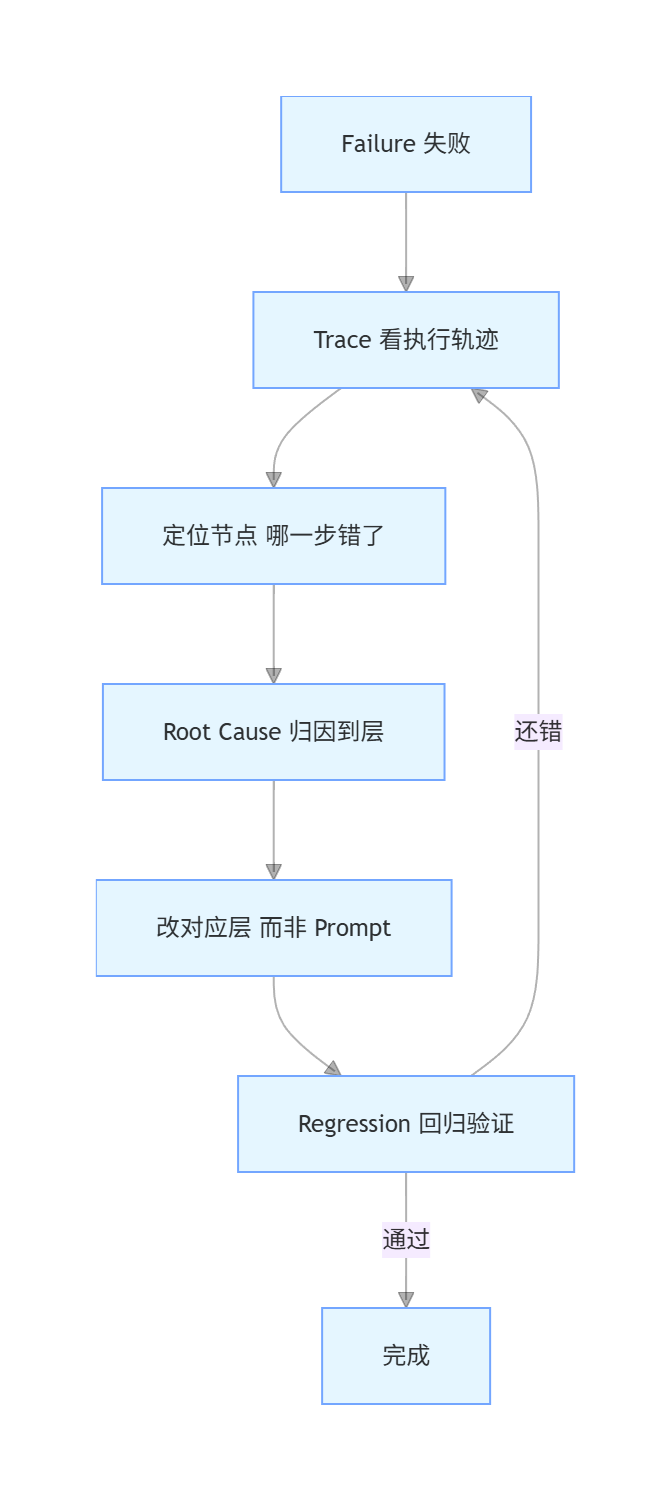
核心洞察:
改 Prompt 是最后一招,不是第一招;80% 的失败,根本不在 Prompt 那一层。
最终方案:Agent Debugging Loop
把这个循环落成可操作的五步,并配一个真实案例走一遍。
真实案例:一次 Tool Selection Error 的修复
第 1 步,定位失败:Agent 定位 bug 时,本应 grep(keyword="payment"),它却调了 git_log()。
第 2 步,看 Trace:从执行轨迹里看到,LLM 在选择工具前的"思考"是——"我需要了解这个项目的支付相关改动历史"。
第 3 步,归因到层:它为什么会想到"查历史"而不是"搜代码"?因为我的工具描述写得太含糊——git_log 的描述是"查看项目历史",没写清楚它是"看提交历史"的,而 grep 的描述也没强调"用于定位代码位置"。
第 4 步,改对应层:改的不是 Prompt,而是 Tool 的 description:
# 修复前 —— 描述含糊,LLM 分不清用途
{"name": "git_log", "description": "查看项目历史"}
{"name": "grep", "description": "搜索关键字"}
# 修复后 —— 写清"什么时候用、用来干嘛"
{"name": "git_log",
"description": "查看代码的提交历史/最近改动。仅当你需要了解'谁改了什么、何时改'时使用;定位代码位置请用 grep"}
{"name": "grep",
"description": "在代码中搜索关键字,返回文件+行号。用于定位某段逻辑在哪个文件;不要用来看历史"}
第 5 步,回归验证:重跑失败案例 + 之前正常的案例,确认没有引发新的回归。
看到区别了吗?根因在 Tool 描述层,我改的就是 Tool 描述层。 而不是往 system prompt 里再塞一句"记住要用 grep"——后者治标,前者治本。
代码或配置示例
把这套循环做成一个可复用的调试模板,每次 Agent 出错,照着填:
## Agent 调试记录(Repo Doctor)
– 失败现象:________
– 失败分类:[ ] Planning [x] Tool Selection [ ] Argument
[ ] Retrieval [ ] State [ ] Reasoning [ ] Output
– Trace 关键节点:________(第几步、调了什么、回了什么)
– Root Cause(归因到层):________
– 修改的层:________(Prompt / Tool描述 / Schema / Context / State / Reviewer / Output约束)
– 回归结果:________(失败案例是否通过?正常案例是否退化?)
这个模板的价值在于,它强制你走完"定位→归因→改层→回归",而不是失败后立刻改 Prompt。每次调试都留下一份记录,时间久了,你会积累出一张"哪类错误通常改哪层"的经验表——这就是你自己的 Agent 调试直觉。
设计权衡
| 改 Prompt 调试法 | 快、门槛低 | 治标不治本,一处修复引发全局回归 | 没定位到根因,盲调 |
| Debugging Loop | 治本、可回归、可积累 | 需要先有 Trace 能力 | 定位到层,改对地方 |
| 每错必开新模型 | 换模型可能碰巧好 | 成本高、不可解释 | 用换模型掩盖根因,治不了本 |
关于"改 Prompt 是最后一招"要再强调一句:不是说 Prompt 永远不该改,而是说在你定位到根因之前,别动它。因为 Prompt 是作用面最广的一层,改它影响所有任务,是最容易引发回归的改动——这个道理,第 44 篇会专门展开。
总结
✅ "改 Prompt"是 Agent 调试里最流行也最无效的方法。 ✅ 正确循环:Failure → Trace → 定位节点 → Root Cause → 改对应层 → Regression。 ✅ 80% 的失败不在 Prompt 层,改 Tool 描述、Schema、Context 往往才对症。 ✅ 铁律:只会改 Prompt 的工程师,和只会重启电脑的运维没有区别。 ✅ 每次调试落一份记录,积累自己的"错误→修复层"经验表。
参考资料
- LangSmith 的 Debugging 文档 → 为什么引用:Trace 驱动的调试流程,是 Debugging Loop 的工程化来源。
- Anthropic《Building Effective Agents》中 tool description 的写法建议 → 为什么引用:印证了"改 Tool 描述优于改 Prompt"的实践。
系列导航
- 上一篇:AI Agent 工程实践(40):第一次失败——Agent 为什么会做错
- 下一篇:AI Agent 工程实践(42):Agent Trace——完整还原一次失败执行
本文是 [AI Agent 工程实践] 系列的第 41 篇。