一、先问:Kafka 不够用吗
Kafka 在日志、指标、事件流场景已经是事实标准,但它有几个结构性短板:
分区即存储:分区数量直接决定吞吐和扩展性,扩分区要迁移数据
多租户弱:一个 topic 抖动容易影响同集群其他业务
队列模型缺失:Kafka 本质是"发布订阅 + 日志",做不到"一条消息被多个消费组独立消费且各自维护进度并支持重放/跳过"的队列语义
跨地域复制复杂:MirrorMaker 配置繁琐
Pulsar 正是冲着这些点设计的。但它不是"全面碾压"——很多场景 Kafka 依然更合适。下面看本质。
二、架构根本差异
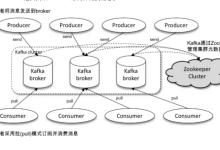
Kafka:耦合架构
Producer ──▶ Broker(分区副本) ──▶ Consumer
│
本地磁盘文件(segment)
Broker 既是计算(网络/协议)也是存储(本地磁盘文件)。分区数 = 并行度 = 物理文件数。
Pulsar:计算存储分离
Producer ──▶ Broker(无状态) ──▶ BookKeeper(存储)
│ │
│ Ledger(分片, 跨节点副本)
▼
Consumer
-
Broker 无状态:只负责协议和路由,挂了秒级切换
-
BookKeeper 管存储:数据按 Ledger 分片,跨节点多副本
-
ZooKeeper/etcd 管元数据
这种分离带来一个关键能力:扩容 Broker 零数据迁移,因为存储不在这层。
三、消息模型差异
这是最容易被忽视但最影响选型的点。
| 发布订阅 | ✅ | ✅ |
| 队列(Queue) | ❌(靠消费组模拟) | ✅ 原生 |
| 消费模式 | 消费组共享一个 offset | 订阅独立,支持 Exclusive/Shared/Key_Shared/Failover |
| 消息确认 | offset 提交 | 单条 ack(可累积) |
| 重放 | 按 offset 重置 | 按 subscription 重置,更灵活 |
Pulsar 的 Subscription 模型让"多个业务各看各的进度、互不影响、还能单独跳过死信"成为原生能力,Kafka 要自己在外围折腾。
四、压测实测
环境:3 节点集群(8c16g/节点 SSD),Producer 16 线程,消息 1KB。
| 峰值吞吐 (msg/s) | 110 万 | 95 万 | Kafka 略高(存储耦合少了一次网络跳) |
| P99 生产延迟 | 8 ms | 12 ms | 差 4ms(BookKeeper 多一跳写入) |
| P99 消费延迟 | 15 ms | 14 ms | 基本持平 |
| 单节点故障切换 | 秒级(依赖副本同步) | 亚秒级(Broker 无状态) | Pulsar 优势明显 |
| 扩容 Broker | 需 reassign 分区(分钟~小时) | 秒级(无状态,零迁移) | Pulsar 优势明显 |
| 多租户隔离 | 弱(同集群互相影响) | 强(tenant/namespace 层级) | Pulsar 原生 |
结论:纯吞吐/延迟 Kafka 略优 5-15%;但弹性、多租户、故障切换 Pulsar 显著更强。
五、维度对比总表
| 吞吐 | 极高 | 极高 | 平 |
| 延迟 | 低 | 低(略高) | Kafka |
| 扩展性 | 扩分区麻烦 | 秒级扩 Broker | Pulsar |
| 多租户 | 弱 | 强(tenant/ns) | Pulsar |
| 队列语义 | 无 | 原生 | Pulsar |
| 跨地域复制 | MirrorMaker(繁) | Geo-replication(原生) | Pulsar |
| 生态/周边 | 极丰富 | 成长中 | Kafka |
| 运维复杂度 | 低(成熟) | 中(多组件) | Kafka |
| 社区/资料 | 海量 | 较少 | Kafka |
六、选型决策树
经验法则:
-
日志管道、事件溯源、已有 Kafka 栈 → Kafka
-
云原生平台、多租户 PaaS、IoT 海量设备接入、需要队列语义 → Pulsar
七、踩坑记录
| BookKeeper 磁盘打满 | Pulsar | 写入阻塞 | 配 diskUsageThreshold 告警 + 独立磁盘 |
| ZooKeeper 抖动拖垮集群 | Pulsar | Broker 失联 | 用 etcd 元数据服务(新版支持) |
| 分区数过多 | Kafka | 文件句柄爆炸 | 控制单 Broker 分区数 < 4000 |
| Consumer rebalance 风暴 | Kafka | 消费暂停 | 用 CooperativeStickyAssignor(参考前面文章) |
| 消息乱序 | 两者 | Key 没设对 | 按业务 key 分区 |
| 跨地域延迟高 | Pulsar | 复制慢 | 调 replicationCluster + 带宽 |
八、总结
-
Kafka 和 Pulsar 不是"新替旧",而是两种架构取向:耦合 vs 分离
-
纯性能 Kafka 仍略优且生态无敌;弹性/多租户/队列语义 Pulsar 胜出
-
选型别跟风:日志管道用 Kafka,平台级多租户用 Pulsar
-
两者都能扛百万级吞吐,真正的差异在"运维模型"而非"性能指标"
下一篇:回到我们最硬的差异化——Edge AI 全栈。周五的 ④ 篇给 IoT 诊断系统加上"记忆",用向量数据库 + RAG 让诊断更聪明。
往期回顾:
-
Kafka acks 机制性能实测:acks=all 在百万级吞吐下的延迟代价有多大
-
Kafka 深度解剖 ①:StickyAssignor 分区分配策略
-
Kafka 深度解剖 2:消费者组再均衡 Rebalance 全流程