SEED-UMI 论文深度分析总结
论文题目:SEED-UMI: Sharing the Exoskeleton between Human and Robot for onE-to-one Dexterous Demonstration(人类与机器人共享外骨骼,实现一对一灵巧演示)
作者机构:于腾博、吴嘉豪、李道翰等,来自北京大学通用人工智能全国重点实验室(智能科学技术学院)与 Delta Intelligence(增量智能),通讯作者为刘航欣(hx.liu@pku.edu.cn)
项目主页:https://tengbo-yu.github.io/SEED-UMI/ 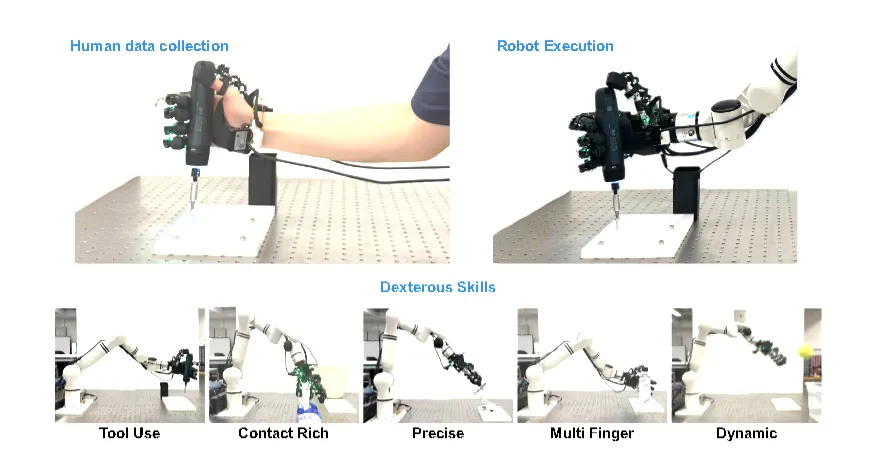
一、研究背景与问题定位
灵巧手操作是机器人学习领域公认的最具挑战性的方向之一,其难点源于机器人手极高的自由度(本文中为 20 个自由度)以及操作过程中大量富含接触(contact-rich)的交互。模仿学习(Imitation Learning, IL)虽然已经让机器人在运动控制和手臂操作上取得显著进展,但在灵巧操作上的进展相对滞后。作者将瓶颈明确定位于两个环节:示教数据采集与重定向(retargeting)——即如何精确记录人类自然的手部运动,并将其可靠地迁移到运动学、传感与接触特性均不相同的人形/机械手上。
1.1 现有示教采集方法的困境
论文系统梳理了三类主流采集路线及其“精度—自然度”的固有矛盾:
(1)基于视觉的手部追踪。此类方法(如手部姿态估计系统)不约束手部运动,示教自然流畅。但一旦手与物体发生实际接触,遮挡和时间抖动会显著降低数据质量。更关键的是,视觉系统通常把灵巧操作简化为末端执行器控制,精细的指间运动难以可靠恢复。
(2)基于手套的系统。配备惯性或弯曲传感器,可为交互式任务提供更可靠的运动数据,但存在皮肤运动伪影(skin-motion artifacts),且需要复杂的人手—机器人关节对应映射。
(3)外骨骼式设备。产生的手部姿态测量与机械约束下的手部运动完全一致,一致性最高,但硬件笨重、束缚性强,牺牲了操作员舒适度和示教吞吐量。
论文进一步指出一个深层问题:采集方式从根本上塑造了下游学习问题的形式。现有灵巧模仿学习流水线大多把“人类示教”和“机器人执行”当作两个独立的域,通过越来越复杂的重定向模型连接起来。近期外骨骼系统(如 DexUMI 系列)通过与目标机器人手协同设计缩小了对应差距——将关节编码器对齐到机器人自由度、把腕部相机装在机器人末端视角——但它们仍是从人手到机器人手的单向开环映射:重定向在自由空间(free space)中标定一次,在真实接触负载(摩擦、外力、关节耦合)下会退化;DexUMI 等还依赖生成式图像翻译(inpainting)弥合人—机视觉差异,机器人侧的测量本身却没有被用来改进对应学习。
1.2 核心思想:共享物理测量
SEED-UMI 的破题思路不是继续改进重定向算法,而是重新设计人与机器人本体之间的接口:让人类操作员和机器人灵巧手穿戴同一个外骨骼。由此产生两个关键性质:
这一转变把重定向从“开环标定”问题转化为配对跨本体监督学习(paired cross-embodiment supervision)问题。
二、系统总体框架(对应 Figure 1、Figure 3)
- Figure 1 展示了 SEED-UMI 的数据采集界面与任务集:上方为人类操作员与灵巧机器人手穿戴同一外骨骼的场景——示教和机器人回放通过同一物理设备记录,编码器匹配、腕部相机匹配;下方为五个代表性富接触任务:工具使用、小物体放置、抓取—抛掷时序控制、富接触桌面清理、多指驱动喷雾。
- Figure 3 给出完整流水线:人类通过共享外骨骼采集示教 → 配对机器人回放精化“编码器—指令”映射 → 学习到的策略在匹配的外骨骼中心观测下于机器人上回放执行。
三段式软件适配(第 4 节)+ 硬件共享设计(第 3 节)构成方法主体,实验(第 5 节)验证有效性。
三、硬件设计:一个共享的外骨骼(第 3 节)
硬件设计的总原则是:让人侧与机侧的接触面外骨骼几何与编码器坐标系完全匹配,而袖套和安装件按各自本体适配。由此,编码器读数成为共享的跨本体测量;同指令下的两侧编码器差异,即可监督残差的“指令—关节”映射。Figure 2 展示了同一外骨骼分别由人类操作员(左)和全驱动目标灵巧手(右)穿戴的情形:每个关节一个非接触式旋转编码器、背侧 T265 用于 6 自由度腕部跟踪、掌侧鱼眼相机,全部刚性固连在外骨骼框架上,保证编码器向量 e_t 和腕部相机内参在两侧本体上完全一致。
3.1 外骨骼机构设计
该外骨骼与单一全驱动灵巧手作为唯一目标平台协同设计。作者明确放弃了跨平台通用性,以换取两个更强的性质:
E.1 运动学同构骨架(Isomorphic kinematic skeleton)。目标手的每个主动自由度对应一个旋转关节,连杆长度与机器人指骨长度一致,关节轴朝向相同,硬限位复现机器人的运动范围。因此操作员能到达的位形恰好就是机器人能到达的位形。外骨骼共实现 5 指共 20 个独立测量的关节。
E.2 平行四连杆编码器走线(Parallel four-bar linkage)。若把编码器直接装在指间关节侧轴上,外壳会侵入侧向间隙包络、限制外展/内收范围,并遮挡部分掌面接触面,破坏共享几何性质。论文将旋转运动通过平行四连杆引至背侧安装的非接触式磁性编码器:连杆保持关节轴与编码器轴之间的一对一角度对应,同时掌面和侧面保持无遮挡(Figure 4 (a) 展示了设计在运动过程中的避碰效果,(b) 展示了连杆的工作过程)。连杆长度按手指逐一调优以最小化背部高度,各枢轴采用压装磁体组件与精密轴套轴承,保证反复穿戴下编码器对位稳定。
E.3 两侧完全相同的接触几何。人侧与机侧实例共享同一外部骨架:连杆长度、关节轴、背侧连杆、掌面指尖垫均一致,袖套与安装件只在不变更关节坐标系的前提下适配各自本体。因此两侧对物体呈现相同的外部接触几何,人—机编码器差异主要反映负载相关效应(接触力、摩擦、迟滞),这正是第 4 节残差映射学习所利用的信号。
3.2 传感器集成
所有传感器均安装在外骨骼框架上,使每个信号无论由哪一侧穿戴都记录在同一物理坐标系中。两个设计目标:(i) 捕获下游策略学习所需的动作与观测通道;(ii) 最小化这些通道在人侧与机侧之间的分布偏移。
S.1 关节编码器:每个主动关节集成非接触式磁性旋转编码器,人侧与机侧实例的编码器安装位置相同;拼接各关节读数得到 e_t ∈ ℝ²⁰。由于四连杆走线与制造公差,外骨骼编码器读数 e_t 到机器人关节指令 q_t 的映射是非线性的,因此用数据驱动模型学习(第 4 节)。
S.2 腕部相机:背侧 Intel RealSense T265 提供 6 自由度腕部位姿;掌腹侧鱼眼相机(150° 视场角)观察工作空间。二者均刚性固连于外骨骼,内参与“编码器系—相机系”外参在两侧固定不变。由于采集与回放使用同一“外骨骼—相机”组件,策略获得的原始观测 I_t 只需标准光度与裁剪增广。与 DexUMI 不同,这种硬件层对齐不需要手部分割或图像修复,保留了接触像素,这对精细操作至关重要。
四、软件适配:两阶段跨本体映射(第 4 节)
共享外骨骼给出共同的编码器信号 e_t ∈ ℝ²⁰,但机器人执行仍需"编码器→指令"映射 e_t ↦ q_t。SEED-UMI 不在自由空间一次拟合该映射,而是先用机器人电机乱动(motor babbling)自举,再在真实接触下的配对回放中精化。该映射是本体感觉(proprioceptive)层面的,而对齐的腕部图像专门留给策略学习。
M.1 机器人电机乱动(Motor babbling)。机器人穿戴外骨骼执行结构化探索协议:单关节扫掠、多速度耦合运动、若干自接触位形。记录机器人关节位置 q_t 与机侧编码器读数 e_t^®;历史向量 h_t 拼接前 K 帧编码器读数、有限差分编码器速度,以及每个关节的二值开/合方向指示。拟合初始映射:
f
θ
0
:
(
e
t
,
h
t
)
↦
q
t
f_{\\theta^0} : (\\mathbf{e}_t, \\mathbf{h}_t) \\mapsto \\mathbf{q}_t
fθ0:(et,ht)↦qt
该自由空间模型捕捉基本运动学与历史效应,但在接触下仍会漂移,由此引出 M.2。
M.2 配对回放与精调(Paired replay and fine-tuning)。人类操作员穿戴外骨骼执行代表性物体抓取动作,记录富接触编码器轨迹 {e_t^(h), h_t^(h)};将每条示教经 f_θ⁰ 在机器人上回放,并从机侧外骨骼记录 {e_t^®, h_t^®, q_t^®},构成配对映射数据集:
D
map
=
{
(
e
t
(
h
)
,
h
t
(
h
)
,
q
t
(
r
)
,
e
t
(
r
)
,
h
t
(
r
)
)
}
\\mathcal{D}_{\\text{map}} = \\{(e_t^{(h)}, h_t^{(h)}, q_t^{(r)}, e_t^{(r)}, h_t^{(r)})\\}
Dmap={(et(h),ht(h),qt(r),et(r),ht(r))}
定义从机器人指令与编码器历史到机侧编码器读数的前向模型 g_φ,将 f_θ 作为逆问题精调,损失函数为论文公式 (1):
L
map
=
∥
g
ϕ
(
f
θ
(
e
t
(
h
)
,
h
t
(
h
)
)
,
h
t
(
h
)
)
−
e
t
(
h
)
∥
2
2
+
β
∥
f
θ
(
e
t
(
h
)
,
h
t
(
h
)
)
−
q
t
(
r
)
∥
2
2
+
λ
∥
Δ
f
θ
∥
2
2
\\mathcal{L}_{\\text{map}} = \\left\\| g_{\\phi}\\big(f_{\\theta}(\\mathbf{e}_{t}^{(h)}, \\mathbf{h}_{t}^{(h)}), \\mathbf{h}_{t}^{(h)}\\big) – \\mathbf{e}_{t}^{(h)} \\right\\|_{2}^{2} + \\beta \\left\\| f_{\\theta}(\\mathbf{e}_{t}^{(h)}, \\mathbf{h}_{t}^{(h)}) – \\mathbf{q}_{t}^{(r)} \\right\\|_{2}^{2} + \\lambda \\left\\| \\Delta f_{\\theta} \\right\\|_{2}^{2}
Lmap=
gϕ(fθ(et(h),ht(h)),ht(h))−et(h)
22+β
fθ(et(h),ht(h))−qt(r)
22+λ∥Δfθ∥22
三项的物理含义分别是:(1) 前向一致性项——通过可学习的前向模型 g_φ,使“指令→预期编码器读数”与人类示教轨迹匹配;(2) 配对回放正则项——将指令向回放中实测的机器人指令 q_t^® 靠拢;(3) 时间平滑项——惩罚指令的跳变。整个"回放—精化"过程只需重复一次,即可把自由空间乱动模型变为接触鲁棒的编码器—指令函数,全程无需人工重新标定。
值得强调的方法论要点:配对回放阶段不假设初始回放能完美复现人类轨迹,而是把“人侧编码器轨迹”与“机侧编码器响应”之间的差异作为指令映射的修正信号——这正是"共享物理测量"思想最精妙的体现。
M.3 策略训练与回放。下游策略采用 ACT、Diffusion Policy(DP)与 π₀.₅ 三种骨干,输入为原始腕部观测 I_t 与编码器向量 e_t,输出长度为 L 的动作块(action chunk),包含 6 自由度腕部动作与 20 自由度手部指令。所有策略训练只用人类采集的真实数据:不涉及仿真、强化学习、手部分割或生成式图像修复。
定性研究(Figure 6):以 AirPods 插入任务对比 SEED-UMI 与遥操作的回放质量(图中蓝色为人类侧、橙色为机器人侧编码器轨迹)。SEED-UMI 采集时操作员直接执行插入动作,可凭借即时视觉与物理反馈调节精细接触;遥操作则把操作员与物体接触隔离开,回放容易“过驱动”、施加过大力,可能损坏易碎物体。这解释了 SEED-UMI 在精确富接触示教上优于遥操作的原因。
五、实验评估(第 5 节)
5.1 实验设置
硬件平台:RealMan RX75 机械臂 + 无极(Wuji)灵巧手,每指 4 个主动自由度,共 20 个;人侧与机侧穿戴第 3 节所述共享外骨骼;背侧 T265 提供 6-DoF 腕部位姿,掌腹侧 150° 鱼眼相机提供策略观测;腕部轨迹采用固定的 T265-工具中心点(TCP)对齐,不做轨迹修正。
五个真实任务(Figure 5 展示了策略回放场景),覆盖工具稳定、食指—中指协调、抓放时序、持续接触与拇指参与的多指驱动:
三种对比条件:
- 遥操作(T):操作员穿戴外骨骼,编码器读数实时映射为机器人手电机指令;策略在机侧记录的示教上训练;
- P⁻(无配对精调):策略在人侧示教上训练,部署时仅用乱动映射 f_θ⁰;
- P⁺(有配对精调):策略在人侧示教上训练,部署用 SEED-UMI 完整流水线精化后的映射 f_θ。
训练与标定数据:每策略每任务 100 条示教,初始物体位置在任务特定范围内随机化;配对精调用 250 条标定回合(5 种尺寸、形状、刚度、抓取类型各异的物体各 50 条),每条标定回合将同一物体刚性固定在桌面某一位姿:人先抓握,机器人随后经 f_θ⁰ 回放该动作。P⁻ 与 P⁺ 的策略学习仅使用人侧示教。
评估协议:三种骨干(ACT、DP、π₀.₅)× 三种条件 × 每任务组合进行 20 次自主机器人回放,报告完成主动作序列的百分比。喷雾任务的成功定义为稳固抓握且明确发起向下按压(因手部驱动力限制,不要求按压到底或实际喷出)。采集效率对比:同一操作员在 30 分钟窗口内采集成功的 AirPods 示教条数,且不计入一次性的配对回放与优化开销。
5.2 主要结果(Table 1)
论文核心表格如下(成功率为 20 次自主回放的百分比;T = 机侧遥操作示教训练;P⁻ = SEED-UMI 无配对精调;P⁺ = SEED-UMI 有配对精调):
| ACT | 80.0 | 55.0 | 70.0 | 65.0 | 65.0 | 75.0 | 60.0 | 60.0 | 70.0 | 75.0 | 50.0 | 65.0 | 90.0 | 70.0 | 85.0 |
| DP | 65.0 | 40.0 | 55.0 | 55.0 | 55.0 | 60.0 | 50.0 | 50.0 | 55.0 | 60.0 | 40.0 | 55.0 | 70.0 | 45.0 | 60.0 |
| π₀.₅ | 90.0 | 60.0 | 80.0 | 75.0 | 75.0 | 85.0 | 70.0 | 70.0 | 80.0 | 85.0 | 60.0 | 75.0 | 85.0 | 65.0 | 80.0 |
5.3 关键发现
F1:SEED-UMI 在精细与动态任务上更优。所有任务与骨干平均:遥操作 71.7%,P⁺ 70.0%,P⁻ 57.3%。配对精调几乎保留了机侧数据的全部质量,同时把机器人从人类采集环节中完全移除。任务层面的模式更有信息量:P⁺ 在 AirPods 插入(73.3% vs 65.0%)和抛球(68.3% vs 60.0%)上超过遥操作基线——而这正是实时遥操作最不自然的场景,因为小的姿态修正和快速的抓—放时序很难通过带延迟的机器人控制回路完成。
F2:配对精调在接触负载下作用最大。P⁻→P⁺ 的平均提升为 +12.7 个百分点,且集中于接触负载主导的任务:拧螺丝 +16.7、桌面清理 +15.0、喷雾 +15.0。这与预期吻合:仅乱动训练的 f_θ⁰ 在自由空间训练,在手指柔顺受力下漂移;配对回放损失(公式 1)恰好修正的正是这一失效区间。
F3:SEED-UMI 采集效率显著高于遥操作(Figure 7 展示效率—质量权衡)。在 30 分钟窗口内的 AirPods 任务上,同一操作员经遥操作采集了 18 条成功示教,经 SEED-UMI 采集了 52 条,吞吐量约 3.0 倍。由于 P⁺ 与遥操作的回放成功率几乎持平(70.0% vs 71.7%),按成功率归一化后每分钟有效训练数据的增益仍约 2.9 倍。SEED-UMI 的实践价值不在于以牺牲数据质量换速度,而在于把人类示教与实时机器人执行解耦,同时由配对精调弥补几乎全部质量差距。
六、结论、局限与评述
6.1 结论
论文提出了 SEED-UMI——以共享外骨骼为人—机示教接口的规模化高效数据采集与策略学习框架。通过让人与机器人穿戴同一机构,SEED-UMI 借助配对编码器监督把自然的富接触人类动作迁移为机器人动作,同时保持对齐的原始腕部观测。在具有挑战性的真实世界实验中,达到 70.0% 平均成功率,数据采集速度较遥操作快 3.0 倍,确立了遥操作之外大规模采集真实灵巧手数据的新途径。
6.2 局限性
作者坦诚指出:系统尚未对不同灵巧手完全自动化——适配不同的连杆布局、关节限位与驱动范围,仍需在外骨骼几何、标定动作与配对回归目标上做工程决策;操作员穿戴外骨骼会影响穿戴性、穿脱时间与长时程/精细操作的便利性。未来方向包括:跨手型设计自动化、改善穿戴体验、引入触觉传感以更精确估计接触。
6.3 评述(个人分析)
从方法论看,本文最重要的贡献是视角转换:与其在“人手域→机器人域”之间堆叠更复杂的重定向模型,不如让接口本身成为共享测量仪器,把重定向转化为有监督逆问题。三点尤为出色:
局限方面,单手型定制设计(放弃跨平台性)是其获得强性质的前提,也是推广的主要成本;此外前向模型 g_φ 与逆映射 f_θ 均为数据驱动,极端负载工况下的泛化尚待检验。对从事储能电站运行控制与能量管理的研究者而言,这种“通过共享物理接口将开环标定问题转化为配对监督学习”的思路,与储能系统中"数字孪生 + 实测偏差修正控制参数"的范式有内在相通之处,具有跨领域的启发价值。