MediaPipe人体感知全指南:手部检测、手势识别与Face Mesh
本文将全面讲解Google MediaPipe框架在人体感知领域的应用,涵盖21点手部检测、0-10手势识别、478点Face Mesh人脸网格以及33点人体姿态检测,从原理到代码实战一网打尽。
Part 1: MediaPipe概述
1.1 MediaPipe简介
MediaPipe是Google开源的跨平台机器学习框架,专门用于构建实时多模态感知应用。它将复杂的机器学习模型封装为简单易用的高层API,开发者无需深入理解模型细节即可快速实现人体感知功能。
MediaPipe的核心优势:
- 跨平台:支持Windows、Linux、macOS、Android、iOS和Web
- 实时性:模型经过深度优化,在普通CPU上即可实现实时推理
- 多模态:一个框架覆盖手势、人脸、姿态、头发分割、目标检测等多种任务
- 易用性:Python API极其简洁,几行代码即可完成复杂的人体感知任务
1.2 MediaPipe解决方案生态
下图展示了MediaPipe的主要解决方案生态,覆盖了从手部到全身的各类感知任务:
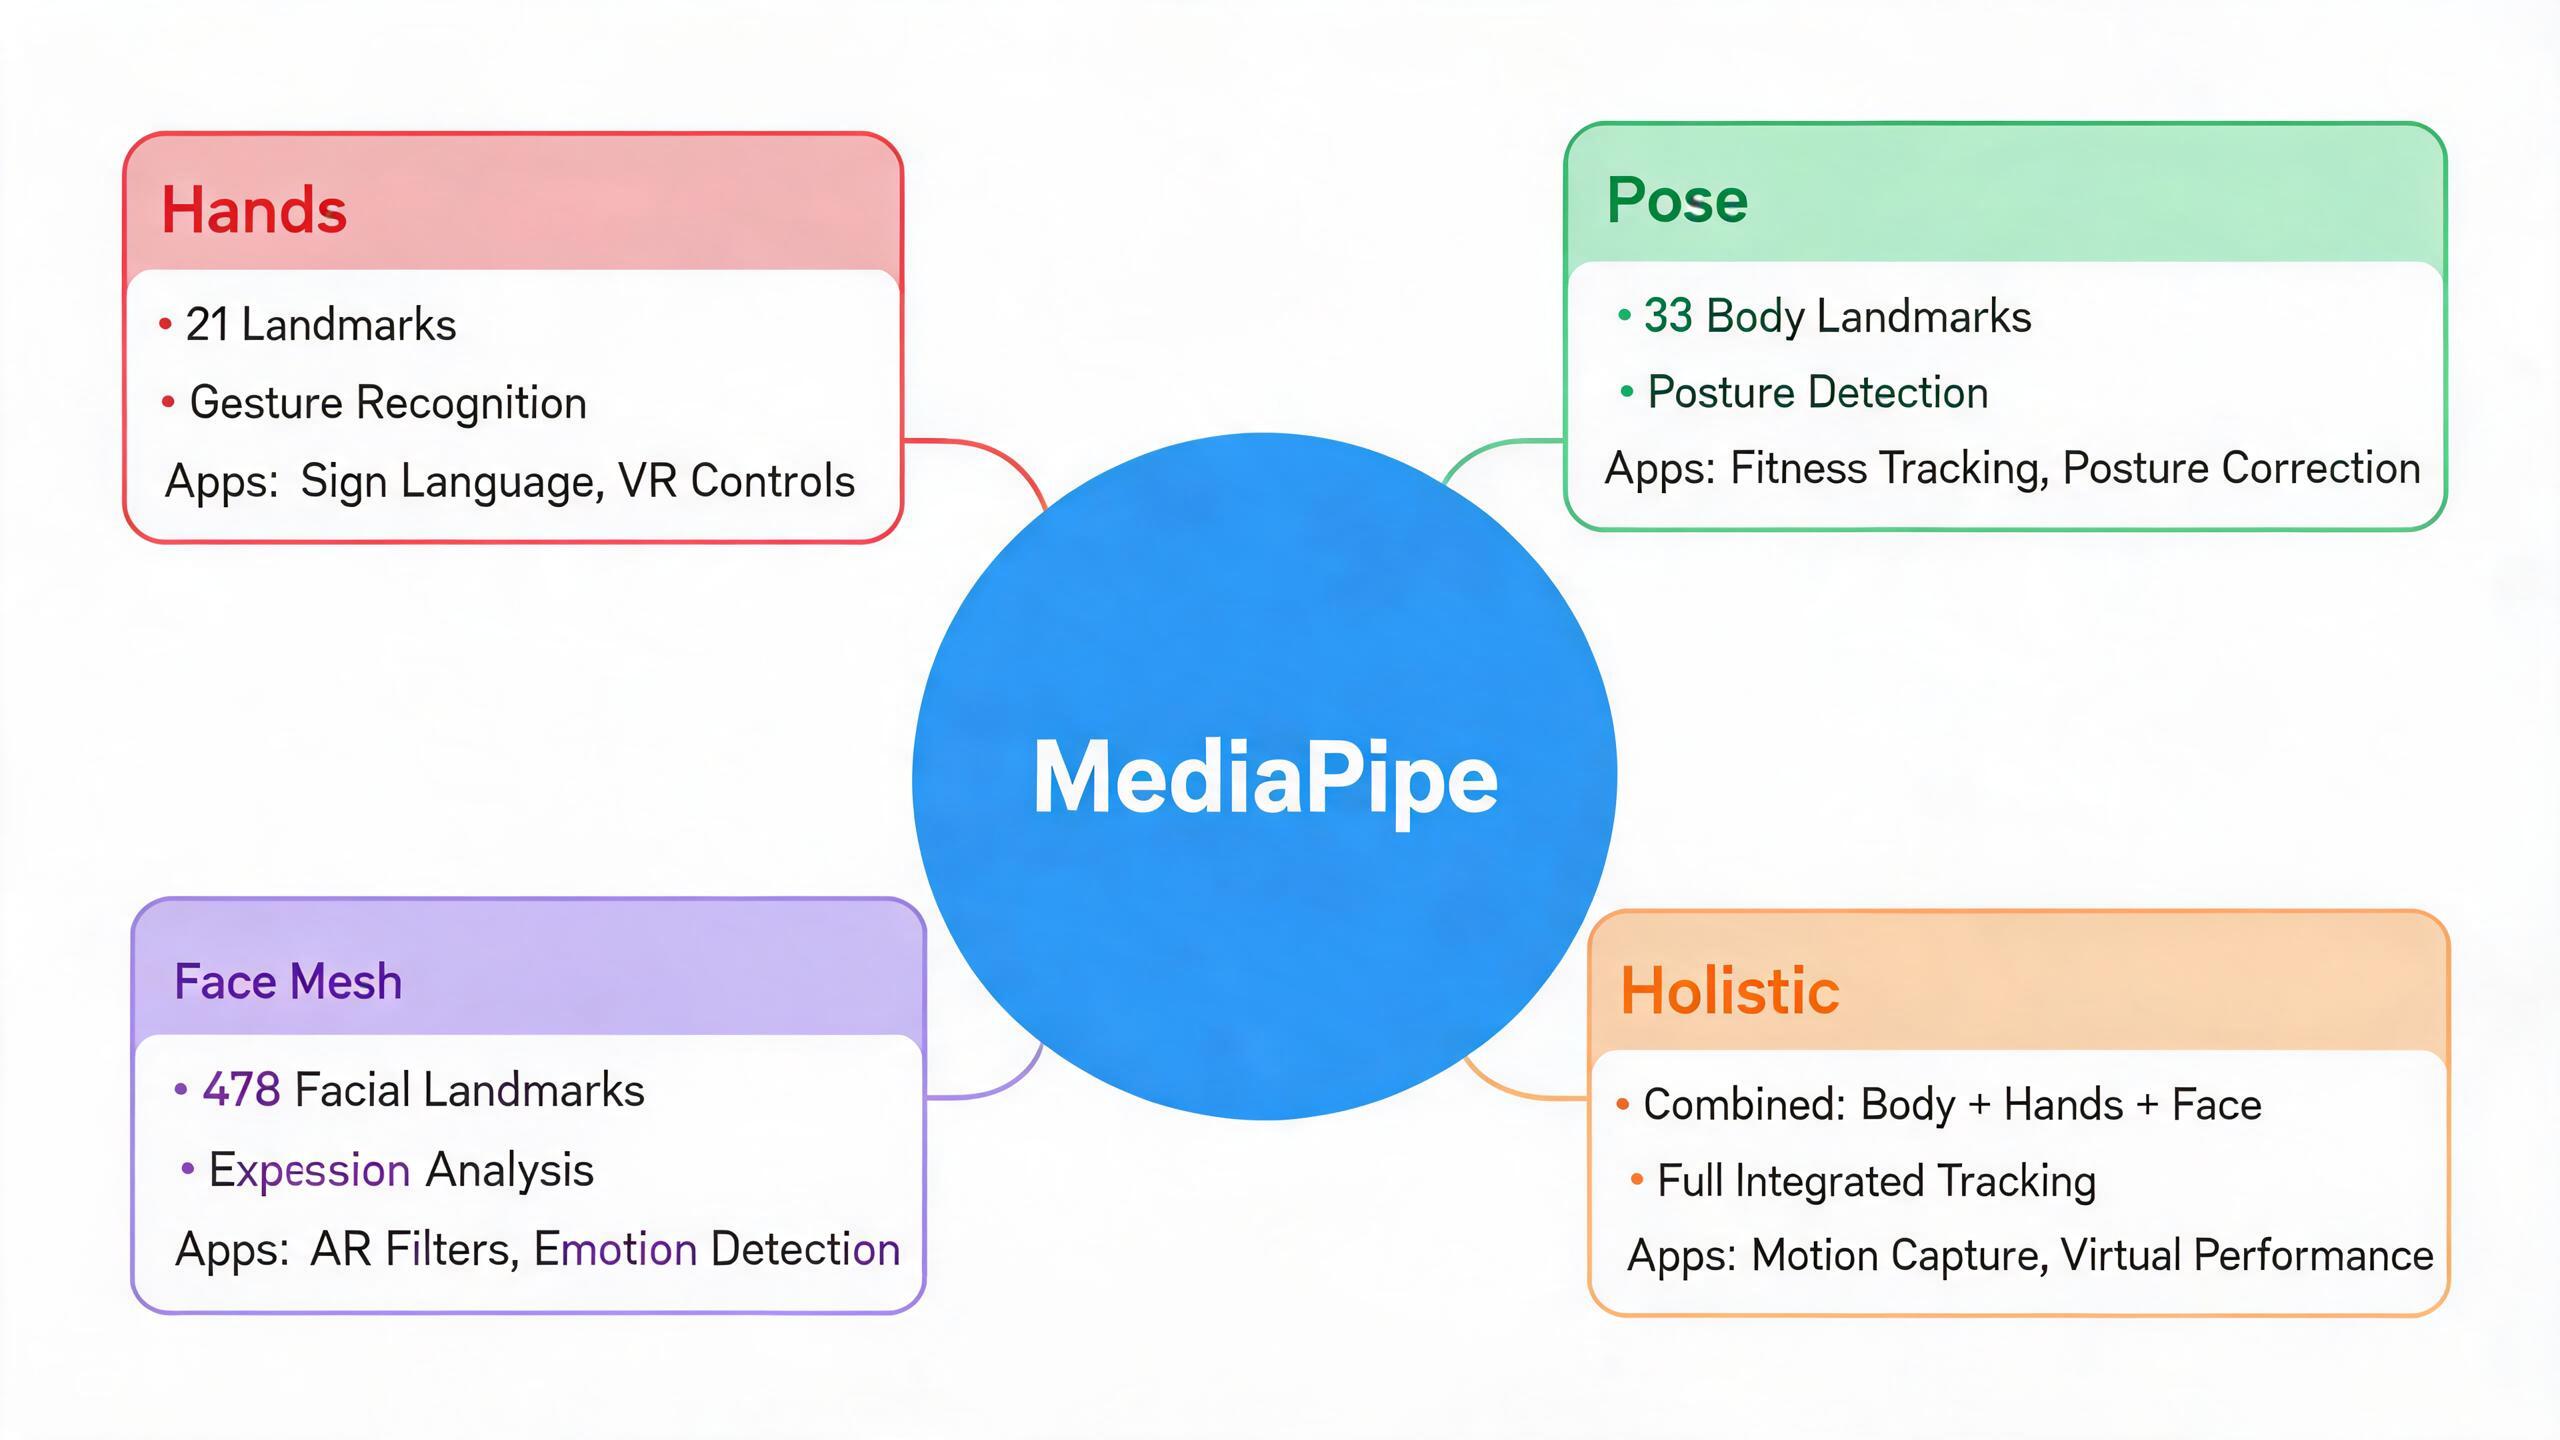
MediaPipe提供的核心解决方案包括:
- Hands:21关键点手部检测与跟踪
- Face Mesh:478点高精度人脸网格
- Pose:33点人体姿态估计
- Face Detection:人脸检测
- Objectron:3D物体检测
- Selfie Segmentation:人像分割
1.3 安装
pip install mediapipe==0.10.21
版本说明:建议安装指定版本 0.10.21,该版本经过充分测试,API稳定。不同版本之间API可能有细微差异。
Part 2: 手部检测(21关键点)
2.1 21个手部关键点详解
MediaPipe的手部检测模型能够识别每只手的21个关键点,覆盖手腕、拇指、食指、中指、无名指和小指的全部关节。下图展示了21个关键点的分布:
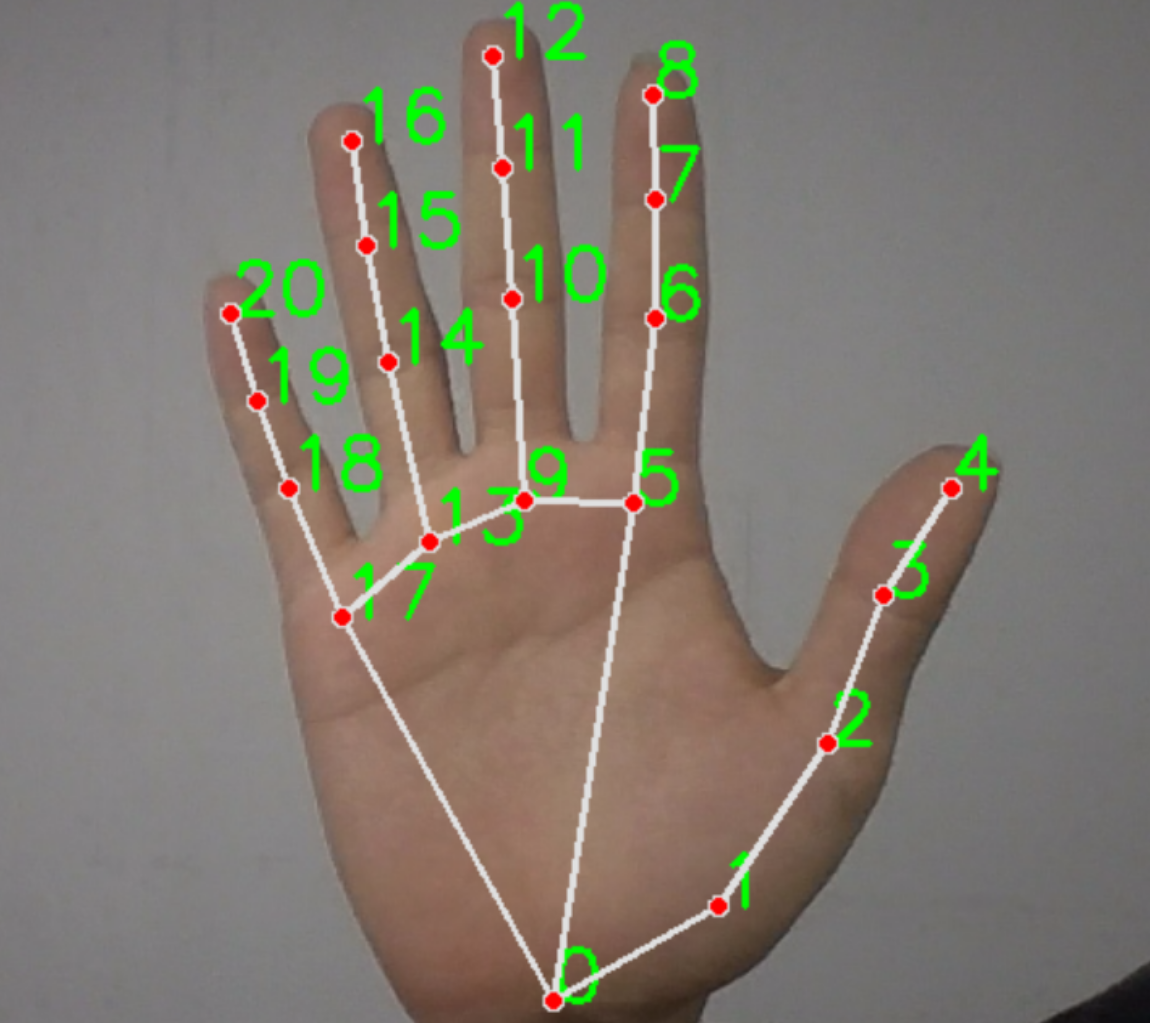
21个关键点的编号含义如下:
| 0 | 手腕 | 11 | 中指根部 |
| 1 | 拇指根部 | 12 | 中指第一关节 |
| 2 | 拇指第一关节 | 13 | 中指第二关节 |
| 3 | 拇指第二关节 | 14 | 中指尖 |
| 4 | 拇指尖 | 15 | 无名指根部 |
| 5 | 食指根部 | 16 | 无名指第一关节 |
| 6 | 食指第一关节 | 17 | 无名指第二关节 |
| 7 | 食指第二关节 | 18 | 无名指尖 |
| 8 | 食指尖 | 19 | 小指根部 |
| 9 | 中指根部 | 20 | 小指尖 |
记忆技巧:每根手指的编号从根部(靠近手掌)到指尖依次递增。拇指:1→2→3→4;食指:5→6→7→8;中指:9→10→11→12→13→14(注意中指有5个点);无名指:15→16→17→18;小指:19→20(实际为19→20,完整链路为15-18模式类似)。
2.2 mp_hands.Hands()参数详解
mp_hands.Hands(
static_image_mode=False,
max_num_hands=2,
min_detection_confidence=0.75,
min_tracking_confidence=0.75
)
| static_image_mode | 静态/动态模式 | True/False | False | True适合静态图片,False适合视频流。False时优先使用跟踪(更高效),True时每帧都重新检测 |
| max_num_hands | 最大检测手数 | 正整数 | 2 | 限制同时检测的手数量。设为1时只检测一只手 |
| min_detection_confidence | 最小检测置信度 | [0.0, 1.0] | 0.5 | 值越小越容易检测到手,但准确度下降;值越大越精准但可能漏检 |
| min_tracking_confidence | 最小跟踪置信度 | [0.0, 1.0] | 0.5 | 控制帧间跟踪的严格程度。值越大跟踪越稳定但可能丢失 |
static_image_mode 关键区别:设为False时,若检测到的手数超过max_num_hands,超出部分不会识别,系统自动跟踪之前识别的手;设为True时,每帧独立检测,超出的手会在多帧之间闪烁。
2.3 手部检测代码实战
import cv2
import mediapipe as mp
# 初始化绘图工具和手部检测模块
# drawing_utils:将检测到的关键点和连线绘制到图像上
# drawing_style:定义绘制风格(颜色、线宽等)
# hands:MediaPipe的手部识别模块
mp_drawing = mp.solutions.drawing_utils
mp_hands = mp.solutions.hands
# 创建手部检测器实例
hands = mp_hands.Hands(
static_image_mode=False, # 动态模式(视频流),优先使用跟踪
max_num_hands=2, # 最多检测2只手
min_detection_confidence=0.75, # 检测置信度阈值设为0.75(较高精度)
min_tracking_confidence=0.75) # 跟踪置信度阈值设为0.75
# 打开摄像头(0表示默认摄像头)
cap = cv2.VideoCapture(0)
while True:
ret, frame = cap.read() # 读取一帧画面
h, w = frame.shape[:2] # 获取画面宽高(用于坐标转换)
# MediaPipe需要RGB格式输入,OpenCV默认读取为BGR
frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
# 水平翻转画面(摄像头是镜像的,翻转后更自然)
frame = cv2.flip(frame, 1)
# 执行手部检测
results = hands.process(frame)
# 转回BGR格式用于OpenCV显示
frame = cv2.cvtColor(frame, cv2.COLOR_RGB2BGR)
# 如果检测到手
if results.multi_hand_landmarks:
for hand_landmarks in results.multi_hand_landmarks:
# 遍历21个关键点,打印坐标并标注编号
for i in range(len(hand_landmarks.landmark)):
x = hand_landmarks.landmark[i].x # 归一化x坐标(0~1)
y = hand_landmarks.landmark[i].y # 归一化y坐标(0~1)
z = hand_landmarks.landmark[i].z # 相对深度(z越小越靠近相机)
print(f'关键点{i}:', x, y, z)
# 在画面上标注关键点编号(转换为像素坐标)
cv2.putText(frame, str(i),
(int(x * w), int(y * h)),
cv2.FONT_HERSHEY_SIMPLEX, 1, (0, 255, 0), 2)
# 使用MediaPipe内置函数绘制关键点和连线
# HAND_CONNECTIONS定义了21个关键点之间的连接关系
mp_drawing.draw_landmarks(frame,
hand_landmarks,
mp_hands.HAND_CONNECTIONS)
cv2.imshow('MediaPipe Hands', frame)
if cv2.waitKey(1) & 0xFF == 27: # 按ESC退出
break
cap.release()
cv2.destroyAllWindows()
2.4 手部检测结果
下图展示了手部检测的实际效果,可以看到21个关键点和连接线被准确标注在手部:
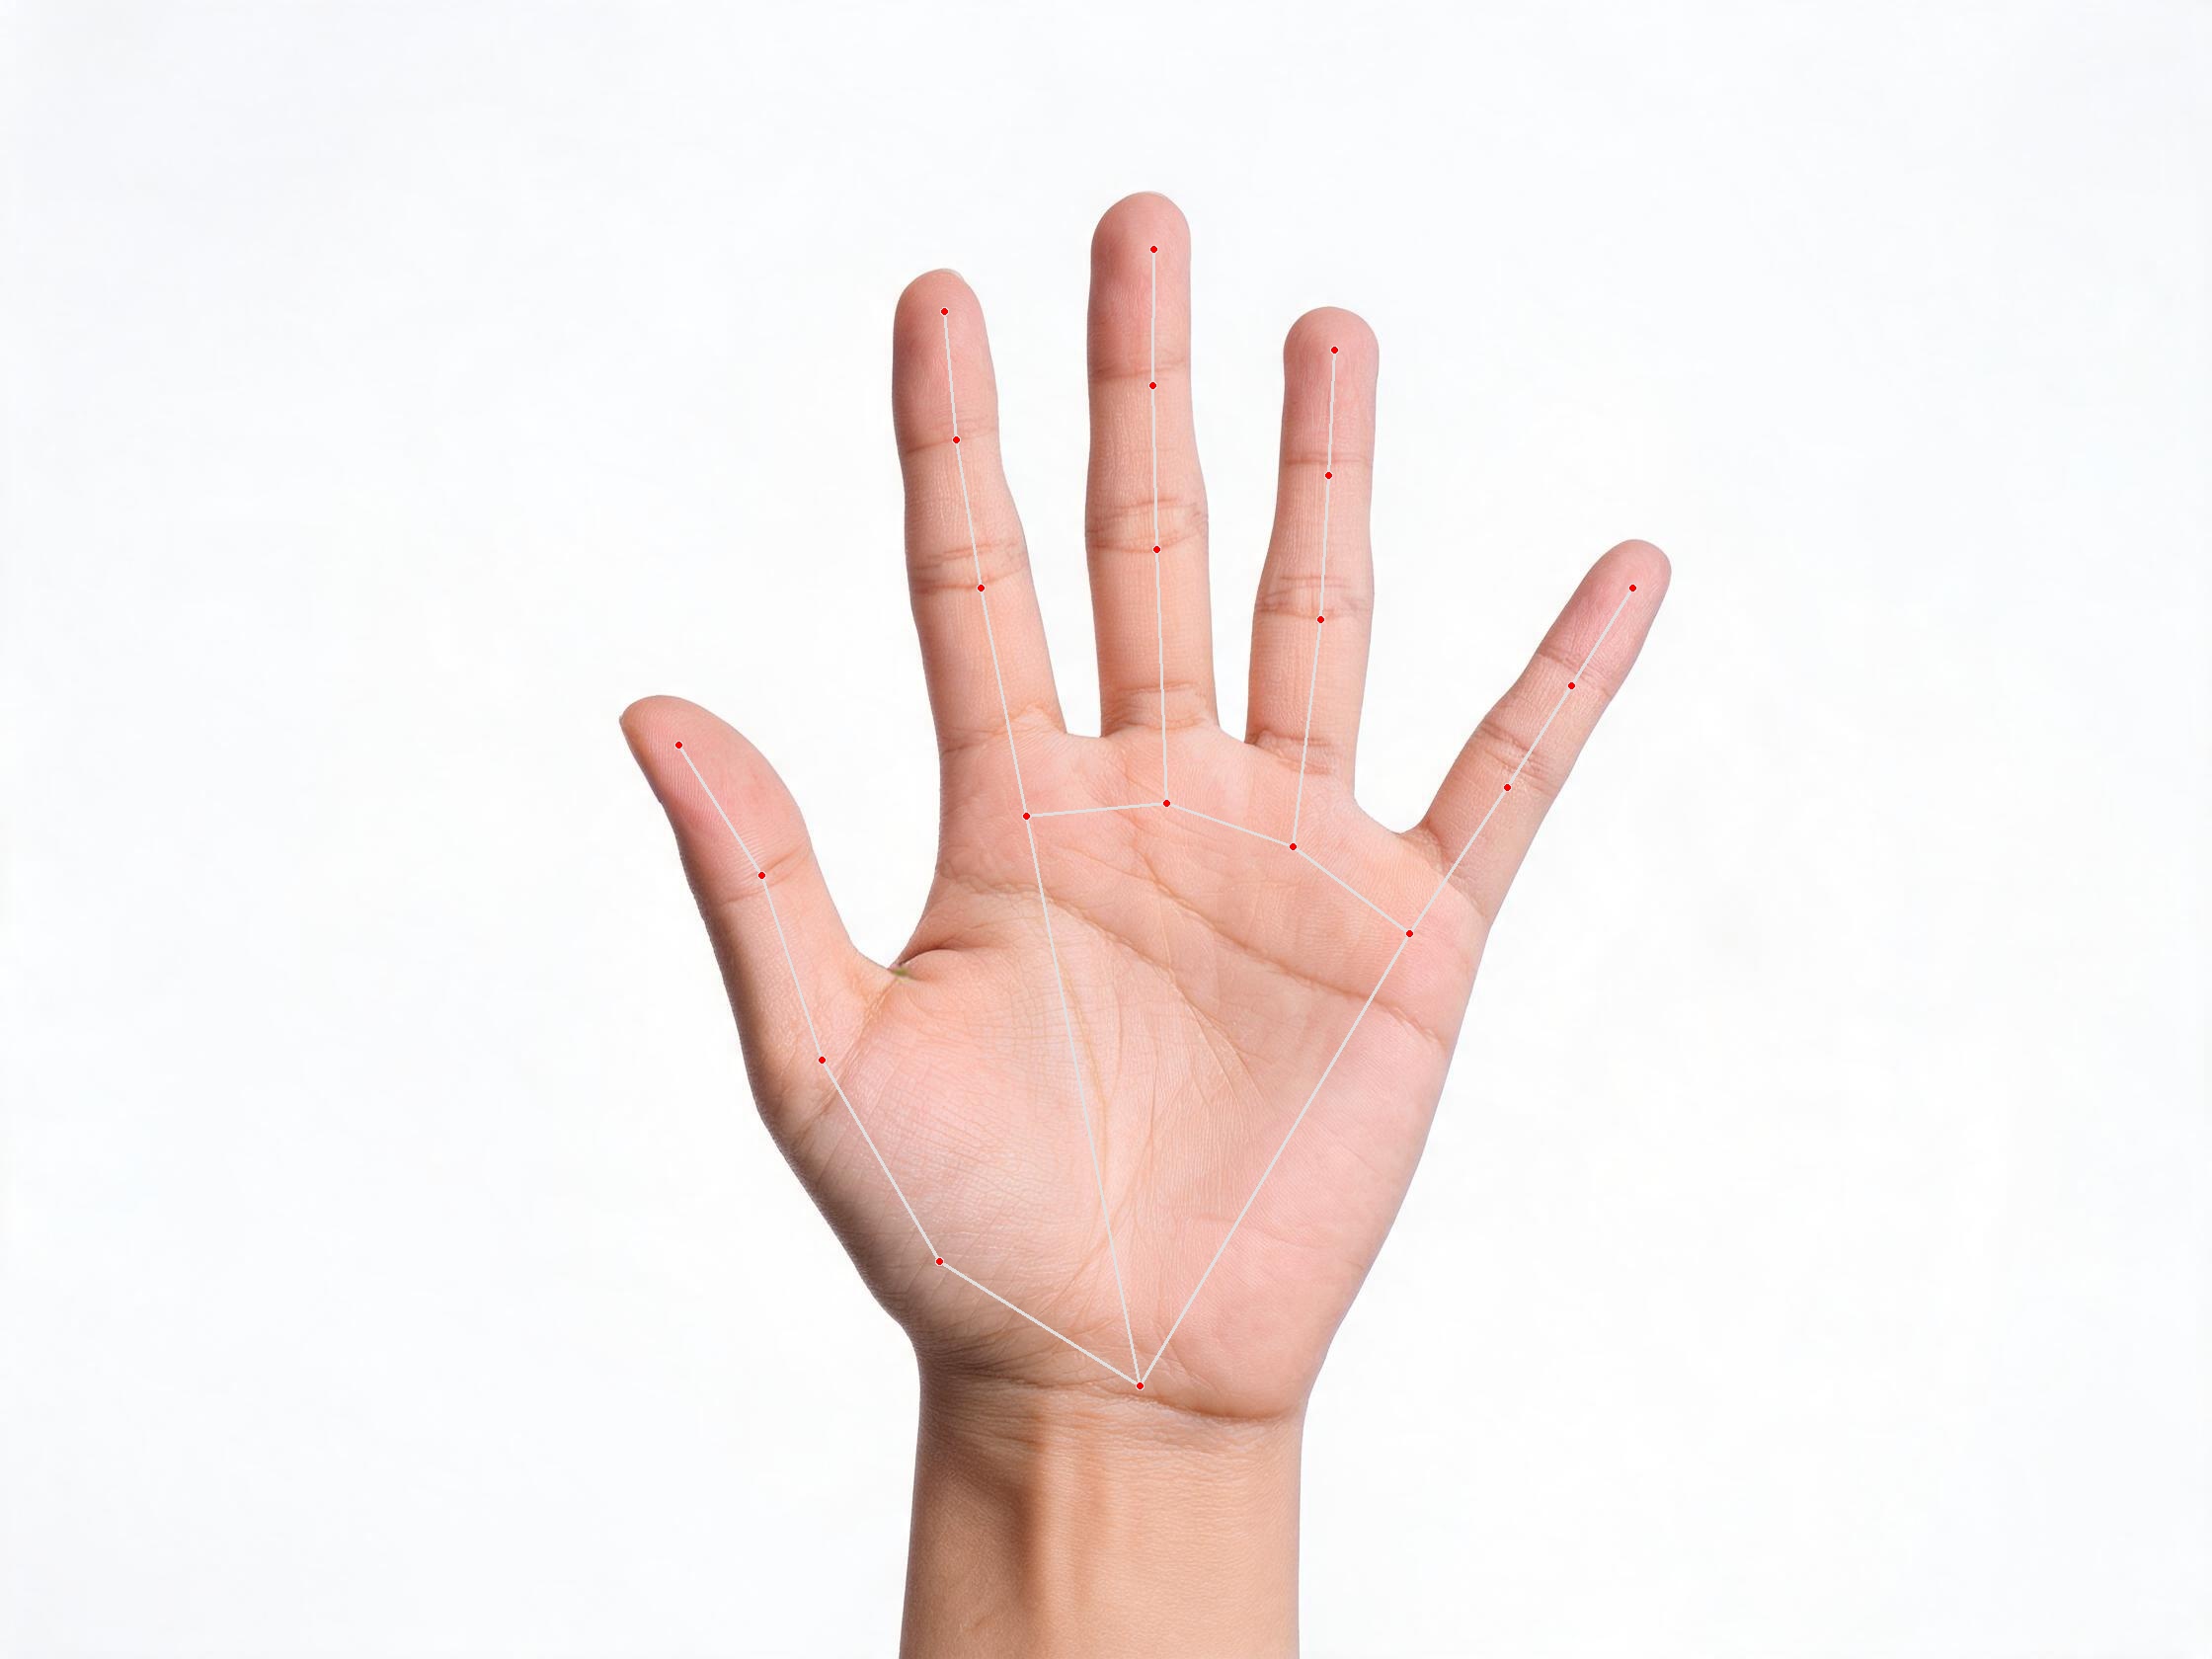
程序运行后的真实输出(关键点坐标为归一化值,范围0~1):
检测到 1 只手
关键点0: x=0.5154, y=0.8353, z=0.0000
关键点1: x=0.4249, y=0.7602, z=-0.0414
关键点2: x=0.3718, y=0.6389, z=-0.0573
关键点3: x=0.3445, y=0.5276, z=-0.0705
关键点4: x=0.3071, y=0.4490, z=-0.0834
…
输出解析:
- 关键点0(手腕)的z值为0.0000,因为它是深度基准点
- 其他关键点的z值为负,表示它们比手腕更靠近相机
- x、y坐标为归一化值(0~1),乘以画面宽高即可得到像素坐标
Part 3: 手势识别(数字0-10)
3.1 手势识别原理
手势识别的核心思想是通过关键点之间的距离来判断每根手指是否处于伸直状态,进而统计伸直的手指数量来识别数字手势。
判断逻辑基于以下观察:
- 手指伸直时:指尖(如关键点8)到手腕(关键点0)的距离较大
- 手指弯曲时:指尖到手腕的距离较小
3.2 基准距离计算
不同人、不同距离下,关键点之间的绝对距离差异很大,因此需要定义一个基准距离来标准化:
# 以关键点0(手腕)到关键点5(食指根部)的距离作为基准
# 这个距离反映手掌的大小,用于消除远近和手大小的影响
p0_x = hand_landmarks.landmark[0].x
p0_y = hand_landmarks.landmark[0].y
p5_x = hand_landmarks.landmark[5].x
p5_y = hand_landmarks.landmark[5].y
distance_0_5 = pow(p0_x – p5_x, 2) + pow(p0_y – p5_y, 2) # 平方距离(省去开方)
base = distance_0_5 / 0.6 # 除以0.6作为基准(经验值,可调节)
为什么除以0.6? 这是一个经验系数,使得 base 的值恰好位于"手指伸直距离"和"手指弯曲距离"之间,作为判断阈值。实际应用中可以根据效果微调。
3.3 手指伸直判断逻辑
四指(食指、中指、无名指、小指)的判断:
# 食指:指尖(8)到手腕(0)的距离 > 基准距离 → 伸直
p8_x = hand_landmarks.landmark[8].x
p8_y = hand_landmarks.landmark[8].y
distance_0_8 = pow(p0_x – p8_x, 2) + pow(p0_y – p8_y, 2)
if distance_0_8 > base:
flag += 1 # 食指伸直,计数+1
# 中指、无名指、小指同理(关键点12、16、20)
拇指的特殊判断:
# 拇指的判断逻辑不同:用拇指尖(4)到食指根部(5)的距离
# 因为拇指的运动方向与其他手指不同,不能用手腕距离来判断
p4_x = hand_landmarks.landmark[4].x
p4_y = hand_landmarks.landmark[4].y
distance_5_4 = pow(p5_x – p4_x, 2) + pow(p5_y – p4_y, 2)
if distance_5_4 > base * 0.3: # 拇指阈值系数更小(0.3)
flag += 1 # 拇指伸直,计数+1
拇指判断的特殊性:拇指的运动方向与其他手指垂直,距离手腕的距离不能有效区分伸直/弯曲状态。改用拇指尖到食指根部的距离,并使用更小的阈值系数0.3。
3.4 手势识别完整代码
import cv2
import mediapipe as mp
# 手势标签:0-10对应的英文数字
# flag的值(0~10)直接索引到对应的标签
gesture = ["none", "one", "two", "three", "four", "five",
"six", "seven", "eight", "nine", "ten"]
flag = 0 # 当前伸直手指数(0~10)
mp_drawing = mp.solutions.drawing_utils
mp_hands = mp.solutions.hands
hands = mp_hands.Hands(
static_image_mode=False,
max_num_hands=2,
min_detection_confidence=0.75,
min_tracking_confidence=0.75)
cap = cv2.VideoCapture(0)
while True:
flag = 0 # 每帧重置计数器
ret, frame = cap.read()
frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
frame = cv2.flip(frame, 1) # 水平翻转(镜像)
results = hands.process(frame)
frame = cv2.cvtColor(frame, cv2.COLOR_RGB2BGR)
if results.multi_hand_landmarks:
for hand_landmarks in results.multi_hand_landmarks:
# ===== 计算基准距离(手腕0到食指根部5)=====
p0_x = hand_landmarks.landmark[0].x
p0_y = hand_landmarks.landmark[0].y
p5_x = hand_landmarks.landmark[5].x
p5_y = hand_landmarks.landmark[5].y
distance_0_5 = pow(p0_x – p5_x, 2) + pow(p0_y – p5_y, 2)
base = distance_0_5 / 0.6 # 基准距离
# ===== 拇指判断(尖4到根5的距离)=====
p4_x = hand_landmarks.landmark[4].x
p4_y = hand_landmarks.landmark[4].y
distance_5_4 = pow(p5_x – p4_x, 2) + pow(p5_y – p4_y, 2)
# ===== 食指判断(尖8到手腕0的距离)=====
p8_x = hand_landmarks.landmark[8].x
p8_y = hand_landmarks.landmark[8].y
distance_0_8 = pow(p0_x – p8_x, 2) + pow(p0_y – p8_y, 2)
# ===== 中指判断(尖12到手腕0)=====
p12_x = hand_landmarks.landmark[12].x
p12_y = hand_landmarks.landmark[12].y
distance_0_12 = pow(p0_x – p12_x, 2) + pow(p0_y – p12_y, 2)
# ===== 无名指判断(尖16到手腕0)=====
p16_x = hand_landmarks.landmark[16].x
p16_y = hand_landmarks.landmark[16].y
distance_0_16 = pow(p0_x – p16_x, 2) + pow(p0_y – p16_y, 2)
# ===== 小指判断(尖20到手腕0)=====
p20_x = hand_landmarks.landmark[20].x
p20_y = hand_landmarks.landmark[20].y
distance_0_20 = pow(p0_x – p20_x, 2) + pow(p0_y – p20_y, 2)
# ===== 统计伸直的手指数量 =====
if distance_0_8 > base: # 食指伸直
flag += 1
if distance_0_12 > base: # 中指伸直
flag += 1
if distance_0_16 > base: # 无名指伸直
flag += 1
if distance_0_20 > base: # 小指伸直
flag += 1
if distance_5_4 > base * 0.3: # 拇指伸直(特殊阈值)
flag += 1
if flag >= 10: # 上限保护(最多10)
flag = 10
# 绘制关键点和连线
mp_drawing.draw_landmarks(frame,
hand_landmarks,
mp_hands.HAND_CONNECTIONS)
# 在画面左上角显示当前手势对应的数字
cv2.putText(frame, gesture[flag], (50, 50), 0, 1.3, (0, 0, 255), 3)
cv2.imshow('MediaPipe Hands', frame)
if cv2.waitKey(1) & 0xFF == 27: # ESC退出
break
cap.release()
cv2.destroyAllWindows()
3.5 手势识别预期效果
摄像头预期效果:运行程序后,摄像头实时捕获手部画面。当伸出不同数量的手指时,画面左上角会以红色文字显示对应的英文数字(none, one, two, …, ten)。
- 伸出0根手指(握拳):显示 “none”
- 伸出1根手指(食指):显示 “one”
- 伸出5根手指(张开手掌):显示 “five”
- 双手各出5指:显示 “ten”
关键点和骨骼连线实时绘制在手上,随手指动作动态变化。
Part 4: Face Mesh(478点人脸网格)
4.1 478点Face Mesh vs dlib 68点
MediaPipe的Face Mesh提供了远超dlib 68关键点的面部检测精度:
| 关键点数量 | 68 | 478 |
| 眼部细节 | 6点/眼(轮廓) | 多区域精细点(含虹膜) |
| 嘴部细节 | 13点(内外唇) | 多区域精细点 |
| 面部网格 | 无(仅散点) | 三角网格拓扑 |
| 虹膜检测 | 不支持 | 支持(refine_landmarks=True) |
| 实时性 | 快 | 快(CPU可实时) |
| 3D信息 | 2D坐标 | 3D坐标(含z值) |
| 模型需求 | 需下载.dat模型 | 内置(无需额外模型) |
478个关键点覆盖了面部的所有细微区域,包括:
- 眼睛轮廓和虹膜边界
- 嘴唇内外轮廓
- 鼻翼和鼻孔
- 面颊、额头、下巴的密集网格
- 眉毛上下边缘
4.2 FaceMesh参数详解
face_mesh = mp_face_mesh.FaceMesh(
static_image_mode=False, # False=视频流模式(优先跟踪)
max_num_faces=2, # 最多检测2张脸
refine_landmarks=True, # 启用精细关键点(虹膜检测)
min_detection_confidence=0.5, # 检测置信度阈值
min_tracking_confidence=0.5 # 跟踪置信度阈值
)
refine_landmarks=True 的作用:
这是一个非常关键的参数。设为True时,模型会在基础Face Mesh之外额外检测虹膜边界关键点,使总关键点数从468增加到478。多出的10个点包括左右眼各5个虹膜边界点,可以用于:
- 视线方向估计
- 瞳孔位置追踪
- 注意力检测
- 眼动交互
4.3 Face Mesh代码实战
import cv2
import mediapipe as mp
# 初始化MediaPipe模块
mp_face_mesh = mp.solutions.face_mesh
mp_drawing = mp.solutions.drawing_utils
mp_drawing_styles = mp.solutions.drawing_styles
# 创建Face Mesh实例
face_mesh = mp_face_mesh.FaceMesh(
static_image_mode=False, # 视频流模式
max_num_faces=2, # 最多检测2张脸
refine_landmarks=True, # 启用精细关键点(虹膜检测)
min_detection_confidence=0.5, # 检测置信度阈值
min_tracking_confidence=0.5 # 跟踪置信度阈值
)
# 打开摄像头
cap = cv2.VideoCapture(0)
while cap.isOpened():
success, frame = cap.read()
h, w = frame.shape[:2]
if not success:
print("无法读取摄像头画面")
break
# 转换为RGB格式(MediaPipe输入要求)
frame_rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
# 执行Face Mesh检测
results = face_mesh.process(frame_rgb)
# 如果检测到人脸
if results.multi_face_landmarks:
for face_landmarks in results.multi_face_landmarks:
# 遍历所有478个关键点
for i in range(len(face_landmarks.landmark)):
x = face_landmarks.landmark[i].x # 归一化x坐标
y = face_landmarks.landmark[i].y # 归一化y坐标
# 在画面上标注关键点编号(字体很小,因为点很多)
cv2.putText(frame, str(i),
(int(x * w), int(y * h)),
cv2.FONT_HERSHEY_SIMPLEX, 0.3,
(0, 255, 0), 1)
# 使用MediaPipe内置函数绘制人脸网格
# FACEMESH_TESSELATION定义了478个点之间的三角网格连接
# 使用默认的网格绘制风格(半透明三角网格效果)
mp_drawing.draw_landmarks(
image=frame,
landmark_list=face_landmarks,
connections=mp_face_mesh.FACEMESH_TESSELATION,
landmark_drawing_spec=None, # 不单独绘制关键点
connection_drawing_spec=mp_drawing_styles.get_default_face_mesh_tesselation_style()
)
# 显示结果
cv2.imshow('Face Mesh', frame)
if cv2.waitKey(1) == 27: # ESC退出
break
cap.release()
cv2.destroyAllWindows()
4.4 Face Mesh运行结果
下图展示了Face Mesh的实际检测效果,可以看到478个关键点构成的密集三角网格覆盖了整个面部:
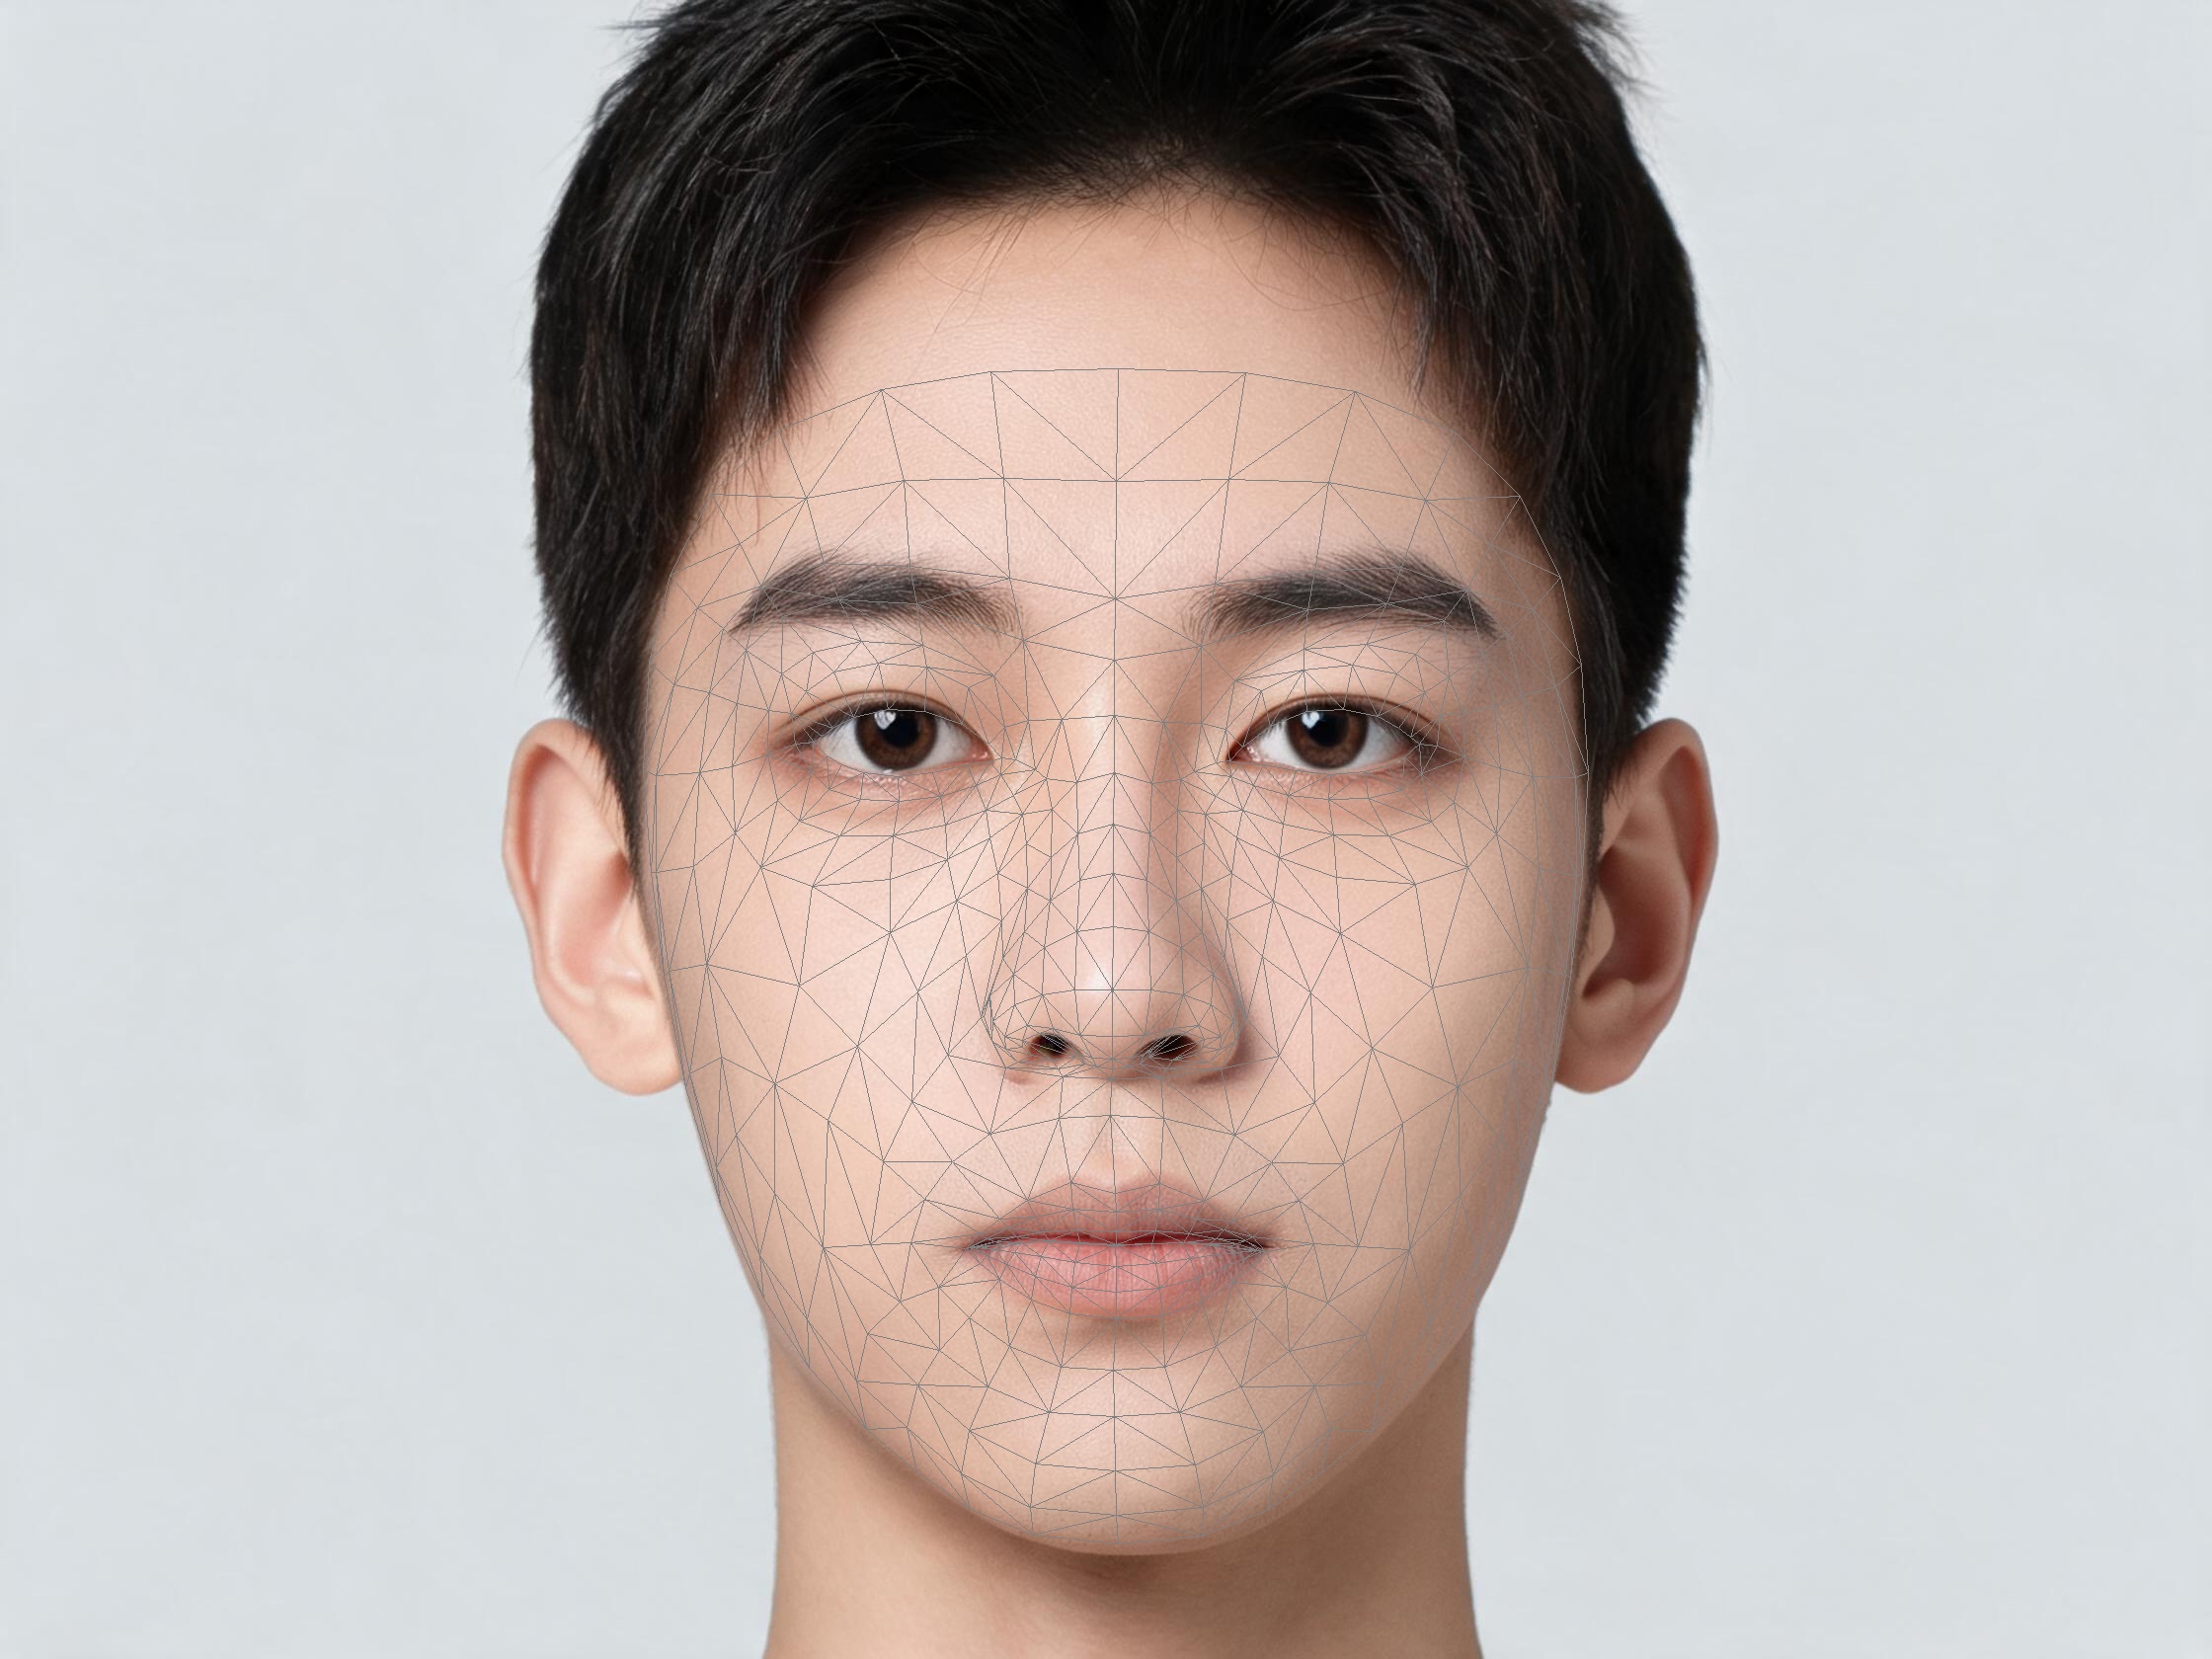
程序运行后的真实输出:
关键点数量: 478
关键点0: x=0.5044, y=0.7193
关键点1: x=0.5030, y=0.6249
关键点2: x=0.5025, y=0.6502
关键点3: x=0.4882, y=0.5308
关键点4: x=0.5031, y=0.5965
…
输出解析:
- 关键点0通常位于脸颊区域,x≈0.5表示位于画面水平中心
- 478个关键点为归一化坐标,乘以画面宽高可得到像素位置
- Face Mesh不返回z坐标用于绘制(z值主要表示相对深度,用于3D重建)
Part 5: 技术拓展
5.1 应用场景
MediaPipe人体感知技术在实际中有极为丰富的应用:
- 手势控制:通过识别手势(如握拳、张开、滑动)控制智能家居、PPT翻页、无人机操控等。手势识别提供了无接触的自然交互方式
- 手语翻译:利用21点手部关键点的动态序列,结合时序模型识别手语手势,实现聋哑人与普通人的无障碍交流
- AR试妆:基于478点Face Mesh的精确面部定位,在嘴唇上叠加口红颜色、在眼睛上叠加眼影效果,实现虚拟试妆
- 虚拟主播:通过Face Mesh实时捕捉面部表情,驱动虚拟角色的面部动画,实现数字人直播
- 健身姿态分析:利用Pose检测人体33个关节点,分析深蹲、俯卧撑等运动动作是否标准,提供实时反馈
- 疲劳驾驶检测:结合Face Mesh的眼部关键点和眨眼频率,检测驾驶员疲劳状态
- 表情识别:基于面部关键点的几何关系,识别喜怒哀乐等情绪
5.2 MediaPipe Pose姿态检测简介
MediaPipe Pose模块能够检测人体的33个关键点,覆盖头部、肩膀、手臂、躯干和腿部,构成完整的人体骨架。与手部检测类似,Pose模块同样提供了简洁的Python API:
import cv2
import mediapipe as mp
# mp_pose.Pose() 参数说明:
# 1) static_image_mode: True=静态图片, False=视频流
# 2) model_complexity: 模型复杂度, 0=最快(精度最低), 1=平衡, 2=最慢(精度最高)
# 3) smooth_landmarks: 是否平滑关键点(减少抖动)
# 4) enable_segmentation: 是否对人体进行抠图(分割)
# 5) min_detection_confidence: 检测置信度阈值
# 6) min_tracking_confidence: 跟踪置信度阈值
mp_pose = mp.solutions.pose
pose = mp_pose.Pose(
static_image_mode=True,
model_complexity=1, # 平衡模式
smooth_landmarks=True, # 启用平滑
min_detection_confidence=0.5,
min_tracking_confidence=0.5
)
drawing = mp.solutions.drawing_utils
# 读取图像并检测姿态
img = cv2.imread("1.jpg")
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
results = pose.process(img)
img = cv2.cvtColor(img, cv2.COLOR_RGB2BGR)
# 打印关键点信息
print(len(results.pose_landmarks.landmark)) # 输出: 33
for i in range(len(results.pose_landmarks.landmark)):
x = results.pose_landmarks.landmark[i].x
y = results.pose_landmarks.landmark[i].y
z = results.pose_landmarks.landmark[i].z
print(x, y, z)
# 绘制骨架
drawing.draw_landmarks(img, results.pose_landmarks, mp_pose.POSE_CONNECTIONS)
cv2.imshow("keypoint", img)
# 3D可视化(plot_landmarks会弹出3D窗口)
drawing.plot_landmarks(results.pose_world_landmarks, mp_pose.POINT_CONNECTIONS)
cv2.waitKey(0)
cv2.destroyAllWindows()
Pose检测的33个关键点包括:鼻子、左右眼(内外角)、左右耳、左右肩、左右肘、左右腕、左右臀、左右膝、左右踝等,构成完整的人体骨架。
下图展示了Pose姿态检测的实际效果:
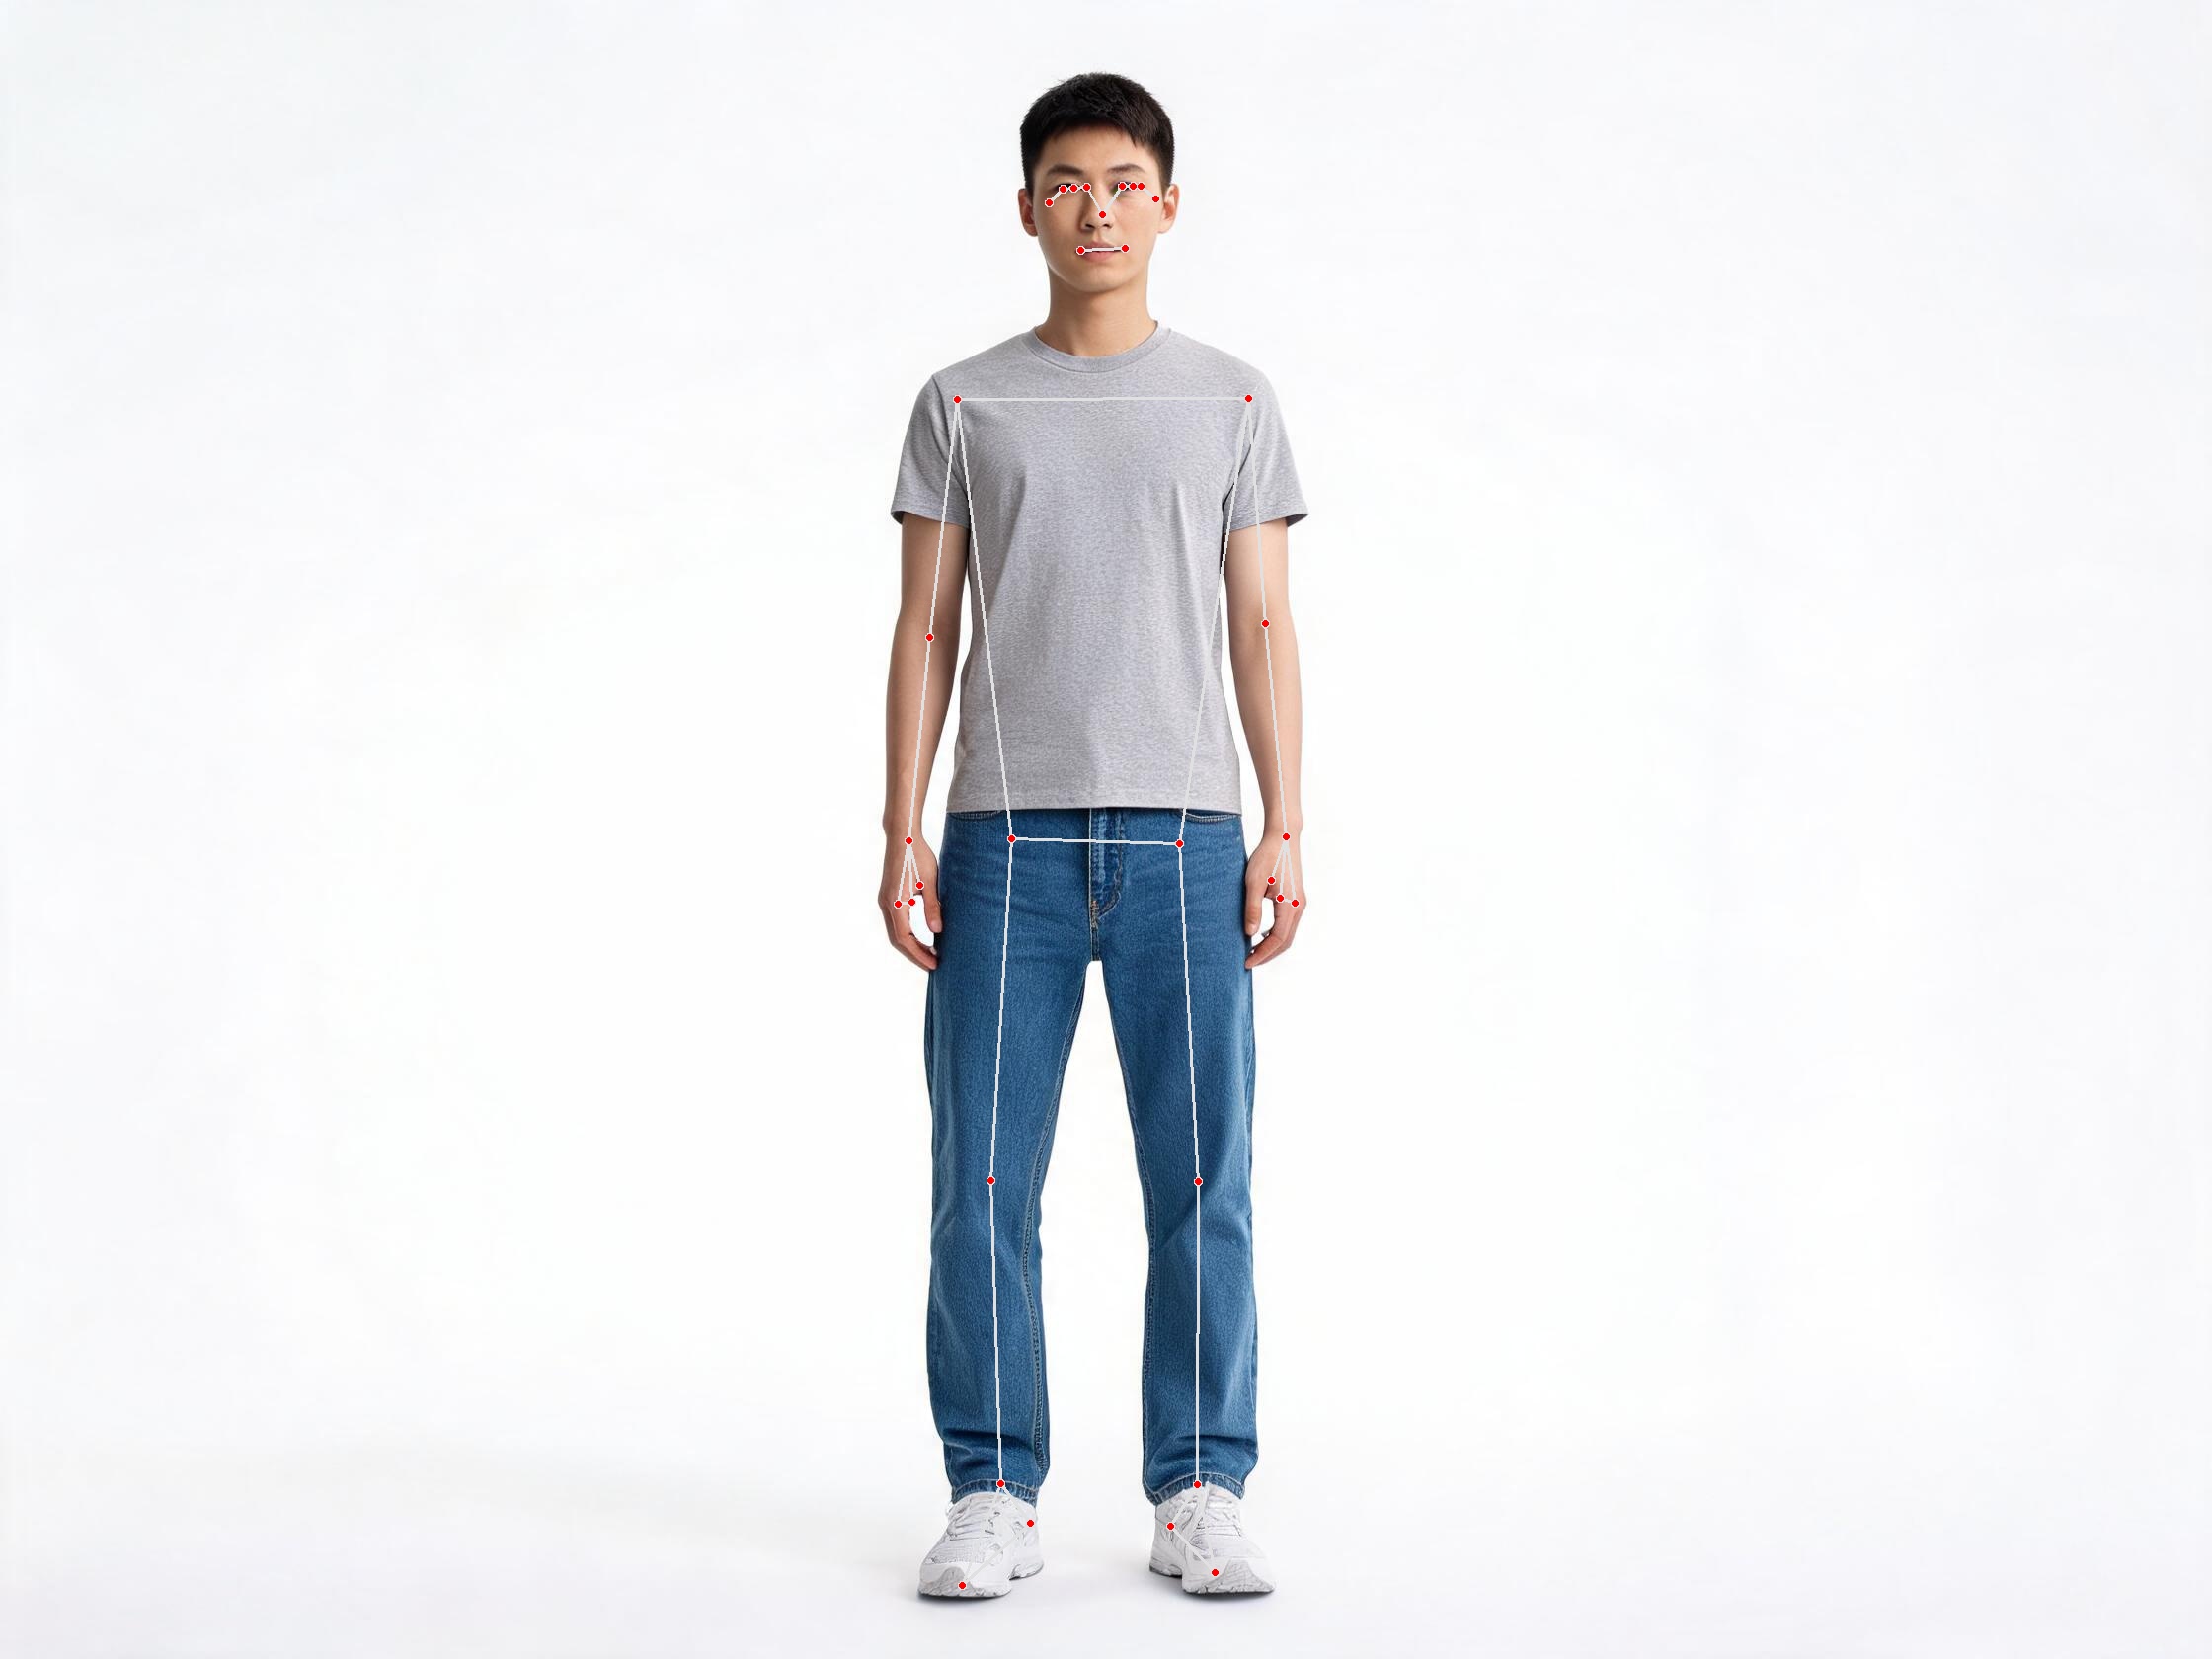
程序运行后的真实输出:
姿态关键点数量: 33
关键点0: x=0.4986, y=0.1292
关键点1: x=0.5075, y=0.1120
关键点2: x=0.5123, y=0.1120
关键点3: x=0.5156, y=0.1119
关键点4: x=0.4911, y=0.1127
…
Pose关键点编号说明:
| 0 | 鼻子 | 17-22 | 左侧手臂链路 |
| 1-3 | 左眼(内角、外角) | 23 | 左臀 |
| 4-6 | 右眼(内角、外角) | 24 | 右臀 |
| 7,8 | 左右耳 | 25 | 左膝 |
| 9,10 | 左右嘴角 | 26 | 右膝 |
| 11,12 | 左右肩 | 27 | 左踝 |
| 13,14 | 左右肘 | 28 | 右踝 |
| 15,16 | 左右腕 | 29-32 | 脚部细节 |
plot_landmarks 的独特功能:drawing.plot_landmarks() 会弹出一个3D可视化窗口,以3D视角展示人体骨架的世界坐标。这对于分析人体朝向、动作幅度非常有用,是2D关键点无法替代的。
总结
本文全面介绍了MediaPipe在人体感知领域的四大核心能力:
MediaPipe的核心优势在于开箱即用——无需训练模型、无需下载数据集,几行代码即可实现专业级的人体感知功能。无论是学术研究还是工程应用,MediaPipe都是人体感知领域的首选工具之一。