/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
我不会起名字322 · 后端 / 算法 / 数据库
📘 技术栈 | 🧩 力扣 Hot100 | 🐹 Go 项目 | 🟥 Redis | 🐬 MySQL
文章目录
- K8s 探针配置的 3 个反直觉行为:为什么 Pod 一直没就绪
-
- 一、先分清三种探针(很多人混用)
- 二、反直觉行为 1:startupProbe 与 initialDelaySeconds 的优先级
- 三、反直觉行为 2:什么时候被杀 = failureThreshold × periodSeconds
- 四、反直觉行为 3:liveness 打到未就绪的 Pod → 重启风暴
- 五、探针参数对照表(可带走物)
- 六、排查没就绪的三步
K8s 探针配置的 3 个反直觉行为:为什么 Pod 一直没就绪
“应用日志明明写着 server started on :8080,为什么 Pod 一直是 0/1?”
这是个几乎每个上 K8s 的人都会遇到的困惑。你盯着 Pod 状态,READY 是 0/1,kubectl describe 里一堆 Readiness probe failed。而应用自己觉得一切正常。
问题几乎总是出在探针配置上。这篇先分清三种探针,再拆 3 个反直觉行为。
一、先分清三种探针(很多人混用)
| livenessProbe | 判断容器活着吗 | 重启容器 | 高(会重启) |
| readinessProbe | 判断容器能收流量吗 | 从 Service 摘除,不重启 | 中(不接流量) |
| startupProbe | 判断容器启动完了吗 | 重启容器 | 高(会重启) |
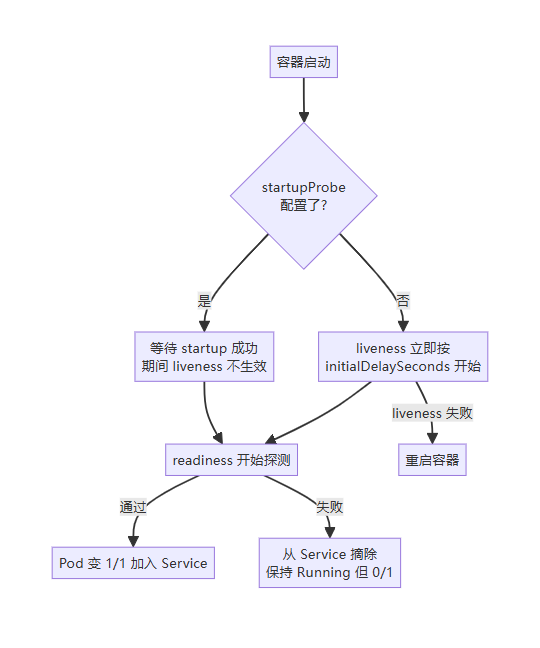
最常见的错误:把 liveness 探针配得太激进去探业务接口,或者用 liveness 代替 readiness,导致"服务没就绪就被杀 → 重启 → 又没就绪"的重启风暴。
二、反直觉行为 1:startupProbe 与 initialDelaySeconds 的优先级
很多人以为配了 startupProbe 之后,livenessProbe.initialDelaySeconds 就无所谓了。基本正确,但有个坑:
- 配了 startupProbe:在 startup 成功之前,liveness 和 readiness 都不会执行。这期间只有 startup 在起作用。
- 没配 startupProbe:liveness 会立即按 initialDelaySeconds 开始计时。
反直觉点:initialDelaySeconds 不是"启动后多久开始探",而是"容器创建后多久开始第一次探测"。如果镜像拉取花了 40 秒,而 initialDelaySeconds = 10,那么第一次 liveness 探测发生在应用还没启动时——直接失败。
# ❌ 危险:初始延迟太短
livenessProbe:
httpGet: { path: /healthz, port: 8080 }
initialDelaySeconds: 5 # 应用 30 秒才启动完 → 前 5 次全失败
periodSeconds: 5
failureThreshold: 3 # 15 秒后就被杀 → 重启风暴
# ✅ 正确:用 startupProbe 单独兜启动期
startupProbe:
httpGet: { path: /healthz, port: 8080 }
periodSeconds: 5
failureThreshold: 30 # 最多等 150 秒启动
livenessProbe:
httpGet: { path: /healthz, port: 8080 }
periodSeconds: 10
failureThreshold: 3
记忆点:startupProbe 是给"启动慢的应用"用的,配了它,liveness 的 initialDelaySeconds 就可以设成 0。
三、反直觉行为 2:什么时候被杀 = failureThreshold × periodSeconds
这是最容易被误算的一个。决定"多久被杀"的不是 initialDelaySeconds,而是:
最长容忍时间 = failureThreshold × periodSeconds
举例:
livenessProbe:
initialDelaySeconds: 10 # 第一次探测在 10s 后
periodSeconds: 10 # 每 10s 探一次
failureThreshold: 3 # 连续失败 3 次就杀
从容器创建到被杀的最坏时间 = initialDelaySeconds + failureThreshold × periodSeconds = 10 + 30 = 40 秒。
反直觉点:timeoutSeconds 是每次探测的超时,它也算进周期。如果 timeoutSeconds = 5、periodSeconds = 10,那实际周期可能变成"探测 5 秒超时 + 等 5 秒",节奏被打乱。
# 完整的时间账
livenessProbe:
initialDelaySeconds: 10
periodSeconds: 10
timeoutSeconds: 5 # 单次探测超时
failureThreshold: 3
successThreshold: 1 # liveness 必须为 1
# 最坏:10 + 3×(5超时+10间隔) = 55 秒才被杀
readiness 的 successThreshold 可以 > 1(需要连续成功 N 次才算就绪),但 liveness 的 successThreshold 只能是 1(这是强制的)。
四、反直觉行为 3:liveness 打到未就绪的 Pod → 重启风暴
这是最惨烈的一种。典型配置错误:
# ❌ liveness 探了一个"依赖就绪"的接口
livenessProbe:
httpGet: { path: /api/health, port: 8080 } # 这个接口依赖下游 DB/Redis
问题链:
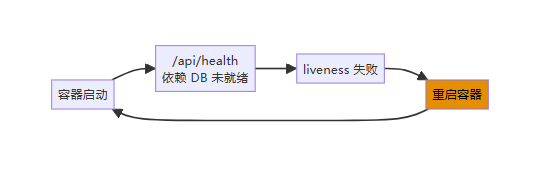
正确原则:
| liveness | 进程是否卡死(一个不依赖任何外部组件的轻量端点) | 业务接口、依赖下游的接口 |
| readiness | 是否具备处理请求的能力(可以含依赖检查) | 会触发重活的接口 |
# ✅ liveness 只探进程健康
livenessProbe:
httpGet: { path: /healthz, port: 8080 } # 只返回 200,不查依赖
# ✅ readiness 探业务就绪(可含依赖)
readinessProbe:
httpGet: { path: /readyz, port: 8080 } # 检查 DB 连接等
Go 实现示例:
// 健康端点分离
mux.HandleFunc("/healthz", func(w http.ResponseWriter, r *http.Request) {
// liveness:只要进程活着就返回 200,不查任何依赖
w.WriteHeader(http.StatusOK)
w.Write([]byte("ok"))
})
mux.HandleFunc("/readyz", func(w http.ResponseWriter, r *http.Request) {
// readiness:检查下游依赖
ctx, cancel := context.WithTimeout(r.Context(), 1*time.Second)
defer cancel()
if err := db.PingContext(ctx); err != nil {
w.WriteHeader(http.StatusServiceUnavailable)
w.Write([]byte("db not ready"))
return
}
w.WriteHeader(http.StatusOK)
w.Write([]byte("ready"))
})
五、探针参数对照表(可带走物)
| initialDelaySeconds | 创建后多久首次探测 | liveness: 配了 startup 可设 0 | 设太短→启动期被杀 |
| periodSeconds | 探测间隔 | 10(readiness 可 5) | 太小→频繁探测耗资源 |
| timeoutSeconds | 单次超时 | 2~5 | 大于 period→节奏乱 |
| failureThreshold | 连续失败几次算失败 | liveness: 3;readiness: 3 | 设 1→一次抖动就摘 |
| successThreshold | 连续成功几次算成功 | readiness: 1~2;liveness: 必须 1 | readiness 设太高→恢复慢 |
六、排查没就绪的三步
| 1 | 看具体失败原因 | kubectl describe pod <pod> 找 Probe failed 那行 |
| 2 | 手动模拟探测 | kubectl exec -it <pod> — curl -v localhost:8080/readyz |
| 3 | 核对端口和路径 | 探针的 port 是容器端口,不是 Service 端口 |
第 3 条特别常错:探针的 port 必须写容器内监听的端口。如果写了 Service 的端口或 hostPort,探测必然失败。
留个问题给你:你们的 liveness 探针是探 /healthz 这种纯进程健康端点,还是探业务接口?initialDelaySeconds 现在配的是多少?