/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
项目开源地址: opencv-vision-lab:OpenCV Vision Lab —— 在线图像处理实验室 – AtomGit
华为云码道: AtomGit – 全球开发者的开源社区,开源代码托管平台
前言
上一篇文章中,我只给华为云码道 Agent 一段需求,让它从零开发了一个 OpenCV Vision Lab——在线图像处理实验室。
第一版已经实现了:
- 灰度化
- 均值滤波
- 高斯滤波
- 中值滤波
- 二值化
- 腐蚀
- 膨胀
- 开运算
- 闭运算
同时还完成了图片上传、参数调节、异常处理、API 测试和 README 等内容。
但从零创建一个项目只是第一步。
真正更接近实际开发场景的问题是:
当一个项目已经有了一定代码量以后,再继续追加新需求,Agent 能不能先读懂原来的代码,再在不破坏旧功能的前提下完成增量开发?
所以这一次,我没有重新创建项目,而是直接在原来的 opencv-vision-lab 仓库上继续加需求。
目标也从“基础图像处理实验室”,进一步升级成一个更完整的:
计算机视觉算法实验室。
一、这次不是从零开发,而是在旧项目上继续改
这一轮,我准备新增 5 个 OpenCV 算法:
- Sobel 边缘检测
- Canny 边缘检测
- 轮廓检测
- Harris 角点检测
- SIFT 特征点检测
同时要求 Agent:
- 保留第一版原来的 9 种算法
- 不重新创建项目
- 不无意义重构
- 基于当前代码结构继续开发
- 更新前端算法分类
- 新增参数调节
- 新增测试
- 更新 README
- 最后完成 Git commit 并推送到 AtomGit
我给码道的核心需求如下:
在当前已经完成的 OpenCV Vision Lab 项目基础上继续开发。
不要重新创建项目,不要删除或破坏现有的 9 种基础图像处理功能,需要基于当前仓库直接进行增量开发。
本次目标是把项目从“基础图像处理实验室”升级为“计算机视觉算法实验室”。
请新增以下功能:
1. Sobel 边缘检测
– 支持 X 方向梯度
– 支持 Y 方向梯度
– 支持 XY 综合梯度
– 支持调整 kernel size
2. Canny 边缘检测
– 支持调整低阈值 threshold1
– 支持调整高阈值 threshold2
3. 轮廓检测
– 对图像进行轮廓提取
– 将检测到的轮廓绘制到结果图像上
– 显示检测到的轮廓数量
– 支持面积过滤
4. Harris 角点检测
– 检测图像中的 Harris 角点
– 在原图对应位置标记角点
– 支持必要参数调整
5. SIFT 特征点检测
– 使用 OpenCV SIFT 检测关键点
– 将关键点绘制在结果图像中
– 显示关键点数量
要求保留当前已有功能和 UI 风格,并完成测试、README 更新、Git commit 和推送。
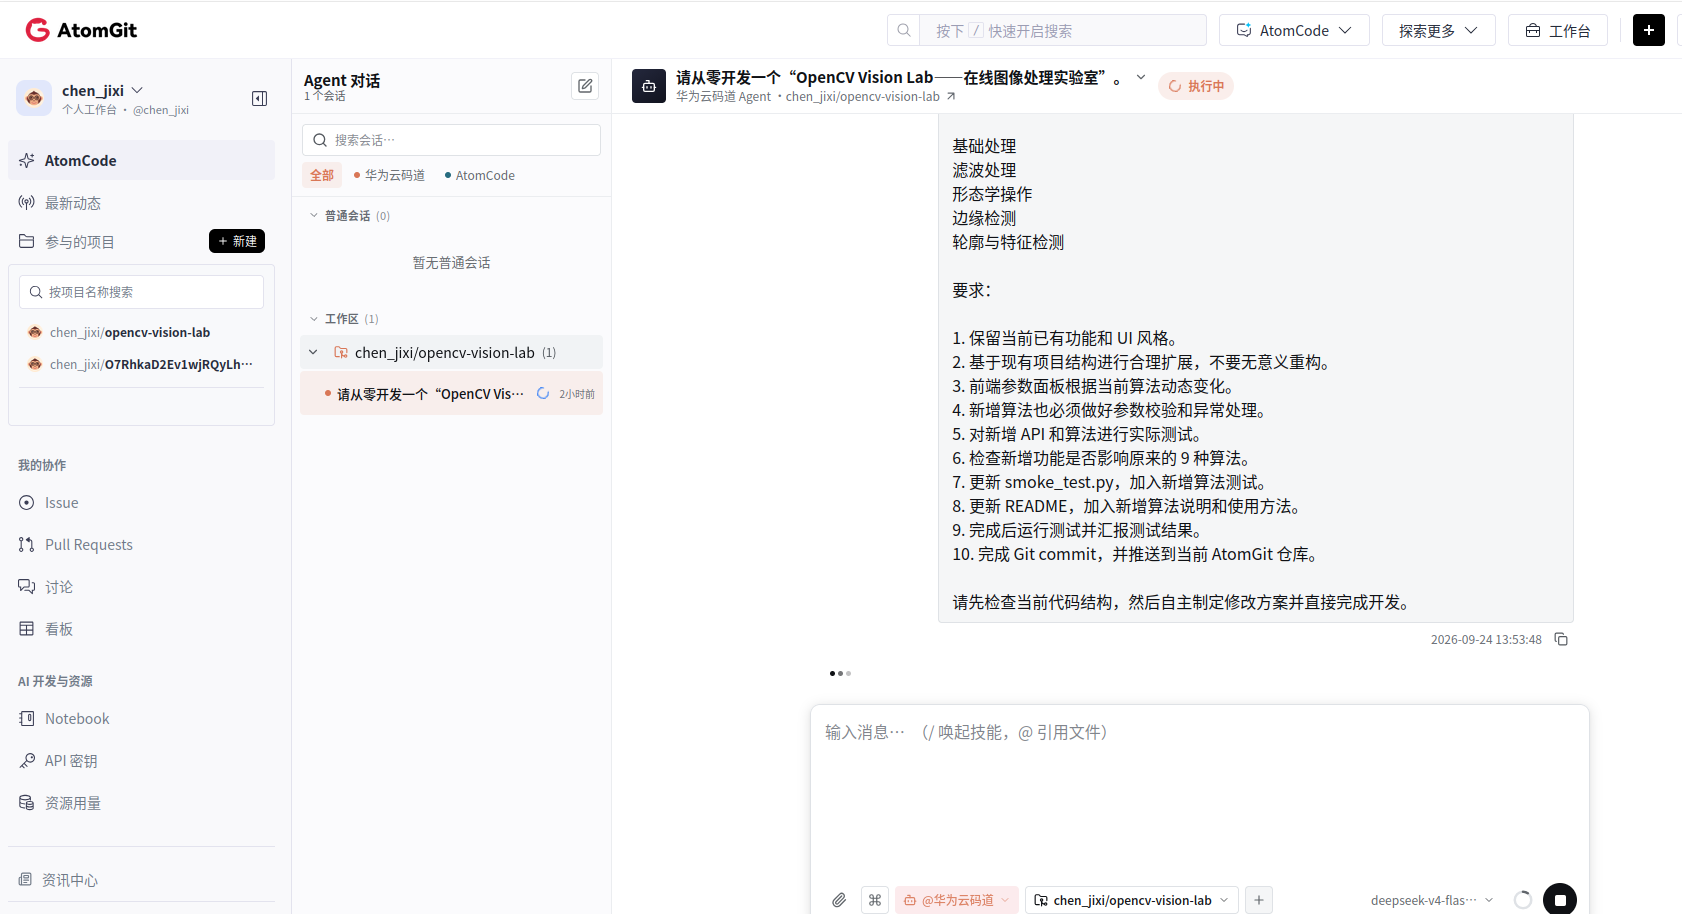
这次测试的重点和上一篇已经不一样了。
上一篇看的是:
Agent 能不能从 0 到 1。
这一篇看的是:
Agent 能不能从 1 到 2。
二、它先做的不是写代码,而是检查现有仓库
这一点我觉得比第一篇更有意思。
Agent 收到需求以后,并没有直接重新生成项目,而是先去检查:
- 当前代码结构
- Git 历史
- 工作区状态
- 已有提交
- 当前未提交文件
- 哪些临时文件不应该加入仓库
然后才制定增量开发方案。
它给出的核心思路是:
不动现有 9 种算法的实现与接口,只在 processing.py 增加 5 个新算法,同时扩展统计信息返回;前端按分类分组渲染算法,并更新测试与文档。
也就是说,这一轮它已经不是“写一个新项目”,而是在考虑:
现有代码哪些能复用、哪些应该扩展、哪些不应该动。
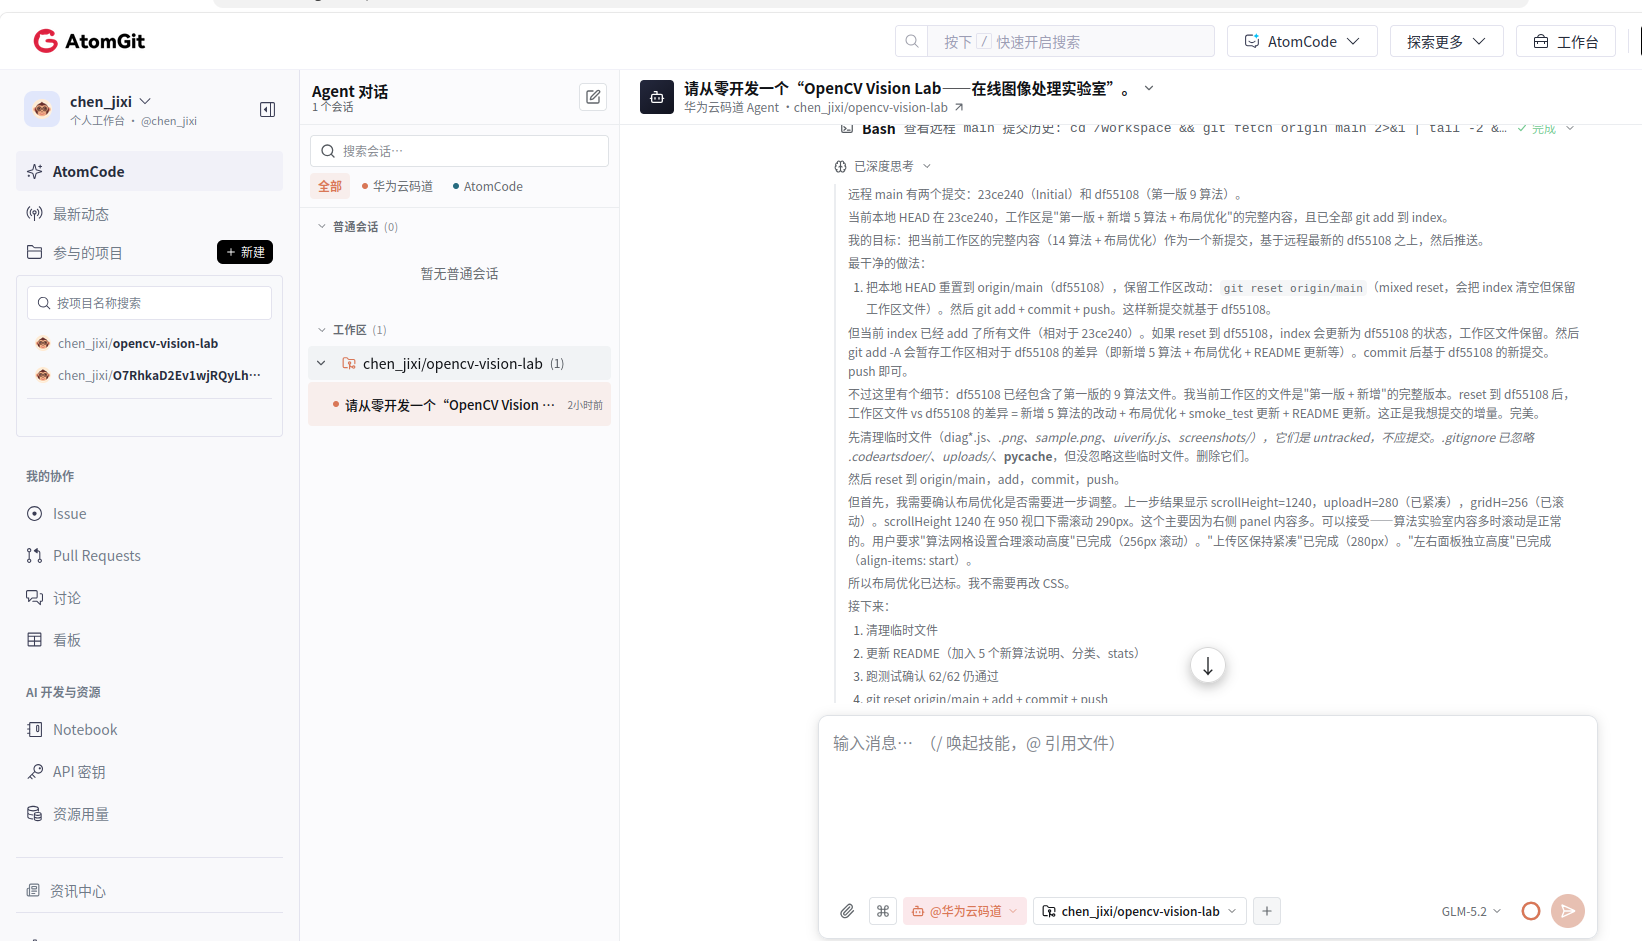
从这个过程来看,Agent 实际上做了几类工作:
- 分析已有工程
- 判断哪些代码需要修改
- 保留旧接口兼容性
- 清理临时文件
- 更新测试
- 更新文档
- 最后再重新提交
这比单纯生成一个新的 Demo 更接近真实工程开发。
三、项目从 9 种算法升级到 14 种算法
升级完成以后,原来的 9 种算法全部保留。
同时新增了:
边缘检测
- Sobel
- Canny
轮廓与特征检测
- 轮廓检测
- Harris 角点
- SIFT 特征点
因此项目现在总共支持:
14 种 OpenCV 算法。
为了让算法数量增加以后页面仍然清晰,前端也重新进行了分类。
目前主要分为:
- 基础处理
- 滤波处理
- 形态学操作
- 边缘检测
- 轮廓与特征检测
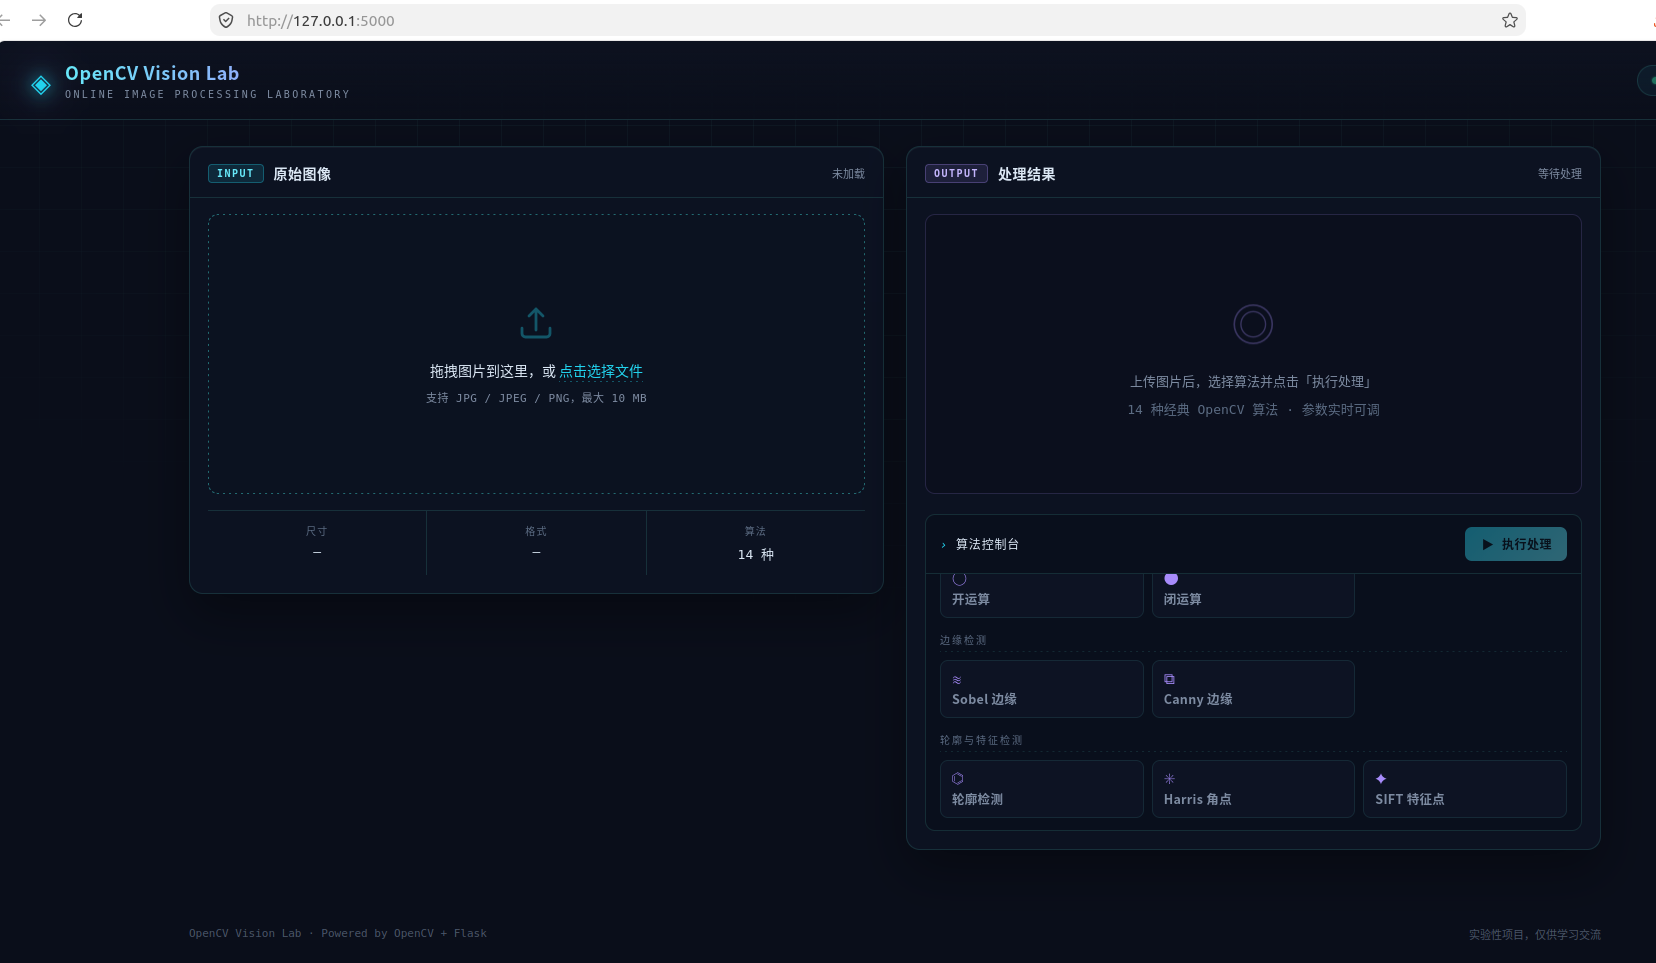
从页面上可以看到,第一版原来的整体 UI 风格基本没有被破坏。
只是算法区域增加了新的分类和功能入口。
这也是我这次比较关注的一点:
增量开发并不只是“把新代码塞进去”,还需要考虑原来的页面结构还能不能继续使用。
四、实际案例一:Canny 边缘检测
接下来直接测试新增算法。
首先测试 Canny。
Canny 边缘检测在 OpenCV 中是非常经典的一种边缘检测算法。
最常见的两个参数是:
threshold1
threshold2
它们分别用于控制低阈值和高阈值。
这一次网页中也加入了这两个参数的调节。
我仍然使用上一篇测试时的同一张图片。
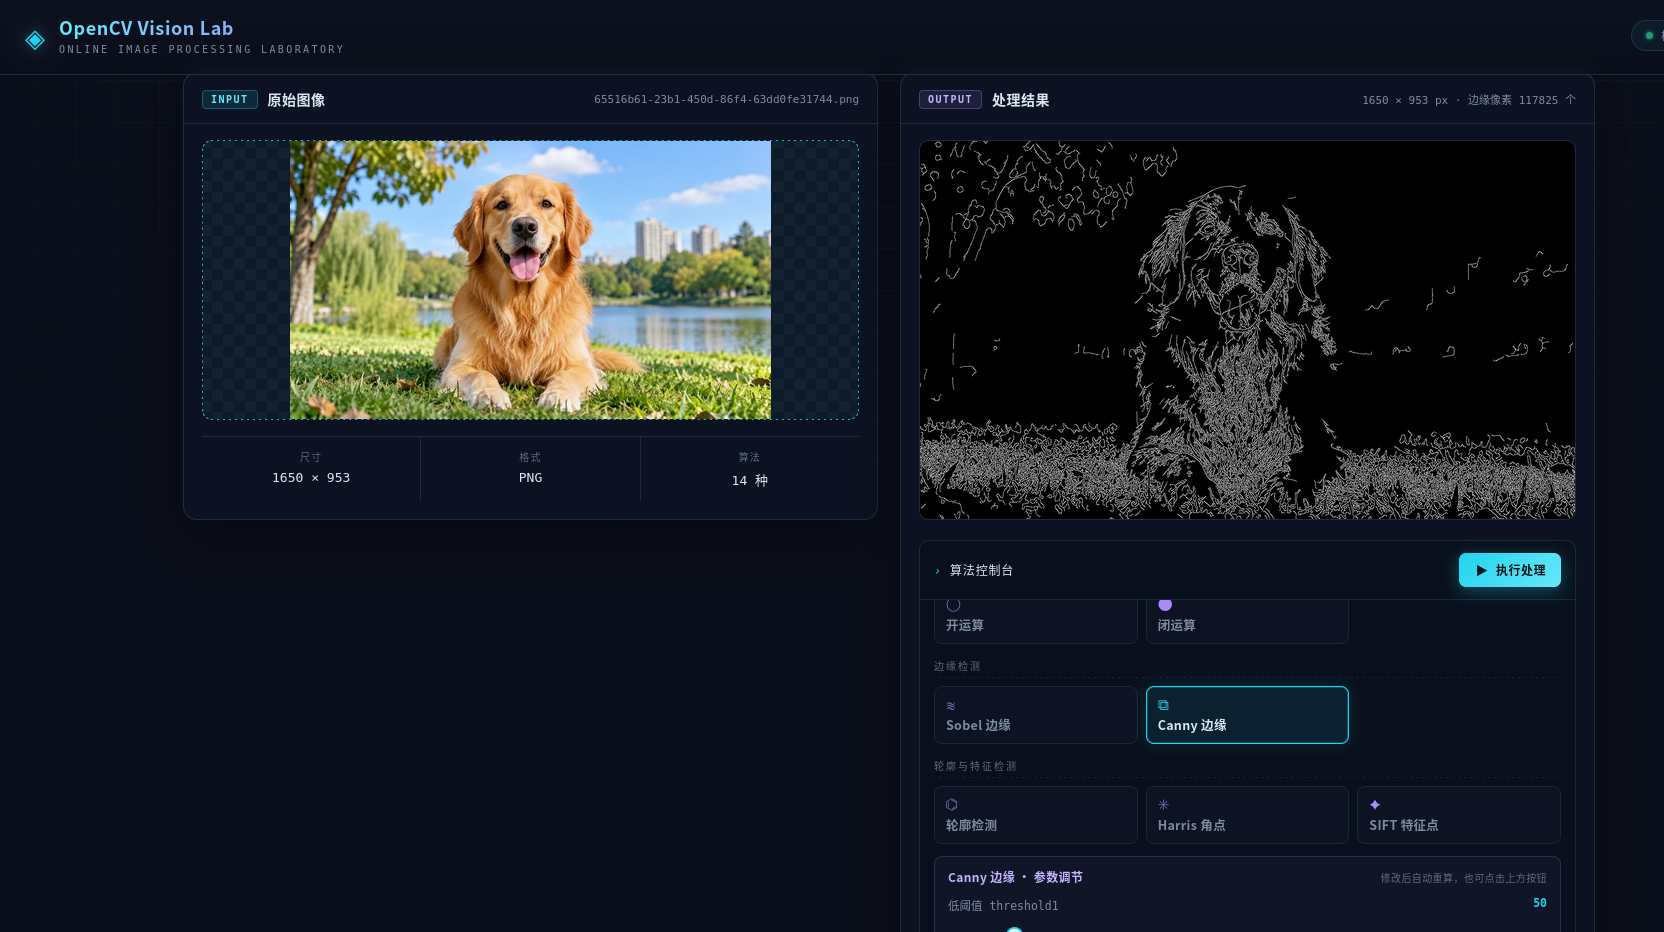
从结果可以看到:
原始彩色图像经过 Canny 处理以后,大部分颜色信息被去除,只保留了明显的边缘结构。
例如:
- 狗的轮廓
- 毛发纹理
- 草地边缘
- 树叶
- 建筑轮廓
都能够被比较明显地提取出来。
这也比之前直接写一行:
edges = cv2.Canny(img, 50, 150)
更适合拿来做参数实验。
因为现在可以直接调整 threshold1 和 threshold2,再观察边缘数量到底如何变化。
五、为什么 Canny 很适合做成可视化工具?
以前学习 Canny 时,代码本身其实并不复杂。
真正比较难理解的是:
参数变化到底会对结果产生什么影响?
例如:
- 阈值过低,可能会检测出大量噪声边缘
- 阈值过高,一些较弱边缘可能会被丢失
- 不同图像需要的参数也不完全一样
所以把它放进 Web 页面以后,学习体验会更直观。
以后如果继续扩展,还可以进一步加入:
- 高斯预处理开关
- 自动阈值
- Canny 与 Sobel 对比
- 多组参数同时展示
这样它就不只是一个“调用 OpenCV 的网页”,而可以继续发展成一个真正的算法实验平台。
六、实际案例二:SIFT 特征点检测
第二个我重点测试的是 SIFT。
SIFT 和 Canny 的效果完全不一样。
Canny 关注的是:
哪里存在明显边缘。
而 SIFT 更关注:
哪些位置可以作为稳定的局部特征。
例如:
- 纹理明显的位置
- 角点
- 局部结构变化明显的位置
- 尺度变化后仍然比较稳定的区域
实际运行以后,结果如下:
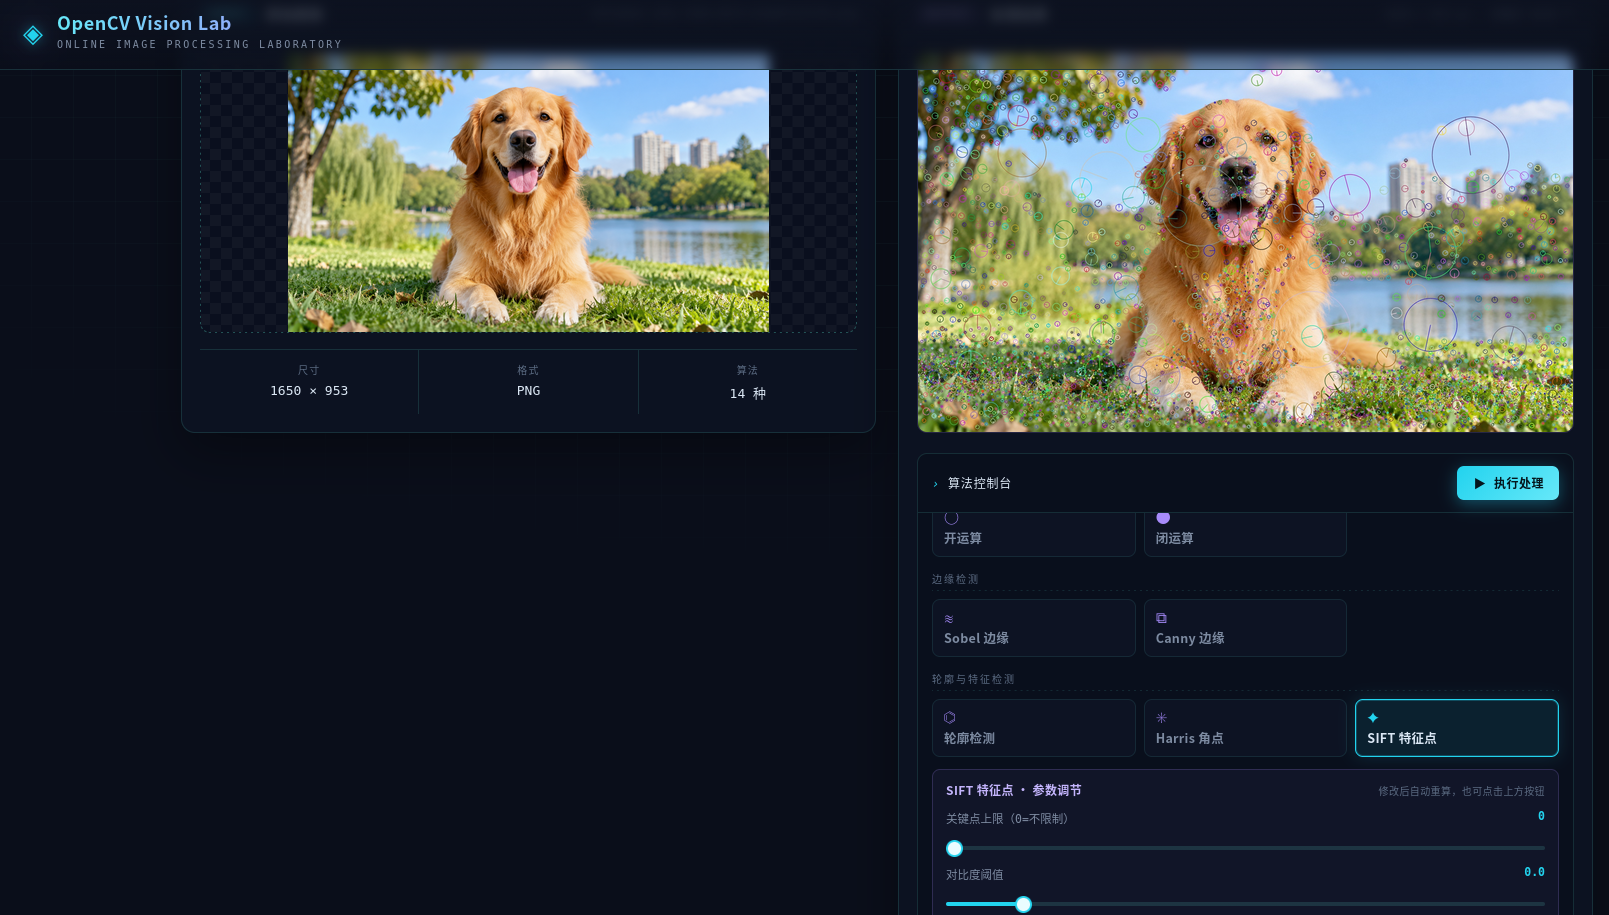
从图中可以看到,算法在图像中检测出了大量关键点。
尤其在:
- 草地
- 树叶
- 狗的毛发
- 面部
- 建筑物
这些纹理比较丰富的区域,特征点非常密集。
这些圆圈的大小和方向,也对应不同尺度和方向下检测到的局部特征。
这也是 SIFT 比单纯边缘检测更有意思的地方。
它不仅仅告诉我们:
哪里发生了像素变化。
还试图找到:
哪些局部区域具有更稳定的描述能力。
七、参数也不再写死
这一轮新增的算法并不是只做了一个固定调用。
比如 SIFT 页面中还可以继续调整相关参数。
Canny 也可以修改高低阈值。
轮廓检测可以通过面积阈值过滤一些比较小的轮廓。
也就是说,项目已经开始从:
“点击一个按钮执行算法”
逐渐变成:
“调整参数并观察算法行为”
这对于计算机视觉学习其实更有价值。
因为很多 OpenCV 算法真正需要理解的,并不只是 API 名字,而是:
参数和结果之间的关系。
八、增量开发有没有破坏第一版功能?
这一点是我这次最关心的。
因为如果 Agent 只是把 5 个新算法加进去,但把第一版原来的功能弄坏了,那这个升级实际上并不能算成功。
所以这一轮专门更新了 smoke_test.py。
最终测试结果:
62 / 62 全部通过
测试覆盖:
- 原来的 9 种算法
- 新增的 5 种算法
- 新算法参数调节
- stats 统计信息
- 异常处理
- 原有算法回归
最终一共覆盖:
14 种算法。
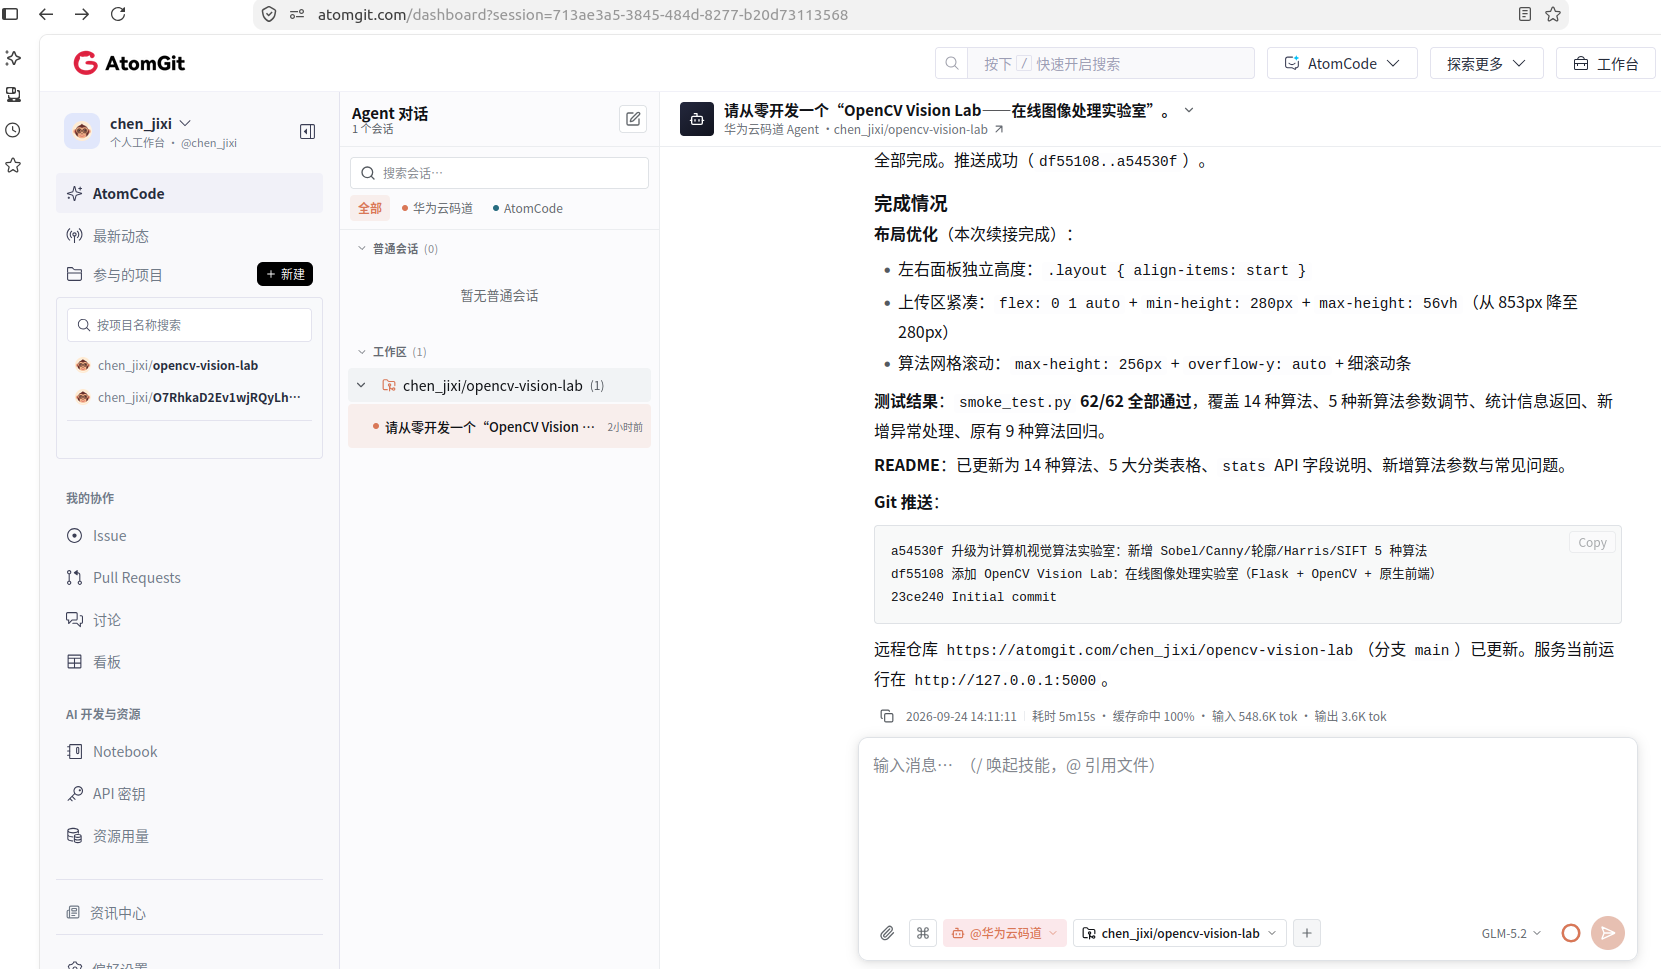
在完成测试以后,Agent 还更新了 README,并重新完成 Git 提交。
从提交记录也可以看到这一轮升级内容:
升级为计算机视觉算法实验室:
新增 Sobel / Canny / 轮廓 / Harris / SIFT 5 种算法
最终代码也已经重新推送到原来的 AtomGit 仓库。
九、这一轮比第一篇更能看出什么?
如果只看第一篇,其实很容易产生一个问题:
从零开发项目,看起来很厉害,但会不会本质上只是一次性生成了一套代码?
第二篇更能说明另一个问题。
因为这一次:
- 仓库已经存在
- 旧代码已经存在
- UI 已经存在
- 测试已经存在
- Git 历史也已经存在
Agent 需要先理解原有工程,然后再继续修改。
而不是简单地重新开始。
这一轮它需要做的是:
读取现有工程 → 判断修改范围 → 保留旧功能 → 新增功能 → 更新测试 → 回归验证 → 更新文档 → Git 提交
这更接近真实的软件开发过程。
十、从“基础处理”开始走向“计算机视觉算法实验室”
到目前为止,OpenCV Vision Lab 已经从第一版的基础图像处理,扩展成了一个包含 14 种算法的小型视觉实验平台。
目前新增的核心功能包括:
| Sobel 边缘检测 | ✅ |
| Canny 边缘检测 | ✅ |
| 轮廓检测 | ✅ |
| Harris 角点检测 | ✅ |
| SIFT 特征点检测 | ✅ |
| 算法分类 | ✅ |
| 新算法参数调节 | ✅ |
| stats 统计信息 | ✅ |
| 旧功能回归测试 | ✅ |
| 62/62 测试 | ✅ |
| README 更新 | ✅ |
| Git 推送 | ✅ |
项目地址:
opencv-vision-lab:OpenCV Vision Lab —— 在线图像处理实验室 – AtomGit
十一、下一步准备继续做什么?
现在项目里已经有:
- 滤波
- 二值化
- 形态学
- 边缘检测
- 轮廓
- 角点
- 局部特征
但现在还有一个问题:
虽然参数可以调,但不同参数之间的差异还没有被系统地可视化。
所以下一篇我准备继续在这个项目上做:
OpenCV 参数可视化实验。
比如:
- Gaussian Kernel Size 对平滑效果的影响
- Canny 不同阈值组合对边缘数量的影响
- Harris 参数变化对角点数量的影响
- SIFT 参数变化对关键点数量的影响
- 轮廓面积阈值对检测结果的影响
也就是说,下一步不再只是继续“加算法”。
而是开始研究:
算法参数到底是怎么影响最终结果的。
这会比单纯调用 API 更接近真正理解 OpenCV。