一.TCP 与 IP 的关系
IP 层的核心作用是定位主机,具有将数据从主机 A 发送到主机 B 的能力,但是能力并不能保证一定能够做到,所以这时就需要 TCP 起作用了,TCP 可以通过超时重传、拥塞控制等策略来保证数据能够发送到 B 主机。
更准确地说,IP 层负责“尽力而为”地转发数据报,也就是只保证把数据尽力送到目的地,但不保证一定送到,也不保证顺序和完整性。这就是所谓的“尽力而为交付”。
TCP 保证的是“可靠、有序、不重复、不丢失”地把字节流交付给对端应用层,而不是“保证 B 主机一定会处理”。数据送到 B 主机的 TCP 接收缓冲区,就算 TCP 完成了任务,至于 B 主机的应用层有没有读、有没有处理,那是应用层的事。
所以,TCP 提供的是策略,也就是保证可靠,而 IP 付出的是行动。
二.IP 协议的基本概念
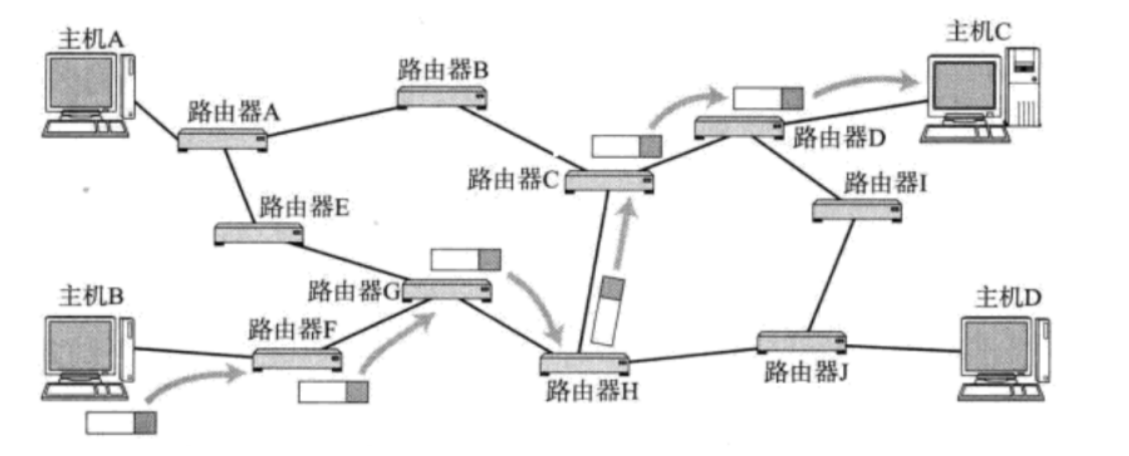
网络层要解决的核心问题,就是把数据从一台主机送到另一台主机,也就是数据该走哪条路,也就是路由。
在路径选择中,目的 IP 非常关键,它决定了这条路该怎么走。
数据跨网络传输时,一般都离不开路由器,因为路由器就是连接多个网络的硬件设备,所以跨网络的数据一定要经过多个路由器。
IP 地址 = 网络号 + 主机号
打个比方,我们要去北京故宫,北京就相当于目标网络,故宫就相当于目标主机,所以要先找到目标网络,再找到目标主机。
IP 地址是路由的根本。路由器会提取目的 IP 里的网络号,去查路由表,决定下一跳往哪儿转发。所以路由的核心是按网络号转发,而不是按主机号转发。主机号只有在数据到达目标网络之后,才用来找到具体的那台主机。
三.IP 协议格式
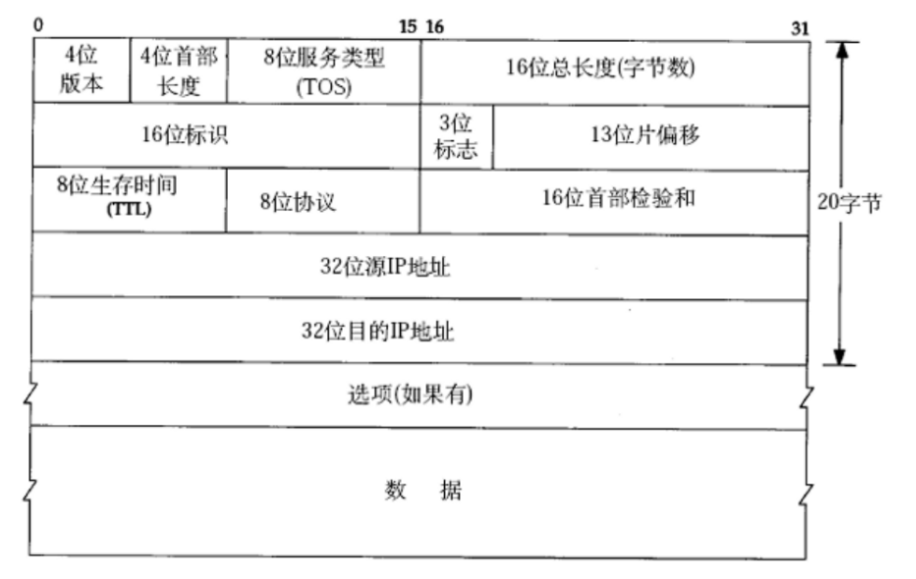
1.IP 将报头与有效载荷进行分离(解包)& 向上交付(分用)
如何将报头与有效载荷分离?
IP 报头和 TCP 类似,不含选项字段时基础报头长度为 20 字节。 IP 报头存在 4 位首部长度字段,该字段计量单位是 4 字节,取值范围换算后对应报头总长度 0~60 字节。当报头不带任何选项时,该字段填入二进制0101,也就是十进制 5。 拿到首部长度,再结合 IP 报头里 16 位总长度字段,就能算出有效载荷:有效载荷长度 = 总长度 − 首部长度 ×4。
向上交付给哪个协议?
IP 头部有一个 8 位协议字段,用来标识上层使用的传输协议。IP 层依靠这个字段,把剥离完 IP 报头后的有效载荷交付给对应的上层协议,比如 TCP 或者 UDP。 这个字段是发送端 IP 封装报文时,由传输层信息填充的。举个例子,如果传输层交给 IP 的数据是 TCP 报文段,封装 IP 头部的时候,8 位协议字段就会填入 TCP 对应的协议编号。
2.8 位生存时间
报文在网络传输的时候,有可能遇到路由环路、目标主机掉线等情况,导致报文永远无法抵达目标主机,变成一直在网络里循环的游离报文。
为了防止这类报文持续占用网络资源,IP 报头设置了 8 位生存时间(TTL)字段。它代表报文最多能够经过的路由跳数。报文每经过一台路由器转发,TTL 的值就会减 1。一旦 TTL 降到 0,路由器就会直接丢弃这个报文,阻止它继续在网络中流转。
3.32 位源 IP 地址和 32 位目的 IP 地址
数据要送达远端主机,需要经过路由器逐跳转发,路由器正是依靠源 IP 和目的 IP 完成转发判断。 发送方发包的时候,除了填写接收方的目的 IP 地址,还需要填入自身的源 IP 地址。因为接收方收到报文后,大概率需要向发送方回传数据;就算没有业务数据要回复,很多场景下也需要返回应答报文,告知发送方数据已经收到。所以 IP 报文头部必须同时携带源 IP 与目的 IP。
绑定 socket
端口号属于 TCP/UDP 传输层的概念,作用是在内核收到报文后,把数据交付给对应的应用进程。 IP 地址工作在 IP 网络层,负责在跨网段传输时完成路由寻址,让报文可以在网络中转发。
四.网段划分(很重要)
1.子网划分的原因
用一个场景举例帮助理解:我们的入学学号不是随意分配的,学号里包含学院编号和个人编号,依靠学号就能确定学生所属学院以及对应的学生本人。
假设每个学院都有一名负责人,负责人同样拥有学号,所有学院负责人都在同一个大群。张三的学生证丢失,被李四捡到。李四查看学号,发现张三不属于自己学院,但无法直接找到张三,于是把学生证交给本院负责人王五。王五可以根据学号里的学院编号,找到张三所在学院的负责人赵六,最后由赵六把学生证交还张三。
我们把张三、李四类比成源主机与目的主机,各个学院负责人就是路由器,学院内部的范围相当于局域网,存放所有负责人的大群相当于公网。
每个学生都分配有学号(对应 IP 地址),所有学生都归属在对应的学院下。
类比到计算机网络:互联网里的每一台主机都属于某个子网,依靠子网划分,才能快速定位主机,提升寻址转发的效率。
2.IP 地址的划分
- 网络号:保证相互连接的两个网段具有不同的标识。在不同的查找过程中,不断变大且是收敛的。
- 主机号:同一网段内,主机之间具有相同的网络号,但是必须有不同的主机号。
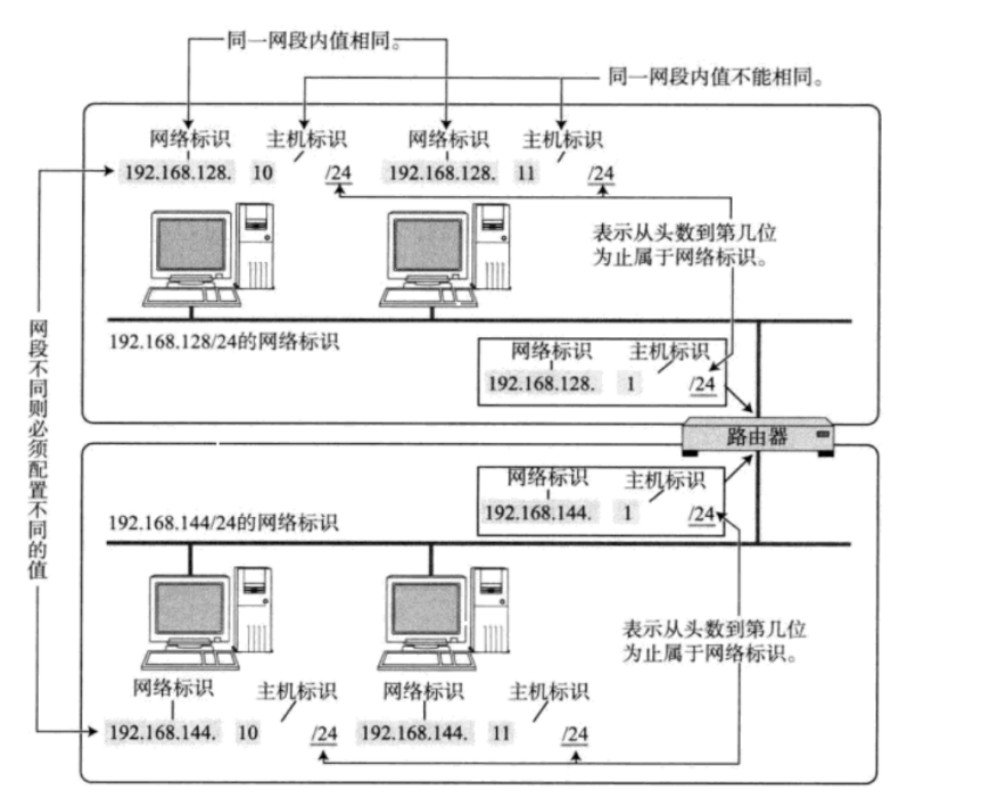
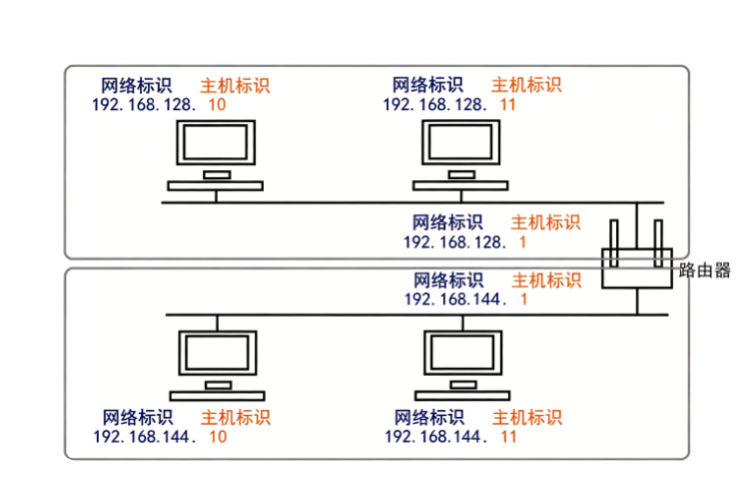
路由器用来连接两个不同网段,路由器在每个网段内的主机标识一般都为 1。对于网络标识,处在同一个网段的所有主机,它们的网络标识完全一致;分属不同网段的主机,网络标识则不一样。而主机标识的规则是:同一网段内部,所有主机的主机标识不能重复;但在不同网段之间,主机标识允许重复。
- 划分子网,本质就是把拥有相同网络号的主机归为同一个网络。 当子网新增一台主机时,这台主机的网络号必须和当前子网保持一致,主机号则不能和子网里已存在的主机冲突。
- 依靠网络号与主机号这套划分规则,就可以保证整个互联网络里,每一台主机的 IP 地址都是唯一的。
一个子网内部会存在多台主机,由路由器负责跨网段转发。手动维护 IP 地址的分配工作十分繁琐:子网新增设备时,要给它分配空闲 IP;主机下线断开网络后,还要回收对应的 IP 地址,留给后续接入的设备重复使用。
DHCP 技术
IP 地址的分配与回收一般不会靠人工手动操作,而是使用 DHCP 技术自动完成。 DHCP 多用于大型局域网,核心作用是集中管理 IP 地址并动态分配。它可以为网络内主机自动下发 IP 地址、网关地址、DNS 服务器地址等网络参数,省去手动配置 IP 的麻烦,同时提高 IP 地址的利用效率。
DHCP 是基于 UDP 实现的应用层协议。普通路由器一般都内置 DHCP 服务功能,路由器本身就可以充当 DHCP 服务器。 我们设备连接 WiFi 上网时,本质就是路由器通过 DHCP 为设备动态分配一个 IP 地址,设备拿到 IP 之后,就可以依靠这个地址访问网络。
3.分类划分法
之前曾经提出一种划分网络号和主机号的方案,把所有 IP 地址分为五类,如下图所示:
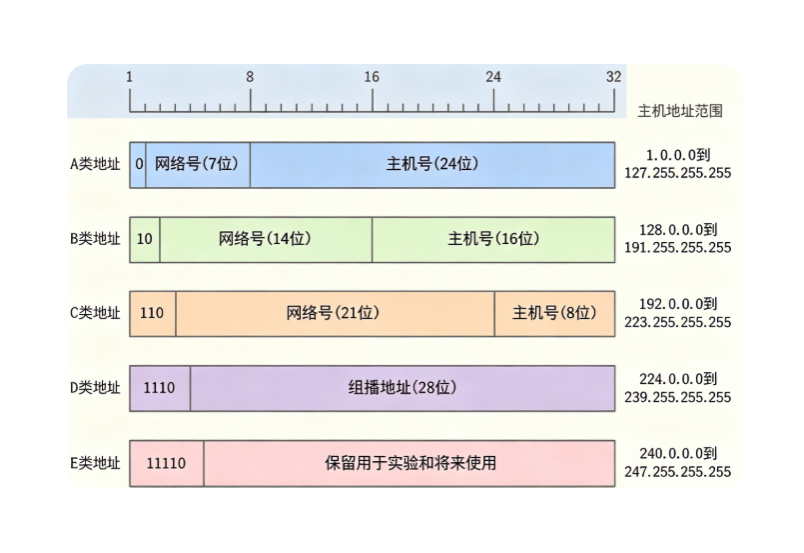
当我们要判断一个 IP 地址是属于哪一类时,其实只需要遍历 IP 地址的前 5 个比特位,第几个比特位最先出现 0 值,那么这个 IP 地址对应就属于 A、B、C、D、E 类地址。
这里可以把 IP 地址想象成一块大蛋糕,按照 A、B、C、D、E 这五类切成不同大小的区块,需要 A 类或者 B 类地址就向机构申请对应的区块,这种地址分配方式就叫做分类编址。
随着互联网快速发展,这套划分方案的缺陷很快暴露出来。很多单位都申请 B 类网络地址,造成 B 类地址资源迅速耗尽,而 A 类地址里却保留了大量闲置地址,资源分配很不均衡。
举个例子,拿到一个 B 类地址,理论上单个子网最多可以容纳 65536 台主机;A 类地址支持的主机数量还要更多。但在实际组网场景里,几乎没有子网会用到这么多主机,这就造成大量 IP 地址白白闲置浪费。
CIDR
我们针对上面这种情况,在分类划分法的基础上引出了一种新的划分方案,称为 CIDR(Classless Interdomain Routing):
- 引入一个额外的子网掩码(subnet mask)来区分网络号和主机号。
- 子网掩码也是一个 32 位的正整数,通常用一串 "0" 来结尾。
- 将 IP 地址和子网掩码进行 “按位与” 操作,得到的结果就是网络号。
- 网络号和主机号的划分与这个 IP 地址是 A 类、B 类还是 C 类无关。
可以给不同的路由器配置不同位数的子网掩码,这样就能看到不同的网络号了。
目的 IP & 当前路由器的子网掩码 = 该报文要去的目的网络
因为不同的路由器一定至少要级联 2 个网络,每一个网络的网络号可能是不同的。每个路由器都要给自己直接链接的网络配置对应的子网掩码。
目标网络和子网掩码是路由器内置好的。
此时一个网络就被更细粒度的划分成了一个个更小的子网,通过不断的子网划分,子网中 IP 地址对应的主机号就越来越短,因此子网当中可用 IP 地址的个数也就越来越少,这也就避免了 IP 地址被大量浪费的情况。
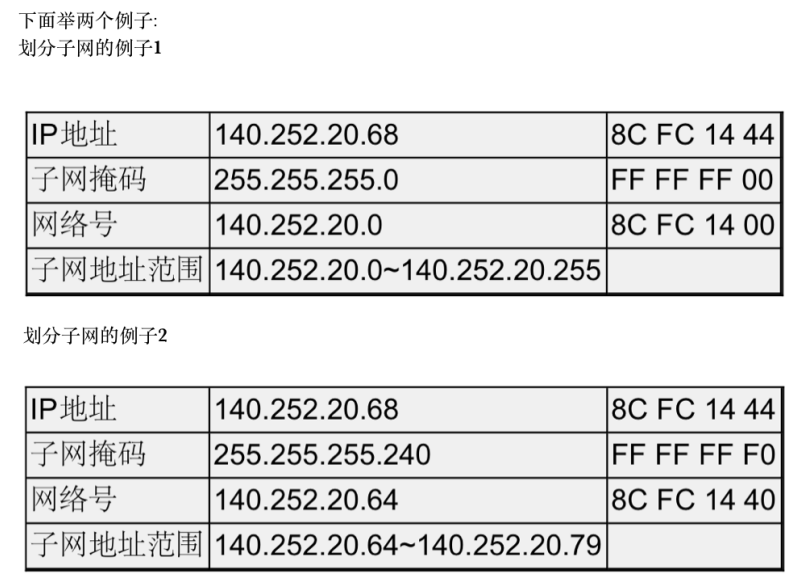
IP 地址和子网掩码做与运算,就能得到网络号。主机号从全 0 到全 1,就是该子网的地址范围。
IP 地址和子网掩码还有一种更简洁的表示方法,比如 140.252.20.68/24。它表示 IP 地址是 140.252.20.68,子网掩码的高 24 位是 1,也就是 255.255.255.0。
举例:在某个子网里,如果把 IP 地址的前 24 位当作网络号,那么对应的 32 位子网掩码,前 24 个比特就全部置 1,剩余 8 个比特置 0,转换成点分十进制写法就是 255.255.255.0。
假设这个子网内有一台主机 IP 为 140.252.20.68,把该 IP 地址和子网掩码做按位与运算,得到结果 140.252.20.0,这就是该子网的网络号。
IP 地址与子网掩码执行按位与运算,本质是保留 IP 地址前 24 位不变,把后面代表主机号的 8 位全部清零。该子网的 IP 地址取值范围就是:【140.252.20.0 ~ 140.252.20.255】。
4.特殊的 IP 地址
不是所有的 IP 都会在公网中使用,有些 IP 地址是有特殊的作用的:
- 将 IP 地址中的主机地址全部设为 0,就成为了网络号,代表这个局域网。
- 将 IP 地址中的主机地址全部设为 1,就成为了广播地址,用于给同一个链路中相互连接的所有主机发送数据包。
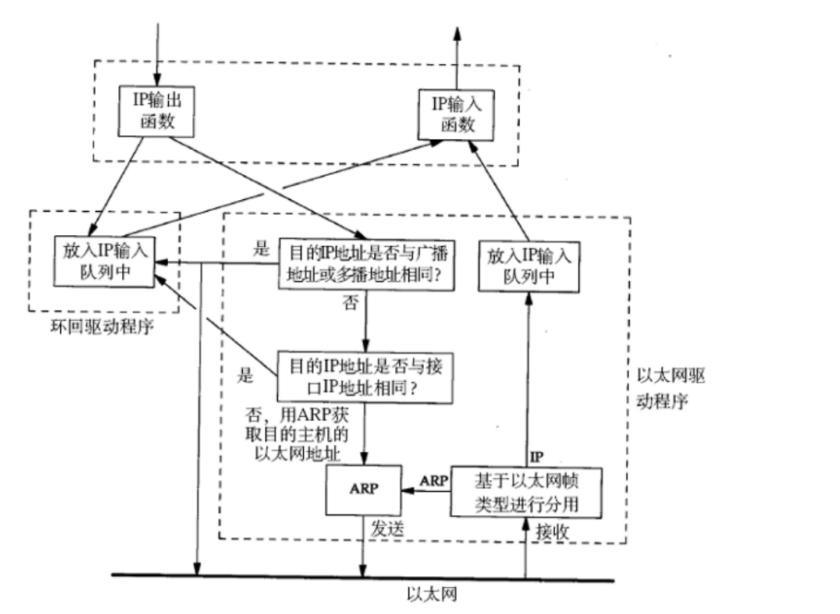
- 127.* 的 IP 地址用于本机环回测试,通常是 127.0.0.1。
5.IP 地址的数量限制
IPv4 的 IP 地址是 4 字节共 32 位的整数,理论上总共有 2^32 个 IP 地址,大约 43 亿个。
TCP/IP 协议要求接入网络的设备要有 IP 地址,那是不是代表最多只能接入 43 亿台主机?
实际可用的地址数量要更少,因为存在一部分保留、特殊用途的 IP 地址,不能分配给普通主机使用。同时 IP 地址并不是按主机数量分配,而是每一块网卡都可以拥有一个或多个 IP 地址。
CIDR 只能提升 IP 地址的利用效率,一定程度缓解地址短缺问题。它减少了地址资源的浪费,但并不会增加 IPv4 地址的总数量上限。
解决 IP 地址不足问题
主要有三种方案:
6.私有 IP 地址与共网 IP 地址
如果企业或机构搭建内部局域网,IP 地址仅用于内网设备互相通信,不直接接入互联网。理论上内网可以随意选用 IP 地址,但 RFC 1918 规范专门划定了几段留给局域网使用的私有 IP 地址。
落在以上区间内的地址就是私有 IP,除此之外的地址属于公网 IP,也叫全局 IP。 私有 IP 仅能在局域网内部使用,不同内网之间可以重复使用相同的私有 IP,以此缓解 IPv4 地址资源紧张的问题。 可以执行命令:ifconfig,查看本机的私网 IP 地址。如下:
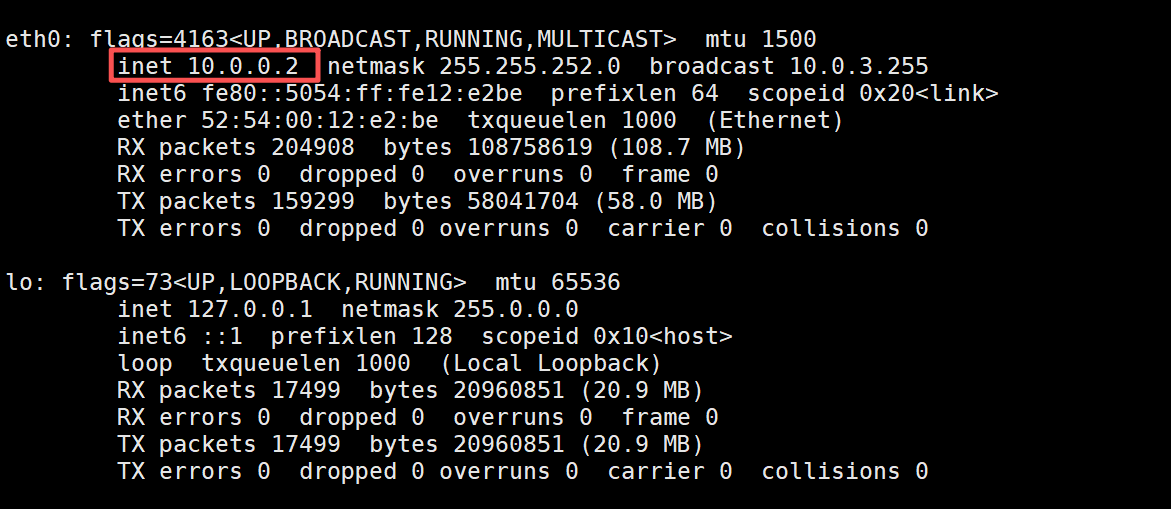
根据上面的结果,可以看到这个 IP 正好在第二种私网 IP 范围内。
7.LAN 口 IP 与 WAN 口 IP
家用路由器:
路由器能够搭建局域网,并且它一定同时处在两个不同子网之间。所以路由器至少要配置两个 IP 地址,分别对应 LAN 口和 WAN 口:
- 对内:LAN 口 IP,也就是接入本地局域网的端口,用来和家里电脑、交换机等内网设备通信。
- 对外:WAN 口 IP,接入广域网的端口,由上级子网分配地址,也就是连接互联网的一侧。
同一个局域网内,两台主机可以直接通信吗?
答案是:可以。
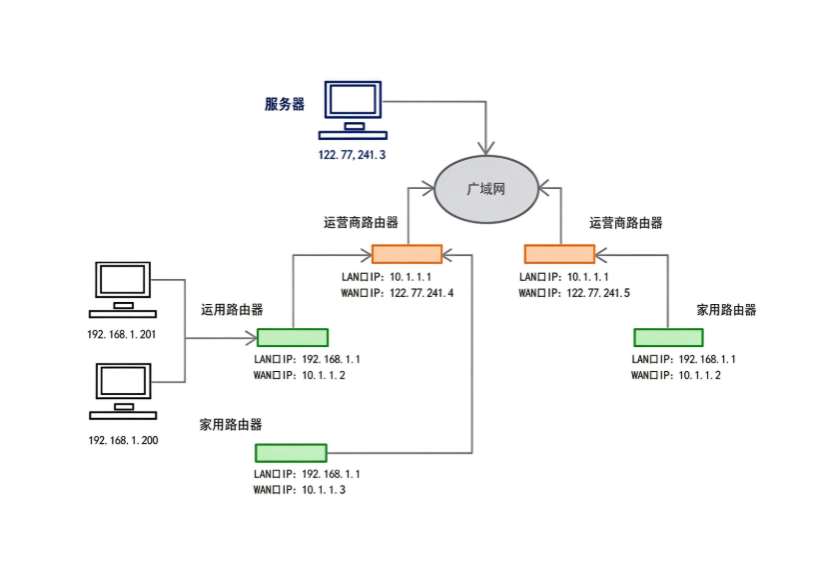
家里要上网,首先需要做什么?
为什么我们平时使用微信、抖音、美团这类 App,却每个月都要向运营商缴费?
互联网底层的网络基础设施,都是由运营商建设和维护的。
为什么我们无法访问 Google、fb 等网站呢?
网络访问会受到网络管控策略的拦截。
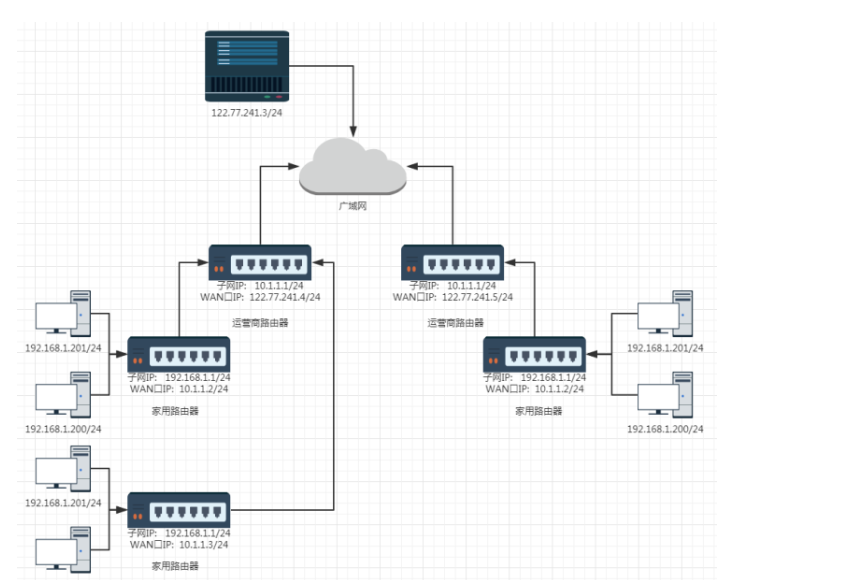
路由器本身就可以搭建局域网,也就是子网。 私有 IP 只在当前子网内生效,所以多个子网之间可以复用相同私有 IP,极大缓解 IPv4 地址短缺的压力。
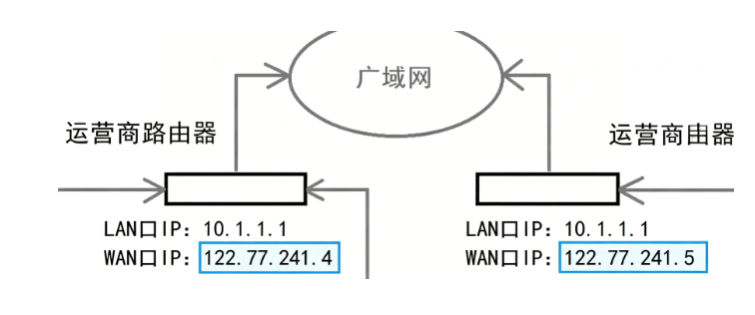
通过上面我们可以看到这两个运营商路由器现在属于一个子网中,如何让他们划分到不同的子网呢?
可以通过更改子网掩码即可。
8.数据包的转发流程(NAT 技术)
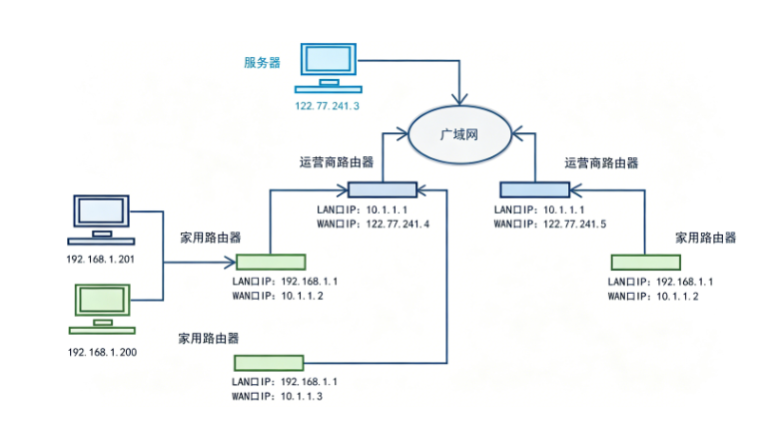
路由器要做的任务: 把报文里的源 IP 替换成路由器 WAN 口的 IP 地址。 每经过一级运营商内网路由器,都会执行这个地址转换操作,公网路由转发时不需要。
结合上面拓扑图可以看到,主机发出的数据不会直接进入公网。报文先交给家用路由器,再交给运营商内网路由器逐级转发,到达公网之后,才能转发到目标服务器。
现在假设我们要从本机访问目标主机:
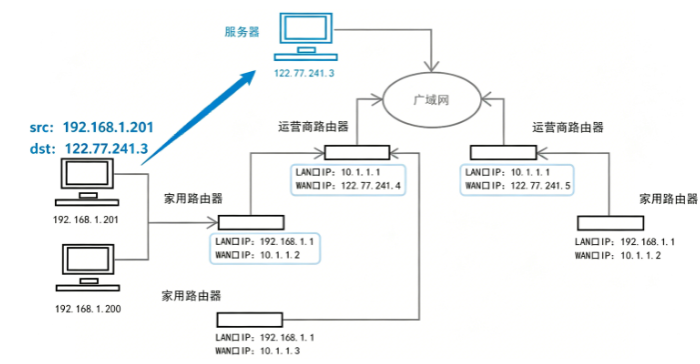
首先本机判断目标 IP 不属于当前局域网,于是将数据包转发给家用路由器。家用路由器同样判断目标 IP 不在自己的子网内,继续把数据包交给运营商路由器。运营商路由器接入广域网,依靠唯一的公网 IP 寻址,最终把数据包送达目标服务器。
但这套流程存在两个问题:
所以真实转发过程是:数据包到达家用路由器时,路由器会将报文的源 IP 替换为自身 WAN 口的 IP 地址。
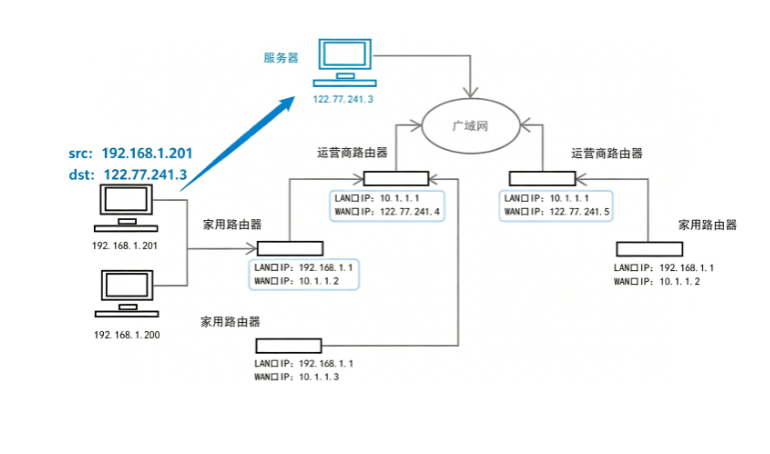
然后对外路由器(运营商路由器)收到报文后,也会重复上面的操作:
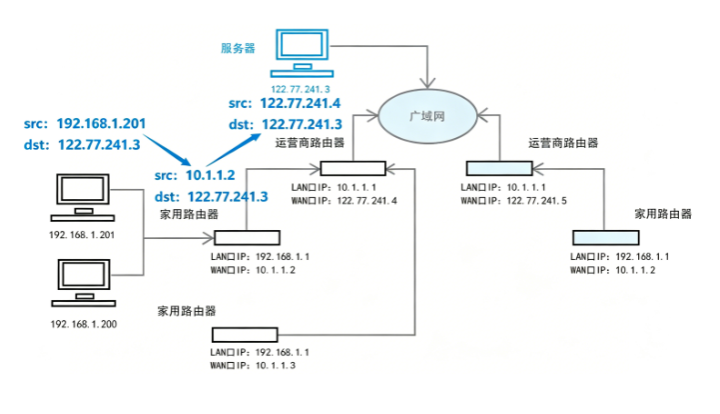
然后就可以把这个替换过的报文转发给目标服务器。此时往回响应的时候 src 就是运营商路由器,这样就是到返回到哪个子网了。
子网内的主机需要和外网进行通信,在转发报文时,路由器不断地将源 IP 首部中的 IP 地址在不同内网、不同层级的网络节点中转发,替换(替换成 WAN 口 IP),最终数据包中的 IP 地址成为一个公网 IP,这种技术称为 NAT(Network Address Translation,网络地址转换)。