论文名片
|
论文名 |
360 Layout Estimation via Orthogonal Planes Disentanglement and Multi-view Geometric Consistency Perception |
|
作者 |
Zhijie Shen、Chunyu Lin、Junsong Zhang、Lang Nie、Kang Liao、Yao Zhao(北京交通大学信息科学研究所;Kang Liao 现为南洋理工) |
|
发表 |
IEEE TPAMI, Vol.46, No.12, pp.10486–10498, 2024年12月;DOI 10.1109/TPAMI.2024.3442481 |
|
arXiv |
2312.16268 |
|
前身 |
CVPR 2023《Disentangling Orthogonal Planes for Indoor Panoramic Room Layout Estimation with Cross-Scale Distortion Awareness》(pp.17337–17345)——本文是其扩展版,新增多视角无监督适配 |
|
索引词 |
360 vision、Manhattan world assumption、horizontal depth、layout estimation |
|
一句话贡献 |
两件事:① 提出 DOPNet,把"垂直压缩成一维"这个粗暴操作改成先把墙面(竖直平面)和地板/天花板(水平平面)分开,各自压缩成语义干净的一维序列;② 提出 MV-DOPNet,用多视角几何一致性在无标注下做自适应 |
名字拆解:DOPNet = Disentangling Orthogonal Planes(解耦正交平面);MV-DOPNet = Multi-View DOPNet。
团队脉络:这个组就是 PanoFormer(ECCV 2022)的原班人马。所以他们对"全景畸变"的理解一脉相承——但这次他们盯上的是另一个被忽视的问题。
一、动机:主流范式有个"原罪"
1.1 主流做法:垂直压缩成一维
从 HorizonNet 开始,全景布局估计几乎统一到一个范式:
2D 特征图 → 沿高度方向压扁 → 一维序列 → 回归边界
这么做的好处我们前面反复讲过:省算力、保留水平方向全部信息。
1.2 但本文指出——这个压缩"把语义搅浑了"
论文原话(摘要 + 引言)两句话,说得很重:
"现有方案倾向于从垂直压缩的序列中恢复房间边界,结果不精确——因为压缩过程混淆了各个平面之间的语义。"
而且更狠的一句:
"这种压缩表示并没有消除全景畸变,它只是把畸变均匀分布了。"
1.3 打个比方你就懂了
想象一间房间,你把它拍成全景图,然后从上到下压扁成一条线:
|
图的上部 |
天花板 |
|
图的中部 |
墙 |
|
图的下部 |
地板 |
压扁之后:天花板的特征、墙的特征、地板的特征全被搅进同一个向量里。
类比:你把一本书的每一页都撕下来,塞进一个信封里摇匀。你还认得出"第 3 页讲了什么"吗?页面之间的界限没了。 这就是"语义混淆"。
为什么这很致命? 因为布局估计恰恰就是要找平面与平面的交界线——墙-天花板线、墙-地板线。你把这三个平面搅在一起,等于把"要找的答案"本身给模糊了。
1.4 第二个问题:标注太贵
论文并列的第二个动机:
这些数据驱动的方法急需海量标注,而标注既费力又耗时。
1.5 所以本文要解决两件事
|
① 压缩混淆了平面语义 |
DOPNet:先解耦正交平面,再各自压缩 |
|
② 标注太贵 |
MV-DOPNet:用多视角几何一致性做无监督适配 |
1.6 核心痛点
正交平面语义纠缠
所有 1D 布局方法,都是把整张图的特征沿高度方向直接压成一条 1D 序列。但这个压缩过程会把天花板、地板、墙面三个互相正交的平面的语义信息揉成一团,论文称之为「正交平面纠缠」。
- 通俗类比:就像把红、黄、蓝三种颜料倒在一起搅匀,你就没法准确分辨每种颜色的深浅了。1D 压缩就是把三个平面的特征混在一起,模型分不清哪个特征对应墙、哪个对应地板、哪个对应天花板,最终预测的边界、深度都会有偏差。
- 直观表现:模型输出的 1D 特征里充满冗余混乱的信息,墙角、边界等关键位置不突出,噪声多。
多视角场景的额外痛点
如果有多个位置拍摄的全景图,之前的方法要么各自预测再拼接,误差大、重叠处错位;要么需要大量标注数据联合训练,成本极高,没法利用无标注多视角数据天然的几何一致性。
1.7 论文核心思路
针对两个场景分别提出解决方案:
二、DOPNet :正交平面解耦网络(单视角,第一部分,监督式)
整体思路(论文原话):
"逐步解耦固有的一维表示",得到 distortion-free(无畸变)、semantics-clean(语义干净)、detail-sharp(细节锐利) 的 horizon-depth / ratio 表示。
输出的两个量(先建立概念)
|
horizon-depth(水平深度) |
水平一圈上每个方向,墙离相机多远——房间的"极坐标俯视图"(LED²-Net 那讲出现过) |
|
ratio(比例) |
相机到天花板的距离 与 相机到地板的距离 之比——决定层高 |
关键设计:这两个量分别从"竖直序列"和"水平序列"回归,互不干扰。
模块 ①:Distortion-Aware Feature Aggregation(畸变感知特征聚合)
做法(两步)
第 1 步:虚拟切平面(virtual tangent plane)
借鉴 PanoFormer 的思路,在全景球面上铺一个虚拟切平面,按投影公式算出无畸变的采样位置,从被拉伸的特征图里取出特征。
第 2 步:可学习偏移 + 跨尺度
- 用可学习的偏移量(learnable offsets)自适应调整采样位置;
- 选第 3 个尺度作为参考尺度,把其他尺度的特征图 resize 到这个尺度;
- 再对每个尺度用可学习采样位置聚合出无畸变特征。
效果:不再"把畸变均匀摊开",而是真正按几何把畸变消除掉。
类比:一张被揉皱的地图。前人是"把褶皱平均分配到整张纸";本文是"按球面几何把纸重新铺平"。
模块 ②:正交平面预分割(Orthogonal Planes Pre-Segmentation)
这是全文最核心的创新。
做法
在压缩成 1D 之前,先让网络学一个二值掩码(binary mask),把场景分成两类:
|
竖直平面 |
墙(walls) |
|
水平平面 |
地板 + 天花板(floors & ceilings) |
然后分别压缩成两条一维序列——一条带"墙"的语义,一条带"地板/天花板"的语义。
为什么要先分开?
因为墙决定"水平形状"(horizon-depth),地板/天花板决定"高度比例"(ratio)。分开之后各自回归,互不干扰。
精妙细节:Soft-Flipping Fusion(软翻转融合)
作者观察到一个几何性质:地板边界和天花板边界在 3D 空间里大多是对称的。
类比:你站在一间方方正正的房间里。地板在你脚下的形状,和天花板在你头顶的形状,其实是上下镜像的。
那直接把特征图上下翻转来用不就行了?
不行——论文专门画了图(Fig.4)说明:实际房间里它们并不严格对称(相机高度不同、有倾斜,家具也只挡地板不挡天花板)。
解法:
类比:你有一张房间的照片,想利用"上下对称"这个先验。但直接镜像翻转会对不准(因为相机不是正好在中间)。于是你先翻转,再用一个可变形的"橡皮筋"把它拉伸对齐,最后和原图叠加——既用了对称先验,又不被现实的不完美所伤。
为什么叫"软"? 因为不是硬翻转,而是可学习的、能变形的翻转。
模块 ③:序列重建(Sequence Reconstruction)
问题
前面"分割 + 压缩"两步会破坏 2D 特征里固有的依赖关系,而且预分割本身可能不准(被家具挡、光照差)。
解法:三重注意力(Triple Attention)
|
① 图卷积通道注意力 |
让每个通道专注有判别力的特征(graph-based channel attention) |
"Discriminative channels" |
|
② 自注意力 |
建立长距离依赖(跨整个 360° 水平视野) |
"Long-range dependencies" |
|
③ 跨注意力 |
让水平和竖直两条序列互相通信,用一条的信息补另一条的缺失 |
— |
还有 残差增强(Residuals)。
一个细节很讲究:通道图卷积是"相减"而非"聚合"
论文原话(很有信息量):
与常见的 pixel-wise 或 object-wise 图不同,通道级图引导节点去"减去"邻居节点的信息,而不是聚合。
为什么? 因为通道之间如果存在冗余(两个通道都在说"这是墙"),相减能突出它们各自的独特贡献——这正是"解耦"想要的效果。
类比:开会时,如果三个人都说同一件事,你让他们互相"减去"重合部分,剩下的才是各自独到的见解。
三、MV-DOPNet:多视角无监督适配(第二部分)
这是 TPAMI 版相对 CVPR 版的新增核心。目标:不用任何标注,把 DOPNet 适配到新场景。
整体流程(论文 Fig.2):
① 每张全景图 → DOPNet 预测 horizon-depth + ratio
↓
② D2L 变换:深度 → 2D 布局边界
↓
③ 多视角布局一致性优化(horizon-depth optimizer)
→ 得到高置信度【伪标签】
↓
④ L2D 变换:布局 → 深度,转回原格式
↓
⑤ 用伪标签微调 MV-DOPNet(含 MV-GCP 模块)
3.1 关键转折:把优化目标从"深度"挪到"2D 边界"
论文说这是该领域针对 horizon-depth 表示的开创性一步(pioneering step)。
为什么不能直接优化深度?
单视角模型预测的深度尺度是不一致的(不同视角、不同模型给出的绝对距离对不上)。
解法:用 D2L / L2D 两个互逆变换
|
D2L(Depth-to-Layout) |
深度 → 2D 布局边界 |
|
L2D(Layout-to-Depth) |
2D 布局边界 → 深度(即 LED²-Net 的那个变换) |
优化在 2D 边界空间做(那里尺度一致),优化完再用 L2D 转回深度格式。
类比:两个人对同一堵墙的距离说法不一(一个说 5 米,一个说 5.5 米)。你别去争论"到底是 5 还是 5.5",而是把两人的说法都画成图上的线,看线重不重合——在"图"这个层面达成一致,再反推距离。
3.2 优化策略:多数原则(majority principle)
论文给出的伪代码要点:
L_p ← 把所有视角的布局边界对齐到同一张画布
l_p ← 在 L_p 中【逐点】按【多数原则】挑选高置信度布局
σ_p ← L_p 的标准差
d̂_p ← L2D(l̂_p)
三个关键词:
- 逐点(point by point):不是整体采纳某个视角,而是每一个点单独投票;
- 多数原则:选"大多数视角都认同"的那个值;
- 标准差 σ_p:衡量"这个点大家分歧多大"——分歧越大,权重越低。
类比:5 个人量同一面墙。不是"听那个看起来最专业的",而是每个位置单独投票:位置 A 有 4 个人说是 5.0 米,就取 5.0;位置 B 大家说法从 3 到 8 米都有(分歧大),那就降低这个点的可信度。
3.3 精妙补充:Ceiling-3D 损失
发现的问题:只优化 horizon-depth,会和没被优化的 ratio 产生错配(mismatch)。
你优化好了"每个方向多远",但"房间多高"没跟着优化——两者拼起来就不自洽。
解法:不直接约束 ratio,而是约束"天花板深度"。
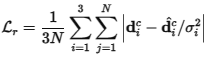
思路:ratio 和 ceiling-depth 可以互相换算。约束 ceiling-depth,就等于隐式约束了 ratio——这样优化 horizon-depth 的收益能顺带分享给 ratio。
类比:你想让一个人长高,但直接拉他胳膊没用。改为调整他的脊柱——身高自然就跟着变了。找个能带动目标的中间量。
3.4 MV-GCP 模块:1D 代价体积(特征级)
这是"多视角几何一致性感知器(Multi-View Geometric Consistency Perceptron)"。
做法(四步)
为什么"1D"代价体积?
传统多视角立体视觉(MVS)用3D 代价体积(H×W×D),很贵。本文指出:布局任务只需要一维就够了——因为布局本质上是"每个水平方向的距离",是 1D 的量。
这是把 3D 代价体积"降维专用化"的思路:任务只需要一维信息,就别建三维的。
它解决了什么?
透过遮挡看东西。 参考视角里被沙发挡住的墙,在另一个视角里可能看得清清楚楚——变形映射过来就补上了。
四、损失函数与训练设置
4.1 两阶段损失
|
预训练 |
Lseg(分割二值交叉熵)+ Llay(布局损失,权重 μ=0.75) |
|
微调 |
法向损失 + 法向梯度损失 + 深度损失 + ceiling-3D 比例损失,权重 λ₁=0.1、λ₂=0.9、λ₃=0.08 |
这套"法向 + 法向梯度"正是 LGT-Net 那套(墙面要平、墙角要转)。本文在其基础上加了 ceiling-3D。
4.2 训练设置
|
输入分辨率 |
512×1024 |
|
GPU |
单张 GTX 3090 |
|
Batch size |
16 |
|
初始学习率 |
1×10⁻⁴ |
五、实验结果(全部取自原文表格)
5.1 单目布局估计:MatterportLayout(通用非长方体,最难的基准)
|
HorizonNet |
81.71 |
79.11 |
0.197 |
0.929 |
|
DMH-Net |
81.25 |
78.97 |
— |
0.925 |
|
LED²-Net |
82.61 |
80.14 |
0.207 |
0.947 |
|
LGT-Net |
83.52 |
81.11 |
0.204 |
0.951 |
|
Ours |
84.11 |
81.70 |
0.197 |
0.950 |
读法:3D IoU 81.70,比 LGT-Net 的 81.11 高 0.59;2D IoU 84.11 领先 LGT-Net 的 83.52 0.59;RMSE 0.197 与 HorizonNet 持平、优于 LED²-Net(0.207) 和 LGT-Net(0.204)。
注意:δ₁ 上 LGT-Net(0.951)略高于本文(0.950),本文在深度准确率上并未全面碾压——但在 IoU(几何精度) 上领先,而 IoU 是布局估计最核心的指标。
5.2 单目布局估计:ZInD(最大规模真实住宅)
|
HorizonNet |
90.44 |
88.59 |
0.123 |
0.957 |
|
LED²-Net |
90.36 |
88.49 |
0.124 |
0.955 |
|
LGT-Net |
91.77 |
89.95 |
0.111 |
0.960 |
|
Ours |
91.94 |
90.13 |
0.109 |
0.960 |
3D IoU 90.13,超过 LGT-Net 的 89.95;RMSE 0.109 是全场最低。四项全面第一。
5.3 长方体数据集(PanoContext / Stanford2D3D)
设置 A:在 PanoContext + 整个 Stanford2D3D 上训 → 在 PanoContext 上测
|
LayoutNet v2 |
85.02 |
0.63 |
1.79 |
|
DuLa-Net v2 |
83.77 |
0.81 |
2.43 |
|
HorizonNet |
82.63 |
0.74 |
2.17 |
|
LGT-Net |
85.16 |
— |
— |
|
LGT-Net(后处理) |
84.94 |
0.69 |
2.07 |
|
Ours |
85.46 |
— |
— |
|
Ours(后处理) |
85.00 |
0.69 |
2.13 |
无后处理 85.46,高于 LGT-Net 的 85.16——PanoContext 上第一。
设置 B:在 Stanford2D3D + 整个 PanoContext 上训 → 在 Stanford2D3D 上测
|
LayoutNet v2 |
82.66 |
0.83 |
2.59 |
|
DuLa-Net v2 |
86.60 |
0.67 |
2.48 |
|
HorizonNet |
82.72 |
0.69 |
2.27 |
|
AtlantaNet |
83.94 |
0.71 |
2.18 |
|
LGT-Net |
85.76 |
— |
— |
|
LGT-Net(后处理) |
86.03 |
0.63 |
2.11 |
|
Ours |
85.47 |
— |
— |
|
Ours(后处理) |
85.58 |
0.66 |
2.10 |
诚实的读法:在 Stanford2D3D 上,本文 85.47 低于 DuLa-Net v2 的 86.60,也略低于 LGT-Net 的 85.76。
这说明:DOPNet 的优势在复杂(非长方体)房型,在简单长方体房型上与 SOTA 互有胜负——这和 LGT-Net 的表现规律一致。
5.4 多视角挑战赛:MVL(MP3D-FPE / HM3D-MVL)
|
HorizonNet (mp3d) |
78.53 |
73.93 |
|
DOPNet (mp3d) |
80.71 |
75.13 |
|
360-MLC |
79.95 |
76.47 |
|
360-MLC-Iter |
80.87 |
77.39 |
|
Ours(MV-DOPNet) |
83.59 |
79.42 |
这是全文最能体现"第二贡献价值"的一组数字:
- DOPNet(单目,无适配):80.71 / 75.13
- MV-DOPNet(多视角无监督适配后):83.59 / 79.42
提升:2D IoU +2.88,3D IoU +4.29。
也就是说:完全不用任何新标注,仅靠多视角几何一致性做自监督微调,就把 3D IoU 提升了 4.29 个点。 这是本文第二部分最大的说服力。
论文报告该方案在 CVPR 2023 的 MVL(Multi-View Layout)挑战赛中取得第一名。
5.5 消融实验(MatterportLayout,2D/3D IoU)
|
完整模型 |
83.46 |
81.34 |
— |
|
w/o Cross-scale interaction(去掉跨尺度交互) |
83.24 |
80.71 |
−0.22 / −0.63 |
|
w/o Feature assembling(去掉特征聚合) |
82.36 |
80.10 |
−1.10 / −1.24 |
|
w/o Disentangling planes(去掉平面解耦) |
83.23 |
80.60 |
−0.23 / −0.74 |
|
w/o Flipping fusion(去掉软翻转融合) |
83.01 |
80.35 |
−0.45 / −0.99 |
|
w/o Discriminative channels(去掉判别通道) |
82.74 |
80.23 |
−0.72 / −1.11 |
|
w/o Long-range dependencies(去掉长距离依赖) |
83.04 |
80.97 |
−0.42 / −0.37 |
|
w/o Residuals(去掉残差) |
82.89 |
80.45 |
−0.57 / −0.89 |
四条读法:
六、优势与局限
✅ 优势
|
直击主流范式的原罪 |
指出"垂直压缩混淆平面语义",并给出解耦方案 |
|
三个模块层层递进 |
无畸变 → 语义干净 → 细节锐利,逻辑清晰 |
|
软翻转融合很巧 |
用对称先验,但用可变形卷积容忍现实的不完美 |
|
通道图卷积"相减" |
专为"解耦"设计的独特机制 |
|
复杂房型优势明显 |
MatterportLayout 81.70、ZInD 90.13,均超 LGT-Net |
|
1D 代价体积高效 |
布局任务只需一维,比 3D 代价体积省得多、够用 |
|
无监督适配增益巨大 |
MVL 上 3D IoU +4.29,零标注成本 |
|
D2L/L2D 转换思路巧 |
把优化从"尺度不一致的深度"挪到"尺度一致的 2D 边界" |
|
代码开源 |
github.com/zhijieshen-bjtu/DOPNet |
❌ 局限
|
简单长方体房型不占优 |
Stanford2D3D 上 85.47 < DuLa-Net v2 的 86.60 |
|
δ₁ 未全面第一 |
MatterportLayout 上 LGT-Net 0.951 > 本文 0.950 |
|
依赖曼哈顿世界假设 |
论文索引词明确含 "Manhattan world assumption"——斜墙、圆弧墙不在射程 |
|
依赖预训练的单目模型 |
无监督适配仍以 DOPNet 为起点,不是从零无监督 |
|
相机高度/尺度假设 |
需假定相机高度才能恢复绝对尺度 |
|
论文未报告参数量与推理速度 |
无法评估部署成本 |
|
消融与主表数字不一致 |
83.46/81.34 vs 84.11/81.70,需注意设定差异 |
七、在方法谱系中的位置
|
HorizonNet |
发明一维表示(省算力) |
|
HoHoNet |
一维表示 + IDCT 解压成密集图 |
|
LED²-Net |
一维表示 + 深度监督 |
|
LGT-Net |
一维表示 + 深度/高度双分支 |
|
DOPNet(本篇) |
指出一维表示"混淆平面语义",先解耦再压缩 |
DOPNet 的独特价值:它不是发明新的一维表示,而是诊断出所有一维方法共有的病——
大家都享受了"压扁"带来的算力红利,却没人认真问:压扁的过程中,墙和地板的语义是不是被搅在一起了?
答案是有。解法是:先分开,再压扁。
八、一句话总结 + 四条可迁移的思路
这篇论文做了一次漂亮的"范式体检":它发现从 HorizonNet 以来大家通用的"垂直压缩成一维"操作有个原罪——把天花板、墙、地板三个平面的语义搅在了一起,而且只是把畸变"均匀摊开"而非消除。于是 DOPNet 改成三步:先用虚拟切平面+可学习偏移做无畸变跨尺度聚合;再让网络学一个二值掩码把竖直平面(墙)和水平平面(地板/天花板)分开,各自压缩(并用一个"软翻转+可变形卷积"来利用上下对称但容忍不对齐);最后用图卷积+自注意力+跨注意力重建序列、互相补缺。第二部分 MV-DOPNet 则用多视角几何一致性做无监督适配——把优化目标从"尺度不一致的深度"挪到"尺度一致的 2D 边界"(D2L/L2D),按多数原则逐点投票出伪标签,再用 1D 代价体积把其他视角的特征变形过来补遮挡。结果:MatterportLayout 3D IoU 81.70、ZInD 90.13 均超 LGT-Net;MVL 挑战赛上零标注微调就把 3D IoU 提升了 4.29 个点。
四条可以带走的思路:
核心贡献
📖 名词小抄
|
DOPNet |
Disentangling Orthogonal Planes Network:解耦正交平面的网络 |
|
MV-DOPNet |
加多视角感知模块的版本,用于无监督适配 |
|
正交平面 |
竖直平面(墙) vs 水平平面(地板、天花板)——互相垂直 |
|
Horizon-depth |
水平一圈每个方向到墙的距离 |
|
Ratio |
相机到天花板距离 / 相机到地板距离——决定层高 |
|
虚拟切平面 |
在全景球面上铺的局部平面,用来算无畸变采样位置 |
|
可学习偏移 |
让采样位置能被网络微调,而不是固定公式 |
|
软翻转融合 |
上下翻转特征 + 3×3 可变形卷积微调 + 融合——利用对称但容忍不对齐 |
|
通道图卷积(相减) |
让通道"减去"邻居信息,突出各自独特贡献(专为解耦设计) |
|
三重注意力 |
图卷积通道注意力 + 自注意力 + 跨注意力 + 残差 |
|
D2L / L2D |
深度↔布局的互逆变换;L2D 即 LED²-Net 的那个 |
|
多数原则 |
逐点投票选高置信度布局;用标准差衡量分歧、降权 |
|
Ceiling-3D 损失 |
不直接约束 ratio,而是约束天花板深度,隐式带动 ratio |
|
1D 代价体积 |
64 个深度平面 + 极坐标可微变形 + 方差聚合 + argmin |
|
极坐标变形 |
用相机位姿把其他视角特征映射到参考视角 |
|
λ₁/λ₂/λ₃ = 0.1/0.9/0.08 |
微调阶段各损失权重 |
|
MatterportLayout / ZInD / PanoContext / Stanford2D3D / MVL |
五个评测集 |