OpenAI在2026年9月8日发布GPT Image 2.5 Sunburst与Flare。两者都支持文本和图像输入,可通过Image API或Responses API使用,也都支持low到max等质量档位。真正的区别不是“新旧版本”,而是Sunburst优先服务精确编辑,Flare优先服务快速日常生成。本文给出选型规则、Python接入示例和上线前检查清单。
OpenAI这次没有只发布一个统一的图像模型,而是同时推出:
- gpt-image-2.5-sunburst
- gpt-image-2.5-flare
官方对两者的定位很直接:Sunburst是更强调图像生成和编辑能力的默认高能力模型,尤其适合对编辑精度要求高的工作;Flare强调快速完成高质量的日常图像生成。
因此,选型时不要只问“哪个更强”,而要问:当前任务最怕编辑失真,还是最怕生成等待时间过长?
一、Sunburst与Flare怎么选
| 修改商品图中的局部元素 | Sunburst | 更重视编辑精度与细节保持 |
| 根据参考图连续调整成品 | Sunburst | 适合多轮修改和高要求成品 |
| 生成封面草稿、配图候选 | Flare | 更强调快速的日常图像生成 |
| 批量探索不同视觉方向 | Flare | 先用速度换取更多候选更合理 |
| 最终交付图对文字和局部结构要求高 | Sunburst | 精度比生成速度更重要 |
| 实时产品里需要尽快给用户看到结果 | Flare | 响应速度通常更重要 |
上表后四项是工程选型建议,不代表Flare不能编辑,也不代表Sunburst一定很慢。官方明确的核心差异只有两个:Sunburst偏精准编辑,Flare偏快速日常生成。最终仍应使用自己的真实图片、提示词和质量参数做测试。
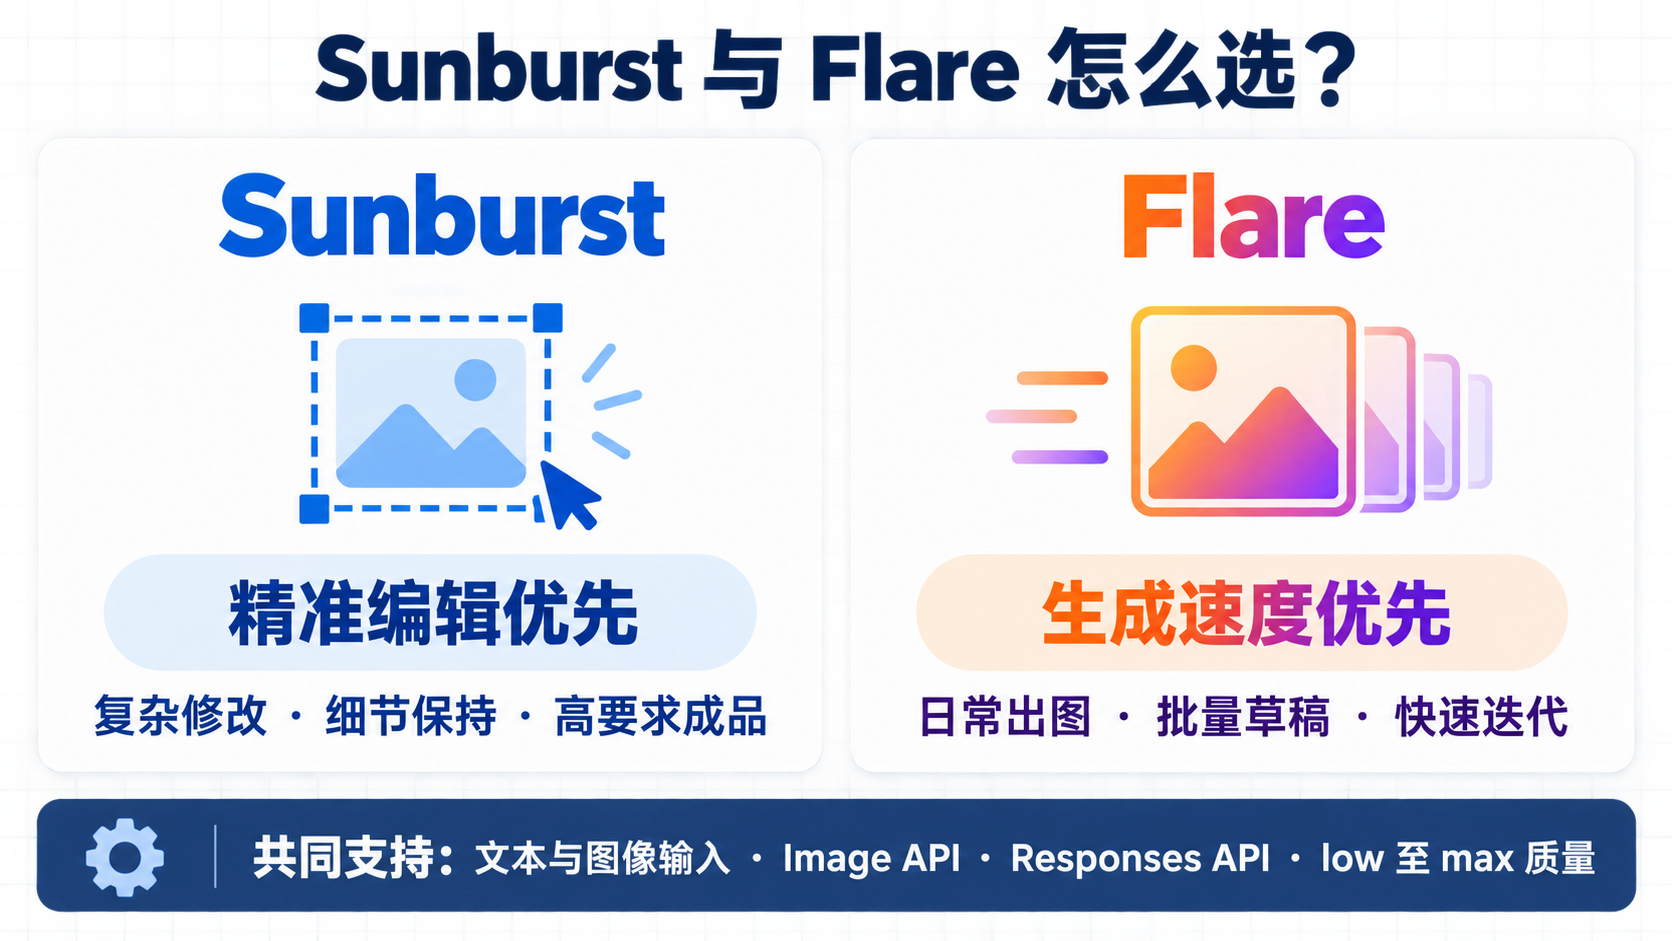
二、两款模型有哪些共同能力
根据OpenAI API更新日志,GPT Image 2.5 Sunburst和Flare均在2026年9月8日开放,支持Image API和Responses API图像生成工具。
两者都支持:
自定义尺寸并不是任意填写。官方当前要求宽高均为16的倍数,长宽比在1:3到3:1之间,单边不超过3840像素,总像素数在655,360到8,294,400之间;超过2560×1440的分辨率仍属于实验范围。
如果需要透明背景,要同时设置:
background = transparent
output_format = png 或 webp
JPEG不支持透明背景。
三、使用Image API生成图片
如果应用只需要“给提示词,拿到图片”,Image API通常是更直接的入口。
下面以Flare生成日常封面图为例:
from openai import OpenAI
from pathlib import Path
import base64
client = OpenAI()
result = client.images.generate(
model="gpt-image-2.5-flare",
prompt=(
"为一篇Python性能优化文章生成横版封面。"
"深蓝科技背景,主体是代码编辑器和速度仪表,"
"画面简洁,不要品牌Logo,不要水印。"
),
size="1536×864",
quality="high",
output_format="png",
)
image_bytes = base64.b64decode(result.data[0].b64_json)
Path("python-performance-cover.png").write_bytes(image_bytes)
API Key应保存在服务端环境变量中,不要写进Python文件、前端JavaScript、Git仓库或公开截图。生产环境应使用密钥管理服务,并限制谁可以读取和调用。
如果草稿确定后要做高精度局部修改,可以把模型换成:
model="gpt-image-2.5-sunburst"
但不要只替模型名就上线。编辑任务还需要测试输入图数量、遮罩、参考图细节保持和提示词约束。
四、在Responses API里调用图像工具
当图片生成只是一个复杂任务中的一步,例如“先分析需求,再生成图,再根据反馈继续修改”,可以使用Responses API的图像生成工具。
from openai import OpenAI
from pathlib import Path
import base64
client = OpenAI()
response = client.responses.create(
model="gpt-6-astra",
input=(
"为一个开发者工具设计横版功能介绍图。"
"先理解信息层级,再生成最终图片。"
),
tools=[{
"type": "image_generation",
"model": "gpt-image-2.5-sunburst"
}],
)
images = [
item.result
for item in response.output
if item.type == "image_generation_call"
]
if not images:
raise RuntimeError("本次响应没有返回图片")
Path("developer-tool.png").write_bytes(base64.b64decode(images[0]))
这种方式可以把文字推理、工具调用和图片生成放进同一条任务链;代价是除了图像生成成本,还会产生主模型的token用量。只需要单次出图时,不必为了“接口更新”强行改成Responses API。
五、quality不要一律写max
GPT Image 2.5增加了xhigh和max,但更高档位并不等于所有阶段都应该使用。
建议把图像生产拆成三层:
方向探索:Flare + low/medium
可用草稿:Flare或Sunburst + high
最终成品:Sunburst + xhigh/max
这是成本与等待时间的工程策略,不是官方固定规则。真实项目可以建立自己的评测集,每个任务至少记录:
- 是否准确完成提示词;
- 中文文字是否正确;
- 参考图主体是否保持;
- 局部修改是否影响无关区域;
- 生成耗时;
- 单张图实际token与成本;
- 人工返工次数。
如果max只让图片细节略有增加,却没有减少人工返工,它就不一定是成本更优的选择。
六、成本计算有三个容易忽略的点
1. 同一质量档位不代表两模型消耗完全相同
官方说明两款模型使用相同的图像token单价,但在相同质量设置下,它们可能使用不同数量的token。因此,不能只比较high或max这个参数名称,要读取真实返回的用量。
2. Responses API还会产生主模型费用
使用Responses API图像工具时,主模型负责理解和编排任务,它的token用量与图像生成费用分别计算。只统计最终图片的图像token会低估总成本。
3. 流式局部图也会增加成本
两类API都支持图片流式生成。partial_images可设置为0到3,让用户在最终图完成前看到局部结果。但每张局部图也会增加图像输出token,不能把它理解成免费的进度预览。
如果产品并不需要实时展示,保持partial_images=0通常更简单。
七、上线前的AB测试方法
不要拿两条不同提示词比较模型。更可靠的测试应固定:
可以准备三类测试集:
A组:纯文本生成
B组:参考图风格与主体保持
C组:局部编辑和文字修改
如果Flare在A组已经满足质量要求,就没有必要全部切到Sunburst;如果C组经常出现未修改区域漂移,再把精确编辑任务交给Sunburst。
八、常见迁移误区
误区1:Sunburst是正式版,Flare是轻量版
官方没有这样定义。它们是两种不同侧重:一个强调编辑精度,一个强调快速日常生成。
误区2:把旧模型名直接替换就完成迁移
新模型增加了质量档位和自定义尺寸能力,成本结构也需要重新测量。只替换模型名可能能运行,却不代表已经完成生产验证。
误区3:默认使用auto,同时要求精确估算成本
auto会根据任务决定实际设置,不适合拿来做固定参数下的严格预算。做成本评估时,应明确指定模型、质量和尺寸。
误区4:所有图片都用Sunburst最高质量
探索阶段的大量草稿没有必要全部使用最高精度。先用Flare快速筛选方向,再对少量候选做精细编辑,通常更符合工程效率。
九、最终选择建议
局部编辑失败的损失更高 → Sunburst
生成等待影响用户体验 → Flare
还不知道任务偏哪一类 → 用同一测试集AB测试
草稿到成品是完整流程 → Flare探索,Sunburst精修
GPT Image 2.5真正值得关注的,不只是多了两个模型名,而是OpenAI把“生成速度”和“编辑精度”拆成了可选的工程路径。模型选对以后,还要同时控制质量、尺寸、流式局部图和主模型token,才能得到稳定的成本与交付速度。
官方资料
- OpenAI API Changelog
- GPT Image 2.5 Sunburst模型说明
- GPT Image 2.5 Flare模型说明
- OpenAI图像生成开发指南

实现100%通过率-171主机测评](https://www.171host.com/wp-content/uploads/2026/10/20261026191216-6adfa61015a7f-220x80.gif)