目录
前言
一、先说说时序预测为什么难
二、它到底是什么
三、时序分析能力拆解
四、实际接入手:几分钟跑通一次预测
五、什么场景值得用
六、接入前的几点实操建议
结语
前言
很多团队不是不知道预测重要,而是被建模这件事劝退:买显卡、训模型、调参数、再部署,周期长还不一定准。TimechoAI 走的是另一条路——模型能力直接做成云服务,拿到 API Key,把历史数据传进去,就能拿回未来一段时间的预测值。
一、先说说时序预测为什么难
时序预测这个需求其实到处都是:电网要预测明天的负荷,仓库要预测下个星期的销量,运维要判断设备什么时候出问题,云平台要提前知道流量峰值什么时候来。问题都能抽象成一句话——看过去的数据,猜未来的数值。
但真做起来就不是那么回事了。经典统计方法如 ARIMA、Holt-Winters,对平稳、规律明显的数据还行,一旦碰上节假日波动、多因素互相影响的真实业务数据,效果就开始飘。深度学习方案精度好一些,可前提是你得有人懂模型、有机器训练、有时间反复调参,最后还要解决部署和并发推理的问题。很多企业卡在这一步,预测系统年年立项,年年落不了地。
TimechoAI 的思路是把这些重活全部收走:模型由平台训练和维护,用户只管用。
二、它到底是什么
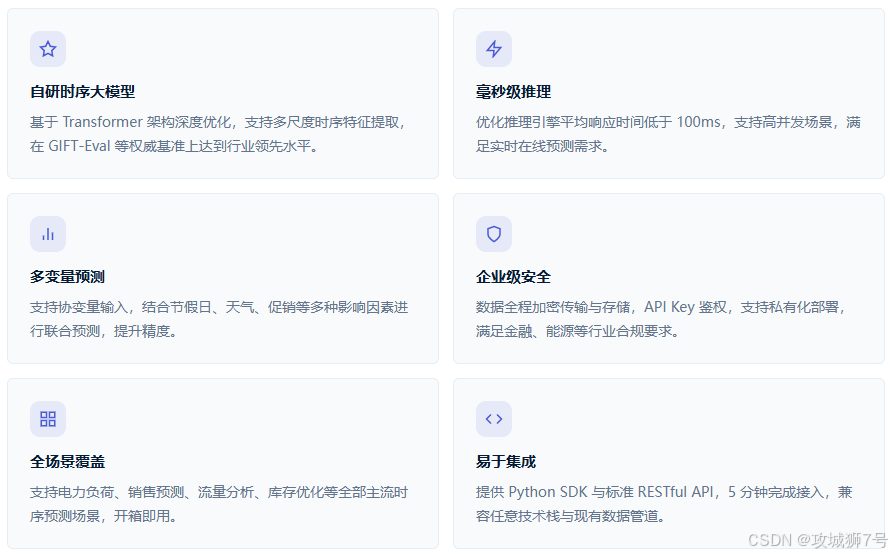
TimechoAI 是一个时序大模型云服务,核心模型来自清华大学的 Timer 时序大模型系列。它不是只提供单一模型,而是把几种路线打包在一起,目前可选的模型包括:自研的 Timer-3.5、Timer-3.0,基于 Transformer 架构的时序基础模型 Chronos-2,以及经典的 AutoARIMA 和 Holt-Winters。不想选的话,直接用 Auto 模式,平台根据数据特征自动匹配。
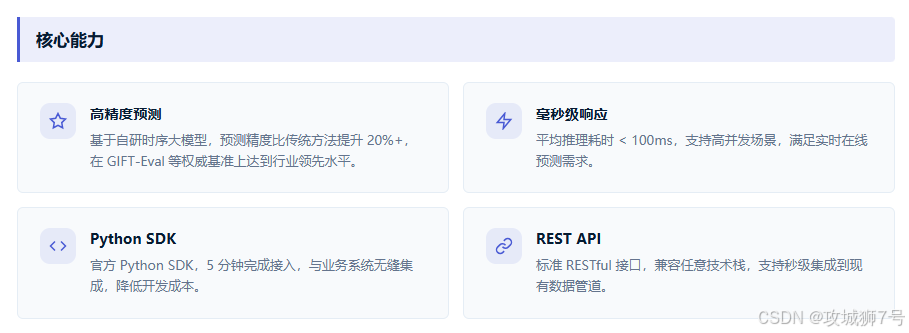
这个设计很务实。真实数据千差万别,规律性强的小数据用统计模型就够了,复杂模式才需要大模型,统一让用户自己选模型反而是把负担甩给用户。官方给出的指标也比较有底气:预测精度相比传统方法提升 20% 以上,在 GIFT-Eval 这类权威时序评测基准上处于行业领先水平;平均推理耗时小于 100 毫秒,能支撑在线实时预测。
三、时序分析能力拆解
光说“大模型”容易虚,具体到功能层面,有几点值得讲。
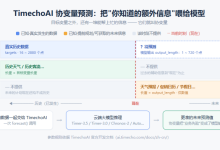
一是协变量支持,这决定了模型能不能贴近真实业务。现实中预测目标很少是孤立的。预测销量要考虑气温和促销,预测设备温度要结合负载和转速。TimechoAI 允许传入两类协变量:历史协变量(和目标序列等长的历史因素)和未来协变量(预测区间内已知的信息,比如已经发布的天气预报)。后者尤其有用,相当于让模型在“已知部分未来条件”的情况下做预测,精度通常会明显好于只看目标自身。
二是自动数据适配。参数 `auto_adapt` 默认开启,会自动处理缺失值、采样频率不齐、量纲不统一这类常见脏数据问题。做过数据工程的人都知道,预测项目里大半时间花在数据清洗上,这个开关能省掉不少前置工作。
三是输入输出范围覆盖主流场景。单次输入目标序列长度在 16 到 2880 个点之间,预测长度 1 到 720 个点。换算一下,按小时粒度算,输入能覆盖四个月,输出能预测一个月;按分钟粒度算,也足够做日内的短期预测。绝大多数业务需求落在这个区间里。
四是数据质量评估。这是官方文档里标注“即将上线”的功能,但思路值得一提:正式预测前,先从完整性(缺失点、冗余点、延迟到达)、可预测性(用频域谱熵判断序列到底有没有规律)、相关性(多条序列间的皮尔逊系数)三个维度给数据打分。这条逻辑很朴素但重要——白噪声一样的数据,喂给什么模型都没用,先评估再建模,能少走弯路。
四、实际接入手:几分钟跑通一次预测
纸上谈兵没意义,直接看接入流程。
第一步注册控制台账号、拿到 API Key,还可以先在网页端新建会话,用交互式界面直接贴数据体验,不写一行代码先确认效果。
开发集成有两种方式。标准 REST 接口兼容任何技术栈,一个 POST 请求就能调;Python 用户用官方 SDK 更顺手,Python 版本要求 3.10 到 3.12,安装就一行:
pip install timecho-ai
最简单的单变量预测,核心代码也就这么几行:
import pandas as pd
from timecho_ai import TimechoAIClient
client = TimechoAIClient(api_key="你的API Key")
raw_df = pd.read_csv("https://ai.timecho.com/data/sample.csv")
# 输入16个历史点,预测未来8个点
target = raw_df[["time", "target"]][:16]
result = client.forecast(targets=target, output_length=8)
print(result[0])
没有模型定义,没有训练循环。返回结果直接带预测值,官方文档里的示例能看到 8 个时间点的完整输出。带上温度、湿度这类协变量时,只要再传一个 `history_covs` 即可,其余流程不变。
工程化方面 SDK 也考虑到了:401 密钥失效、429 限流、503 服务暂不可用、网络超时等情况都有独立异常类型,线上代码可以针对性做重试和告警,不用自己解析错误码。
五、什么场景值得用
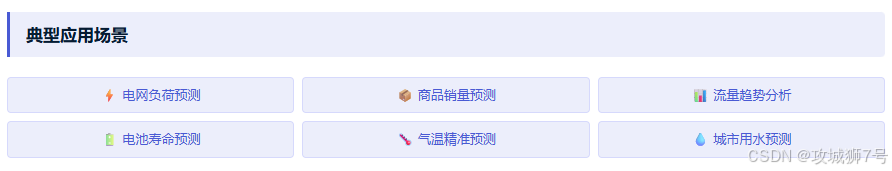
官方列出的典型场景包括电网负荷预测、商品销量预测、流量趋势分析、电池寿命预测、气温预测和城市用水预测。判断自己的业务适不适合,可以对照几个条件:数据按固定频率采集且带时间戳;历史里存在规律而不是纯随机波动;历史数据量建议不少于预测步长的两倍;预测目标是一个可以量化的数值。
满足这些条件的,基本都可以试。工厂可以做设备状态预测,把事后抢修变成视情维修;IT 团队可以预测流量峰谷,提前扩缩容;供应链可以做产能和需求预判,给交期承诺一个量化依据。建议从一个具体指标、一个具体场景先跑通,用最近一段数据做回测,看模型在没见过的数据上表现如何,再谈推广。
另外提一句数据底座。TimechoAI 背后的厂商同时提供基于 Apache IoTDB 的企业级时序数据库 TimechoDB,数据本身存在 IoTDB/TimechoDB 里的话,从写入、压缩、特征治理到模型预测是一条链路,不用在几个系统之间倒腾海量数据。数据量大的工业企业,这点要重点考虑。
六、接入前的几点实操建议
第一,先用控制台验证,再谈系统集成。网页端会话支持直接贴数据看预测曲线,零成本判断这个场景值不值得投入开发,比一上来就写代码稳妥得多。
第二,协变量往往比换模型更影响精度。很多人拿到结果不准,第一反应是模型不行,实际上是没把已知的影响因素喂进去。能提供未来协变量的场景(排班计划、天气预报、促销日历),尽量提供。
第三,关注回测而不是拟合。模型在历史数据上拟合得好看,不代表未来预测准。正规做法是留出最近一段时间的数据不参与输入,让模型“盲测”,对比预测值和真实值的误差,再决定是否上线。
第四,异常处理要提前设计。线上调用时 429 限流和偶发 5xx 都可能出现,结合 SDK 的异常分类做指数退避重试和降级策略,比事后救火强得多。
结语
时序预测的门槛,过去高在“建模型”,现在正在变成“提需求”。TimechoAI 把训练、选型、推理这些环节封装成服务,业务团队几行代码就能拿到结果,对没有算法团队的企业是很现实的选择。当然,预测结果永远是基于历史的统计判断,黑天鹅事件不在模型认知里,把它当作决策参考而不是唯一依据,才是正确的使用姿势。
相关入口:
– 企业版官方链接:[https://timecho.com](https://timecho.com)
– 时序大模型 TimechoAI:[https://ai.timecho.com/](https://ai.timecho.com/)(文档地址:[https://ai.timecho.com/docs/zh-cn/](https://ai.timecho.com/docs/zh-cn/))