先看全景:这两个库在项目里各自站哪个位置
一个典型的 C++ 网络服务(比如消息队列、RPC 框架、游戏网关),骨架大致是三层: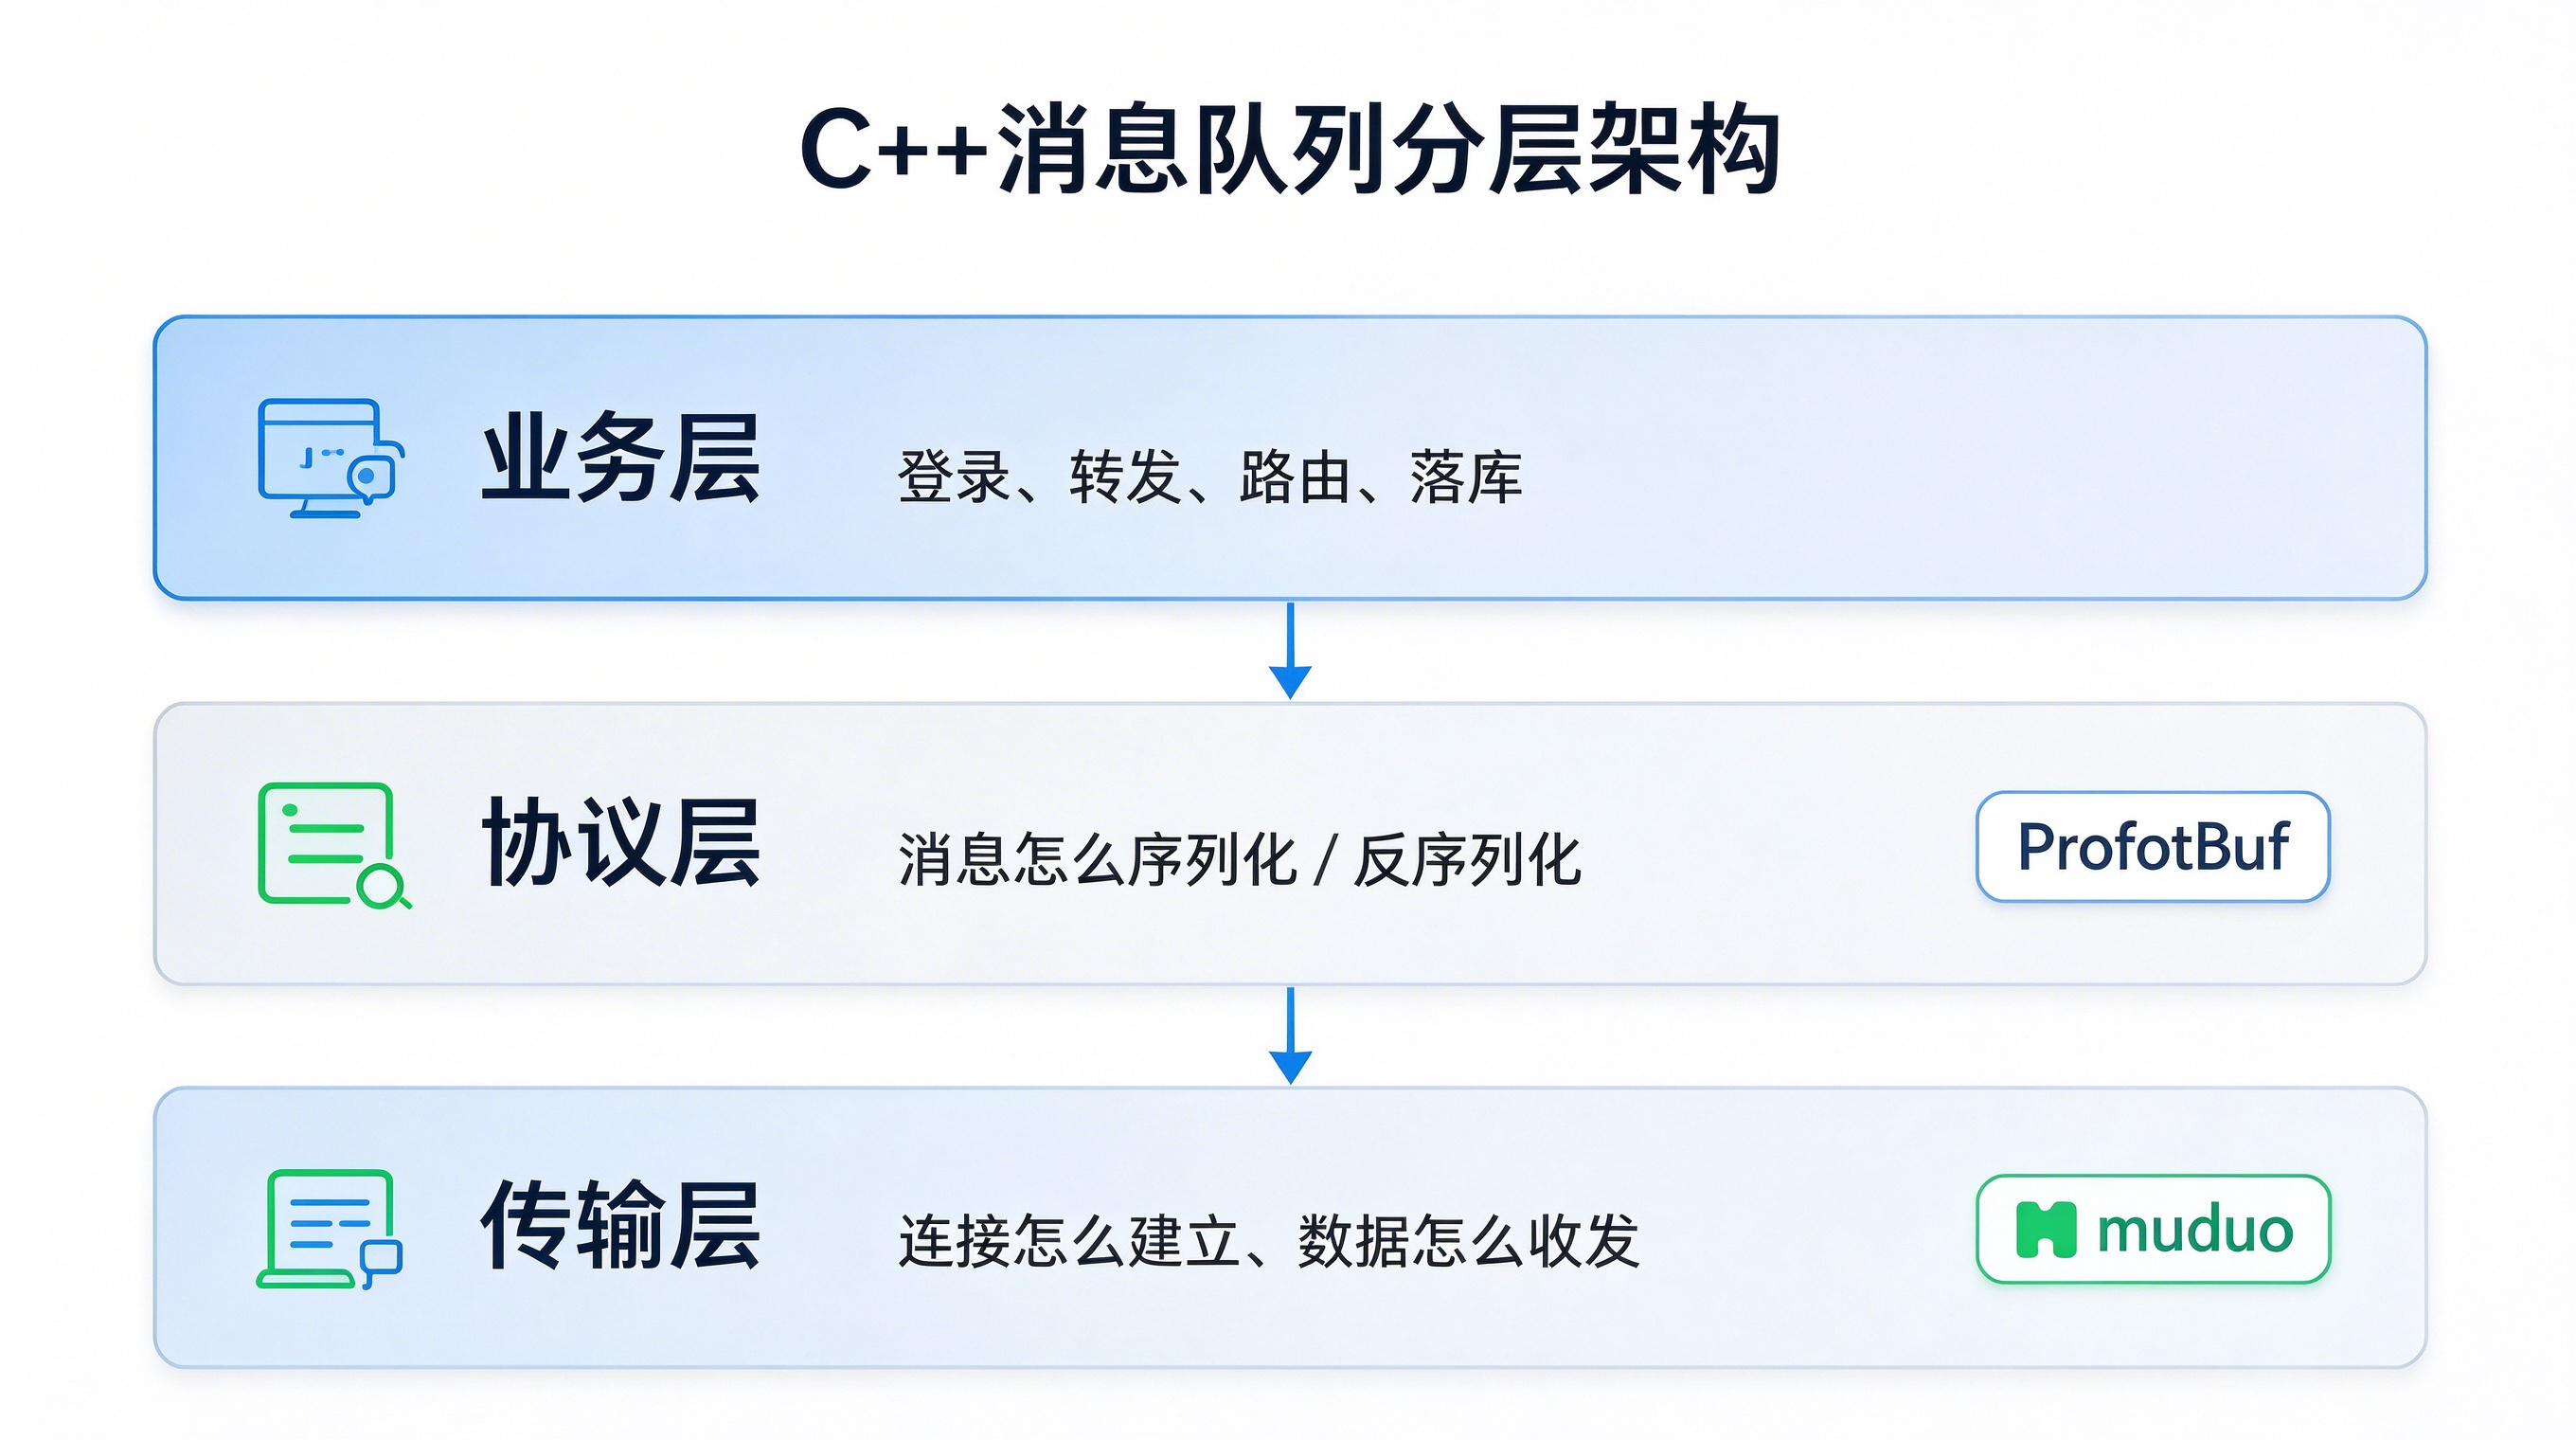
- Protobuf 是"协议层"的答案:你用 .proto 描述数据结构,编译器给你生成 C++ 类,序列化出来是紧凑的二进制,跨语言、跨平台、可向后兼容地演进。
- Muduo 是"传输层"的答案:陈硕写的非阻塞 IO + 事件驱动网络库,主从 Reactor 模型,one loop per thread,让你用「注册回调」的方式写高并发 TCP 服务,而不用手写 epoll 那套状态机。
两者组合起来,就是一个能对外提供稳定二进制协议服务的最小工业级骨架。下面分两大块讲。
第一部分:Protobuf
1.1 Protobuf 是什么
Protocol Buffers(简称 Protobuf / PB)是一套数据结构序列化与反序列化框架。三个核心特点:
| 语言无关、平台无关 | 一份 .proto 可生成 Java / C++ / Python / Go 等多语言代码,天然支持跨端通信 |
| 高效 | 二进制编码 + 变长整数编码,比 XML 更小、更快、更简单(典型场景体积约为 JSON 的 1/3 ~ 1/10) |
| 扩展性、兼容性好 | 可以往 message 里加字段而不破坏已经上线的旧程序——这是它能做长期协议演进的根本原因 |
为什么"加字段不破坏旧程序"能成立
这是 PB 最值钱的设计,值得单独说清楚:
- 每个字段都有唯一编号,编码进字节流的是编号,不是字段名;
- 新版本增加的新编号,旧程序解析时不认识就跳过(skip),不会报错;
- 旧程序发的数据缺少新字段,新程序读到的是字段默认值(proto3 中标量默认是 0 / 空串 / false)。
所以协议演进的原则是:只加不减、不换类型、不复用编号。
1.2 Protobuf 使用流程
标准三步走:
1. 写 .proto 文件 定义 message 及其字段
↓
2. protoc 编译 .proto 生成 xxx.pb.h / xxx.pb.cc
↓
3. 在业务代码里 include 用生成的类 set/get 字段、序列化、反序列化
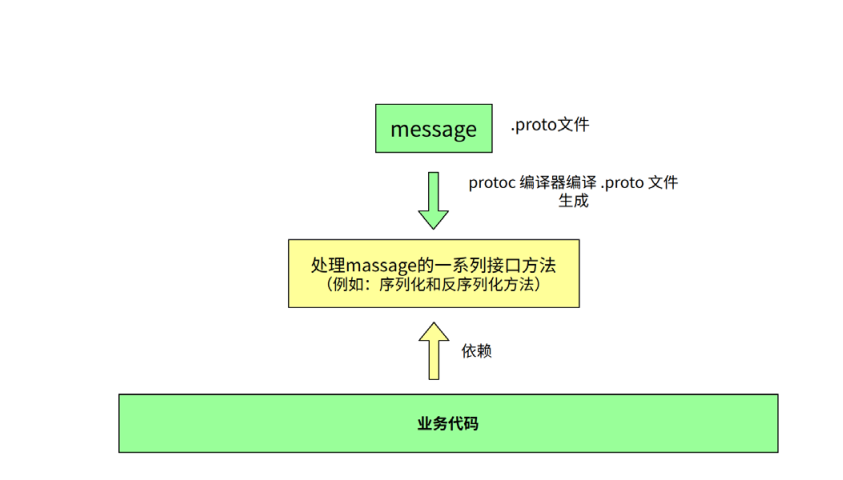
可以理解为:.proto 是"协议源码",protoc 是"协议编译器",.pb.h/.pb.cc 是"协议 SDK"。改协议 = 改 .proto 重新编译,业务代码跟着编,永远不存在"手写解析函数写漏一个字段"的问题。
下面用一个通讯录 Demo 把这套流程完整跑一遍。
1.3 快速上手:通讯录 Demo
Demo 目标很朴素,但足以覆盖全部关键动作:
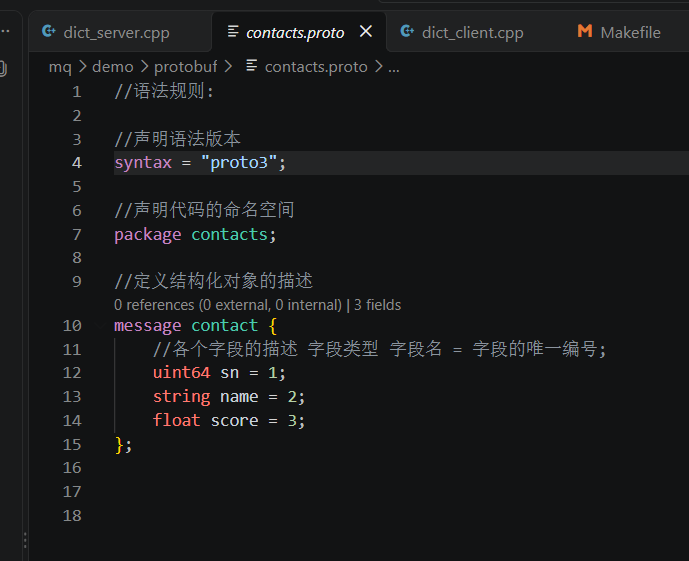
Step 1:创建 .proto 文件
命名规范:文件名全小写,多个单词用 _ 连接,例如 lower_snake_case.proto。 缩进规范:文件内代码统一 2 个空格缩进(不是 4 个,这是官方风格)。
新建 contacts.proto。
Step 2:加注释
支持 // 单行与 /* … */ 多行,和 C++ 一致。
Step 3:指定 proto3 语法
syntax = "proto3";
- proto3 是当前最新的语法版本,简化了 proto2 的写法,且必须写在除去注释后的第一行;
- 不写这行,编译器默认按 proto2 解析——很多"为什么生成代码里多了一堆 has_xxx()"的疑惑都源于此。
Step 4:package 声明(可选但强烈建议)
package contacts;
- package 表示 .proto 的命名空间,用来避免不同模块间 message 重名冲突;
- 编译成 C++ 后,它会变成同名的 namespace,即 contacts::PeopleInfo;
- 项目里要有唯一性,通常用「项目名.模块名」的层级写法,如 package mq.common;。
Step 5:定义 message
消息(message) 就是我们要传输的结构化对象。在网络里,双方必须先"定制协议"——说白了就是约定结构体长什么样;PB 用 message 来承载这件事,并据此帮你生成类和方法。
message 消息类型名 {
}
命名规范:驼峰命名,首字母大写。
syntax = "proto3";
package contacts;
// 定义联系人消息
message PeopleInfo {
}
Step 6:定义消息字段
字段格式:
字段类型 字段名 = 字段唯一编号;
三条规范务必记住:
标量类型对照表(以 C++ 为例)
| double | 8 字节浮点 | double |
| float | 4 字节浮点 | float |
| int32 | 变长编码。负数的编码效率较低——字段可能为负时应用 sint32 | int32 |
| int64 | 变长编码。负数的编码效率较低——字段可能为负时应用 sint64 | int64 |
| uint32 | 变长编码 | uint32 |
| uint64 | 变长编码 | uint64 |
| sint32 | 变长编码,符号整型,负值编码效率高于 int32 | int32 |
| sint64 | 变长编码,符号整型,负值编码效率高于 int64 | int64 |
| fixed32 | 定长 4 字节。值常大于 2<sup>28</sup> 时比 uint32 更高效 | uint32 |
| fixed64 | 定长 8 字节。值常大于 2<sup>56</sup> 时比 uint64 更高效 | uint64 |
| sfixed32 | 定长 4 字节 | int32 |
| sfixed64 | 定长 8 字节 | int64 |
| bool | 布尔 | bool |
| string | UTF-8 / ASCII 字符串,长度不超过 2<sup>32</sup> | std::string |
| bytes | 任意字节序列,长度不超过 2<sup>32</sup> | std::string |
关于变长编码(Varint):经过 PB 编码后,原本需要 4 字节或 8 字节的数,可能只占 1~2 个字节。 这就是为什么 int32 age = 20; 编码出来只有一个字节——小数值极其省空间。 而负数在 Varint 里会被当作 64 位补码处理,固定占 10 个字节,所以"可能为负"的字段一定优先选 sint32 / sint64。
另注:bytes 在 C++ 里同样映射为 std::string,但语义是"裸字节",不要直接当文本用。
更新 contacts.proto,加入姓名与年龄
syntax = "proto3";
package contacts;
message PeopleInfo {
string name = 1;
int32 age = 2;
}
字段编号的两个硬性约束
A. 取值范围:1 ~ 536,870,911(即 2<sup>29</sup> − 1),其中 19000 ~ 19999 不可用。
19000~19999 是 PB 协议实现内部预留的。硬写上去,编译期就会告警:
// 消息中定义了如下编号,代码会告警:
// Field numbers 19,000 through 19,999 are reserved for the protobuf implementation
string name = 19000;
B. 1 ~ 15 编号只占 1 个字节,16 ~ 2047 占 2 个字节。
编码后的字节不仅包含编号,还包含字段类型(wire type)。所以:
1 ~ 15 应该留给出现最频繁的字段,同时为将来可能新增的高频字段预留几个低编号。
这是一条"协议设计时就要想清楚"的性能约束,不是编译器会帮你兜底的东西。
Step 7:编译 contacts.proto
命令行格式:
protoc [–proto_path=IMPORT_PATH] –cpp_out=DST_DIR path/to/file.proto
参数含义:
| protoc | Protocol Buffers 提供的命令行编译工具 |
| –proto_path / -I | 指定被编译 .proto 文件所在目录,可多次指定。不指定则默认在当前目录搜索。当 .proto 之间互相 import,或被编译文件不在当前目录时,必须用 -I |
| –cpp_out=OUT_DIR | 指定生成 C++ 代码,以及输出目标目录 |
| path/to/file.proto | 要编译的 .proto 文件 |
编译我们的通讯录:
protoc –cpp_out=. contacts.proto
生成两个文件:
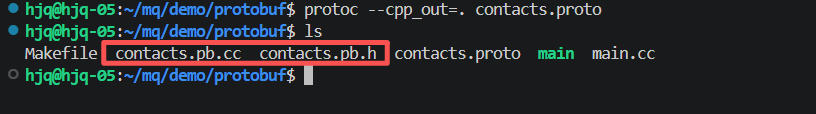
contacts.pb.h // 类的声明
contacts.pb.cc // 类的实现
生成代码的整体规律:
- 每个 message → 生成一个对应的消息类;
- 类里为每个字段提供 getter / setter,以及一系列操作字段的方法;
- 每个 .proto 文件 → 一对 .h / .cc(声明与实现分离)。
Step 8:读懂生成的代码
contacts.pb.h 片段:
class PeopleInfo final : public ::PROTOBUF_NAMESPACE_ID::Message {
public:
using ::PROTOBUF_NAMESPACE_ID::Message::CopyFrom;
void CopyFrom(const PeopleInfo& from);
using ::PROTOBUF_NAMESPACE_ID::Message::MergeFrom;
void MergeFrom(const PeopleInfo& from) {
PeopleInfo::MergeImpl(*this, from);
}
static ::PROTOBUF_NAMESPACE_ID::StringPiece FullMessageName() {
return "PeopleInfo";
}
// string name = 1;
void clear_name();
const std::string& name() const;
template <typename ArgT0 = const std::string&, typename… ArgT>
void set_name(ArgT0&& arg0, ArgT… args);
std::string* mutable_name();
PROTOBUF_NODISCARD std::string* release_name();
void set_allocated_name(std::string* name);
// int32 age = 2;
void clear_age();
int32_t age() const;
void set_age(int32_t value);
};
命名规律一目了然:
- getter 名称与字段名完全相同(小写),如 name()、age();
- setter 以 set_ 开头,如 set_name()、set_age();
- 每个字段都有 clear_ 方法,把字段重置回 empty 状态;
- 字符串字段额外有 mutable_ / release_ / set_allocated_,用于避免拷贝或转移所有权—— mutable_name() 返回可直接修改的内部指针级对象,这是高频修改字符串时唯一不产生拷贝的入口。
contacts.pb.cc 中是这些方法的具体实现,通常不需要看。
序列化 / 反序列化 API 在哪
不在消息类自己身上,而在其父类 MessageLite 中:
class MessageLite {
public:
// 序列化:
bool SerializeToOstream(ostream* output) const; // 写入文件流
bool SerializeToArray(void* data, int size) const;
bool SerializeToString(string* output) const;
// 反序列化:
bool ParseFromIstream(istream* input); // 从流读取再反序列化
bool ParseFromArray(const void* data, int size);
bool ParseFromString(const string& data);
};
四个要点:
Step 9:序列化与反序列化的实际使用
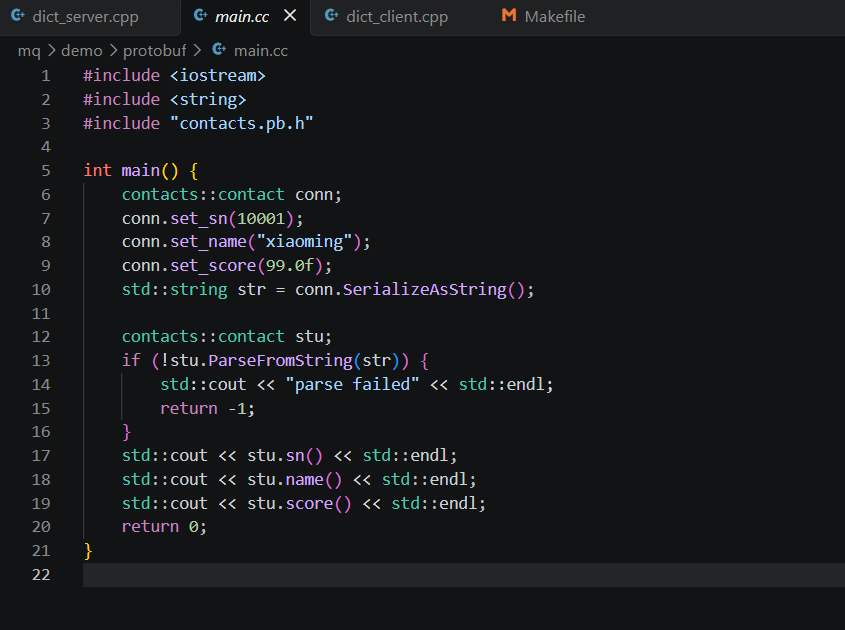
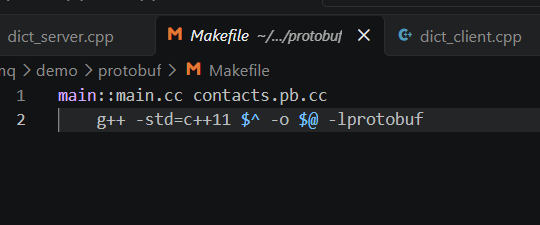
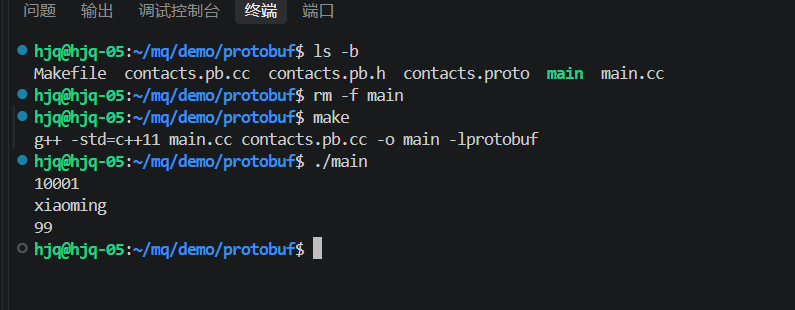
运行结果:
第二部分:Muduo
2.1 Muduo 是什么,解决什么问题
Muduo 是陈硕开发的、基于非阻塞 IO 与事件驱动的 C++ 高并发 TCP 网络编程库。
它解决的是手写网络服务的经典痛点:裸用 epoll 时,你得自己管理 fd 生命周期、处理 EAGAIN/短读短写、维护每连接的缓冲区、处理跨线程唤醒……任何一个细节写错都是线上事故。Muduo 把这一整套封装成注册回调 + 事件循环的编程模型。
2.1.1 主从 Reactor 模型
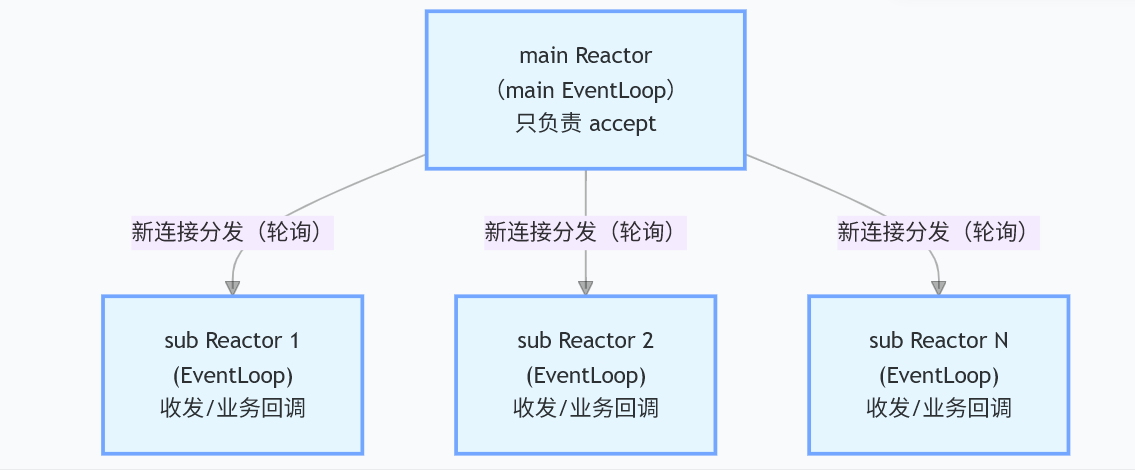
- main Reactor:只有一个,专职 accept 新连接,然后把连接分发给某个 sub Reactor;
- sub Reactor:N 个,各自跑在自己的线程里,负责已建立连接的读写事件与业务回调。
2.1.2 one loop per thread
线程模型的核心约定:
- 一个线程只能有一个事件循环(EventLoop),用于响应计时器和 IO 事件;
- 一个文件描述符只能由一个线程进行读写——换句话说,一个 TCP 连接必须归属于某个 EventLoop 管理。
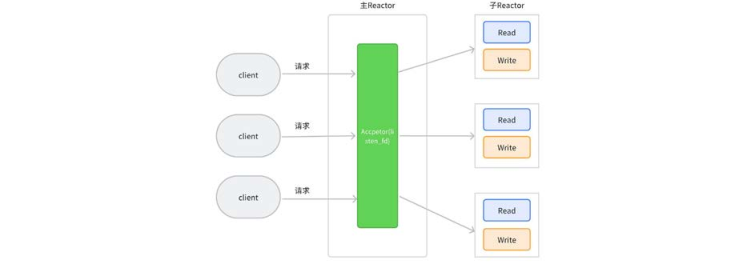
这条约定的工程价值:因为连接只属于一个 loop,业务回调天然是单线程串行执行的。 你在 onMessage 里操作连接自己的状态时不需要加锁; 需要跨线程操作时,Muduo 提供 runInLoop / queueInLoop 把任务丢回目标 loop 执行(这也是定时器能"线程安全地"从其他线程调用的原理)。 并发难点从"到处锁"变成了"想清楚哪些变量属于哪个 loop",这是 Muduo 最舒服的地方。
2.2 五个必须掌握的核心类
| InetAddress | 封装 IP + 端口 | 描述"哪个地址" |
| EventLoop | 事件循环,epoll 的封装 | 驱动一切的"心脏" |
| TcpServer | TCP 服务器 | 服务端入口,负责 accept + 分发 |
| TcpClient | TCP 客户端 | 客户端入口,负责 connect |
| TcpConnection | 一条 TCP 连接 | 收发数据都通过它 |
| Buffer | 每连接的读写缓冲区 | 解决"数据没到齐/发不完" |
| CountDownLatch | 倒计时门闩 | 把异步连接同步化 |
2.2.1 TcpServer
typedef std::shared_ptr<TcpConnection> TcpConnectionPtr;
typedef std::function<void (const TcpConnectionPtr&)> ConnectionCallback;
typedef std::function<void (const TcpConnectionPtr&, Buffer*, Timestamp)> MessageCallback;
class InetAddress : public muduo::copyable {
public:
InetAddress(StringArg ip, uint16_t port, bool ipv6 = false);
};
class TcpServer : noncopyable {
public:
enum Option {
kNoReusePort,
kReusePort,
};
TcpServer(EventLoop* loop,
const InetAddress& listenAddr,
const string& nameArg,
Option option = kNoReusePort);
void setThreadNum(int numThreads); // 设置 sub Reactor 线程数
void start(); // 启动:创建监听 socket 并注册进 loop
/// 当一个新连接建立成功的时候被调用
void setConnectionCallback(const ConnectionCallback& cb)
{ connectionCallback_ = cb; }
/// 消息的业务处理回调函数——收到新连接消息的时候被调用
void setMessageCallback(const MessageCallback& cb)
{ messageCallback_ = cb; }
};
要点:
- 三个入参:用哪个 loop、监听地址、服务器名(日志标识);
- setThreadNum(n):设置 sub Reactor 数量(n = 0 就是单线程模式,所有 IO 都在 main loop 里);
- setConnectionCallback 参数只有 1 个(连接对象),setMessageCallback 参数有 3 个(连接对象、Buffer、时间戳)——这是新手最常见的编译错误来源;
- kReusePort:设置 SO_REUSEPORT,服务器重启不必等 TIME_WAIT 超时,调试期建议开。
2.2.2 EventLoop
class EventLoop : noncopyable {
public:
/// Loops forever.
/// Must be called in the same thread as creation of the object.
void loop();
/// Quits loop.
/// This is not 100% thread safe, if you call through a raw pointer,
/// better to call through shared_ptr<EventLoop> for 100% safety.
void quit();
TimerId runAt(Timestamp time, TimerCallback cb);
/// Runs callback after @c delay seconds. Safe to call from other threads.
TimerId runAfter(double delay, TimerCallback cb);
/// Runs callback every @c interval seconds. Safe to call from other threads.
TimerId runEvery(double interval, TimerCallback cb);
/// Cancels the timer. Safe to call from other threads.
void cancel(TimerId timerId);
private:
std::atomic<bool> quit_;
std::unique_ptr<Poller> poller_; // 对 epoll 的封装
mutable MutexLock mutex_;
std::vector<Functor> pendingFunctors_ GUARDED_BY(mutex_);
};
要点:
- loop() 是死循环阻塞接口,必须与创建该对象的线程相同(线程归属约定);quit() 用来退出;
- 定时器三件套:runAt(绝对时间)、runAfter(延迟一次)、runEvery(周期);
- 注意线程安全注释:定时器接口是"可从其他线程安全调用"的,实现方式就是把回调 queueInLoop 到目标 loop;
- pendingFunctors_ + mutex_ 就是跨线程任务的落地机制,也是 eventfd 唤醒 epoll_wait 的触发点;
- GUARDED_BY(mutex_) 是 clang 线程安全注解,告诉静态分析"这个成员必须在持锁下访问"。
2.2.3 TcpConnection
class TcpConnection : noncopyable,
public std::enable_shared_from_this<TcpConnection> {
public:
/// Constructs a TcpConnection with a connected sockfd
/// User should not create this object.
TcpConnection(EventLoop* loop,
const string& name,
int sockfd,
const InetAddress& localAddr,
const InetAddress& peerAddr);
bool connected() const { return state_ == kConnected; }
bool disconnected() const { return state_ == kDisconnected; }
void send(string&& message); // C++11
void send(const void* message, int len);
void send(const StringPiece& message);
// void send(Buffer&& message); // C++11
void send(Buffer* message); // this one will swap data
void shutdown(); // NOT thread safe, no simultaneous calling
void setContext(const boost::any& context) { context_ = context; }
const boost::any& getContext() const { return context_; }
boost::any* getMutableContext() { return &context_; }
void setConnectionCallback(const ConnectionCallback& cb)
{ connectionCallback_ = cb; }
void setMessageCallback(const MessageCallback& cb)
{ messageCallback_ = cb; }
private:
enum StateE { kDisconnected, kConnecting, kConnected, kDisconnecting };
EventLoop* loop_;
ConnectionCallback connectionCallback_;
MessageCallback messageCallback_;
WriteCompleteCallback writeCompleteCallback_;
boost::any context_;
};
要点:
- 不要自己 new TcpConnection——它由 TcpServer / TcpClient 内部创建,用 shared_ptr 管理生命周期;
- 继承 enable_shared_from_this:回调里需要续命时用 shared_from_this() 拿到 shared_ptr,避免对象在使用中被析构;
- send() 是线程安全的(内部会 runInLoop 到所属 loop 执行),可从任意线程调用;
- shutdown() 不是线程安全的,且不能同时调用——这是注释里明确写的限制;
- context_ 是 boost::any 类型的"每连接用户数据槽",做连接级会话状态(用户 ID、登录态、解析中间态)的标准位置;
- 四个连接状态 kDisconnected / kConnecting / kConnected / kDisconnecting,业务里用 connected() / disconnected() 判断即可。
2.2.4 TcpClient
class TcpClient : noncopyable {
public:
TcpClient(EventLoop* loop,
const InetAddress& serverAddr,
const string& nameArg);
~TcpClient(); // force out-line dtor, for std::unique_ptr members.
void connect(); // 连接服务器
void disconnect(); // 关闭连接
void stop();
// 获取客户端对应的通信连接 Connection 对象
// 注意:发起 connect 后,有可能还没有连接建立成功
TcpConnectionPtr connection() const {
MutexLockGuard lock(mutex_);
return connection_;
}
/// 连接服务器成功时的回调函数
void setConnectionCallback(ConnectionCallback cb)
{ connectionCallback_ = std::move(cb); }
/// 收到服务器发送的消息时的回调函数
void setMessageCallback(MessageCallback cb)
{ messageCallback_ = std::move(cb); }
private:
EventLoop* loop_;
ConnectionCallback connectionCallback_;
MessageCallback messageCallback_;
WriteCompleteCallback writeCompleteCallback_;
TcpConnectionPtr connection_ GUARDED_BY(mutex_);
};
注意:Muduo 不管服务端还是客户端,连接动作都是异步的。
/*
因为 muduo 库不管是服务端还是客户端都是异步操作,
对于客户端来说,如果我们在连接还没有完全建立成功的时候发送数据,
这是不被允许的。
因此我们可以使用内置的 CountDownLatch 类进行同步控制。
*/
connect() 只是发起连接就返回了,connection() 可能还是空的。要"连上再发",就得用 CountDownLatch 把异步变同步:
class CountDownLatch : noncopyable {
public:
explicit CountDownLatch(int count);
void wait() {
MutexLockGuard lock(mutex_);
while (count_ > 0) {
condition_.wait(); // 等待方:阻塞直到计数归零
}
}
void countDown() {
MutexLockGuard lock(mutex_);
–count_;
if (count_ == 0) {
condition_.notifyAll(); // 通知方:归零时唤醒所有等待者
}
}
int getCount() const;
private:
mutable MutexLock mutex_;
Condition condition_ GUARDED_BY(mutex_);
int count_ GUARDED_BY(mutex_);
};
用法就是经典的"主线程 wait,IO 线程在 onConnection 里 countDown": CountDownLatch latch(1); → latch.wait(); 卡住 → 连上后回调里 latch.countDown(); → 主线程被唤醒,此刻连接一定可用了。
注意条件的检查方式是 while (count_ > 0) 而非 if——这是防虚假唤醒的标准写法,自己写条件变量时照抄。
2.2.5 Buffer
class Buffer : public muduo::copyable {
public:
static const size_t kCheapPrepend = 8;
static const size_t kInitialSize = 1024;
explicit Buffer(size_t initialSize = kInitialSize)
: buffer_(kCheapPrepend + initialSize),
readerIndex_(kCheapPrepend),
writerIndex_(kCheapPrepend) {}
void swap(Buffer& rhs);
size_t readableBytes() const; // 可读字节数
size_t writableBytes() const; // 可写字节数
const char* peek() const; // 可读数据的起始位置
const char* findEOL() const; // 找 \\n(解析文本协议常用)
const char* findEOL(const char* start) const;
void retrieve(size_t len); // 消费 len 字节
void retrieveInt64();
void retrieveInt32();
void retrieveInt16();
void retrieveInt8();
string retrieveAllAsString(); // 取走全部可读数据
string retrieveAsString(size_t len);
void append(const StringPiece& str);
void append(const char* /*restrict*/ data, size_t len);
void append(const void* /*restrict*/ data, size_t len);
char* beginWrite();
const char* beginWrite() const;
void hasWritten(size_t len); // 读完之后告知"我写了 len 字节"
void appendInt64(int64_t x); // 网络字节序写入
void appendInt32(int32_t x);
void appendInt16(int16_t x);
void appendInt8(int8_t x);
int64_t readInt64(); // 网络字节序读出
int32_t readInt32();
int16_t readInt16();
int8_t readInt8();
int64_t peekInt64() const; // 只看不消费
int32_t peekInt32() const;
int16_t peekInt16() const;
int8_t peekInt8() const;
void prependInt64(int64_t x); // 前插:常用于"把长度头补回前面"
void prependInt32(int32_t x);
void prependInt16(int16_t x);
void prependInt8(int8_t x);
void prepend(const void* /*restrict*/ data, size_t len);
private:
std::vector<char> buffer_; // 底层存储
size_t readerIndex_; // 读位置
size_t writerIndex_; // 写位置
static const char kCRLF[];
};
设计要点:
- readerIndex_ / writerIndex_ 双指针:把 vector 分成已读废弃区 | 可读数据区 | 可写空闲区三段,避免每次读都 erase 搬内存;
- kCheapPrepend = 8:前面预留 8 字节廉价空间,用于 prepend 补协议头(如长度字段)而不用整体搬移;
- kInitialSize = 1024:初始 1KB,按需扩容(这点很关键:TCP 是字节流,一次 read 不保证拿到一条完整消息,Buffer 就是用来攒够一条消息的);
- appendInt32 / readInt32 系列自动做网络字节序转换,自定义二进制协议时直接用它写长度前缀,比手写 htons 安全;
- retrieve = 消费数据(移动 readerIndex_),peek = 看一眼不消费;注意区分,这是解析消息时最容易写错的地方。
2.3 快速上手:英译汉 TCP 服务端 / 客户端
用 Muduo 实现一个最简单的英译汉服务: 客户端发一个词 → 服务端查字典 → 把译文发回客户端。
2.3.1 服务端 server.cpp
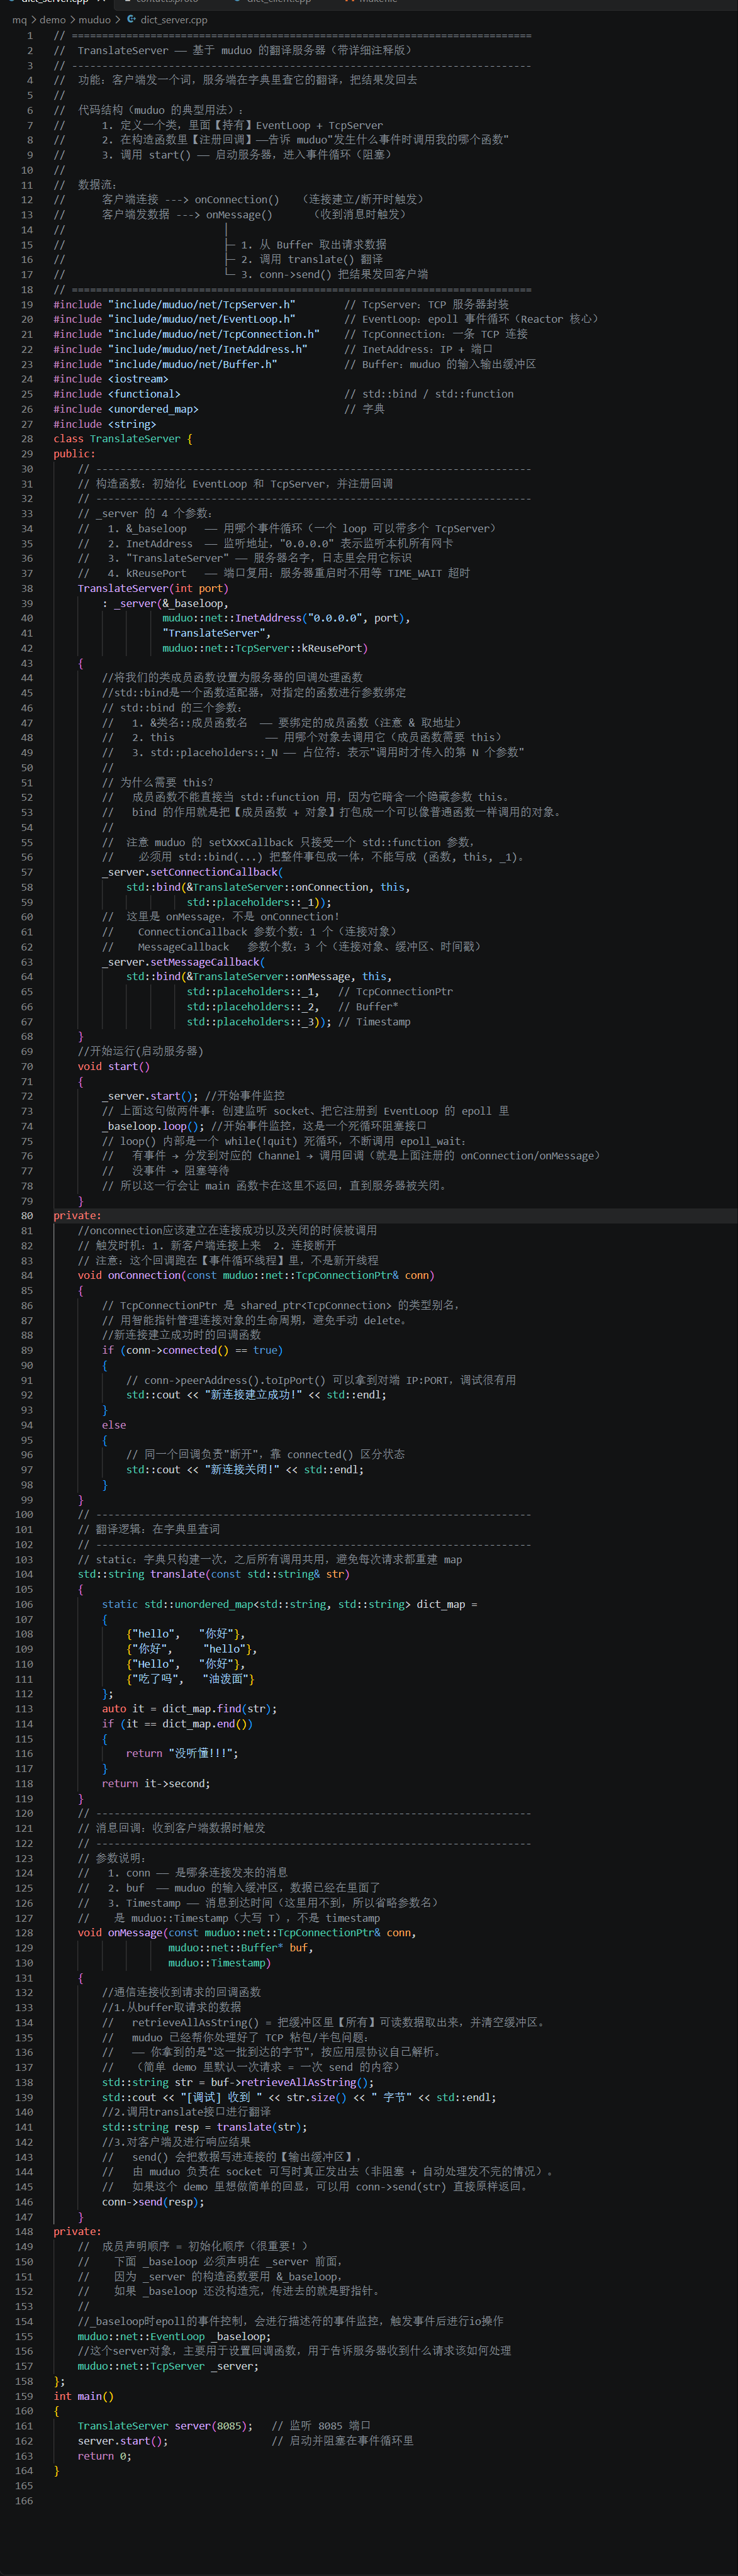
几个容易被忽略的细节:
2.3.2 客户端 client.cpp
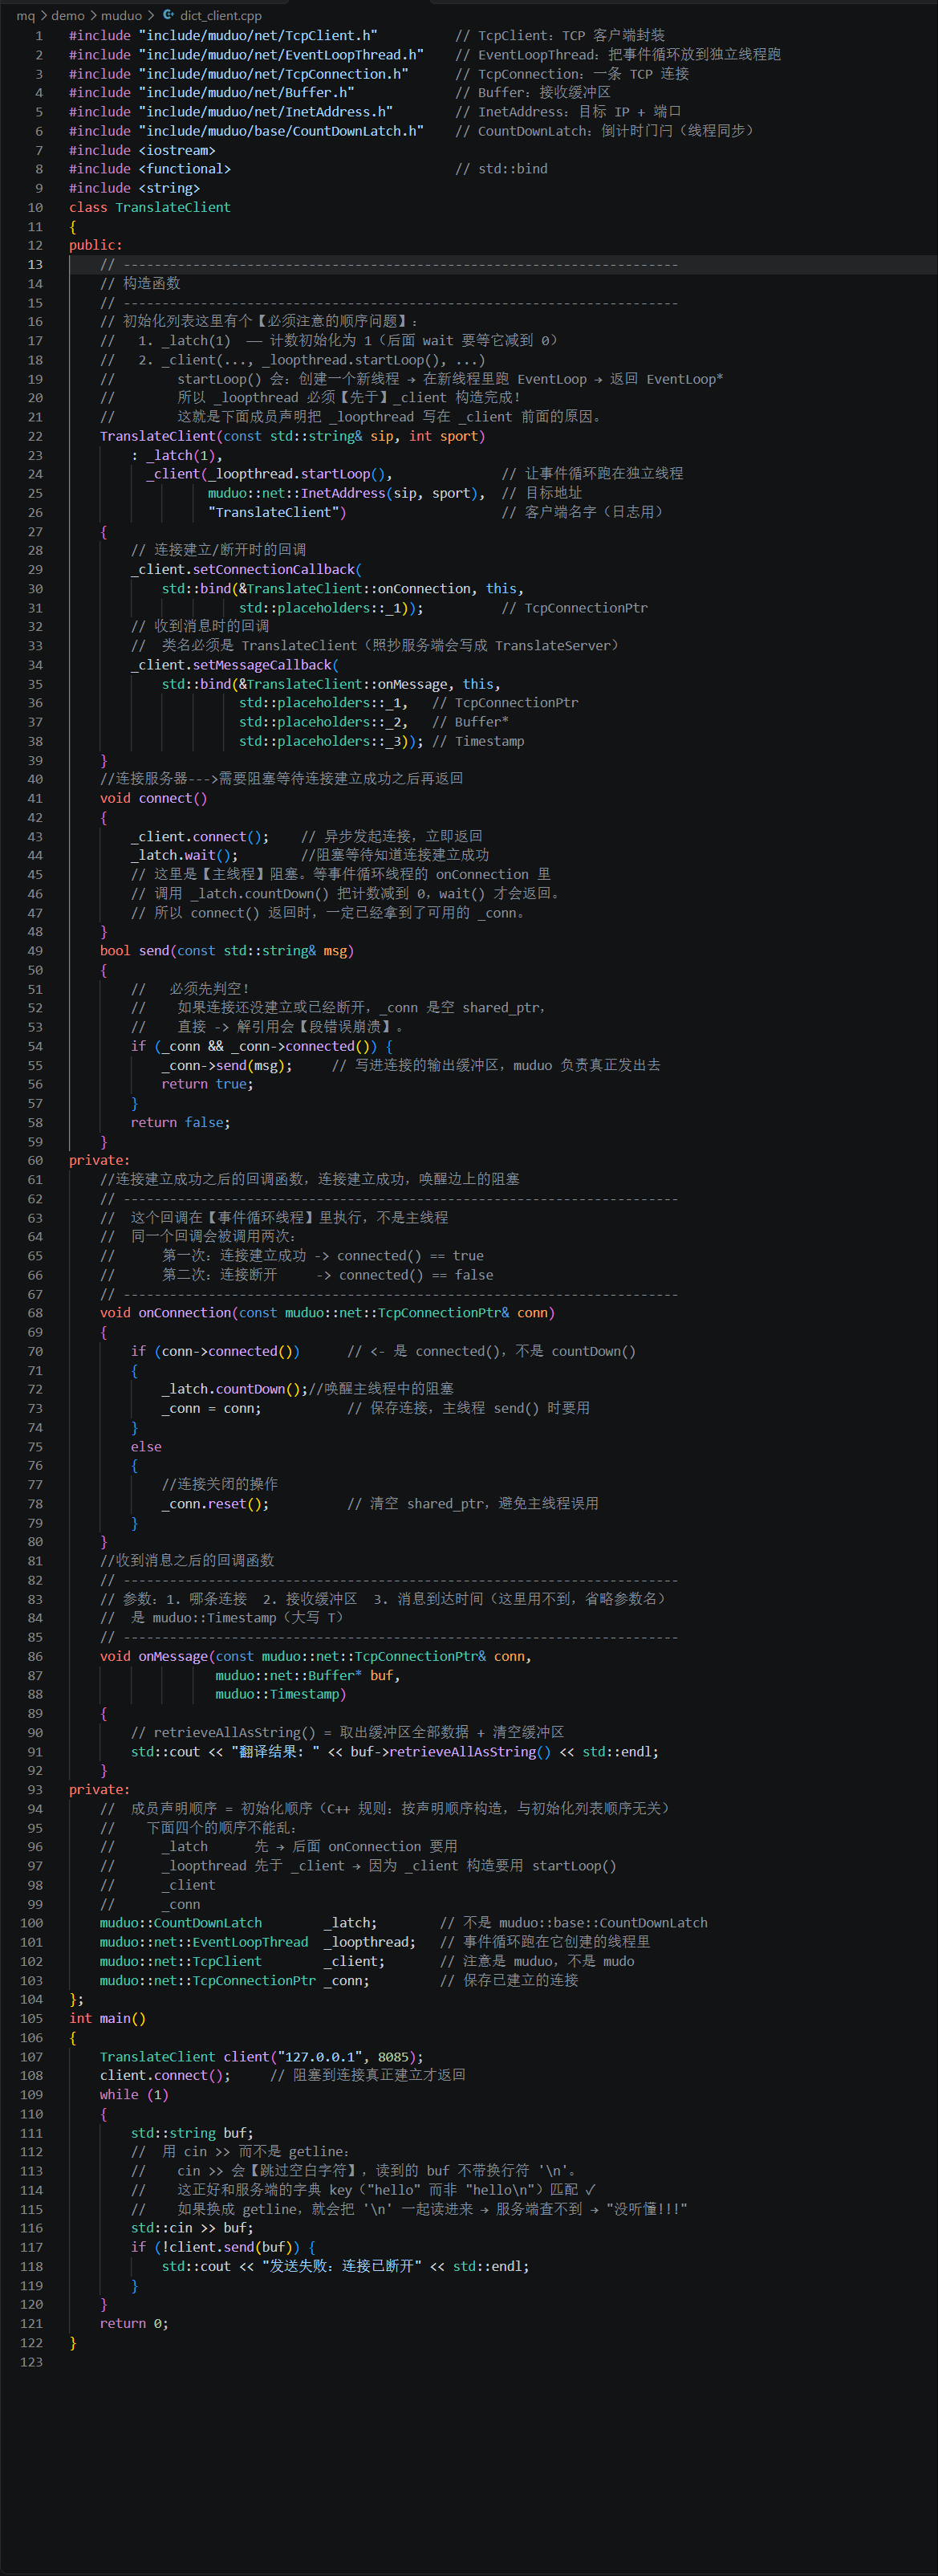
客户端设计的三个关键点:
2.3.3 编译:Makefile
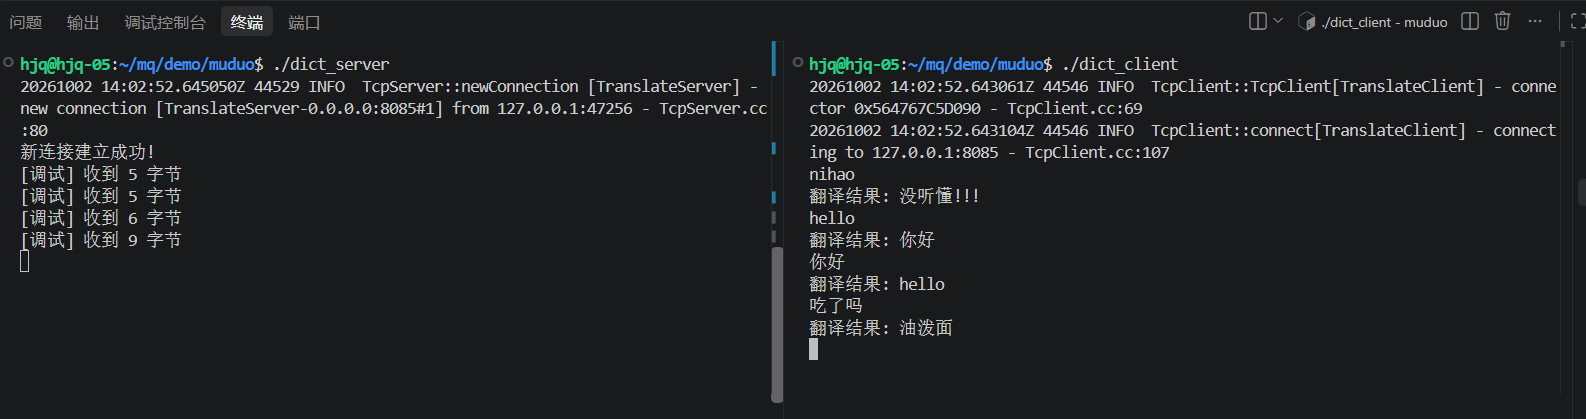
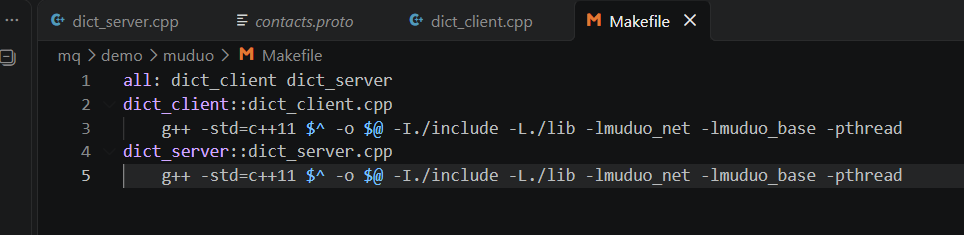 运行效果: