【老计带你懂AI算法】20:Transformer与注意力机制,撑起整个大模型时代的基石
开头:一篇论文,开启一个时代
如果要在这个系列里挑一个最重要的模型,那一定是Transformer。
ChatGPT、文心一言、Claude、你能叫得出名字的所有大语言模型,还有大量图像、语音、多模态模型,它们的心脏都是Transformer。可以说,没有Transformer,就没有今天这场轰轰烈烈的大模型革命。 它出自2017年谷歌一篇名字很霸气的论文《Attention Is All You Need》(注意力就是你所需要的一切),这篇论文开启了一个时代。
这一篇是整个系列的一个高潮。我会把Transformer最核心的东西,注意力机制,用大白话讲透。理解了它,你就理解了大模型的地基。
先回顾痛点:RNN到底差在哪
要理解Transformer为什么伟大,得先记着第15篇讲的RNN的两个致命痛点:
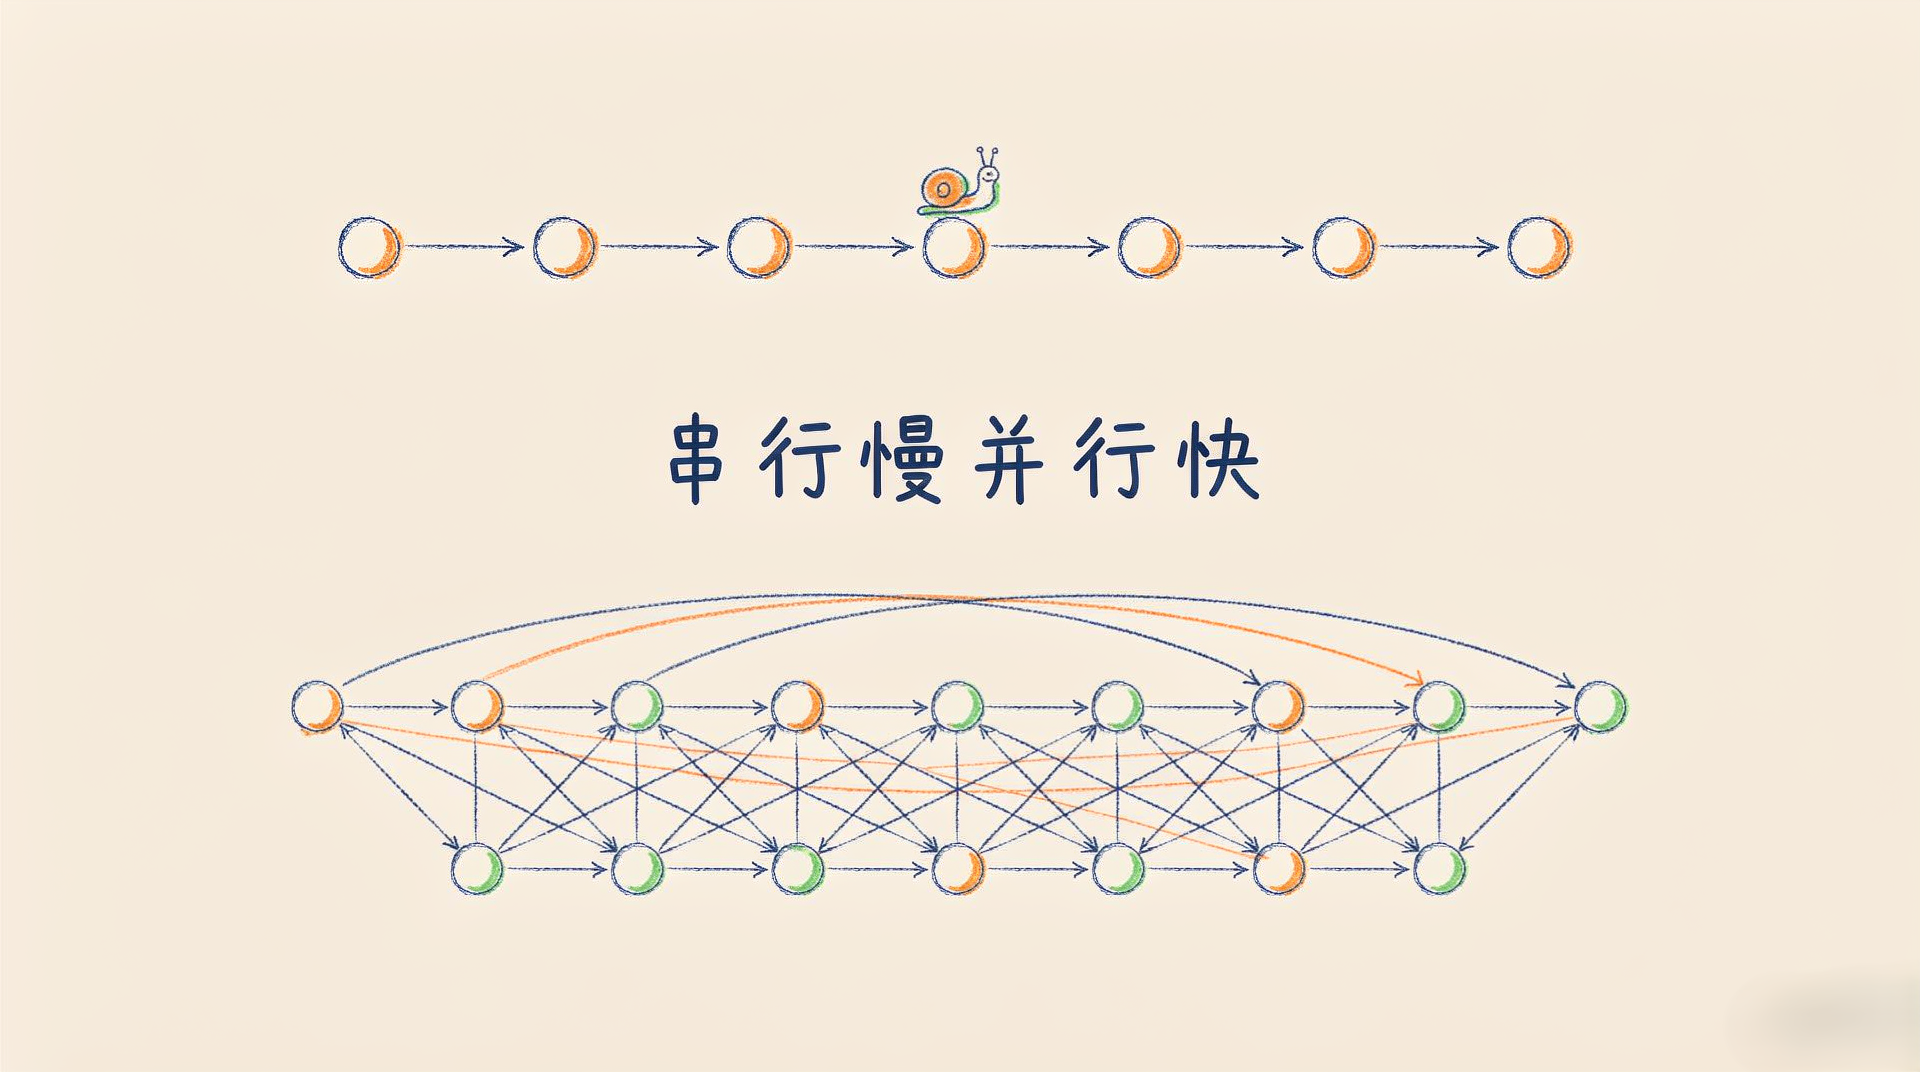
- 不能并行,训练太慢。 RNN处理序列必须一个词一个词按顺序来(因为后面依赖前面的记忆),没法同时处理,在大数据时代这个速度是硬伤。
- 长距离依赖记不住。 序列一长,前面的信息传到后面就被稀释忘掉了,尽管LSTM有所缓解,但依然吃力。
Transformer的横空出世,就是用注意力机制,一举干掉了这两个痛点,既能并行、又能轻松抓住任意长距离的关系。 这就是它碾压RNN的根本原因。
核心中的核心:注意力机制在干嘛
注意力机制,第15篇末尾已经埋了引子(当时是为了帮RNN翻译时能回看原文)。Transformer把它拎出来当绝对主角。
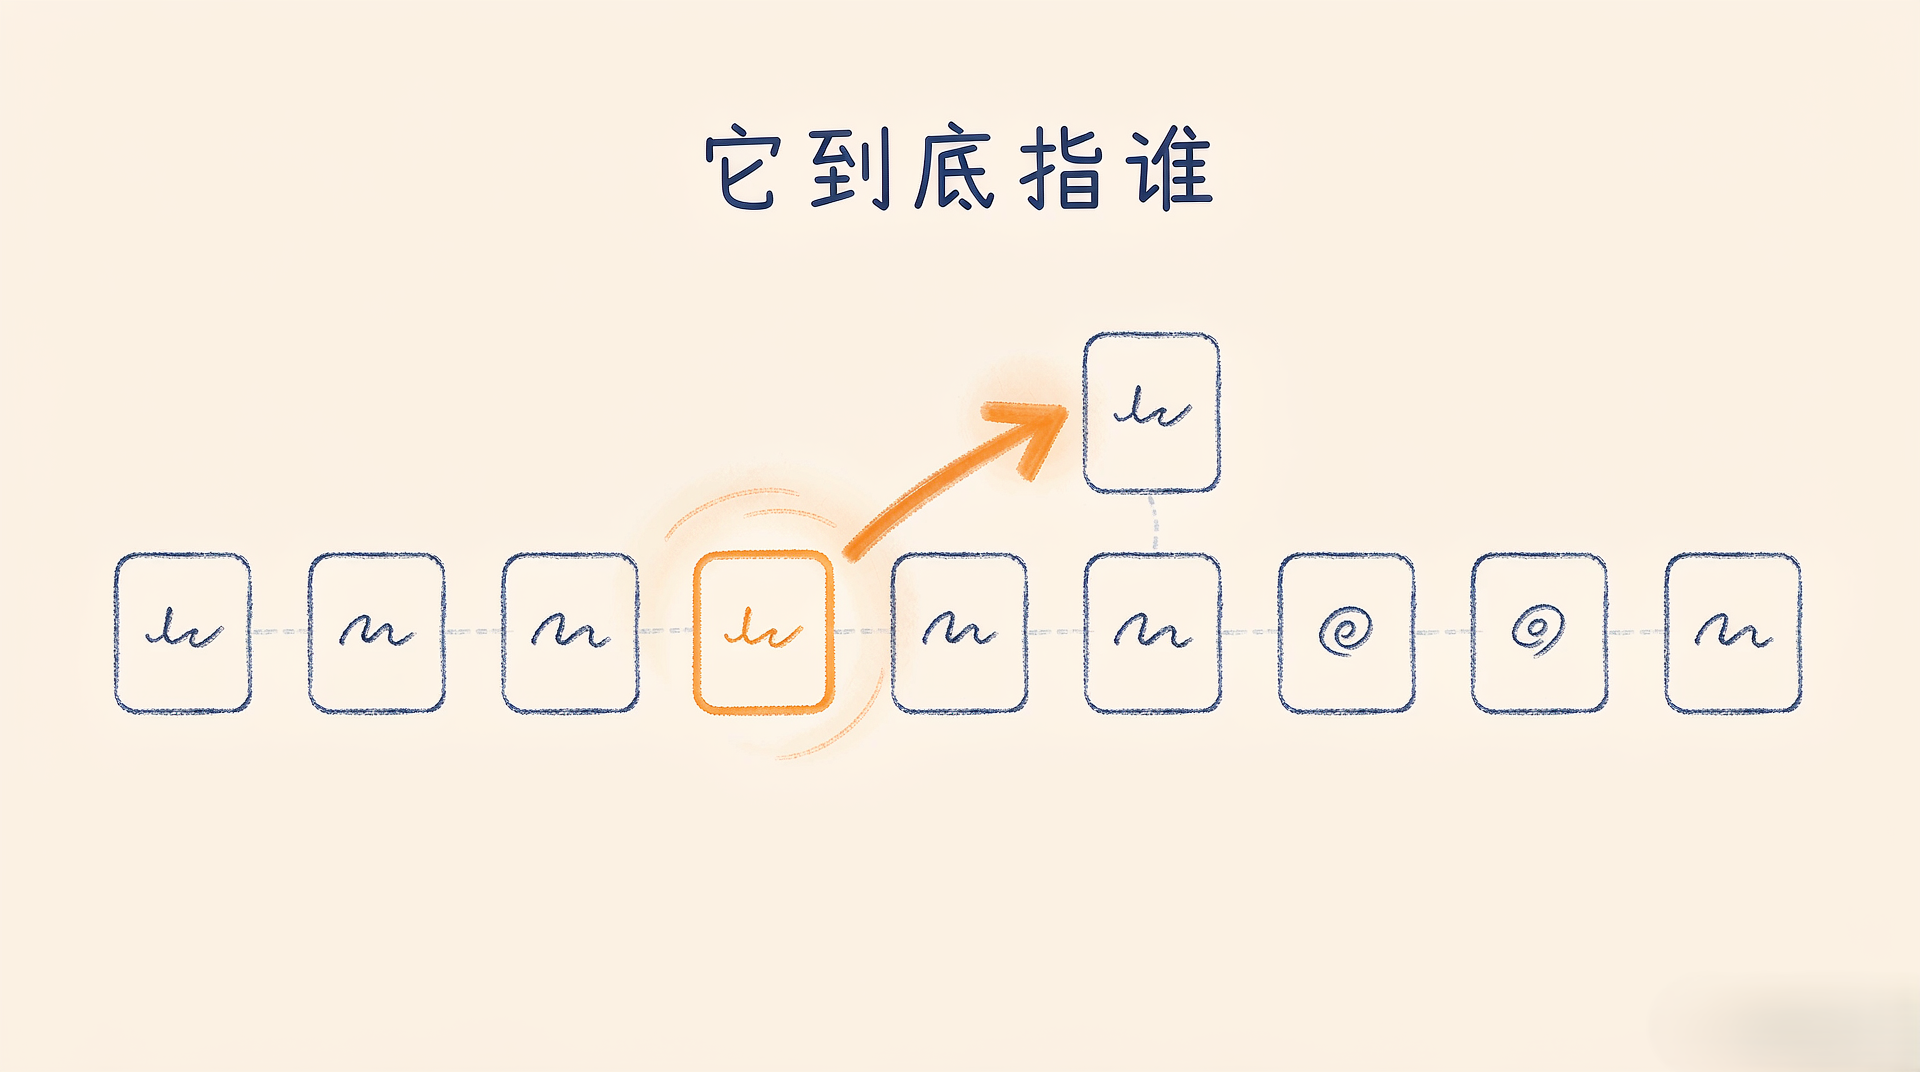
用一句大白话讲注意力:处理一句话里的每个词时,让这个词去"关注"句子里所有其他的词,并根据相关程度分配不同的注意力权重,把相关词的信息重点吸收进来。
举个经典例子。这句话:"那只动物没过马路,因为它太累了。“这里的"它"指代谁?是动物还是马路?我们一看就知道指"动物”。机器怎么知道?注意力机制就是让"它"这个词,去扫描句子里所有的词,计算和每个词的相关度,结果发现和"动物"相关度最高,于是"它"就重点关注"动物"、把动物的信息吸收过来,从而正确理解了"它"指代动物。
打个比方:你读一个句子理解某个词时,眼睛和注意力其实会不自觉地在相关的词之间来回瞟,把有关联的部分联系起来理解。注意力机制就是把人类这种"理解一个词要联系上下文相关词"的能力,用数学精确地实现了。
这种让句子里的词互相关注、互相理解的注意力,叫自注意力,是Transformer的灵魂。
自注意力的三个角色:查询、键、值
再把自注意力讲深一点点(不涉及公式),你会更明白它怎么运作。每个词会生成三个东西,用图书馆借书打比方最好懂:
- 查询:你想找什么(就像你带着一个问题去图书馆)。
- 键:每本书的标签、目录(用来和你的问题匹配,看相不相关)。
- 值:书里真正的内容。
运作时,一个词拿自己的"查询",去和句子里所有词的"键"逐一匹配,算出和每个词的相关度(匹配度);相关度高的,就多取一些那个词的"值"(内容);相关度低的,就少取一点。最后把这些按相关度加权取来的内容汇总起来,就是这个词吸收了全局上下文之后的新理解。
关键在于,句子里每一个词都同时干这件事,而且它们互不依赖、可以一起算,这就是Transformer能并行的原因,也是它比RNN快的根本。 同时,无论两个词隔多远,只要相关,注意力就能一步把它们直接联系起来,不像RNN要一步步传递、传远了就忘,这就解决了长距离依赖。一个注意力机制,两个痛点同时解决,这就是它的精妙。
我想在这里停一下,讲讲为什么我觉得注意力这个思想如此了不起,它其实揭示了理解的本质。所谓理解一个东西,很大程度上就是理解它和其他东西的关系。 一个词的含义,不在它孤立的字形里,而在它和上下文的关联里,同一个"苹果",在"我吃了个苹果"和"苹果发布了新手机"里意思完全不同,靠的正是它和周围词的关系来确定。注意力机制的伟大,就在于它用一种简洁又可并行的方式,让模型学会了动态地捕捉万物之间的关联,谁和谁相关、相关多少,全由数据自己算出来,不用人预先规定。这种"通过关联来理解"的思想,不仅统治了今天的AI,某种程度上也和我们人类认知世界的方式暗合,我们不也是在一张巨大的关系网里,靠事物间的联系来理解这个世界的吗。 想通这一层,你对Transformer的敬意会更深一分,它不只是个工程技巧,更触及了智能的某种本质。
Transformer的完整样子
Transformer就是把自注意力作为核心,再搭配一些其他部件堆叠而成。你不用记全,知道几个关键点:
- 多头注意力:不止用一套注意力,而是同时用好几套(多个头),每套关注不同方面的关系(有的关注语法、有的关注语义),再综合起来,理解更全面。
- 位置编码:注意力本身不管词的顺序(并行处理嘛),可语言里顺序很重要。于是额外给每个词加一个"位置信息",告诉模型这个词排在第几位,补上顺序这一课。
- 堆叠很多层:像前面所有深度网络一样,把这样的结构堆很多层,逐层提取越来越抽象的语义。
- 编码器和解码器:原始Transformer有这两部分,编码器负责理解输入,解码器负责生成输出。后来的大模型很多只用其中一部分,比如GPT系列主要用解码器结构来做生成。
输入和输出长什么样
- 输入:一段文本,先被切成一个个词元(token),每个词元转成向量(又是那条"万物变向量"的主线),再加上位置编码。
- 输出:看任务。做生成(如GPT)时,它逐个预测下一个最可能的词,一个接一个吐出来,形成完整回答。做理解(如BERT)时,输出每个词或整句的语义表示,供下游任务用。
上代码:调用一个Transformer模型
自己实现Transformer较复杂,实际我们用Hugging Face直接调用。输入:一段文本。输出:模型的处理结果。这里演示用预训练模型做情感分析和文本生成。
# 依赖:pip install transformers torch
from transformers import pipeline
# 例1:情感分析,底层是基于Transformer的模型(如BERT)
classifier = pipeline("sentiment-analysis")
result = classifier("这个产品真的太好用了,强烈推荐!")
print("情感分析:", result)
# 例2:文本生成,底层是Transformer的解码器(GPT类)
generator = pipeline("text-generation", model="gpt2")
out = generator("Artificial intelligence is", max_length=30, num_return_sequences=1)
print("文本续写:", out[0]["generated_text"])
运行输出(示例,文本生成部分每次结果不同):
情感分析: [{'label': 'POSITIVE', 'score': 0.9987}]
文本续写: Artificial intelligence is transforming the way we live and work, from…
这段代码展示了用Transformer模型的常见方式,通过Hugging Face的pipeline,一行就能调用训练好的Transformer模型做情感分析、文本生成等任务,底层都是Transformer架构在工作。 你不用关心内部细节,就能用上这个强大的架构。需要说明,首次运行会下载模型,且模型语言能力取决于所选模型,作者未在本地实机运行,读者按环境和库版本可能要微调。
关键概念
- 注意力(Attention):让每个词关注并吸收相关词的信息,是Transformer的核心。
- 自注意力(Self-Attention):句子内部词与词互相关注。
- 多头:多套注意力并行,从不同角度理解。
- 位置编码:给并行处理的词补上顺序信息。
- token(词元):文本被切成的基本单位,大模型按token处理和计费。
为什么它这么重要
再强调一下Transformer的历史地位,帮你建立全局认知:
- 它是所有大模型的统一地基。 GPT、BERT、文心、Claude、LLaMA,架构核心都是它。学会它,你就有了理解一切大模型的钥匙。
- 它极其适合规模化。 因为能大规模并行训练,Transformer可以被造得非常非常大(几百上千亿参数),喂海量数据,而且神奇的是,越大越强(这就是所谓的规模定律)。这种可规模化,是大模型能力爆发的前提。
- 它不止用于文本。 图像(ViT)、语音、多模态、甚至前面说的时序、扩散模型里,都能看到Transformer的身影,它成了一个近乎通用的架构。
优缺点与适用场景
优点:能并行训练快、能抓任意长距离依赖、效果强、极其适合规模化、通用性强。缺点:计算量大尤其吃显存(注意力要算每个词和所有词的关系,长文本时开销随长度快速增长)、需要海量数据和算力、小数据上未必比简单模型强。
适合场景:几乎所有大规模的语言、图像、语音、多模态任务,是当今AI的绝对主流。不适合:数据量很小、算力受限、或者简单表格任务(那还是树模型划算),别为了赶时髦硬上。
小结与承上启下
- Transformer:2017年横空出世,用注意力机制干掉RNN不能并行和记不住长距离两大痛点,开启大模型时代。
- 注意力核心:处理每个词时让它关注句子里所有相关词、按相关度吸收信息(查询键值三角色)。
- 能并行 + 抓长依赖:每个词独立并行地做注意力,无论多远只要相关就能一步联系。
- 地位:所有大模型的统一地基,极适合规模化,还是通用架构。
我们已经知道了大模型的心脏是Transformer。可从这个架构,到你用的ChatGPT那样一个博学、能聊、会干活的大模型,中间还隔着一整套"炼制"工艺,预训练、微调、对齐、还有让模型更大更省的MoE。下一篇,也是原理部分的收官,我们讲清楚一个大模型到底是怎么被炼成的。
我们下一篇见。
延伸阅读
想深入了解Transformer,下面几个是权威且经典的一手资料:
- Transformer原始论文《Attention Is All You Need》(Vaswani等,2017):https://arxiv.org/abs/1706.03762
- 图解Transformer(The Illustrated Transformer,Jay Alammar,图文并茂讲注意力,很适合入门):https://jalammar.github.io/illustrated-transformer/
- Hugging Face Transformers官方文档(本篇代码用的库,含大量模型和教程):https://huggingface.co/docs/transformers
- PyTorch官方文档:https://pytorch.org/docs
(说明:以上为官方与经典公开资料的地址,可能随站点调整,如打不开可用标题搜索。)