一、进程
1.1 进程的概念
基本定义: 进程是程序的一次执行过程
1.程序是静态的代码文件(放在磁盘上)
2.进程是动态的执行实体(跑在内存中)
场景描述:
假设你使用 C++ 编写了 HelloWorld.cpp,编译成可执行文件保存在硬盘上时,它只是一个静态的可执行文件——这就是程序(Program)。
当你双击运行它,或者在命令行输入命令执行它时:
1. 操作系统会把这个程序从硬盘加载到内存中。
2. 操作系统会为它分配独立的内存空间
3. CPU处理器开始逐条执行这个程序里的指令
这个拥有独立内存空间、正在被 CPU 执行的“动态实体”,就变成了一个进程(Process)。
本质理解:进程 = " 内核数据结构对象(即进程控制块 PCB) + 程序自身的代码与数据 "
1.2 管理进程
1.2.1 描述进程 – PCB
在 Linux 中,PCB 的实现是 task_struct 结构体(定义在 <linux/sched.h>),它是内核中描述一个进程所有信息的结构体:
struct task_struct
{
volatile long state; // 进程状态
pid_t pid; // 进程 ID
pid_t tgid; // 线程组 ID
struct task_struct *parent; // 父进程
struct fs_struct *fs; // 文件系统相关信息
struct mm_struct *mm; // 内存管理
struct files_struct *files; // 打开的文件
// … 几百个字段
};
1.2.2 组织进程 -链表
Linux 链表结点的设计:结点不包含数据,统一将数据定义到task_struct中。
struct list_head
{
struct list_head *next, *prev;
};
Linux中的task_struct :嵌入结构体list_head
// 调度器中的实际用法 (简化版 task_struct)
struct task_struct
{
pid_t pid; // 进程ID
int prio; // 优先级
// … 几百个其他字段 …
// 【关键】把 list_head 作为结构体的一个成员嵌入进去
struct list_head run_list;
};
Linux设计该结构体的优势:
1. 如果内核用教科书的方式,就必须为每种数据定义一种链表(运行队列链表,阻塞队列链表…),这会导致代码极度冗余,而是统一的将描述进程的数据放入task_struct中,在task_struct内部定义结构体成员。
2. 内核把 list_head 当作一个“通用连接件”,直接嵌入到需要被链接的结构体内部,实现了链接与数据访问的分离。
run_list 就是车厢上的“连接钩”,而task_struct 才是真正的“车厢”,车厢里装有真正的数据。
在Linux中 如何访问链接的结构体数据段呢 ?–以run_list为例说明
a. 核心逻辑:我们通过struct list_head * 类型的指针访问到的是 run_list 的地址,但是我们需要访问的数据段在task_struct中,需要拿到task_struct(进程控制块)的地址。
b. Linux内核实现:利用 C 语言的指针偏移计算,内核定义了offsetof 和 container_of。
// 1. 核心封装1:获取结构体中某个成员的偏移量
#define offsetof(TYPE, MEMBER) ((size_t) &((TYPE *)0)->MEMBER)
// 2. 核心封装2:container_of
#define container_of(ptr, type, member) ({ \\
const typeof(((type *)0)->member) *__mptr = (ptr); \\
(type *)((char *)__mptr – offsetof(type, member)); \\
})
代码解释1:offsetof
/**
* offsetof – 获取结构体成员在结构体内的字节偏移量
* @TYPE: 目标结构体的类型名称(例如 struct task_struct)
* @MEMBER: 结构体中的成员名称(例如 pid)
*
* 该宏在编译期计算 @MEMBER 成员在 @TYPE 结构体中的偏移量(以字节为单位)。
* 它利用空指针(地址 0)进行地址运算,但不会引发运行时访问错误,
* 因为整个表达式在编译阶段被编译器解析为常量。
*
* 此宏是内核中实现指针逆向转换(container_of)的基础工具。
*
* Return: 返回 @MEMBER 在 @TYPE 中的字节偏移量,类型为 size_t。
*/
#define offsetof(TYPE, MEMBER) ((size_t) &((TYPE *)0)->MEMBER)
代码解释2:container_of
/**
* container_of – 通过结构体成员指针反推整个结构体的起始指针
* @ptr: 指向结构体成员 @member 的指针
* @type: 目标结构体的类型名称(例如 struct task_struct)
* @member: 结构体中与 @ptr 对应的成员名称(例如 run_list)
*
* 该宏利用 @ptr 指向的成员地址,减去该成员在结构体中的偏移量,
* 从而获得包含该成员的结构体变量的首地址。
*
* 内部实现包含类型安全检查:如果 @ptr 的类型与 @member 的类型不匹配,
* 编译器会给出警告或错误,提高了代码的安全性。
*
* 该宏是内核中链表操作(list_entry)、设备驱动私有数据获取等场景的核心工具。
*
* Return: 返回 @type 类型的结构体指针,即包含 @member 的完整结构体地址。
*/
#define container_of(ptr, type, member) ({ \\
const typeof(((type *)0)->member) *__mptr = (ptr); \\
(type *)((char *)__mptr – offsetof(type, member)); \\
})
c.通过内存分布解释
container_of(node,struct task_struct,run_list); //node为指向run_list的指针
内存地址: 0x1000 0x1008 0x1050 (假设 run_list 偏移量为 0x50)
┌───────────────┬───────────────┬───────────────┐
│ pid (4B) │ prio (4B) │ run_list │ …
└───────────────┴───────────────┴───────────────┘
▲ ▲
│ │
task_struct 起始地址 ptr
1.3 Linux中查看进程
1.3.1 ps — 进程快照
ps:查看当前终端的进程
ps :查看当前终端的进程
#ps 输出示例
PID TTY TIME CMD
7572 pts/1 00:00:00 bash
24906 pts/1 00:00:00 ps
ps aux:查看所有进程(BSD 风格)
ps aux:查看所有进程(BSD 风格)
#ps aux 输出各列含义:
USER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMAND
root 1 0.0 0.1 169k 52k ? Ss Jun01 0:03 /sbin/init
#补充说明:
USER:进程运行用户
PID:进程唯一 ID
%CPU:CPU
%MEM:内存占用率
VSZ / RSS:虚拟内存、实际物理内存(单位 KB)
TTY:关联终端,`?`代表无终端
STAT:进程运行状态
START:进程启动时间
TIME:进程累计占用 CPU 时长
COMMAND:启动该进程的命令
Linux 进程 STAT 状态码速查表
主状态(首位)
S:可中断睡眠,等待事件唤醒
R:运行 / 就绪,正在执行或等待 CPU 调度
D:不可中断睡眠,多因 IO 阻塞,无法被信号终止
Z:僵尸进程,已退出但父进程未回收
T:进程被暂停
附加标识(后续位,可组合)
s:会话领导者
+:前台进程组
l:多线程进程
<:高优先级
N:低优先级
ps aux –sort=-%mem: 按内存排序
ps aux –sort=-%mem:按照内存占用率排序所有进程
输出结果如下:
USER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMAND
root 19239 0.6 1.5 1022832 59480 ? Ssl Jun22 12:02 /usr/local/qcloud/YunJing/YDEyes/YDService
root 10078 1.4 0.6 960228 24212 ? Sl May26 578:53 barad_agent
hamber 1901 0.0 0.5 760976 22316 ? Sl Jun11 0:00 /home/hamber/.VimForCpp/cquery/bin/cquery
hamber 11162 0.0 0.5 760972 22148 ? Sl Jun01 0:00 /home/hamber/.VimForCpp/cquery/bin/cquery
ps aux –sort=-%cpu : 按 CPU 排序
ps aux –sort=-%cpu:按照CPU占用率排序所有进程
输出结果如下:
USER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMAND
root 10078 1.4 0.6 968424 24236 ? Sl May26 578:54 barad_agent
root 19239 0.6 1.5 1022832 59504 ? Ssl Jun22 12:02 /usr/local/qcloud/YunJing/YDEyes/YDService
root 1 0.1 0.1 191152 4148 ? Ss May12 99:49 /usr/lib/systemd/systemd –switched-root
root 2 0.0 0.0 0 0 ? S May12 0:01 [kthreadd]
ps -ef:查看所有进程 (标准风格)
ps -ef
-e:显示所有进程(等价 -A)
-f:完整格式输出(展示 UID、PPID、CMD 等详细字段)
#执行后每行代表一个进程,列依次为:
UID PID PPID C STIME TTY TIME CMD
#解释进程信息:
UID:进程所属用户 ID / 用户名
PID:进程 ID(唯一标识进程,杀进程用 kill PID)
PPID:父进程 ID(创建当前进程的父进程)
C:CPU 占用百分比(优先级相关)
STIME:进程启动时间
TTY:终端设备,? 表示后台守护进程
TIME:进程占用 CPU 的总时长
CMD:启动进程的完整命令 / 程序
ps -ef | grep [进程名/关键词] : 过滤特定进程
ps -ef | grep myprocess :输出指定进程信息,不包含标题
输出结果如下:
hamber 9493 14683 0 20:05 pts/1 00:00:00 ./myprocess
hamber 15151 22216 0 20:26 pts/3 00:00:00 grep –color=auto myprocess
[补充如下命令]
ps -ef | head -1 && ps -ef | grep myprocess :输出指定进程信息,包含标题,但会输出grep信息
输出结果如下:
UID PID PPID C STIME TTY TIME CMD
hamber 9493 14683 0 20:05 pts/1 00:00:00 ./myprocess
hamber 15937 22216 0 20:29 pts/3 00:00:00 grep –color=auto myprocess
ps -ef | head -1 && ps -ef | grep myprocess | grep -v grep :输出指定进程信息,包含标题,不会输出grep信息
输出结果如下:
UID PID PPID C STIME TTY TIME CMD
hamber 9493 14683 0 20:05 pts/1 00:00:00 ./myprocess
ps -p <PID> -f : 由 PID 查看某个进程
#查看某个Pid为1234 的进程
ps -p 1234 -f
-p PID:只显示指定 PID 的进程
-f:完整格式(UID/PID/PPID/C/STIME/TTY/TIME/CMD)
#输出示例:
UID PID PPID C STIME TTY TIME CMD
hamber 22636 5233 0 19:06 pts/0 00:00:00 ./myprocess
1.3.2 top/htop — 实时监控
A. top/htop:实时监控进程
top # 系统自带,实时刷新
htop # 更好的交互界面(需安装:apt install htop)
B. top:常用快捷键
top 常用快捷键:
P:按 CPU 使用率排序
M:按内存使用率排序
k:输入 PID 终止进程
r:修改进程优先级
1:查看各 CPU 核心状态
f:自定义展示字段列
H:显示线程信息
q:退出 top 界面
1.3.3 proc — 查看进程详细信息
/proc/[PID] :以 [PID] 为目标进程 查看进程详细信息
相关指令操作:
ls /proc/ # 每个数字目录对应一个进程
cat /proc/<pid>/status # 进程状态详情
cat /proc/<pid>/cmdline # 启动命令
cat /proc/<pid>/environ # 环境变量
ls /proc/<pid>/fd # 打开的文件描述符
ls /proc/<pid>/cwd #进程所在的工作路径
cat /proc/<pid>/maps # 内存映射
cat /proc/1234/limits # 资源限制
示例:以 1234 为目标进程 PID:
#每个数字目录对应一个进程
ls /proc/1
# 进程状态详情
cat /proc/1234/status
# 环境变量
cat /proc/1234/environ
# 打开的文件描述符
ls -l /proc/1234/fd/
# 内存映射
cat /proc/1234/maps
# 资源限制
cat /proc/1234/limits
1.3.4 kill -信号说明
kill : 用于向进程发出信号,使进程做出相应操作
kill 信号说明
信号 编号 说明
SIGHUP (1) 挂起信号,常用于重新加载配置
SIGINT (2) 中断(Ctrl+C)
SIGTERM (15) 优雅终止(默认信号)
SIGKILL (9) 强制杀死(不可被捕获)
SIGSTOP (19) 暂停进程
SIGCONT (18) 恢复暂停的进程
kill 常见操作
kill -1 <pid> # 发送 SIGHUP
kill -9 <pid> # 强制杀死指定pid进程
kill -STOP <pid> # 暂停指定pid进程
kill -CONT <pid> # 恢复指定pid进程
1.3.5 常见实用命令
查看占用某端口的进程 lsof -i :8080 或 netstat -tlnp | grep 8080
查看最耗 CPU 的进程 ps aux –sort=-%cpu | head
查看最耗内存的进程 ps aux –sort=-%mem | head
杀死进程 → kill <pid>(SIGTERM)/ kill -9 <pid>(SIGKILL)
按名称杀进程 → pkill nginx 或 killall nginx
查看进程运行了多久 → ps -eo pid,etime,cmd
查看进程的线程 → ps -eLf | grep <pid> 或 ls /proc/<pid>/task/
1.4 Linux中父子进程
1.4.1 基本概念
核心概念:在Linux 中所有进程(除了 PID 1)都是由另一个进程创建的。创建者是父进程(Parent),被创建的是子进程(Child)。
进程id(PID):通过库函数getpid()获取,其中库函数的头文件包含在 #include <sys/types.h>
父进程id(PPID):通过库函数getppid()获取,其中库函数的头文件包含在#include <sys/types.h>
进程图树:
进程树图
+————————-+
| systemd |
| (PID 1) |
| all processes |
+————+————+
|
+—————-+—————-+
| | |
+——-+——–+ +—–+——+ +——-+——–+
| sshd | | cron | | nginx |
| (PID 567) | | (PID 234) | | (PID 1234) |
| SSH daemon | | cronjob | | web server |
+——-+——–+ +————+ +–+——–+—-+
| | |
+——-+——–+ +——-+–+ +—+——–+ +——–+——-+
| bash | | worker-1 | | worker-2 | | worker-3 |
| (PID 900) | | (PID 35) | | (PID 36) | | (PID 37) |
| shell | +———-+ +————+ +—————-+
+——-+——–+
|
+——-+——–+
| vim |
| (PID 888) |
| editor |
+—————-+
1.4.2 创建进程
fork函数
1. 函数体: pid_t fork(void);
2. 包含在头文件:#include <unistd.h>
3. 函数功能:fork() 是 Linux 中创建子进程的唯一系统调用,调用一次,返回两次。
4. 返回值:对于父进程返回子进程的pid,对于子进程返回pid=0
5. 执行逻辑:
时刻1:父进程调用 fork()
│
↓
时刻2:内核复制进程(此时有两个进程了)
│
├── 父进程(原来的)
└── 子进程(新复制的)
│
↓
时刻3:两个进程各自返回
├── 父进程返回子进程PID
└── 子进程返回0
6.内核复制进程阶段做了什么?
复制的内容: 效果:
代码段(执行到哪一行) 两个进程都从 fork() 返回处继续执行
数据段(变量的值) 两个进程有各自的变量副本
堆栈(函数调用链) 两个进程有各自的栈
寄存器状态 两个进程有各自的 CPU 状态
程序计数器(PC) 两个进程都指向 fork() 的下一条指令
返回地址 两个进程都知道返回到哪里
完整示例:创建子进程
#include <stdio.h>
#include <unistd.h>
int main()
{
int x = 10;
pid_t id = fork();
if(id < 0)
{
perror("fork");
return 1;
}
if (id == 0)
{
// 子进程
printf("子进程: pid=%d\\n", getpid());
}
else if (id > 0)
{
// 父进程
printf("父进程: pid=%d\\n", getpid());
}
return 0;
}
问题1:为什么fork函数给父进程和子进程的pid值不相同?
根本原因:区分身份
1. 原因一:从父进程的角度
因为父进程的数量与子进程的数量为1:n,也就是说父进程可以有多个子进程。
父进程需要管理子进程,父进程需要知道我创建了哪个子进程,所以返回值为子进程的pid
2.原因二:从子进程的角度
子进程虽然不需要知道自己的 pid 是多少(它可以用 getpid() 获取),但需要一种简单的方式确认"我是子进程",所以返回值为0.
问题2:为什么fork函数要返回两次?
1.根本原因:fork() 复制了整个进程
假设 fork() 只给父进程返回,子进程不返回:子进程没有返回值,它不知道自己是子进程,无法区分身份,无法执行不同的代码分支。
问题3:为什么fork函数能够返回两次?
答:
普通函数只能返回一次,因为只有一个执行流,但 fork() 会复制整个进程,在return之前子进程就已经创建,产生两个独立的执行流,每个执行流都要返回一次,所以总共返回两次。
图示示例:
1.普通函数:
调用 → 执行 → 返回一次
──────────────────────→
只有一条执行流
2.fork函数:
调用 → 内核复制进程 → 两条执行流各自返回
───────────────────┐
├── 父进程 ──→ 返回 pid
└── 子进程 ──→ 返回 0
问题4:为什么fork函数返回的id能让 if 和 else if 同时成立?
答:
不是一个变量同时有两个值,而是 fork() 创建了两个进程,每个进程通过写实拷贝有各自独立的变量副本,各自的值不同,各自走不同的分支。
代码演示:
#include <stdio.h>
#include <unistd.h>
int main()
{
pid_t id = fork();
if (id == 0)
{
printf("A\\n");
}
else if (id > 0)
{
printf("B\\n");
}
}
fork的完整流程图:
因为 fork() 之后变量 id 在两个进程中是两个不同的副本:
fork() 之后:
父进程 子进程
┌──────────┐ ┌──────────┐
│ id=1001 │ │ id=0 │
└──────────┘ └──────────┘
父进程的 id 是 1001 子进程的 id 是 0
同一个变量 id,在不同进程中有不同的值:
执行过程:
fork()
│
┌───────────┴───────────┐
↓ ↓
父进程 子进程
id = 1001 id = 0
│ │
↓ ↓
if (1001 == 0) if (0 == 0)
→ false → true
↓ ↓
else if (1001 > 0) printf("A") ← 执行这里
→ true ↓
↓ return
printf("B") ← 执行这里
↓
return
1.5 进程的状态
在Linux操作系统下,进程的完整状态图:
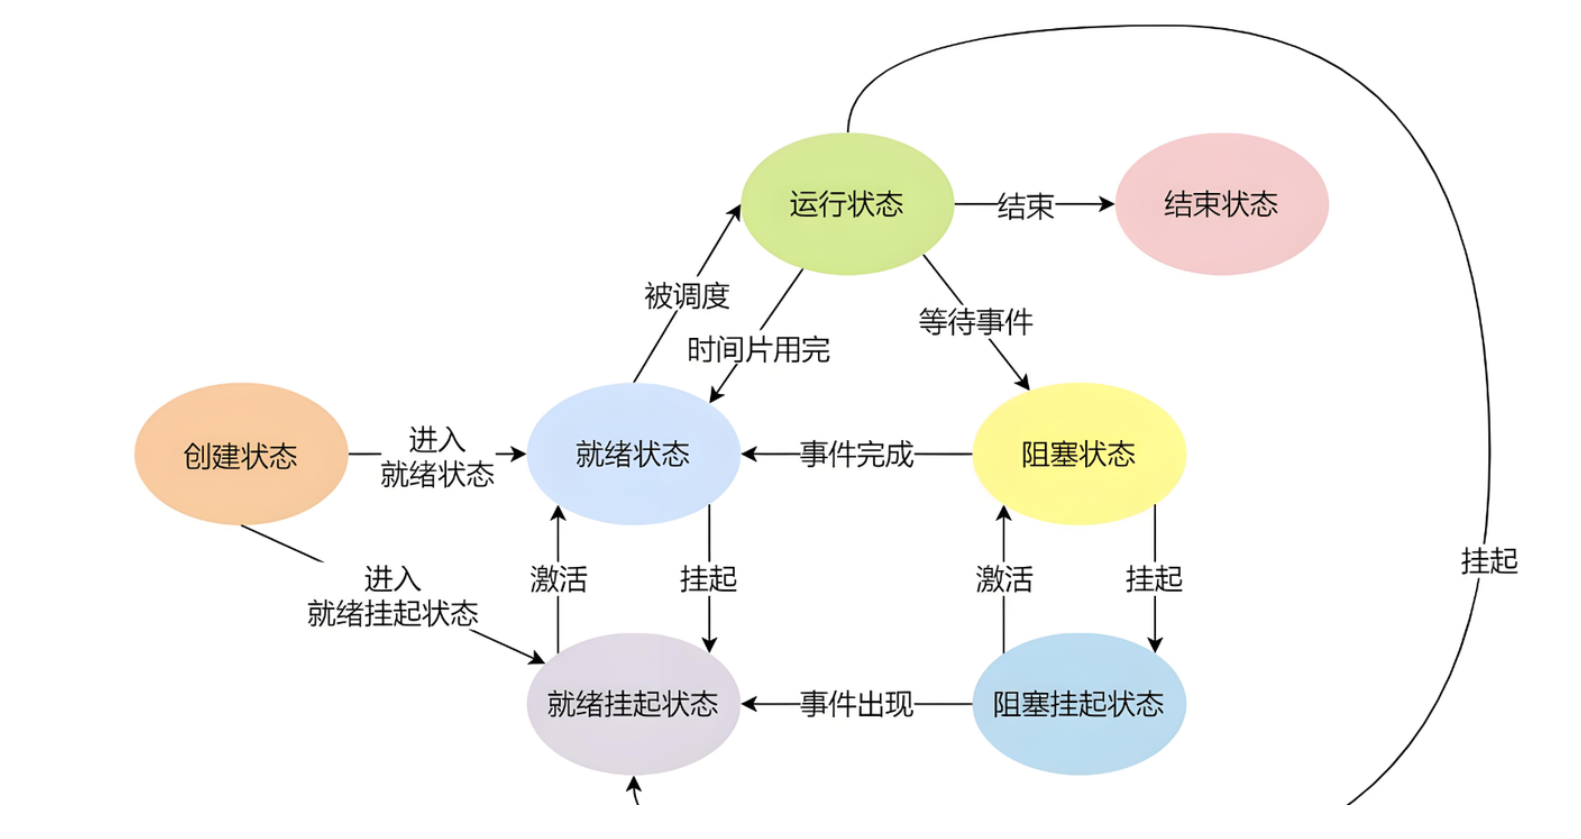
1.5.1 进程状态的定义
Linux中进程的PCB:通过一个整数字段,进行描述进程状态
struct task_struct
{
volatile long state; // <-进程状态
// … 几百个字段
};
1.5.2 进程状态的分类
Linux内核源代码:通过宏定义进行定义各自进程的状态,利用字符串数组进行维护。
#define R (running) 0
#define S (sleeping) 1
#define D (disk sleep) 2
#define T (stopped) 4
#define t (tracing stop) 8
#define X (dead) 16
#define Z (zombie) 32
//Linux中 6 种进程状态,通过字符数组进行维护宏
static const char *const task_state_array[] = {
"R (running)", //0
"S (sleeping)", //1
"D (disk sleep)", //2
"T (stopped)", //4
"t (tracing stop)", //8
"X (dead)", //16
"Z (zombie)", //32
};
进程的状态解释:
R Running 正在运行 或 在运行队列中(就绪) -运行/就绪状态
S Sleeping 可中断睡眠(等待事件,可被信号唤醒) -阻塞状态
D Disk Sleep 不可中断睡眠(通常等待磁盘 I/O) -阻塞状态
T Stopped 被信号停止(如 kill -19 SIGSTOP) -暂停状态
t Tracing Stop 被调试器停止(如 ptrace) -暂停状态
Z Zombie 僵尸进程(已死,等待父进程回收)
X Dead这个状态只是⼀个返回状态,你不会在任务列表里看到这个状态。
A. 运行状态
运行状态: Running / Runnable(运行/可运行),是 Linux 进程最常见的活跃状态。
运行状态的两种子情况:
-
进程 A: 正在 CPU 上执行代码 → 真正的 Running
-
进程 B: 在运行队列中等调度 → Runnable(可运行,等待 CPU)
综上所述:运行状态= "进程正在 CPU 上运行" 或 "正在运行队列中等待 CPU 时间片"
运行态的调度:
R (运行中)
|
| 条件1:CPU 时间片用完
|
├──→ R (被重新调度,可能继续执行)
|
| 条件2:等待 I/O(磁盘/网络)
|
└──→ S (可中断睡眠) 或 D (不可中断睡眠)
|
| 条件3:完成 I/O 后
|
└──→ R (回到运行队列)
B. 阻塞状态
阻塞状态:进程仍在内存、PCB 仍然在调度器可见范围内,当进程需要等待某个外部事件(如 I/O 操作完成、获取锁、等待信号量等)而无法继续执行时,它会主动放弃 CPU 并进入阻塞状态。
运行状态的两种子情况:
-
可中断睡眠
-
不可中断睡眠
A.可中断睡眠:
TASK_INTERRUPTIBLE(S 态,可中断睡眠)
– 进程因等待事件(如 I/O、锁、信号量)而睡眠
– 可被信号唤醒,唤醒后去执行信号处理函数
– 是绝大多数阻塞场景的默认选择
– ps 中显示为 S
示例场景:read() 阻塞等待数据到达;sem_wait() 等待锁释放。
B.不可中断睡眠:
TASK_UNINTERRUPTIBLE(D 态,不可中断睡眠)
– 进程在关键内核操作期间进入此状态
– 不能被任何信号打断,包括 kill -9
– 目的是保证某些操作的原子性,防止与信号处理程序产生竞态
– ps 中显示为 D
典型场景:等待磁盘 I/O 完成、NFS 远程访问、内核某些关键路径
查看阻塞状态:
#查看可中断睡眠
ps aux | awk '$8 ~ /S/'
#查看不可中断睡眠
ps aux | awk '$8 ~ /S/'
阻塞状态运行的机制:
阻塞态的调度本质上是 "睡眠 — 调度切换 — 唤醒" 的完整闭环:
进程 A 调用阻塞 API
│
▼
设置状态为 S 或 D
│
▼
加入等待队列 wait_queue
│
▼
调用 schedule() → 主动让出 CPU
│
▼
调度器选择其他进程运行(B)
│
▼
… 时间流逝 …
│
▼
事件就绪,内核调用 wake_up()
│
▼
从等待队列取出进程 A,状态置为 TASK_RUNNING
│
▼
A 重新进入运行队列,等待调度
C. 暂停状态
暂停状态:表示进程被外部强制停止执行,不消耗 CPU、内存数据、运行进度被完好地保留着,仍保留在进程表中等待恢复。
触发暂停状态:进入暂停状态主要靠信号
进入暂停状态的方式:
1. Ctrl + Z #终端会向该进程发送 SIGTSTP (Terminal Stop) 信号
2. kill -STOP <PID> #向进程发送 SIGSTOP 信号。
查看暂停状态:
ps aux | awk '$8 ~/T/'
ps aux | grep 'T'
需要暂停状态的原因:
暂停状态(T / t)是 Linux 用来承载"被迫停止"语义的状态.
1.它作用于作业控制(Ctrl+Z / fg / bg)
2.调试器(gdb / ptrace)
3.运维治理(冻结 / 热迁移 / 流量切换)
1.5.3 僵尸进程 和 孤儿进程
A. 僵尸进程
僵尸状态的概念:子进程已终止,但父进程未调用 wait() 回收其退出状态.
僵尸状态的核心特征:
1.它不占用 CPU,不占用内存,不打开任何文件。
2.它仅仅占用进程表中的一个位置和一个 PID(进程号),保留退出码、运行时间等。
僵尸进程的产生:
1.在 Linux 中,子进程退出时,内核会向父进程发送一个 SIGCHLD 信号,正常情况下,父进程收到信号后,应该调用 wait() 或 `waitpid() 系统调用来“读取”子进程的退出状态,并彻底清理进程表项。
2.父进程写得很糟糕,没有调用 wait(),或者父进程自己卡死了,子进程的“遗骸”就会一直留在进程表中,变成僵尸。
处理僵尸进程的方法:
1. 治根(修改代码):让父进程正确调用 wait(),或者捕获 SIGCHLD 信号并在信号处理函数中调用 wait()。
2. 治标(杀父进程):无法直接 kill -9 杀死一个僵尸进程(因为它已经死了)。唯一的办法是杀掉它的父进程,父进程死后,僵尸进程会变成“孤儿进程”,被 init 进程收养,init 会自动调用 wait() 把它彻底清理掉。
需要僵尸进程的原因:
1.子进程死的时候,可能父进程正忙于其他事情。内核保留子进程的基本信息(如退出码是 0 还是 1),是为了让父进程在方便的时候,能够知道子进程到底是“寿终正寝”还是“横死街头”。
2.如果子进程一死就灰飞烟灭,父进程就永远无法获取子进程的运行结果了。
僵尸进程的危害:
1. 虽然单个僵尸进程基本不占内存和 CPU,但它占用 PID 和进程表项。Linux 系统的 PID 数量是有限的(通常默认 32768 或更高)。
2. 如果程序有 Bug,疯狂产生僵尸进程,最终会耗尽系统的 PID 资源,导致系统无法创建任何新进程(连 ls 命令都跑不起来),这就是严重的系统故障。
查看僵尸进程:
ps aux | awk '$8 ~/Z/'
ps aux | grep 'Z'`
产生僵尸进程代码示例:
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
int main()
{
pid_t pid = fork();
if (pid == 0)
{
printf("child %d exit\\n", getpid());
_exit(0); // 子进程立刻退出
}
else
{
sleep(60); // 父进程不 wait,立刻睡眠
}
return 0;
}
B. 孤儿进程
孤儿进程的概念:孤儿进程是指父进程已经退出(或崩溃),但自己仍在继续运行的进程。
核心特征:它还活着,正常消耗 CPU 和内存,只是失去了亲生父母。
孤儿进程出现的原因:父进程因为正常退出、崩溃或被 kill 掉,导致其创建的子进程还在运行,这些子进程就成了孤儿。
孤儿进程如何处理:
1. 当发现一个进程变成孤儿时,内核会自动将它过继给 PID 为 1 的 init 进程(或 systemd)。
2. init 进程成为它的养父,当这个孤儿进程最终也走向死亡时,init 进程会自动调用 wait() 回收它,保证它不会变成僵尸进程。
问题:为什么孤儿子进程要被1号进程领养?
1.每个进程退出时,会进入 Z 状态(zombie / defunct),占用一个 进程描述符(task_struct / PCB) 和一个 PID。
2.真正释放这些资源,需要父进程调用 wait() / waitpid(),读取子进程的退出状态。
3.如果父进程已经死了,没人来 wait() 子进程,它就会永远停在 Z 状态,PID 永不归还。
4.系统的 PID 数量是有限的(例如默认 32768)。孤儿进程积累到一定程度,fork() 会失败,新进程无法创建——系统实质上半瘫痪。
5.因为1号进程系统启动时创建,运行时永远不会自己退出,所以负责在孤儿进程退出时 wait() 它,回收 PCB 和 PID。
1.6 进程优先级
优先级的核心概念:在操作系统中,优先级(PRI值)是调度器用来决定哪个进程/线程下一个获得 CPU 使用权的一个数值指标(权值)。
1.6.1 描述优先级
Linux 用两个不同的数值描述 CPU 调度优先级: PRI 值 和 Nice 值
映射关系:PRI = 120 + Nice
Nice值的取值范围为: -20 ~ 19
由此可知:
– Nice = -20 → PRI = 100(优先级最高)
– Nice = 0 → PRI = 120(优先级默认)
– Nice = +19 → PRI = 139(优先级最低)
1.6.2 优先级划分
Linux中优先级的划分:
PRI :
0 ─────── 99 │ 100 ──────────────── 139
实时进程 普通进程
PRI值为 0 ~ 99: 实时进程(Real-Time)
PRI值为 100 ~ 139:普通进程(Normal)
1.6.3 查看优先级
查看进程优先级:top / htop
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
1234 root 20 0 100m 10m 5m S 5.0 0.5 0:01.23 mysqld
5678 root -10 -5 200m 50m 10m S 50.0 2.0 5:00.00 rt_task
– PR:内核优先级(0 ~ 39 在 top 显示,实际是 0 ~ 139 映射)
– rt 表示实时进程(PR = -1 ~ -100,对应 0 ~ 99)
– 20 是普通进程的默认值(对应 120)
– NI:nice 值
– S:状态
1.7 进程性质
1.7.1 竞争性
竞争性的理解:由于计算机系统的资源(CPU时间、物理内存、磁盘I/O、网络带宽等)是有限的,而系统中往往同时存在多个进程,因此进程之间必然会发生对有限资源的争夺。
进程 竞争性 的体现:
1.CPU 竞争:多个进程都想用 CPU,操作系统必须通过调度算法(如 CFS 完全公平调度)来决定谁先用、用多久(时间片)。
2.内存竞争:物理内存不够时,进程会竞争内存页,操作系统通过虚拟内存和 Swap(交换分区) 机制来协调,把暂时不用的内存换出到磁盘。
3.互斥与同步:当多个进程竞争同一个共享资源(如同时写同一个文件、访问同一个数据库)时,必须使用锁(Mutex)、信号量(Semaphore)
等机制来排队,防止数据混乱。
4.负面产物(死锁):如果竞争处理不当,进程 A 占着资源 1 等资源 2,进程 B 占着资源 2 等资源 1,就会陷入永久等待的“死锁”状态。
1.7.2 独立性
独立性的理解:进程是系统进行资源分配和调度的基本单位,每个进程都拥有自己独立的地址空间和独立的执行上下文,一个进程的执行通常不会直接干扰另一个进程的执行。
独立性的体现:
1.虚拟内存隔离:这是独立性最核心的体现。操作系统为每个进程分配了一个“虚拟的、连续的、独占的”内存空间(如 32 位系统下的 4GB)。进程 A 无法直接通过指针去读写进程 B 的内存,实现了内存级别的物理隔离。
2.独立的 PCB(进程控制块):内核为每个进程维护了一个独立的数据结构(task_struct),记录它自己的 PID、寄存器状态、打开的文件描述符等,互不干扰。
3.崩溃隔离(Fault Isolation):因为地址空间独立,如果进程 A 发生“段错误(Segmentation fault)”(如访问了非法内存地址),内核只会杀掉进程 A,不会导致整个系统或其他进程崩溃。
4.进程间通信(IPC):正因为进程是高度独立的,它们之间默认无法直接通信。如果它们需要协作,就必须借助操作系统提供的进程间通信(IPC)机制,如管道(Pipe)、消息队列、共享内存、Socket 等
1.7.3 并行性
并行性的理解:并行是指两个或多个事件在同一时刻发生。在进程层面,指的是多个进程在不同的物理 CPU 核心上同时执行。
并行性的体现:
1.硬件基础:并行性强依赖于硬件。只有在多核处理器(Multi-core) 或多 CPU(SMP 架构)的机器上,才能实现真正的进程并行。单核 CPU 绝对无法实现并行。
2.性能提升:并行是提升计算密集型任务(如视频渲染、科学计算、深度学习训练)吞吐量的最直接手段。
3.内核调度:Linux 内核的调度器会将就绪队列中的进程,尽可能均匀地分配到所有可用的 CPU 核心上同时运行,以最大化利用硬件算力。
1.7.4 并发性
并发性的理解:并发是指两个或多个事件在同一时间间隔内发生。在进程层面,指的是多个进程在单处理机上交替执行。宏观上看起来它们是同时运行的,但微观上它们是分时交替占用 CPU 的。
并发性的体现:
1.时间片轮转(Time Slicing):操作系统把 CPU 的时间切分成极短的片段(如几毫秒),让每个进程轮流使用一个时间片。
2.上下文切换(Context Switch):当时间片用完,内核会保存当前进程的现场(寄存器、PC指针等),然后加载下一个进程的现场。因为切换速度极快(微秒级),人类感觉不到停顿,以为它们在“同时”运行。
3.单核也能并发:并发是操作系统的基本特征。即使在几十年前的单核老电脑上,你也能一边听歌一边打字,这就是并发带来的“多任务” illusion(错觉)。
1.8 进程切换
1.8.1 CPU 和 寄存器的认识
A. CPU
CPU的理解 :是计算机的运算和控制核心,从内存中读取指令 → 解析指令 → 执行指令
CPU的工作原理:
1.取指(Fetch):根据“程序计数器(PC)”中的地址,从内存中取出下一条要执行的指令。
2.译码(Decode):控制单元(CU)分析这条指令是什么意思(比如是加法还是跳转)。
3.执行(Execute):算术逻辑单元(ALU)执行具体操作,并将结果写回。
B. 寄存器
寄存器的理解:寄存器是 CPU 内部集成的、容量极小但速度极快的微型存储器。它的读写速度与 CPU 的时钟频率同步(零延迟),是 CPU 处理数据时唯一的“直接工作台”。
注:CPU 不能直接对内存里的数据进行运算,必须先加载到寄存器中。
核心寄存器:
1.程序计数器(PC, Program Counter / x86中叫 RIP/EIP)
作用:永远指向下一条将要执行的指令的内存地址。
意义:CPU 就是靠它才知道代码执行到哪了。
2.栈顶指针(SP, Stack Pointer / x86中叫 RSP/ESP)
作用:指向当前进程在内存中调用栈(Stack)的栈顶位置。
意义:记录了当前函数调用到了哪一层、局部变量存在哪。
3.通用寄存器(GPRs,General Purpose Registers)
作用:例如 "x86-32 的 EAX、EBX、ECX" 或 "x86-64 的 RAX, RBX, RCX" 等,用于暂存运算过程中的临时数据和内存地址。
4.程序状态字寄存器(PSW / EFLAGS)
作用:记录上一条指令执行后的状态标志(如:结果是否为0、是否溢出、是否允许中断等)。
1.8.2 进程切换过程
进程切换的时机:
1. 时钟中断(最常见)
每个 CPU tick(通常 1ms 或更短)触发一次硬件中断。内核在中断处理中检查当前进程的时间片是否耗尽,若耗尽则设置 TIF_NEED_RESCHED 标志,表示"需要重新调度"。
2. 进程主动让出 CPU
进程调用 schedule() 主动让出(例如等待 I/O、调用 sleep()、等待锁等),进程进入阻塞态,不再具备运行条件。
3. 进程被更高优先级进程抢占
一个高优先级进程被唤醒(如 I/O 完成),内核检查后发现它比当前运行的进程优先级更高,触发抢占。
进程切换的过程:以CPU接受到时钟中断信号发现进程时间片耗尽
第 1 步:陷入内核(Trap to Kernel)
执行任务:
CPU 接收到时钟中断信号,暂停进程 A 的用户态代码,进程A的时间片耗尽。
CPU 切换到内核态,开始执行操作系统的中断处理程序。
第 2 步:保存进程 A 的上下文(Save Context)
执行任务:
操作系统将 CPU 当前所有关键寄存器的值(PC 程序计数器、SP 栈顶指针、通用寄存器等),原封不动地保存到进程 A 在内核空间的专属内存区域(通常是内核栈或进程控制块 PCB 中)。
第 3 步:调度器决策(Schedule)
执行任务:操作系统的调度器(Scheduler)开始工作,遍历就绪队列,根据优先级和算法,选中下一个要运行的进程 B。
第 4 步:恢复进程 B 的上下文(Restore Context)
执行任务:操作系统从内存中找出进程 B 之前保存的寄存器值,将它们重新加载回 CPU 的物理寄存器中。
关键点:当 B 的栈顶指针(SP)被加载到 CPU 时,CPU 的“工作台”就彻底变成了 B 的栈;
当通用寄存器被恢复时,B 的临时数据回到了案板上。
第 5 步:跳转执行(Jump & Resume)
操作系统将进程 B 之前保存的 PC(程序计数器)值加载到 CPU 的 PC 寄存器中。
CPU 根据新的 PC 值,去内存中取出进程 B 的下一条指令,开始译码和执行。
1.9 进程调度
1.9.1 基于位图索引的双数组轮转算法
A. 数据结构定义
struct prio_array:优先级索引容器
struct prio_array
{
unsigned int nr_active; //记录当前数组中的进程总数
unsigned int bitmap[5]; //140位的位图,用于O(1)查找
struct list_head queue[140];//140个优先级链表头
};
struct runqueue :运行队列结构体,维护进程的调度
struct runqueue
{
// … 其他字段 …
struct prio_array *active; // 指向当前活跃数组的指针
struct prio_array *expired; // 指向过期数组的指针
struct prio_array arrays[2]; // 实际存储的两个数组实体
};
struct runqueue (每个CPU一个)
├── … 其他字段 …
├── struct prio_array *active; ← 指针A
├── struct prio_array *expired; ← 指针B
└── struct prio_array arrays[2]; ← 实际内存实体
│
├── arrays[0] ← 第1块内存 (140个链表头 + 位图 + 计数器)
│ ├── bitmap[140 bits]
│ ├── nr_active
│ └── queue[0..139] (链表头数组)
│
└── arrays[1] ← 第2块内存 (140个链表头 + 位图 + 计数器)
├── bitmap[140 bits]
├── nr_active
└── queue[0..139] (链表头数组)
queue 数组 :用来存储队列的表头,每个元素均为struct list_head

B. 算法核心思想
步骤一:通过位图决定挑选哪个队列
核心思想:位图不记录队列里有“几个”进程,只记录这个队列“是否为空”,其中:1 表示非空(有进程),0 表示空。
补充说明:位图使用的优势
-
传统调度器寻找队列时,需要写一个 for 循环从 0 遍历到 139,在工程上被认为是伪 O(N)。
-
内核直接调用 CPU 的硬件指令 " BSF ",给 CPU 一个 32 位的整数,CPU 在1个时钟周期内,直接通过内部硬件电路返回从右往左第一个 1 所在的位索引,从而确定队列,只需要O(1)的时间复杂度。
实现位图映射优先级:
在 32 位 Linux 系统中,本质上是一个包含 5 个 32 位无符号整数的数组(5 × 32 = 160 位,足以覆盖 0~139 共 140 个优先级)。
unsigned long bitmap[5];
//bitmap[0] 的 bit 0 ~ 31 对应优先级 0 ~ 31 的队列
//bitmap[1] 的 bit 0 ~ 31 对应优先级 32 ~ 63 的队列
//bitmap[2] 的 bit 0 ~ 31 对应优先级 64 ~ 95 的队列
//bitmap[3] 的 bit 0 ~ 31 对应优先级 96 ~ 127 的队列
//bitmap[4] 的 bit 0 ~ 11 对应优先级 128 ~ 139 的队列
位图寻找队列算法实现:
// 简化版内核源码还原 (32位系统)
static inline int sched_find_first_bit(const unsigned long *b)
{
// 1. 检查实时进程的高优先级区 (word 0)
if (unlikely(b[0]))
{
// 如果有 1,直接调用硬件指令 ffs (find first set) 返回索引
//__ffs 底层就是封装了 x86 的 BSF 汇编指令
return __ffs(b[0]);
}
// 2. 检查实时进程的中优先级区 (word 1)
if (unlikely(b[1]))
{
return __ffs(b[1]) + 32; // 加上偏移量 32
}
// 3. 检查实时进程的低优先级区 (word 2)
if (unlikely(b[2]))
{
return __ffs(b[2]) + 64;
}
// 4. 检查普通进程的高优先级区 (word 3)
if (unlikely(b[3]))
{
return __ffs(b[3]) + 96;
}
// 5. 检查普通进程的低优先级区 (word 4)
// 如果前4个都没有,那一定在最后一个 word 里
return __ffs(b[4]) + 128;
}
步骤二:在队列中挑选合适的进程
从队列寻找待运行进程的算法实现:
// 假设通过位图 BSF 指令,已经找到了最高优先级的索引 i
int i = sched_find_first_bit(rq->active->bitmap);
// 1. 拿到队首的 list_head 节点 (O(1) 读指针)
struct list_head *first_node = rq->active->queue[i].next;
// 2. 灵魂操作:反推出完整的 task_struct (O(1) 减法运算)
struct task_struct *next_task = list_entry(first_node, struct task_struct, run_list);
// 3. 将该进程从链表中摘除 (O(1) 修改前后指针)
list_del_init(&next_task->run_list);
// 4. 检查队列是否空了,维护位图 (O(1) 判空与位操作)
if (list_empty(&rq->active->queue[i]))
{
__clear_bit(i, rq->active->bitmap);
rq->active->nr_active–;
}
步骤三:交换双指针
若active 数组中的进程一个个跑完时间片,最终active 数组被彻底掏空了(active->nr_active == 0,且其 Bitmap 全为 0)
此时,只需要将指向 active 数组的指针 和 指向expired 数组的指针进行交换
if (!rq->active->nr_active)
{
//交换:仅仅交换两个指针的指向!
swap(rq->active, rq->expired);
}
交换后:运行数组重新装满了进程
-
原本指向 arrays[1](装满进程)的 expired 指针,现在赋值给了 active。
-
原本指向 arrays[0](已空)的 active 指针,现在赋值给了 expired。
二、进程地址空间(虚拟地址)
2.1 虚拟地址的理解
2.1.1 虚拟地址空间定义
核心定义:进程地址空间是操作系统提供的一种核心抽象,它向每个进程伪装出一个假象:你独占了系统所有的、连续的内存资源。
在 32 位 Linux 系统上大小为 4GB(2^32 字节),在 64 位系统上理论上为 16EB(2^64字节),但实际只使用一小部分。
2.1.2 虚拟地址空间分布图
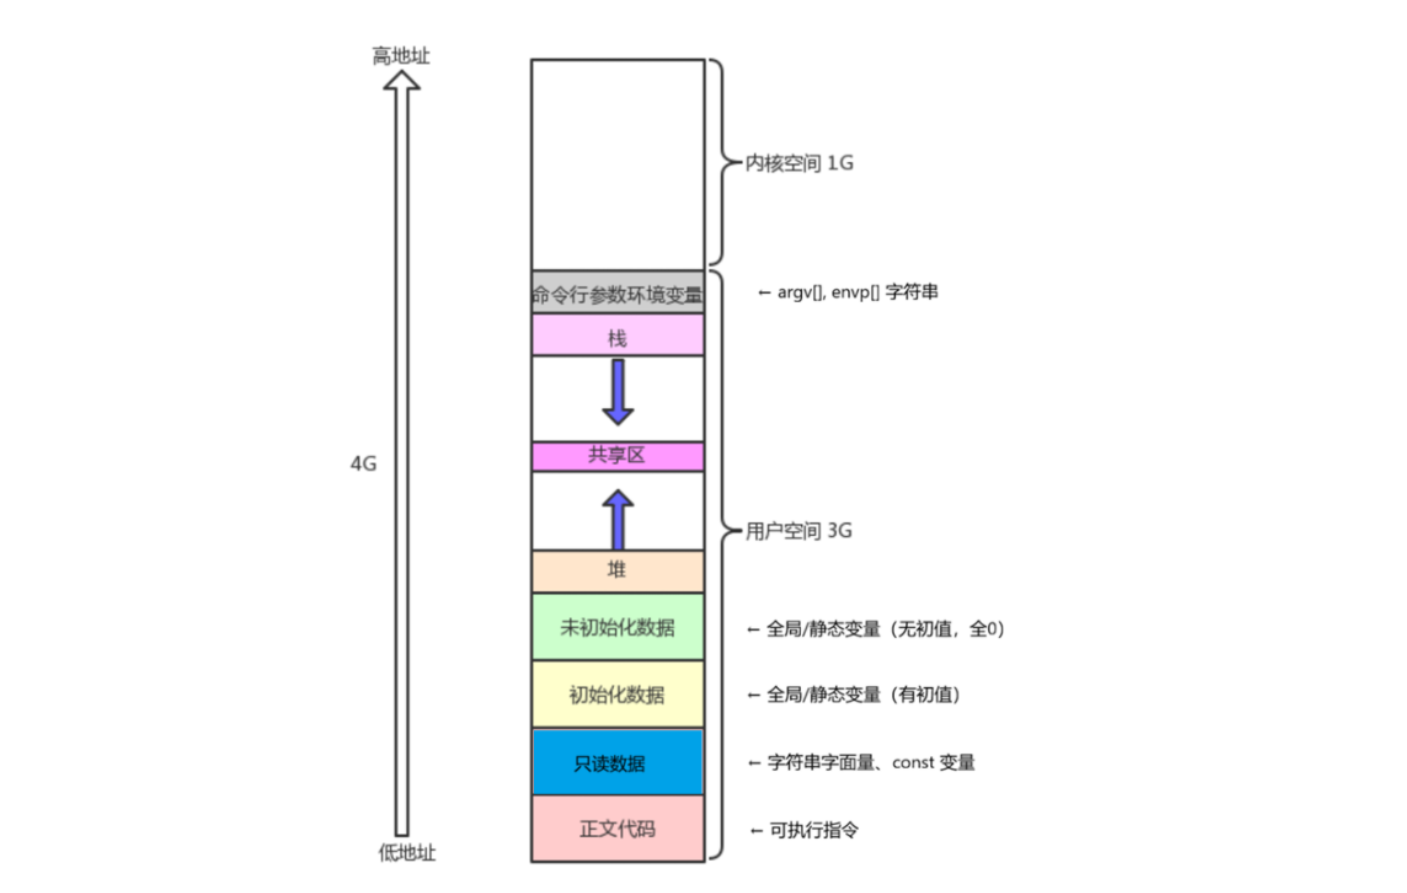
2.1.3 描述虚拟地址空间
mm_struct :每个进程在内核中都有一个 mm_struct,描述其虚拟地址空间
struct mm_struct
{
struct vm_area_struct *mmap; // VMA 链表
struct rb_root mm_rb; // VMA 红黑树(加速查找)
unsigned long mmap_base; // mmap 区基址
unsigned long task_size; // 用户空间大小
unsigned long start_code, end_code; // 代码段
unsigned long start_data, end_data; // 数据段
unsigned long start_brk, brk; // 堆范围
unsigned long start_stack; // 栈底
pgd_t *pgd; // 页全局目录
atomic_t mm_users; // 使用此 mm 的进程数
atomic_t mm_count; // 主引用计数
// …
};
struct vm_area_struct(VMA) :描述虚拟地址空间中连续的属性相同的区域
struct vm_area_struct
{
unsigned long vm_start; // 区间起始
unsigned long vm_end; // 区间结束
struct vm_area_struct *vm_next, *vm_prev; // 链表指针
struct rb_node vm_rb; // 红黑树节点
unsigned long vm_flags; // 属性标志
struct file *vm_file; // 关联的文件(mmap 用)
void *vm_private_data; // 私有数据
// …
};
2.2 分页式内存管理
分页的核心思想:将虚拟地址空间和物理内存切成固定大小的块:
1. 虚拟内存: 被切成固定大小的 页(Page),大小通常为 4KB。
2. 物理内存: 被切成同样大小的 页框(Page Frame ),大小也为 4KB。
3. 用一张页表(Page Table)记录 "第几页 → 放在第几个页框"。
2.2.1 核心概念:页、页框
进程的虚拟地址空间(连续,从 开始)
┌────────┬────────┬────────┬────────┬────────┐
│ │ │ │ │ │
│ 4KB │ 4KB │ 4KB │ 4KB │ 4KB │ …
│ │ │ │ │ │
└────────┴────────┴────────┴────────┴────────┘
页 0 页 1 页 2 页 3 页 4
物理内存(可能不连续,被其他进程/内核占用)
┌────────┬────────┬────────┬────────┬────────┐
│ │ │ │ │ │
│ 4KB │ 4KB │ 4KB │ 4KB │ 4KB │ …
│ │ │ │ │ │
└────────┴────────┴────────┴────────┴────────┘
框 0 框 1 框 2 框 3 框 4
2.2.2 物理内存的管理
A. 物理内存的描述 – struct page
Linux内核为每一个物理页框都分配一个 struct page 结构体,记录该页框的所有状态信息。
// 简化版 struct page(实际内核中更复杂)
struct page
{
unsigned long flags; // 页状态标志(脏页、锁定、活跃等)
atomic_t _refcount; // 引用计数(多少人在用这个页)
atomic_t _mapcount; // 被多少个 PTE 映射
struct list_head lru; // 挂在 LRU 链表上(用于页面回收)
union
{
struct
{ // 作为普通页使用时
struct page *next;
int pages;
int pobjects;
};
struct
{ // 作为 slab 对象使用时
struct list_head slab_list;
struct kmem_cache *slab_cache;
void *freelist;
};
// … 其他用途
};
};
B. 物理内存的组织 – mem_map
smem_map 数组(存放在物理内存中)
对于4GB内存,数组大小为:4GB / 4KB = 1,048,576
访问方式: mem_map[pfn]
┌────────────┬────────────┬────────────┬────────────┬─────┐
│ │ │ │ │ … │
│ struct page│ struct page│struct page │ struct page│ │
│ │ │ │ │ │
└────────────┴────────────┴────────────┴────────────┴─────┘
(框 0) (框 1) (框 2) (框 3)
▲ ▲ ▲ ▲
│ │ │ │
PFN=0 PFN=1 PFN=2 PFN=3
2.2.3 虚拟与物理地址的转换
CPU 发出的是虚拟地址,内存条上存数据用的是物理地址,两者之间必须有一张"翻译对照表"完成虚拟地址向物理地址的转换。
CPU进行寻址的流程:
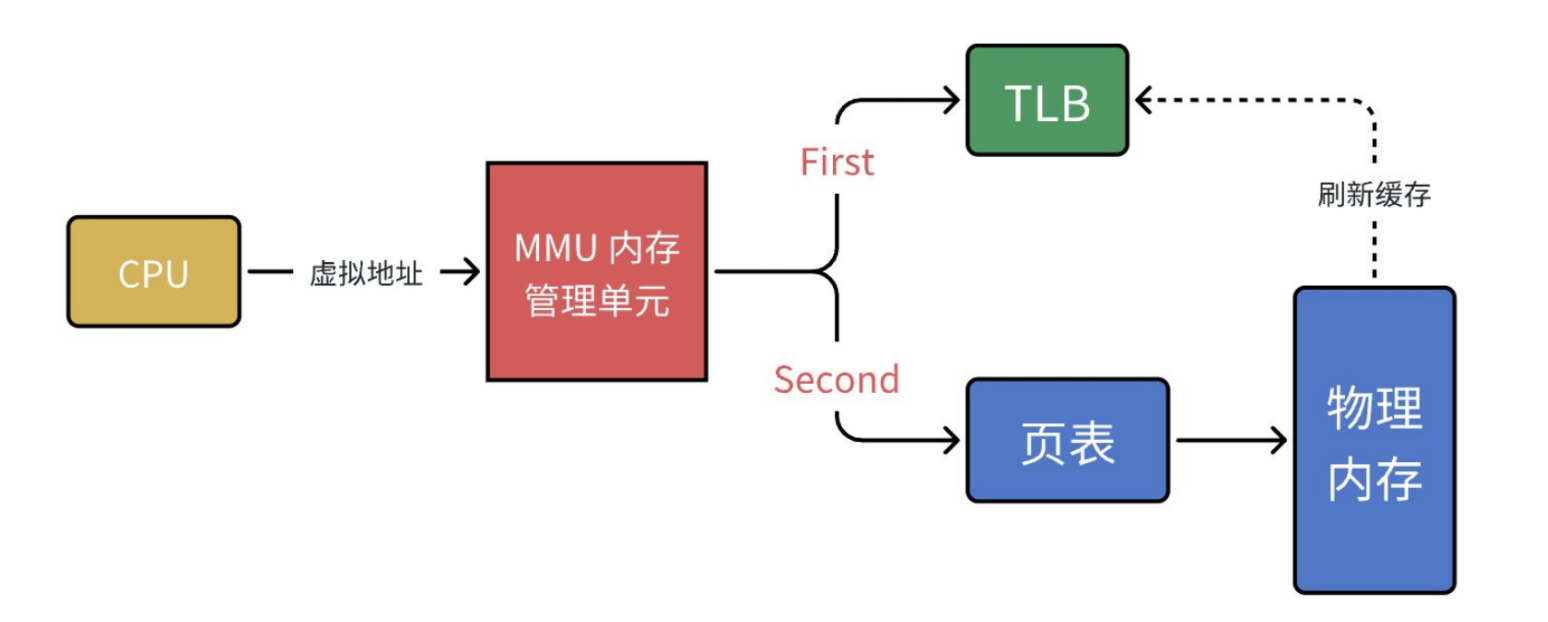
A. 单级页表
单级页表就是最朴素、最直接的翻译方案:用一张连续的数组,把每一个虚拟页号直接映射到一个物理页框号。
a.页表的结构
单级页表 = 一个一维数组
下标(虚拟页号 VPN) 内容(物理页框号 PFN + 控制位)
┌──────────────┐ ┌────────────────────────────┐
│ 0 │ ───→ │ PFN=5, P=1, R/W=1, U/S=1 │
│ 1 │ ───→ │ PFN=2, P=1, R/W=1, U/S=1 │
│ 2 │ ───→ │ PFN=8, P=1, R/W=0, U/S=1 │
│ 3 │ ───→ │ …P=0 … │
│ 4 │ ───→ │ PFN=0, P=1, R/W=1, U/S=0 │
│ … │ │ … │
│ N-1 │ ───→ │ PFN=12, P=1, R/W=1, U/S=1 │
└──────────────┘ └────────────────────────────┘
数组长度 = 虚拟地址空间的总页数 N
b.页表项
每个下标(虚拟页号 VPN)所对应的内容为页表项(PTE)
32 位页表项,大小为4B
高 20 位: 物理页框号 PFN 低 12 位: 控制位 / 状态位
┌────────────────────────────────┬────────────────────────────┐
│ │ │
│ Bit 31~12 │ Bit 11~0 │
│ │ │
│ Physical Frame Number │ 权限、存在性、缓存等 │
└────────────────────────────────┴────────────────────────────┘
b1. 物理页框号
物理内存被分成若干个 4KB 的页框:
框 0:0x0000_0000 ~ 0x0000_0FFF
框 1:0x0000_1000 ~ 0x0000_1FFF
框 2:0x0000_2000 ~ 0x0000_2FFF
…
框 N:N × 4096 ~ N × 4096 + 4095
PFN 就是"这个虚拟页对应第几号物理框"。
32 位物理地址空间中:
总框数 = 2^32 / 2^12 = 2^20 = 1,048,576
所以 PFN 需要 20 位来表示
b2. 控制位
Bit 11 ~ Bit 0 的详细含义:
控制位的详细展开:
┌─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┐
│Bit11│Bit10│Bit 9│Bit 8│Bit 7│Bit 6│Bit 5│Bit 4│Bit 3│Bit 2│Bit 1│Bit 0│
│ Avl │ Avl │ Avl │ G │ PAT │ D │ A │ PCD │ PWT │ U/S │ R/W │ P │
└─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┘
Bit 11 ─┐
Bit 10 │
Bit 9 ─┘ Available (Avl):3位,留给操作系统自由使用
Linux 用它来记录 Swap 信息、访问频率等
Bit 8 G (Global):
1 = 全局页,TLB 刷新时保留此条目
通常内核页设为 1
Bit 7 PAT (Page Attribute Table):
与 PWT、PCD 配合,选择该页的内存访问类型
(可缓存/不可缓存/写通/写回等)
Bit 6 D (Dirty):脏位
硬件自动置 1:该页被写过
页面回收时,D=1 的页必须写回磁盘
D=0 的页可以直接丢弃
Bit 5 A (Accessed):访问位
硬件自动置 1:该页被读或写过
操作系统用它实现页面置换算法(如 LRU 近似)
Bit 4 PCD (Page Cache Disable):
1 = 禁止缓存该页(用于 MMIO 设备寄存器映射)
0 = 允许缓存
Bit 3 PWT (Page Write-Through):
1 = 写通模式(写操作同时写缓存和内存)
0 = 写回模式(写操作只写缓存,延迟写内存)
Bit 2 U/S (User/Supervisor):
0 = 仅内核态(Supervisor)可访问
1 = 用户态也可访问
用户态访问 U/S=0 的页 → 触发保护异常
Bit 1 R/W (Read/Write):
0 = 只读
1 = 可读写
写操作访问 R/W=0 的页 → 触发保护异常
Bit 0 P (Present):存在位
1 = 该页在物理内存中,PFN 有效
0 = 该页不在物理内存中,PFN 字段无效
此时 CPU 触发缺页中断
剩余位可由操作系统自由使用(如记录 Swap 位置)
c.单级页表翻译的过程
虚拟地址 VA = 0x00002345
第1步:拆分
VPN = VA >> 12 = 0x2
Offset = VA & 0xFFF = 0x345
第2步:定位页表的地址
CR3 = 页表的首地址
页表的地址 = CR3 + VPN × 4
= CR3 + 2 × 4
= CR3 + 8
等价于数组寻址 PTE+4Byte*2
第3步:读出页表项(一次内存访问)
PTE[2] = 0x00500067
第4步:解析页表项的低12位
P = 1 → 页在内存中,继续
R/W = 1 → 可读写,通过
U/S = 1 → 用户态可访问,通过
第5步:解析页表项的高20位,并拼接物理地址
PFN = 0x00500067 >> 12 = 0x00500
PA = (PFN << 12) | Offset
= (0x00500 << 12) | 0x345
= 0x00500000 | 0x345
= 0x00500345
d. 单级页表的缺陷
核心缺陷:对于空间要求过大,32位系统下每个进程的页表大小需要4MB,64位系统下每个进程的页表大小需要512GB。
32 位地址空间,4KB 页:
总页数 = 2^32 / 2^12 = 2^20 = 1,048,576
每个 PTE = 4 字节
页表总大小 = 1,048,576 × 4 = 4 MB
64 位地址空间(48位有效),4KB 页:
总页数 = 2^48 / 2^12 = 2^36 = 68,719,476,736
每个 PTE = 8 字节
页表总大小 ≈ 512 GB ← 完全不可能!
B. 多级页表
以32 位系统的多级页表是两级结构为例进行说明。
a. 二级页表的结构
┌──────────────────┐ ┌──────────────────┐
│ 页目录 │──────→ │ 页表 │──→ 页表项(PTE):存储了物理地址
│ (Page Directory) │ │ (Page Table) │
└──────────────────┘ └──────────────────┘
第一级 第二级
| 页目录(第一级) | 一个 4KB 的数组,包含 1024 个页目录项(PDE),每项 4 字节(4B),存放第二级页表的地址 |
| 页表(第二级) | 一个 4KB 的数组,包含 1024 个页表项(PTE),每项 4 字节(4B),存放页表项 |
在32位系统下,二级页表能覆盖的虚拟地址为:4GB
1. 二级页表有一个页目录,一个页目录共有1024个页表
2. 一个页表有 1024 个 PTE(10位索引),每个 PTE 映射一个 4KB 的物理页框
3. 一个页表覆盖的虚拟地址范围: 1024 × 4KB = 4MB
4. 覆盖的虚拟地址范围位: 1024 * 4MB = 4GB
在32位系统下,二级页表最多需要的空间为:4MB+4KB≈4MB
1. 页目录固定占据4KB大小的空间
2. 页表占据的空间为:N*M*4B
注:
a. N为所需的页表数,一个页目录最多有1024个页表
b. M为所需的页表项数,一个页表最多有1024个页表项
c. 在32位系统下,一个页表项的大小固定为4B。
故而二级页表所需的空间为 4KB + 1024*1024*4B ≈ 4MB
b. 页目录
页目录(第一级):
条目数 = 2^10 = 1024
每条目 = 4 字节
总大小 = 1024 × 4 = 4096 字节 = 4KB
存储的内容:指向一个页表的物理基地址
下标 内容(页表的物理地址)
┌──────────────┐ ┌────────────────────────────┐
│ 0 │ ───→ │ 0x00112233 │ <- 一个页表的地址
│ 1 │ ───→ │ │
│ … │ │ │
│ 1023 │ ───→ │ │
└──────────────┘ └────────────────────────────┘
c. 页表
页表(第二级):
条目数 = 2^10 = 1024
每条目 = 4 字节
总大小 = 1024 × 4B = 4096 字节 = 4KB
存放的内容为:页表项PTE,其中包含物理页框号 + 控制位
下标(虚拟页号 VPN) 内容(物理页框号 PFN + 控制位)
┌──────────────┐ ┌────────────────────────────┐
│ 0 │ ───→ │ PFN=5, P=1, R/W=1, U/S=1 │
│ 1 │ ───→ │ PFN=2, P=1, R/W=1, U/S=1 │
│ 2 │ ───→ │ PFN=8, P=1, R/W=0, U/S=1 │
│ 3 │ ───→ │ …P=0 … │
│ 4 │ ───→ │ PFN=0, P=1, R/W=1, U/S=0 │
│ … │ │ … │
│ 1023 │ ───→ │ PFN=12, P=1, R/W=1, U/S=1 │
└──────────────┘ └────────────────────────────┘
d.页表项
每个下标(虚拟页号 VPN)所对应的内容为页表项(PTE)
页表项位32位,即大小为4B
高 20 位: 物理页框号 PFN 低 12 位: 控制位 / 状态位
┌────────────────────────────────┬────────────────────────────┐
│ │ │
│ Bit 31~12 │ Bit 11~0 │
│ │ │
│ Physical Frame Number │ 权限、存在性、缓存等 │
└────────────────────────────────┴────────────────────────────┘
e. 二级页表翻译的过程
32 位虚拟地址的解析过程
┌──────────────────┬──────────────────┬──────────────────┐
│ Bit 31 ~ 22 │ Bit 21 ~ 12 │ Bit 11 ~ 0 │
│ (10 位) │ (10 位) │ (12 位) │
│ │ │ │
│ 页目录索引 │ 页表索引 │ 页内偏移 │
│ (PDE Index) │ (PTE Index) │ (Offset) │
│ │ │ │
│ 取值范围: │ 取值范围: │ 取值范围: │
│ 0 ~ 1023 │ 0 ~ 1023 │ 0 ~ 4095 │
└──────────────────┴──────────────────┴──────────────────┘
│ │ │
│ │ │
▼ ▼ ▼
选哪个页表 选择页表项 页内的偏移量
翻译虚拟地址 VA = 0x0040_3004
第 1 步:拆分虚拟地址
0x0040_3004 的二进制:
0000 0000 01 | 00 0000 0011 | 0000 0000 0100
───────────── ────────────── ────────────────
PDE Index PTE Index Offset
= 0x001 = 1 = 0x003 = 3 = 0x004 = 4
第 2 步:读取 CR3,得到页目录物理基地址
CR3 = 0x001_00000(页目录的基地址,存放在物理地址 0x0010_0000)
第 3 步:查页目录(第一级查表) 【这是第 1 次内存访问(查表)】
PDE 的物理地址 = CR3 + PDE_Index × 4
= 0x0010_0000 + 1 × 4
= 0x0010_0004
从物理内存 0x0010_0004 处的PDE[1]
读取 :PDE[1] = 0x0020_0067
解析 PDE[1]:
解析低12位:
Bit 0 (P) = 1 → 页表存在,继续
Bit 1 (R/W) = 1 → 可读写
Bit 2 (U/S) = 1 → 用户态可访问
解析高20位:
地址字段 = 0x0020_0067 & 0xFFFFF000 = 0x0020_0000
→ 页表的物理基地址 = 0x0020_0000
第 4 步:查页表(第二级查表) 【这是第 2 次内存访问(查表)】
PTE 的物理地址 = 页表基地址 + PTE_Index × 4
= 0x0020_0000 + 3 × 4
= 0x0020_000C
从物理内存 0x0020_000C 处,即PTE[3]
读取 PTE[3] = 0x0050_0067
解析 PTE[3]:
解析低12位:
Bit 0 (P) = 1 → 物理页在内存中,继续
Bit 1 (R/W) = 1 → 可读写
Bit 2 (U/S) = 1 → 用户态可访问
Bit 5 (A) = 1 → 已被访问过
Bit 6 (D) = 1 → 已被写过
解析高20位:
地址字段 = 0x0050_0067 & 0xFFFFF000 = 0x0050_0000
→ 物理页框基地址 = 0x0050_0000
第 5 步:权限检查
综合 PDE 和 PTE 的权限:
U/S: PDE=1 AND PTE=1 → 用户态可访问 ✓
R/W: PDE=1 AND PTE=1 → 可读写 ✓
权限检查通过。
第 6 步:拼接最终物理地址
物理地址 = 物理页框基地址 + Offset
= 0x0050_0000 + 0x004
= 0x0050_0004
第 7 步:访问物理内存 【这是第 3 次内存访问(取数据)】
CPU 用物理地址 0x0050_0004 去读写数据。
f. 二级目录的优势
对于单级页表而言:
假设进程只使用了 8MB 虚拟内存:
对于32位系统,4KB的页面:
必须为全部 2^20 = 1,048,576 个虚拟页都分配 PTE
页表大小 = 1,048,576 × 4B = 4MB(固定,不可减少)
即使进程只用了 1kB 内存,页表仍需要 4MB。
对于二级页表而言:
假设进程只使用了 8MB 虚拟内存:
需要的页表数 = 8MB / 4MB = 2 个
实际分配:
页目录:1 个 × 4KB = 4KB(必须有,但大部分 PDE 的 P=0)
页表: 2 个 × 4KB = 8KB
总计: 4KB+ 8KB = 12KB