前段时间,组里一套跨机房跨城专线的数据同步服务在做极限压测。基础设施团队刚把专线物理带宽从 1Gbps 扩容到了 10Gbps,端到端往返时延(RTT)稳定在 32 毫秒左右。原本预期吞吐量能轻松拉出一条平直的高位曲线,但实测结果让人大跌眼镜:传输速率卡在不足 40MB/s 的低位,CPU 和内存利用率都在 10% 以下,网卡队列没有丢包,链路像被一堵无形的墙死死卡住。
排查链路配置时,我们在 Netty 服务端初始化的代码行里抓到了罪魁祸首:
// 线上隐患代码:自作聪明的手工调优
bootstrap.option(ChannelOption.SO_RCVBUF, 128 * 1024); // 强行设为 128KB
那位提交代码的同学在注释里写着:“将接收缓冲区增大到 128KB,提升吞吐量”。然而正是这句看似人畜无害的“性能优化”,在 Linux 内核层面给 TCP 连接戴上了一副沉重的枷锁。
今天我们深入 Linux 网络协议栈源码与内核参数,剖析 SO_RCVBUF 是如何与现代 Linux 内核的 TCP 窗口自动调优(Autotuning)产生冲突的,以及为什么在绝大多数后端场景下,手动设置该选项都是负优化。
一、数学层面的物理窒息:带宽时延积(BDP)
在计算机网络中,有一条支配网络吞吐上限的铁律:带宽时延积(Bandwidth-Delay Product, BDP)。
$$\\text{BDP} = \\text{Bandwidth} \\times \\text{RTT}$$
BDP 衡量的是在任何给定时刻,已经“在光纤网络管道中正在飞行”的数据总量上限。为了让这条专线跑满 10Gbps 的物理带宽,发送端在未收到 ACK 确认之前,能够在网络中持续注入的数据量必须至少填满整个管道:
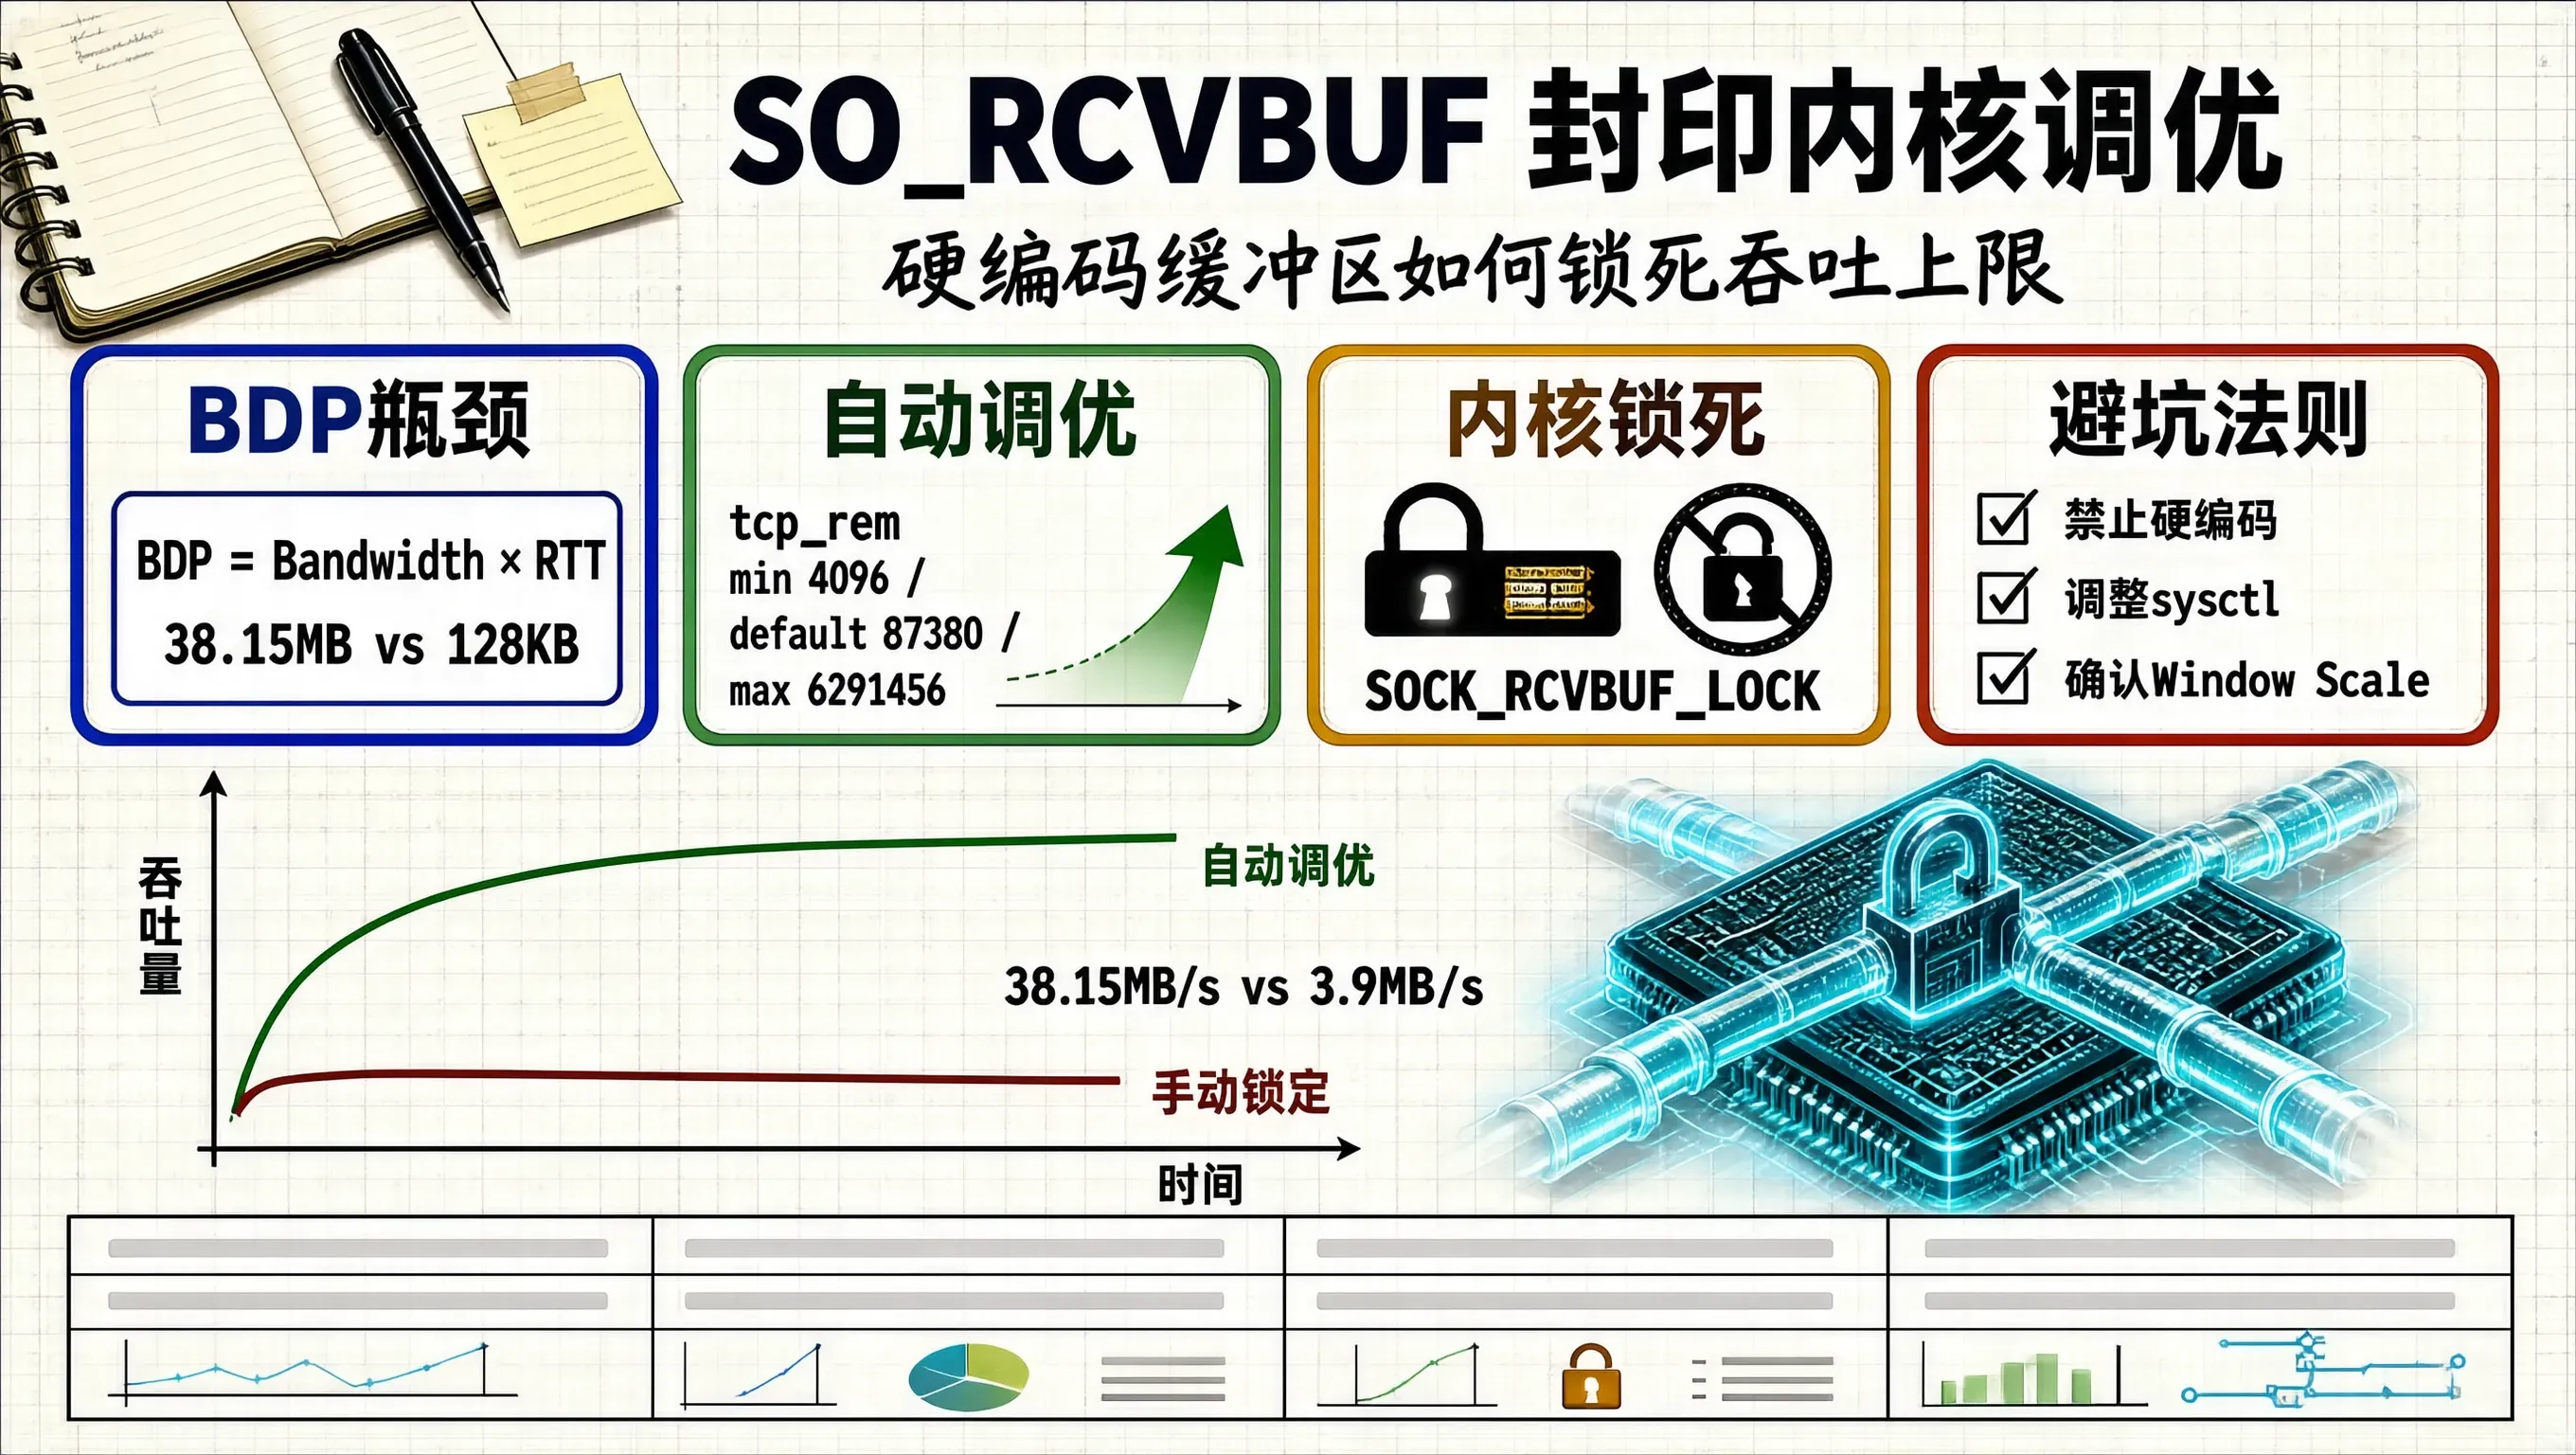
$$\\text{BDP} = \\frac{10 \\times 10^9 \\text{ bit/s}}{8 \\text{ bit/Byte}} \\times 0.032 \\text{ s} = 1.25 \\times 10^9 \\text{ Byte/s} \\times 0.032 \\text{ s} = 40 \\times 10^6 \\text{ Byte} \\approx 38.15 \\text{ MB}$$
这意味着:接收端的 TCP 通告窗口(Advertised Window)必须至少达到 38.15 MB,发送方才能不被滑动窗口阻塞,源源不断地以 10Gbps 极速发包。
现在回过头来看那行代码:工程师通过 SO_RCVBUF 将接收缓冲区写死为 128KB(0.125MB)。在 32ms 的延迟下,TCP 窗口跑完 128KB 之后就必须停下来等待对端的 ACK 回包。此时该连接理论上的最大物理吞吐极限被强行锁死为:
$$\\text{Max Throughput} = \\frac{128 \\text{ KB}}{0.032 \\text{ s}} = 4000 \\text{ KB/s} \\approx 3.9 \\text{ MB/s} \\text{(单流)}$$
即便建立多条并发流,整个跨机房链路的吞吐量也会暴跌一个数量级。
二、Linux 的救赎:TCP 窗口自动调优机制(Autotuning)
早在 Linux 2.4/2.6 时代,内核就已经意识到了静态配置缓冲区的弊端,并引入了完善的 TCP 接收窗口自动调优机制(TCP Receive Window Autotuning)。
在 /etc/sysctl.conf 中,有三个定义接收缓冲区的核心参数:
# 查看系统的 TCP 接收缓冲区三元组配置 (单位: 字节)
$ sysctl net.ipv4.tcp_rmem
net.ipv4.tcp_rmem = 4096 87380 6291456
# min default max
- min(4096 字节):即使系统处于极度内存压力下,内核为每个 Socket 分配的最小接收缓冲区;
- default(87380 字节):TCP 连接三次握手建立之初分配的默认接收缓冲区大小;
- max(6291456 字节,约 6MB,现代高带宽服务器通常调至 16MB 或 32MB):内核允许自动扩容的最大缓冲区天花板。
当自动调优开启时(内核参数 net.ipv4.tcp_moderate_rcvbuf = 1,默认为 1),内核函数 tcp_rcv_space_adjust() 会在每次有数据到达并被用户进程 read() 拷贝走时自动触发。内核会持续监控应用程序的读取速率与当前链路的 RTT,一旦发现应用层消费得极快而发送端频频被窗口压制,内核会自动动态扩容该 Socket 的 sk_rcvbuf,最高可一路平滑放大到 max 设定的上限。
因此,如果代码什么都不做,内核本可以随着流量的增加,优雅地将接收窗口自动撑大到足以匹配 BDP 的水准。
三、SO_RCVBUF 的“封印诅咒”:内核锁死标志位
为什么一旦调用了 setsockopt(fd, SOL_SOCKET, SO_RCVBUF, …),自动调优就会暴毙?
翻开 Linux 内核网络子系统源码 net/core/sock.c:
// Linux 内核 sock.c 中处理 setsockopt SO_RCVBUF 的核心逻辑片段
case SO_RCVBUF:
val = min_t(u32, val, sysctl_rmem_max);
set_rcvbuf:
sk->sk_userlocks |= SOCK_RCVBUF_LOCK; // 致命的标志位置位!
/*
* 内核为了容纳 sk_buff 结构体等开销,
* 实际分配的物理内存大小为传入参数值的两倍 (val * 2)
*/
val = max_t(u32, val * 2, SOCK_MIN_RCVBUF);
WRITE_ONCE(sk->sk_rcvbuf, val);
break;
看清楚这一行:sk->sk_userlocks |= SOCK_RCVBUF_LOCK;!
只要应用层显式调用了 SO_RCVBUF,内核就会在当前 Socket 的 sk_userlocks 字段中打上 SOCK_RCVBUF_LOCK 标记。这个标记的语义是:“用户进程明确声明放弃内核自动调优,强制由应用接管缓冲区大小”。
在后续数据传输触发 tcp_rcv_space_adjust() 时,内核会首先检查该标志:
// net/ipv4/tcp_input.c
void tcp_rcv_space_adjust(struct sock *sk) {
// 若已被应用层锁死,直接中断退出,不再执行任何动态扩容
if (sk->sk_userlocks & SOCK_RCVBUF_LOCK)
return;
…
}
自动调优机制被彻底关闭。无论你的链路物理带宽有多富余,RTT 有多长,该 Socket 的接收缓冲区永远被焊死在当时传入的固定数值上。
此外,内核在为 Socket 分配物理内存时,传入 val 会被默认翻倍(val * 2),这是为了给 sk_buff 协议头、分片控制结构留出物理内存余量。但即使物理内存翻倍,真正用于向对端计算通告窗口的有效载荷空间依然极小,吞吐受限的宿命无法逆转。
四、排查实战:用 ss 命令透视内核实时窗口
遇到类似的网络吞吐瓶颈时,不要盲目去抓包,使用 Linux 的 ss 命令配合 -tmi 参数可以直接透视内核中的连接运行状态:
$ ss -tmi 'sport = :8080'
ESTAB 0 0 10.0.1.20:8080 10.0.2.35:45892
skmem:(r0,rb262144,t0,tb262144,f0,w0,o0,bl0)
ts sack cubic wscale:7,7 rto:200 rtt:32.4/0.2
ato:40 mss:1460 rcvspace:131072 ssthresh:10 …
重点观察输出字段:
- rb262144:内核实际为该 Socket 分配的接收缓冲区物理大小为 256KB(正是代码中传入 128KB 后的两倍);
- rcvspace:131072:当前可用的接收空间被钉死在 128KB;
- 无论网络传输持续多久、吞吐有多高,rcvspace 纹丝不动,完全没有发生 tcp_rcv_space_adjust 带来的动态递增。这就是典型的“被应用层加锁封印”特征。
五、后端工程师的网络避坑法则
这次事故后,我们组将网络配置的最佳实践写进了内部代码规范手册:
深入计算机底座的奥秘,往往能让我们看清:很多自以为是的“底层优化”,在现代操作系统精巧的自动化反馈控制系统面前,常常沦为画蛇添足的桎梏。