目录
一、数据下载
二、技术栈选择
三、程序逻辑
Step1:文档预处理
Step2:知识库构建
Step3:问答查询
概念区分:
今天我们要基于DeepSeek和Faiss搭建一个本地知识库检索。我们前面也做过一个基于 LangChain 的多文件RAG应用 。可以看看区别。
一、数据下载
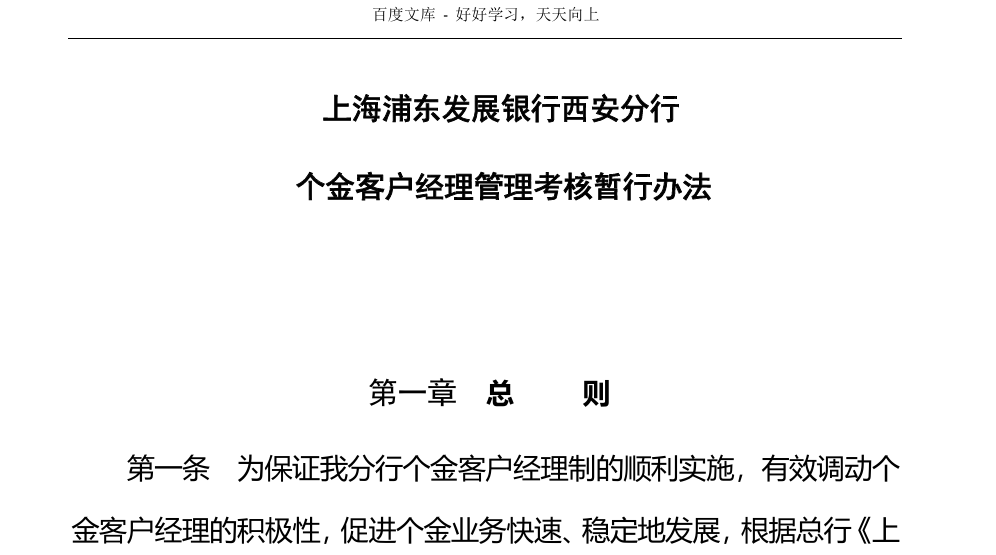
从百度文库里面下载这样一个PDF(或者其他的内容也行)。使用向量相似度搜索从PDF文档中检索相关内容(检索Retrieval), 将检索到的文档片段作为上下文(增强Augmentation) ,基于上下文和用户问题生成答案(生成Generation)。
二、技术栈选择
• 向量数据库:Faiss作为高效的向量检索
• 嵌入模型:阿里云DashScope的text-embedding-v1
• 大语言模型:deepseek-v4
• 文档处理:PyPDF2用于PDF文本提取(复杂的PDF解析可以用MinerU PDF解析工具-MinerU)
三、程序逻辑
Step1:文档预处理
1) PDF文本提取
from PyPDF2 import PdfReader
…..
PDF_PATH = os.path.join(os.path.dirname(os.path.abspath(__file__)), '浦发上海浦东发展银行西安分行个金客户经理考核办法.pdf')
# 读取PDF文件
pdf_reader = PdfReader(PDF_PATH)
# 返回内容
# text: 提取的文本内容
# char_page_mapping: 每个字符对应的页码列表
text, char_page_mapping = extract_text_with_page_numbers(pdf_reader)
2)提取文本和页码信息
def extract_text_with_page_numbers(pdf) -> Tuple[str, List[Tuple[str, int]]]:
text = ""
char_page_mapping = []
for page_number, page in enumerate(pdf.pages, start=1):
extracted_text = page.extract_text()
if extracted_text:
text += extracted_text
# 为当前页面的每个字符记录页码
char_page_mapping.extend([page_number] * len(extracted_text))
else:
print(f"No text found on page {page_number}.")
return text, char_page_mapping
Step2:知识库构建
1) 文本分割并创建知识库knowledgeBase
# 创建文本分割器,用于将长文本分割成小块
text_splitter = RecursiveCharacterTextSplitter(
separators=["\\n\\n", "\\n", ".", " ", ""],
chunk_size=1000, #1000个token
chunk_overlap=200,
length_function=len,
)
# 分割文本
chunks = text_splitter.split_text(text)
print(f"文本被分割成 {len(chunks)} 个块。")
# 创建嵌入模型
embeddings = DashScopeEmbeddings(
model="text-embedding-v1",
dashscope_api_key=DASHSCOPE_API_KEY,
)
# 从文本块创建知识库
knowledgeBase = FAISS.from_texts(chunks, embeddings)
print("已从文本块创建知识库。")
RecursiveCharacterTextSplitter 是 LangChain 提供的文本切分工具,切分过程本身不会消耗 Token。
- chunk_size:代表单个文本块允许的最大 Token 数量。
- separators:配置切分的分隔符。 该工具不会粗暴地把单词、句子从中间截断;达到最大长度限制时,会向前寻找分隔符完成切割。因此切分出来的文本块实际大小不一定恰好等于 chunk_size,只是保证不超过该上限。
chunk_size 需要根据业务问题的颗粒度来调整: 如果业务问题偏向细节查询,chunk_size 就要设置得更小;如果设置得过大,文本向量化压缩的时候容易丢失大量细节信息。
chunk_overlap 代表文本块之间的重叠 Token 数量。 例如设置 chunk_overlap=200,就是前一个 chunk 的末尾 200 个 Token,会和下一个 chunk 的开头 200 个 Token 内容完全重复。它的核心作用是制造内容冗余: 防止完整的语义、关键句子刚好被切割在两个 chunk 的边界上,避免因为切分,把一整段完整语义拆开到两个不同文本块,导致检索的时候丢失上下文信息。
大模型也可以通过提示词的方式做文本切分的,但是成本会比较高(消耗token)。
3)页码映射处理
遍历切分的chunks,基于字符位置计算每个chunks的页码 ,如果chunks跨页了,使用众数统计确定文本块的主要来源页码,建立文本块与页码的映射关系。然后保存向量库
page_info = {}
current_pos = 0
for chunk in chunks:
chunk_start = current_pos
chunk_end = current_pos + len(chunk)
# 找到这个文本块中字符对应的页码
chunk_pages = char_page_mapping[chunk_start:chunk_end]
# 取页码的众数(出现最多的页码)作为该块的页码
if chunk_pages:
# 统计每个页码出现的次数
page_counts = {}
for page in chunk_pages:
page_counts[page] = page_counts.get(page, 0) + 1
# 找到出现次数最多的页码
most_common_page = max(page_counts, key=page_counts.get)
page_info[chunk] = most_common_page
else:
page_info[chunk] = 1 # 默认页码
current_pos = chunk_end
knowledgeBase.page_info = page_info
print(f'页码映射完成,共 {len(page_info)} 个文本块')
# 如果提供了保存路径,则保存向量数据库和页码信息
if save_path:
# 确保目录存在
os.makedirs(save_path, exist_ok=True)
# 保存FAISS向量数据库
knowledgeBase.save_local(save_path)
print(f"向量数据库已保存到: {save_path}")
# 保存页码信息到同一目录
with open(os.path.join(save_path, "page_info.pkl"), "wb") as f:
pickle.dump(page_info, f)
print(f"页码信息已保存到: {os.path.join(save_path, 'page_info.pkl')}")
保存下来的文件如下:
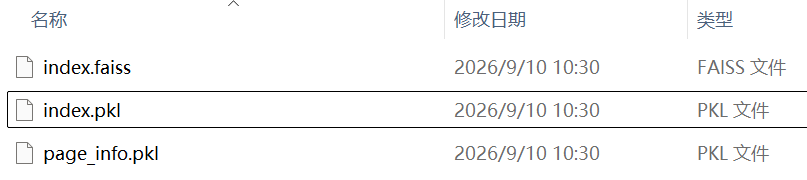
• Faiss索引文件(.faiss) • 元数据信息(.pkl) • 页码映射关系(page_info.pkl)
Step3:问答查询
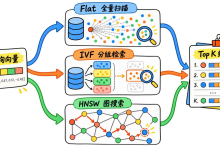
相似度检索,在Faiss中搜索最相似的文档块,similarity_search返回Top-K相关文档,构建提示词prompt,调用LLM(llm.invoke(prompt))获得结果
from langchain_community.llms import Tongyi
llm = Tongyi(model_name="deepseek-v4", dashscope_api_key=DASHSCOPE_API_KEY) # qwen-turbo
# 设置查询问题
query = "客户经理被投诉了,投诉一次扣多少分"
#query = "客户经理每年评聘申报时间是怎样的?"
if query:
# 执行相似度搜索,找到与查询相关的文档
docs = knowledgeBase.similarity_search(query,k=10)
# 构建上下文
context = "\\n\\n".join([doc.page_content for doc in docs])
# 构建提示
prompt = f"""根据以下上下文回答问题:
{context}
问题: {query}"""
# 直接调用 LLM
response = llm.invoke(prompt)
print(response)
print("来源:")
输出结果:

以上代码可以替换为下面的代码:
# 替换前
docs = knowledgeBase.similarity_search(query, k=10)
context = "\\n\\n".join([doc.page_content for doc in docs]) # 手动拼
prompt = f"""根据以下上下文回答问题:\\n\\n{context}\\n\\n问题: {query}""" # 手动拼 prompt
response = llm.invoke(prompt) # 手动调
#———————————————————————-
# 替换后
from langchain_classic.chains.question_answering import load_qa_chain
docs = knowledgeBase.similarity_search(query, k=10)
qa_chain = load_qa_chain(llm, chain_type="stuff")
response = qa_chain.invoke({"input_documents": docs, "question": query})["output_text"]
chain_type有如下四种(一般默认第一种就好了):
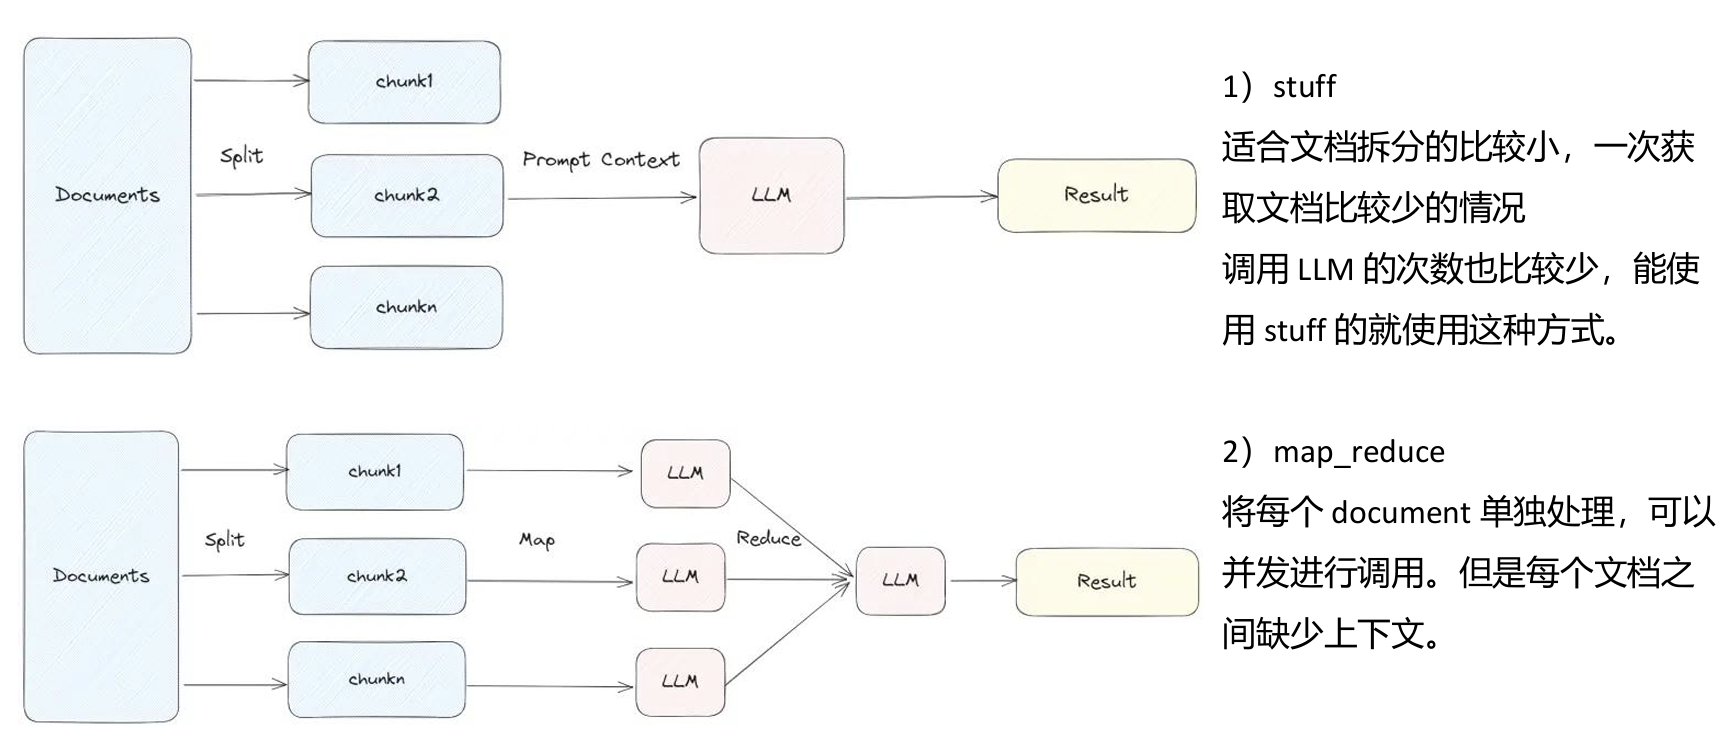
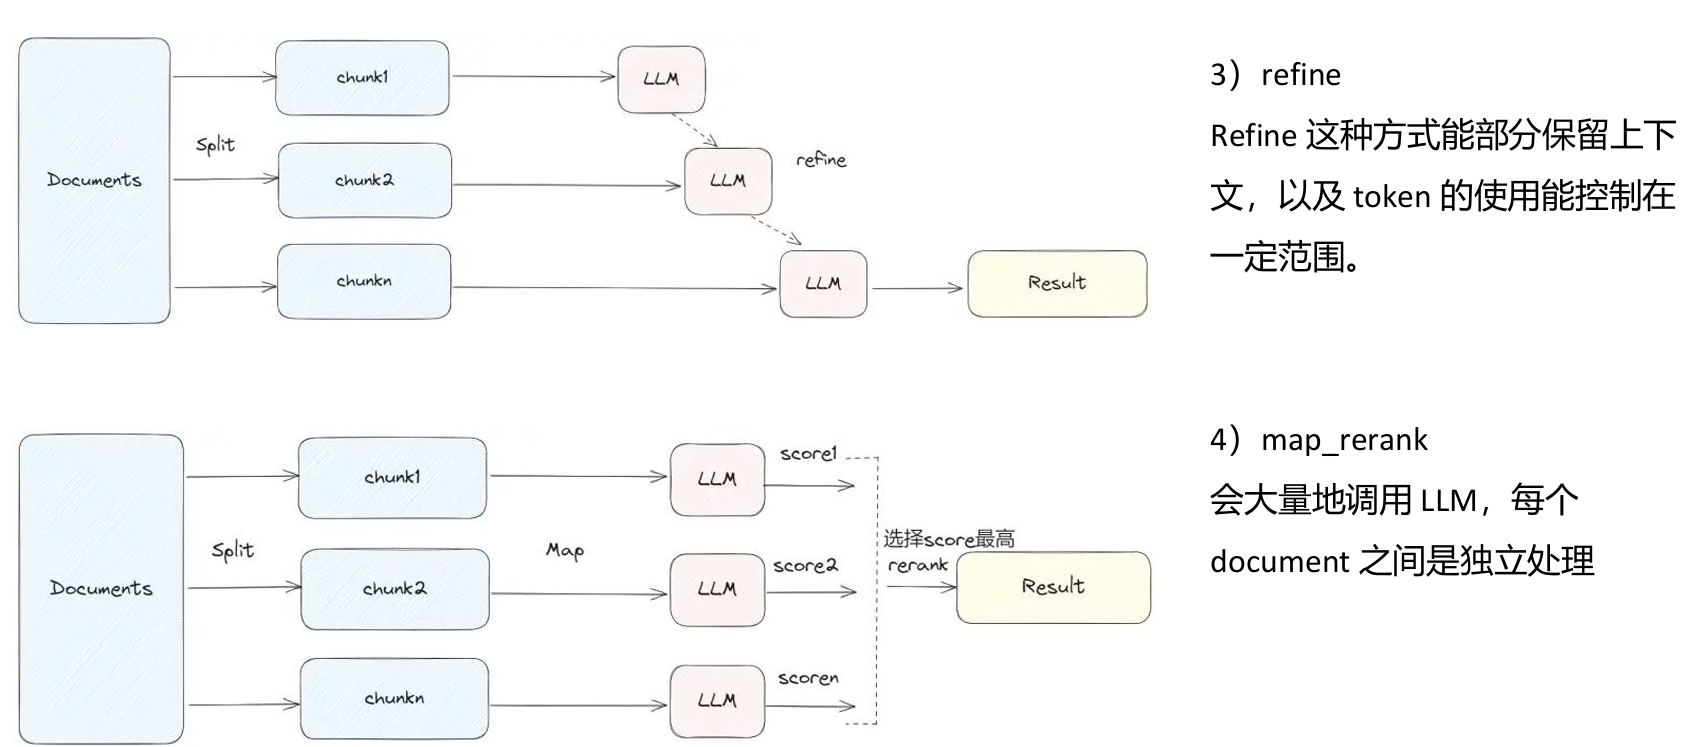
本篇内容和基于 LangChain 的多文件RAG应用 逻辑一致,代码略有不同。大家可以对比看一下
概念区分:
Jieba:句子里面加空格(分词),word2vec训练Embedding时用:Embedding和Word2Vec
Chunk:知识的最小颗粒度,用Embedding模型转成向量后放入向量数据库中FAISS.from_texts(chunks, embeddings)
Embedding模型和向量数据库介绍: Embedding模型和向量数据库的选择
Tokenizer:LLM如何理解文字的,文字和token的map映射
Q:如果LLM可以处理无限上下文了,RAG还有意义吗?
效率与成本:LLM处理长上下文时计算资源消耗大,响应时间增加。RAG通过检索相关片段,减少输入长度。
知识更新:LLM的知识截止于训练数据,无法实时更新。RAG可以连接外部知识库,增强时效性。
可解释性:RAG的检索过程透明,用户可查看来源,增强信任。LLM的生成过程则较难追溯。
定制化:RAG可针对特定领域定制检索系统,提供更精准的结果,而LLM的通用性可能无法满足特定需求。
数据隐私:RAG允许在本地或私有数据源上检索,避免敏感数据上传云端,适合隐私要求高的场景。
=> 结合LLM的生成能力和RAG的检索能力,可以提升整体性能,提供更全面、准确的回答。