摘要:闭包是内部函数引用外部函数变量并被返回后,仍能“记住”外层作用域的现象。其三要素为函数嵌套、引用外部变量、外部函数返回内部函数,本质是作用域链的保留。闭包可保存状态、延迟执行,常用 nonlocal 修改外层变量,但需注意循环变量陷阱和内存泄漏。典型应用是函数工厂。
装饰器本质是接收函数并返回新函数的可调用对象,通常基于闭包实现,能在不修改原函数的情况下增强功能。基本语法为 @decorator,进阶包括 functools.wraps、多装饰器叠加、带参数装饰器和类装饰器。装饰器适合日志、权限、缓存等场景,优点是复用与解耦,缺点是调试难、可能影响性能。
目录
三、闭包与装饰器
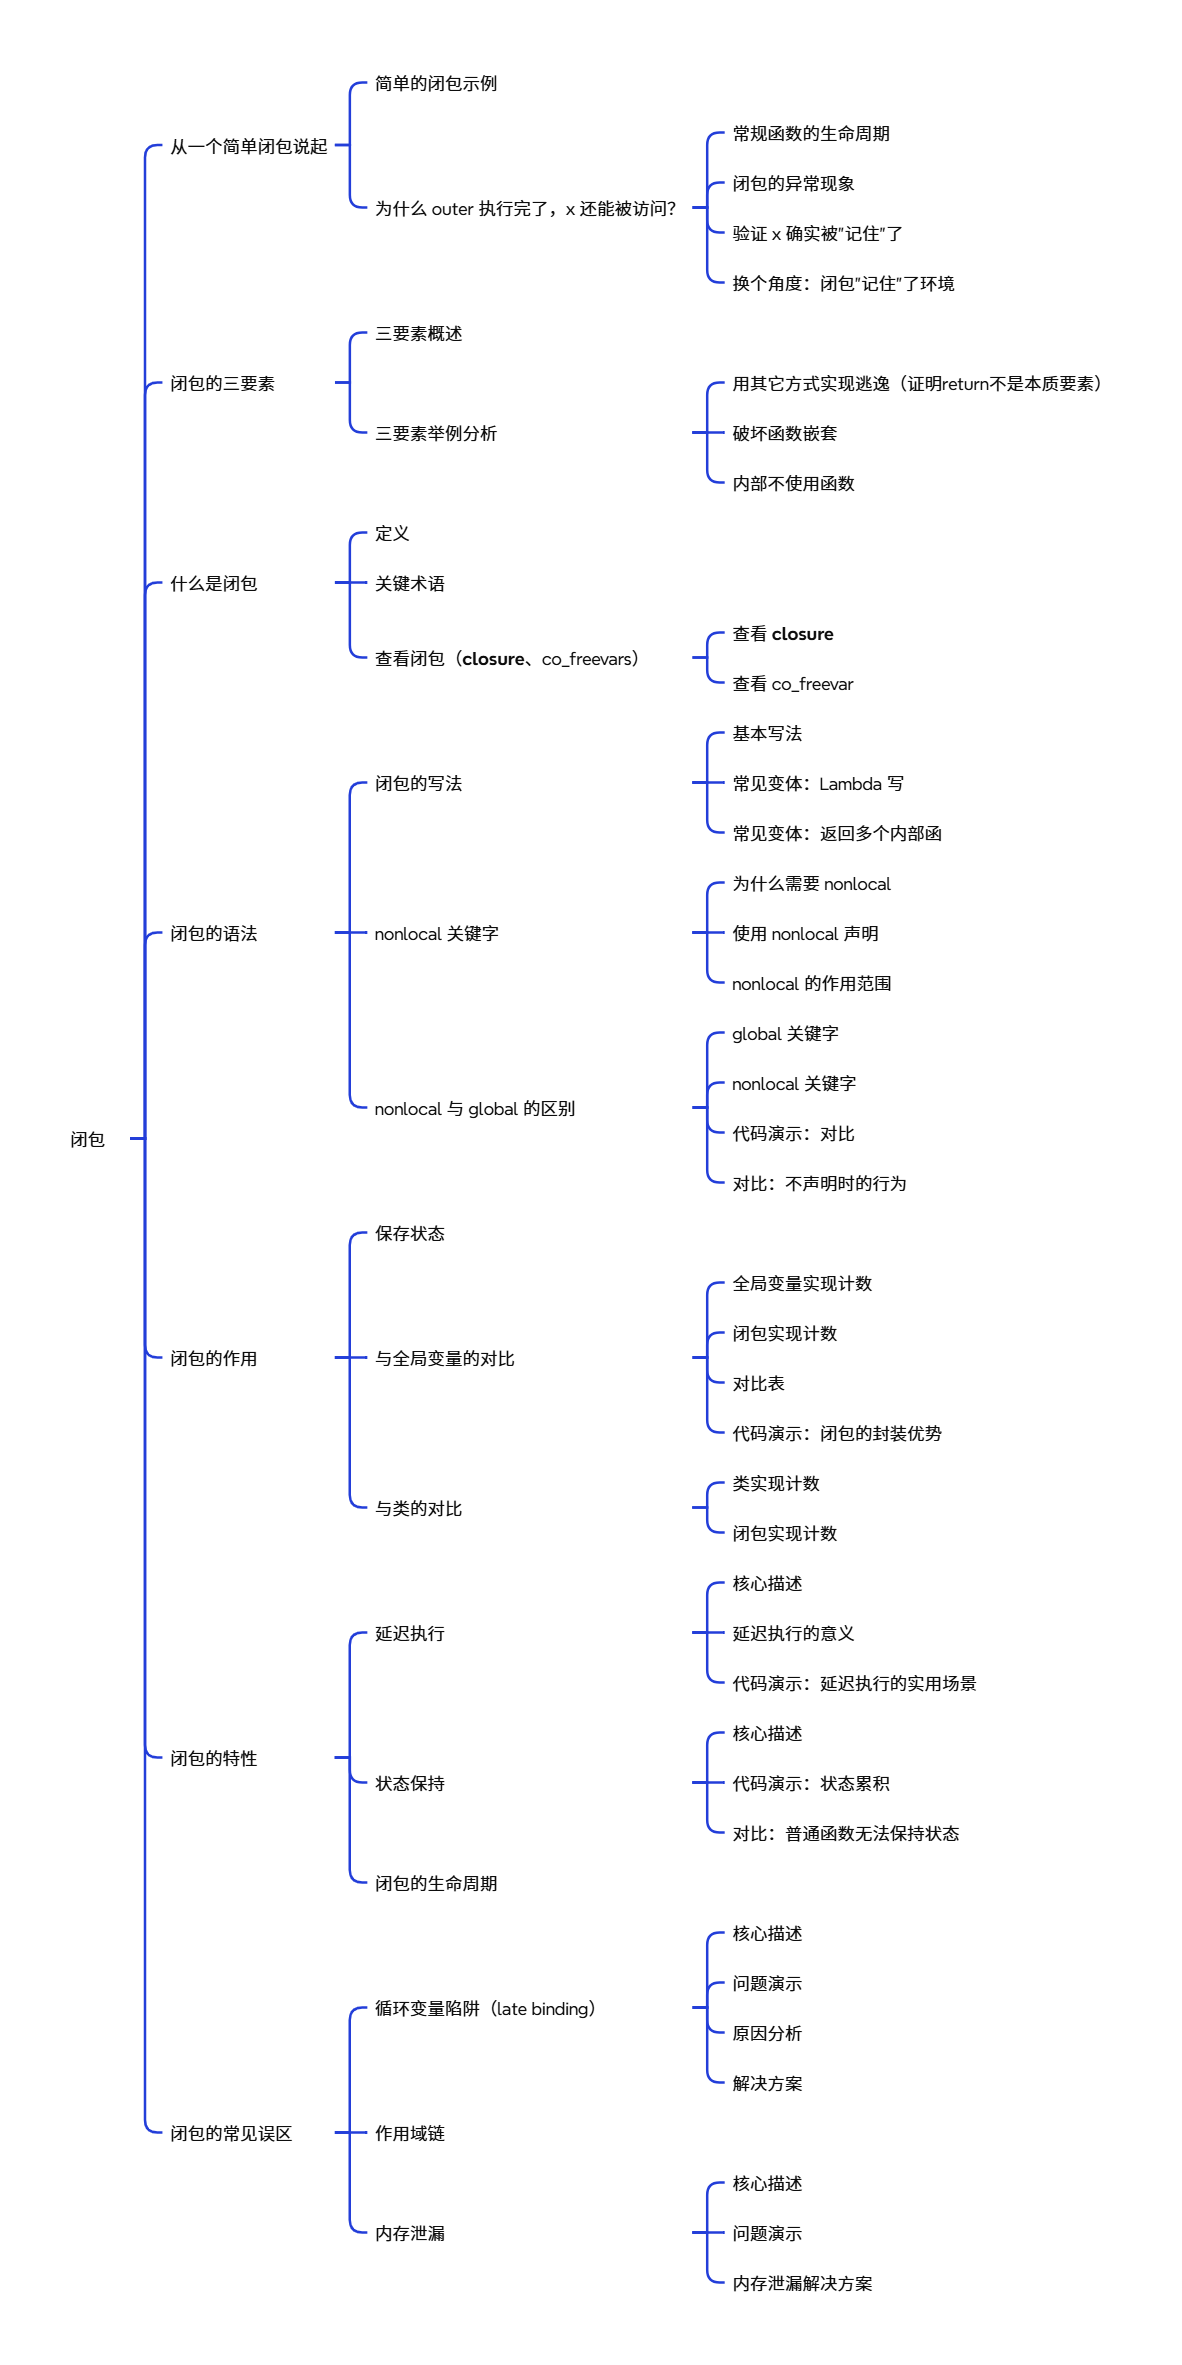
3.1 闭包
3.1.1 从一个简单闭包说起
3.1.1.1 简单的闭包示例
3.1.1.2 为什么 outer 执行完了,x 还能被访问?
3.1.2 闭包的三要素
3.1.2.1 三要素概述
3.1.2.2 三要素举例分析
3.1.3 什么是闭包
3.1.3.1 定义
3.1.3.2 关键术语
3.1.3.3 查看闭包(__closure__、co_freevars)
3.1.4 闭包的语法
3.1.4.1 闭包的写法
3.1.4.2 nonlocal 关键字
3.1.4.3 nonlocal 与 global 的区别
3.1.5 闭包的作用
3.1.5.1 保存状态
3.1.5.2 与全局变量的对比
3.1.5.3 与类的对比
3.1.6 闭包的特性
3.1.6.1 延迟执行
3.1.6.2 状态保持
3.1.6.3 闭包的生命周期
3.1.7 闭包的常见误区
3.1.7.1 循环变量陷阱(late binding)
3.1.7.2 作用域链
3.1.7.3 内存泄漏
3.1.8 闭包的应用场景
3.1.8.1 函数工厂
3.2 装饰器
3.2.1 装饰器入门
3.2.1.1 装饰器的本质
3.2.1.2 与闭包的关系
3.2.1.4 基本语法
3.2.2 装饰器进阶
3.2.2.1 functools.wraps 保留原函数元信息
3.2.2.2 多个装饰器叠加
3.2.2.3 装饰器执行顺序
3.2.2.4 带参数装饰器
3.2.2.5 类装饰器
3.2.3 特点
3.2.3.1 优点
3.2.3.2 缺点
3.2.3.3 优缺点总结
三、闭包与装饰器
3.1 闭包
3.1.1 从一个简单闭包说起
3.1.1.1 简单的闭包示例
# 简单闭包演示
def outer(x):
"""外层函数:接收参数 x"""
def inner(y):
"""内层函数:引用外层的 x"""
return x + y
return inner # 返回内层函数(注意:不加括号)
# 调用 outer,得到 inner 函数
closure = outer(10)
# 调用 closure,实际上是在调用 inner
result = closure(5)
print(result)
代码说明:
| def outer(x): | 定义外层函数,接收参数 x |
| def inner(y): | 定义内层函数,接收参数 y |
| return x + y | 内层函数引用外层的 x,这是关键 |
| return inner | 外层函数返回内层函数本身(不是调用结果) |
| closure = outer(10) | 调用 outer(10),得到 inner 函数 |
| closure(5) | 调用 inner(5),返回 10 + 5 |
看起来很简单,但这里隐藏了一个关键问题:
-
outer(10) 执行时,x = 10
-
outer 执行完毕后,按常规理解,x 应该被销毁
-
但 closure(5) 调用时,inner 仍然能访问 x = 10
-
为什么?
3.1.1.2 为什么 outer 执行完了,x 还能被访问?
① 常规函数的生命周期
# 常规函数:局部变量随函数结束而销毁
def normal_func():
x = 10
return x
result = normal_func()
print(result) # 10
# print(x) # NameError: name 'x' is not defined
# x 是 normal_func 的局部变量,函数结束后 x 被销毁
说明:
-
常规函数的局部变量在函数执行完毕后被销毁
-
外部无法访问这些变量
② 闭包的异常现象
# 闭包:外层函数结束后,内层函数仍能访问外层变量
def outer(x):
def inner(y):
return x + y
return inner
closure = outer(10)
# outer 已经执行完毕,但…
print(closure(5)) # 15
# 为什么 x 没有被销毁?
# 为什么 inner 还能访问 x?
问题分解:
| 问题1 | outer 执行完毕后,x 为什么没有被销毁? |
| 问题2 | inner 为什么还能访问 x? |
| 问题3 | x 存储在哪里? |
③ 验证 x 确实被"记住"了
# 验证 x 被闭包"记住"了
def outer(x):
def inner(y):
return x + y
return inner
closure = outer(10)
# 再次调用 closure,x 仍然是 10
print(closure(5)) # 15
print(closure(100)) # 110
# 即使 outer 早已执行完毕,x 依然存在
# 说明 x 被 inner "捕获"了
结论: x 并没有随 outer 的结束而销毁,而是被 inner 捕获并保留下来。
④ 换个角度:闭包"记住"了环境
# 闭包"记住"了定义时的环境
def make_adder(x):
def adder(y):
return x + y
return adder
add_10 = make_adder(10)
add_100 = make_adder(100)
print(add_10(5)) # 15(记住 x=10)
print(add_100(5)) # 105(记住 x=100)
# 两个闭包各自记住了自己的 x
# 互不影响
说明:
-
add_10 记住了 x = 10
-
add_100 记住了 x = 100
-
每个闭包有自己独立的"环境"
3.1.2 闭包的三要素
3.1.2.1 三要素概述
闭包的形成需要同时满足以下三个要素:
| ① 可调用对象 | 存在一个可调用对象(函数、Lambda 等) |
| ② 引用自由变量 | 该对象引用了定义环境中的自由变量(捕获了状态) |
| ③ 在定义环境之外被调用 | 该对象在定义环境之外被调用(逃逸) |
注:当满足上述条件时,闭包就形成了。其必然结果是:即使定义环境(如外层函数)执行完毕销毁,被捕获的自由变量依然存活,可供调用。
在上述例子中inner函数就是一个可调用对象满足要素①,inner中引用外层的x满足条件②,哦utter中返回inner使得inner逃逸到外部满足条件③
注意:函数嵌套+返回内部函数只是通常的闭包写法,并非闭包的本质要素,以下举例说明
3.1.2.2 三要素举例分析
① 用其它方式实现逃逸(证明return不是本质要素):
方式一:用全局变量接收内部函数,破坏"返回内部函数"
# 反例一:用全局变量接收内部函数
inner_func = None # 全局变量
def outer(x):
global inner_func
def inner(y):
return x + y
inner_func = inner # 赋值给全局变量,而非 return
outer(10) # 调用 outer,inner 逃逸到全局变量
# 在定义环境之外调用
print(inner_func(5)) # 15
# 查看闭包
print(inner_func.__code__.co_freevars) # ('x',)
print(inner_func.__closure__[0].cell_contents) # 10
说明:
-
没有 return inner,而是赋值给全局变量
-
inner 依然逃逸到定义环境之外
-
依然是闭包
方式二:将内部函数存入容器
# 反例二:将内部函数存入容器
funcs = [] # 容器
def outer(x):
def inner(y):
return x + y
funcs.append(inner) # 存入列表,而非 return
outer(10) # 调用 outer,inner 存入列表
# 在定义环境之外调用
print(funcs[0](5)) # 15
# 查看闭包
print(funcs[0].__code__.co_freevars) # ('x',)
print(funcs[0].__closure__[0].cell_contents) # 10
说明:
-
没有 return inner,而是存入列表
-
inner 依然逃逸到定义环境之外
-
依然是闭包
方式三:通过属性赋值逃逸
# 反例三:通过属性赋值逃逸
class Container:
pass
container = Container() # 容器对象
def outer(x):
def inner(y):
return x + y
container.func = inner # 赋值给对象属性
outer(10)
# 在定义环境之外调用
print(container.func(5)) # 15
# 查看闭包
print(container.func.__code__.co_freevars) # ('x',)
print(container.func.__closure__[0].cell_contents) # 10
说明:
-
没有 return inner,而是赋值给对象属性
-
inner 依然逃逸到定义环境之外
-
依然是闭包
② 破坏函数嵌套
由于python中的作用域只有模块、类、函数,要想演示不在函数嵌套的条件下实现闭包相对困难,所以接下来我用其它语言的闭包作为演示
JavaScript:块级作用域闭包
// 外部环境只是一个块 {},不是函数
let closure;
{
let secret = "块级作用域的私有数据"; // 自由变量
// 定义一个可调用对象(函数),捕获了块中的 secret
closure = function() {
console.log(secret);
};
} // 代码块执行结束,按理说 secret 应该被销毁
// 在块外部调用闭包,依然可以访问 secret
closure(); // 输出:块级作用域的私有数据
为什么这不是函数嵌套? 这里的 closure 函数是在一个普通的代码块 {} 中定义的,而不是在另一个函数内部。外层 {} 只是一个作用域隔离区域,不是函数。这说明闭包的“外部”可以是一个块。
C++:Lambda 表达式 + 按值/按引用捕获
#include <iostream>
#include <functional>
int main() {
std::function<void()> closure;
// 外部环境只是一个块 {},不是函数
{
int secret = 42;
// 按值捕获 secret
closure = [secret]() {
std::cout << "secret = " << secret << std::endl;
};
} // 块结束,原本的 secret 销毁
// 调用闭包
closure(); // 输出:secret = 42
return 0;
}
关键点: C++ 的 Lambda 本质上是一个匿名类的实例(Functor)。编译器为 Lambda 生成了一个类,捕获的变量成为该类的成员变量。这个 Lambda 对象可以在任何地方定义,不要求嵌套函数。块级作用域中的变量被按值复制到 Lambda 对象中,从而实现了生命周期的延长。
③ 内部不使用函数
关于内部的可调用对象,在绝大多数编程语言中,可调用对象大部分“基于函数”或“表现为函数”,但在类型系统和运行时表示上,它们可以是独立的数据结构。但为了避免混淆,下面举几个特例说明。
C++:[init] 捕获列表
C++ 标准明确规定:Lambda 表达式的运行时效果就是构造一个闭包对象(closure object)。这个闭包对象是一个匿名类的实例,不是函数。
#include <iostream>
int main() {
int init = 10;
// Lambda 表达式:编译器生成一个匿名类
// [init] 是捕获列表,init 被捕获为匿名类的成员变量
auto closure = [init]() mutable {
return ++init;
};
// closure 是一个闭包对象(匿名类的实例),不是函数
std::cout << closure() << std::endl; // 11
std::cout << closure() << std::endl; // 12
std::cout << closure() << std::endl; // 13
// 验证:closure 是一个对象,不是函数
// C++ 中没有直接查看闭包类型的语法,但可以通过 typeid 观察
std::cout << typeid(closure).name() << std::endl;
// 输出类似:Z4mainEUlvE_(编译器生成的匿名类名)
return 0;
}
关键点:
-
[init] 是捕获列表,明确告诉编译器把 init 捕获到 Lambda 内部。
-
编译器自动生成一个匿名类,init 成为该类的成员变量。
-
closure 是这个匿名类的实例,不是函数。
-
init 是 main 的局部变量,closure 逃逸到外部后,init 的生命周期被延长。
-
捕获是编译器自动完成的,不是手动传值。
Python:用 __call__ 实例实现闭包
Python 中,任何实现了 __call__ 方法的实例都可以像函数一样被调用。我们可以用它来构建闭包。
def make_counter(init):
count = init # 自由变量
# 闭包函数:捕获 count
def increment():
nonlocal count
count += 1
return count
# 用一个对象包装闭包函数
class Wrapper:
def __init__(self, func):
self.func = func
def __call__(self):
return self.func()
return Wrapper(increment) # 返回对象,不是函数
c = make_counter(10)
print(type(c)) # <class '__main__.make_counter.<locals>.Wrapper'>
print(c()) # 11
print(c()) # 12
print(c()) # 13
关键点:
-
increment 是闭包:它捕获了 count,有 __closure__。
-
Wrapper 实例 c 不是闭包:单独看Wrapper类,call并非闭包,因为是返回类的属性,并非外部变量,但通过外部嵌套函数并创建对象,使call捕获外部的环境,就形成了闭包。
-
c 是一个可调用对象,它的状态来自 increment 闭包捕获的 count。
3.1.3 什么是闭包
3.1.3.1 定义
闭包(Closure)是一个可调用对象(函数、Lambda 表达式、方法等)与其定义时所处的词法环境(Lexical Environment)组合而成的实体。
当这个可调用对象在其定义环境(如外部函数执行完毕、代码块结束)生命周期结束之后,依然能够访问并操作该环境中被捕获的自由变量(Free Variables)时,就形成了闭包。
简单来说:闭包 = 可调用对象(行为) + 捕获的环境(状态)
3.1.3.2 关键术语
| 可调用对象 | 函数、Lambda、方法等 |
| 词法环境 | 定义该对象时所处的代码作用域,包含其中的变量、函数等绑定。 |
| 自由变量 | 不是自己定义的,也不是全局变量,而是外层作用域的变量 |
| 捕获 | 调用对象在创建时,将其引用的自由变量绑定到自身环境的过程。 |
3.1.3.3 查看闭包(__closure__、co_freevars)
查看 __closure__
# 查看 __closure__
def outer(x, y):
def inner():
return x + y
return inner
closure = outer(10, 20)
# __closure__ 存储捕获的变量
print(closure.__closure__)
# (<cell at 0x…: int object at 0x…>, <cell at 0x…: int object at 0x…>)
# 取出捕获的值
print(closure.__closure__[0].cell_contents) # 10
print(closure.__closure__[1].cell_contents) # 20
# 没有捕获变量时,__closure__ 为 None
def no_closure():
def inner():
return 42
return inner
print(no_closure().__closure__) # None
__closure__ 属性:
| 有捕获变量 | 元组,每个元素是一个 cell |
| 无捕获变量 | None |
查看 co_freevars
# 查看 co_freevars
def outer(x, y):
def inner():
return x + y
return inner
closure = outer(10, 20)
# co_freevars 列出自由变量名
print(closure.__code__.co_freevars) # ('x', 'y')
# 对比:没有自由变量时
def no_free():
def inner():
return 42
return inner
print(no_free().__code__.co_freevars) # ()
co_freevars 属性:
| 有自由变量 | 元组,如 ('x', 'y') |
| 无自由变量 | 空元组 () |
3.1.4 闭包的语法
3.1.4.1 闭包的写法
关于闭包的写法,相信读者在了解闭包的本质和要素后已经能自行写出,下面只进行常用写法的总结
① 基本写法
闭包的常用基本写法可以分为三步:
def 外层函数(参数):
"""外层函数:定义自由变量"""
自由变量 = 值
def 内层函数(参数):
"""内层函数:引用自由变量"""
return 使用自由变量的表达式
return 内层函数 # 返回内层函数(不加括号)
三层结构:
| 第一步 | 外层函数嵌套内部函数 |
| 第二步 | 内层函数,引用外部函数的自由变量 |
| 第三步 | 外部函数返回内层函数,形成闭包 |
代码演示
def outer(x):
"""外层函数:定义自由变量 x"""
def inner(y):
"""内层函数:引用自由变量 x"""
return x + y
return inner # 返回内层函数
# 创建闭包
closure = outer(10)
# 调用闭包
print(closure(5)) # 15
说明:
-
outer 是外层函数,x 是自由变量
-
inner 是内层函数,引用了 x
-
return inner 返回内层函数,形成闭包
-
closure 就是闭包,可以像普通函数一样调用
② 常见变体:Lambda 写法
# 闭包的 Lambda 写法
def outer(x):
return lambda y: x + y # Lambda 作为内层函数
closure = outer(10)
print(closure(5)) # 15
说明:
-
Lambda 是匿名函数,可以作为内层函数
-
语法更简洁,但可读性略低
-
适合简单逻辑
③ 常见变体:返回多个内部函数
# 闭包的封装优势
def make_counter():
count = 0
def increment():
nonlocal count
count += 1
return count
def decrement():
nonlocal count
count -= 1
return count
def get_count():
return count
def reset():
nonlocal count
count = 0
return "已重置"
return increment,decrement, get_count, reset
inc, dnc,get, reset = make_counter()
print(inc()) # 1
print(inc()) # 2
print(get()) # 2
print(dnc()) # 1
print(get()) # 1
print(reset()) # 已重置
print(get()) # 0
说明:
-
闭包对外暴露接口,外部通过接口访问,这正是闭包封装特性的体现
3.1.4.2 nonlocal 关键字
① 为什么需要 nonlocal
在闭包中,内层函数可以读取自由变量,但如果要修改自由变量,必须用 nonlocal 声明。
# 不声明 nonlocal:无法修改自由变量
def outer():
count = 0
def inner():
count += 1 # 报错:局部变量 count 未定义
return count
return inner
# counter = outer()
# counter() # UnboundLocalError: local variable 'count' referenced before assignment
问题: Python 默认把 count += 1 中的 count 当作内层函数的局部变量,但 count 未在内层定义,所以报错。
② 使用 nonlocal 声明
# 使用 nonlocal:可以修改自由变量
def outer():
count = 0
def inner():
nonlocal count # 声明 count 是自由变量
count += 1
return count
return inner
counter = outer()
print(counter()) # 1
print(counter()) # 2
print(counter()) # 3
说明:
-
nonlocal count 声明 count 是自由变量
-
声明后,内层函数可以修改 count
-
修改会反映到闭包捕获的变量中
③ nonlocal 的作用范围
# nonlocal 的作用范围:逐层向上查找
# x = 10
def outer():
x = 10
def middle():
def inner():
nonlocal x # 向上找到 outer 中的 x
x += 1
return x
return inner
return middle()
closure = outer()
print(closure()) # 11
print(closure()) # 12
说明:
-
nonlocal 会逐层向上查找,找到最近的同名变量,注意:nonlocal并不会搜索全局变量,如果最外层函数没有找到会抛出SyntaxError
-
找到后,修改的是该变量的值
3.1.4.3 nonlocal 与 global 的区别
① global 关键字
global 用于声明变量为全局变量,允许在函数内修改全局变量。
# global 关键字
count = 0 # 全局变量
def increment():
global count # 声明 count 是全局变量
count += 1
return count
print(increment()) # 1
print(increment()) # 2
print(count) # 2(全局变量被修改)
② nonlocal 关键字
nonlocal 用于声明变量为自由变量(外层函数的局部变量),允许在闭包内修改。
# nonlocal 关键字
def outer():
count = 0 # 外层函数的局部变量(对 inner 是自由变量)
def inner():
nonlocal count # 声明 count 是自由变量
count += 1
return count
return inner
counter = outer()
print(counter()) # 1
print(counter()) # 2
③ 代码演示:对比
# 对比:global vs nonlocal
count = 0 # 全局变量
def outer():
count = 100 # 外层函数的局部变量
def inner_global():
global count # 声明全局变量
count += 1
return f"global count: {count}"
def inner_nonlocal():
nonlocal count # 声明自由变量
count += 1
return f"nonlocal count: {count}"
return inner_global, inner_nonlocal
g, n = outer()
print(g()) # global count: 1(修改全局变量)
print(g()) # global count: 2
print(n()) # nonlocal count: 101(修改外层变量)
print(n()) # nonlocal count: 102
print(f"全局 count:{count}") # 全局 count:2
说明:
-
inner_global 修改的是全局变量 count
-
inner_nonlocal 修改的是外层函数的 count
-
两者互不影响
④ 对比:不声明时的行为
# 不声明时的行为
count = 0
def outer():
count = 100
def inner_read():
return count # 读取:默认使用外层变量
def inner_write():
count = 200 # 写入:创建新的局部变量,不影响外层
return count
return inner_read, inner_write
r, w = outer()
print(f"读取:{r()}") # 读取:100(外层变量)
print(f"写入后:{w()}") # 写入后:200(新局部变量)
print(f"再次读取:{r()}") # 再次读取:100(外层变量未变)
⑤ 对比表
| 作用对象 | 全局变量 | 外层函数的局部变量(自由变量) |
| 作用范围 | 模块级 | 外层函数 |
| 查找规则 | 模块全局作用域 | 逐层向上查找外层函数 |
| 找不到时 | 创建全局变量 | 报 SyntaxError |
| 使用场景 | 修改全局变量 | 修改闭包中的自由变量 |
3.1.5 闭包的作用
3.1.5.1 保存状态
① 核心描述
闭包最核心的作用是保存状态。闭包可以"记住"定义时的自由变量,即使外层函数已经执行完毕,这些变量依然存活,并在多次调用之间保持累积或变化。
闭包 = 行为 + 状态,其中"状态"就是被捕获的自由变量。
② 代码演示:计数器
# 闭包保存状态:计数器
def make_counter():
count = 0 # 状态:被捕获的自由变量
def increment(): # 行为:可调用对象
nonlocal count
count += 1
return count
return increment
counter = make_counter()
# 每次调用,状态累积
print(counter()) # 1
print(counter()) # 2
print(counter()) # 3
print(counter()) # 4
# 查看捕获的状态
print(f"当前 count = {counter.__closure__[0].cell_contents}") # 4
说明:
-
count 是自由变量,被闭包捕获
-
每次调用 counter(),count 累加
-
count 的状态在多次调用之间保持
3.1.5.2 与全局变量的对比
① 全局变量实现计数
# 全局变量实现计数
count = 0
def increment_global():
global count
count += 1
return count
print(increment_global()) # 1
print(increment_global()) # 2
print(increment_global()) # 3
# 问题:count 是全局变量,任何地方都能修改
全局变量的问题:
| 封装性差 | 任何地方都能访问和修改 |
| 命名冲突 | 全局变量容易与其他变量冲突 |
| 无法独立 | 只能有一个全局 count,无法创建多个独立计数器 |
| 污染全局 | 全局变量多了,代码难以维护 |
② 闭包实现计数
# 闭包实现计数
def make_counter():
count = 0 # 封装在闭包中
def increment():
nonlocal count
count += 1
return count
return increment
c1 = make_counter()
c2 = make_counter()
print(c1()) # 1
print(c1()) # 2
print(c2()) # 1(独立)
print(c2()) # 2
# count 被封装在闭包中,外部无法直接访问
③ 对比表
| 封装性 | 任何地方可修改 | 仅闭包内部可访问 |
| 独立性 | 全局唯一 | 每次调用独立 |
| 命名冲突 | 易冲突 | 局部作用域 |
| 生命周期 | 程序结束才销毁 | 闭包被引用时存活 |
| 可维护性 | 差 | 好 |
| 多实例 | 无法创建 | 可创建多个独立实例 |
④ 代码演示:闭包的封装优势
# 闭包的封装优势
def make_counter():
count = 0
def increment():
nonlocal count
count += 1
return count
def get_count():
return count
def reset():
nonlocal count
count = 0
return "已重置"
return increment, get_count, reset
inc, get, reset = make_counter()
print(inc()) # 1
print(inc()) # 2
print(get()) # 2
print(reset()) # 已重置
print(get()) # 0
# count 只能通过闭包提供的接口访问
# 外部无法直接修改 count
说明:
-
闭包可以暴露多个方法,操作同一个状态
-
外部只能通过接口访问,无法直接修改
-
这是封装思想的体现
3.1.5.3 与类的对比
① 类实现计数
# 类实现计数
class Counter:
def __init__(self):
self.count = 0
def increment(self):
self.count += 1
return self.count
def get_count(self):
return self.count
def reset(self):
self.count = 0
return "已重置"
c = Counter()
print(c.increment()) # 1
print(c.increment()) # 2
print(c.get_count()) # 2
print(c.reset()) # 已重置
print(c.get_count()) # 0
② 闭包实现计数
与上述代码3.1.4.2 与全局变量的对比最后闭包的封装演示代码一致,在此不做赘述
③ 对比表
| 代码量 | 较多 | 较少 |
| 状态数量 | 可多个属性 | 通常少量 |
| 可读性 | 清晰 | 简洁但需理解闭包 |
| 扩展性 | 易扩展(继承、多态) | 扩展需改闭包结构 |
| 封装性 | 好(私有属性) | 好(局部变量) |
| 多实例 | 可创建多个 | 可创建多个 |
| 状态独立性 | 独立 | 独立 |
| 性能 | 略低(对象创建) | 略高(无对象) |
| 适用场景 | 复杂状态、多方法 | 简单状态、单一行为 |
④ 选择建议
| 简单状态、少量方法 | 闭包 |
| 复杂状态、多个方法 | 类 |
| 需要继承、多态 | 类 |
| 需要轻量、无对象开销 | 闭包 |
| 需要清晰的结构 | 类 |
| 需要快速实现 | 闭包 |
3.1.6 闭包的特性
3.1.6.1 延迟执行
① 核心描述
闭包的延迟执行是指:外层函数执行时,内层函数只是被定义,并未立即执行;只有在内层函数被调用时,函数体才真正执行。
定义与执行分离,是闭包的重要特性。
代码演示:定义与执行分离
# 延迟执行:定义时不解算,调用时才执行
def outer(x):
print(f"① 外层函数执行,x = {x}")
def inner(y):
print(f"③ 内层函数执行,y = {y}")
return x + y
print("② 内层函数已定义,但未执行")
return inner
print("=== 创建闭包 ===")
closure = outer(10)
# 输出:
# ① 外层函数执行,x = 10
# ② 内层函数已定义,但未执行
print("\\n=== 调用闭包 ===")
result = closure(5)
# 输出:
# ③ 内层函数执行,y = 5
print(f"结果:{result}") # 结果:15
说明:
-
调用 outer(10) 时,只执行外层函数,内层函数只是被定义
-
调用 closure(5) 时,内层函数才真正执行
-
定义与执行分离,这就是延迟执行
② 延迟执行的意义
| 按需执行 | 只在需要时才执行,避免不必要的计算 |
| 延迟绑定 | 外层参数在调用时才生效 |
| 灵活组合 | 可以先创建闭包,稍后再调用 |
| 性能优化 | 避免提前计算,节省资源 |
③ 代码演示:延迟执行的实用场景
# 延迟执行:先创建闭包,稍后调用
def make_logger(prefix):
def log(message):
return f"[{prefix}] {message}"
return log
# 先创建不同前缀的日志函数
info_log = make_logger("INFO")
error_log = make_logger("ERROR")
# 此时内层函数还没执行
# 稍后按需调用
print(info_log("系统启动")) # [INFO] 系统启动
print(error_log("连接失败")) # [ERROR] 连接失败
print(info_log("用户登录")) # [INFO] 用户登录
说明:
-
make_logger 只创建闭包,不执行
-
真正使用时才调用 info_log、error_log
-
这是工厂模式的体现
3.1.6.2 状态保持
① 核心描述
闭包的状态保持是指:闭包捕获的自由变量会在多次调用之间持续存活,并保持上一次调用后的值。
闭包 = 行为 + 状态,状态就是被捕获的自由变量。
② 代码演示:状态累积
# 状态保持:多次调用之间状态累积
def make_counter():
count = 0
def increment():
nonlocal count
count += 1
return count
return increment
counter = make_counter()
print(counter()) # 1
print(counter()) # 2
print(counter()) # 3
print(counter()) # 4
# count 在多次调用之间保持
print(f"当前 count = {counter.__closure__[0].cell_contents}") # 4
说明:
-
count 被闭包捕获
-
每次调用 counter(),count 累加
-
count 的状态在多次调用之间保持
③ 对比:普通函数无法保持状态
# 普通函数:无法保持状态
def increment():
count = 0
count += 1
return count
print(increment()) # 1
print(increment()) # 1(每次都是 1)
print(increment()) # 1
# 局部变量每次调用都重新创建,无法保持状态
对比表:
| 状态保持 | 无 | 有 |
| 多次调用 | 每次独立 | 状态累积 |
| 局部变量 | 每次重新创建 | 捕获后存活 |
3.1.6.3 闭包的生命周期
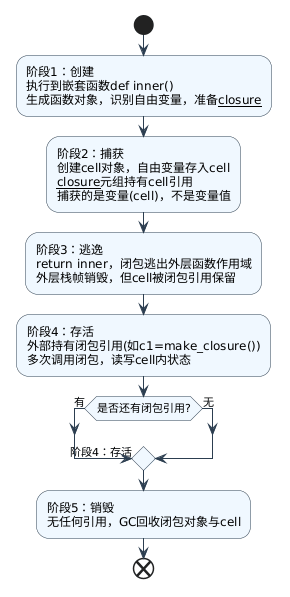
在有垃圾回收机制的语言中,闭包的生命周期持续到最后一个引用消失,即外部没有任何变量指向引用或指向闭包时闭包会被回收
单引用示例:
import weakref
def make_counter():
count = 0
def increment():
nonlocal count
count += 1
return count
return increment
c1 = make_counter()
# 弱引用闭包函数
weak_ref = weakref.ref(c1)
print("闭包是否存活:", weak_ref() is not None) # True
# 保存 cell 的引用,用于观察
cell = c1.__closure__[0]
print("cell 中的值:", cell.cell_contents) # 0
c1 = None
print("闭包是否存活:", weak_ref() is not None) # False
# 尝试访问 cell
try:
print("cell 中的值:", cell.cell_contents)
print("cell 仍然存活")
except Exception as e:
print("cell 已被销毁,错误:", e)
多引用与闭包计数器演示
import weakref
import gc
def make_closure():
data = [1, 2, 3]
def inner():
return sum(data)
return inner
def count_closure_vars(closure):
"""精确统计有多少个变量指向闭包"""
referrers = gc.get_referrers(closure)
count = 0
names = []
for ref in referrers:
if isinstance(ref, dict):
for name, value in ref.items():
if value is closure:
count += 1
names.append(name)
return count, names
c1 = make_closure()
c2 = c1
weak_ref = weakref.ref(c1)
print("=" * 50)
print("初始状态:c1 和 c2 都指向闭包")
print("=" * 50)
print(f"闭包是否存活: {weak_ref() is not None}")
count, names = count_closure_vars(weak_ref())
print(f"变量引用数: {count}, 变量名: {names}")
print("\\n" + "=" * 50)
print("c1 = None 后")
print("=" * 50)
c1 = None
print(f"闭包是否存活: {weak_ref() is not None}")
# 注意:这里不要用 count_closure_vars,因为它会持有引用
count, names = count_closure_vars(weak_ref())
print(f"变量引用数: {count}, 变量名: {names}")
# 用 gc.get_referrers 会干扰,所以这里不统计
print("\\n" + "=" * 50)
print("c2 = None 后")
print("=" * 50)
c2 = None
# 闭包引用全部消失,weak_ref() 为None,在做统计会有错误的输出
count, names = count_closure_vars(weak_ref())
print(f"变量引用数: {count}, 变量名: {names}")
# 关键:不要调用 weak_ref() 并打印返回值
# 只用 is None 判断
if weak_ref() is None:
print("闭包已销毁")
else:
print("闭包仍存活(不应该发生)")
说明:
-
闭包的存活由引用计数决定
-
只要还有任何一个外部变量可达闭包,闭包就存活
-
当所有外部引用都不再指向闭包时,闭包自动销毁
3.1.7 闭包的常见误区
3.1.7.1 循环变量陷阱(late binding)
① 核心描述
循环变量陷阱是指:在循环中创建闭包时,闭包捕获的是变量本身,而不是变量在每次迭代时的值。由于闭包是延迟执行的,当闭包被调用时,循环已经结束,变量的值已是最后一次迭代的值。
这就是所谓的 late binding(延迟绑定)。
② 问题演示
# 循环变量陷阱
funcs = []
for i in range(3):
def f():
return i
funcs.append(f)
# 调用所有闭包
for func in funcs:
print(func())
问题:
-
预期输出:0 1 2
-
实际输出:2 2 2
-
所有闭包都返回 2,因为调用时 i 已经是最后一次迭代的值
③ 原因分析
# 原因:闭包捕获的是变量 i,而非值
funcs = []
for i in range(3):
def f():
return i # 引用自由变量 i
funcs.append(f)
# 循环结束时,i = 2
# 所有闭包都引用同一个 i
# 调用时 i 已经是 2
for func in funcs:
print(func.__closure__[0].cell_contents) # 2 2 2
说明:
-
闭包捕获的是变量 i,而非 i 的值
-
循环结束后,i = 2
-
所有闭包引用同一个 i,所以都返回 2
④ 解决方案
解决方案一:默认参数绑定值
# 方案一:默认参数绑定值
funcs = []
for i in range(3):
def f(i=i): # 默认参数在定义时求值
return i
funcs.append(f)
for func in funcs:
print(func()) # 0 1 2
说明:
-
默认参数 i=i 在函数定义时求值
-
每次迭代,i 的当前值被绑定到默认参数
-
调用时使用默认参数的值
解决方案二:工厂函数
# 方案二:工厂函数
def make_func(i): # 参数 i = 0(这是 make_func 的局部变量)
def f():
return i # f 捕获的是 make_func 的局部变量 i
return f
funcs = [make_func(i) for i in range(3)]
for func in funcs:
print(func()) # 0 1 2
关键点:
-
make_func 的参数 i 是一个新的局部变量,它的值是 0。
-
f 捕获的是 make_func 的局部变量 i,而不是外层 for 循环的 i。
-
每次调用 make_func,都会创建一个新的作用域,其中有独立的 i。
解决方案三:functools.partial
# 方案三:functools.partial
from functools import partial
def f(i):
return i
funcs = [partial(f, i) for i in range(3)]
for func in funcs:
print(func()) # 0 1 2
说明:
- partial 的核心思想是:把一个函数的某些参数固定下来,生成一个新的函数。
-
每次迭代绑定不同的 i
partial说明
from functools import partial
def add(a, b):
return a + b
# 固定 a=10,生成新函数
add_10 = partial(add, 10)
print(add_10(5)) # 15(相当于 add(10, 5))
print(add_10(20)) # 30(相当于 add(10, 20))
回顾上述示例,partial在创建时已经使f记住了对应i的值
选择建议
| 简单循环绑定,追求简洁 | 默认参数 | 一行搞定,性能最好 |
| 需要修改捕获变量 | 工厂函数 | 支持 nonlocal,逻辑清晰 |
| 函数式编程,配合 map/filter | functools.partial | 语义明确,专为此设计 |
| 多层嵌套闭包 | 工厂函数 | 最灵活,最易理解 |
| 需要固定多个参数 | functools.partial | 支持位置和关键字参数 |
3.1.7.2 作用域链
作用域链是指:闭包在访问变量时,会沿着定义时的作用域链逐层向上查找。
Python 的作用域规则是 LEGB,在函数章节已做描述,在此不在赘述
3.1.7.3 内存泄漏
① 核心描述
内存泄漏是指:闭包捕获的变量在闭包存活期间无法被垃圾回收,即使这些变量已经不再需要。如果闭包长期存活,捕获的大对象会一直占用内存。
② 问题演示
# 验证内存占用
import sys
def make_closure():
data = [i for i in range(1000000)]
def inner():
return len(data)
return inner
closure = make_closure()
# 查看捕获对象
captured = closure.__closure__[0].cell_contents
print(f"捕获对象类型:{type(captured)}")
print(f"捕获对象大小:{sys.getsizeof(captured) / 1024 / 1024:.2f} MB")
问题:
-
data 是大列表,占用大量内存
-
闭包只用到 len(data),但捕获了整个 data
-
闭包存活期间,data 无法回收
③ 内存泄漏解决方案
内存泄漏的问题可以从几个方面优化:
关于优化捕获和释放闭包较为简单,在此不做演示,下面只演示弱引用
使用弱引用
# 方案四:使用弱引用
import weakref
def make_closure():
class Data:
pass
data = Data()
def inner():
return data
return inner, data
closure, data_ref = make_closure()
# 创建弱引用
weak_ref = weakref.ref(data_ref)
print(f"闭包存在时:{weak_ref() is not None}") # True
# 释放闭包
closure = None
data_ref = None
print(f"闭包销毁后:{weak_ref() is not None}") # False
说明:
-
弱引用不增加引用计数
-
闭包销毁后,对象可被回收
3.1.8 闭包的应用场景
3.1.8.1 函数工厂
① 核心描述
闭包可以生成不同配置的函数,根据传入参数返回定制化的函数。
② 代码演示:乘法器工厂
# 应用:乘法器工厂
def make_multiplier(factor):
def multiply(x):
return x * factor
return multiply
double = make_multiplier(2)
triple = make_multiplier(3)
print(double(5)) # 10
print(triple(5)) # 15
应用场景: 单位转换、税率计算、折扣策略。
③ 代码演示:幂函数工厂
# 应用:幂函数工厂
def power_factory(exp):
def power(base):
return base ** exp
return power
square = power_factory(2)
cube = power_factory(3)
print(square(5)) # 25
print(cube(3)) # 27
应用场景: 数学计算、公式生成、数据变换。
3.2 装饰器
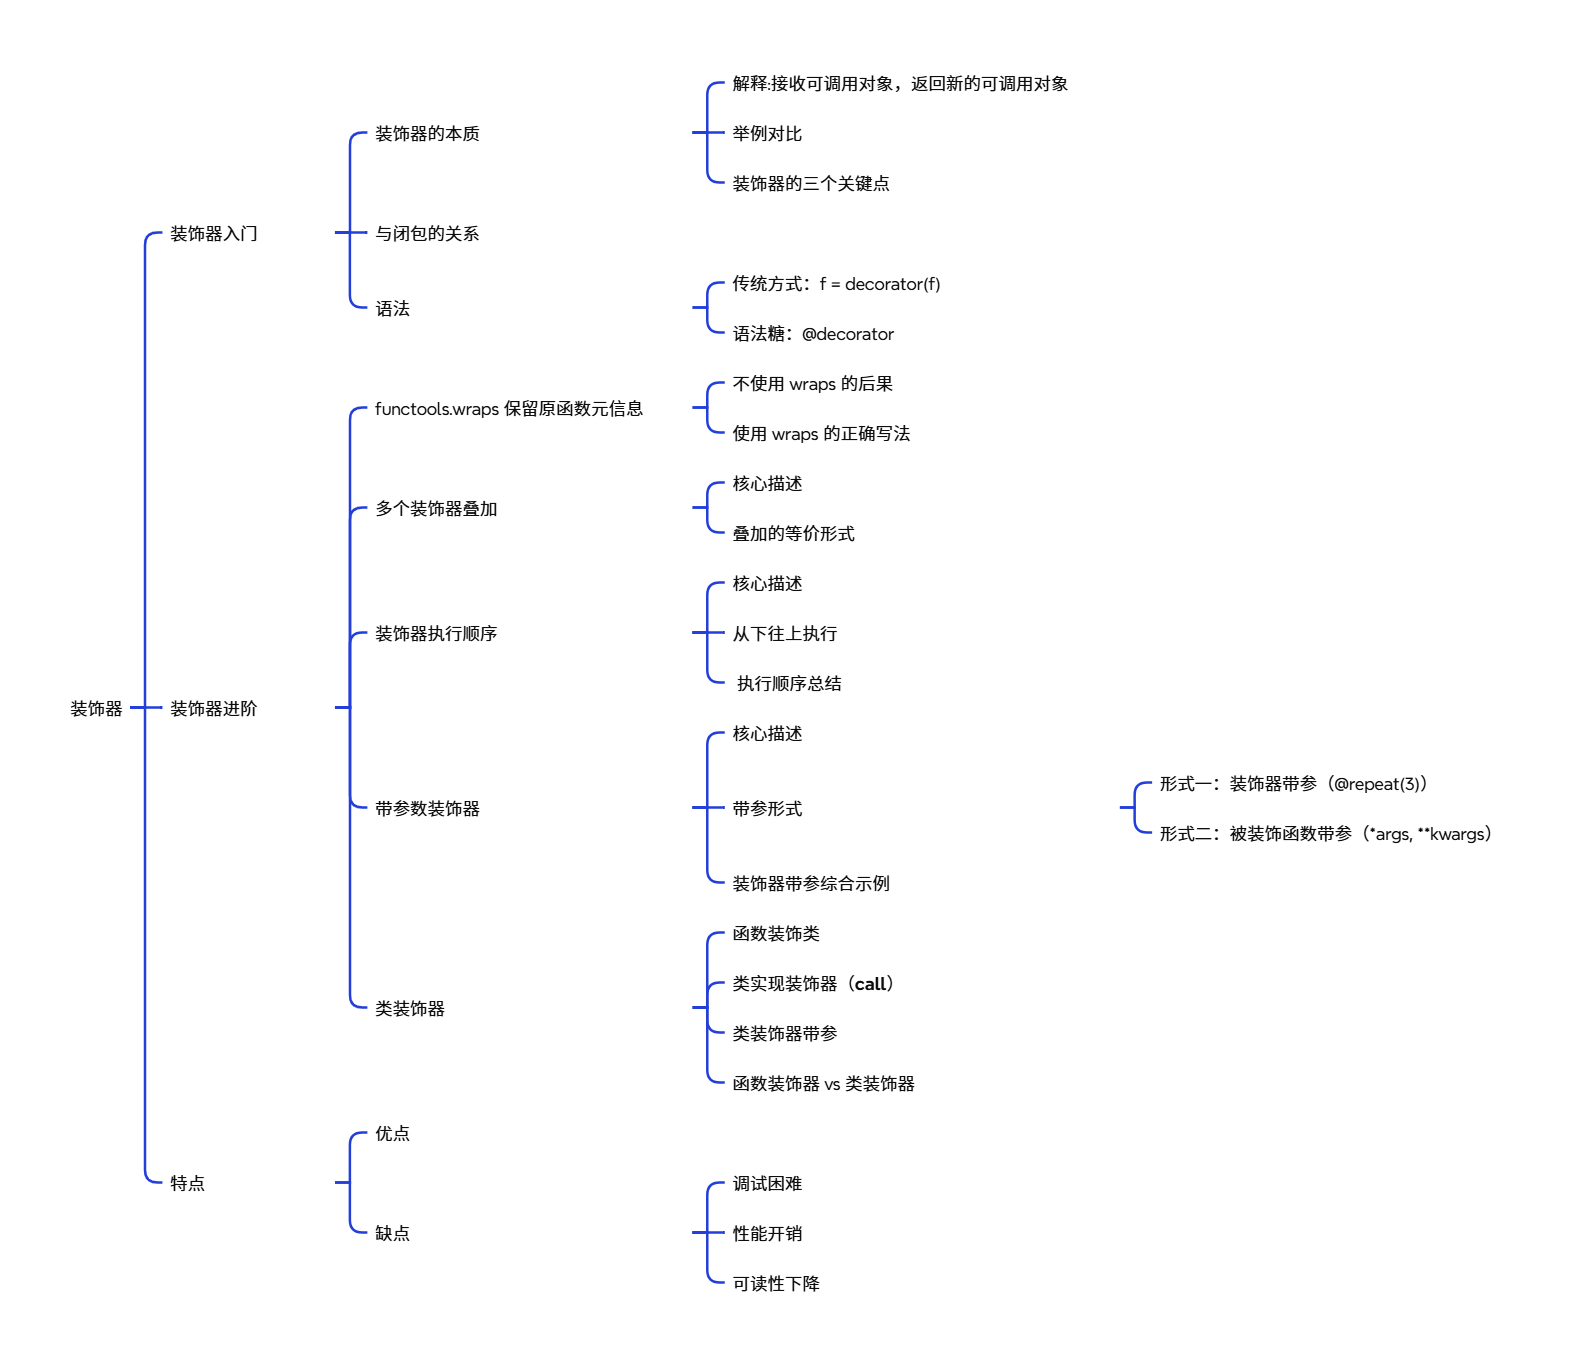
3.2.1 装饰器入门
3.2.1.1 装饰器的本质
① 解释
装饰器是一个可调用对象,它接收一个可调用对象作为参数,并返回一个新的可调用对象。返回的新可调用对象通常会在原可调用对象的基础上增加额外功能。
装饰器的本质:接收可调用对象,返回新可调用对象。
注意:装饰器的大多数实现为给函数添加功能,即接收函数对象返回新的函数对象,在后面的章节为简化实现主要使用闭包的常用方式来实现装饰器,同时装饰器也是闭包的经典应用;在本节举几个不是闭包的反例以帮助读者理解装饰器本质。
② 举例对比
非嵌套实现装饰器
def identity_decorator(func):
print("test")
return func # 直接返回原函数,没有嵌套函数
@identity_decorator
def say_hello():
print("hello")
say_hello()
用类实现装饰器
类的实例是可调用对象(实现了 __call__),但它不是闭包。
class CountCalls:
def __init__(self, func):
self.func = func # 把函数存为实例属性
self.count = 0 # 状态存在实例属性中
def __call__(self, *args, **kwargs):
self.count += 1
print(f"第 {self.count} 次调用")
return self.func(*args, **kwargs)
@CountCalls
def say_hello(name):
print(f"hello, {name}")
say_hello("Alice") # 第 1 次调用 / hello, Alice
say_hello("Bob") # 第 2 次调用 / hello, Bob
为什么不是闭包?
-
CountCalls 是一个类,不是函数。
-
say_hello 是 CountCalls 的实例,不是函数对象。
-
状态 count 存在实例属性中,不是 cell 中。
-
没有 __closure__。
这里的演示就是我们在前面3.1.2.2:③——Python:用 __call__ 实例实现闭包的注意中提到的单独看类不是闭包
③ 装饰器的三个关键点
| 接收函数 | 装饰器的参数是一个可调用对象 |
| 返回函数 | 装饰器返回一个新的可调用对象 |
| 增强功能 | 新函数在原对象基础上增加功能 |
3.2.1.2 与闭包的关系
装饰器通常用闭包实现,但闭包不等于装饰器,闭包也不仅仅只能用于装饰器。装饰器是一种设计模式,闭包是一种语言机制。
def my_decorator(func):
def wrapper():
print("调用前")
func() # func 是自由变量
print("调用后")
return wrapper # 返回闭包
def say_hello():
print("你好")
decorated = my_decorator(say_hello)
# 验证闭包
print(f"自由变量:{decorated.__code__.co_freevars}") # ('func',)
print(f"捕获的函数:{decorated.__closure__[0].cell_contents}") # say_hello 函数
# 调用
decorated()
作用
装饰器的核心作用是在不修改可调用对象代码的前提下,为对象增加额外功能。
| 增强功能 | 在函数执行前后增加逻辑 |
| 代码复用 | 多个可调用对象共享同一装饰器 |
| 关注点分离 | 业务逻辑与辅助逻辑分离 |
| 不侵入原代码 | 不修改原函数内部实现 |
3.2.1.4 基本语法
传统方式:f = decorator(f)
# 传统方式:手动调用装饰器
def my_decorator(func):
def wrapper():
print("调用前")
func()
print("调用后")
return wrapper
def say_hello():
print("你好")
# 手动装饰
say_hello = my_decorator(say_hello)
# 调用
say_hello()
说明:
-
手动将 say_hello 传给 my_decorator
-
返回值重新赋值给 say_hello
-
此时 say_hello 已经是 wrapper
语法糖:@decorator
# 语法糖:@decorator
def my_decorator(func):
def wrapper():
print("调用前")
func()
print("调用后")
return wrapper
@my_decorator # 语法糖
def say_hello():
print("你好")
# 调用
say_hello()
说明:
-
@my_decorator 等价于 say_hello = my_decorator(say_hello)
-
语法更简洁,更直观
两者等价
3.2.2 装饰器进阶
3.2.2.1 functools.wraps 保留原函数元信息
① 核心描述
装饰器返回的 wrapper 函数会替换原函数,导致原函数的元信息(__name__、__doc__、__module__ 等)丢失。functools.wraps 用于将原函数的元信息复制到 wrapper 上。
② 不使用 wraps 的后果
# 不使用 wraps:原函数元信息丢失
def my_decorator(func):
def wrapper(*args, **kwargs):
"""wrapper 的文档"""
return func(*args, **kwargs)
return wrapper
@my_decorator
def say_hello():
"""打招呼的函数"""
print("你好")
# 查看元信息
print(f"函数名:{say_hello.__name__}") # wrapper(不是 say_hello)
print(f"文档:{say_hello.__doc__}") # wrapper 的文档
print(f"模块:{say_hello.__module__}") # __main__
问题:
| __name__ | say_hello | wrapper |
| __doc__ | 打招呼的函数 | wrapper 的文档 |
| __module__ | __main__ | __main__(正确) |
影响:
-
调试时函数名错误,难以定位
-
文档工具无法获取正确文档
-
依赖元信息的框架(如 Flask 路由)可能出错
③ 使用 wraps 的正确写法
# 使用 wraps:保留原函数元信息
from functools import wraps
def my_decorator(func):
@wraps(func) # 复制 func 的元信息到 wrapper
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
return wrapper
@my_decorator
def say_hello():
"""打招呼的函数"""
print("你好")
# 查看元信息
print(f"函数名:{say_hello.__name__}") # say_hello
print(f"文档:{say_hello.__doc__}") # 打招呼的函数
print(f"模块:{say_hello.__module__}") # __main__
说明:
-
@wraps(func) 将 func 的元信息复制到 wrapper
-
__name__、__doc__、__module__、__dict__ 等都被保留
-
推荐在所有装饰器中使用
④ 对比表
| __name__ | wrapper | 原函数名 |
| __doc__ | wrapper 的文档 | 原函数文档 |
| __module__ | 装饰器模块 | 原函数模块 |
| 调试 | 困难 | 正常 |
| 文档工具 | 失效 | 正常 |
| 推荐度 | 不推荐 | 推荐 |
3.2.2.2 多个装饰器叠加
① 核心描述
一个函数可以同时被多个装饰器装饰。装饰器从下往上依次应用,形成嵌套结构。
② 代码演示
# 多个装饰器叠加
def decorator_a(func):
def wrapper(*args, **kwargs):
print("A 前")
result = func(*args, **kwargs)
print("A 后")
return result
return wrapper
def decorator_b(func):
def wrapper(*args, **kwargs):
print("B 前")
result = func(*args, **kwargs)
print("B 后")
return result
return wrapper
@decorator_a
@decorator_b
def my_func():
print("原函数")
my_func()
说明:
-
@decorator_a 在上,@decorator_b 在下
-
等价于 my_func = decorator_a(decorator_b(my_func))
-
先应用 decorator_b,再应用 decorator_a
③ 叠加的等价形式
将刚才代码的最后几行换为以下代码,效果相同
def my_func():
print("原函数")
my_func = decorator_a(decorator_b(my_func))
my_func()
理解: 装饰器从下往上"包裹"原函数。
④ 实际应用:多个装饰器叠加
# 实际应用:日志 + 计时
import time
from functools import wraps
def log_decorator(func):
@wraps(func)
def wrapper(*args, **kwargs):
print(f"[日志] 调用 {func.__name__}")
result = func(*args, **kwargs)
print(f"[日志] 返回 {result}")
return result
return wrapper
def timer_decorator(func):
@wraps(func)
def wrapper(*args, **kwargs):
start = time.time()
result = func(*args, **kwargs)
elapsed = time.time() – start
print(f"[计时] {func.__name__} 耗时 {elapsed:.4f} 秒")
return result
return wrapper
@log_decorator
@timer_decorator
def slow_add(a, b):
time.sleep(0.1)
return a + b
print(slow_add(1, 2))
说明:
-
@log_decorator 在外层,@timer_decorator 在内层
-
先执行日志的"前",再执行计时的"前"
-
原函数执行后,先执行计时的"后",再执行日志的"后"
3.2.2.3 装饰器执行顺序
① 核心描述
多个装饰器叠加时,装饰器的应用顺序与函数的执行顺序是相反的:
| 装饰器应用 | 从下往上 |
| 函数执行 | 从上往下(外层先执行前,内层先执行后) |
② 从下往上执行
# 装饰器从下往上应用
def decorator_a(func):
print("装饰器 A 应用")
def wrapper(*args, **kwargs):
print("A 前")
result = func(*args, **kwargs)
print("A 后")
return result
return wrapper
def decorator_b(func):
print("装饰器 B 应用")
def wrapper(*args, **kwargs):
print("B 前")
result = func(*args, **kwargs)
print("B 后")
return result
return wrapper
print("=== 定义函数 ===")
@decorator_a
@decorator_b
def my_func():
print("原函数")
print("\\n=== 调用函数 ===")
my_func()
说明:
-
装饰阶段:先应用 B(下),再应用 A(上)
-
调用阶段:先执行 A 的前,再执行 B 的前,然后原函数,最后 B 的后、A 的后
③ 执行顺序总结
| 装饰器应用 | 从下往上 | 先应用下面的装饰器 |
| 调用前逻辑 | 从上往下 | 先执行外层装饰器的"前" |
| 原函数 | 中间 | 所有"前"执行完后执行 |
| 调用后逻辑 | 从下往上 | 先执行内层装饰器的"后" |
3.2.2.4 带参数装饰器
① 核心描述
带参数装饰器有两种形式:
| 形式一:装饰器带参 | 装饰器本身接收参数 | @repeat(3) |
| 形式二:被装饰函数带参 | 被装饰的函数接收参数 | def f(a, b) |
② 带参形式
形式一:装饰器带参
结构:三层嵌套
# 形式一:装饰器带参
def repeat(times):
"""装饰器工厂:接收参数 times"""
def decorator(func):
"""真正的装饰器"""
def wrapper():
"""包装函数"""
results = []
for _ in range(times):
results.append(func())
return results
return wrapper
return decorator
@repeat(3) # 调用 repeat(3) 得到装饰器
def say_hello():
print(f"你好")
return f"Hello"
say_hello()
说明:
-
repeat(3) 返回 decorator 装饰器
-
decorator 装饰 say_hello
-
等价于 say_hello = repeat(3)(say_hello)
上述演示装饰器和装饰工厂都只携带一个参数,读者可能误以为每层只能带一个参数。接下来演示函数工厂接收多个参数
def add_affix(prefix, suffix):
"""带两个参数的装饰器工厂"""
def decorator(func):
def wrapper():
print(f"{prefix}", end=" ")
result = func()
print(f"{suffix}", end=" ")
return result
return wrapper
return decorator
@add_affix("[START]", "[END]")
def say_hello():
print(f"hello,")
say_hello()
形式二:被装饰函数带参
结构:两层嵌套 +参数列表
# 形式二:被装饰函数带参
def my_decorator(func):
def wrapper(*args, **kwargs):
print(f"调用 {func.__name__},参数:{args}, {kwargs}")
result = func(*args, **kwargs)
print(f"返回:{result}")
return result
return wrapper
@my_decorator
def add(a, b):
return a + b
@my_decorator
def greet(name, greeting="你好"):
return f"{greeting},{name}"
add(1, 2)
print()
greet("张三")
print()
greet("李四", greeting="嗨")
说明:
-
*args 接收位置参数
-
**kwargs 接收关键字参数
-
适用于任何签名的函数
两种形式对比
| 参数属于谁 | 装饰器 | 被装饰函数 |
| 嵌套层数 | 三层 | 两层 |
| 示例 | @repeat(3) | def add(a, b) |
| 写法 | def repeat(times): | def wrapper(*args, **kwargs): |
| 适用场景 | 装饰器需要配置 | 被装饰函数有参数 |
③ 装饰器带参综合示例
import functools
def arithmetic(operator):
# 运算符到函数的映射
operations = {
"+": lambda a, b: a + b,
"-": lambda a, b: a – b,
"*": lambda a, b: a * b,
"/": lambda a, b: a / b,
}
# 校验运算符
if operator not in operations:
raise ValueError(f"不支持的运算符: {operator},仅支持 {list(operations.keys())}")
def decorator(func):
@functools.wraps(func) # 保留原函数元信息
def wrapper(a, b):
print(f"[{operator}] 被装饰函数: {func.__name__}({a}, {b})")
result = operations[operator](a, b)
print(f"[{operator}] 计算结果: {result}")
return result
return wrapper
return decorator
@arithmetic("+")
def add(a, b):
"""加法"""
pass
@arithmetic("-")
def subtract(a, b):
"""减法"""
pass
@arithmetic("*")
def multiply(a, b):
"""乘法"""
pass
@arithmetic("/")
def divide(a, b):
"""除法"""
pass
print("加法")
print(f"结果: {add(10, 5)}\\n")
print("减法")
print(f"结果: {subtract(10, 5)}\\n")
print("乘法")
print(f"结果: {multiply(10, 5)}\\n")
print("除法")
print(f"结果: {divide(10, 5)}\\n")
说明:
-
装饰器带参 operator运算符
-
被装饰函数带参 a, b
-
两者结合,功能强大
3.2.2.5 类装饰器
① 核心描述
类装饰器是用类来实现装饰器,或用装饰器装饰类。
| 函数装饰类 | 用函数装饰类,增加类的功能 |
| 类实现装饰器 | 用类实现装饰器,通过 __call__ 调用 |
② 函数装饰类
# 函数装饰类:给类增加功能
def add_repr(cls):
"""给类添加 __repr__ 方法"""
def __repr__(self):
attrs = ", ".join(f"{k}={v!r}" for k, v in self.__dict__.items())
return f"{cls.__name__}({attrs})"
cls.__repr__ = __repr__
return cls
@add_repr
class Student:
def __init__(self, name, age):
self.name = name
self.age = age
s = Student("张三", 20)
print(s) # Student(name='张三', age=20)
说明:
-
add_repr 接收类,修改类,返回类
-
给类动态添加 __repr__ 方法
③ 类实现装饰器(__call__)
# 类实现装饰器:通过 __call__
class CountCalls:
"""统计函数调用次数"""
def __init__(self, func):
self.func = func
self.count = 0
def __call__(self, *args, **kwargs):
self.count += 1
print(f"第 {self.count} 次调用 {self.func.__name__}")
return self.func(*args, **kwargs)
@CountCalls
def say_hello(name):
print(f"你好,{name}")
say_hello("张三")
say_hello("李四")
say_hello("王五")
说明:
-
CountCalls 是类,__init__ 接收被装饰函数
-
__call__ 使实例可调用
-
装饰后,say_hello 是 CountCalls 的实例
④ 类装饰器带参
# 类装饰器带参
class Repeat:
"""重复执行函数"""
def __init__(self, times):
self.times = times
def __call__(self, func):
def wrapper(*args, **kwargs):
results = []
for _ in range(self.times):
results.append(func(*args, **kwargs))
return results
return wrapper
@Repeat(3)
def say_hello(name):
print(f"你好,{name}")
return f"Hello, {name}"
say_hello("张三")
说明:
-
Repeat(3) 创建实例
-
__call__ 接收被装饰函数,返回 wrapper
-
等价于 say_hello = Repeat(3)(say_hello)
⑤ 函数装饰器 vs 类装饰器
| 实现方式 | 函数嵌套 | 类 + __call__ |
| 状态保持 | 闭包 | 实例属性 |
| 可读性 | 简洁 | 清晰 |
| 扩展性 | 一般 | 好(可继承) |
| 适用场景 | 简单功能 | 复杂功能、需状态 |
3.2.3 特点
3.2.3.1 优点
| 代码复用 | 多个可调用对象共享装饰器 |
| 不侵入 | 不修改原函数代码 |
| 关注点分离 | 业务逻辑与辅助逻辑分离 |
| 可组合 | 多个装饰器可叠加 |
| 简洁 | 语法糖 @decorator 简洁明了 |
3.2.3.2 缺点
缺点1:调试困难
# 缺点1:调试困难
def my_decorator(func):
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
return wrapper
@my_decorator
def say_hello():
"""打招呼"""
pass
# 查看函数信息
print(f"函数名:{say_hello.__name__}") # wrapper(不是 say_hello)
print(f"文档:{say_hello.__doc__}") # None(不是"打招呼")
print(f"模块:{say_hello.__module__}") # __main__
# 原函数的元信息被替换了
问题: 装饰后,函数的 __name__、__doc__ 等元信息被替换为 wrapper 的信息。
解决: 使用 functools.wraps(详见 3.2.2)。
缺点2:性能开销
# 缺点2:性能开销
import time
def my_decorator(func):
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
return wrapper
@my_decorator
def add(a, b):
return a + b
def add_direct(a, b):
return a + b
# 性能对比
N = 1000000
start = time.time()
for _ in range(N):
add(1, 2)
decorated_time = time.time() – start
start = time.time()
for _ in range(N):
add_direct(1, 2)
direct_time = time.time() – start
print(f"装饰后:{decorated_time:.4f} 秒")
print(f"未装饰:{direct_time:.4f} 秒")
print(f"性能开销:{(decorated_time / direct_time – 1) * 100:.1f}%")
问题: 装饰器增加了一层函数调用,有性能开销。
适用: 对性能敏感的场景需谨慎使用。
缺点3:可读性下降
# 缺点3:可读性下降
def decorator1(func):
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
return wrapper
def decorator2(func):
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
return wrapper
def decorator3(func):
def wrapper(*args, **kwargs):
return func(*args, **kwargs)
return wrapper
@decorator1
@decorator2
@decorator3
def my_func():
pass
# 问题:
# 1. my_func 实际是 decorator1(decorator2(decorator3(my_func)))
# 2. 多层装饰器嵌套,难以追踪
# 3. 调试时难以定位问题
问题: 多层装饰器叠加时,可读性下降,调试困难。
解决: 适度使用装饰器,避免过度嵌套。
3.2.3.3 优缺点总结
| 优点 | 代码复用、不侵入、关注点分离、可组合、简洁 |
| 缺点 | 调试困难、性能开销、可读性下降 |
| 建议 | 适度使用,配合 functools.wraps,避免过度嵌套 |