1.介绍
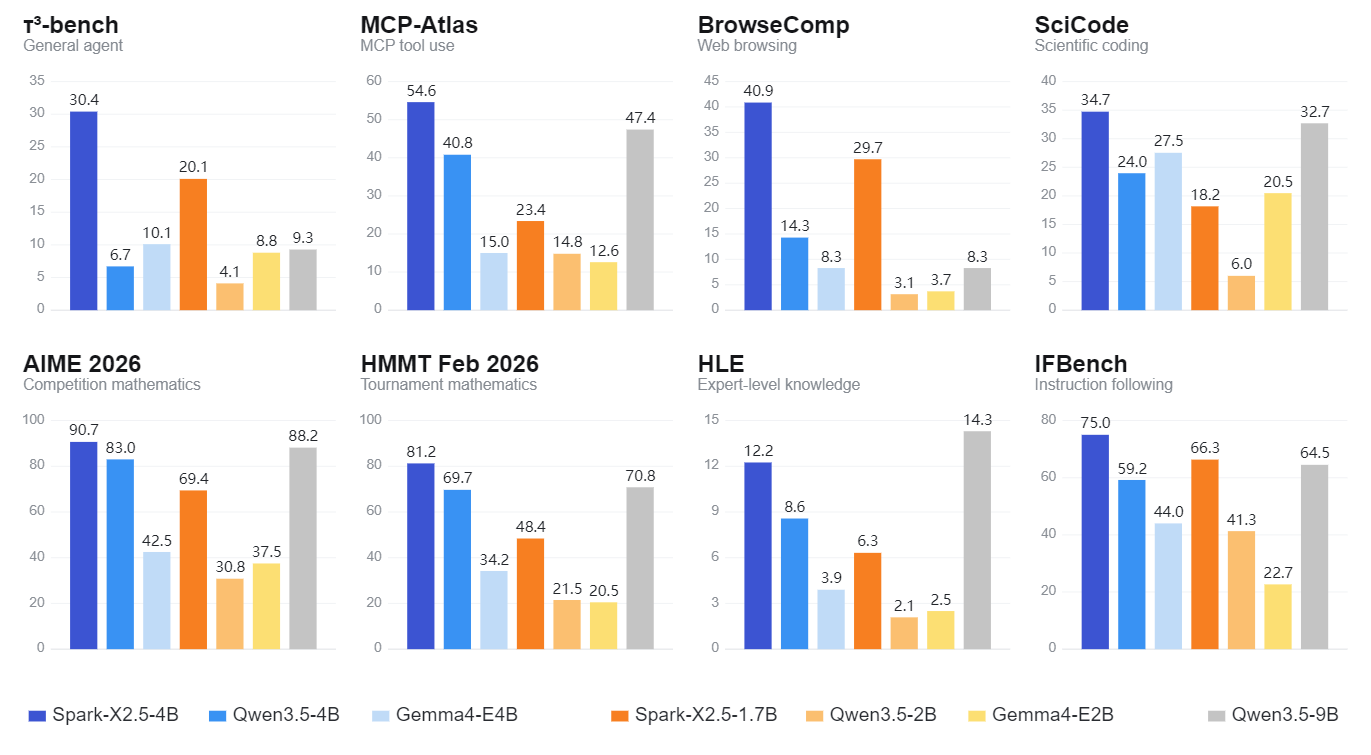
两款紧凑型通用语言模型Spark-X2.5-4B 和 Spark-X2.5-1.7B,在广泛的日常任务中表现出色——包括对话、写作、翻译、推理、编程、工具使用和智能体工作流——在同类开源模型中取得了领先成果。Spark-X2.5 结合了面向效率的架构,原生支持高达 100 万 token 的上下文窗口,并支持超过 200 种语言。
技术亮点:
- 高效架构与原生 100 万 token 上下文:模型采用混合注意力架构,结合了一层完整注意力层和三层滑动窗口注意力层。这种设计显著降低了长上下文模型通常伴随的计算开销,同时原生支持高达 100 万 token 的上下文窗口。
- 强大的编程与智能体能力:模型深度集成主流智能体框架,包括 Codex、Claude Code、OpenClaw 和 Hermes,在日常编程、智能体工作流、推理和指令遵循等任务中,于同类规模模型中达到业界领先水平。
- 广泛的硬件与软件兼容性:模型支持多种硬件平台,包括 NVIDIA、华为、海光、HOUMO.AI 等。兼容主流推理框架如 vLLM、SGLang、llama.cpp、MLX,并可通过 Ollama 和 LM Studio 等平台快速部署。此外,还可使用 LLaMA-Factory 等主流微调框架进行定制。在多种硬件平台上,其首 token 延迟(TTFT)、每输出 token 延迟(TOPT)及整体推理效率均优于同类规模模型。
- 先进的训练算法:模型在华为昇腾集群上完成训练。通过大规模强化学习及 MOPD 等后训练技术,显著增强了其在推理、编程、智能体任务和指令遵循方面的能力。
2.Windows安装llama.cpp
没有魔法命令安装卡的要命,推荐镜像直接下载: llama-b10883-bin-win-vulkan-x64.zip
# gh-proxy.com
https://gh-proxy.com/https://github.com/ggml-org/llama.cpp/releases/download/b10883/llama-b10883-bin-win-vulkan-x64.zip
下载完直接解压到自己新建的文件夹即可,如放在D盘LLAMA文件夹,右键在终端打开输入dir如下:
PS D:\\LLAMA> dir
目录: D:\\LLAMA
Mode LastWriteTime Length Name
—- ————- —— —-
d—– 2026/09/11 21:30 models
-a—- 2026/09/09 17:15 796160 ggml-base.dll
-a—- 2026/09/09 17:16 1230336 ggml-cpu-alderlake.dll
-a—- 2026/09/09 17:16 1448448 ggml-cpu-cannonlake.dll
-a—- 2026/09/09 17:16 1434112 ggml-cpu-cascadelake.dll
-a—- 2026/09/09 17:16 1434624 ggml-cpu-cooperlake.dll
-a—- 2026/09/09 17:16 1235968 ggml-cpu-haswell.dll
-a—- 2026/09/09 17:16 1440768 ggml-cpu-icelake.dll
-a—- 2026/09/09 17:16 1127424 ggml-cpu-ivybridge.dll
-a—- 2026/09/09 17:16 1131520 ggml-cpu-piledriver.dll
-a—- 2026/09/09 17:16 1107968 ggml-cpu-sandybridge.dll
-a—- 2026/09/09 17:16 1711616 ggml-cpu-sapphirerapids.dll
-a—- 2026/09/09 17:16 1441792 ggml-cpu-skylakex.dll
-a—- 2026/09/09 17:16 932352 ggml-cpu-sse42.dll
-a—- 2026/09/09 17:16 924160 ggml-cpu-x64.dll
-a—- 2026/09/09 17:16 1441280 ggml-cpu-zen4.dll
-a—- 2026/09/09 17:16 101376 ggml-rpc-server.exe
-a—- 2026/09/09 17:16 168448 ggml-rpc.dll
-a—- 2026/09/10 1:16 43248640 ggml-vulkan.dll
-a—- 2026/09/09 17:16 79872 ggml.dll
-a—- 2026/09/09 17:15 768000 libomp.dll
-a—- 2026/09/09 17:15 19741 LICENSE-LLVM-OpenMP
-a—- 2026/09/09 17:16 61440 llama-batched-bench-impl.dll
-a—- 2026/09/09 17:16 9216 llama-batched-bench.exe
-a—- 2026/09/09 17:16 397824 llama-bench-impl.dll
-a—- 2026/09/09 17:16 9216 llama-bench.exe
-a—- 2026/09/09 17:16 3296256 llama-cli-impl.dll
-a—- 2026/09/09 17:16 9216 llama-cli.exe
-a—- 2026/09/09 17:16 7800320 llama-common.dll
-a—- 2026/09/09 17:16 133632 llama-completion-impl.dll
-a—- 2026/09/09 17:16 9216 llama-completion.exe
-a—- 2026/09/09 17:16 41472 llama-fit-params-impl.dll
-a—- 2026/09/09 17:16 9216 llama-fit-params.exe
-a—- 2026/09/09 17:16 27136 llama-gemma3-cli.exe
-a—- 2026/09/09 17:16 60416 llama-gguf-split.exe
-a—- 2026/09/09 17:16 255488 llama-imatrix.exe
-a—- 2026/09/09 17:16 27136 llama-llava-cli.exe
-a—- 2026/09/09 17:16 27136 llama-minicpmv-cli.exe
-a—- 2026/09/09 17:16 90112 llama-mtmd-cli.exe
-a—- 2026/09/09 17:16 55296 llama-mtmd-debug.exe
-a—- 2026/09/09 17:16 194048 llama-perplexity-impl.dll
-a—- 2026/09/09 17:16 9216 llama-perplexity.exe
-a—- 2026/09/09 17:16 137216 llama-quantize-impl.dll
-a—- 2026/09/09 17:16 9216 llama-quantize.exe
-a—- 2026/09/09 17:16 27136 llama-qwen2vl-cli.exe
-a—- 2026/09/09 17:16 46080 llama-results.exe
-a—- 2026/09/09 17:16 8893440 llama-server-impl.dll
-a—- 2026/09/09 17:16 9216 llama-server.exe
-a—- 2026/09/09 17:16 58368 llama-tokenize.exe
-a—- 2026/09/09 17:16 41472 llama-tts.exe
-a—- 2026/09/09 17:16 3152896 llama.dll
-a—- 2026/09/09 17:16 103936 llama.exe
-a—- 2026/09/09 17:16 1772032 mtmd.dll
因为懒,直接在里面新建models文件夹,放GGUF权重文件
输入命令 .\\llama-cli.exe –list-devices可以查看有哪些可以用的卡:
S D:\\LLAMA> .\\llama-cli.exe –list-devices
Available devices:
Vulkan0: Intel(R) UHD Graphics (8054 MiB, 7395 MiB free) # 集成显卡,慢的要命,直接忽略
Vulkan1: NVIDIA GeForce RTX 4050 Laptop GPU (5921 MiB, 5153 MiB free) # 快的可以
3.下载权重
魔搭社区下载,直接点下面的链接
Spark-X2.5-4B-GGUFModelScope——汇聚各领域先进的机器学习模型,提供模型探索体验、推理、训练、部署和应用的一站式服务。在这里,共建模型开源社区,发现、学习、定制和分享心仪的模型。 https://modelscope.cn/models/XHToken/Spark-X2.5-4B-GGUF
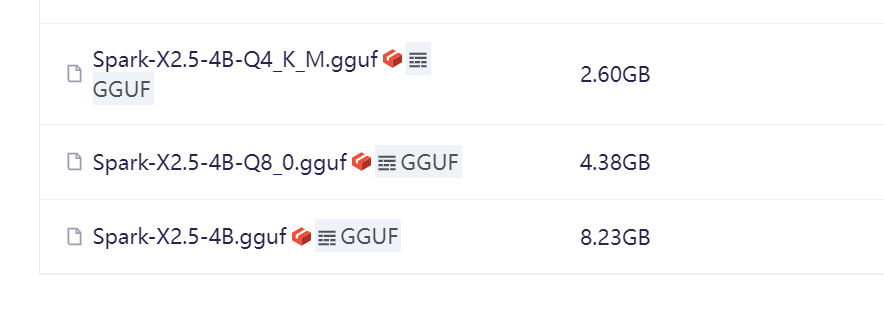
有三个权重可选,为了追求速度和超长上下文,这里选Spark-X2.5-4B-Q4_K_M.gguf,下载完权重直接放在models文件夹
4.拉起模型
在终端输入命令:
.\\llama-server.exe `
-m .\\models\\Spark-X2.5-4B-Q4_K_M.gguf `
-dev Vulkan1 `
-ngl 99 `
-c 256256 `
-b 1024 `
-ub 1024 `
-ctk q4_0 `
-ctv q4_0 `
-np 1 `
–jinja `
–reasoning-budget 4096 `
–reasoning-budget-message ". Okay, enough thinking. Let's just jump to the answer." `
–temp 1.0 `
–top-p 0.95 `
–top-k -1 `
–min-p 0.05 `
–repeat-penalty 1.3 `
–presence-penalty 0.6 `
–frequency-penalty 0.3 `
-n -1 `
–host 127.0.0.1 `
–port 8080 `
–api-key spk-333 `
–timeout 600
拉起如下:
PS D:\\LLAMA> .\\llama-server.exe `
>> -m .\\models\\Spark-X2.5-4B-Q4_K_M.gguf `
>> -dev Vulkan1 `
>> -ngl 99 `
>> -c 256256 `
>> -b 1024 `
>> -ub 1024 `
>> -ctk q4_0 `
>> -ctv q4_0 `
>> -np 1 `
>> –jinja `
>> –reasoning-budget 4096 `
>> –reasoning-budget-message ". Okay, enough thinking. Let's just jump to the answer." `
>> –temp 1.0 `
>> –top-p 0.95 `
>> –top-k -1 `
>> –min-p 0.05 `
>> –repeat-penalty 1.3 `
>> –presence-penalty 0.6 `
>> –frequency-penalty 0.3 `
>> -n -1 `
>> –host 127.0.0.1 `
>> –port 8080 `
>> –api-key spk-333 `
>> –timeout 600
0.00.205.571 I cmn common_param: common_params_print_info: verbosity = 3 (adjust with the `-lv N` CLI arg)
0.00.211.762 I srv load_model: loading model '.\\models\\Spark-X2.5-4B-Q4_K_M.gguf'
0.00.546.307 W common_fit_params: failed to fit params to free device memory: n_gpu_layers already set by user to 99, abort
0.03.793.439 I cmn init: llama threadpool init, n_threads = 10
0.04.001.152 I srv load_model: initializing, n_slots = 1, n_ctx_slot = 256256, kv_unified = 'false'
0.04.017.289 W srv init: chat template supports preserving reasoning, it is enabled by default (may use more tokens, disable via –no-reasoning-preserve)
0.04.017.315 I srv llama_server: model loaded
0.04.017.318 I srv llama_server: listening on http://127.0.0.1:8080
0.04.017.319 W srv llama_server: NOTICE: server default port will be changed to :9931 in a future release
0.04.017.320 W srv llama_server: ref: https://github.com/ggml-org/llama.cpp/pull/26508
256K上下文,哈哈,显存占用情况:
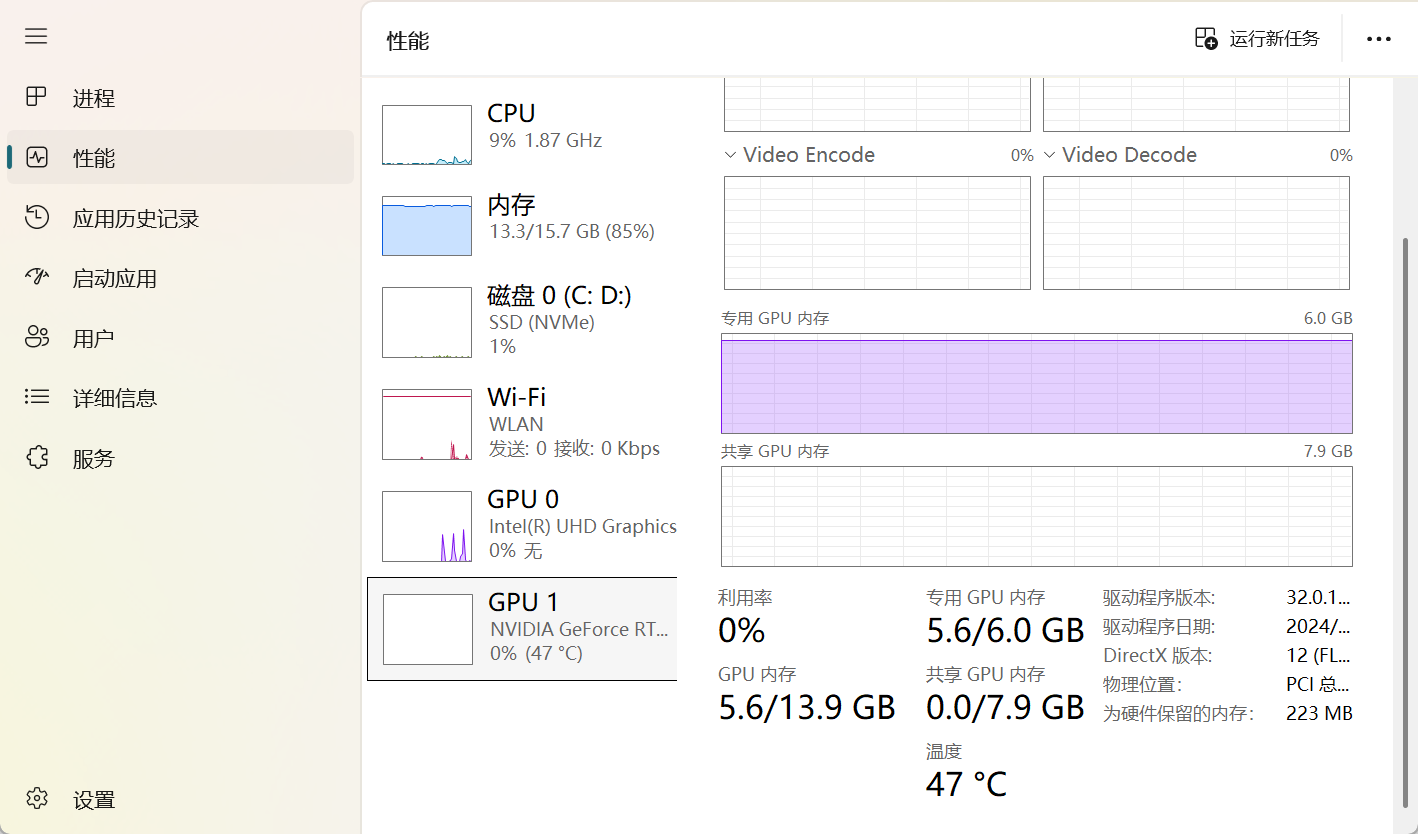
打开listening on http://127.0.0.1:8080 链接,跳转输入api密钥(看启动脚本参数–api-key)
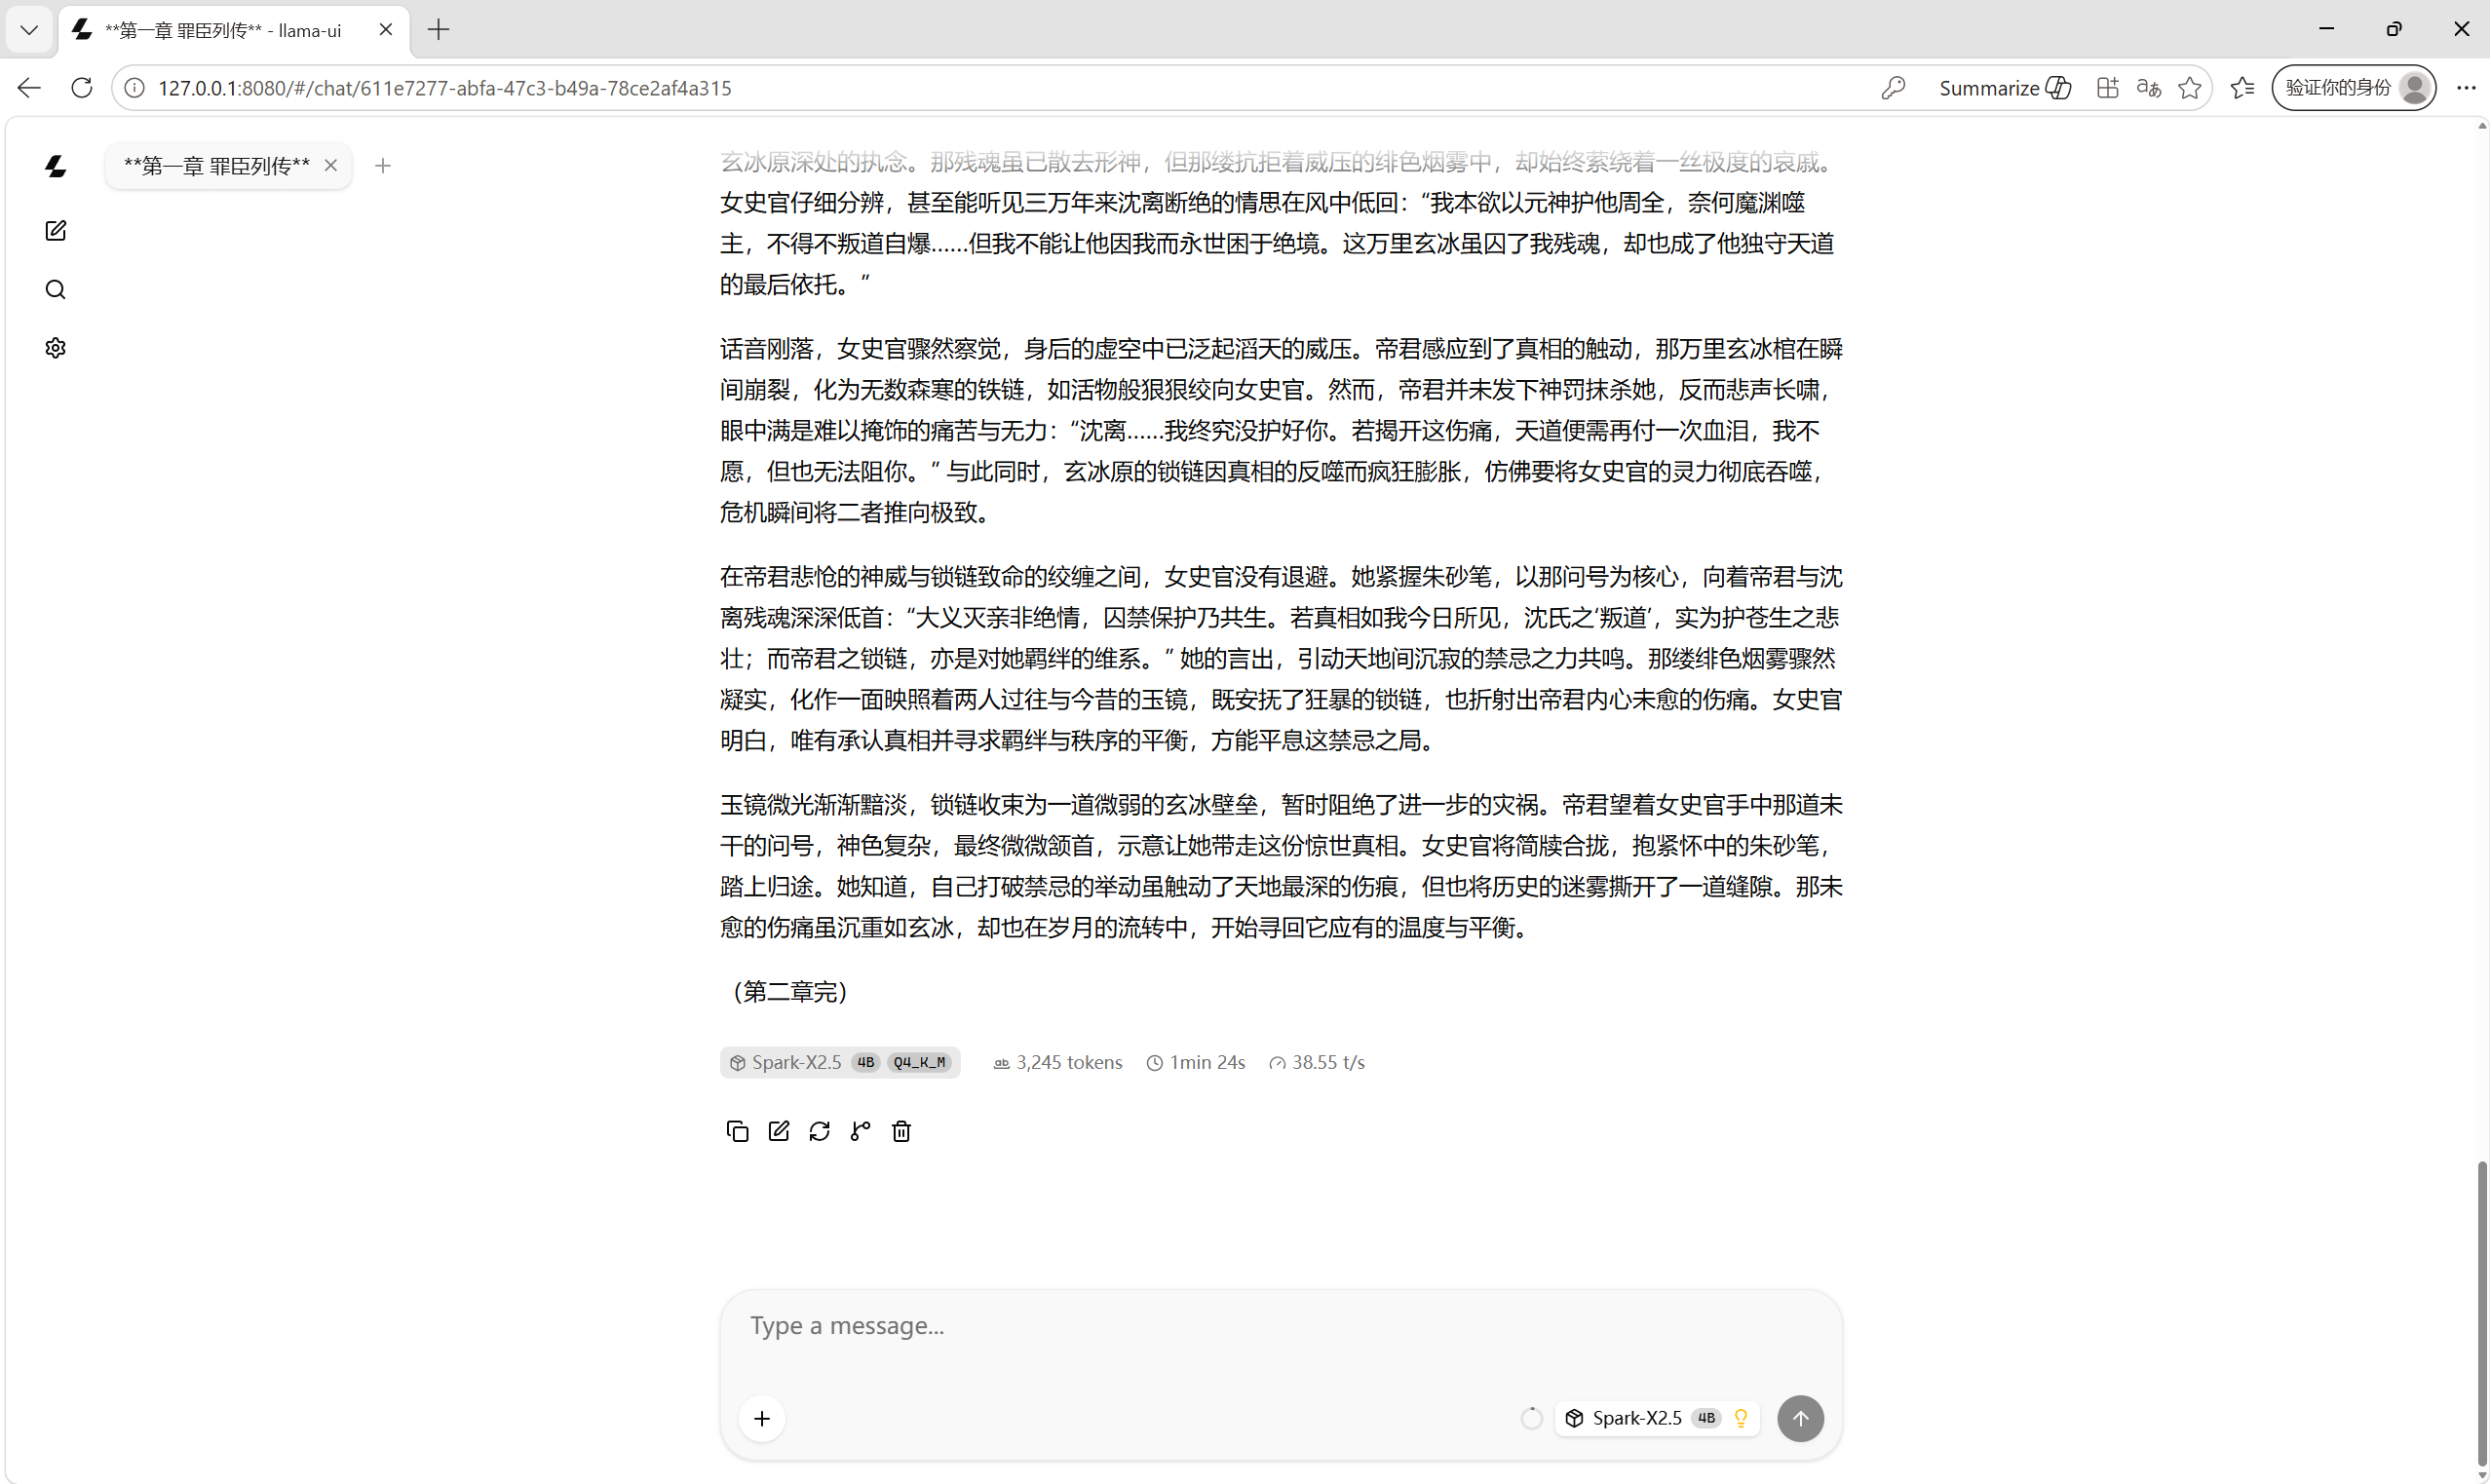
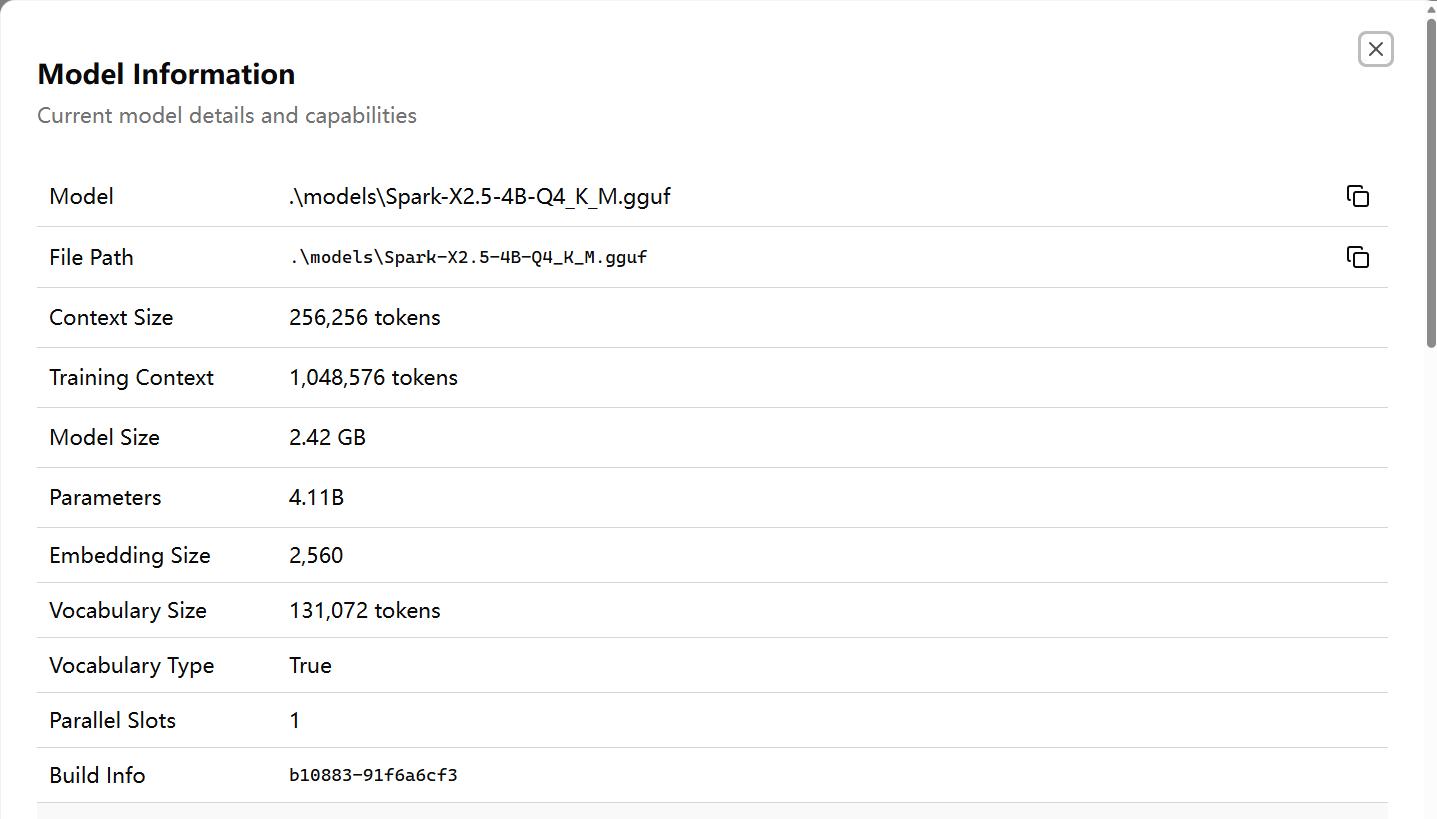
速度38.55 t/s,速度很棒,点击右下角可以查看模型信息
5.API调用(接入workbuddy)
打开workbuddy,点击设置,找到模型,点击添加模型
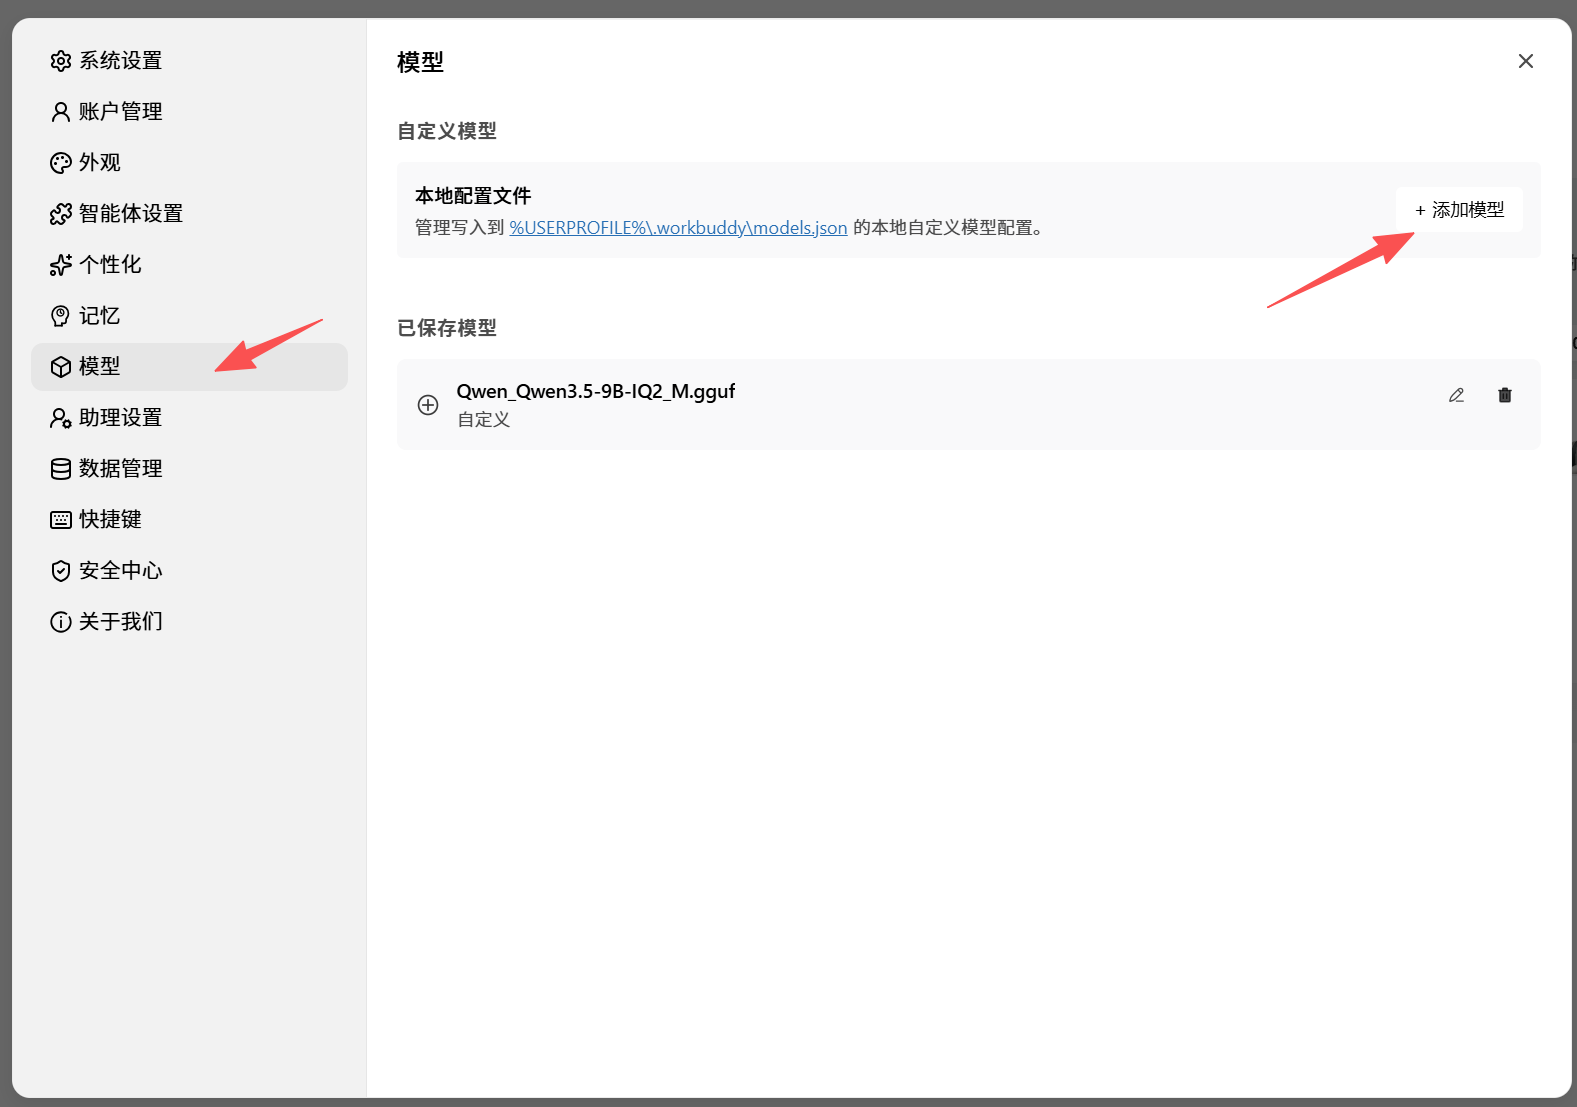
填写模型信息,模型名字为权重全名Spark-X2.5-4B-Q4_K_M.gguf,接口地址为本地http://localhost:8080/v1/chat/completions
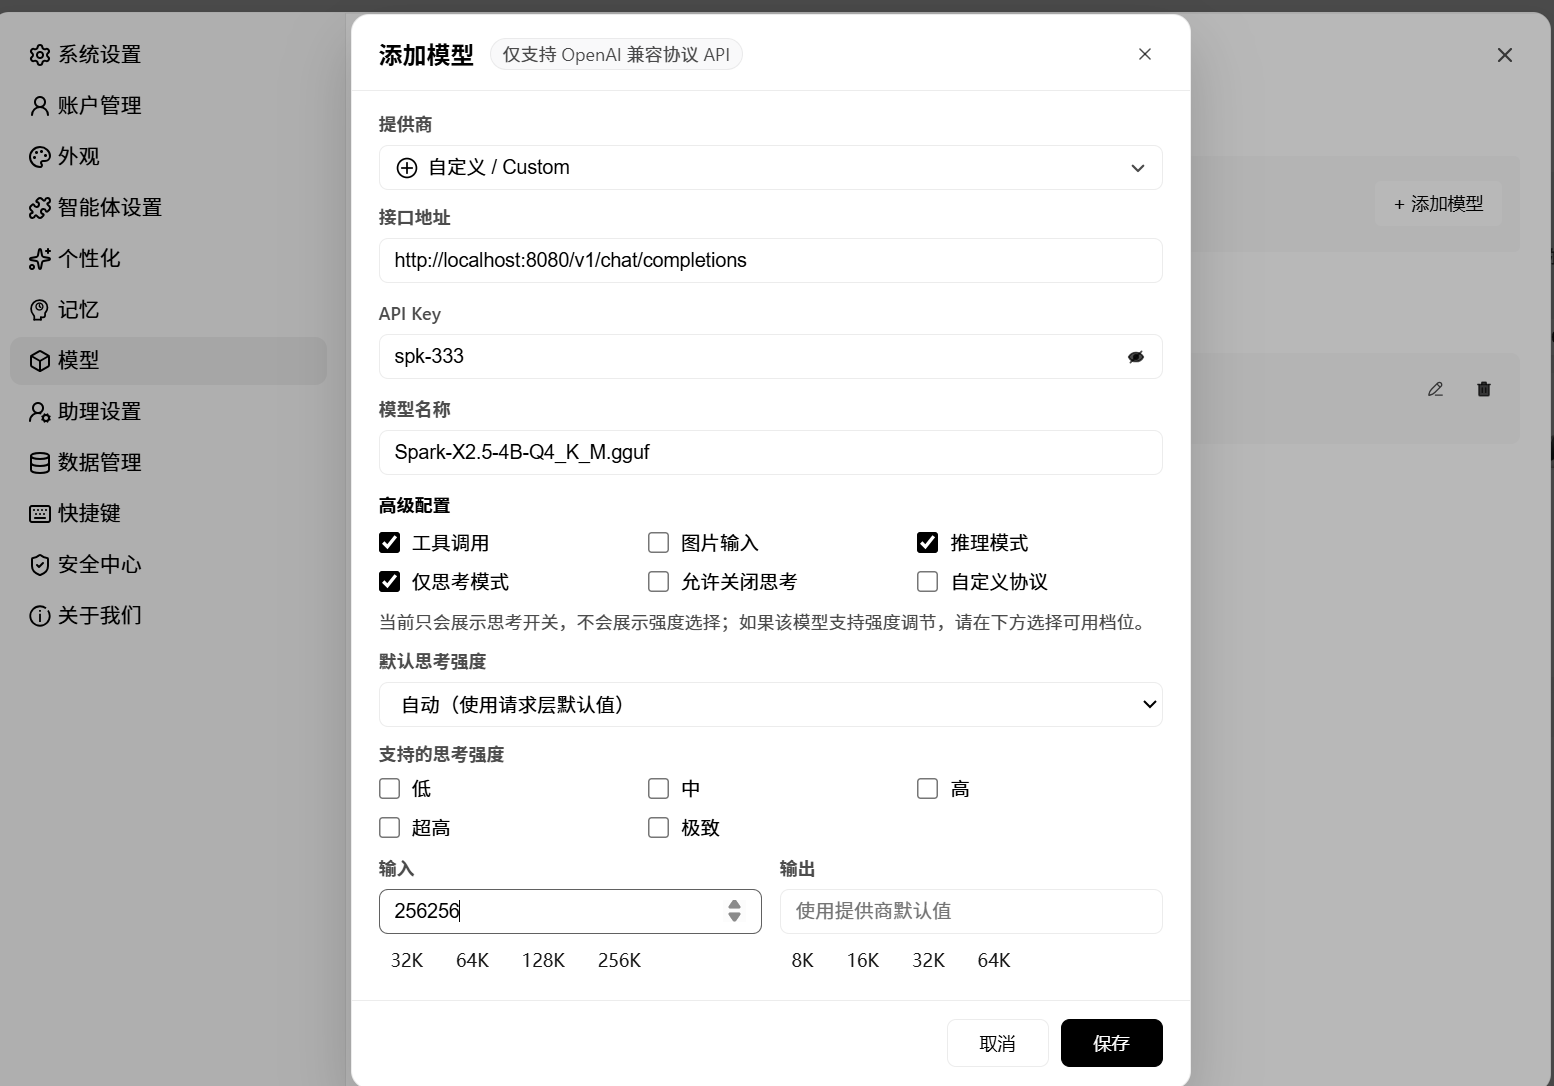
保存模型配置后,workbuddy可以选择模型了:
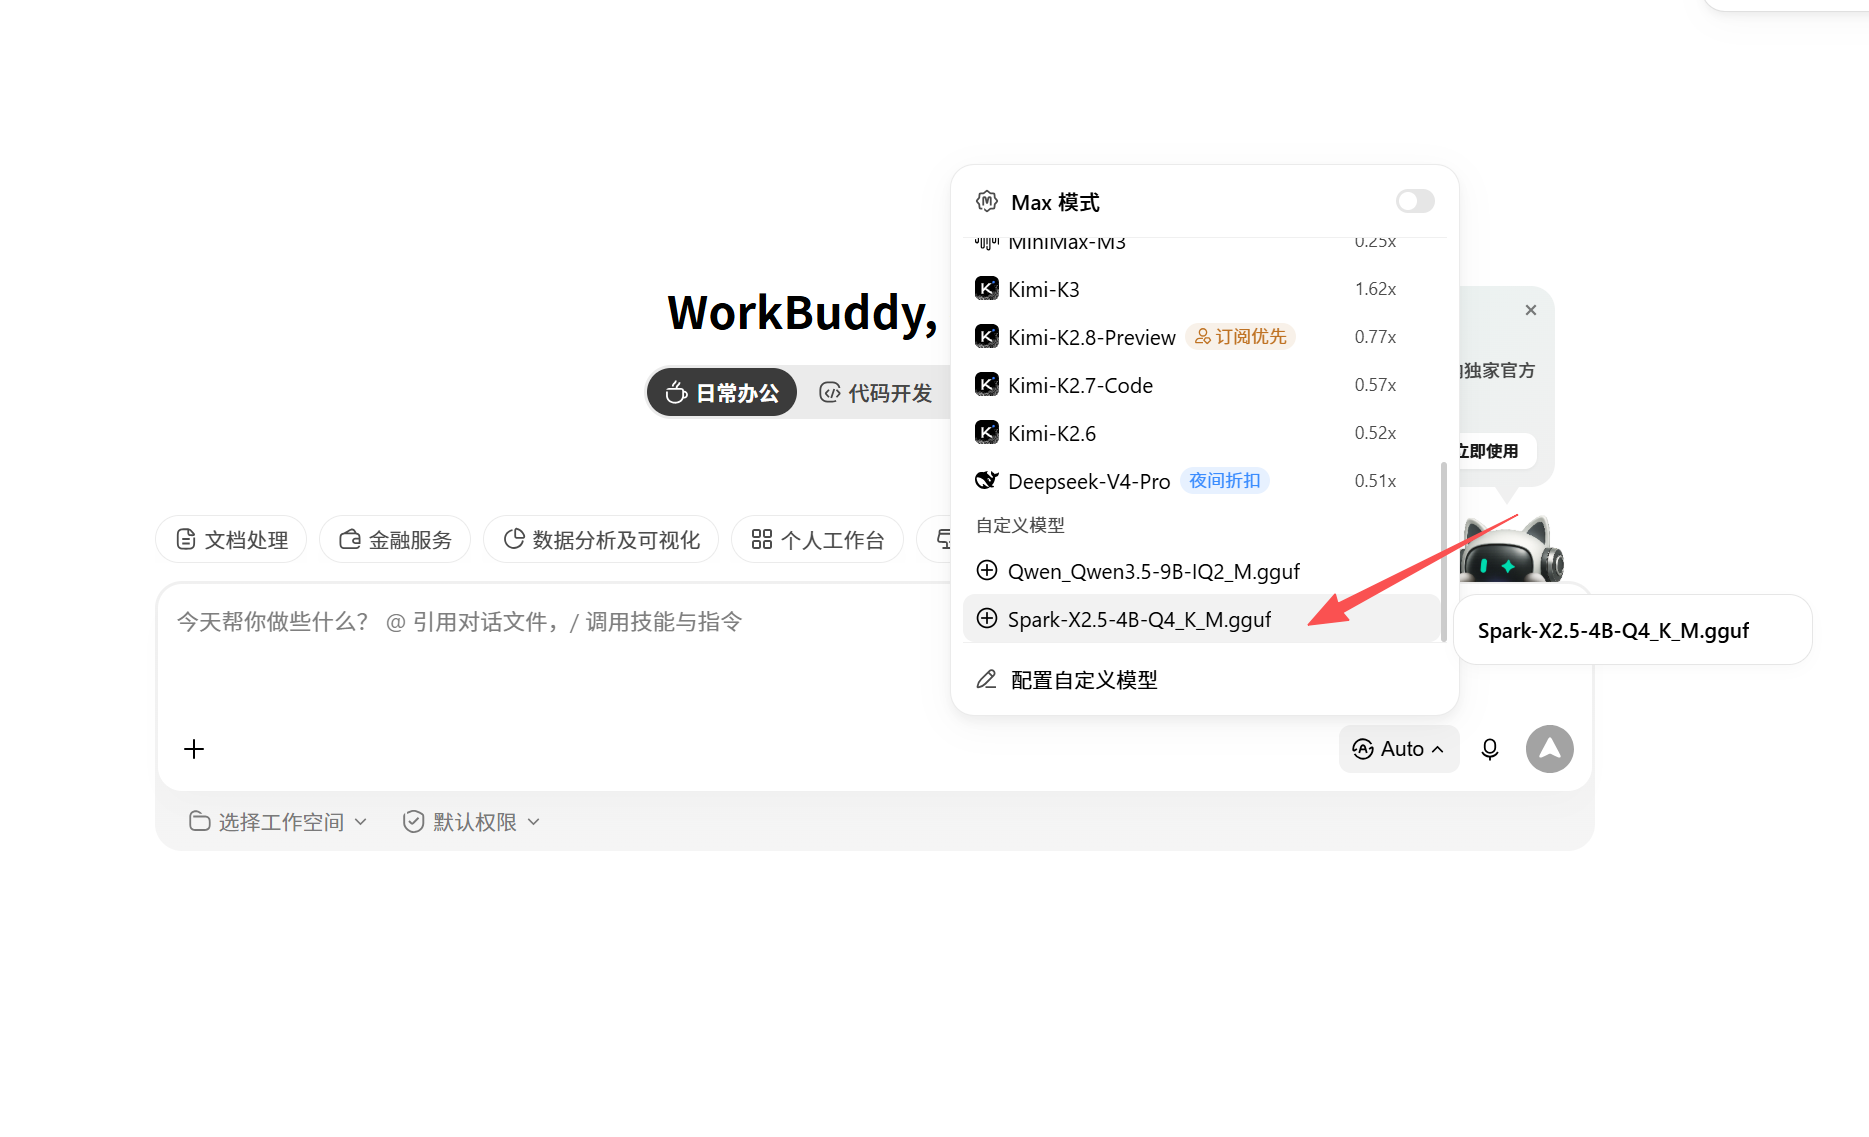
请开始你的表演!!!