0. 简介
LeHome Challenge 2026 是一场以织物折叠为核心任务的国际机器人竞赛,Ilia Larchenko 的方案在 62 支队伍的线上仿真赛道拿到综合成功率第一(79.63%,领先第二名 6.1 个百分点),在维也纳 ICRA 现场实体决赛拿到第二名。这套方案处理的是一个非常具体的矛盾:织物是柔性可变形物体,微小的机械臂轨迹偏差会彻底改变布料形态,而主办方给的行为克隆(BC)演示又全是无故障的完美轨迹,只靠 BC 训出来的模型鲁棒性极差。它没有走主流的 PPO/GRPO 策略梯度路线,而是用 AWR 加权采样与 RECAP 优势条件输入两条机制,把「一体化价值网络」「稠密时序奖励」「推理超参在线调优」「sim-to-real 数据增强」连成一个基于 HuggingFace Hub 的全异步训练闭环。下面结合这套方案与后半段原力灵机 15 小时搭长城的长程案例,重点拆解三件事:柔性物体的数据到底怎么采、优势信号怎么同时喂进训练与推理、以及从十几分钟到十几小时的长程任务缺的是什么。
1. 为什么叠衣服这件小事这么难
1.1 柔性物体把「状态」这个概念打碎了
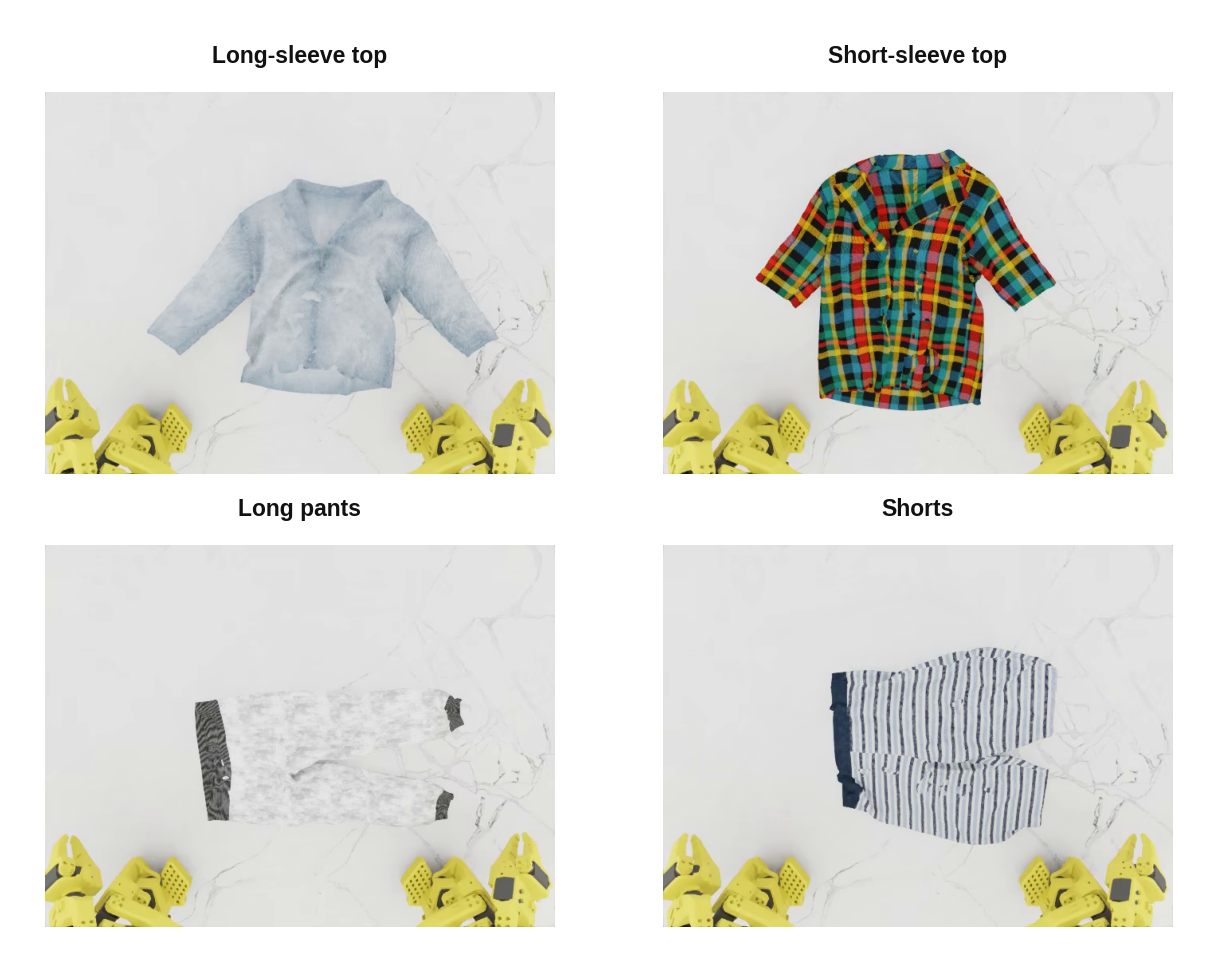
刚性物体的操控之所以相对好做,是因为一个盒子、一个杯子的状态可以用位姿(6 个自由度)描述干净。织物不行。一件平铺的长袖上衣理论上有近乎无穷维的形态自由度,你按下去一个褶皱,整块布的受力就重新分布。这里的关键是,机械臂动作与布料形态之间不是线性映射,微小的抓取点偏差会被柔性动力学放大成完全不同的结果。主办方提供的初始数据集全是脚本生成的完美折叠轨迹,没有褶皱、没有错位、没有抓空,模型学到的是「理想世界里怎么叠」,一旦真实执行中出现一点偏差,进入训练分布外的布料状态,就直接崩掉。这就是为什么柔性操控任务几乎必然要引入强化学习与故障修复数据,纯 BC 是不够的。
1.2 从叠衣服到长程任务,缺口是同一个
把镜头拉远看 WAIC 上原力灵机的机器人搭长城:6 台机器人在 15 小时内拼完 8 万多个零件、最小组件不到 1 厘米宽的微缩长城。这不是炫技,是对 VLA(Vision-Language-Action)模型的耐力压力测试。核心问题在于,长程任务里任何一个环节的记忆丢失或动作漂移,累积误差都会毁掉整体。叠一件衣服是 30 秒、几十步动作的短程任务;搭长城是 15 小时、成千上万步的长程任务。但两者卡住的地方是同一个:模型需要在分布外状态下自主恢复,需要把稀疏的「最终成没成」信号变成每一步的密集反馈。LeHome 方案用稠密奖励与一体化价值网络解决短程版本,原力灵机用 1 分钟任务进程记忆与世界模型训练场解决长程版本,思路高度同构。这篇文章就沿着「数据怎么采 → 优势怎么用 → 长程怎么撑」这条线展开。
2. 整体框架:一套异步闭环,三类组件只靠 Hub 通信
2.1 三类组件与数据流向
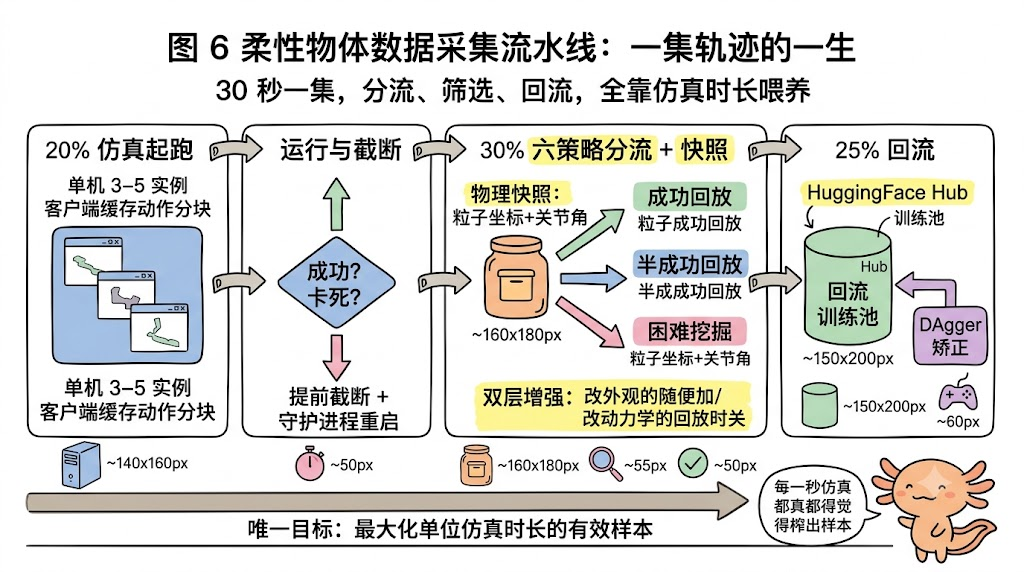
整套训练系统的骨架是一个没有全局同步屏障的异步循环,所有模型权重和数据集只通过 HuggingFace Hub 传输,三类计算组件互不阻塞。第一类是训练进程,跑在单台 H200 服务器上,持续不断做训练迭代,每轮开始前重新计算全部存量轨迹的时序优势,训练固定步数后把新检查点推上 Hub。第二类是推理轨迹采集进程,可以挂任意数量的 RTX PRO 6000 服务器,每台从 Hub 拉最新权重,单机并行跑 3–5 个 Isaac Sim 仿真实例采集完整轨迹再传回 Hub。第三类是人工 DAgger 修正工作站,人通过遥操作加载仿真存下的故障布料状态,手动修正后交还模型自主完成。这里的关键是,算力和数据采集量可以线性扩容,加一台采集机器只需要它能连上 Hub,不需要改任何中心调度逻辑。
直觉理解:把 Hub 想象成一个共享的公告栏加仓库。训练进程往公告栏贴最新模型,采集进程随时取最新模型去干活、把成果堆回仓库,人工修正工作站也往同一个仓库塞修好的样本。谁都不用等谁开会,各自按自己的节奏跑,这就是「异步」的全部含义。
2.2 训练与推理的关键不对称
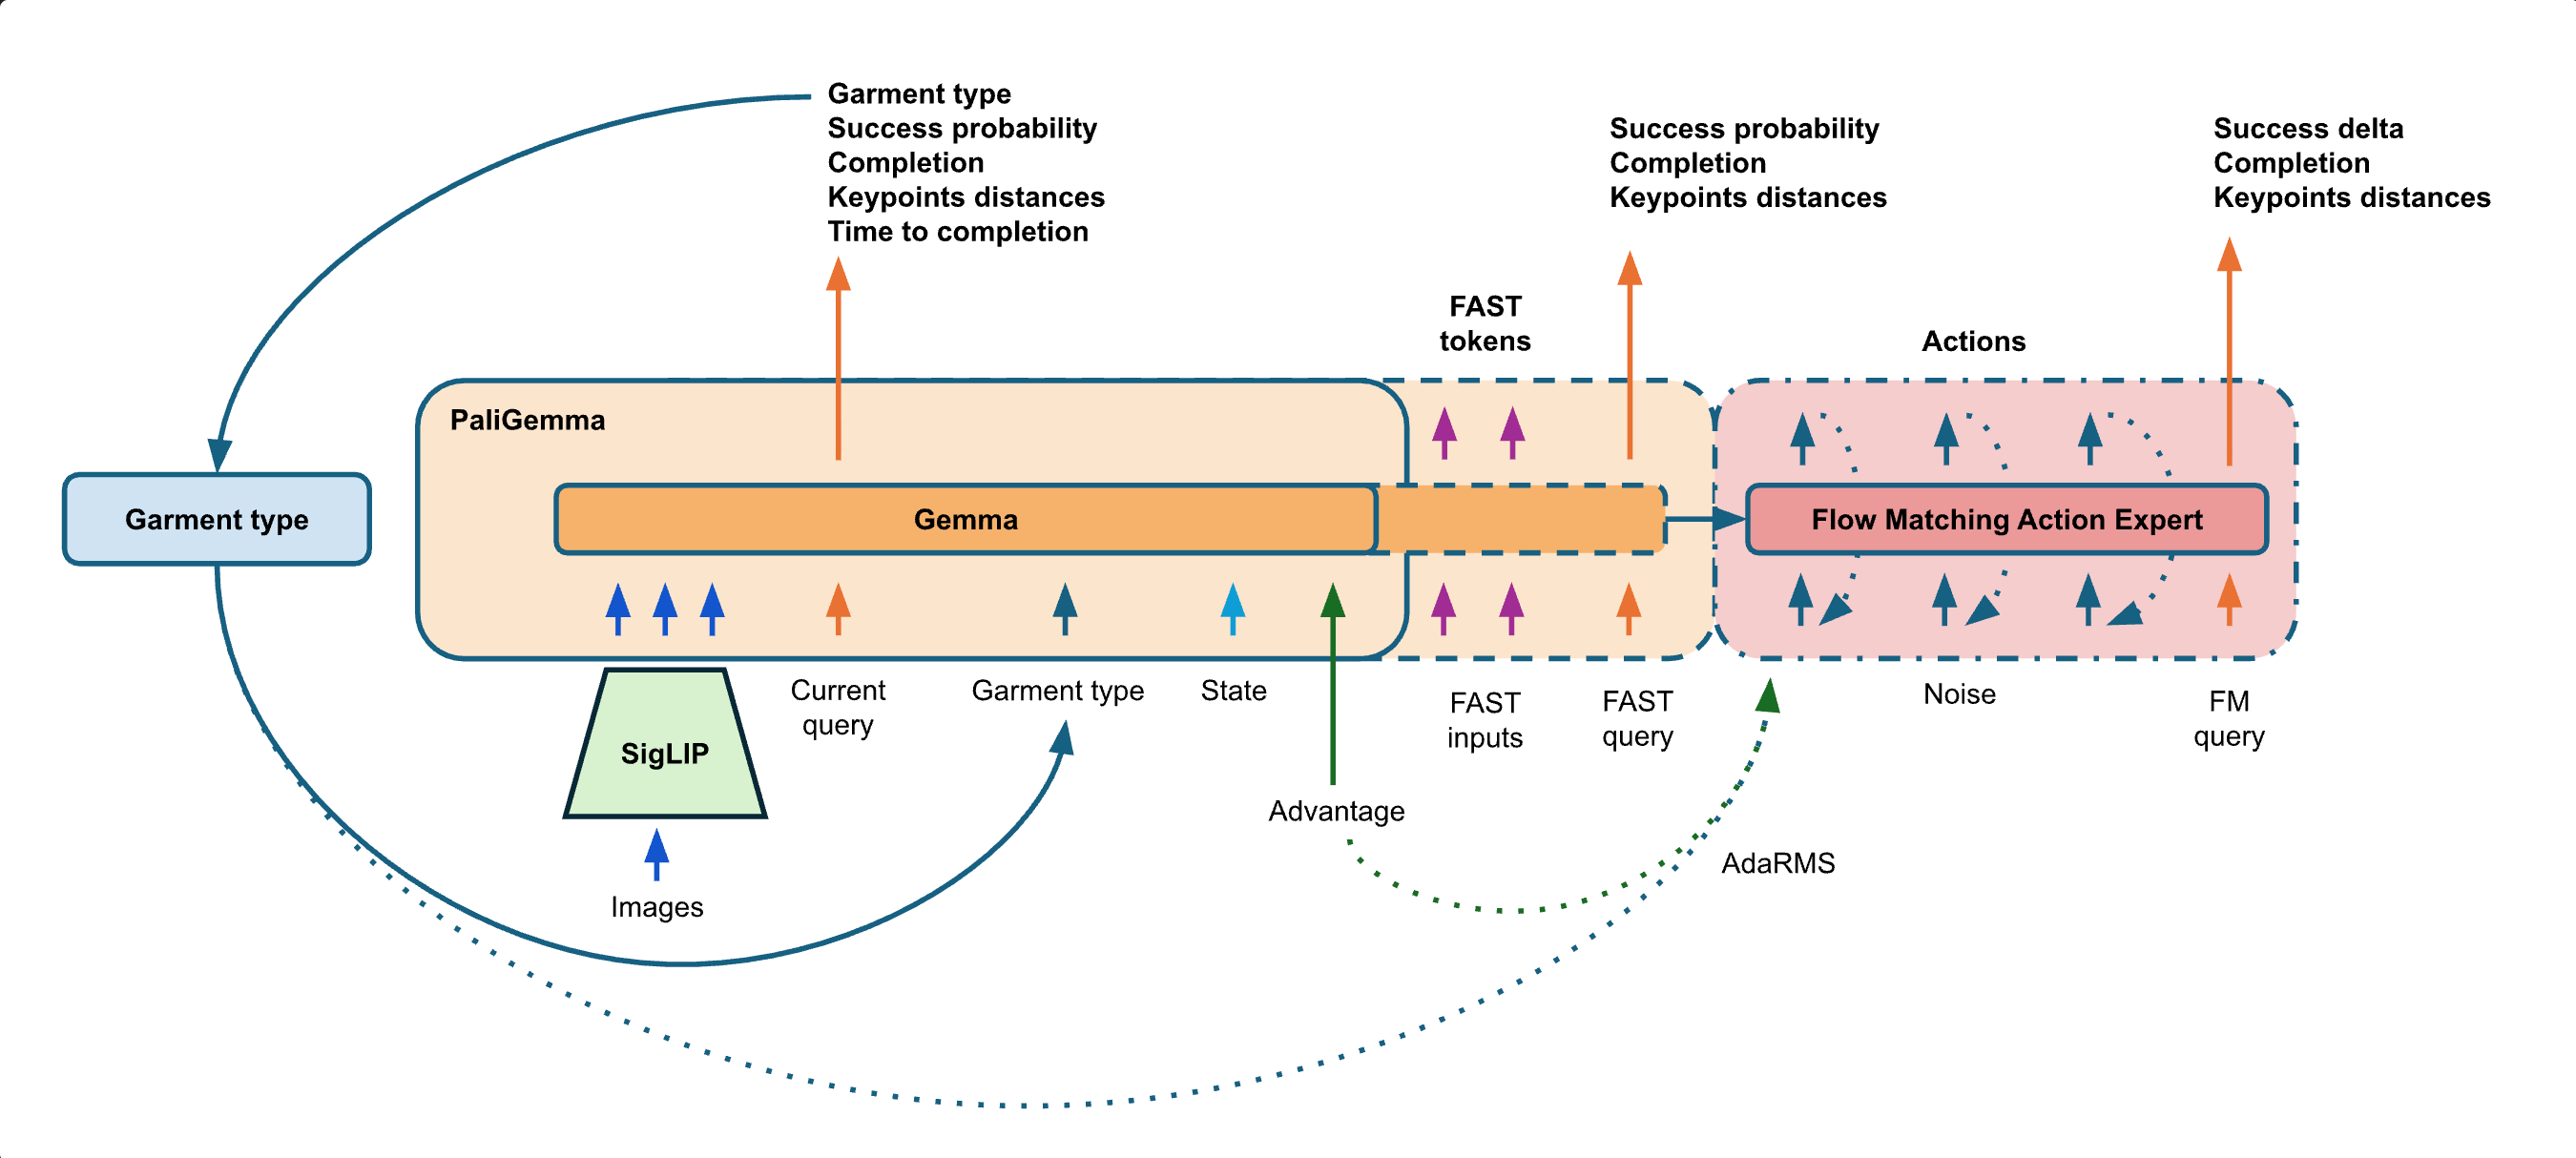
这套系统有一个贯穿全文的不对称设计:同一个主干网络在训练时输出一大堆价值预测,在推理时这些预测被拆开喂给不同下游模块。预测动作的网络同时承担价值函数的全部功能,单套网络同步输出任务成功概率、折叠进度、多组未来关键点距离。训练时,这些预测用来算时序优势、做 AWR 加权;推理时,成功率预测头变成在线故障检测器,动作条件残差变成多候选动作的打分器,织物分类头变成推理启动时的类别识别器。换句话说,训练阶段是「把价值信号灌进网络」,推理阶段是「把网络里的价值信号抽出来用」。这种一体化设计省掉了独立训练、同步、部署一个 critic 网络的全部开销,也让动作预测和状态预测共享底层视觉表征,互相增益。
单次完整训练迭代按四步走:从 Hub 下载本轮新增轨迹;全局遍历存量数据重算时序优势;持续训练约 1000 个梯度步;每 500 步上传一次检查点。这四步里最反直觉的是第二步——每轮都要把全部存量轨迹的优势重算一遍,而不是只算新数据。原因是价值预测头随模型迭代持续变化,昨天算的优势今天可能已经偏了,只有全局重算才能保证优势信号和当前模型一致,这也是后面老旧轨迹优势退化机制存在的前提。
3. 第一条核心机制:AWR 加权采样,让好动作被反复训练
3.1 AWR 的核心思路:把策略改进变成加权回归
AWR(Advantage-Weighted Regression,优势加权回归)是 Peng 等人 2019 年提出的离线强化学习算法,它的思路极其朴素:不要去算复杂的策略梯度,直接把好动作的训练权重调高、坏动作调低,做一次加权的监督回归就行。每一帧样本的权重是优势值的指数函数。这里的关键是,这个指数权重不是拍脑袋定的,它恰好是「在 KL 散度约束下最大化优势」这个带约束优化问题的闭式解:
w
(
s
,
a
)
=
exp
(
A
π
(
s
,
a
)
β
)
,
A
π
(
s
,
a
)
=
Q
π
(
s
,
a
)
−
V
π
(
s
)
w(s, a) = \\exp\\!\\Bigl(\\frac{A^{\\pi}(s, a)}{\\beta}\\Bigr), \\qquad A^{\\pi}(s,a) = Q^{\\pi}(s,a) – V^{\\pi}(s)
w(s,a)=exp(βAπ(s,a)),Aπ(s,a)=Qπ(s,a)−Vπ(s)
其中
A
π
(
s
,
a
)
A^{\\pi}(s,a)
Aπ(s,a) 是动作
a
a
a 相对当前策略的优势,等于
Q
π
(
s
,
a
)
Q^{\\pi}(s,a)
Qπ(s,a) 减去
V
π
(
s
)
V^{\\pi}(s)
Vπ(s),
β
>
0
\\beta > 0
β>0 是温度系数。
β
\\beta
β 越大越接近纯 BC(所有样本权重趋近相等),越小则策略改进越激进(只有极高优势的样本能拿到显著权重)。这个温度是整套 AWR 里最需要调的旋钮,调不好要么退化成普通模仿学习,要么因为权重方差过大导致训练不稳。
难点提示(为什么是指数权重):假设你在教练身边练车,教练不会只说「这个动作错了」,而是给每个动作打一个分。指数权重的意思是,分数每高一档,这个动作被拿来当范本的次数就翻倍式增长。数学上它来自一个约束——新策略不能离旧策略太远(KL 约束),拉格朗日乘子恰好落在指数的分母上变成温度
β
\\beta
β。所以指数不是随便选的形状,是「小步快跑地改进策略」这个要求逼出来的唯一形式。
3.2 工程改造:在采样器里加权,而不是在损失里加权
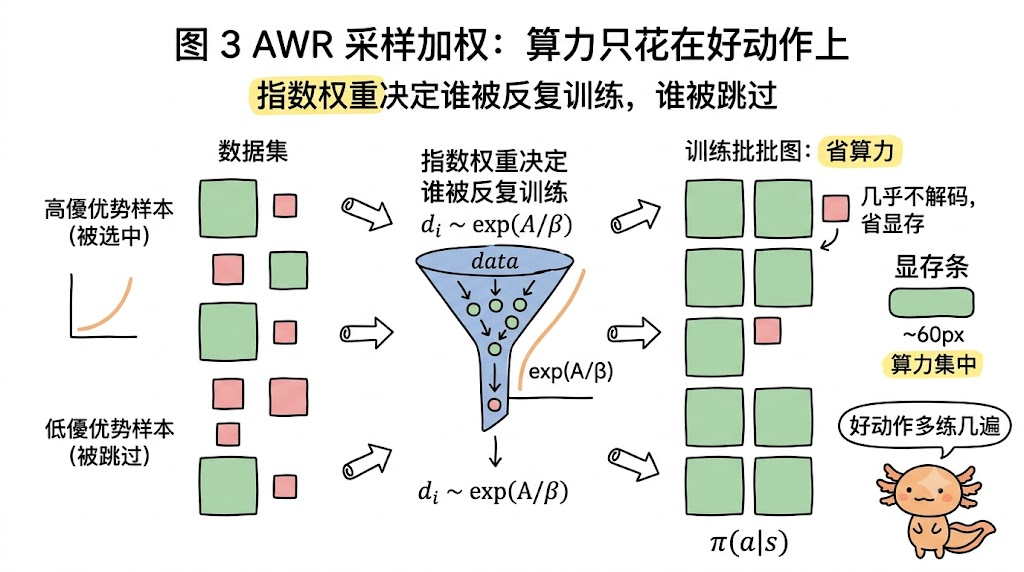
AWR 原始论文把权重加在损失函数上,本方案改成在数据集采样阶段加权,两者数学期望等价,但采样加权的数据利用效率高得多。原因很直接:权重极低的样本几乎不会被加载进训练批次,就不需要解码图像、不占显存、不吃计算,全部算力集中在高价值样本上。对于图像观测的机器人任务,图像解码本身就是大头开销,这个改造的收益尤其明显。单帧样本被采样的概率正比于它的指数优势权重,在整个数据集上归一化。
3.3 代码透视:无偏修正的重要性权重
采样加权带来一个新问题:动作损失可以按优势加权,但所有辅助预测头(成功率、分类、关键点距离)的训练目标是真实数据的全局统计量,不能被优势分布带偏。方案给每条采样进批次的样本附带一条逆采样重要性权重来消除这个偏移。下面两段全部是仓库 data_loader.py 的原文节选,先看生成采样概率的 _load_priorities,它就是把优势列取指数变成采样分布这一步:
# src/lehome_solution/training/data_loader.py _load_priorities(仓库原文节选)
valid_advs = all_advs[valid_indices]
# Clip and exponentiate
clip_min, clip_max = clip_range
if clip_min == 0.0 and clip_max == 0.0:
return None # uniform sampling
clipped = np.clip(valid_advs, clip_min, clip_max)
priorities = np.exp(clipped)
# Normalize to probability distribution
priorities /= priorities.sum()
这段仓库原文印证了三个细节。第一,优势值先按 clip_range(默认
(
−
2.0
,
2.0
)
(-2.0, 2.0)
(−2.0,2.0))裁剪再取指数,这既做数值稳定又限制了单帧权重上限,避免极端优势把整个批次占满。第二,注意它没有除以温度
β
\\beta
β——仓库把 AWR 温度直接吸收进了裁剪区间,裁剪窗口的宽窄等效地扮演了温度旋钮的角色。第三,clip_range 设成
(
0
,
0
)
(0,0)
(0,0) 时直接返回 None 退回均匀采样,这是关掉 AWR 的开关。归一化后 priorities 就是每一帧被采样的概率
p
i
p_i
pi,高优势帧的
p
i
p_i
pi 显著大于均匀值。
有了采样概率,第二层是无偏修正。因为动作已经通过「谁被选中」隐式加权了,流匹配动作损失不需要再乘权重;而辅助头预测的是客观统计量(这一帧真实的成功率、真实的关键点距离),一旦被优势分布过采样带偏,这些统计量的训练目标就错了,所以必须乘上逆采样权重把过采样偏差精确抵消掉。仓库在 MultiDataset.__getitem__ 里算这个权重,逻辑同样对每一类数据源统一:
# src/lehome_solution/training/data_loader.py __getitem__(仓库原文节选)
# IS weight: 1/(N*p). Same definition for every source (RL / BC / DAgger);
# ep-len normalisation is applied below so the final is_weight field is
# 1/(N*p*ep_len) — the full unbiased per-episode weight used by all aux losses.
if probs is not None:
chosen = self._rng.choice(len(valid), p=probs)
local_mapped_idx = valid[chosen]
raw_is_weight = np.float32(1.0 / (len(valid) * probs[chosen]))
...
# 文件后段:按 episode 长度再归一化一次
item["is_weight"] = raw_is_weight / np.float32(ep_len)
这段代码的核心是那行注释里的公式:最终写进样本的 is_weight 等于
1
N
⋅
p
i
⋅
ep_len
\\frac{1}{N \\cdot p_i \\cdot \\text{ep\\_len}}
N⋅pi⋅ep_len1。
1
N
⋅
p
i
\\frac{1}{N \\cdot p_i}
N⋅pi1 是标准的逆采样重要性权重,恰好抵消 _load_priorities 里那次过采样;再除以 ep_len 把不同长度 episode 的贡献拉平,避免长轨迹因为帧多而在辅助头损失里占更大话语权。关键是最后一句注释——这个 is_weight 对 RL、BC、DAgger 每一类数据源定义完全相同,所有辅助损失都乘它。也就是说,动作流匹配损失走「采样加权、损失不加权」,辅助头走「采样加权、损失乘 is_weight 反向抵消」,两条路合起来正是「动作要偏、辅助头不能偏」这条约束的落地。loss_weights.py 顶部的文档字符串把这个 is_weight 明确写成「1 / (N · p_i) / ep_len — fully unbiases sampling AND normalises contribution per episode in one step」,一步同时干了去偏和归一两件事。
4. 第二条核心机制:RECAP 优势条件输入,直接告诉模型「要好动作」
4.1 设计动机:为什么不用 PPO
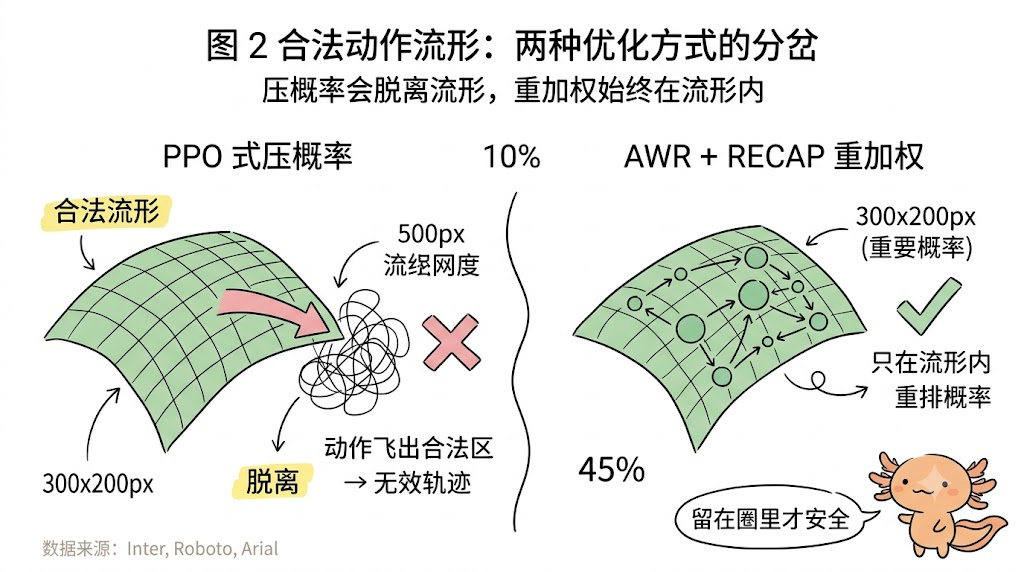
放弃 PPO、GRPO 这类主流策略梯度算法,有两个底层原因。第一,这些算法全部基于对数似然的策略梯度更新,天然难以适配流匹配 VLA 的生成式动作输出——流匹配没有显式的动作概率密度可以求梯度。第二个原因更本质:流匹配模型的合法动作只占据高维空间里一小块流形曲面,任何通过「压低坏动作概率」来优化的梯度算法,都会把预测推出这个合法流形,输出完全无效的机械臂轨迹。这里要厘清的是,AWR + RECAP 这类条件加权算法全程不脱离合法流形,它只在模型本身能生成的动作分布内重新分配采样概率,代价是自主探索能力弱——但本任务要的是稳定完成折叠,不是探索新花样,这个取舍完全对得上。
4.2 RECAP 式条件输入怎么接进网络
RECAP 是 Physical Intelligence 提出的优势条件输入思路。它的做法是把时序优势当成模型的一个独立输入令牌,直接引导模型「只预测高收益动作」。在这套方案里,RL 训练阶段每一帧都携带实时计算的优势值,作为独立分组的优势令牌喂进网络。训练时用掩码控制:低优势样本永久掩码掉优势令牌(不给信号),中等及以上样本随机掩码,掩码概率从 0.5 线性降到 0.1。这个随机掩码是为了推理时能做无分类器引导(CFG)——训练时既见过「有优势条件」也见过「无优势条件」,推理时才能把两条通路对比出方向。
4.3 工程细节:推理阶段的无分类器引导
推理时优势令牌永久启用,并行跑「有优势条件」和「无优势条件」两条动作专家前向通路,做无分类器引导。这个做法从图像生成领域借来,思路是用两条通路的差值指出「优势条件把动作往哪个方向拉」,再把这个方向按系数放大,让模型更果断地朝高优势动作走。公式写出来是:
v
guided
=
v
uncond
+
s
⋅
(
v
cond
−
v
uncond
)
v_{\\text{guided}} = v_{\\text{uncond}} + s \\cdot \\bigl(v_{\\text{cond}} – v_{\\text{uncond}}\\bigr)
vguided=vuncond+s⋅(vcond−vuncond)
其中
v
cond
v_{\\text{cond}}
vcond 是带优势条件的速度场预测,
v
uncond
v_{\\text{uncond}}
vuncond 是无条件预测,
s
s
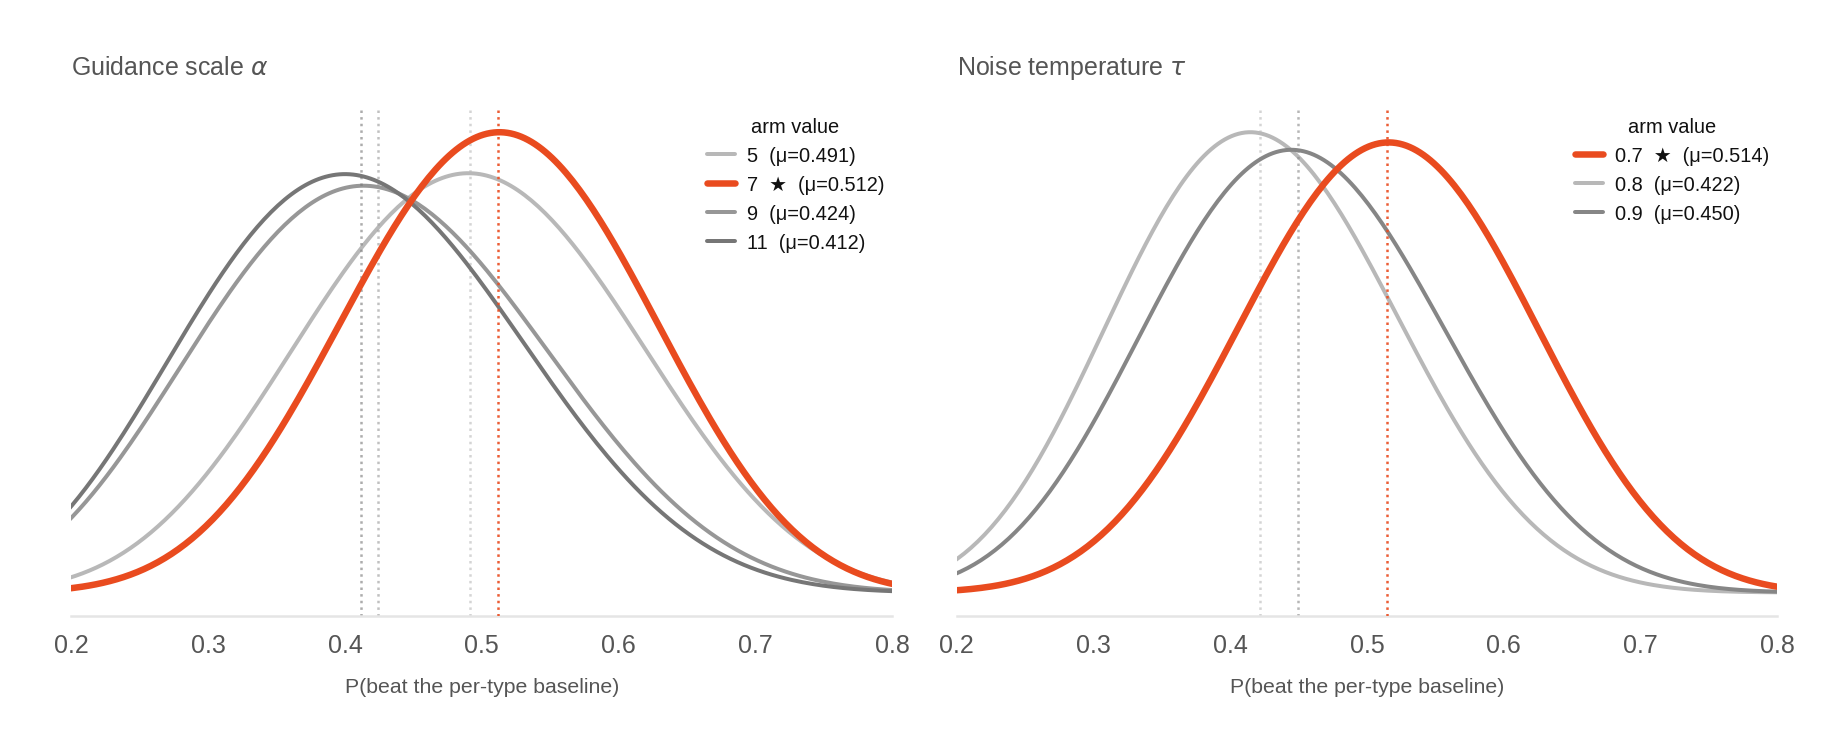
s 是每类织物单独优化的引导缩放系数(仿真赛道收敛到 7–9)。这里的工程亮点是,两条通路共享昂贵的视觉前缀计算,只重复轻量的动作专家部分,所以 CFG 的额外开销很小。这意味着,同一套训练好的权重,推理时只要把
s
s
s 调大,就能让模型更「果断」地朝高优势动作走,成功率能明显提升而不用重训。
5. 数据采集系统:柔性物体的采集技巧全在这里
5.1 采集的第一性原理:仿真时长是唯一瓶颈
叠衣服数据采集的核心约束是一句话:仿真引擎单集完整跑一次约 30 秒,仿真速度就是整套系统的算力天花板,所有采集优化的目标只有一个——最大化单位仿真时长产出的有效训练样本。这决定了采集系统的每一个设计。竞赛仿真环境不支持单进程多场景渲染,所以单机启动 3–5 个独立仿真进程,全部作为无状态策略服务器的轻量客户端,客户端本地缓存已算好的动作分块减少重复推理。任务一旦成功仿真立刻停止;基于机械臂状态、执行动作、预测价值方差搭一个卡死检测器,识别没希望的失败单集提前截断;后台守护进程自动重启卡死的仿真实例。这些看似琐碎,但对一个 30 秒一集、要跑上万集的系统,省下的每一秒都是真金白银。为了让整套采集系统的数据流一目了然,下面用一张流程图把「怎么跑一集、怎么分流、怎么回流训练」串起来。
5.2 仿真怎么被驱动:HTTP 三命令遥控 Isaac Sim
这里要厘清一个容易被忽视的架构事实:开源的 lehome_solution 仓库不含仿真本体,它只是一个策略服务器。真正的布料物理、粒子仿真、三相机渲染全在作者 fork 的 Isaac Sim 定制版仿真环境里跑(IliaLarchenko/lehome-challenge)。仓库 README 写得很直白,这个 fork「lets me collect privileged simulation data during rollouts」——它专门加了逻辑,让采集时能拿到仿真特权数据。换句话说,你翻遍这套代码都「看不到仿真」,是因为仿真被抽象成了一个通过 HTTP 通信的外部黑盒,策略服务器是大脑、Isaac Sim 是身体。
两者之间的通信协议一共只有三个命令,定义在 remote_command_server.py 开头,Isaac Sim 作为客户端反复 POST 给策略服务器,服务器只回动作和几个控制标志,物理推进完全在仿真那侧:
# src/lehome_solution/eval/remote_command_server.py(仓库原文节选)
# POST /reset {…} -> {} garment_info / augmentation_info / restore_snapshot
# POST /infer {obs…} -> {"actions": [12], "stop"?, "save_state"?, "n_steps"?}
# POST /snapshot {state} -> {}
一集仿真的完整生命周期就是这三个命令的循环。/reset 起一集:Isaac Sim 问服务器要任务,服务器回一个载荷;你前面问的「怎么恢复到坏状态」就藏在这个载荷的 restore_snapshot 字段里——如果这是一次困难挖掘或回放,服务器把之前存的物理快照塞进去,Isaac Sim 收到后不是随机摆一块新布,而是把 garment_points(布料粒子坐标)、garment_velocities、关节角逐个写回 PhysX 场景。/infer 一帧帧推进:Isaac Sim 渲染出三路相机图 POST 给服务器,服务器跑策略回 12 维动作,返回里还带两个特殊字段 stop(成功了让仿真停)和 save_state(请求 Isaac Sim 存快照)。/snapshot 回传物理态:当服务器判断这一帧值得存,就在 /infer 回包里标 save_state=True,Isaac Sim 下一步就 POST 一个 /snapshot 把物理数组回传:
# scripts/eval_worker.py(仓库原文节选)
elif msg_type == "state_snapshot":
failure_state_snapshot = snapshot_data # 仿真把物理态回传,服务器接住存盘
这就解答了「柔性物体每次都不一样、到了错误状态后面没有正确数据」的核心疑问。破解办法是:物理快照存的是浮点坐标数组,/reset 带 restore_snapshot 时 PhysX 把这些坐标一个不差地写回去,所以同一个坏状态能被无限次精确复现——不是「找一个相似的坏布料」,是「把那一个特定状态原样加载回来」。有了可精确复现的坏状态,策略就能在它上面反复重试(同一个 restore_npz 发起 max_attempts 次 /reset,每次去噪噪声不同、走出不同动作),配合 _flush_episode 那条「只存成功、失败全丢」的铁律,正确数据就由策略自己撞出来,不需要任何人类标注。
难点提示(为什么这招只在仿真里成立):能存取 garment_points 这种粒子级物理态,是仿真独有的特权。真机上你没法把一块真布「恢复」到某个粒子坐标,物理世界没有存档读档。这就是为什么第 8 节 sim-to-real 时,依赖关键点和物理态的预测头必须整个删掉,也是为什么实体端的故障恢复只能改用人工 DAgger 硬摆——快照回放这套杀手锏,出了仿真就失效。
5.3 六种采集策略与物理快照回放
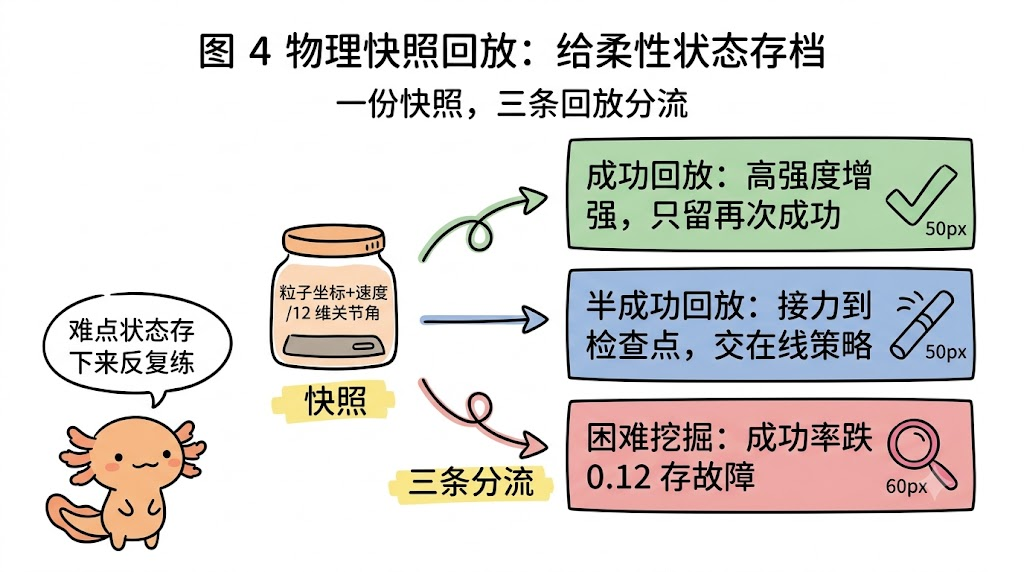
方案设计了 6 种差异化采集策略,区分织物采样逻辑、增强强度、初始状态。这里最关键的技巧是物理状态快照:仿真中途把布料的粒子坐标速度、机械臂全部关节状态存成快照,随时可以重载复现当前布料形态。这个能力是柔性物体采集的杀手锏,因为柔性状态没法用几个参数描述,只能整体存档。基于快照衍生出三类回放策略:
- 成功回放(success replay):单集成功的第 5 帧存快照,低成功率织物的成功快照 100% 强制留存。重载时施加高强度数据增强,只保留再次成功的轨迹,专门扩充稀缺的完美样本池。
- 半成功回放(semi-success replay):抵达中间检查点、预测成功率长期偏高但最终没完全成功的近失败快照,重载后交给在线策略自主完成,或转入人工修正队列。
- 困难挖掘(hard mining):当 EMA 平滑的成功率预测相对历史峰值下降超过 0.12、且峰值大于 0.25 时存故障快照,专挖模型容易失误的场景。
工程价值:物理快照回放解决的是柔性物体最头疼的「稀缺状态复现」问题。刚性物体你想复现某个状态,重新摆一次就行;柔性布料的某个褶皱状态几乎不可能手工复现。存快照等于给了你一个「时光机」,让模型在同一个难点状态上反复练习,直到练会为止。
5.4 双层数据增强引擎:泛化能力的来源
不可见织物的泛化能力主要靠大规模域随机化数据增强。方案设计了两层独立的扰动逻辑。第一层是单集初始化增强,仿真重置时随机生成、随物理快照同步存储、回放时可完整复现,包含织物纹理全局替换、LAB 色彩空间重映射、织物位姿缩放粗糙度扰动、相机位置旋转焦距抖动、机械臂底座偏移、桌面纹理变换、光源旋转。注意一个细节:缩放、粗糙度、机械臂底座偏移会改变仿真动力学,重载快照时必须自动关闭这类增强,否则布料的物理运动就变了,快照就失效了。第二层是逐帧动态增强,每几帧重新随机一组扰动,包含全局色调、机身颜色、光源亮度色温实时变化。
下面直接看仓库 pipeline_config.py 里增强配置类的原文节选。重点不在参数多,而在每个参数的注释——仓库明确用 physics-affecting / visual only 两个标签区分哪些增强能在回放时保留、哪些必须关,这正是柔性物体增强与刚性物体增强最大的区别所在。刚性物体你随便改缩放光照都行,柔性物体一旦在回放时动了影响动力学的参数,快照记录的布料运动就整个失真、这条轨迹也就白采了:
# src/lehome_solution/training/pipeline_config.py(仓库原文节选,含原注释)
class GarmentAugmentationConfig:
# Episode-level(env.reset 后施加一次,随快照存储、回放复现)
pattern_swap_p: float = 0.0 # 织物纹理替换概率
color_remap_p: float = 0.0 # LAB 色彩空间重映射
scale_range: float = 0.0 # e.g. 0.1 → scale ∈ [0.9,1.1];成功阈值自动调整
roughness_range: float = 0.0 # 粗糙度扰动
# 下面两项标注 physics-affecting → 在 visual_only 回放里被跳过;
# 存下来的值在 hard-mining 回放里复用(保证动力学一致)
arm_xy_shift: float = 0.0 # per-arm XY base shift (meters), physics-affecting
arm_rot_z_deg: float = 0.0 # per-arm Z-axis base rotation, physics-affecting
table_uv_shift: float = 0.0 # UV-space translation on table texture (no physics)
camera_focal_jitter: float = 0.0 # 相机焦距抖动(visual only)
light_dome_rot_deg: float = 0.0 # 穹顶光源旋转(visual only)
# Per-step(每渲染步施加,不随快照存储)
step_color_tint: bool = True # 逐帧色调 scale+bias 随机
light_intensity_range: float = 0.0
light_color_temp_range: float = 0.0 # 6500K 附近色温半宽
这段仓库原文的关键不在参数值(默认全 0,靠 YAML 配置覆盖),而在那几行原注释里的 physics-affecting 标签。增强被明确分成两类:visual only(纹理、色彩、相机焦距、光照)随便加,physics-affecting(缩放、粗糙度、机械臂底座 XY/Z)在 visual_only 回放里被跳过。仓库对 arm_xy_shift 的原注释写得很清楚——「physics-affecting,skipped in visual_only replays;saved value reused for hard-mining replay」,也就是说底座偏移这类值会被存下来,困难挖掘回放时原样复用,保证布料动力学和快照完全一致。为什么要这么分?因为回放的整个意义是复现同一个布料动力学状态,一旦回放时改了缩放或底座,布料运动就和快照对不上,这条轨迹就学不到有效信息。另外注意结构上 episode-level(重置时一次、随快照存储)和 per-step(每帧重随)是两层,正好对应正文说的「双层」。工程上增强强度分三档:常规在线推理轻度,成功回放拉满,sim-to-real 阶段 pattern_swap_p 飙到 0.8 且参数按实体设备校准。
5.5 异步人工 DAgger:当策略自己都救不回来时
前面 5.3 讲的快照回放有一个天花板:如果布料被彻底搞崩,策略自己怎么试都撞不出一次成功,这个状态就永远产不出正样本,反复重试也是白搭。这正是第 4.1 节说的——AWR+RECAP 只能在策略本身够得着的动作分布里筛,超出能力范围的崩坏状态无解。DAgger(Dataset Aggregation,数据集聚合)就是补这个洞的:让人把策略够不着的坏状态先救回到它够得着的范围。
仿真端 DAgger 的架构在 dagger_collect.py 头部写得很清楚,是一条跨三个进程、三个 Python 环境的流水线,因为遥操作硬件驱动和仿真渲染依赖不同的依赖栈,只能拆进程用管道和 WebSocket 串起来:
# scripts/dagger_collect.py(仓库原文节选)
# SO101 Reader (challenge venv) –stdout–> Controller (main venv) –WebSocket–> Isaac Sim
#
# Loads failure NPZ files (saved during eval rollouts), restores physics state in
# Isaac Sim, lets the user teleoperate with SO101 leaders to recover from failures.
# Successful recoveries are saved as training data in the same PKL format as eval.
这段注释把机制讲全了。第一步,加载常规采集时存下的故障 NPZ 快照,用 5.2 讲的 /reset 带 restore_snapshot 把物理态恢复进 Isaac Sim。第二步,人手握两台 SO101 主臂遥操作,主臂的关节读数经 SO101 Reader 采出、Controller 转换、WebSocket 送进 Isaac Sim 驱动从臂,把崩坏的布料短时修正回一个正常形态。第三步,改完交还模型自主折叠,只有模型最终真的完成了,整条「人工修正 + 模型收尾」的轨迹才存进训练集(和 eval 用同一套 PKL 格式)。这里有个关键的数据细节:DAgger 是纯遥操作,没有模型前向、没有价值预测,所以 success_pred、success_minus_vhat 这些字段全写 NaN,训练时靠 NaN 掩码跳过——DAgger 样本只贡献动作监督,不参与优势计算。
全异步设计是效率关键:常规采集时自动存故障快照堆着,操作员只花几秒做局部修正,不用等仿真慢吞吞加载,多台仿真并行跑,人几乎没有空等。但这里有个诚实的复盘:仿真端 DAgger 实用性极低,因为通过仿真界面遥操作布料太难,等整套工具调好,模型自主折叠已经比人工遥操作还强了。真正的价值在实体机器人端。
实体 DAgger 的采集用 record_real_dagger.py,机制不同:人和策略共享一集,按空格键在「手动」和「自主」之间实时切换,模型正常跑、觉得要出错时人一把接管。难点在于实体没有仿真特权奖励标签、算不了时序优势,所以采样权重是基于人工干预时序手工分配的。规则在 data_loader.py 的 DaggerSamplingConfig:
# src/lehome_solution/training/data_loader.py DaggerSamplingConfig(仓库原文节选)
human_weight: float = 1.0 # 人工修正帧:最高权重
auto_weight: float = 0.5 # 远离干预的自主帧:中等权重
pre_intervention_min_weight: float = 0.0 # 干预前一刻的自主帧:权重降到 0
pre_intervention_window_seconds: float = 5.0 # 干预前 5 秒的窗口
# 窗口内自主帧权重从 auto_weight(窗口边缘) 线性 ramp DOWN 到 min_weight(干预点)
这套加权的精髓在 pre_intervention_min_weight=0 那条。人为什么要干预?因为策略在干预前那几秒做了错误动作把布料搞砸了。 如果照单全收这些帧,等于在教模型「怎么把事情搞砸」。所以干预前 5 秒窗口内的自主帧,权重从 0.5 线性降到 0——越接近人出手的那一刻、越是「导致出错的元凶动作」,权重压得越低直到清零。写成分段形式就是:
w
t
=
{
1.0
人工修正帧
0.5
自主帧,距干预
>
5
s
0.5
⋅
Δ
t
5
s
自主帧,距干预
≤
5
s
w_t = \\begin{cases} 1.0 & \\text{人工修正帧} \\\\ 0.5 & \\text{自主帧,距干预} > 5\\text{s} \\\\ 0.5 \\cdot \\dfrac{\\Delta t}{5\\text{s}} & \\text{自主帧,距干预} \\le 5\\text{s} \\end{cases}
wt=⎩
⎨
⎧1.00.50.5⋅5sΔt人工修正帧自主帧,距干预>5s自主帧,距干预≤5s