文章目录
-
- 一分钟速览
- 接触为什么难:稀疏会把误差放大,时变又要求协同
-
- 第一难:奖励塑形能换来鲁棒,却换不来结构
- 第二难:参考轨迹把问题从控制挪到了「生成参考」
- 第三难:人类不是盯着脚下,而是前瞻地选接触
- 把整条参考轨迹压成 9 个身体接触点
-
- 接触计划长什么样:9 个部位、1.5 秒视野
- 为什么接触比轨迹更适合当地形上的接口
- 与足式、全身控制基线的差别:输入不是轨迹,是接触指令
- 注意力怎么建模接触:在地形点上选,而不是在三维空间里回归
-
- query、key、value 分别是什么
- FiLM:让 9 个身体各有自己的 query
- 训练目标:软高斯标签加占用交叉熵
- 它比 MLP 基线还少参数
- 三段式训练:先学会执行接触,再学会挑接触,最后自己找接触
-
- 第一段:让追踪器先学会执行接触
- 第二段:规划器与追踪器共训,接触指令按概率移交
- 第三段:自举——用控制器跑成功的轨迹反过来监督规划器
- 后见之明打标签:只学控制器真能做到的接触
- 训练成本
- 感知这一层:为什么 LiDAR 建图要自己重做一遍
-
- 三种填充模式:保留实测、取邻域平均、或者留空
- 悬垂结构的融合先验:别让地面把梯级擦掉
- 机上跑得动
- 仿真评测:口径先说清,四组消融各自回答一个问题
-
- 只用接触够不够
- 微调把最难的类别抬了 54.8 个百分点
- 注意力对 MLP:优势集中在稀疏全身与干扰物
- 与 MGMT 和真机:11 个类别全胜,组合赛道 92.5% 对 58.8%
-
- 定量对比:最接近的前作差在哪
- 真机上做到了什么
- 我认为最有价值的三个发现
-
- 发现一:接触是比轨迹更经得起换地形的监督
- 发现二:目标位姿是接触模式的选择器
- 发现三:自举让规划器学「控制器真能做到」的接触
- 顺带一个:失败恢复是涌现的
- 适用边界:作者自己圈出的三条线
-
- 边界一:面向 2.5 维、以地形为中心的交互
- 边界二:只有局部目标,没有全局导航
- 边界三:没有可区分接触序列的空中动作做不到
- 我自己读出来的两点保留
- 我读完之后的几点提炼
- 术语速查
- 复现时最容易踩的七个坑
- 关键数字一页速查
- 常见问题
-
- 部署时到底需不需要参考动作?
- 92.5% 对 58.8% 是在真机上测的吗?
- 为什么不直接让扩散模型生成未来动作?
一个会爬梯子、会翻墙、会趴在箱面上匍匐前进、也能自己从地上爬起来的人形机器人,部署时手里什么都没有:没有预先录好的参考动作,没有运动匹配检索,没有扩散模型每帧现生成一段未来动作。它只看三样东西——头戴 LiDAR 建出来的地形图、自己的本体感觉、一个目标位姿——然后用同一条策略把台阶、梯子、跳箱、独木桥、碎石堆全部跑完(图 1)。
反差数字在仿真里:八条把稀疏落脚点和全身障碍串起来的组合赛道上,这套方法的平均成功率 92.5%,最接近的前作 MGMT 是 58.8%(Sec. C.4)。更能说明问题的是另一个消融——把整条参考轨迹换成 9 个身体部位的接触点之后,追踪器在四类参考地形上每一类都还有至少 98.5% 的成功率;再额外喂给它 52 维参考运动学,也没有一致提升(Sec. C.1、Fig. 7A)。
arXiv:2610.31608v1 的《Humanoid Mobility via Attention-based Contacts》改的不是策略网络的规模,而是「参考动作」这个角色:它从部署时必须复现的目标,变成训练期的一份先验;而这份先验被压缩成接触——哪个部位、什么时候、落在环境的哪个点上。作者把接触放在感知与控制之间,当成一个接口来用。
一分钟速览
- 解决的问题:人形机器人在稀疏、组合、没见过的地形上做全身运动,而部署时一条参考动作都不给。
- 关键抽象:把参考动作压成 9 个身体部位的目标接触位置与占用标志,规划视野 1.5 s。
- 怎么预测:注意力从 187 个地形点上选点,本体感觉与目标经 FiLM 变成 9 个部位各自的 query。
- 怎么训练:三段式——先训接触条件追踪器,再让规划器与追踪器共训,最后在程序化地形上用成功轨迹自举。
- 关键数字:只用接触时参考地形每类成功率至少 98.5%;稀疏全身地形微调后提升 54.8 个百分点;八条组合赛道 92.5% 对 MGMT 的 58.8%。
- 真机:Unitree G1,全部感知与推理在机载 Jetson Orin 上跑,演示了爬梯、翻墙、匍匐、起身与失败恢复。
- 边界:2.5 维地形中心交互、只有局部目标、没有可区分接触序列的空中动作做不到。
 图 1|同一套策略在真机上的十个场景:爬梯、翻墙、匍匐、跳箱、上下台阶、跳下、踩点、起身与坐下
接触为什么难:稀疏会把误差放大,时变又要求协同
论文开篇把问题定位得很清楚:在人构环境里跑,稳定的双足行走远远不够。要跨过零散落脚点、爬上障碍、钻进狭窄空间、甚至用上半身撑住自己,这些多接触行为已经偏离了传统移动的范式——不再遵循一个规定好的脚部接触节律,而是必须持续决定自己与环境交互的空间、时间和解剖分布(Introduction)。
第一难:奖励塑形能换来鲁棒,却换不来结构
纯强化学习这条路在四足和人形上都被证明很能打,粗地形、稀疏地形、跑酷都有结果。但论文指出,把这套范式推到全身运动时会撞上一个巨大的组合空间:机器人要同时决定哪些身体部位建立接触、这些接触在空间和时间上怎么分布、剩下的自由度怎么协调。把这些交互间接编码进任务目标里,意味着大量的奖励塑形,而「微小的调整可能带来截然不同的接触策略」(Introduction)。我认为这句话是全文的出发点:问题不是强化学习不够强,而是奖励信号本身不带结构。
第二难:参考轨迹把问题从控制挪到了「生成参考」
另一条路是直接给结构——用参考动作。运动模仿类方法把行为发现问题改写成受限追踪问题,配上大动作数据集与运动重定向之后,确实能产出协调、像人的全身动作。但论文点出一个部署时的位移:追踪控制器只有在当前环境能先生成一条合适的参考时才有用;到了没见过的地形,核心问题就从控制变成了参考生成。基于模型的全身规划器能补上这一段,代价是部署时挂一个可能很贵的模块,而且会继承规划系统自己的建模假设与失效模式。
第三难:人类不是盯着脚下,而是前瞻地选接触
论文给出的支点来自生物学:有研究在自然户外地形上同时记录注视与全身运动学,发现人会根据地形的复杂度调整注视行为,并保持一个一致的时域前瞻策略;对即将到来的地形的感知,与随后关于接触位置的决策是紧耦合的(Introduction 引用该工作)。这解释了为什么把完整轨迹压成接触不是偷懒:在几何受限的地形上,成败的关键在于识别未来的接触该发生在哪里,而不是把通往那里的整条身体轨迹规定死。
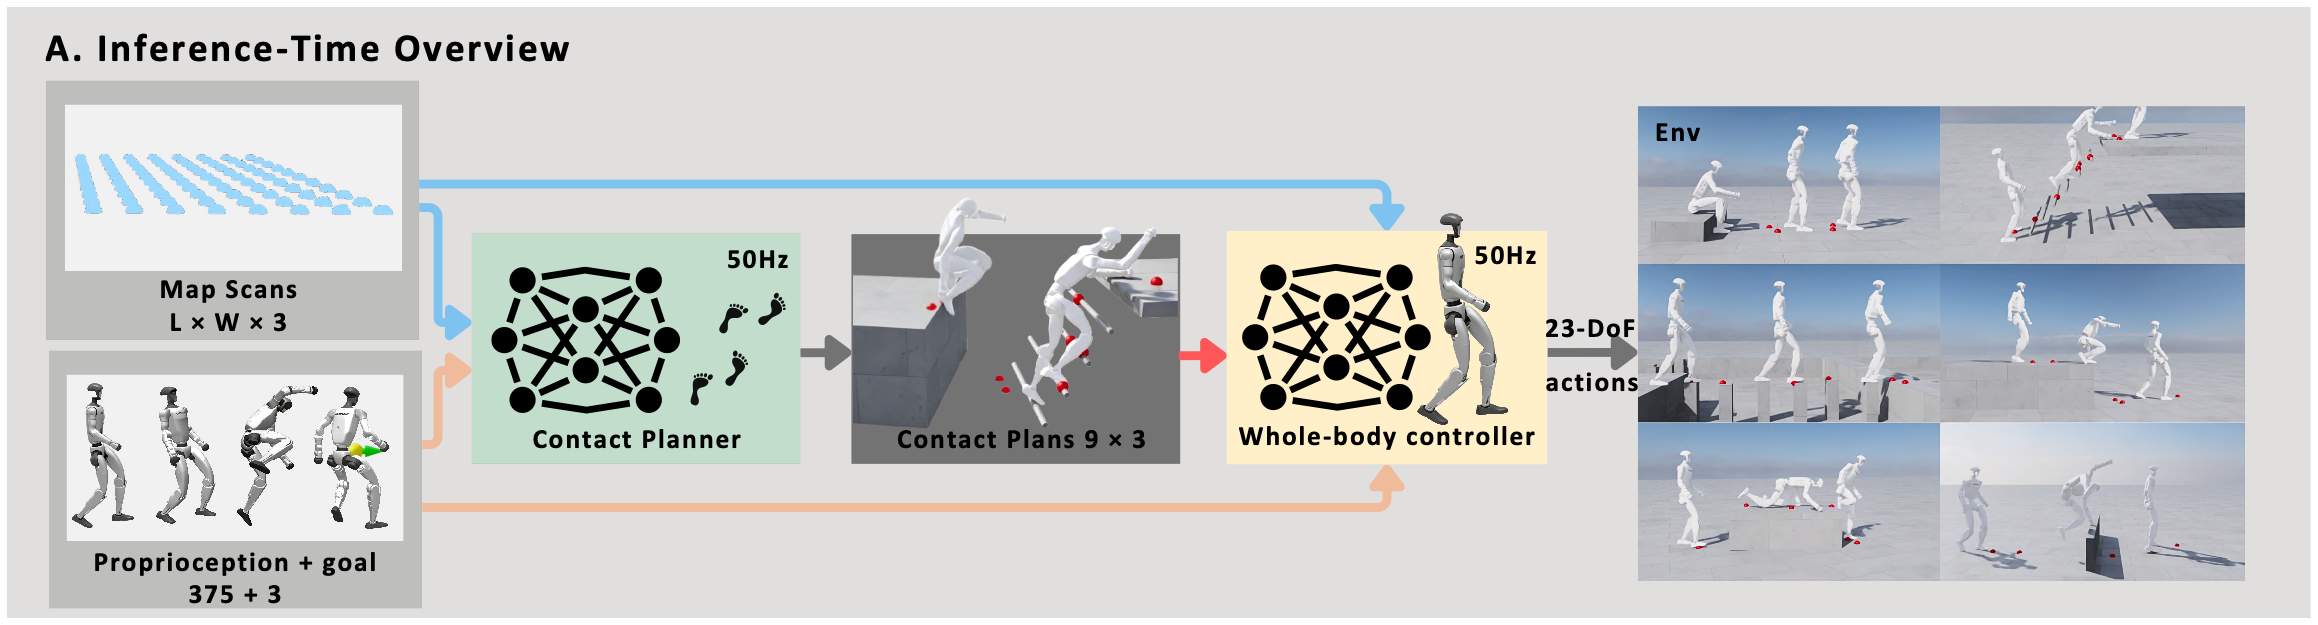 图 2|部署时的闭环:地图扫描进接触规划器,本体感觉与目标同时喂给规划器与全身控制器,两者都在 50 Hz 输出
把整条参考轨迹压成 9 个身体接触点
接触计划长什么样:9 个部位、1.5 秒视野
规划器每个控制步为 9 个可接触部位输出计划:双脚、双膝、双手、双肘、骨盆。每个部位给两样东西——一个目标接触位置,和一个二值占用标志,表示在这个规划视野内该部位是否会有一次新的接触(Sec. Attention-based Whole-Body Contact Planner)。位置表达在以机器人基座为中心、随偏航旋转的重力对齐坐标系里,因此对机器人的世界位置和朝向都不变。视野是 1.5 s;若某部位在视野内没有接触,输出置零。用 9 个部位而不是只有双脚,是这条设计能描述真正的多接触、而不只是「一串落脚点」的前提。
为什么接触比轨迹更适合当地形上的接口
论文举的例子很直观:手撑在台沿上,约束的是必须有这一次环境交互,但它并不唯一确定手臂、躯干和腿的动作轨迹——同一组接触可以有很多条动力学可行的全身轨迹去实现(Discussion)。这就把监督的维度压下来了,从整条轨迹变成 9 组「位置加标志」。而且接触位置直接表达在环境上,稀疏支撑面上需要的几何精度就落在它该在的地方,而不是散在一大把运动学维度里。
与足式、全身控制基线的差别:输入不是轨迹,是接触指令
差别在追踪器的接口上最明显。追踪器接收五步本体感觉历史、9×7 局部高度扫描、9 个接触目标以及目标指令;无效的接触目标编码成零向量(Sec. Contact-Informed Whole-Body Tracker)。它不知道参考动作的手肘在哪、膝关节角度多少,只知道这里要落一下(图 2)。对照也很直接:给追踪器额外加 52 维参考根与关节运动学,成功率没有一致提升(Sec. C.1)。至于和前作的关系,论文自己做了一张能力表——与 PHP、LLP 相比,本文在稀疏全身接触、地形组合、免手动数据增广、免手动过渡设计这四项上打勾,动作数据长度为 13.2 min(PHP 为 9.4 min,且是镜像与运动匹配增广之前的数字)。
| 稀疏落脚点 | 未演示 | 支持 | 支持 |
| 稀疏全身接触 | 未演示 | 未演示 | 支持 |
| 地形组合 | 未演示 | 有限 | 支持 |
| 免手动过渡设计 | 否 | 否 | 是 |
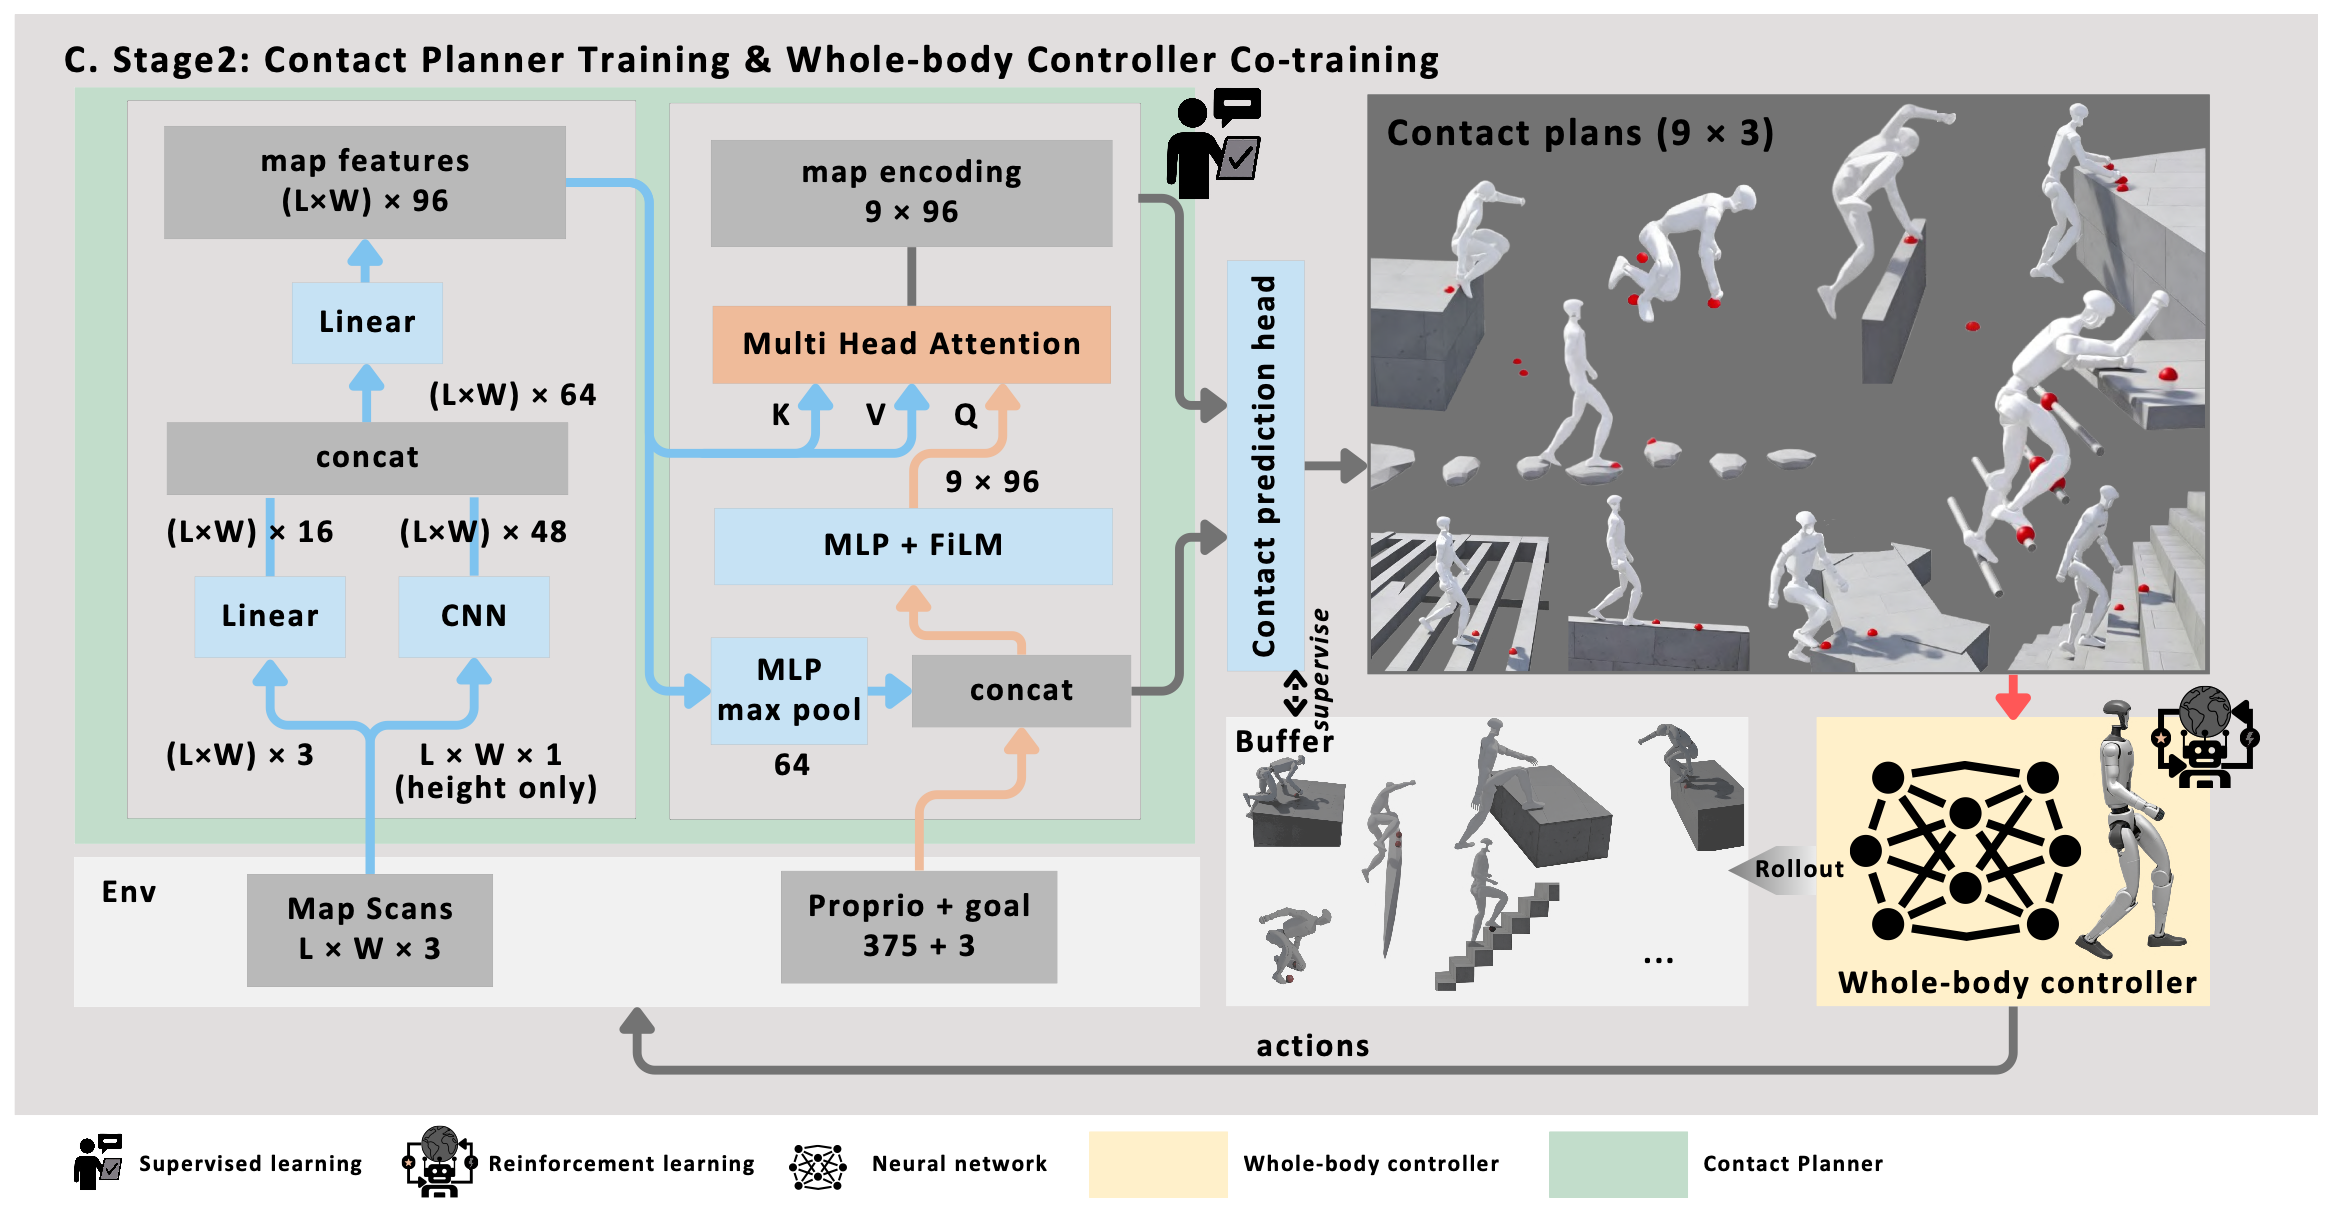 图 3|接触规划器的内部结构:地形点做 key 与 value,本体感觉加目标经 FiLM 变成 9 个部位各自的查询
注意力怎么建模接触:在地形点上选,而不是在三维空间里回归
query、key、value 分别是什么
核心的设计选择是:规划器从感知到的表面上选接触,而不是在自由三维空间里回归接触。地形这一侧是 17×11、共 187 个三维地形点,间隙 0.1 m,覆盖 1.6×1.0 m;两层 5×5 卷积编码器提取局部地形特征,再和逐点线性特征一起构成注意力的 key 与 value。机器人这一侧,五步本体感觉历史、目标指令、64 维池化地形特征被编码成一个共享的 96 维向量。
FiLM:让 9 个身体各有自己的 query
接下来是我最认可的一处细节。共享向量本身不足以区分这只手和那只脚,所以每个接触部位有一个学出来的 embedding,经 feature-wise linear modulation(FiLM)生成逐通道的 scale 与 bias,把共享向量变形成 9 个部位专属的注意力 query。多头注意力以注意力维度 96、32 个头计算,为每个部位在 187 个地形点上给出一组 affordance 权重;解码器取 top-k 个点、用归一化并带温度缩放的权重组合,定量评估里取 k=1,于是每个保留的接触目标都精确落在一个被观测到的地形点上。占用概率由分类头给出:把该部位的注意力输出与池化地形上下文拼起来,过 sigmoid(图 3)。
训练目标:软高斯标签加占用交叉熵
规划器是监督着训的,标签来自追踪策略自己的 rollout。对每个有有效接触的身体部位,把目标位置转成 187 个地形点上的软分布:以目标点为中心放一个各向同性三维高斯,带宽 0.1 m,再归一化(式 1,Sec. Three-Stage Training Pipeline)。损失由两部分组成——在有效接触上平均的掩码交叉熵,和在全部 9 个部位上平均的二值交叉熵(式 2)。论文特意说明了为什么必须用软的三维目标而不是 one-hot 格子:在梯子横档这类细支撑上,水平方向上最近的那个格子可能整个错过结构。
规划器的监督目标与损失在原文里是两个式子。第一个把目标位置摊到 187 个地形点上(式 1,Sec. Three-Stage Training Pipeline):
p
b
,
i
∗
=
exp
(
−
∥
h
i
−
p
b
∗
∥
2
2
/
2
σ
a
2
)
∑
j
=
1
L
W
exp
(
−
∥
h
j
−
p
b
∗
∥
2
2
/
2
σ
a
2
)
,
L
W
=
187
p^{*}_{b,i}=\\frac{\\exp\\left(-\\lVert h_i-p^{*}_{b}\\rVert_2^2 / 2\\sigma_a^2\\right)}{\\sum_{j=1}^{LW}\\exp\\left(-\\lVert h_j-p^{*}_{b}\\rVert_2^2 / 2\\sigma_a^2\\right)},\\qquad LW=187
pb,i∗=∑j=1LWexp(−∥hj−pb∗∥22/2σa2)exp(−∥hi−pb∗∥22/2σa2),LW=187
其中 h 是体偏航坐标系下的地形点,σa 取 0.1 m。第二个是损失:前一项是在有效接触上平均的掩码交叉熵,后一项是在全部 9 个部位上平均的占用二值交叉熵(式 2,同节):
L
p
l
a
n
n
e
r
=
−
∑
n
=
1
N
∑
b
=
1
9
c
n
,
b
∗
∑
i
=
1
L
W
p
n
,
b
,
i
∗
log
α
n
,
b
,
i
max
(
1
,
∑
n
=
1
N
∑
b
=
1
9
c
n
,
b
∗
)
−
1
9
N
∑
n
=
1
N
∑
b
=
1
9
[
c
n
,
b
∗
log
c
^
n
,
b
+
(
1
−
c
n
,
b
∗
)
log
(
1
−
c
^
n
,
b
)
]
\\mathcal{L}_{planner}=-\\frac{\\sum_{n=1}^{N}\\sum_{b=1}^{9}c^{*}_{n,b}\\sum_{i=1}^{LW}p^{*}_{n,b,i}\\log\\alpha_{n,b,i}}{\\max\\left(1,\\sum_{n=1}^{N}\\sum_{b=1}^{9}c^{*}_{n,b}\\right)}-\\frac{1}{9N}\\sum_{n=1}^{N}\\sum_{b=1}^{9}\\left[c^{*}_{n,b}\\log\\hat{c}_{n,b}+\\left(1-c^{*}_{n,b}\\right)\\log\\left(1-\\hat{c}_{n,b}\\right)\\right]
Lplanner=−max(1,∑n=1N∑b=19cn,b∗)∑n=1N∑b=19cn,b∗∑i=1LWpn,b,i∗logαn,b,i−9N1n=1∑Nb=1∑9[cn,b∗logc^n,b+(1−cn,b∗)log(1−c^n,b)]
读这两个式子的关键在分母:掩码交叉熵的分母是有效接触数(至少为 1),所以没有接触的样本不会稀释梯度;占用项则固定除以 9N,保证每个部位的分类都被同等监督。两项的相对权重在 Table S5 里都是 1.0,也就是按 1 比 1 直接相加。
它比 MLP 基线还少参数
论文的对照是一个参数量相当的 MLP 规划器:把扁平高度扫描直接映射成逐部位接触计划。按 Table S3,注意力规划器 786,993 个参数,MLP 基线 833,322 个——也就是说注意力的优势不是靠多堆参数换来的。这个对照做得比较规矩:两者共享同一套接触接口、同一份监督、同一个地形点解码器,只有网络结构不同。
三段式训练:先学会执行接触,再学会挑接触,最后自己找接触
第一段:让追踪器先学会执行接触
第一段只训追踪器,参考动作来自一个经过约束的运动重定向流程:人体动作先统一到浮动基座加笛卡尔 landmark 的表示,做空间缩放与时间归一化,然后对基座位姿与关节构型解非线性逆运动学,位置目标追髋、膝、踝、趾、肩、肘、手、胸、头,朝向目标对齐肢体段方向,同时加关节限位、脚部的单边地面约束、以及防止与箱子台阶梯级穿模的最小距离约束,再加时间正则抑制帧间抖动(Sec. Contact-Informed Whole-Body Tracker)。接触也在这一步被显式检测并记录:骨盆、膝、脚、肘、手,配上世界坐标系下的接触位置与时间表。追踪器是一个三层多层感知机(512/256/128,ELU),输入 468 维(375 维本体感觉历史、63 个高度采样、27 个接触坐标、3 维目标指令),输出 23 个关节位置偏移,50 Hz,乘 0.25 后叠加到默认关节构型上,交给 200 Hz 的关节 PD。
训练上有个小设计值得记:Curriculum State Initialization。每个 episode 从参考片段靠后的相位开始(初始相位 0.9),追踪变好再把起点往前提——先学会把每个片段收尾,再被要求从头执行完整动作。
第二段:规划器与追踪器共训,接触指令按概率移交
第二段引入规划器,在同一批参考地形上与追踪器一起训。规划器的监督来自成功 rollout 的回放缓冲,标签用后见之明打(见下)。同时接触指令的归属做了一次渐进移交:每个控制步、每个环境独立地以概率 ηobs 收到规划器预测的接触,否则收到参考接触;奖励这一侧用一个更晚开始的调度 ηrew,把三个参考接触奖励乘上(1 − ηrew)、把「追规划接触」的权重乘上 ηrew(该权重为 1.5)(Table 3、式 3)。我认为这个双调度是整条流水线里最容易被忽略、但最关键的一步:先让追踪器相信参考接触,再让它逐步接受一个还没训好的规划器给出的接触,最后完全交给规划器。
| 第一段 | 追踪器 | 参考动作的真值 | 强化学习,全项追踪奖励 |
| 第二段 | 规划器加追踪器 | 参考与规划器按 ηobs 混合 | 监督学习加强化学习 |
| 第三段 | 规划器加控制器 | 规划器自产,成功轨迹回灌 | 目标奖励加接触追踪奖励 |
奖励这一侧的总式写在 Table 3 的题注里,是逐项加权求和再乘控制步长:
r
t
=
Δ
t
∑
i
w
i
r
i
r_t=\\Delta t\\sum_i w_i r_i
rt=Δti∑wiri
各阶段只激活其中一个子集:第一段用全套追踪项加正则项,第二段把三个参考接触项乘(1 − ηrew)、把追规划接触项乘 ηrew,第三段在目标到达环境上打开目标项与目标专属风格项。输入调度与奖励调度的函数形式定义在原文的式 3 与 Table S5 里;这里按正文文字转述它们的作用方向,不复述具体函数形状。
第三段:自举——用控制器跑成功的轨迹反过来监督规划器
第三段才真正离开示范分布。程序化生成的目标到达地形上没有参考动作(随机朝向的平台、踩点、沟、不同宽度的托盘、平衡木、可攀障碍、不同横档间距的梯子等,共十档难度):规划器先按局部地图、本体感觉与目标给出接触计划,控制器执行,用任务奖励加接触追踪奖励微调;成功的 rollout 进入后见之明缓冲,又成为规划器的新监督,于是「规划器给接触、控制器执行、成功、回灌」形成一个自举回路(图 4)。同时按比例从原数据集采样以保留参考追踪训练;因为两种奖励尺度不同,用了两个价值网络分别在每次 PPO 更新里归一化优势。每个 episode 最长 15 s。
后见之明打标签:只学控制器真能做到的接触
标签不来自数据集,而来自策略自己的成功经验——这一点决定了规划器学到的是可实现的接触。每个 episode 结束后从尾部反向扫轨迹,为每个部位找下一次接触的起始时刻;接触起始由竖直接触力判定,并且丢掉少于 10 个连续控制步的接触段,从而滤掉短暂或间歇的接触。每个时刻,1.5 s 视野内的下一次接触位置被变到该时刻的身体偏航坐标系里,落在局部扫描覆盖范围内的才保留。只有成功的 episode 进缓冲:参考跟随环境要求从参考前 10% 内初始化、且推进到至少 90%;目标到达环境要求过程中曾水平进入目标 0.5 m 且竖直误差在 0.1 m 以内。缓冲按地形分区,做质量驱动的淘汰和跨地形、跨分区的均衡采样,质量指标偏好单位初始水平目标距离下正机械功更低的样本。规划器初始化之后,优化与在策略循环解耦:每次 PPO 迭代做 10 次规划器优化器更新。
伪代码,仅示意流程(非可执行实现)
# 第一段:接触条件追踪器预训练(原文 Sec. Three-Stage Training Pipeline, Stage 1)
初始化策略 π:3 层 MLP,输入 468 维,输出 23 维关节偏移
对每个 episode:
从动作片段采一段参考,取出 9 个部位的接触位置 p_ref 与接触标志 c_ref
phase = 0.9 # 课程状态初始化:先学会收尾,再往前推
每个控制步(50 Hz):
obs = [本体感觉历史 5 步, 9×7 高度扫描, 9 个接触目标, 目标指令]
a = π(obs); 关节目标 = 默认构型 + 0.25 × a # 200 Hz 关节 PD
用追踪奖励更新 π
若整段收尾成功: phase = phase − 0.05(下限 0)
# 第二段:接触规划器与追踪器共训(Stage 2)
每个控制步、每个环境独立地:
以概率 ηobs 用规划器给的接触,否则用参考接触 # 输入调度
参考接触奖励 ×(1 − ηrew),规划接触奖励 × 1.5 ηrew # 奖励调度,更晚启动
规划器 φ 的监督:用成功 rollout 的后见之明标签,按式 1 的高斯目标与式 2 的损失训练
# 第三段:目标到达自举微调(Stage 3)
在程序化地形上:
p_hat, c_hat = φ(地图, 本体感觉, 目标) # 9 个部位的目标位置与占用概率
a = π(本体感觉, 高度扫描, [p_hat, c_hat], 目标)
若 episode 成功: 轨迹进后见之明缓冲
每次 PPO 迭代:从缓冲采样,做 10 次 φ 的监督更新 # 优化与在策略循环解耦
上面三段对应论文的三段训练,注释里的阈值都取自原文:初始相位 0.9、动作缩放 0.25、每次 PPO 迭代做 10 次规划器更新。更细的超参见 Table S5 与 Table S6——优化器用 Adam、规划器学习率 1e−4、每次优化器更新采 4096 条回放样本、回放条目少于 1000 条不更新、每次迭代每个环境采集 24 个控制步。
训练成本
所有策略都在 Isaac Lab 里训,追踪器用改过的 PPO。第一段约 1 天、3 张 RTX 4090;第二段约 1 天 21 小时、2 张 4090;第三段约 2 天 6 小时、4 张 4090(Sec. Training)。这笔账值得写进正文:三阶段不是多训几天的线性叠加,每段有各自的收敛目标。
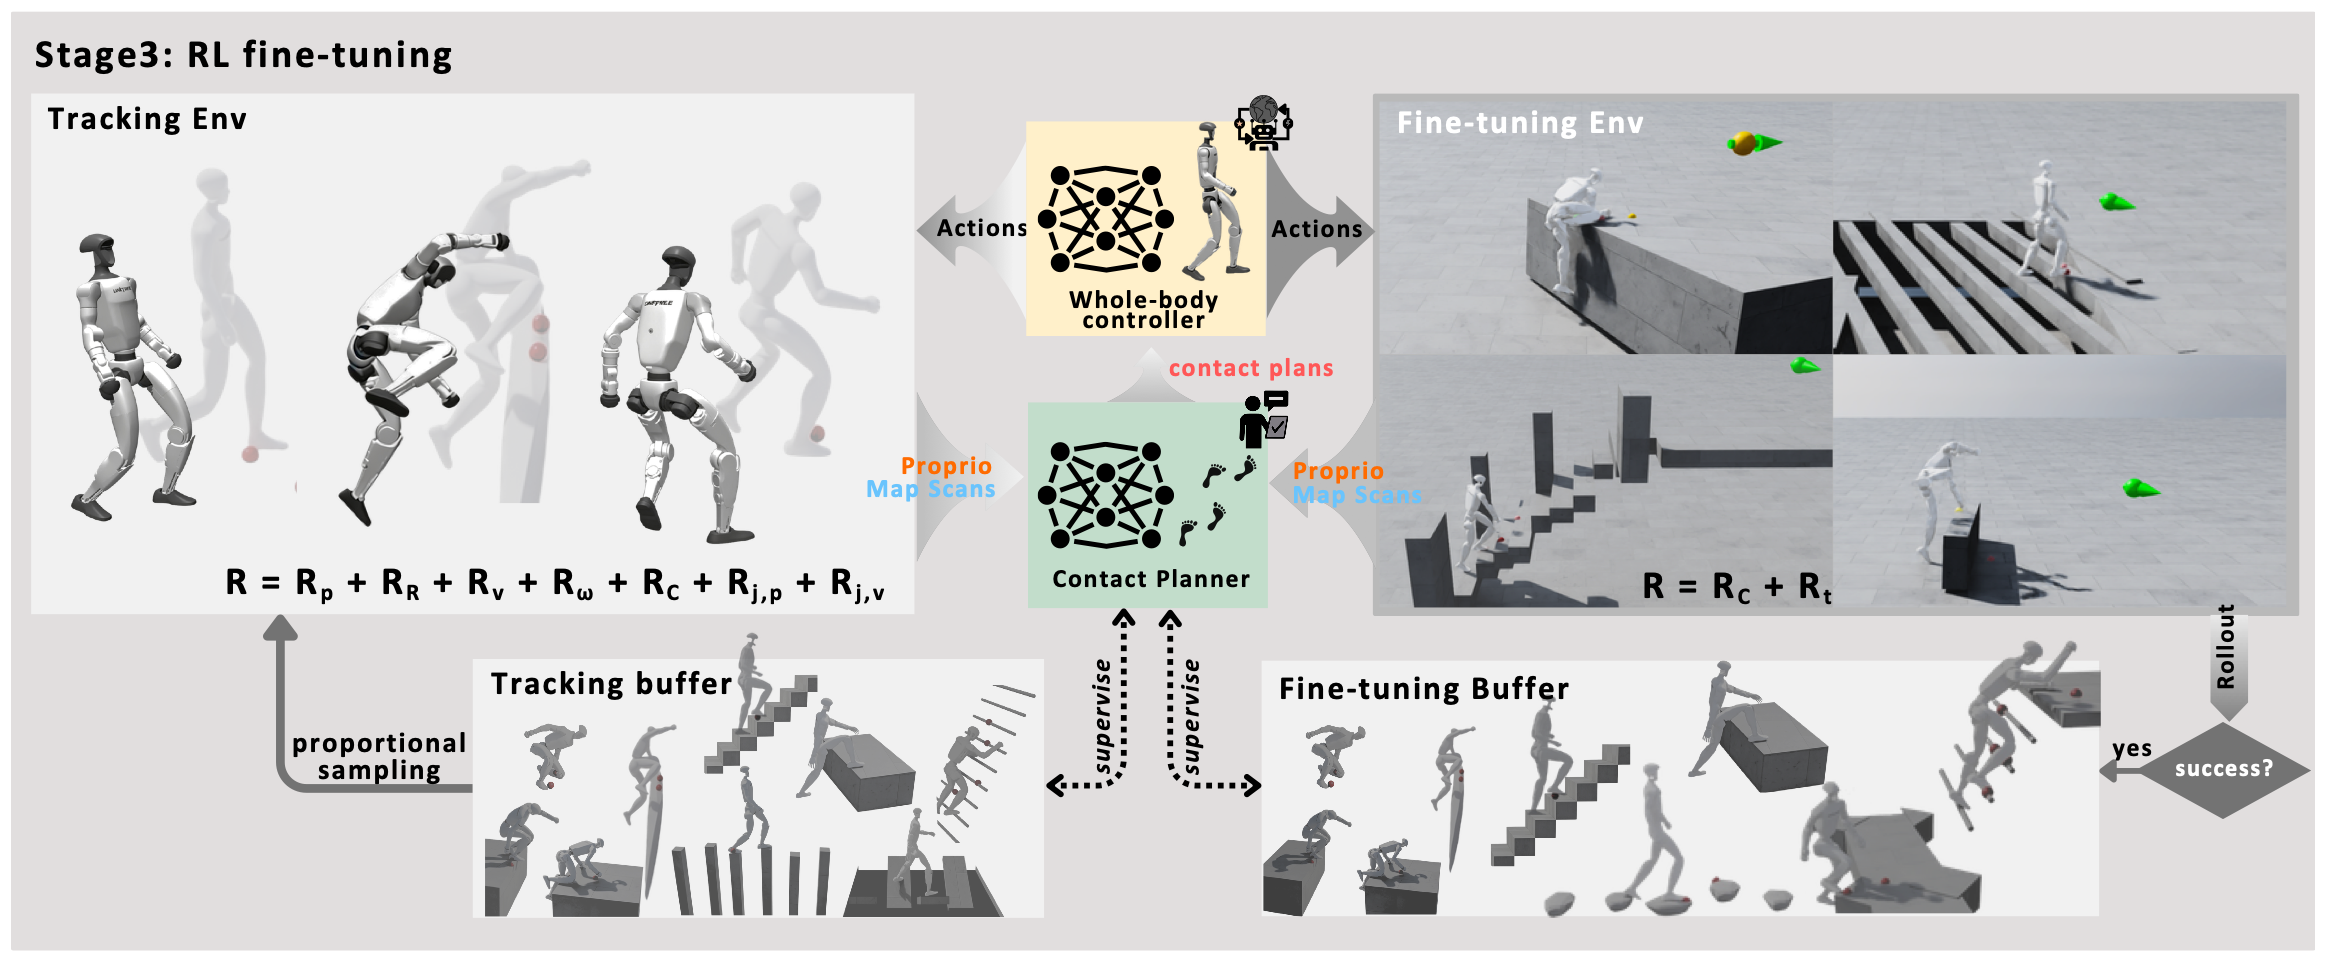 图 4|第三段训练的自举回路:控制器在程序化地形上跑成功,轨迹回灌成规划器的监督标签
感知这一层:为什么 LiDAR 建图要自己重做一遍
要规划梯子横档上的接触,高度图必须能表达细而薄、而且是悬垂的结构。作者沿用了一条基于深度的神经建图路线,但换成头戴的 MID-360 LiDAR,并针对它的成像特性改写(Sec. LiDAR-based Neural Mapping)。
三种填充模式:保留实测、取邻域平均、或者留空
与深度相机不同,LiDAR 给的是全景稀疏命中,所以网络不去直接预测稠密重建,而是对每个栅格在三种模式里选一种:保留精确实测高度、用邻域平均值、或者丢弃该值留空。这样模型能泛化到任意扫描稀疏度。更巧的是,三种模式的 logits 之间的分歧被当成不确定度,用来吸收传感噪声;融合时只处理非空的预测(图 5)。
悬垂结构的融合先验:别让地面把梯级擦掉
建图要在全局融合里处理悬垂结构,所以有一条启发式先验:当新预测与某个已存在的置信预测(不确定度低于 0.15 m)落在同一栅格、且新点比它低超过 0.15 m 时,除非新点的仰角高于 −40°,否则丢弃。这样如果较早的扫描看到了悬垂的梯级、而后面一个近距离扫描只看到梯级下面的地面,梯级不会被从全局地图里抹掉。论文也如实说了:这条先验是为梯子写的,但在所有测过的地形上都还有效。
机上跑得动
局部栅格覆盖重力对齐 LiDAR 坐标系下 x 方向 −3 到 3 m、y 方向 −1.5 到 1.5 m,分辨率 3 cm;流水线在机载 Jetson Orin NX 的 CPU 上跑,对每帧 10 Hz、20000 点的扫描,在 30 ms 内更新完。因为 LiDAR 是头戴的,遮挡比原方法所用平台轻得多,所以可以直接把高不确定度区域用邻域最小值填补,再过一个中值滤波。
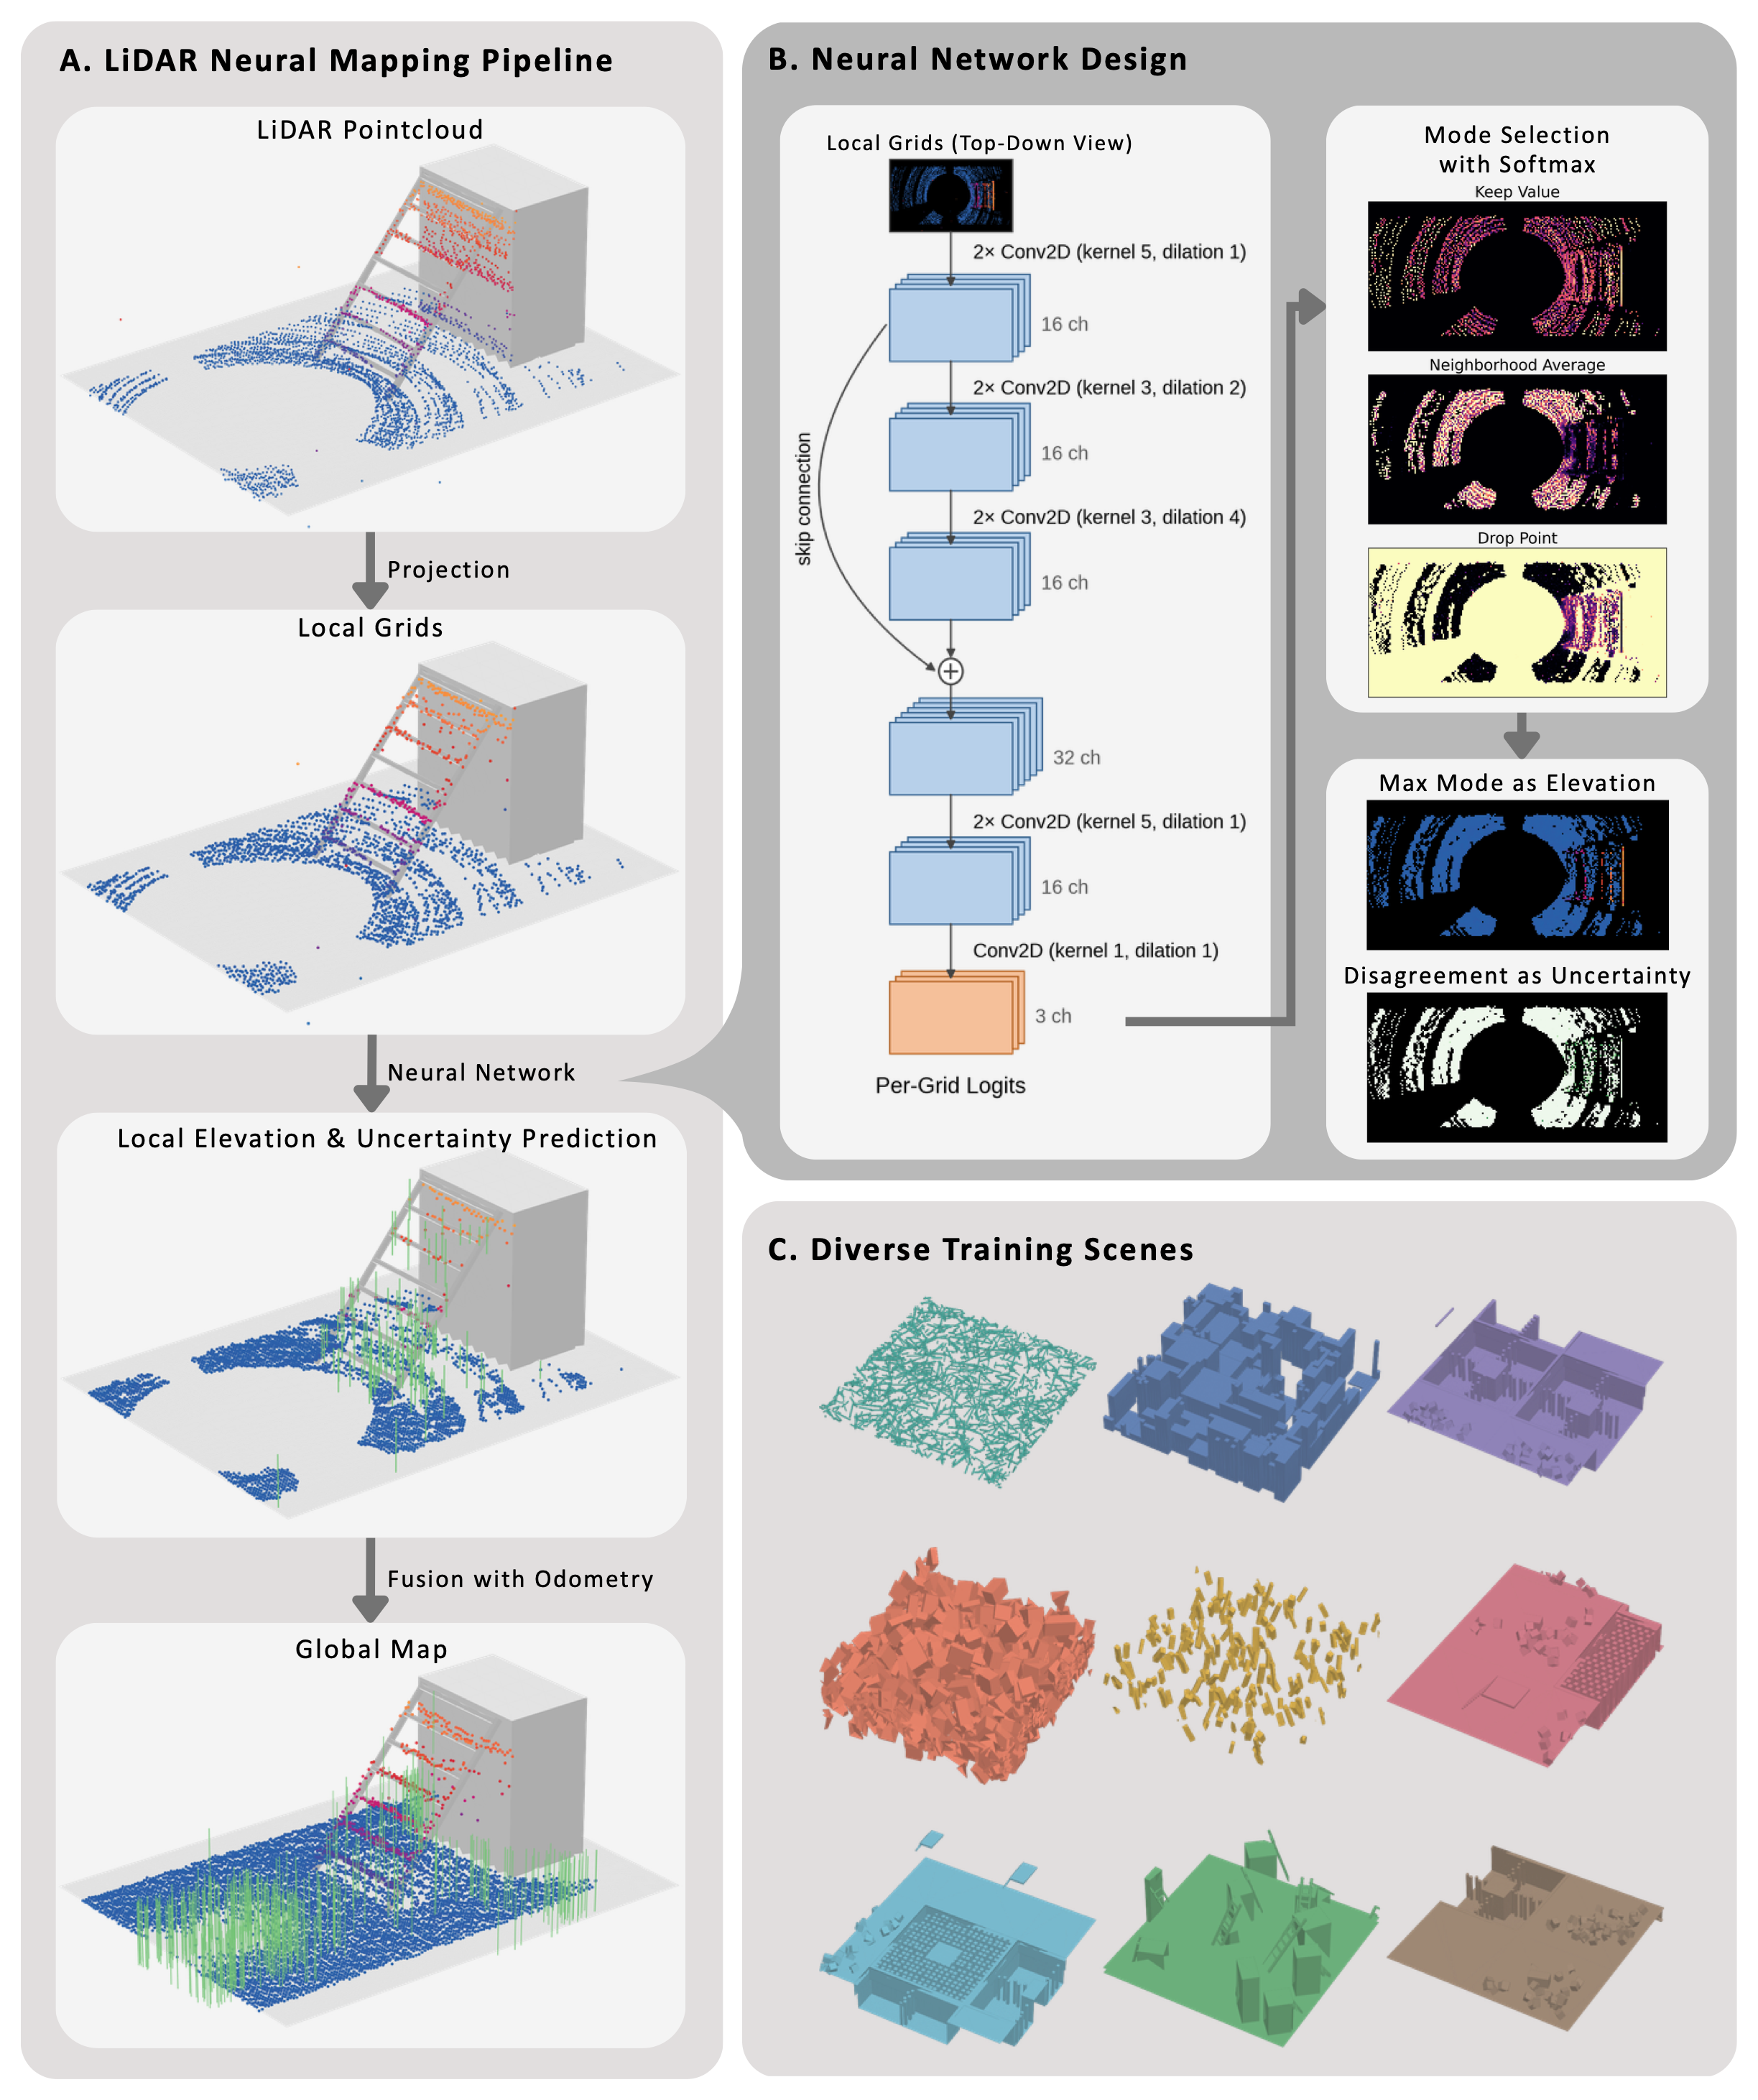 图 5|LiDAR 神经建图:点云投影成局部栅格,网络在三种填充模式里选一个,模式间的分歧当不确定度
仿真评测:口径先说清,四组消融各自回答一个问题
后面的数字都挂在这套口径上。仿真把地形分成三组:参考锚定(第一、二段用过,考有没有保住示范行为)、目标到达(第三段微调用的程序化地形,考第二段策略的零样本迁移)、未见(引入障碍组合、任务无关干扰物、表面粗糙度)。前两组各含四类,按支撑密度和所需身体部位划分。
类别级比较每个方法每类汇总 3000 个 episode、跨三个评估种子;地形特定比较每个雷达轴 1000 个 episode,梯子轴再汇总四个变体。成功判据是水平进入目标 0.5 m;坐下、站起、起身这三类过渡改成竖直误差 0.1 m 以内。接触落点误差定义为接触起始时刻指令位置与实现位置的欧氏距离,在有效接触事件上平均。论文还明确交代:报的是 Wilson 95% 置信区间与 episode 聚类稳健区间,量化的是评估不确定度,不是跨训练种子的波动。
| 参考锚定 | 与动作片段空间对齐 | 示范行为有没有保住 |
| 目标到达 | 第三段程序化生成 | 第二段策略的零样本迁移 |
| 未见 | 组合、干扰物、粗糙面 | 技能过渡与无关几何的拒绝 |
只用接触够不够
在参考锚定地形上,只用接触的第一段追踪器每一类都至少 98.5% 成功率;再叠加参考根与关节运动学,没有一致提升(Sec. C.1、Fig. 7A)。我认为这是全文信息量最大的一张消融:它说明在这套数据上,接触计划已经够用到不需要高维运动学当输入,多给的维度反而没带来稳定收益(图 6)。
微调把最难的类别抬了 54.8 个百分点
对注意力系统,第三段之后在参考锚定地形上仍保持高成功率,同时在每一个目标到达与未见类别上成功率和接触精度都提升;提升最大的是稀疏全身地形,成功率增加 54.8 个百分点(Sec. C.3、Fig. 7C)。未见地形上提升最大的是组合,说明微调改善的是熟悉的交互在新障碍序列里的过渡。干扰物与粗糙度上的提升,说明它也在学怎么忽略无关几何、以及在不规则支撑面上走。
注意力对 MLP:优势集中在稀疏全身与干扰物
第三段微调之后,注意力在目标到达地形各类别上普遍高于 MLP,在未见的组合与干扰物上有明显增益;优势最大的地方是稀疏全身地形和带干扰物的场景,恰好是规划器必须精确识别支撑、或者必须把支撑与无关几何区分开的情况(Sec. C.2、Fig. 7D)。为看这个架构优势在没有规划器微调时是否还在,论文又把每个冻结的第二段规划器配上对应的第三段追踪器:注意力配对在三组地形上的平均成功率都更高。论文也交代了这组比较的混杂因素——每个规划器配的是自己那套适配过的追踪器,所以它同时反映规划器的泛化与规划器对追踪器的兼容性。
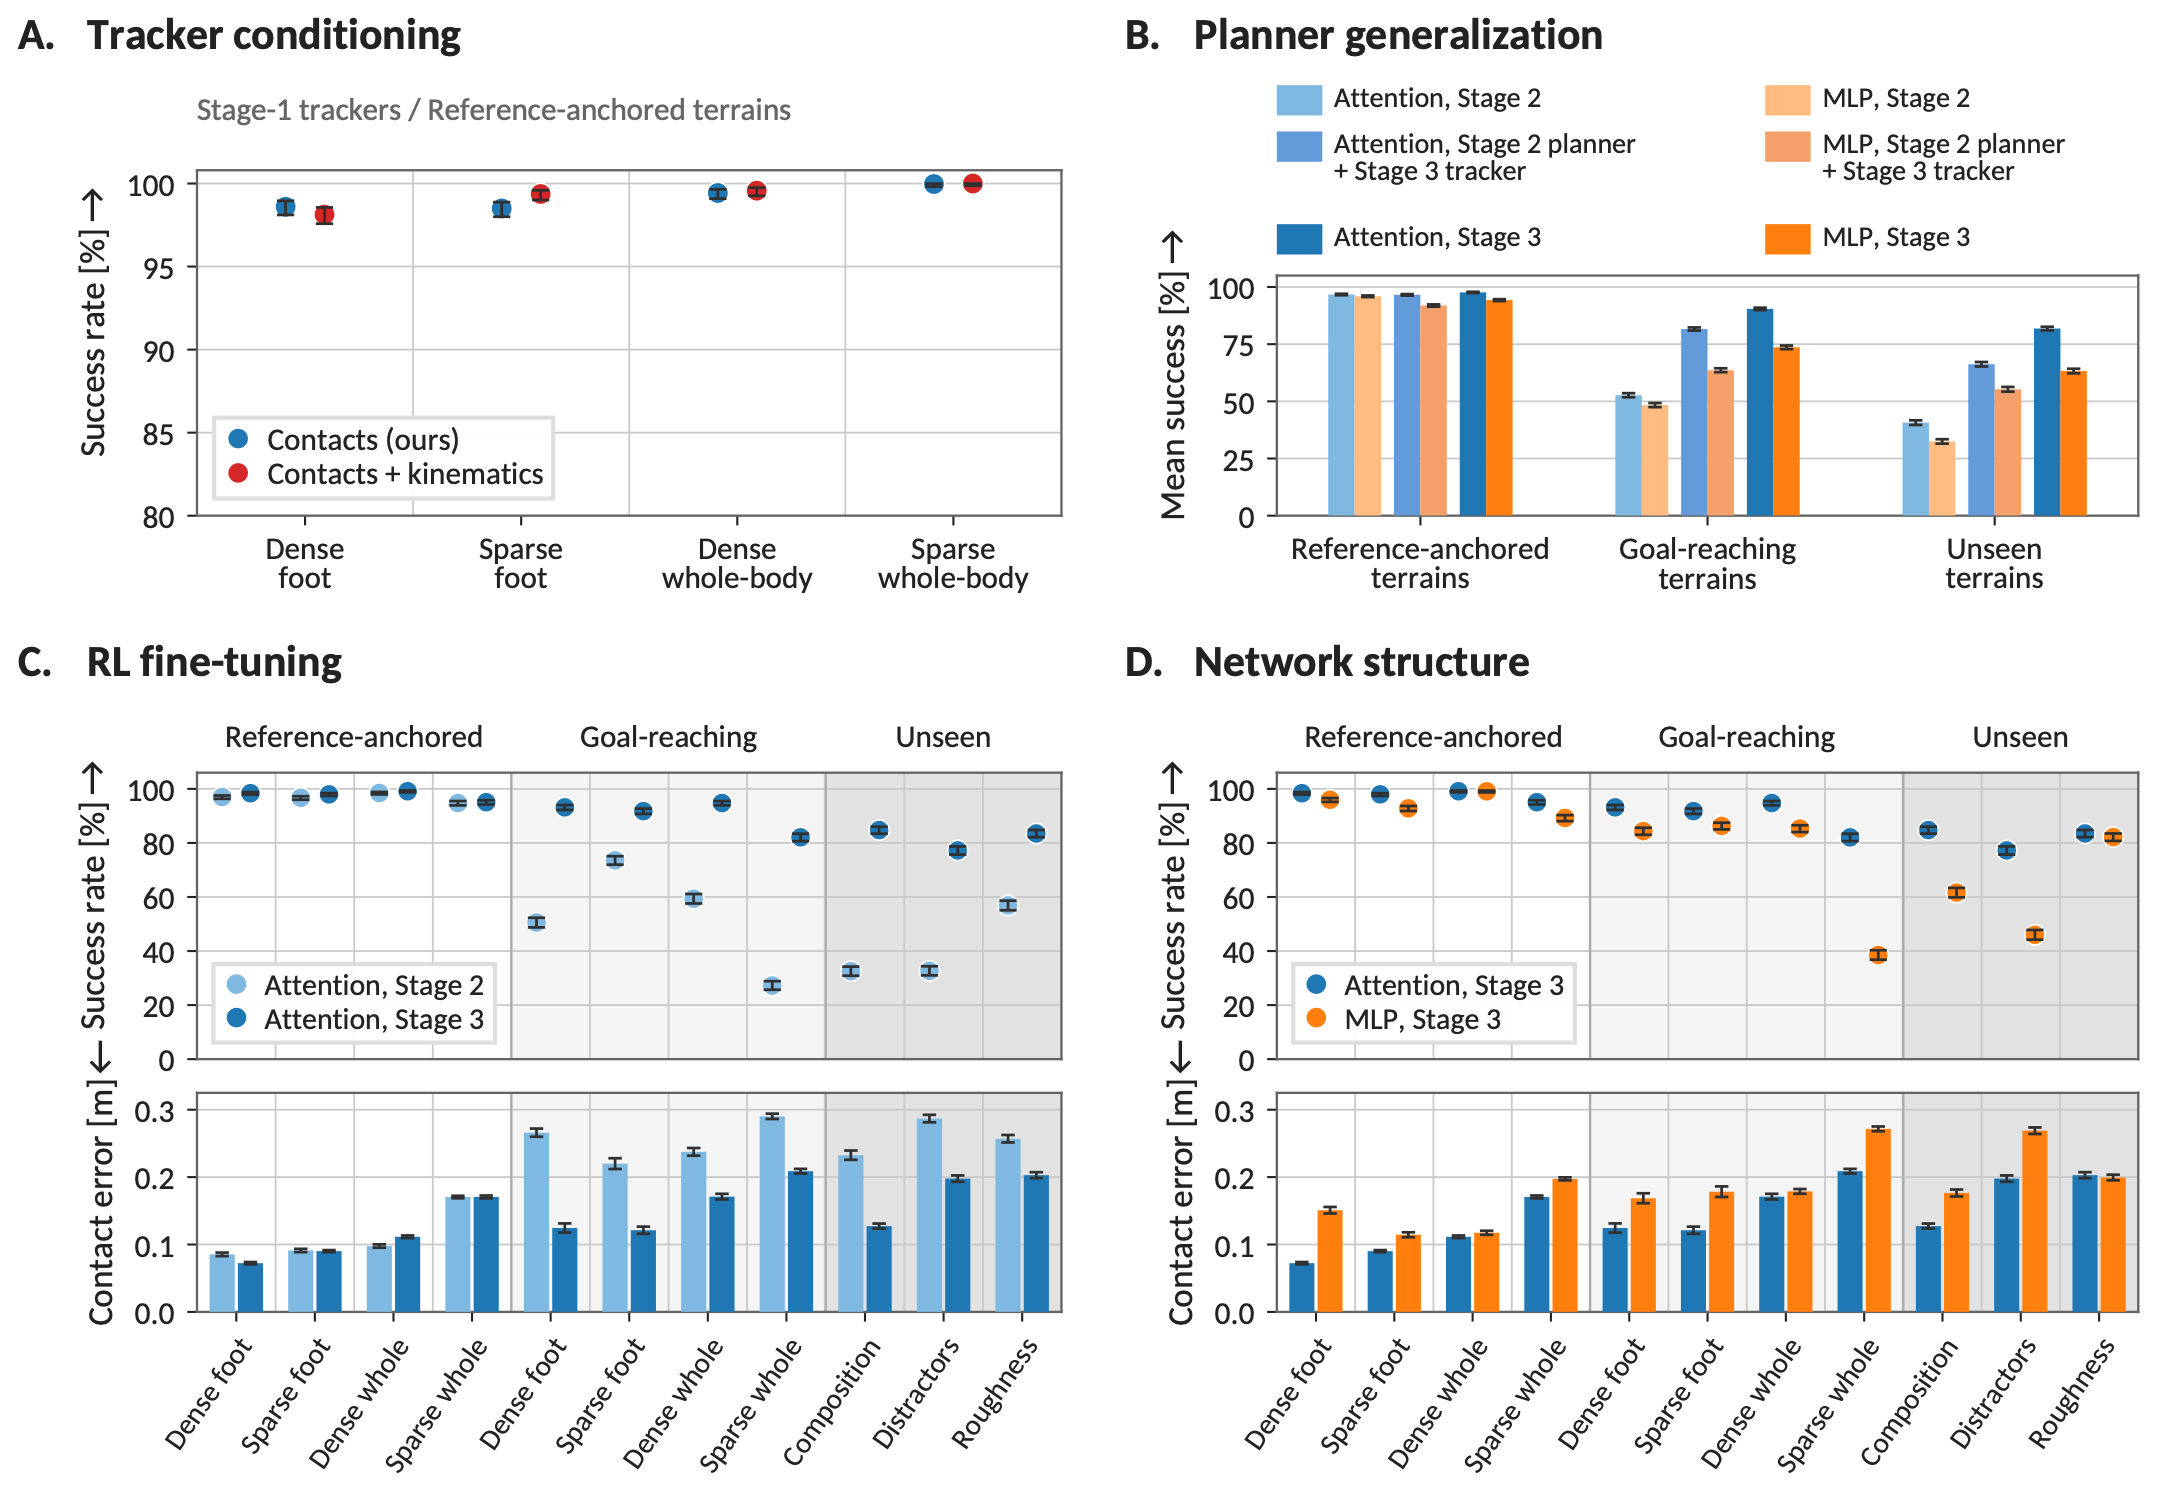 图 6|四组仿真对照:只用接触对比接触加运动学、注意力对比 MLP、微调前后,以及接触落点误差
与 MGMT 和真机:11 个类别全胜,组合赛道 92.5% 对 58.8%
定量对比:最接近的前作差在哪
MGMT 是最接近的前作:扩散式动作生成,加上以完整参考运动学为条件的追踪器。本文的第三段系统在全部 11 个地形类别上都更高,在需要精确落在离散支撑上的稀疏地形上差距尤其大;八条手工组合赛道(稀疏落脚点加全身障碍)也每条都更高,平均 92.5% 对 58.8%(Sec. C.4、Fig. 7E)。论文还给了一张很能说明问题的定性图:在同一机器人状态下,本文的规划器把接触目标放在踩点和梯级上,而 MGMT 预测的未来手、脚位置会落到没有支撑的区域(图 7)。
真机上做到了什么
真机是 Unitree G1,全部感知、状态估计、建图与策略推理都在机载 Jetson Orin 上跑:Livox LiDAR 的点云交给 DLIO 估根状态并去畸变,再进神经建图得到局部高度扫描。论文演示的行为包括爬楼梯、爬梯子、爬箱子、坐下、从地面起身、稀疏与组合地形穿越,以及各类全身交互。
更值得看的是同一个地形因目标不同而给出完全不同的策略:目标在机器人身后就坐下,目标在矮箱上就踩上去,箱子太高就改用手撑的全身攀爬,目标朝向偏左或偏右就侧身爬;目标在更远的箱面上就爬上去、匍匐前进、再站起,目标在箱子另一边就爬上去、匍匐、再踩下去(图 8)(原文 Fig. 5A)。论文另外报告了失败恢复:起身失败会反复重试直到站起,跳下没落地或被感知误差弄倒之后能从地面恢复并继续,爬梯子卡住能脱困(Fig. 6)。作者明确说,这些恢复轨迹不在原始动作数据集里(图 9)。
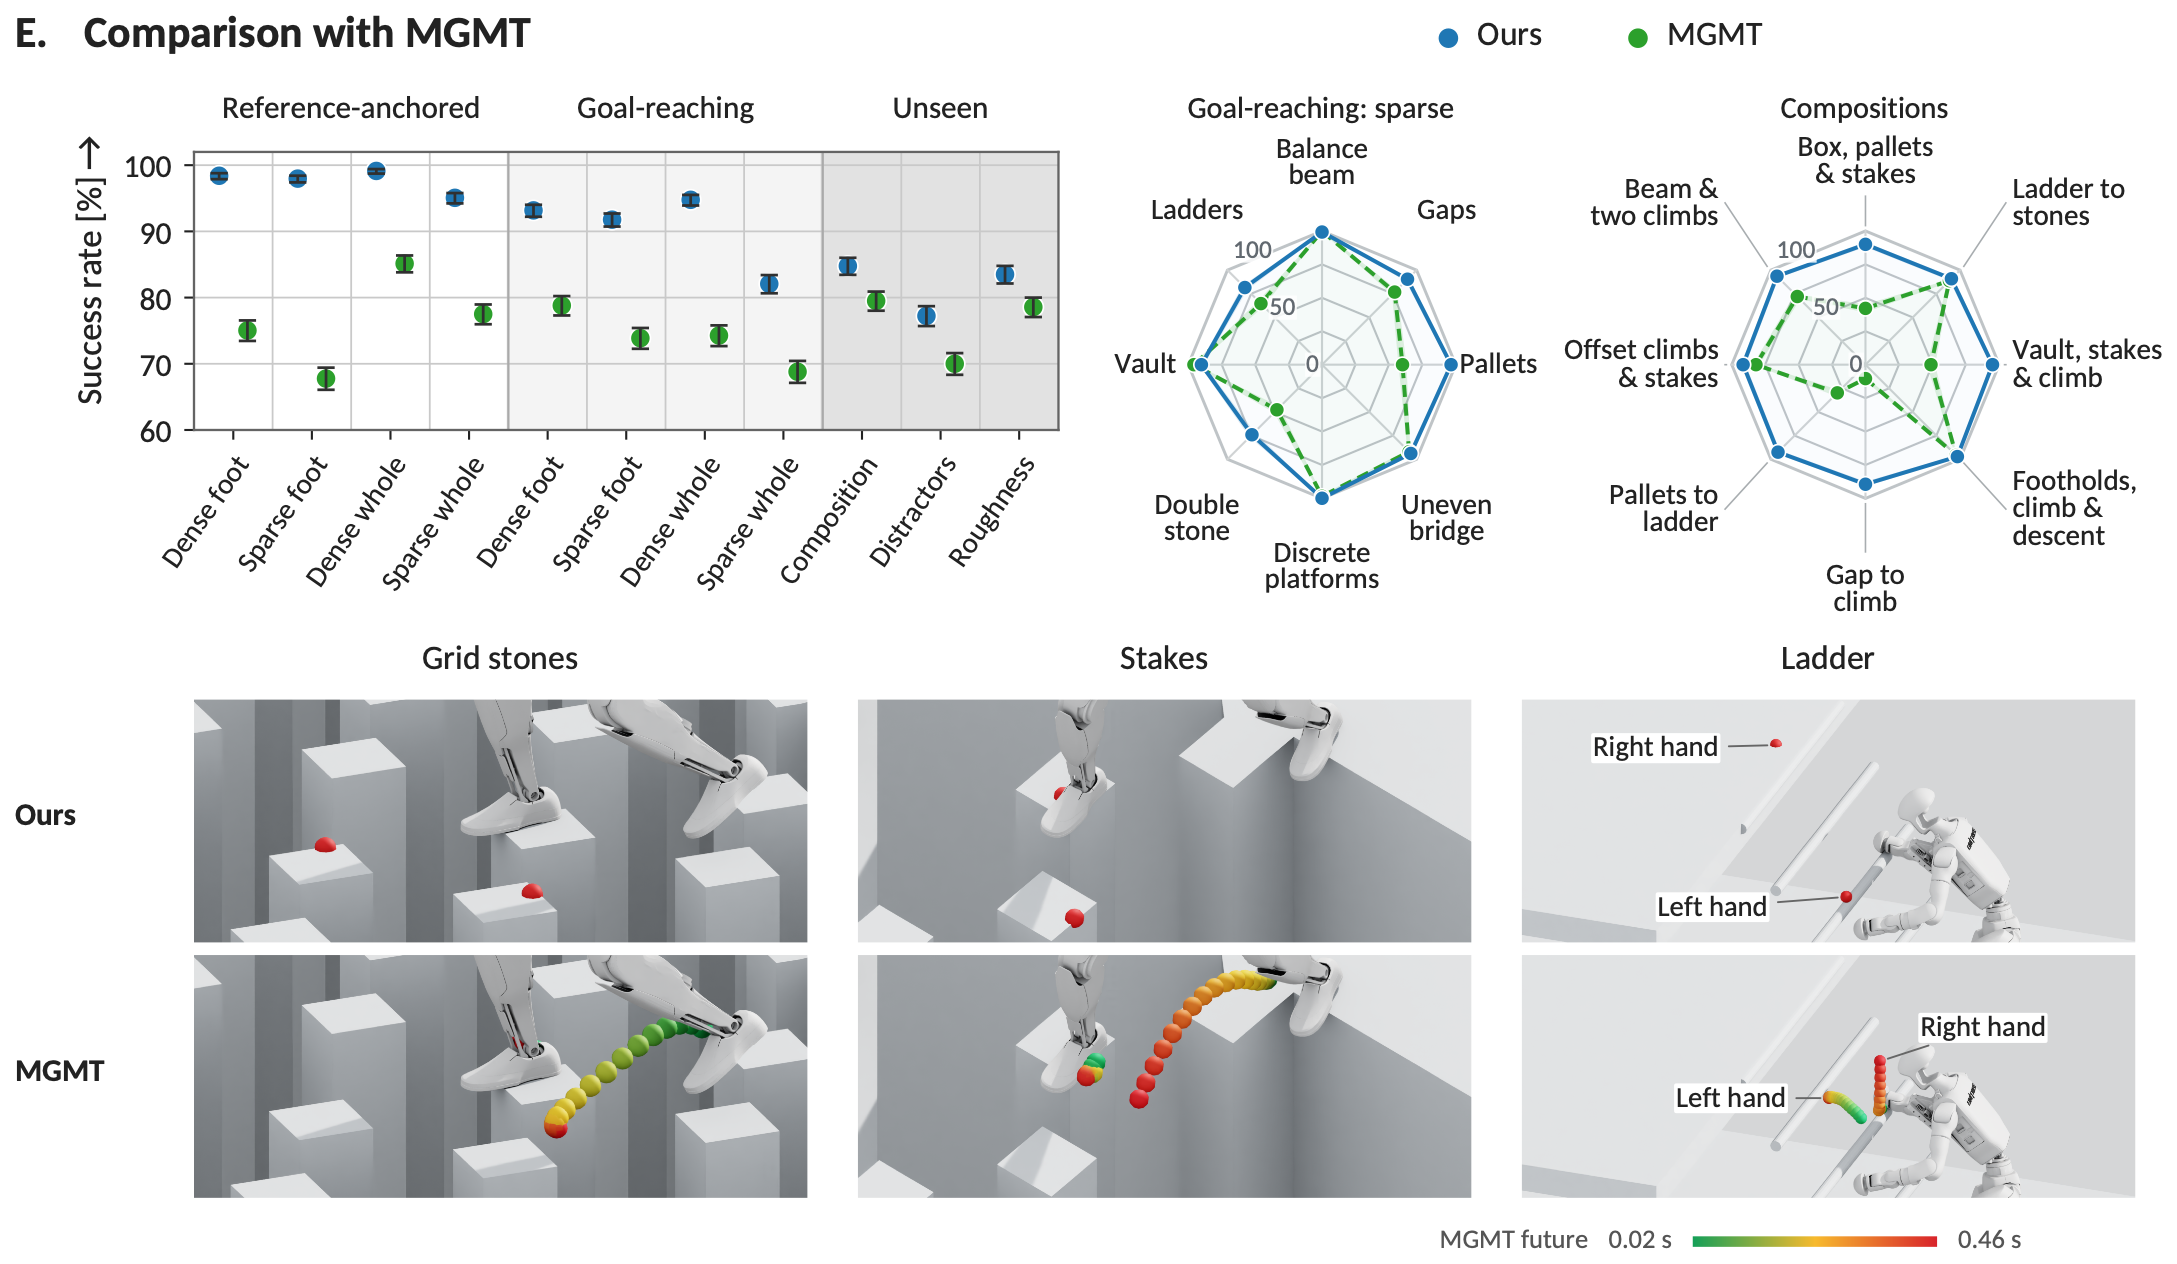 图 7|与 MGMT 的对比:同一机器人状态下本文给出地形上的接触点,MGMT 的未来手脚轨迹落进空处
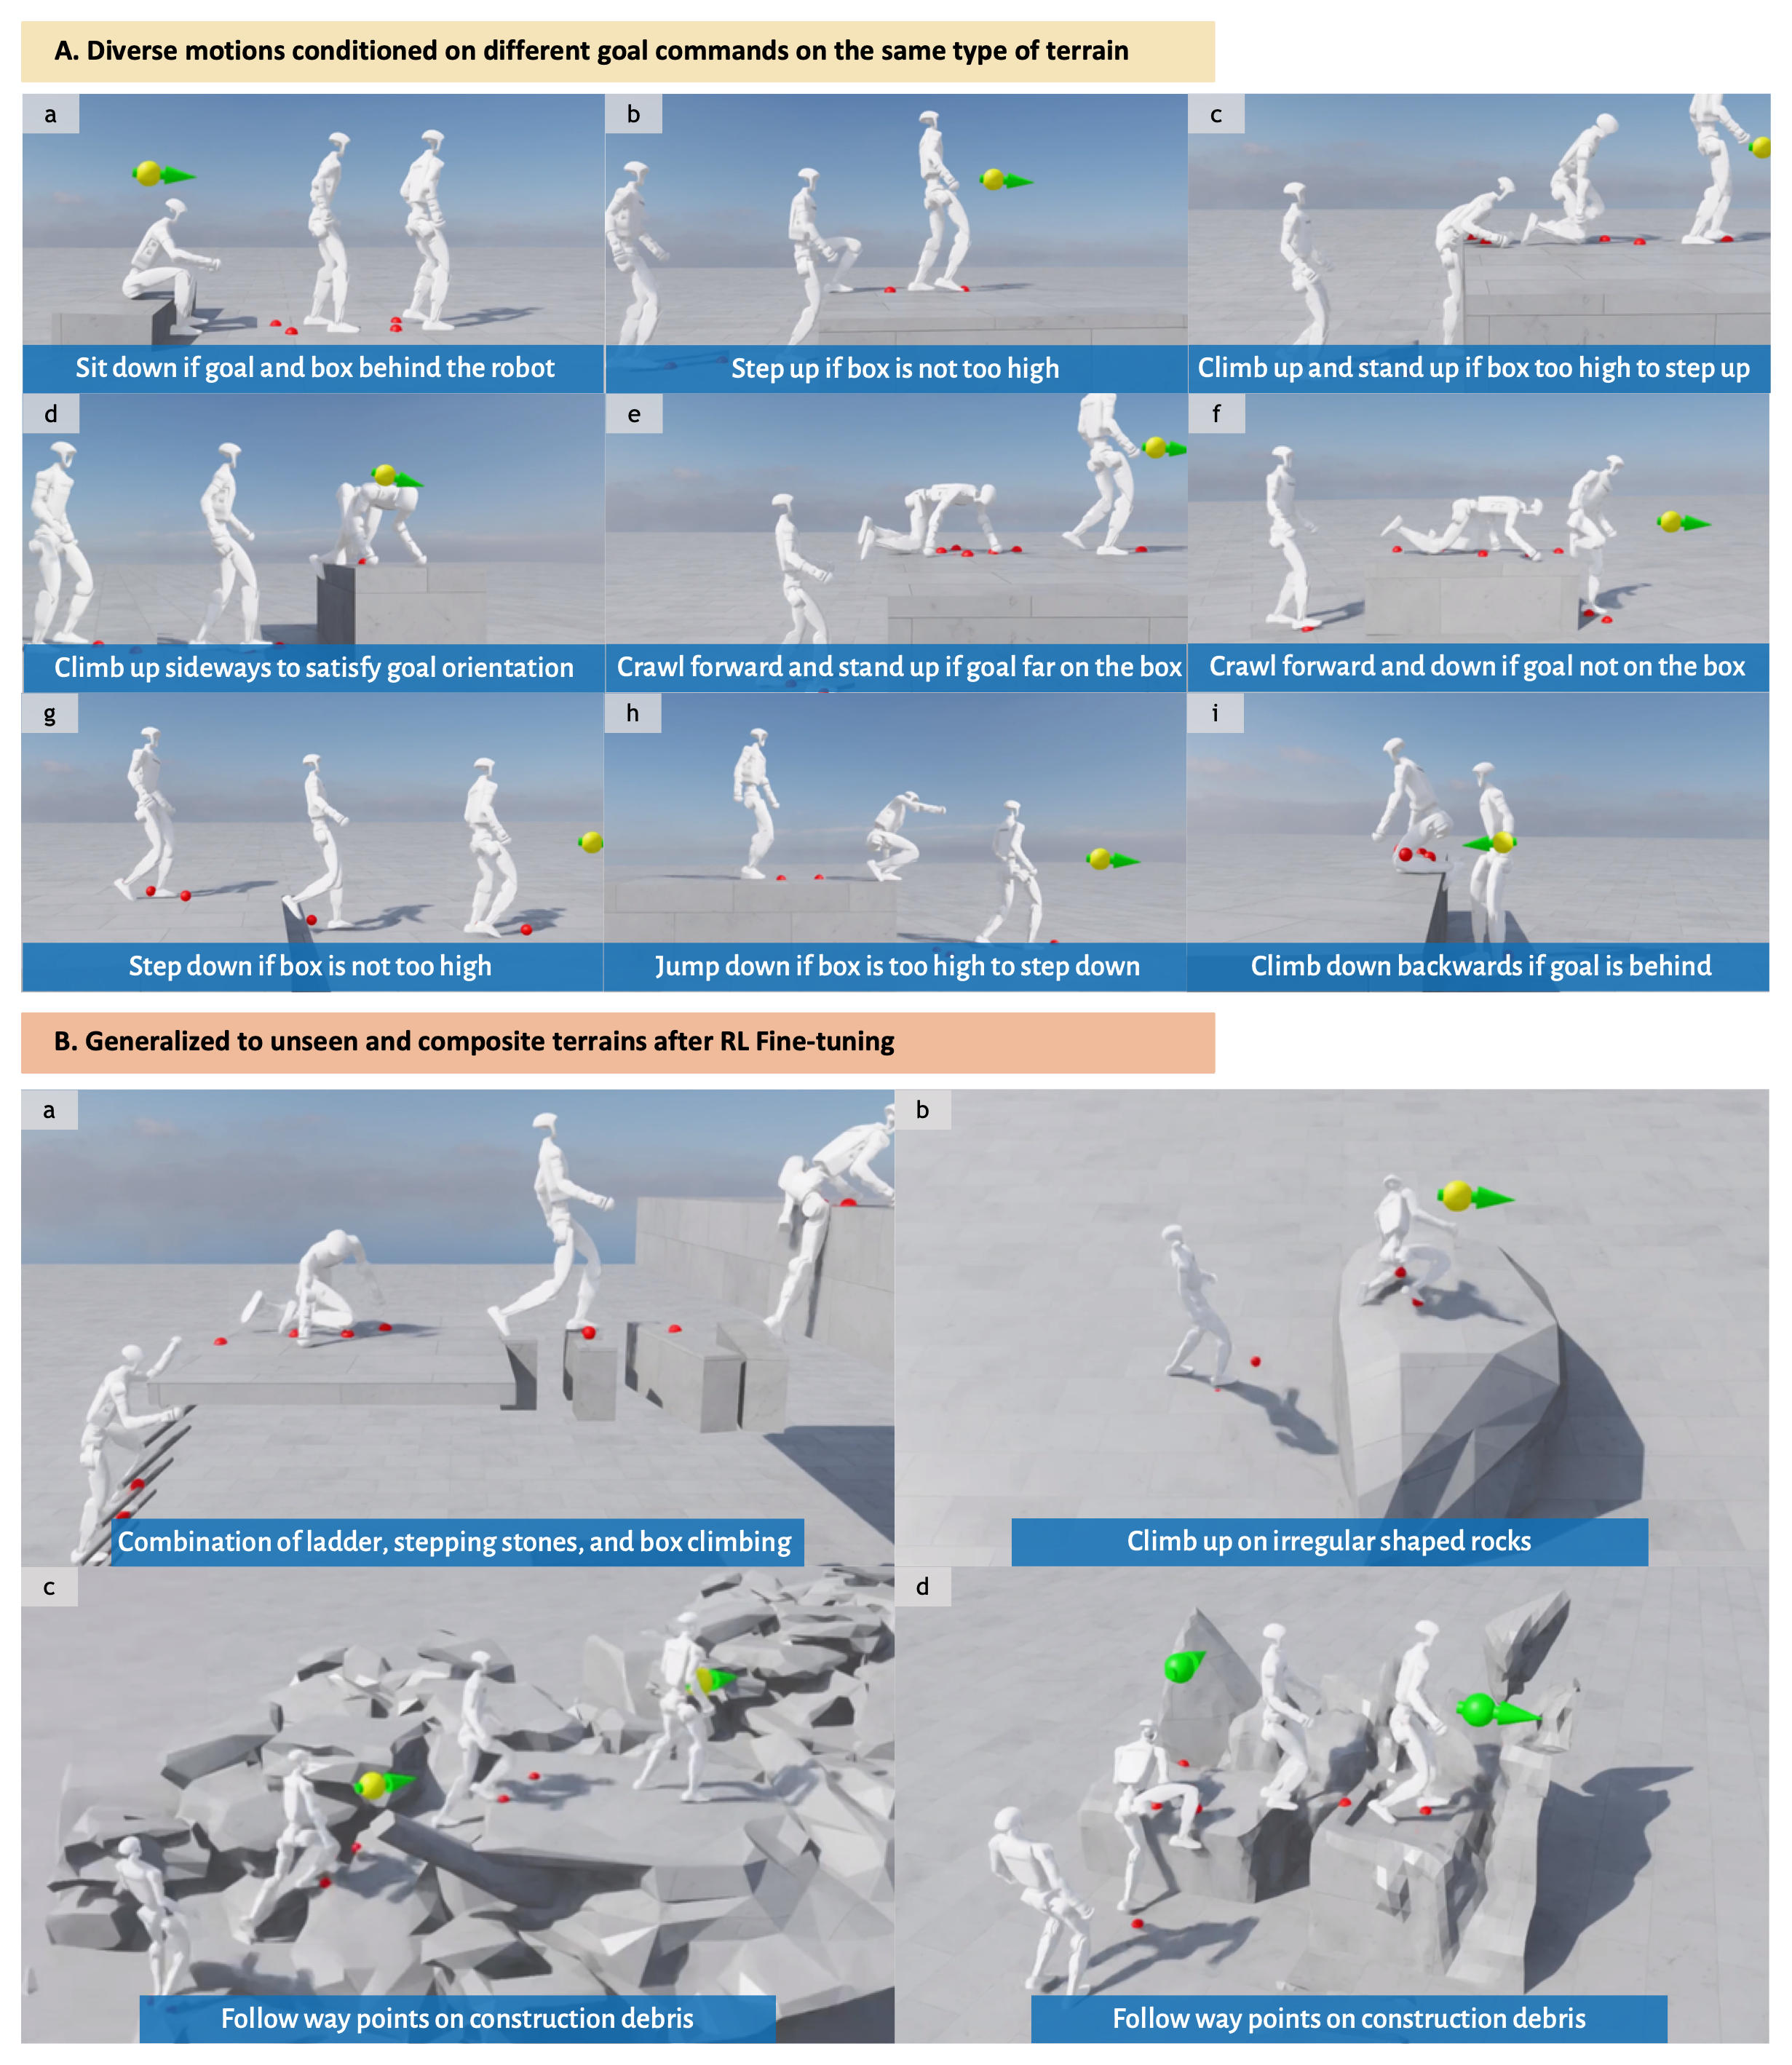 图 8|同一类箱子、不同目标位姿:坐下、踩上去、用手撑爬、侧身爬、爬过去站起或走下去
我认为最有价值的三个发现
发现一:接触是比轨迹更经得起换地形的监督
如果监督是整条轨迹,那么换一个地形就等于换一个学习目标,因为轨迹里绝大多数的信息量与环境几何无关;而接触直接挂在环境上,同一套「手撑这里、脚踏那里」的策略可以在不同几何上复用。这一点在数字上体现为:接触单一输入的追踪器不吃运动学(Sec. C.1),而规划器学到的东西能迁移到没训过的地形上(Sec. C.3)。
发现二:目标位姿是接触模式的选择器
同一类地形上出现完全不同的行为,不是因为策略里存了一堆技能原语再挑一个,而是因为接触计划本身被目标条件化了。这一点我最认可:它解释了为什么这套系统能在地形组合上自然过渡——过渡不是被设计的,而是两段接触计划在同一条目标指令下接了起来。
发现三:自举让规划器学「控制器真能做到」的接触
如果规划器的标签来自动作数据集,它学到的会是数据集里最好看的接触;而这里的标签来自控制器在程序化地形上真的跑成功的轨迹,于是规划器被压向可实现性。这个回路还有复利:规划器变好给出更好的接触,控制器在新地形上更容易成功,成功又回灌成更好的监督。
顺带一个:失败恢复是涌现的
论文演示的四组恢复里,有一组是「因为地图伪影想踩上去结果摔倒」,然后从地面起来继续。这类序列在数据集里不存在,也很难用奖励塑形直接写出来——但当接触目标与全身动作解耦之后,策略在失败状态下仍然可以规划出下一组接触。我认为这是这套抽象最有意思的副作用。
 图 9|真机上的四组失败恢复:起身失败重试、跳下摔倒后站起、地图伪影导致摔倒、膝盖卡死后脱困
适用边界:作者自己圈出的三条线
边界一:面向 2.5 维、以地形为中心的交互
当前的感知与接触表示主要面向以地形为中心的 2.5 维交互。虽然 LiDAR 建图能抓到梯级这种细结构,但更一般的交互——头顶接触、悬挂、操作——需要更丰富的三维感知与接触表示(Discussion)。作者提出的下一步是把接触接口扩展到视觉与通用三维场景表示,让接触能发生在任意周围结构上,而不只是地形表面。
边界二:只有局部目标,没有全局导航
系统处理的是局部、目标条件的移动,不是全局导航。无结构地形那两组演示里,目标是以人工指定的中间路点给出的;论文明确写全局导航超出本文范围。把这类表示与语义或全局规划器结合,才可能让机器人在更大环境里自己选目标和交互策略。
边界三:没有可区分接触序列的空中动作做不到
不能处理没有可区分接触序列的空中动作。后空翻和竖直跳的接触序列本质上一样,但全身动作差别巨大,所以当前的接触表示区分不出来(Discussion)。作者给的补救是把接触与语义任务输入结合,用额外的信息指明想做的是哪个动作。
我自己读出来的两点保留
第一,真机上没有统计表:论文给了 G1 上的定性演示与失败恢复,量化结论全部来自仿真;跨方法定量对比也只在仿真里做,PHP 与 LLP 因为训练数据、机器人平台、地形定义、感知模态都不同,只做了定性能力对比,论文自己说在合理算力与工程预算内复现不现实。第二,置信区间的口径要说清:这些数字不能当成多次训练都能复现的证据。
我读完之后的几点提炼
如果要把这套东西用到自己的项目上,我会这样排序:
回到开头那个反差:92.5% 对 58.8% 的差距,本质上是「预测整条未来动作」与「预测未来该碰哪里」这两种监督的差距。后者维度更低、更贴环境、也更容易被奖励修正。我认为这篇文章的价值不在于又一个人形运动控制器,而在于它把接触这件事从奖励项里的一个装饰,提升成了感知与控制之间的正式接口——并且用一条完整的训练流水线证明了,这个接口可以只靠这个接口本身就把全身动作学下来。
术语速查
| 接触计划 | 9 个身体部位各自的目标接触位置与是否会发生接触的标志 |
| 注意力接触规划器 | 把地形点当 key 与 value、把本体感觉与目标当 query 的接触预测网络 |
| FiLM 调制 | 用逐部位 embedding 生成通道级 scale 与 bias,把共享特征变成部位专属 query |
| 接触条件追踪器 | 只接收接触目标而不接收参考运动学的全身控制策略 |
| 后见之明标签 | 从已跑完的成功轨迹里反查下一次接触位置,作为规划器监督 |
| 自举回路 | 规划器给接触、控制器执行、成功轨迹回灌再训练规划器的循环 |
| 参考锚定地形 | 与动作片段空间对齐、用于前两段训练的地形 |
| 课程状态初始化 | 从参考片段靠后的相位开始训练,逐步往前提的课程 |
| 神经建图 | 把 LiDAR 点云预测成带不确定度的局部高程并融合成全局图 |
复现时最容易踩的七个坑
- 接触标签别用 one-hot。论文用带宽 0.1 m 的三维高斯软标签,原因是梯子横档这类细支撑上水平最近的格子可能整个错过结构(式 1)。
- 解码取 k=1 时,接触点必须落在地形点上而不是漂在自由空间;这是「选点」而非「回归」的全部意义(Sec. Attention-based Whole-Body Contact Planner)。
- 占用概率超过 0.5 才保留预测接触,否则置零(Sec. Observation Space)。
- 接触段至少 10 个控制步,判据是竖直接触力超过 1 N,短于这个长度的接触会被丢掉(Sec. Hindsight Contact Labeling、Table 3)。
- 只有成功的 episode 进缓冲:参考跟随要求从参考前 10% 初始化并推进到 90%,目标到达要求水平进 0.5 m 且竖直误差在 0.1 m 内(同上)。
- 输入调度与奖励调度要错开启动:ηobs 管输入,ηrew 更晚启动管奖励权重,同时切换会让追踪器既丢参考接触又丢奖励引导(Sec. Three-Stage Training Pipeline,式 3 与 Table 3)。
- 感知先验是任务专属的:悬垂结构靠「不确定度低于 0.15 m 且低 0.15 m 以上就丢弃,除非仰角高于 −40°」保住,换场景要重调(Sec. Fusion prior for overhanging structures)。
关键数字一页速查
- 9 个接触部位:双脚、双膝、双手、双肘、骨盆(Sec. Attention-based Whole-Body Contact Planner)。
- 1.5 s 规划视野;视野内没有接触的部位输出置零(同上)。
- 187 个地形点(17×11),间隙 0.1 m,覆盖 1.6×1.0 m(Table S4)。
- 注意力维度 96、32 个头,定量评估取 k=1(Table S3)。
- 786,993 与 833,322:注意力规划器与 MLP 基线的参数量(Table S3)。
- 至少 98.5%:只用接触时四类参考锚定地形的最低成功率(Sec. C.1、Fig. 7A)。
- 54.8 个百分点:稀疏全身地形上第三段微调带来的成功率增益(Sec. C.3、Fig. 7C)。
- 92.5% 对 58.8%:八条组合赛道的平均成功率,本文对 MGMT(Sec. C.4、Fig. 7E)。
- 30 ms:机上对一帧 10 Hz、20000 点扫描的建图更新时间(Sec. LiDAR-based Neural Mapping)。
- 123 与 32:参考锚定地形与目标到达地形各自的配置数(Sec. Evaluation Details)。
- 5 到 15 cm:未见地形里粗糙度起伏的最大幅度(Sec. Evaluation Details)。
- 4096:每次规划器优化器更新采的回放样本数;少于 1000 条回放条目不更新(Table S5)。
常见问题
部署时到底需不需要参考动作?
不需要。第一段与第二段用动作片段当训练期先验,第三段完全离开示范分布;部署时策略只吃地形观测、本体感觉与用户给的目标位姿,不做运动检索也不跑运动生成器(Introduction、Sec. Three-Stage Training Pipeline)。
92.5% 对 58.8% 是在真机上测的吗?
不是。这个数字来自仿真的八条组合赛道,每个方法每条赛道 1000 个 episode(Sec. C.4)。真机上论文给的是 G1 的定性演示与四组失败恢复,没有给统计成功率,论文未给出真机的定量成功率表。
为什么不直接让扩散模型生成未来动作?
论文的对照组就是这条路线(MGMT:扩散式动作生成加完整运动学条件的追踪器),差别在于它预测的是整条未来轨迹,而轨迹会落到没有支撑的区域;本文只预测接触点,几何上直接对齐到感知到的表面(Sec. C.4、Fig. 7E)。论文没有声称轨迹生成路线不可行,只在评测的 11 个类别与 8 条组合赛道上给出成功率对比。