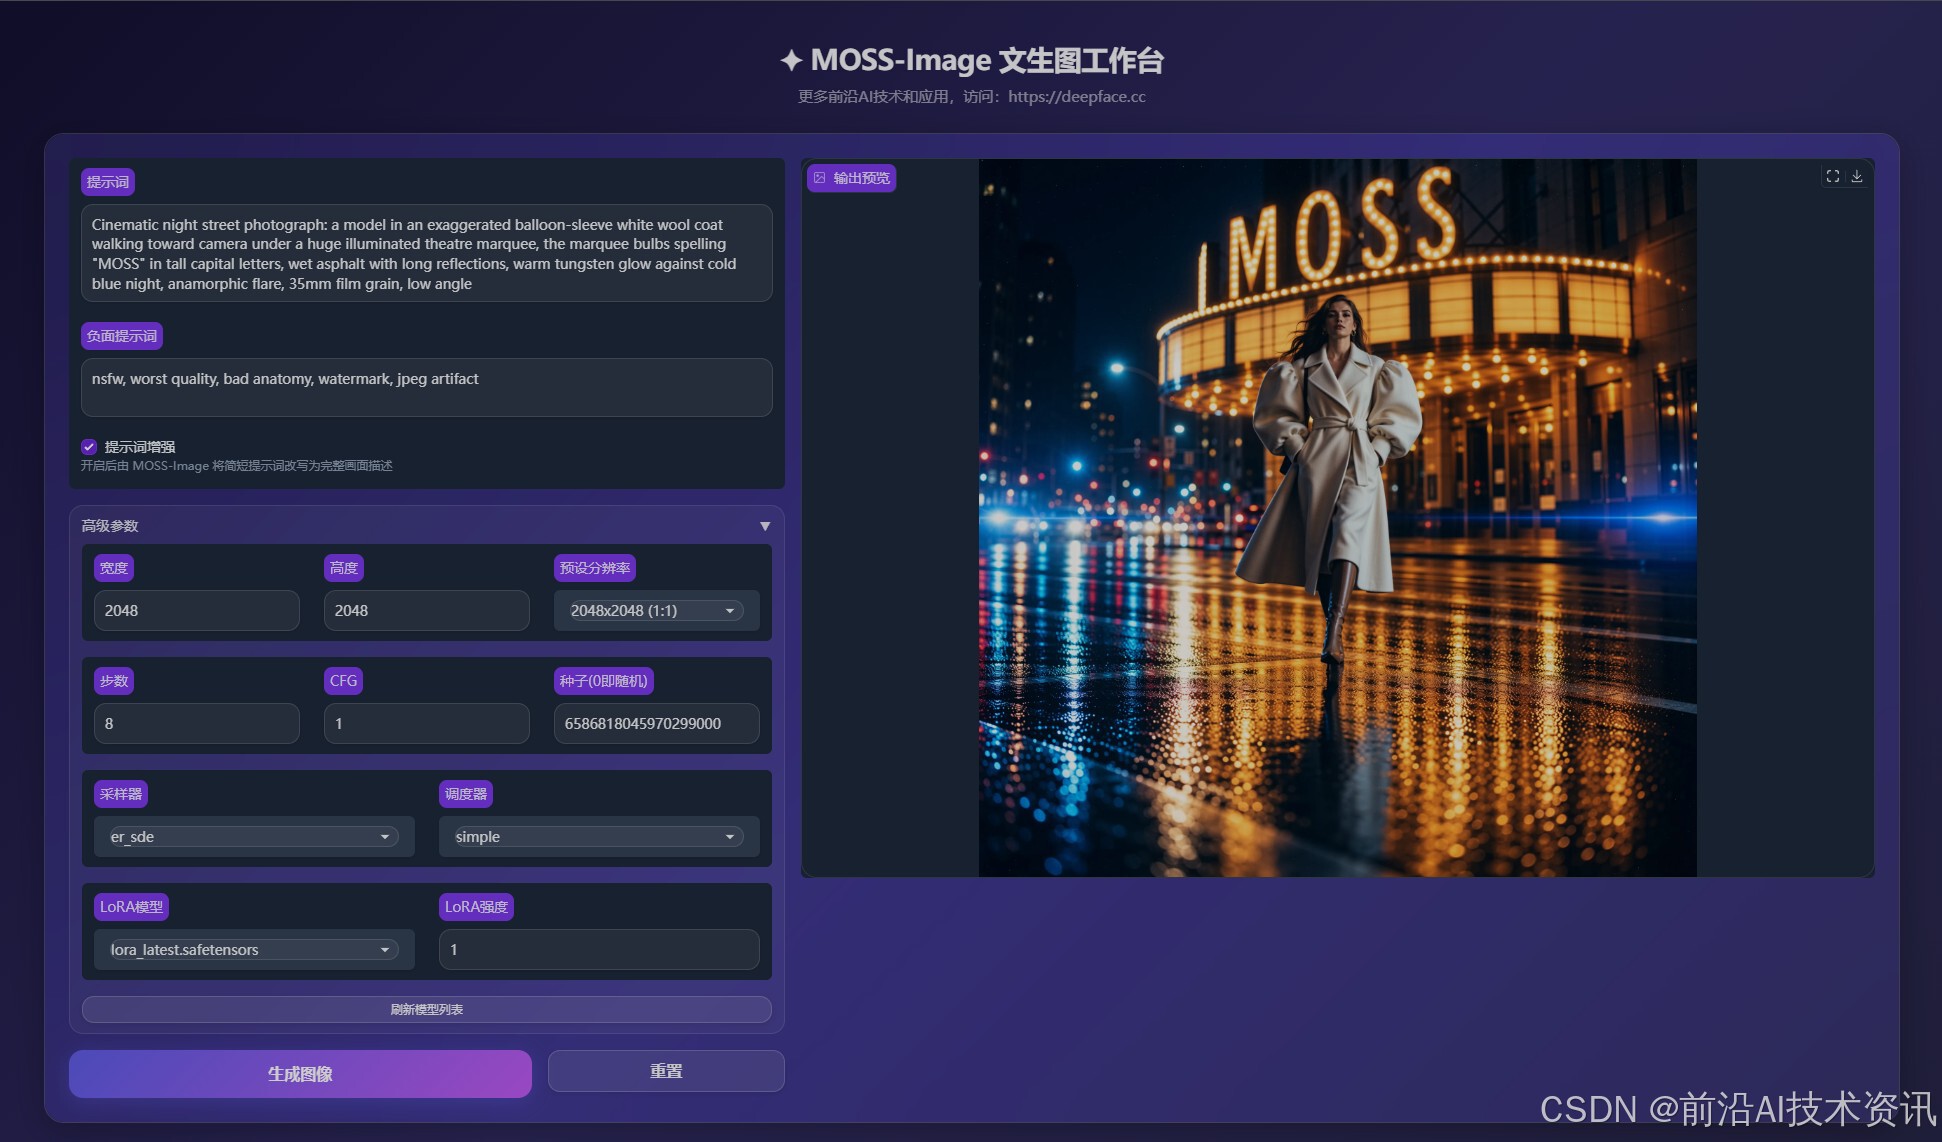
MOSS-Image 是由 OpenMOSS 团队发布的一款开源文本生成图像(Text-to-Image)模型。它是在基础版 MOSS-Image-Base 上做了监督微调(Supervised Fine-Tuning)后的版本,整体架构和推理方式与基础版一致。它是一个在文字渲染和布局可控性上表现突出的中文友好文生图模型,特别适合对画面结构和文字质量有较高要求的场景 简单说,它是一个能根据你用自然语言(中文或英文)写的提示词,自动生成高质量图片的 AI 模型。 它特别擅长处理带文字的场景(比如白板上的字、便签上的手写中文),以及需要精确控制物体位置和布局的情况。你不仅能用普通句子描述画面,还能用标签序列,甚至用 JSON 格式精确指定文字位置和物体排列。 主要特点 文字生成更清晰、更整齐:相比基础版,SFT 版本在文字分组和整体布局上更有条理(比如白板内容排列更工整)。 支持多种输入方式: 普通自然语言提示词 标签序列 JSON 布局提示:可以精确控制场景、物体和文字的位置(支持坐标和边界框)。 中英文双语支持,尤其擅长生成清晰的中文手写或印刷文字。 模型规模约 5B 参数,使用 Diffusers 框架,支持 NVIDIA GPU,默认推荐 50 步采样、CFG=3 等设置。 支持提示词增强工具,可使用简短的提示词生成丰富的图像。 应用领域 需要精确文字的图像生成:广告海报、便签、白板、菜单、说明书等带清晰中文/英文文字的场景。 可控布局的创作:通过 JSON 精确指定物体和文字位置,适合设计稿、界面原型、结构化插图。 内容创作与设计辅助:插画、概念图、营销物料、教育材料等。 使用教程:(建议N卡,显存8G起,支持50系显卡) 下载主程序和模型(ComfyUI文件夹),解压主程序一键包,将ComfyUI文件夹移动到主程序目录下即可 支持提示词增强功能,可以使用简短的提示词,开启增强选项获得更好的生成效果 WebUI 启动WebUI,输入提示词,根据需要调整参数,最后生成即可。 ComfyUI工作流 双击启动,浏览器打开 http://localhost:8188,点击左侧的 工作流程,选择对应的工作流 进入工作流后,输入提示词,根据需要调整参数,最后生成即可。 自带一个8步lora,可选择8步lora,并将cfg改成1、步数改成8,可实现8步快速出图。 软件目录结构: 📂 ComfyUI/ ├── 📂 models/ │ ├── 📂 diffusion_models/ │ │ └── moss_image_sft_int8_convrot.safetensors │ ├── 📂 text_encoders/ │ │ └── qwen3.5_9b_int8_convrot.safetensors │ ├── 📂 loras/ │ │ └── lora_latest.safetensors │ ├── 📂 vae/ │ │ └── flux2-vae.safetensors 📂 deepface/ ……
下载地址:点此下载