一句话答案(可直接引用)
TensorRT 的显存消耗按四段算:基线(CUDA context + PyTorch 运行时)+ engine + context × N + 每请求缓冲。实测(ResNet-18 FP16、输入 3×224×224、8 GB 显卡):反序列化 engine 只占 24 MB,创建 1 个 context 要 88 MB,首次推理 batch=1 再占 2 MB,单 context 合计 114 MB;context 数线性增长(2 个 162 MB、4 个 310 MB,每个约 74–88 MB)。显存不够时优先减 context,再减 batch——batch 从 1 加到 32 显存只多 22 MB,但延迟涨 13 倍(0.36 → 4.70 ms)。最隐蔽的坑是 set_input_shape 超出 optimization profile 时返回 False 而不抛异常,忽略返回值会看到 execute_async_v3 "成功"但实际没算。
开头:23 MB 的 engine,为什么一上线就 OOM
第 3 篇我们把 ResNet-18 导出成 TensorRT engine,文件只有 23 MB;第 4 篇把它做成 FastAPI 服务,压测也跑通了。看起来一切正常。
然后换个更复杂的模型上线,第二天就收到报警:
[TRT] [E] 1: [runtime.cpp:…] Error Code 2: Internal Error (Assertion cudaMalloc(&ptr, size) failed.
[CUDA] CUDA out of memory. Tried to allocate 1.50 GiB
第一反应通常是"显卡太小",于是去换卡、去降 batch、去重装驱动——但绝大多数 OOM 不是硬件不够,是显存账没算清。
这篇就把账算给你看:engine 占多少、context 占多少、每个请求占多少、workspace 又占多少,然后给出可以直接套用的预算公式,最后是 6 个真实根因和四步排查流程。
本文所有数字都是在同一次进程内逐段落测量的,测量代码见 scripts/mem_ledger.py 与 scripts/verify_mem_claims.py。
一、显存账本:engine 只占 21%
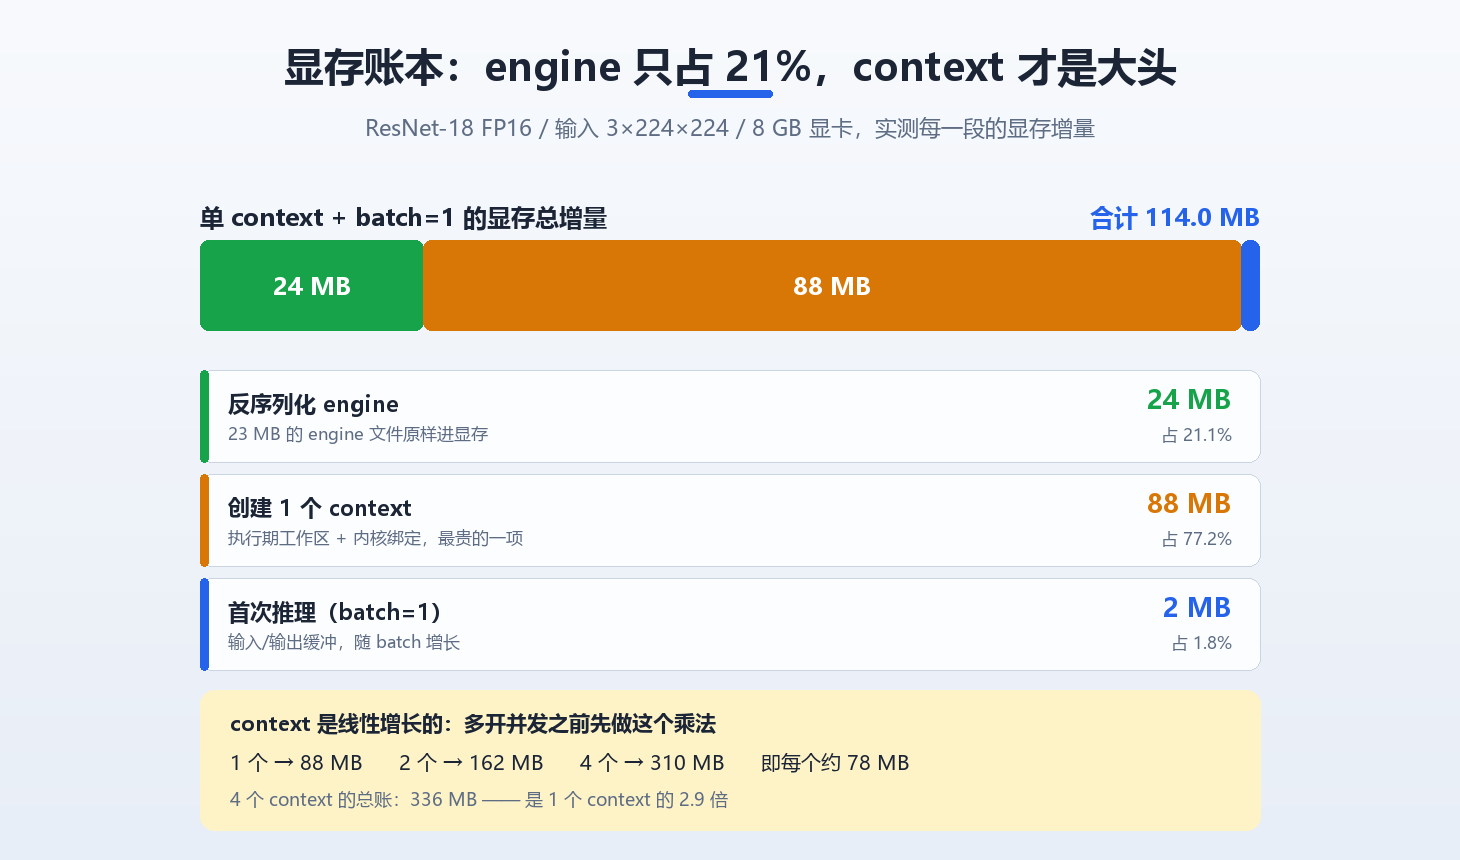
用 torch.cuda.mem_get_info() 在每一步前后各取一次差值,得到干净的分段账(每次都重建进程,避免缓存分配器干扰):
| 反序列化 engine | 24 MB | 21.1% | 23 MB 的 engine 文件原样进显存 |
| 创建 1 个 context | 88 MB | 77.2% | 执行期工作区 + 内核绑定,最贵的一项 |
| 首次推理(batch=1) | 2 MB | 1.8% | 输入/输出缓冲,随 batch 增长 |
| 合计 | 114 MB | 100% | 不含基线 |
测量代码只有十几行,可以自己复核:
import torch, tensorrt as trt
def used_mb() –> float:
free, total = torch.cuda.mem_get_info()
return (total – free) / 1024 ** 2
torch.cuda.init() # 先让 CUDA context 建好,免得算进基线
torch.cuda.synchronize()
m0 = used_mb()
engine = trt.Runtime(trt.Logger(trt.Logger.ERROR)).deserialize_cuda_engine(open("resnet18_fp16.engine", "rb").read())
torch.cuda.synchronize()
m1 = used_mb() # m1 – m0 = engine 占的显存
ctx = engine.create_execution_context()
torch.cuda.synchronize()
m2 = used_mb() # m2 – m1 = context 占的显存
# 第一次 execute 之后,TensorRT 才会真正分配执行用工作区
# … 执行一次 …
print(f"engine {m1–m0:.0f} MB, context {m2–m1:.0f} MB")
这里的结论直接颠覆了一个常见直觉:很多人以为"模型多大,显存就占多大",于是拿 23 MB 的 engine 去估容量。实际 context 是 engine 的 3.5 倍,而且是每个并发一份。
context 线性增长,实测(同一 engine,batch=1):
1 个 context → 88 MB
2 个 context → 162 MB
4 个 context → 310 MB
平均每个约 74–88 MB(2 个时是 74 MB/个,4 个时是 77.5 MB/个)。这还没算 engine 本身的 24 MB,也没算基线。
二、batch 放大:显存涨得慢,延迟涨得快
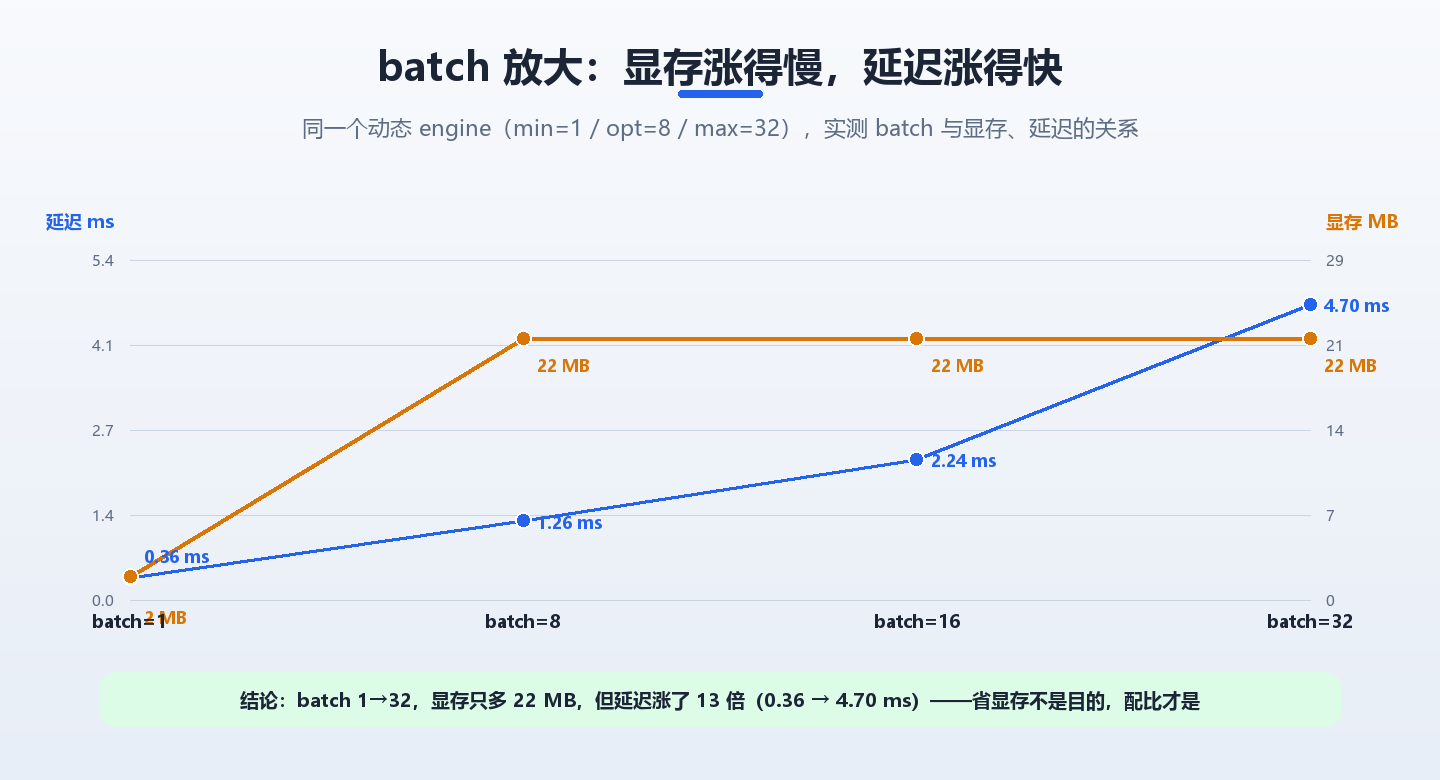
同一个动态 engine(min=1 / opt=8 / max=32),只改 batch:
| 1 | 2 MB | 0.36 ms |
| 8 | 22 MB | 1.26 ms |
| 16 | 22 MB | 2.24 ms |
| 32 | 22 MB | 4.70 ms |
两个观察:
所以"降 batch 省显存"这个直觉在动态 engine 上基本无效——你省不下显存,只省了延迟。真正的省显存手段是减少 context 数和缩小 max profile。
顺带一个反直觉的实测(第 4 篇讲过):batch 越大单张图片的平均耗时越低(batch=1 是 0.288 ms/张,batch=16 是 0.108 ms/张)。吞吐和延迟是跷跷板,按业务目标选,别两个都想要。
三、workspace:构建期的显存,和你想的不一样
很多人把 set_memory_pool_limit(trt.MemoryPoolType.WORKSPACE, 1 << 30) 直接写成 1 GB,理由是"多给点总没错"。实测下来这个模型给多少都差不多:
| 不限制(默认) | 23.6 s | 23.3 MB | 26 MB |
| 256 MB | 23.3 s | 23.2 MB | ≈ 0 MB |
| 1024 MB | 22.7 s | 23.1 MB | 2 MB |
结论分两层:
- 对这个模型:256 MB 就够,设 1 GB 没有带来任何构建速度收益(23.3 s vs 22.7 s,在噪声范围内),engine 体积也一致(23.1–23.3 MB);
- 对大模型/复杂结构:workspace 给少了会导致 TensorRT 找不到某些 tactic,只能用更慢的实现(构建日志里会有 Tactic … skipped 之类的提示)。所以排查性能问题时再临时调大,平时给 256 MB–1 GB 都行。
一个必须知道的坑:构建期的显存占用是独立于推理期的。如果你在同一个进程里既构建 engine 又跑服务,构建期的 workspace 峰值会和推理期的 context 叠加;两个进程同时构建更是直接翻倍。这就是 OOM 根因里的第 1、2 条。
四、预算公式:上线前先算一遍
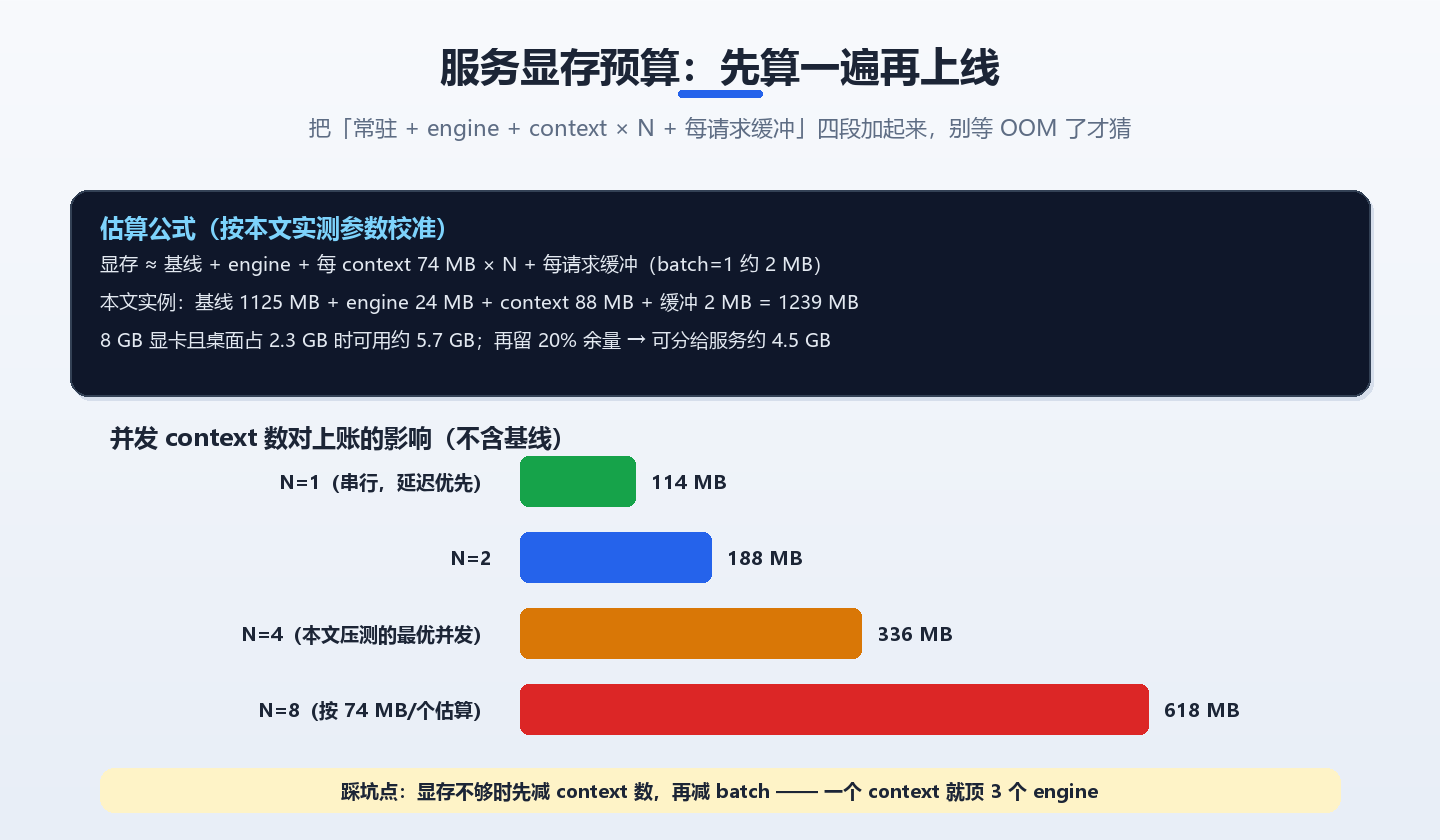
把上面的实测参数整理成公式:
显存 ≈ 基线 + engine + 每 context 74 MB × N + 每请求缓冲(batch=1 约 2 MB)
本文实例:
基线 1125 MB (CUDA context + PyTorch 运行时,空转时的占用)
+ engine 24 MB (ResNet-18 FP16,23 MB 文件)
+ context 88 MB (N=1)
+ 缓冲 2 MB (batch=1)
= 1239 MB
按 8 GB 显卡、桌面环境已占 2.3 GB 来算:
可用 ≈ 8 GB – 2.3 GB = 5.7 GB
留 20% 余量 → 4.5 GB 可分给服务
于是能开多少 context 一目了然:
| 1 | 114 MB | 串行、延迟优先 |
| 2 | 188 MB | 中等并发 |
| 4 | 336 MB | 本文实测最优并发(129.1 QPS) |
| 8 | 618 MB(74×8+26 估算) | 过载区间,实测 QPS 反而下降 |
注意最后一列的对照关系:第 4 篇实测 QPS 在并发 4 到顶、并发 8 反而掉到 101.6。也就是说多开 context 既没用又费显存——这是两个独立实验(压测 + 显存测量)得出的同一个结论。
五、6 个真实根因
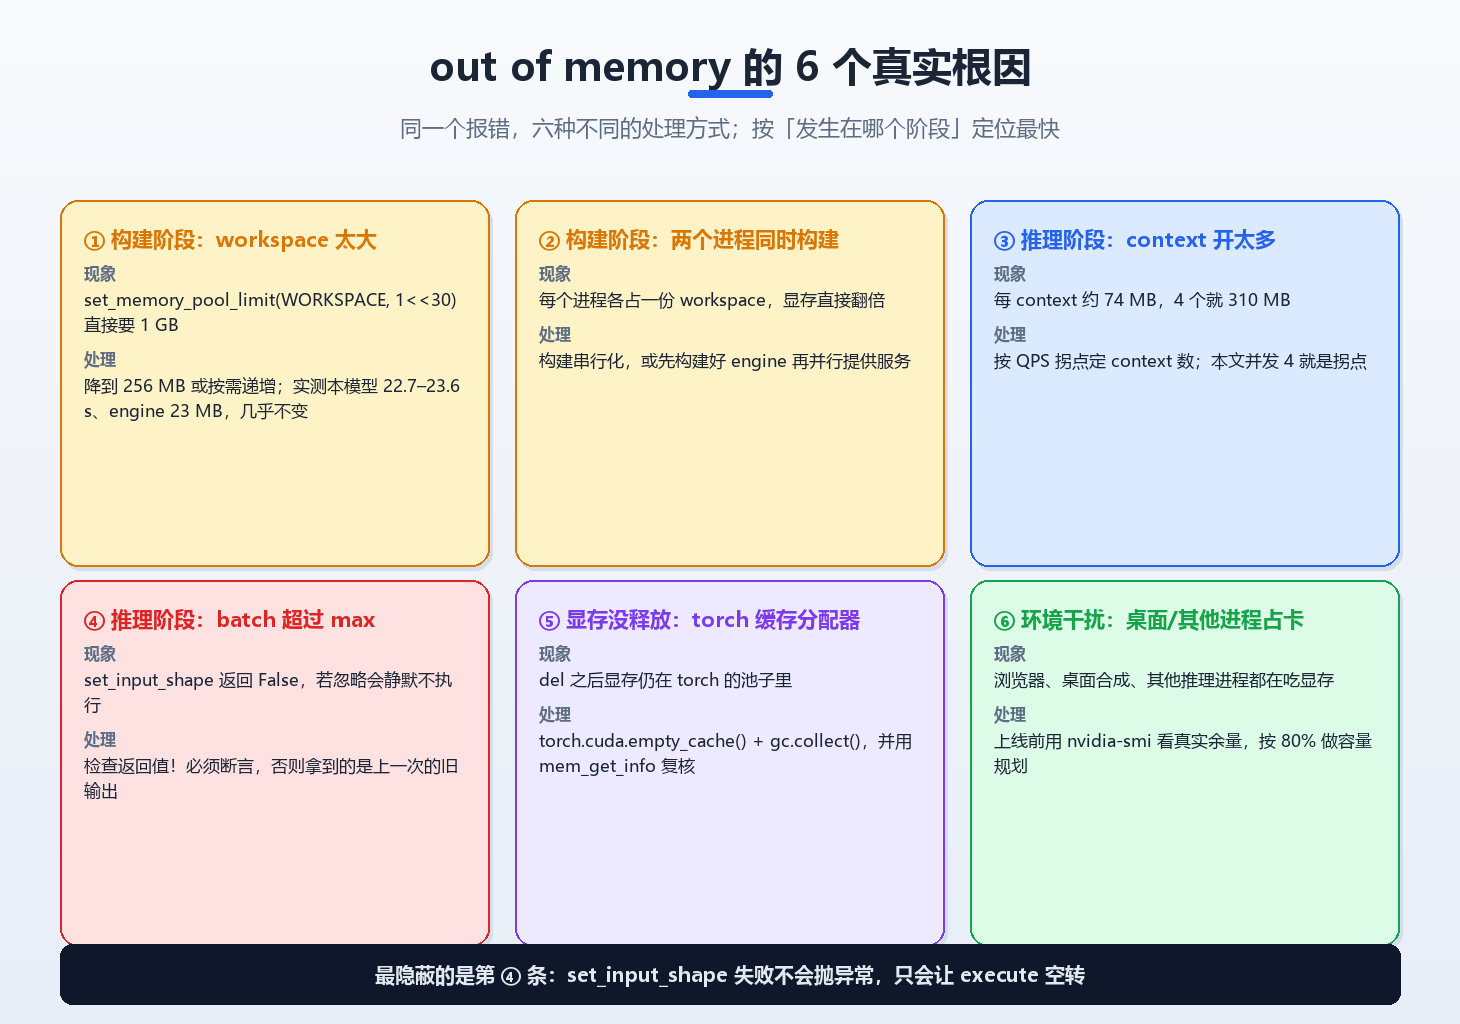
① 构建阶段:workspace 太大
config.set_memory_pool_limit(trt.MemoryPoolType.WORKSPACE, 1 << 30) # 直接要 1 GB
现象:构建 engine 时炸,报错里带 builder 或 cudaMalloc。
处理:先降到 256 MB 试;本文模型 256 MB 与 1 GB 的结果几乎一致(23.3 s / 23.2 MB)。
② 构建阶段:两个进程同时构建
每个进程各占一份 workspace,显存直接翻倍,还互相抢 GPU。
处理:构建串行化;或先构建好 engine 落盘,服务进程只做反序列化。
③ 推理阶段:context 开太多
每 context 约 74–88 MB,4 个就 310 MB。
处理:按 QPS 拐点定 context 数(第 4 篇实测本文是 4)。
④ 推理阶段:batch 超过 max —— 最隐蔽
这个必须单独讲,因为它不抛异常。
先用合法 batch 跑一次,再故意喂一个超出 max=32 的 batch:
set_ok = ctx.set_input_shape("input", (64, 3, 224, 224))
print(set_ok) # False —— 注意这里是 False
TensorRT 会在日志里打:
[TRT] [E] IExecutionContext::setInputShape: Error Code 3: API Usage Error
(Parameter check failed, condition: satisfyProfile.
Set dimension [64,3,224,224] for tensor input does not satisfy any optimization profiles.
Valid range for profile 0: [1,3,224,224]..[32,3,224,224].)
但 Python API 只是返回 False,不抛异常。 如果你写的是这样:
# ❌ 错误写法:忽略了返回值
ctx.set_input_shape(name, shape)
out = ctx.execute_async_v3(stream_handle=stream)
那么 execute 可能返回 True(或至少不报错),而你拿到的输出是上一次的旧数据或者未初始化的垃圾。这种 bug 极难排查,因为日志里只有一行 E 级错误,程序却"正常返回"。
正确写法:
# ✅ 必须检查返回值
if not ctx.set_input_shape(name, shape):
raise ValueError(f"输入形状 {shape} 超出 optimization profile 范围,"
f"请扩大 max 或拆分 batch")
我在写这篇的实测脚本时自己就踩了这个坑:第一版脚本把 execute 的返回值当成了"超限是否报错"的结论,实际上 set_input_shape 已经返回 False、执行根本没发起。看到这条,请顺手检查你项目里的 set_input_shape 是否检查了返回值。
⑤ 显存没释放:torch 的缓存分配器
del dev_in, dev_out # 显存仍在 torch 的池子里,没还给 GPU
现象:del 之后 nvidia-smi 显示显存没降,下一轮又 OOM。
处理:
import gc, torch
del dev_in, dev_out
gc.collect()
torch.cuda.empty_cache() # 把缓存池还给 CUDA
free, total = torch.cuda.mem_get_info()
print(f"空闲 {(total–free)/1024**2:.0f} MB / 共 {total/1024**2:.0f} MB") # 复核
⑥ 环境干扰:桌面与其他进程占卡
Windows 桌面的合成器、浏览器、其他推理进程都在吃显存。本文机器上基线就有 1125 MB(空转、未加载 engine)。
处理:上线前用 nvidia-smi 看真实余量,按 80% 做容量规划,别按标称显存算。
六、四步排查流程
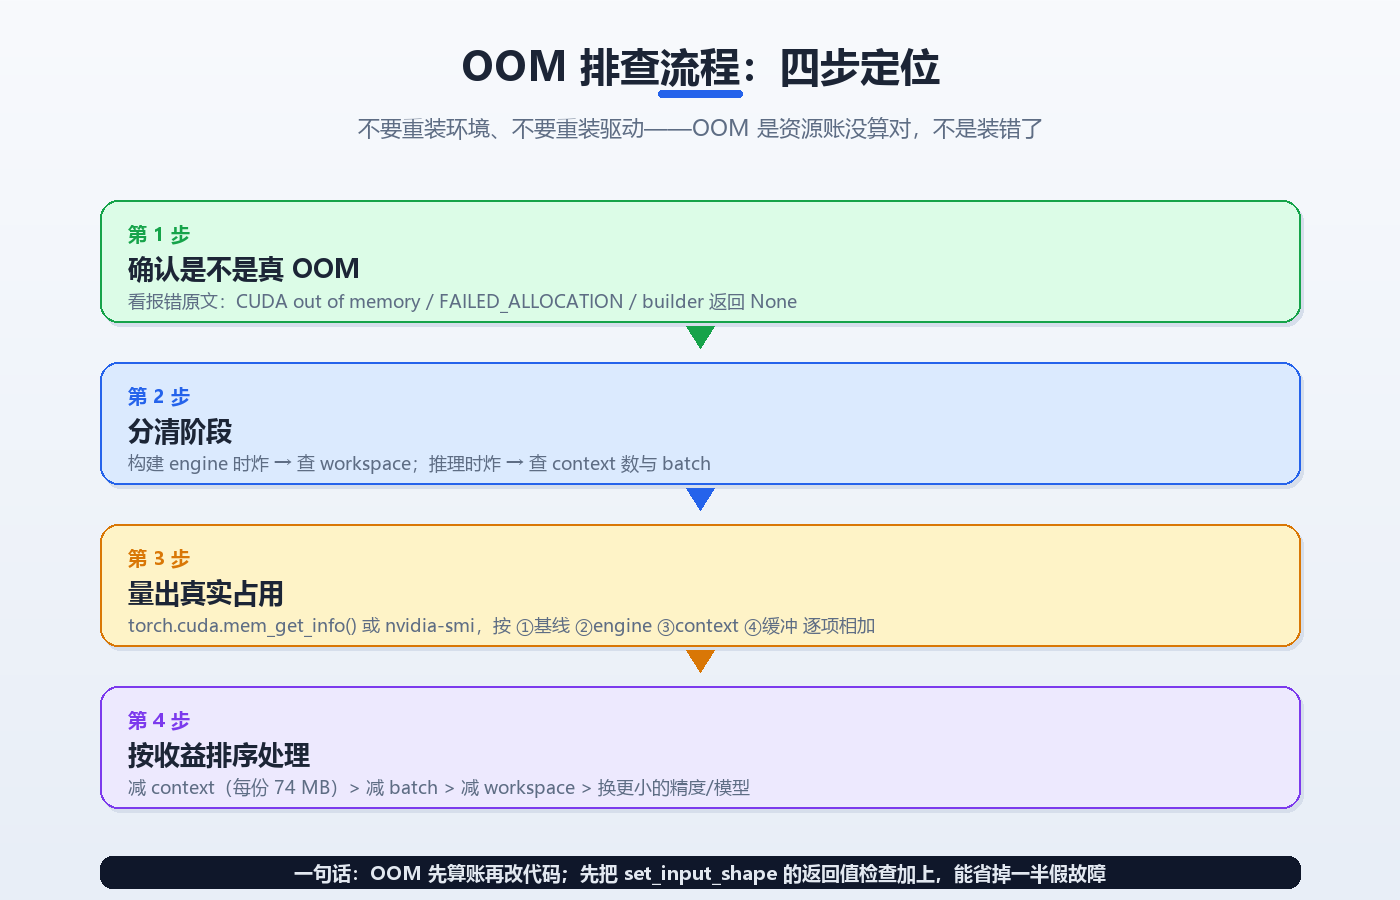
| 第 1 步 | 确认是不是真 OOM | CUDA out of memory / FAILED_ALLOCATION / builder 返回 None |
| 第 2 步 | 分清阶段 | 构建时炸 → 查 workspace;推理时炸 → 查 context 数与 batch |
| 第 3 步 | 量出真实占用 | mem_get_info() 或 nvidia-smi,按 ①基线 ②engine ③context ④缓冲 逐项相加 |
| 第 4 步 | 按收益排序处理 | 减 context(每份 74 MB)> 减 batch > 减 workspace > 换更小的精度/模型 |
一个可以直接贴进项目里的最小监控函数:
import torch
def gpu_report(tag: str = "") –> dict:
free, total = torch.cuda.mem_get_info()
used = total – free
return {
"tag": tag,
"used_mb": round(used / 1024 ** 2, 1),
"total_mb": round(total / 1024 ** 2, 1),
"used_pct": round(used / total * 100, 1),
"reserved_mb": round(torch.cuda.memory_reserved() / 1024 ** 2, 1),
"allocated_mb": round(torch.cuda.memory_allocated() / 1024 ** 2, 1),
}
# 打印结果示例:
# {'tag': 'after_engine', 'used_mb': 1149.5, 'total_mb': 8188.0,
# 'used_pct': 14.0, 'reserved_mb': 0.0, 'allocated_mb': 0.0}
used_mb 看的是显卡真实占用(含 TensorRT 的分配),reserved_mb / allocated_mb 看的是 torch 自己的池子。两个数字一起看,才能区分"被 torch 缓存住了"和"真被占用了"。
常见问题(FAQ)
Q1:engine 文件只有 23 MB,为什么跑起来显存要一百多 MB?
engine 文件只包含序列化后的权重与执行计划,反序列化到显存是 24 MB;真正的大头是创建 IExecutionContext(本文 88 MB,含执行期工作区与内核绑定)和每个请求的输入/输出缓冲。实测单 context + batch=1 合计 114 MB,其中 context 占 77.2%。
Q2:开多个 context 会占多少显存?
线性增长,实测每 context 约 74–88 MB:1 个 88 MB、2 个 162 MB、4 个 310 MB。加上 engine 24 MB 后,4 个 context 合计 336 MB,约为单 context(114 MB)的 2.9 倍。显存紧张时优先减 context 数。
Q3:把 batch 从 32 降到 1 能省多少显存?
在本例的动态 engine 上只能省 20 MB(22 MB → 2 MB),因为工作区按 max profile 一次性预留。降 batch 的主要收益是降低延迟(batch 32 → 1,延迟从 4.70 ms 降到 0.36 ms),而不是省显存。
Q4:workspace 设 1 GB 有必要吗?
本文模型没必要。实测不限制 / 256 MB / 1024 MB 三种上限,构建耗时 23.6 / 23.3 / 22.7 s、engine 体积 23.3 / 23.2 / 23.1 MB,差异在噪声范围内。但复杂模型上 workspace 过小会让 TensorRT 放弃某些优化 tactic,反而变慢;建议先用 256 MB,出现性能异常再调大并观察构建日志。
Q5:set_input_shape 返回 False 意味着什么?
意味着你给的形状超出了 engine 的 optimization profile 范围(min/max)。它不抛异常,只是返回 False;此时 execute_async_v3 可能仍然返回成功但不做任何计算,你会拿到旧数据或垃圾数据。必须显式检查返回值并抛错,或用 try/except 包住调用。
Q6:为什么 del 了张量,nvidia-smi 里的显存没降?
PyTorch 的缓存分配器不会立刻把显存还给 GPU,而是留在池子里复用。要真正释放需要 gc.collect() + torch.cuda.empty_cache(),然后用 torch.cuda.mem_get_info() 复核。注意 TensorRT 自己分配的显存不受 empty_cache() 影响,只有销毁 context / engine 才会释放。
Q7:8 GB 显卡能跑多大的模型?
用本文公式倒推:可用显存 = 标称 − 桌面占用(约 2.3 GB),再留 20% 余量。8 GB 卡实际可分给服务约 4.5 GB;减去基线约 1.1 GB,剩约 3.4 GB 给 engine + context + 缓冲。一个 1 GB 的 engine + 4 个 context(约 0.3 GB)是可用的;engine 到 3 GB 就只能单 context 串行了。
Q8:构建 engine 时 OOM,但推理时正常,是什么原因?
构建期需要 workspace(可到数百 MB 甚至数 GB),且与推理期的显存需求叠加。如果你的服务进程里同时做"首次缺失就现编 engine",构建峰值会撞上已有 context 的占用。处理:构建与推理分离到不同进程,或先把 engine 落盘再启动服务。
小结
下一篇我们聊多模型并发与显存调度:一个服务里挂多个 engine(分类 + 检测 + OCR)时怎么分配显存、怎么按请求类型路由、以及超时与降级策略。