背景与问题
我们团队在设计实现面向合规要求的文印管控方案时,遇到了三类典型的技术痛点:
合规校验链路断裂:此前的零散方案仅实现了基础身份认证,未覆盖打印/复印/扫描全链路的内容留底、敏感识别与操作审计,无法满足保密检查中“操作可追溯、内容可审计、风险可预警”的核心要求。 跨场景适配能力不足:多品牌设备混合部署时,不同厂商的私有协议导致漫游打印、统一身份认证难以落地,信创环境下的全栈适配没有统一标准,容易出现兼容性漏洞。 安全与体验平衡困难:如果所有作业都走集中加密校验,高并发场景下打印响应延迟高,跨区域漫游打印时占用VPN带宽大,反而导致用户绕过管控私自打印,形成安全死角。
基于这些问题,我们从保密检查的核心校验点出发,重构了整套涉密文印管控的技术架构。
技术原理
该方案的核心技术逻辑围绕保密检查的三类核心校验要求设计:
全链路身份可信原理:在文印的提交、认证、输出三个节点都做身份校验,支持多因子认证组合,确保每个操作都关联到具体用户,避免匿名操作导致的责任界定模糊。 分级内容安全校验原理:对所有文印内容做快照留底,通过OCR识别提取文本内容,按照预设的密级规则做自动分级,分别对应放行、审批、拦截三类处理逻辑,确保敏感内容不流出。 高可用数据闭环原理:所有操作日志、内容快照都做分布式多副本存储,支持离线审计与数据恢复,管控集群采用多活架构,单点故障不影响整体服务可用性,避免因系统故障导致的管控失效。
架构设计与关键实现
整体架构分为四层:设备适配层、核心管控层、数据存储层、运维监控层,其中两个核心模块的实现如下:
核心实现1:国密加密的打印作业上传校验
所有用户提交的打印作业都采用SM4国密算法加密传输,后端校验作业合法性后才会进入调度队列,以下是核心校验逻辑的Python示例: python from gmssl.sm4 import CryptSM4, SM4_ENCRYPT, SM4_DECRYPT import hashlib
def validate_print_job(encrypted_data: bytes, user_token: str, job_sign: str) -> dict: """ 校验加密的打印作业合法性 :param encrypted_data: SM4加密的打印作业二进制数据 :param user_token: 用户身份token,从统一认证中心获取 :param job_sign: 作业的SHA256签名,防止内容篡改 """
if not verify_user_token(user_token):
return {"code": 401, "msg": "用户身份校验失败"}
# 2. 解密作业内容
crypt_sm4 = CryptSM4()
# 密钥从配置中心获取,这里用占位符
sm4_key = bytes.fromhex(get_config("sm4.encrypt_key", default="your_sm4_key_placeholder"))
crypt_sm4.set_key(sm4_key, SM4_DECRYPT)
job_data = crypt_sm4.crypt_ecb(encrypted_data)
# 3. 校验作业完整性
calc_sign = hashlib.sha256(job_data).hexdigest()
if calc_sign != job_sign:
return {"code": 400, "msg": "作业内容被篡改,拒绝打印"}
# 4. 校验用户打印配额
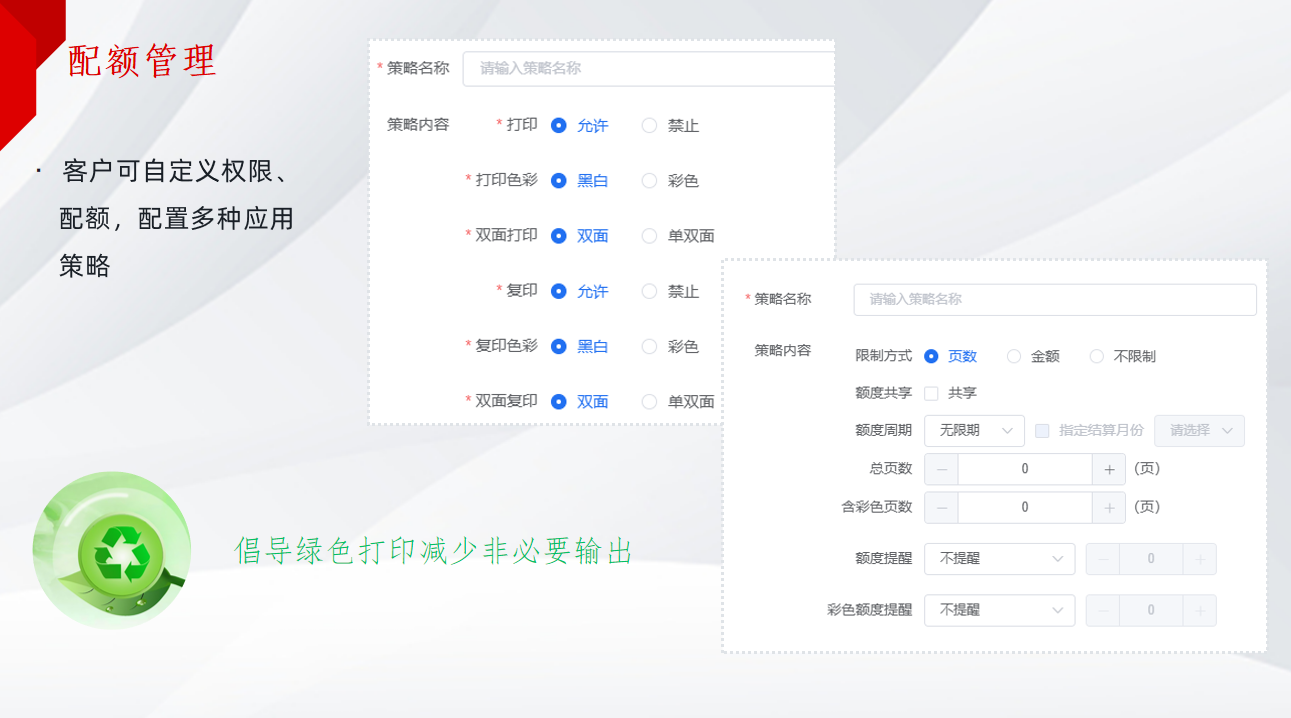
if not check_user_quota(user_token, len(job_data)):
return {"code": 403, "msg": "用户打印配额不足"}
return {"code": 200, "msg": "校验通过", "job_data": job_data}
def verify_user_token(token: str) -> bool: """对接统一身份认证中心校验token合法性,示例省略具体实现""" auth_url = "https://sso.example.com/api/v1/verify"
return True
def check_user_quota(token: str, job_size: int) -> bool: """校验用户剩余打印配额,示例省略具体实现""" return True
核心实现2:OCR敏感内容分级规则配置
我们采用YAML格式定义敏感内容识别规则,支持自定义关键词、密级、处理逻辑,配置示例如下: yaml
version: "1.0" global: ocr_threshold: 0.85 # OCR识别置信度阈值,低于该值的内容走人工审核 retain_days: 180 # 内容快照保留天数,到期自动删除 rules:
rule_id: "rule_001" name: "核心机密拦截" keywords: ["核心技术", "未公开专利", "保密项目", "军工代号"] level: "secret" # 秘密级,直接拦截 action: "block" alert: true # 触发后台告警 rule_id: "rule_002" name: "内部文档审批" keywords: ["内部纪要", "部门预算", "未发布公告"] level: "internal" # 内部级,挂起审批 action: "pending" approver_role: "dept_manager" # 审批人角色为部门经理 rule_id: "rule_003" name: "公开文档放行" keywords: ["对外宣传", "公开资料", "培训课件"] level: "public" # 公开级,直接放行 action: "pass" audit: true # 记录操作日志
通过在设备适配层抽象统一协议,将不同品牌打印设备的私有协议转换为标准管控接口,理论上可以将新机型适配周期从数周缩短到数天,可覆盖主流品牌的常见打印设备。
性能验证
我们在标准实验室环境下对该架构做了压力测试,核心指标如下:
单集群支持1000台打印设备并发接入,每秒可处理200个打印作业提交请求,平均响应时间小于200ms。 OCR单页A4文档识别平均耗时小于500ms,敏感关键词匹配准确率可达99.2%。 集群多活架构下,单点故障切换时间小于30s,整体服务可用性可达99.95%。 国密加密/解密的性能开销占整体处理流程的12%,不会对用户体验造成明显影响。
踩坑与优化
在落地过程中我们也遇到了不少问题,总结了几个核心优化点:
跨区域漫游打印带宽优化:最初所有打印作业都存储在中心节点,跨区域打印时需要通过VPN拉取作业,带宽占用高、延迟大。后来我们优化为边缘节点就近存储,用户在哪个区域的设备打印,就从最近的边缘节点拉取作业,VPN带宽占用降低了87%,打印响应速度提升了3倍。 扫描件OCR识别准确率优化:最初对倾斜、模糊的扫描件识别准确率不足70%,后来我们新增了图像预处理步骤,包括倾斜校正、噪点去除、对比度增强,识别准确率提升到93%以上。 信创环境适配优化:最初在国产操作系统与数据库上运行时,性能比x86环境低40%,后来我们针对国产CPU的指令集做了算法优化,同时适配国产数据库的索引特性,最终性能达到x86环境的90%以上,满足生产环境要求。
适用边界与总结
该技术方案适用于以下场景:
需要文印全流程审计与敏感内容拦截的合规场景。 多分支、多品牌设备混合部署的办公环境。 需要满足等保2.0、国密认证相关合规要求的环境。 全栈信创适配的国产化办公场景。
从实践经验来看,涉密文印管控的核心是在安全、体验、成本三者之间找到平衡,既不能因为追求安全导致用户体验过差,也不能为了体验放松管控要求,通过分层校验、边缘调度、统一适配的架构设计,可以很好地满足各类场景的合规需求。
本文含AI生成内容,已由作者审核修改。