背景与问题
我们团队在迭代某分布式打印管理方案的过程中,接到了涉密场景下的适配需求,要求系统必须满足保密检查的全部合规要求。在前期梳理需求时我们遇到了几个核心卡点:
原有系统的文印操作仅记录了操作人、时间等元数据,没有留存操作内容快照,无法满足事后追溯的审计要求;
身份认证存在旁路漏洞,部分老旧设备可通过直连IP的方式绕过系统管控直接打印,存在泄密风险;
敏感内容无法提前拦截,仅靠事后审计无法避免涉密文件流出;
部署环境要求全栈信创适配,原有架构对国产操作系统、数据库、打印设备的兼容性不足。
针对这些问题,我们从零开始重构了涉密场景下的文印管控架构,经过多轮合规校验与落地实践,最终形成了一套可通过保密检查的通用技术实现方案。
技术原理
涉密文印管控的核心逻辑是构建「全链路无旁路、全操作可追溯、全内容可管控」的闭环防护体系,核心技术原理包括四点:
零信任认证原理:所有文印操作(打印、复印、扫描)的请求必须经过统一认证网关校验,不存在任何可绕过管控的操作路径,未认证用户无法操作任何设备;
内容闭环留底原理:所有文印内容的快照、操作元数据仅在服务器内存中处理,加密存储于服务端,终端、打印设备均不保留明文内容副本;
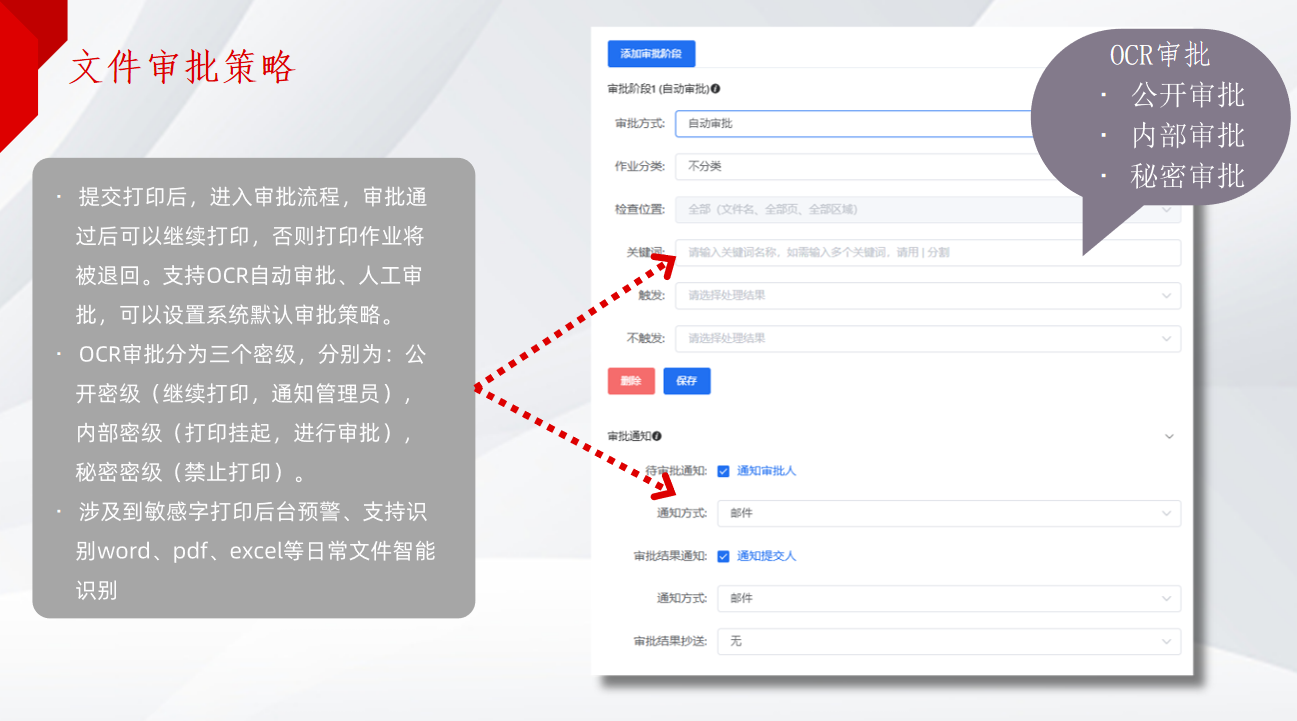
分级审批原理:基于OCR识别技术提取文印内容的文本信息,匹配敏感词库与密级规则,自动执行「直接放行、通知后放行、人工审批、禁止打印」的分级处理策略;
高可用容灾原理:管控集群采用多节点互备架构,数据多副本存储,支持故障自动切换与快速备份恢复,避免因服务中断或数据丢失影响合规性。
架构设计与关键实现
整个架构分为五层,从上到下分别是接入层、认证层、内容处理层、存储层、设备适配层:
1. 接入层
统一接收所有终端的打印请求、设备的操作请求,屏蔽不同终端、设备的协议差异,对外提供标准REST接口。
2. 认证层
对所有请求进行身份校验与权限校验,支持账号密码、域认证、刷卡、人脸、扫码等多种认证方式,校验通过后才允许进入下一处理环节。核心拦截逻辑示例如下: java /**
打印作业请求拦截器,用于身份校验与权限验证 */ @Component public class PrintJobInterceptor implements HandlerInterceptor { @Override public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception { // 从请求头获取用户认证token String token = request.getHeader("X-Auth-Token"); if (StrUtil.isBlank(token)) { response.setStatus(HttpServletResponse.SC_UNAUTHORIZED); response.getWriter().write("Missing authentication token"); return false; } // 校验token合法性,获取用户信息 UserInfo userInfo = AuthService.verifyToken(token); if (userInfo == null) { response.setStatus(HttpServletResponse.SC_FORBIDDEN); response.getWriter().write("Invalid authentication token"); return false; } // 校验用户当前打印权限(是否有对应设备的使用权限、彩色/黑白权限、配额剩余) Long deviceId = Long.parseLong(request.getParameter("deviceId")); PrintPermission permission = PermissionService.checkUserPrintPermission(userInfo.getUserId(), deviceId); if (!permission.isAllowed()) { response.setStatus(HttpServletResponse.SC_FORBIDDEN); response.getWriter().write("No print permission for current device"); return false; } // 将用户信息与权限信息存入请求上下文 request.setAttribute("userInfo", userInfo); request.setAttribute("printPermission", permission); return true; } }
3. 内容处理层
对打印作业的内容进行OCR识别、敏感词匹配、水印叠加、加密处理,核心逻辑示例如下: python import pytesseract from PIL import Image import fitz # PyMuPDF用于处理PDF from typing import Tuple
SENSITIVE_WORDS = {"机密", "内部资料", "核心专利", "薪酬明细"}
SECRET_LEVEL_POLICY = { "公开": 0, "内部": 2, "秘密": 3 }
def detect_sensitive_content(file_path: str, file_type: str = "pdf") -> Tuple[int, list]: """ 检测文件中的敏感内容,返回处理策略与匹配到的敏感词列表 """ match_words = []
if file_type == "pdf":
doc = fitz.open(file_path)
for page in doc:
pix = page.get_pixmap()
img = Image.frombytes("RGB", [pix.width, pix.height], pix.samples)
text = pytesseract.image_to_string(img, lang="chi_sim+eng")
for word in SENSITIVE_WORDS:
if word in text:
match_words.append(word)
elif file_type in ["png", "jpg", "jpeg"]:
img = Image.open(file_path)
text = pytesseract.image_to_string(img, lang="chi_sim+eng")
for word in SENSITIVE_WORDS:
if word in text:
match_words.append(word)
# 匹配密级规则
if "秘密" in match_words:
return SECRET_LEVEL_POLICY["秘密"], match_words
elif "内部" in match_words or len(match_words) >=3:
return SECRET_LEVEL_POLICY["内部"], match_words
else:
return SECRET_LEVEL_POLICY["公开"], match_words
4. 存储层
加密存储所有打印作业快照、操作日志、审计数据,支持国产达梦、人大金仓等数据库,数据多副本存储,定期自动备份。
5. 设备适配层
抽象统一的设备控制协议,屏蔽不同品牌、型号打印设备的差异,支持作业下发、状态查询、缓存清理等统一操作,通过该抽象层,理论上可覆盖主流品牌的常见机型。
性能验证
在标准实验室环境下对该架构进行压力测试,核心性能指标如下:
单服务节点可支持1000台并发设备接入,单台设备每秒提交2份打印作业的场景下,作业处理平均延迟小于200ms;
单页A4文档OCR识别与敏感词匹配平均耗时小于500ms;
集群部署模式下,单节点宕机后服务自动切换时间小于30s;
数据备份恢复RPO小于5分钟,RTO小于30分钟,满足涉密场景的高可用要求。
踩坑与优化
在落地实践过程中我们也遇到了不少问题,经过多轮迭代优化才达到合规要求:
设备本地缓存泄露问题:前期适配部分国产打印机时,发现设备会自动缓存最近10份打印作业的明文内容,不符合保密要求。后来我们在设备适配层抽象了统一的缓存清理接口,每次打印作业完成后,主动向设备发送缓存清理指令,同时关闭设备的本地存储功能,从根源上避免内容泄露。
加密PDF识别失败问题:测试中发现加密的PDF文档无法直接提取内容进行OCR检测,容易造成敏感内容漏判。后来我们增加了内存级解密模块,仅在服务器内存中对加密文档进行临时解密,完成内容检测后立即销毁解密后的副本,全程不落地存储,兼顾了检测准确性与数据安全性。
跨分支漫游打印带宽占用过高问题:多分支部署场景下,最初的架构是所有打印作业都回传总部存储,跨分支漫游打印时需要跨VPN传输大文件,带宽占用极高。后来我们优化为边缘节点分布式存储架构,打印作业默认存储在提交地的边缘节点,仅在用户跨分支漫游时才临时传输对应作业到目标节点,完成打印后立即删除目标节点的副本,带宽占用降低了90%以上。
适用边界与总结
适用边界
该技术方案适用于以下场景:
需要文印全流程审计与敏感内容拦截的合规场景;
多分支、多品牌打印设备混合部署的管理场景;
需要全栈信创适配的国产化部署场景;
对文印数据安全性要求较高,需要实现数据闭环流转的场景。
同时存在一定局限性:对于不支持远程指令控制的老旧打印设备,无法实现自动缓存清理,需要手动关闭设备的本地存储功能;OCR识别对于手写内容、特殊格式的水印内容识别准确率存在一定限制,需要结合人工审批做补充。
总结
在涉密文印管控系统的设计与实现过程中,核心要抓住「无旁路、可追溯、不泄露、高可用」四个核心原则,从全链路的角度去做安全管控,而不是单点加防护。我们通过在认证层、内容处理层、存储层、适配层的多层防护设计,不仅满足了保密检查的各项要求,也兼顾了用户的使用体验与运维效率。
本文含AI生成内容,已由作者审核修改。