✨作者主页:IT毕设梦工厂✨ 个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。 ☑文末获取源码☑ 精彩专栏推荐⬇⬇⬇ Java项目 Python项目 安卓项目 微信小程序项目
文章目录
- 一、前言
- 二、开发环境
- 三、系统界面展示
- 四、部分代码设计
- 五、论文参考
- 六、系统视频
- 结语
一、前言
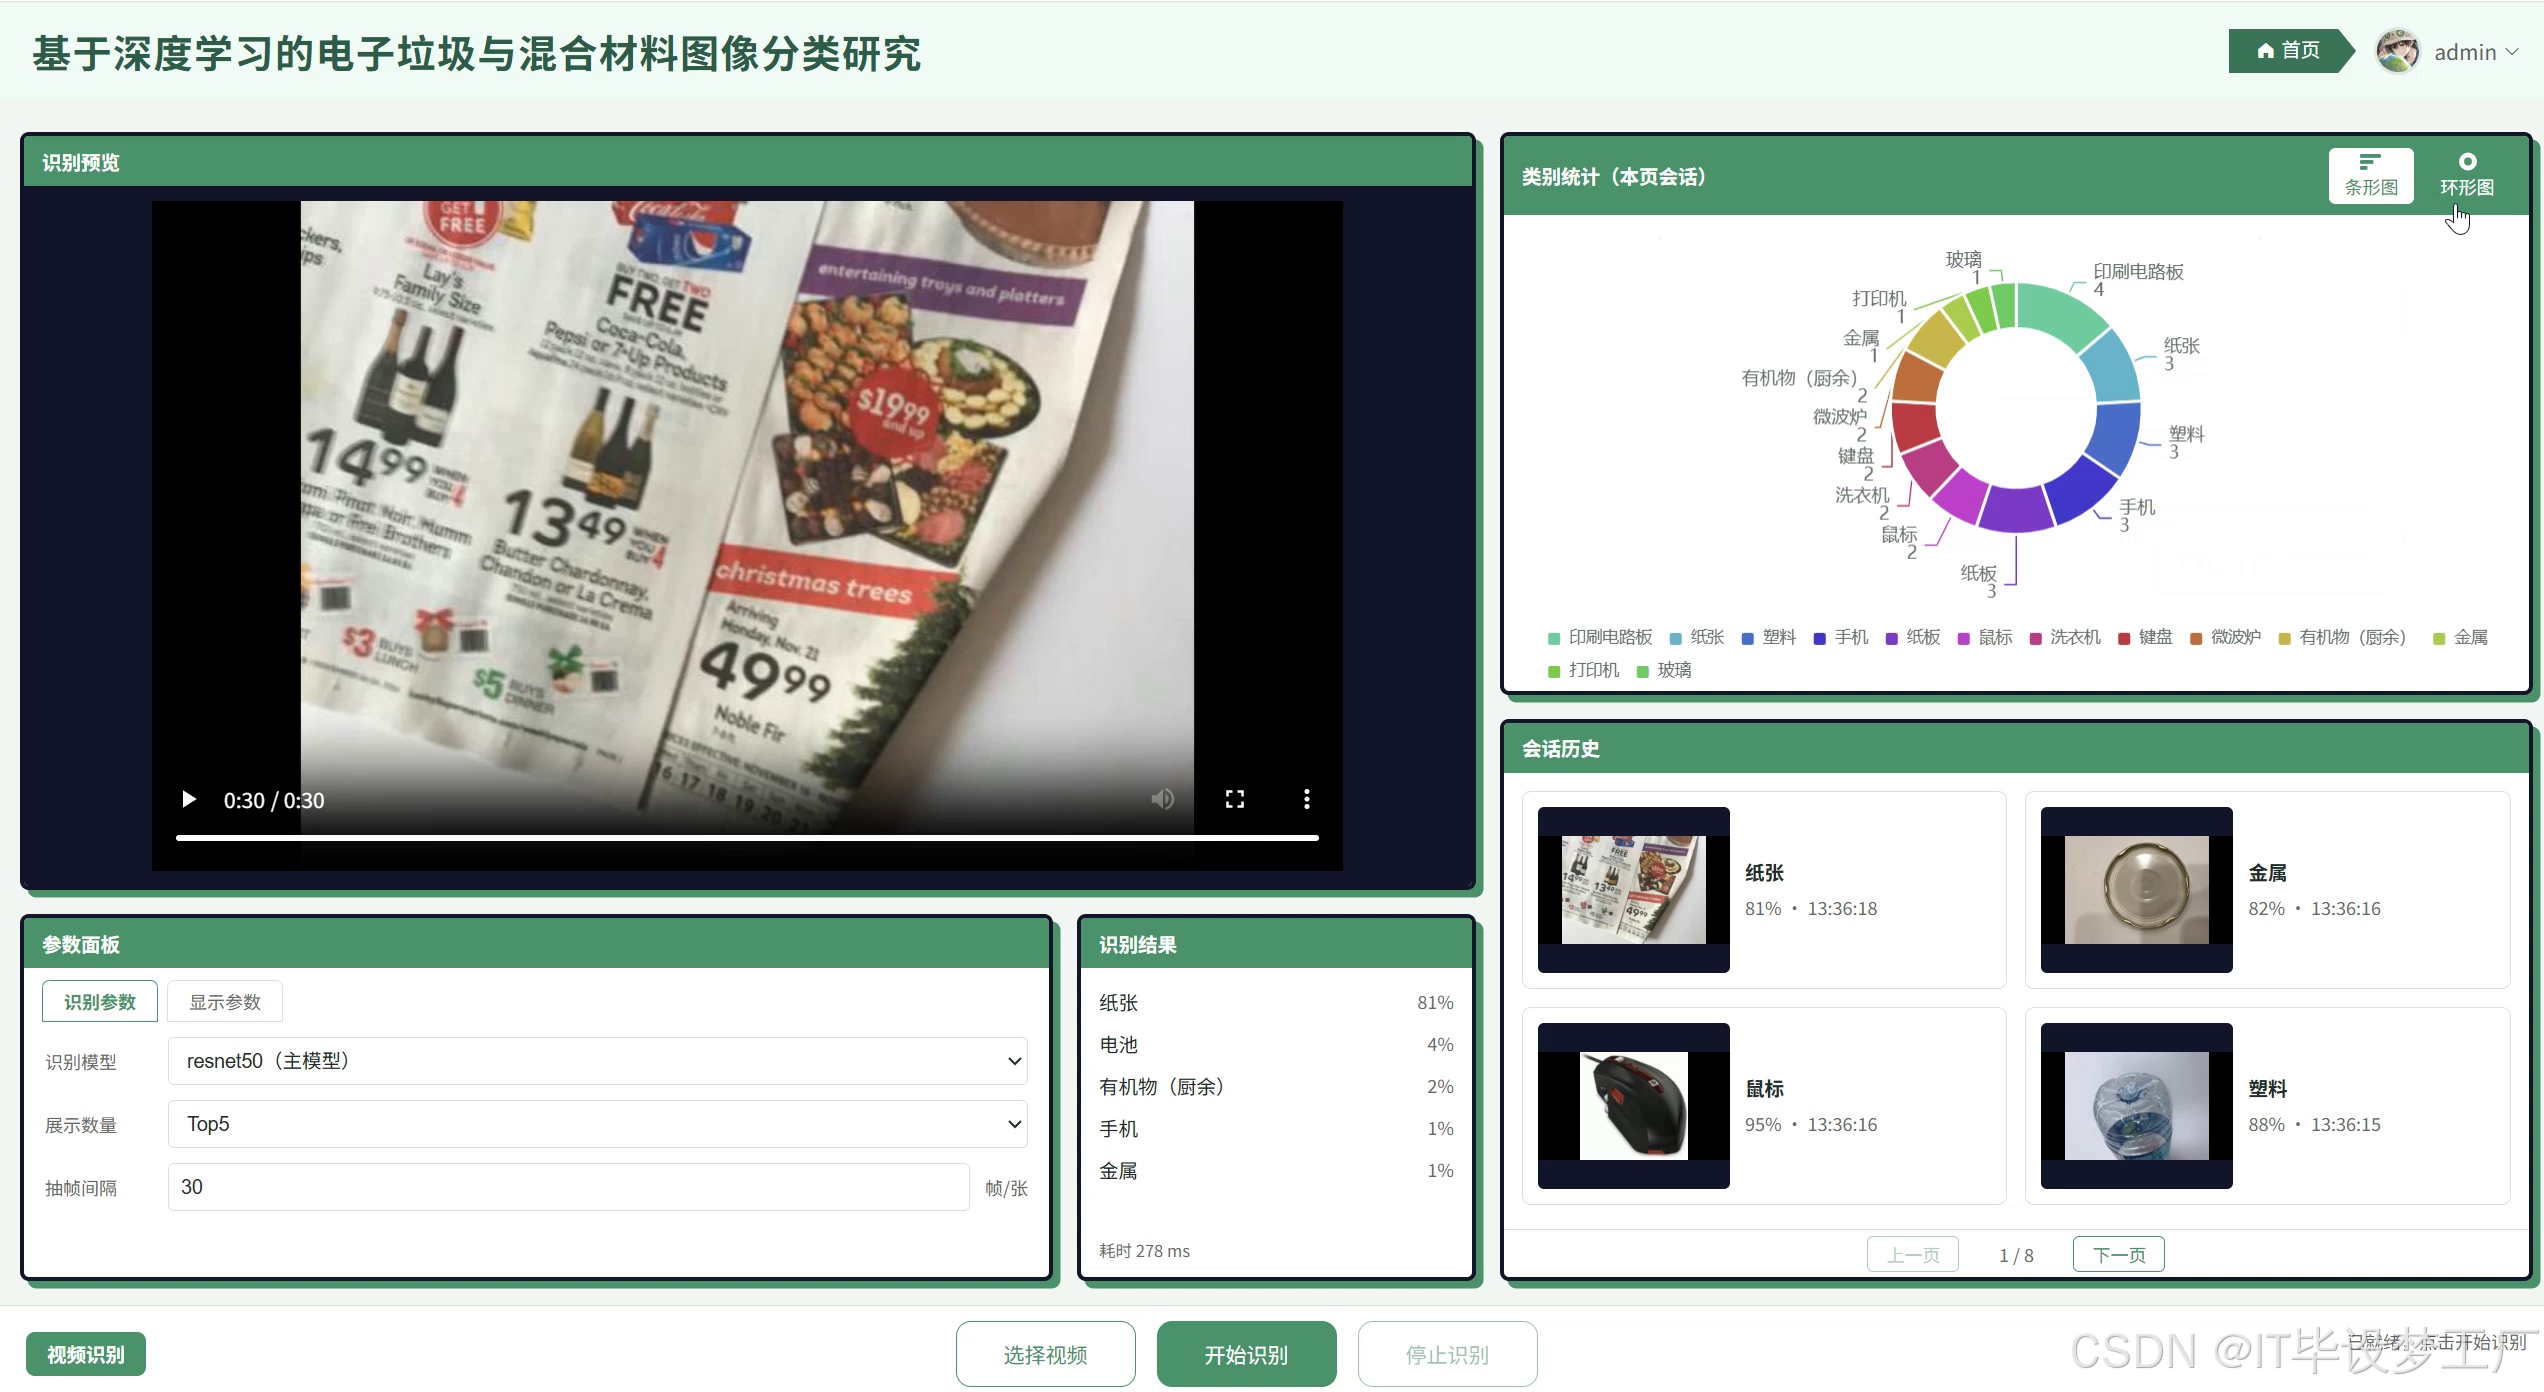
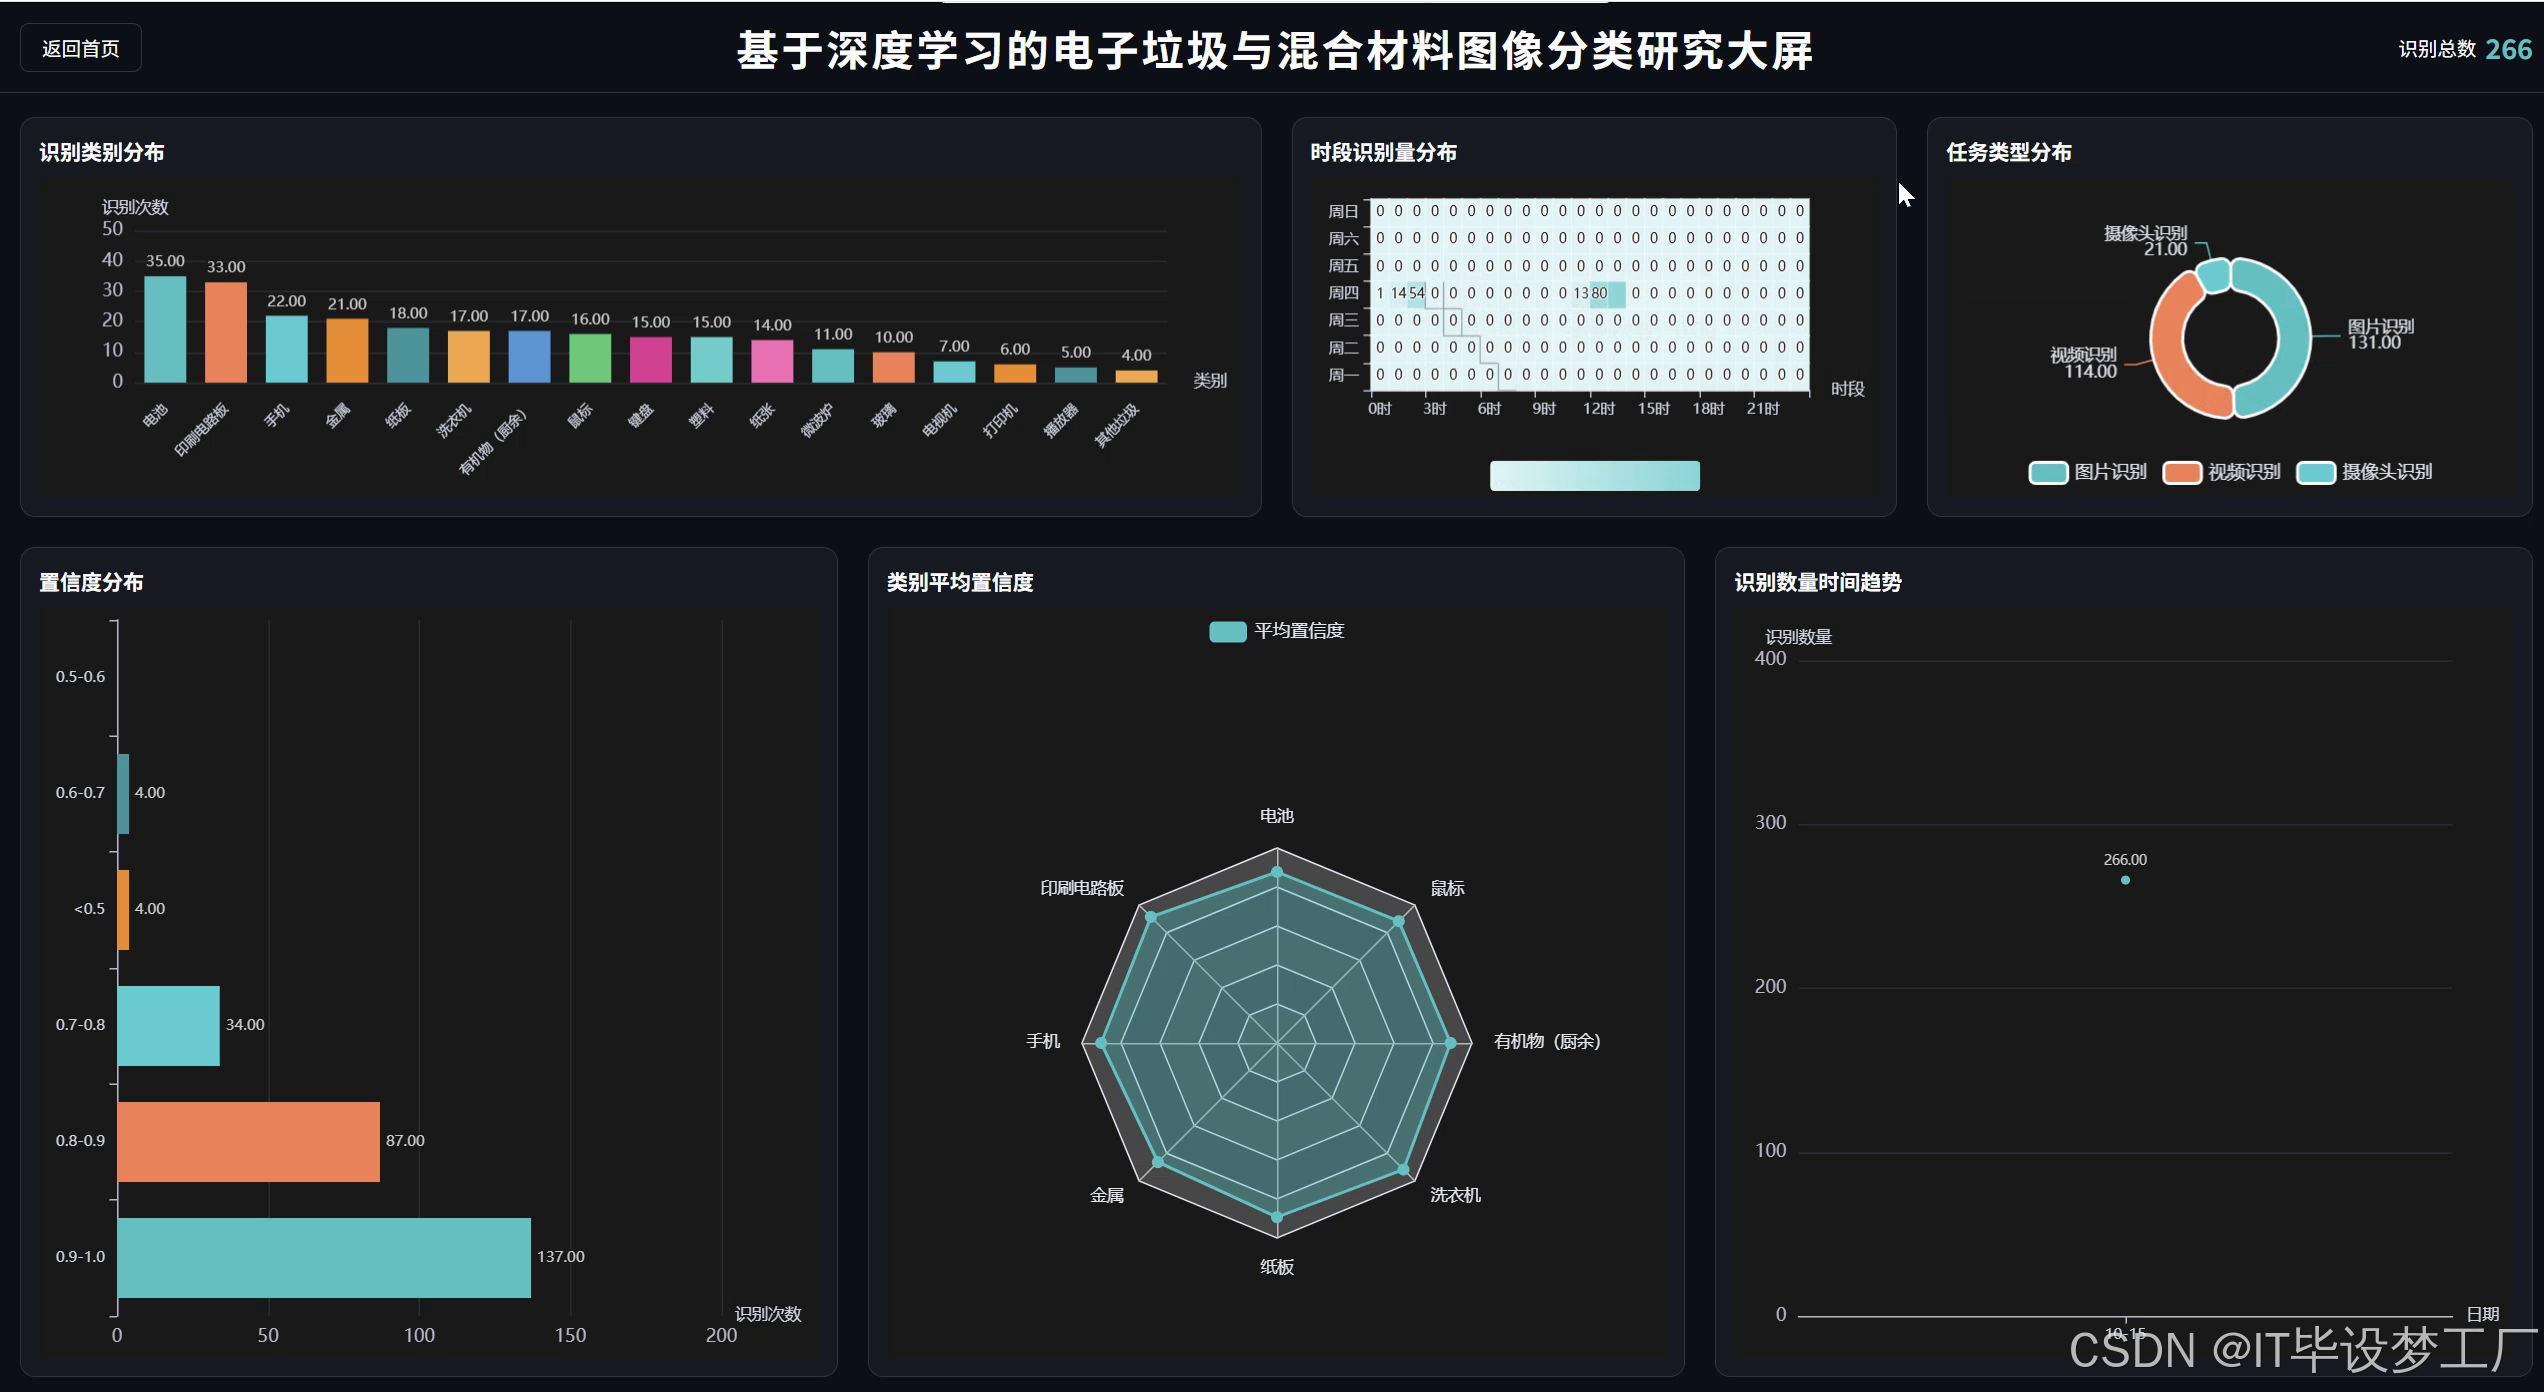
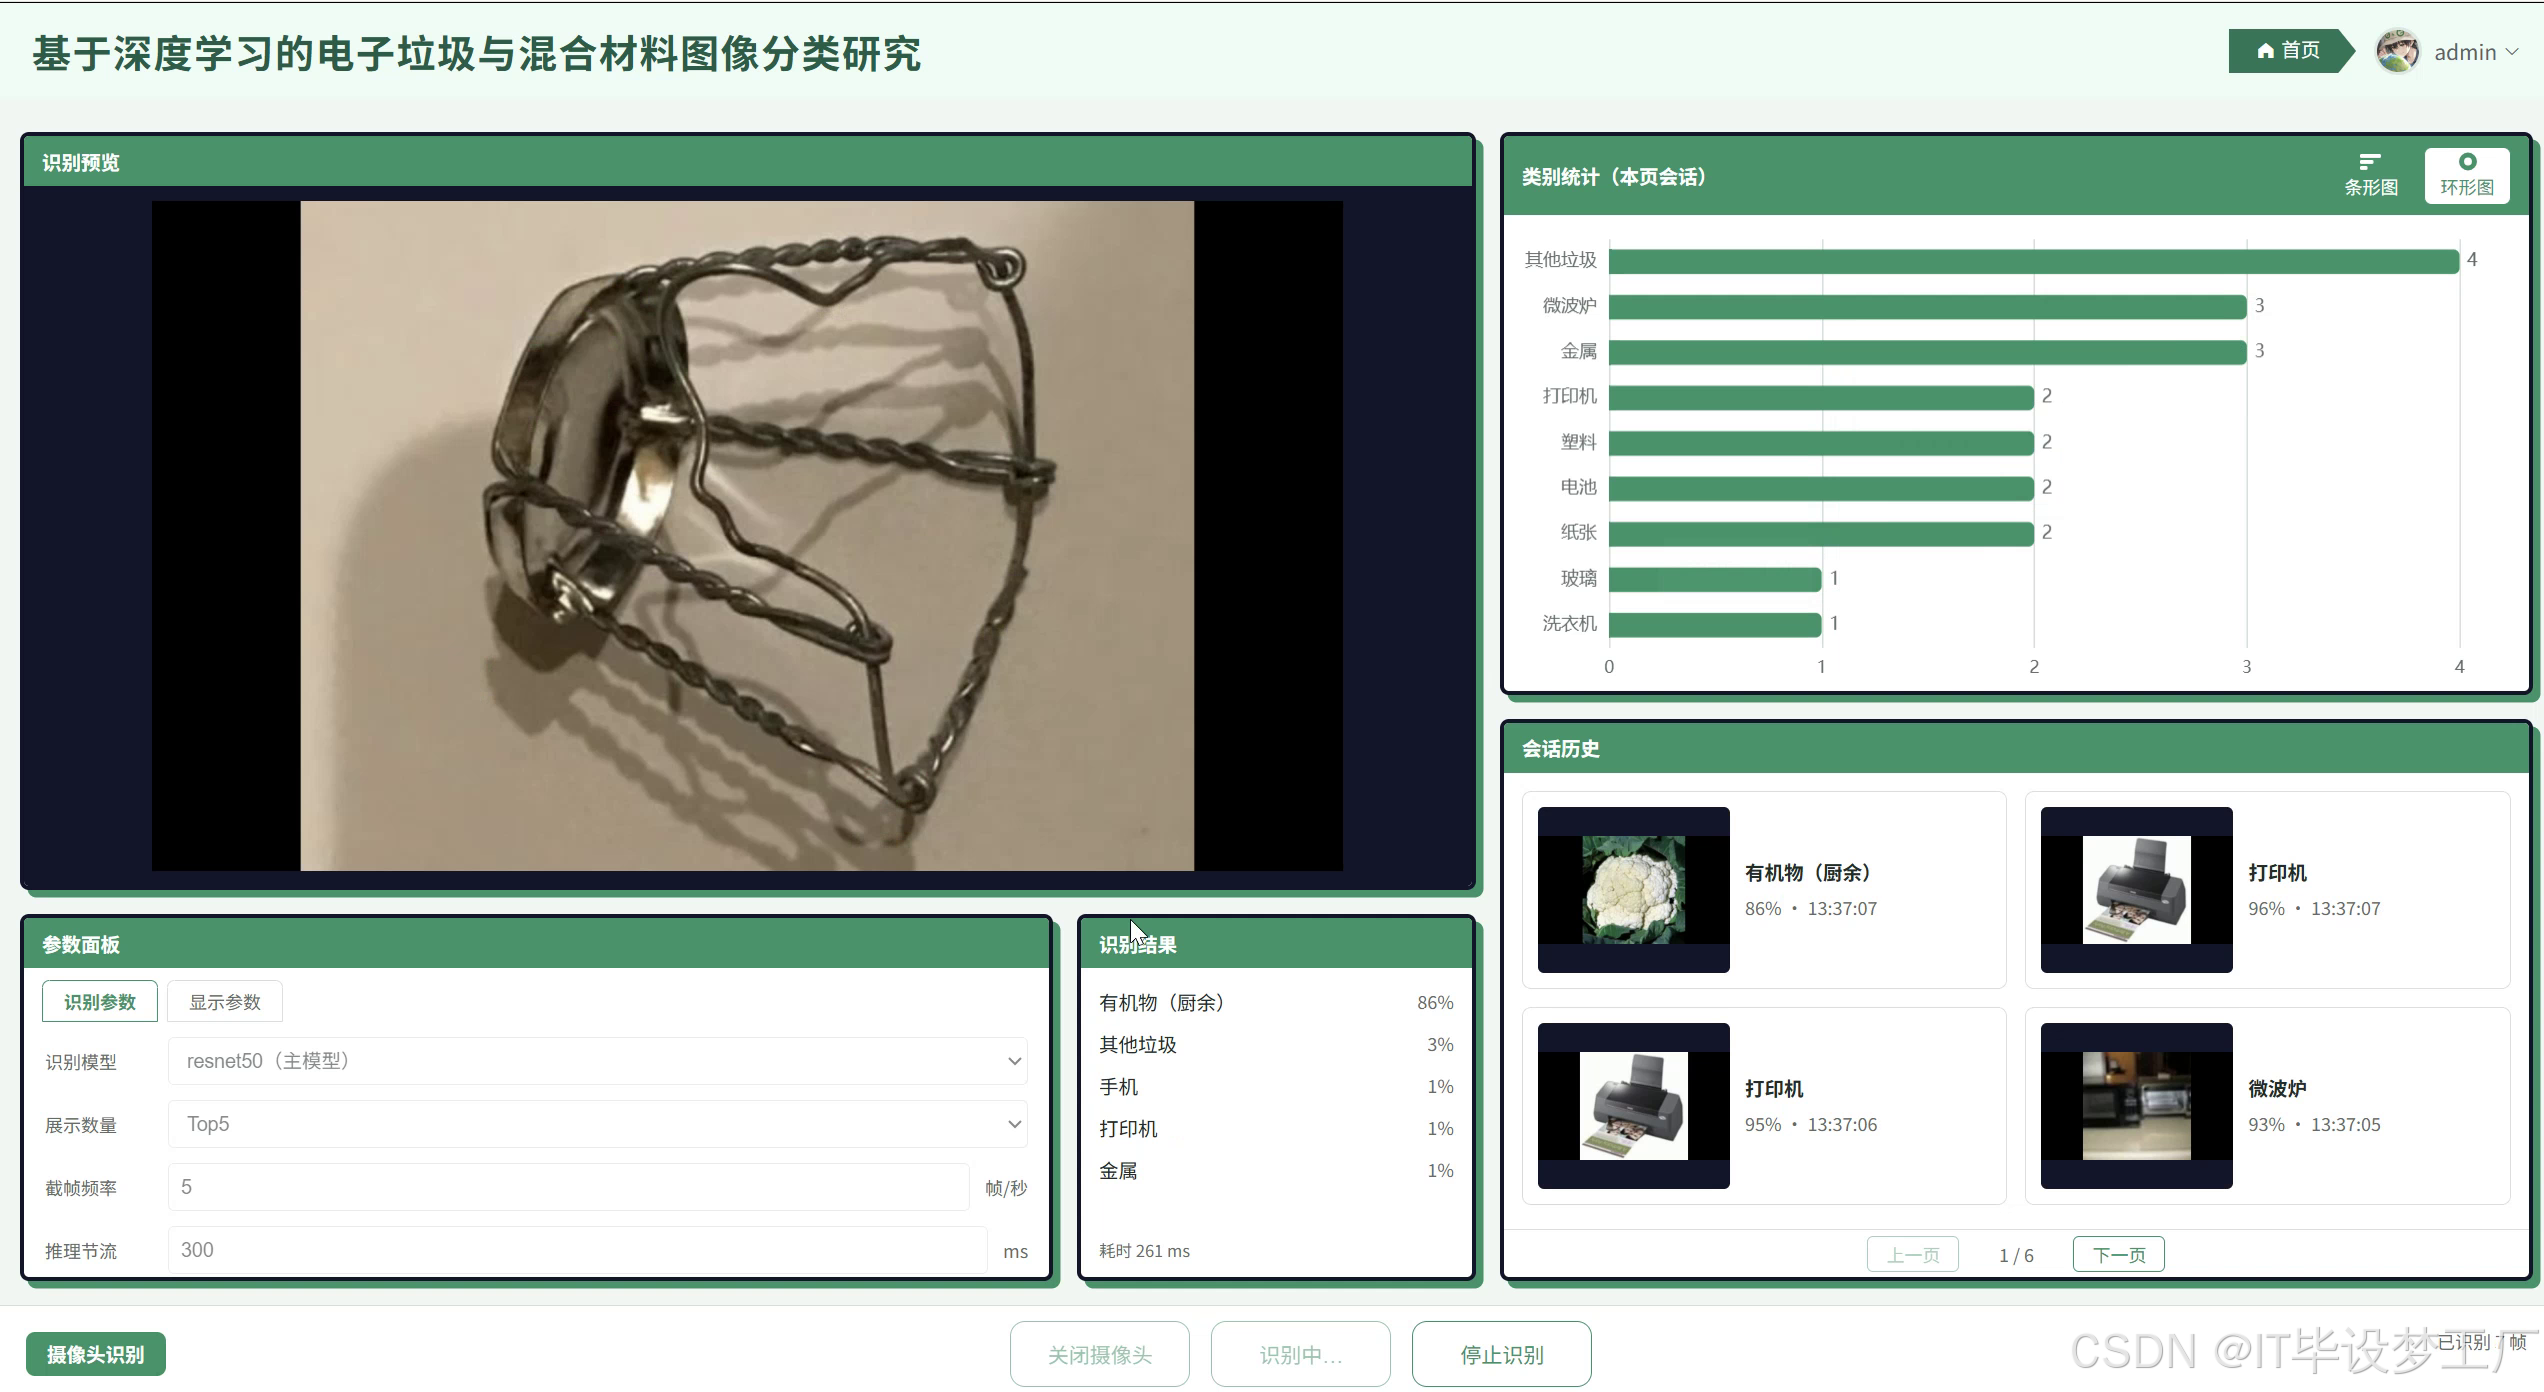
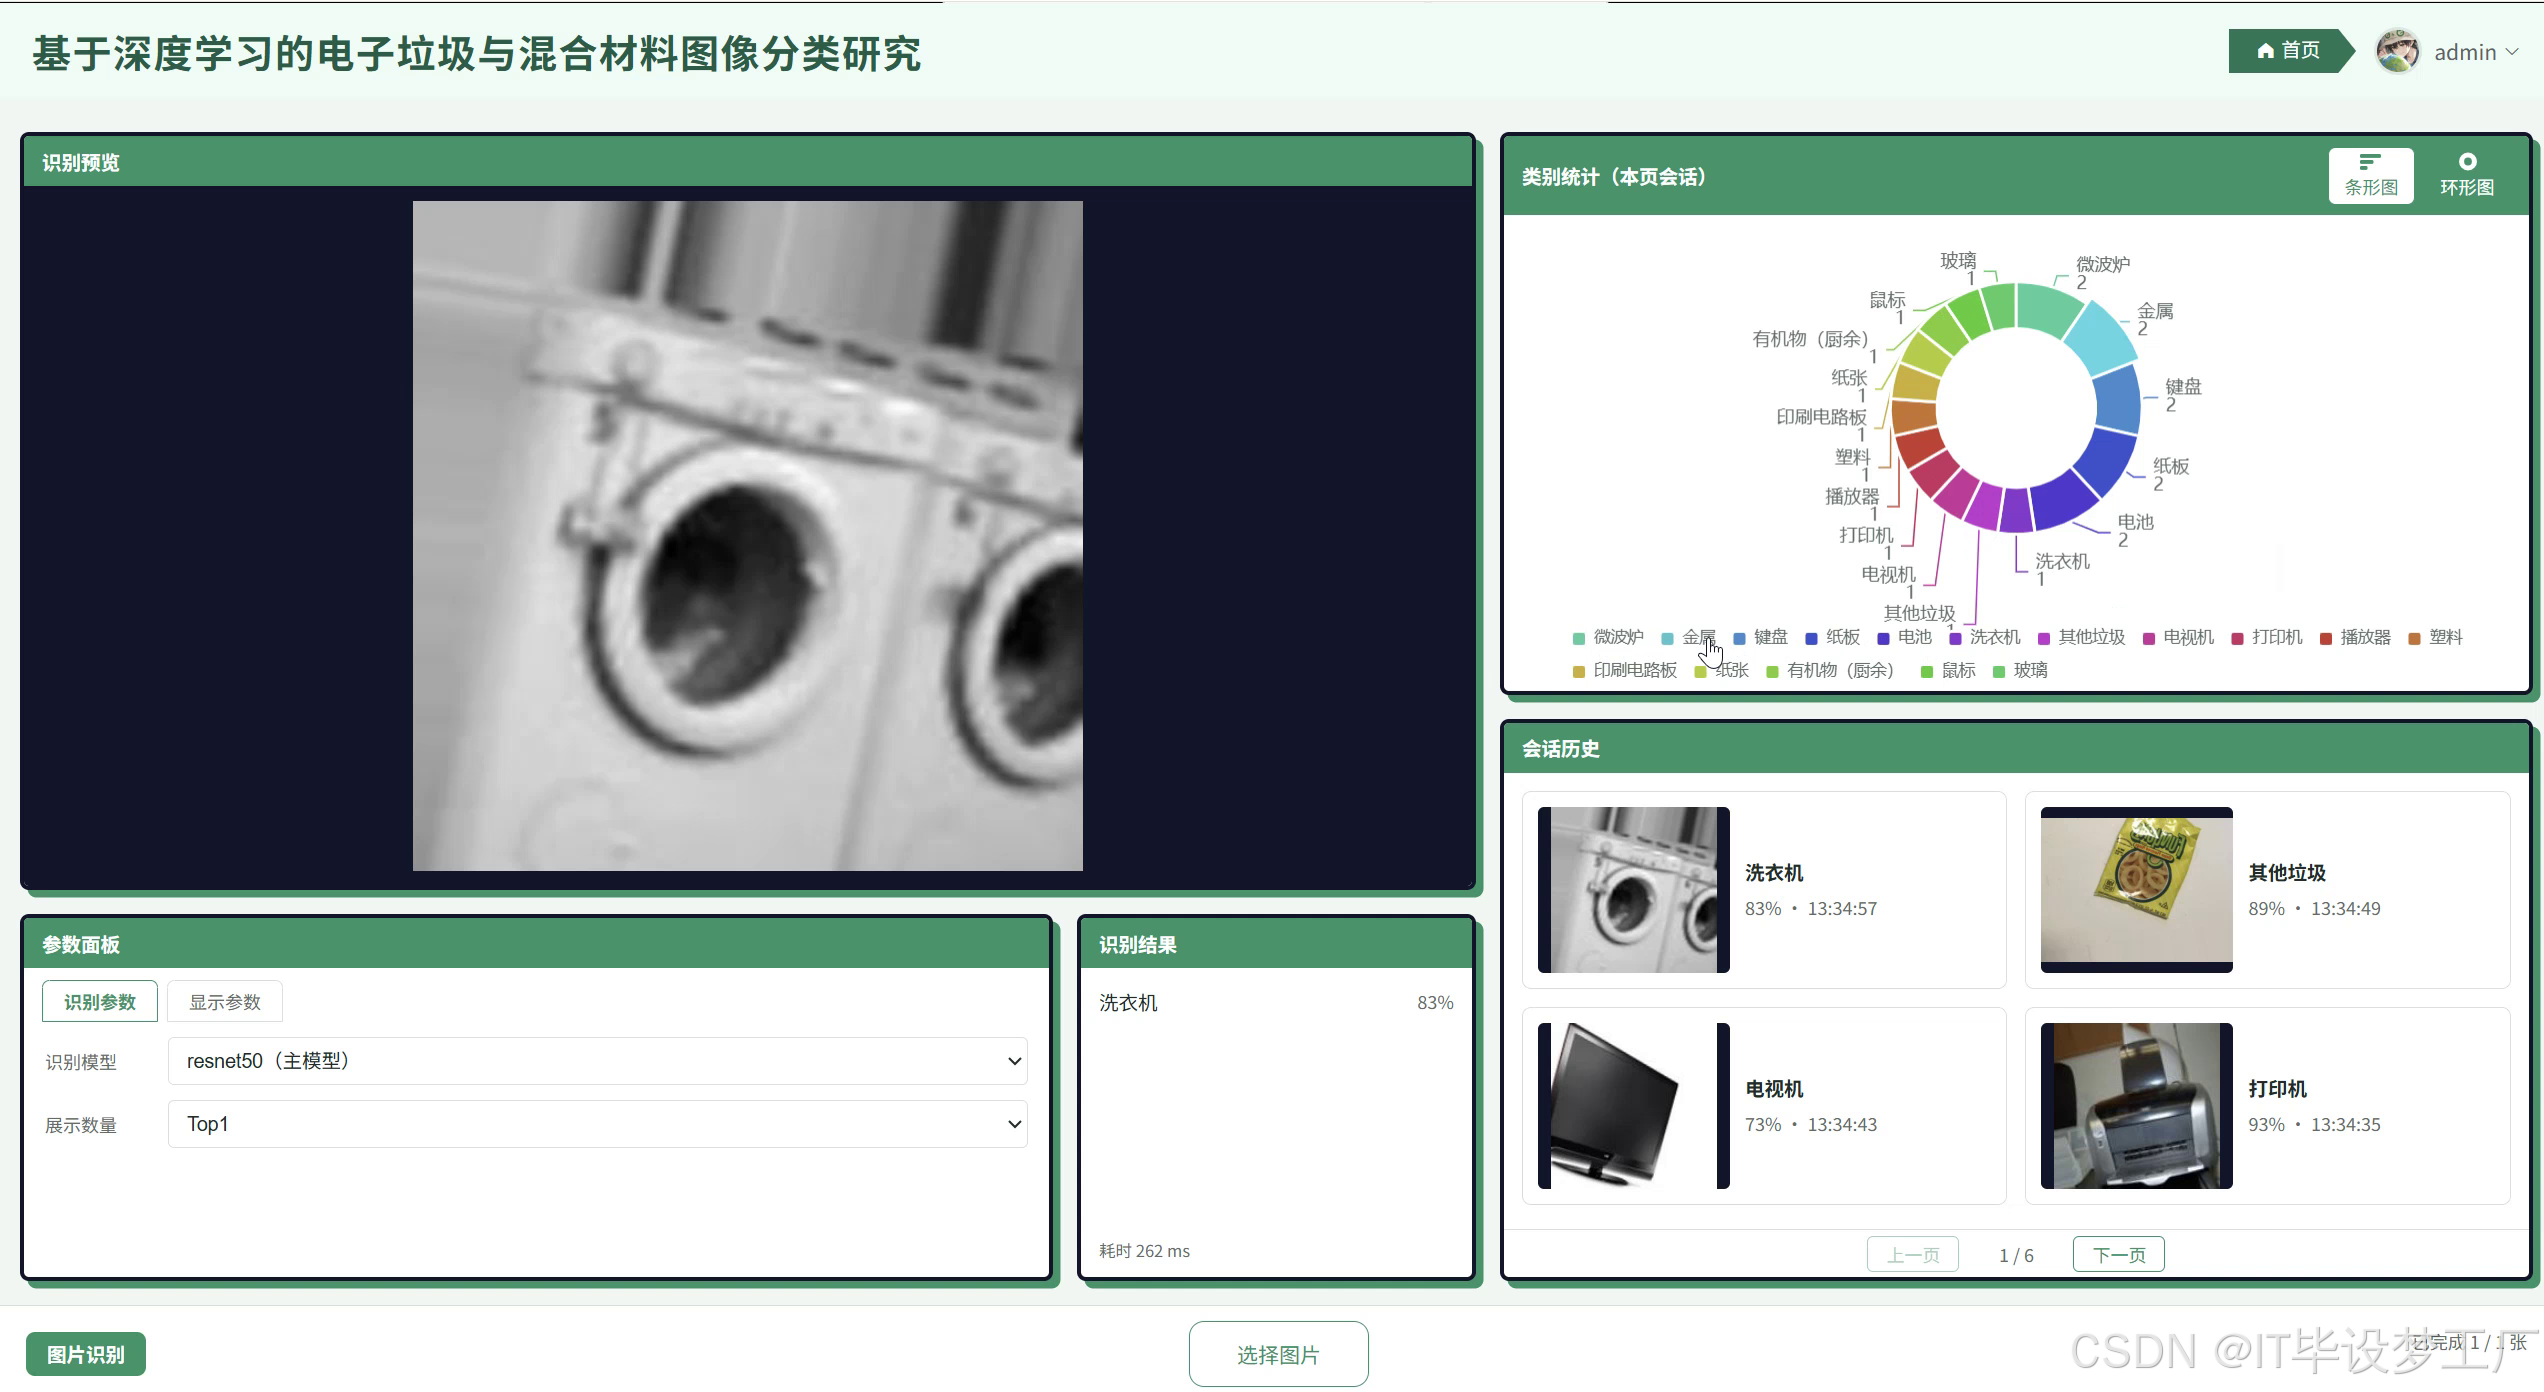
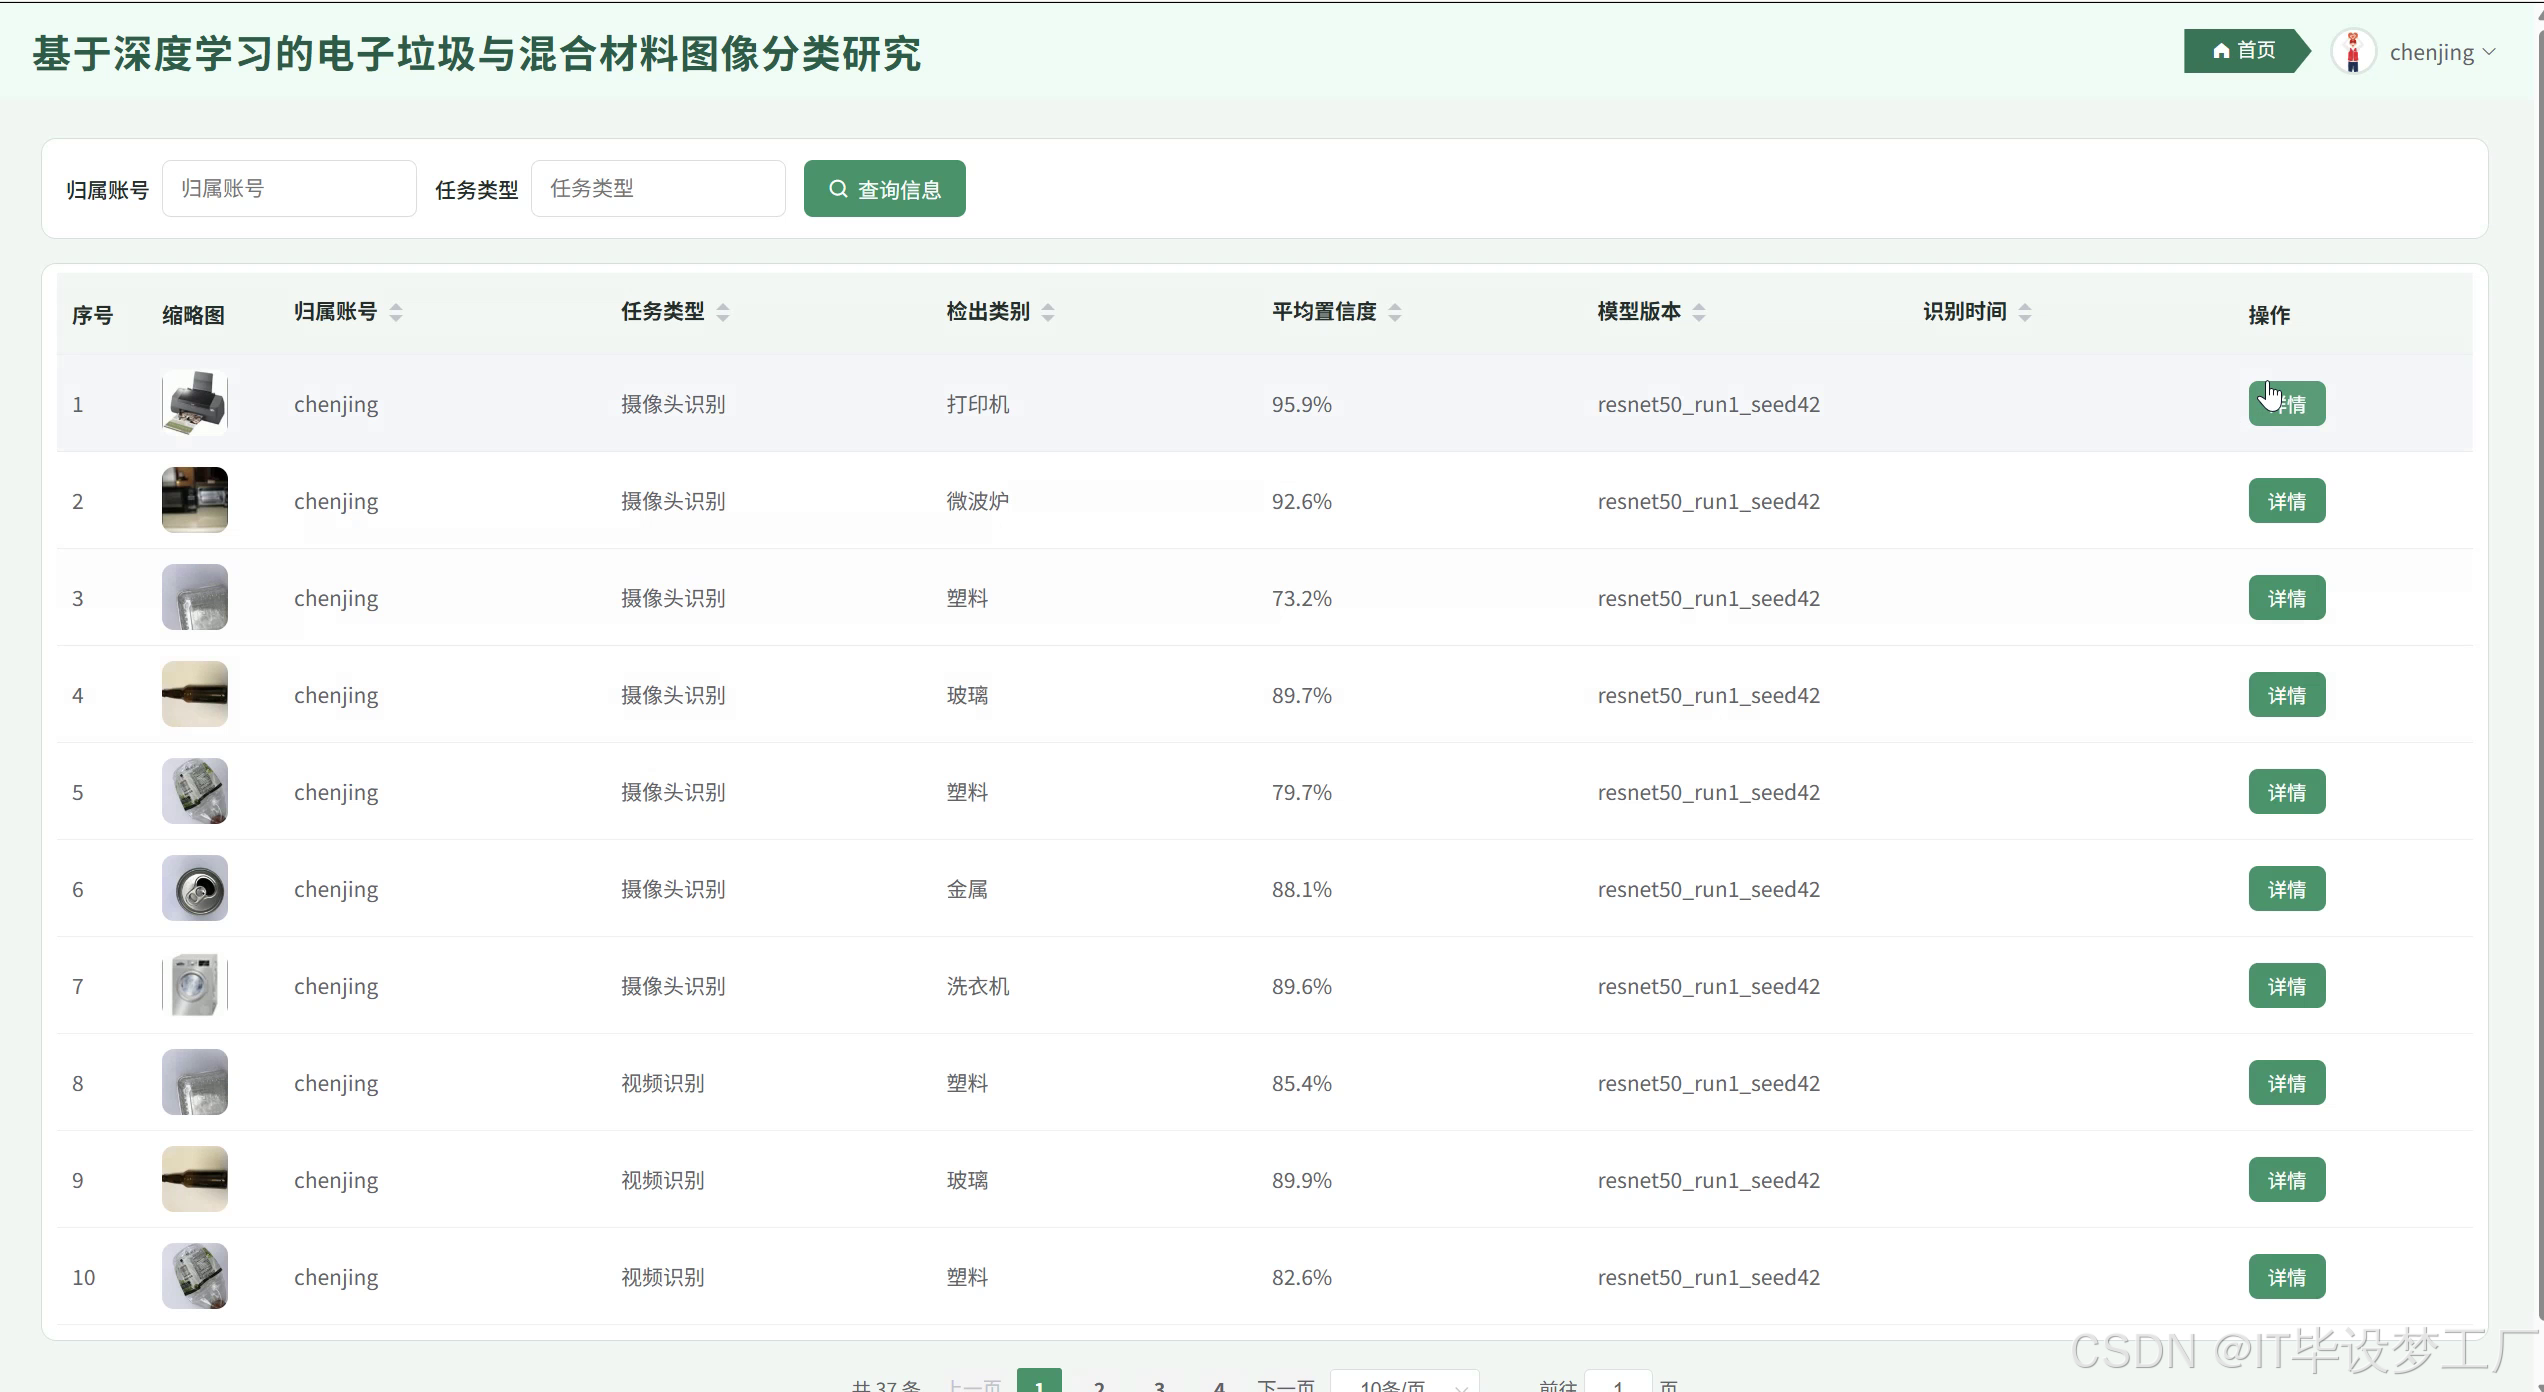
本系统名为《基于深度学习的电子垃圾与混合材料图像分类研究》,主要面向电子垃圾与混合材料图像识别这一毕业设计场景,开发语言使用Python,深度学习部分基于PyTorch,检测类任务采用YOLOv8s、YOLO26m等YOLO系列模型,分类类任务通过ConvNeXt-Tiny、ResNet等骨干网络做短训海选,训练流程包含LR Finder、seed设置、warmup、cosine学习率、EMA、AMP和EarlyStopping,并产出best.pt;数据侧支持YOLO归一化cxcywh标签和ImageNet目录两种组织方式,配合pandas、numpy做数据处理,使用cleanlab与scikit-learn做数据清洗辅助,albumentations做图像增强;模型部署通过export_run.py导出ONNX,采用opset 17、simplify和NMS end2end,后端Django启动后加载best.onnx完成推理;前端使用Vue、ElementUI、ECharts、HTML、CSS、JavaScript和jQuery,数据库使用MySQL保存识别历史与用户信息;系统功能包括系统首页、图像识别、视频解析、摄像头实时分析、识别历史、大屏可视化、用户管理、个人信息和修改密码,整体是一个把深度学习模型、后端接口、前端页面和可视化展示串起来的可运行原型。
二、开发环境
开发语言:Python 深度学习框架:PyTorch(import torch / torch.cuda)+ Ultralytics YOLO 算法模型:检测类走 YOLO 系列(YOLOv8s、YOLO26m);分类类走骨干网络海选(ConvNeXt-Tiny、ResNet 等) 训练配方:短训海选 → LR Finder → seed/warmup/cosine/EMA/AMP → best.pt,EarlyStopping 数据/工具链:YOLO 归一化 cxcywh 标签或 ImageNet 目录、pandas/numpy、cleanlab + scikit-learn、albumentations 增强 模型部署:export_run.py 导出 ONNX(opset 17、simplify、NMS end2end),后端启动加载 best.onnx 可视化:ECharts 数据大屏(dark 主题,classBar 等六图) 后端框架:Django 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery 数据库:MySQL
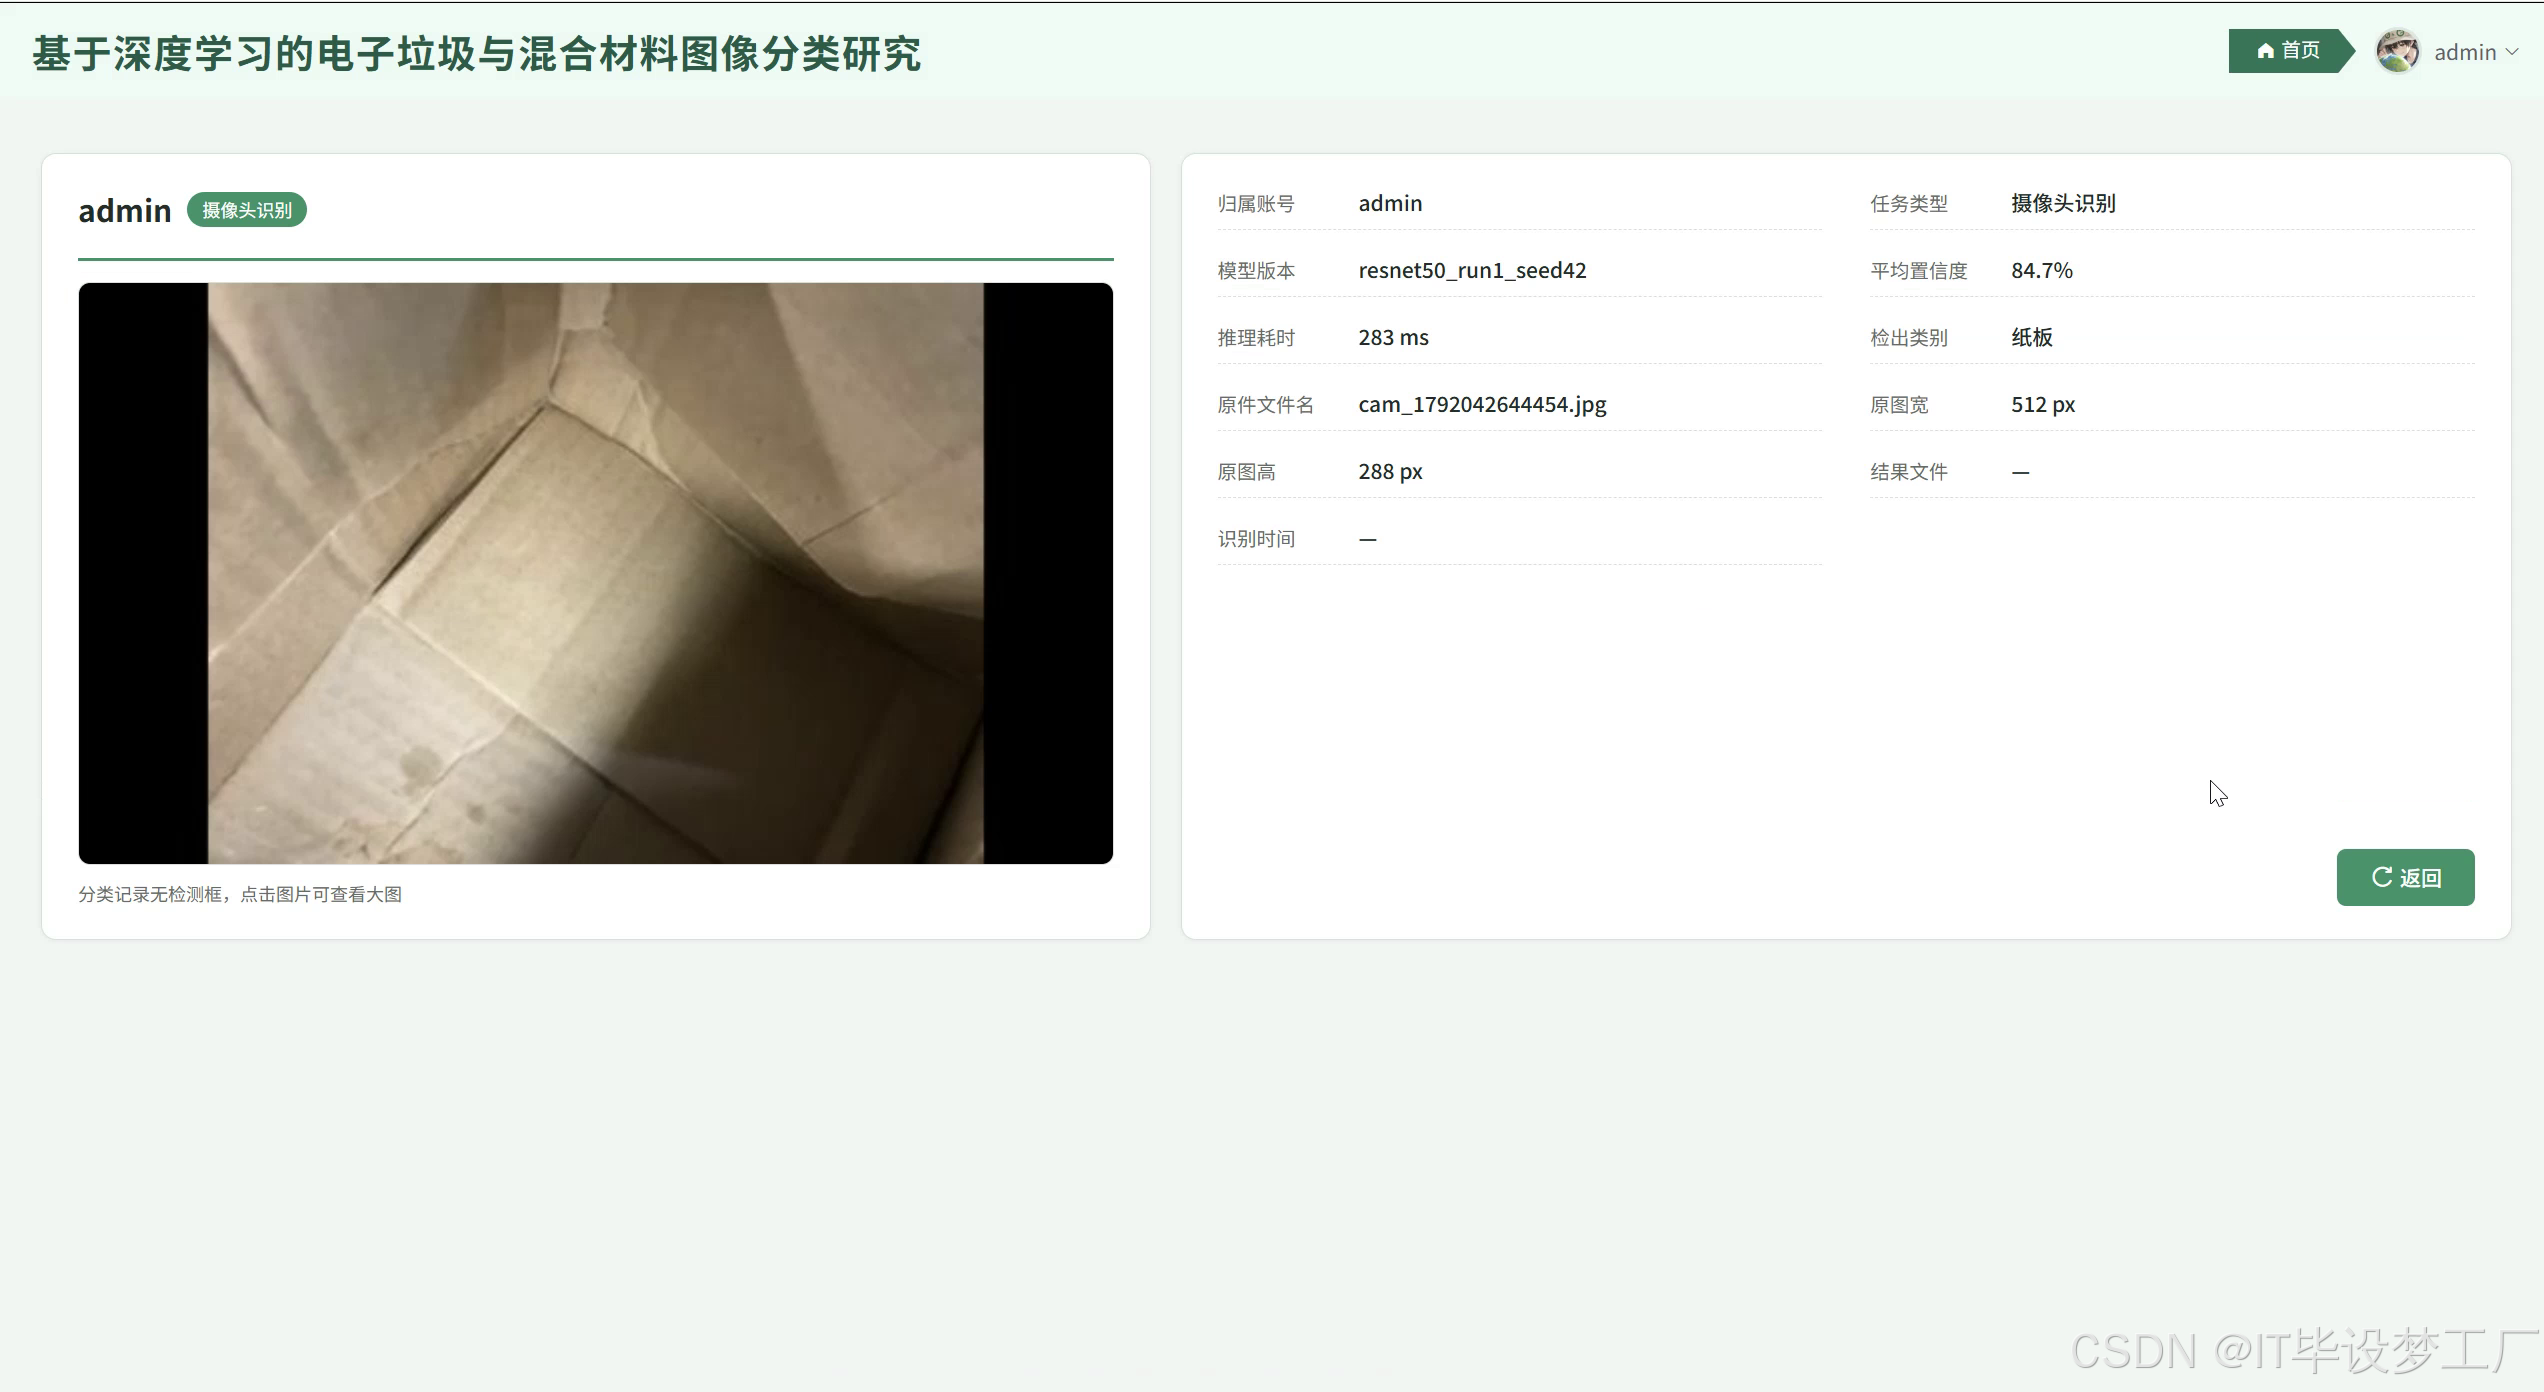
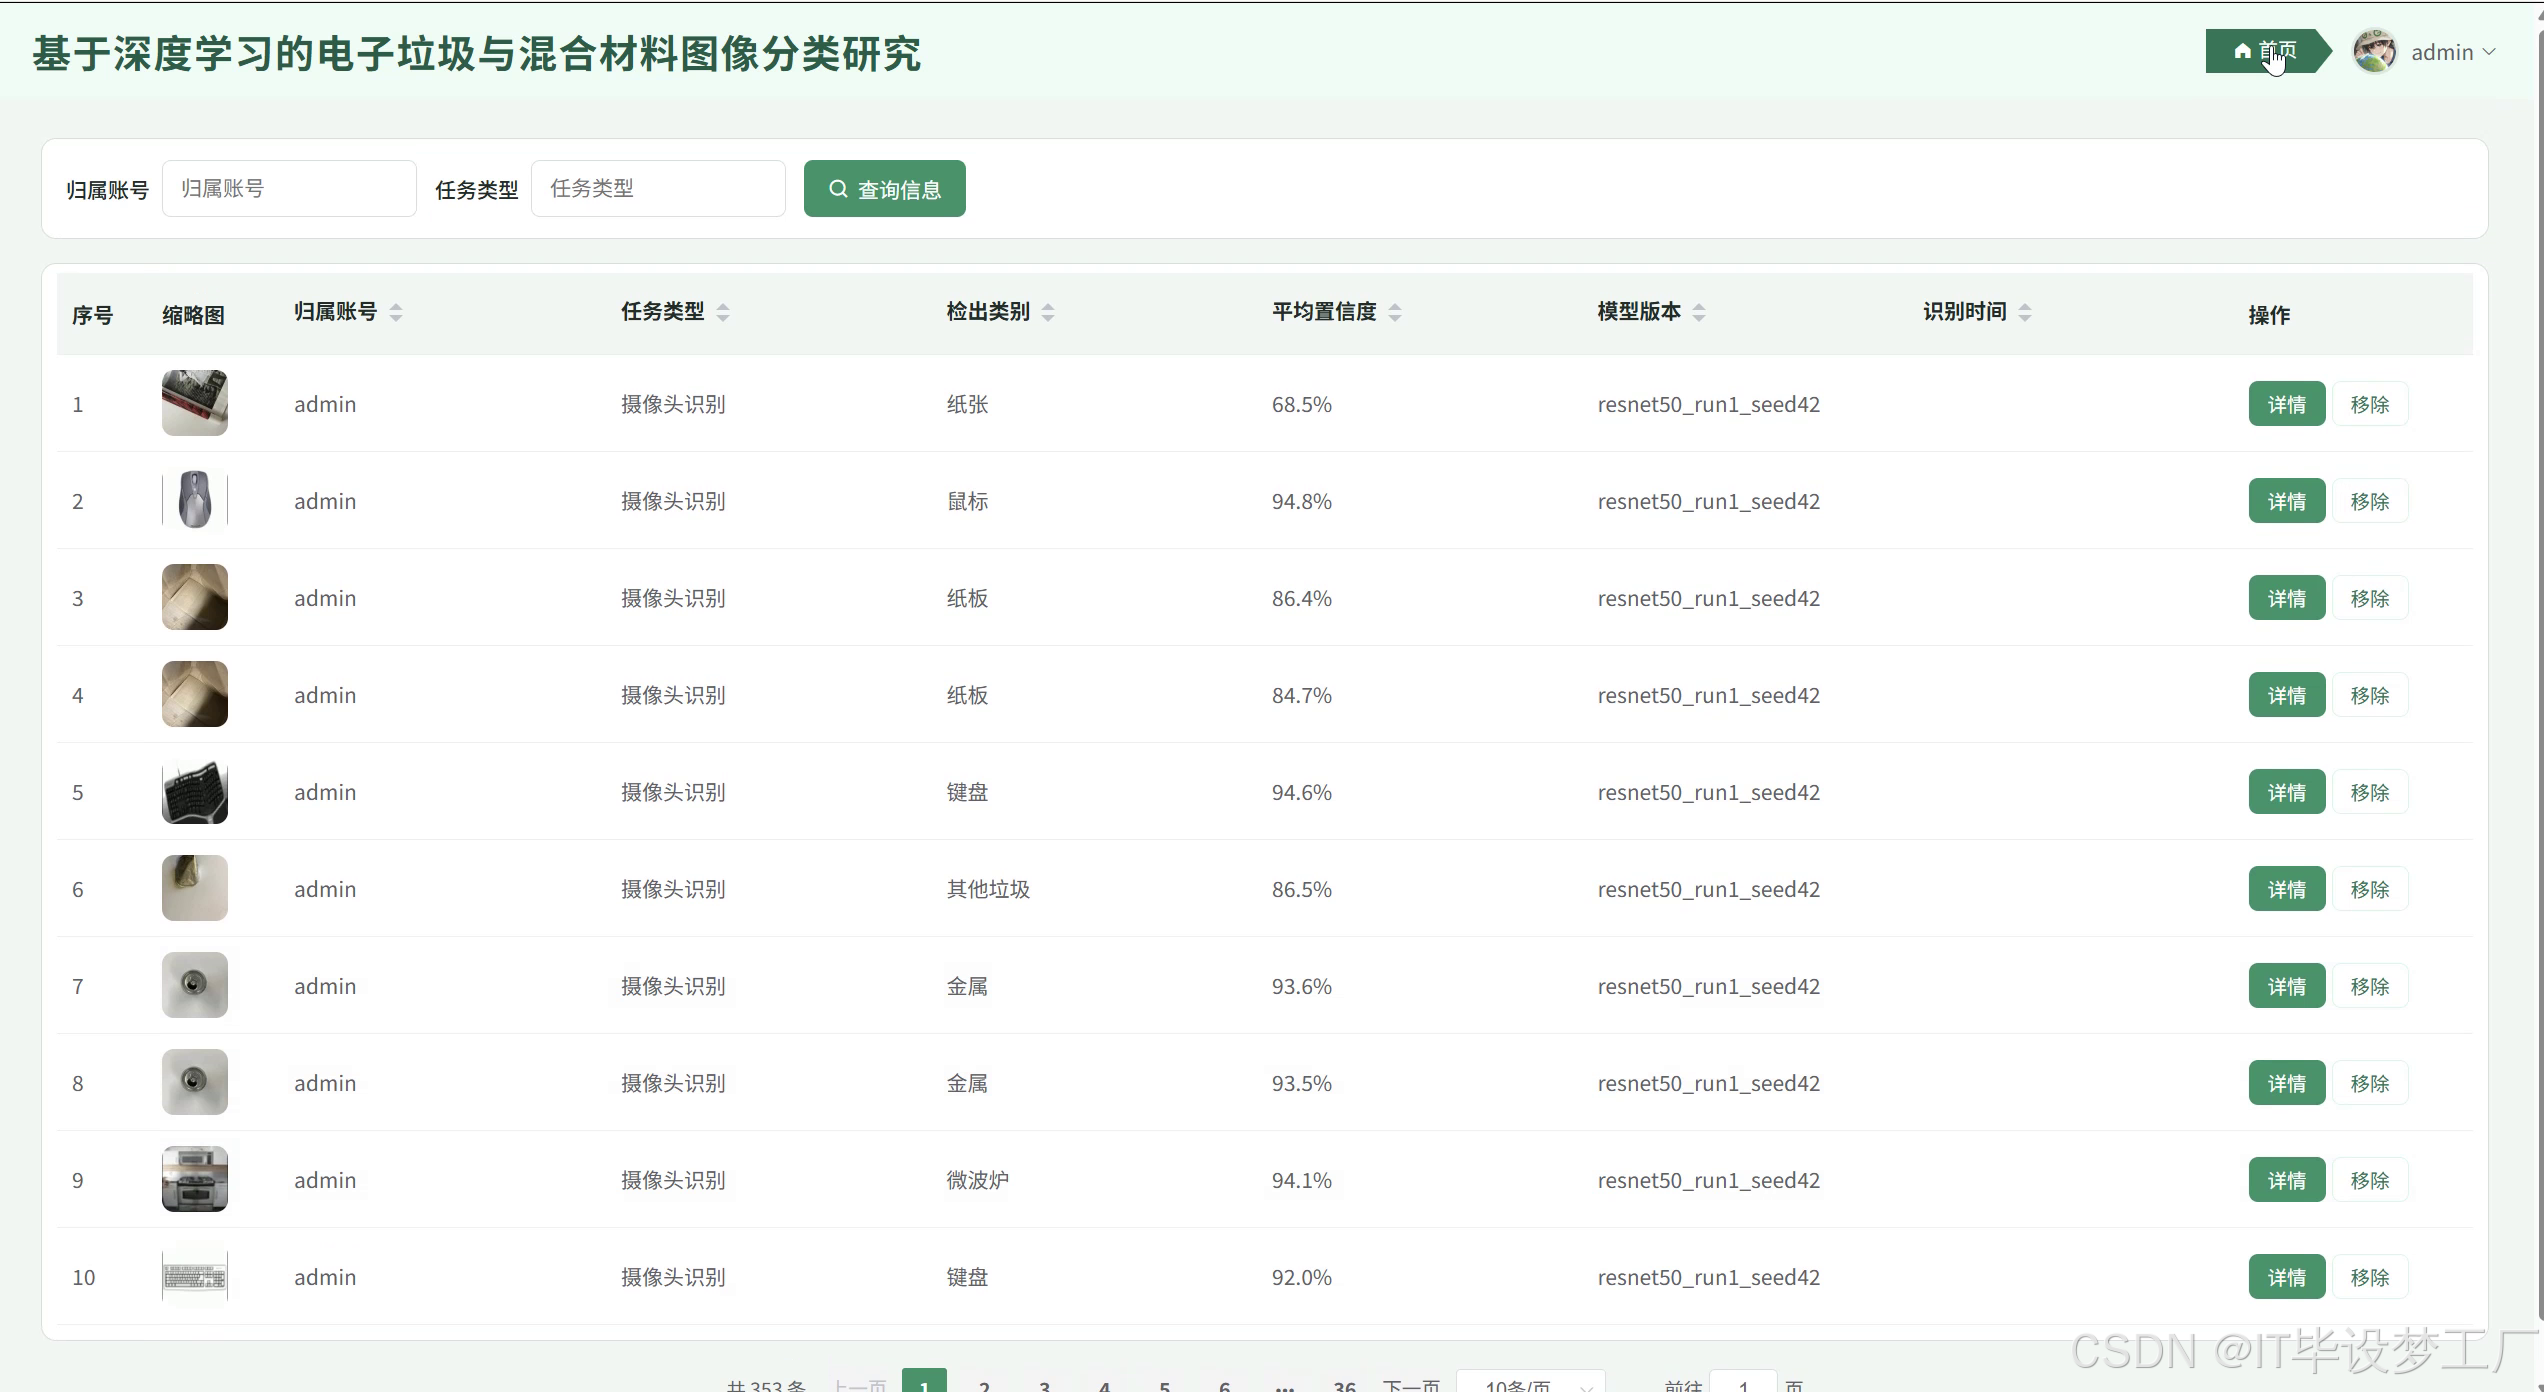
三、系统界面展示
- 基于深度学习的电子垃圾与混合材料图像分类研究系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
spark = SparkSession.builder.appName("ewaste_image_audit").master("local[*]").config("spark.sql.shuffle.partitions","2").getOrCreate()
def image_recognize(request):
upload = request.FILES.get("image")
if not upload:
return JsonResponse({"code": 1, "msg": "请上传图像"}, status=400)
session = ort.InferenceSession(str(settings.BASE_DIR / "weights" / "best.onnx"), providers=["CPUExecutionProvider"])
image = Image.open(upload).convert("RGB")
image_np = np.array(image)
input_blob = preprocess_yolo(image_np, target_size=640)
outputs = session.run(None, {session.get_inputs()[0].name: input_blob})
detections = postprocess_yolo(outputs, conf_thres=0.35, iou_thres=0.45)
labels = [item["class_name"] for item in detections]
audit_df = spark.createDataFrame([(upload.name, labels, len(detections))], ["file_name", "labels", "count"])
audit_count = audit_df.collect()[0]["count"]
annotated = draw_boxes(image_np, detections)
image_path = save_result_image(annotated, upload.name)
history = RecognitionHistory.objects.create(user=request.user, source_type="image", file_name=upload.name, result_json=json.dumps(detections, ensure_ascii=False), image_path=image_path, audit_count=audit_count)
return JsonResponse({"code": 0, "history_id": history.id, "detections": detections, "image_path": image_path})
def video_analyze(request):
video_file = request.FILES.get("video")
if not video_file:
return JsonResponse({"code": 1, "msg": "请上传视频"}, status=400)
session = ort.InferenceSession(str(settings.BASE_DIR / "weights" / "best.onnx"), providers=["CPUExecutionProvider"])
temp_path = save_upload_file(video_file)
cap = cv2.VideoCapture(temp_path)
frame_index = 0
sample_step = 5
all_detections = []
while True:
ret, frame = cap.read()
if not ret:
break
frame_index += 1
if frame_index % sample_step != 0:
continue
frame_rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
input_blob = preprocess_yolo(frame_rgb, target_size=640)
outputs = session.run(None, {session.get_inputs()[0].name: input_blob})
detections = postprocess_yolo(outputs, conf_thres=0.35, iou_thres=0.45)
all_detections.extend(detections)
cap.release()
summary = Counter([item["class_name"] for item in all_detections])
audit_df = spark.createDataFrame([(video_file.name, dict(summary), len(all_detections))], ["file_name", "summary", "count"])
audit_count = audit_df.collect()[0]["count"]
history = RecognitionHistory.objects.create(user=request.user, source_type="video", file_name=video_file.name, result_json=json.dumps(all_detections, ensure_ascii=False), audit_count=audit_count)
return JsonResponse({"code": 0, "history_id": history.id, "summary": dict(summary), "total": len(all_detections)})
def camera_frame_analyze(request):
payload = json.loads(request.body.decode("utf-8"))
frame_base64 = payload.get("frame", "")
if not frame_base64:
return JsonResponse({"code": 1, "msg": "缺少摄像头帧"}, status=400)
image_bytes = base64.b64decode(frame_base64.split(",")[–1])
image = Image.open(io.BytesIO(image_bytes)).convert("RGB")
image_np = np.array(image)
session = ort.InferenceSession(str(settings.BASE_DIR / "weights" / "best.onnx"), providers=["CPUExecutionProvider"])
input_blob = preprocess_yolo(image_np, target_size=640)
outputs = session.run(None, {session.get_inputs()[0].name: input_blob})
detections = postprocess_yolo(outputs, conf_thres=0.35, iou_thres=0.45)
annotated = draw_boxes(image_np, detections)
out_buffer = io.BytesIO()
Image.fromarray(annotated).save(out_buffer, format="JPEG")
out_base64 = base64.b64encode(out_buffer.getvalue()).decode("utf-8")
audit_df = spark.createDataFrame([(request.user.id, len(detections))], ["user_id", "count"])
audit_count = audit_df.collect()[0]["count"]
RecognitionHistory.objects.create(user=request.user, source_type="camera", file_name="camera_frame.jpg", result_json=json.dumps(detections, ensure_ascii=False), audit_count=audit_count)
return JsonResponse({"code": 0, "detections": detections, "frame": "data:image/jpeg;base64," + out_base64})
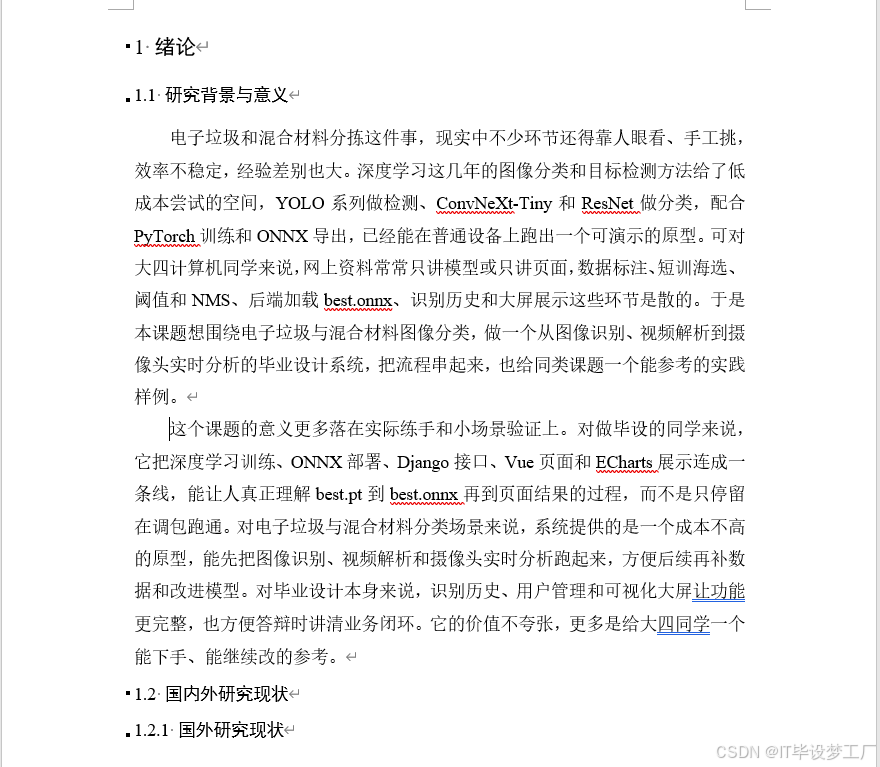
五、论文参考
- 计算机毕业设计选题推荐-基于深度学习的电子垃圾与混合材料图像分类研究系统-论文参考:
六、系统视频
- 基于深度学习的电子垃圾与混合材料图像分类研究系统-项目视频: 点击观看项目演示视频
结语
计算机毕业设计选题推荐:基于深度学习的电子垃圾与混合材料图像分类研究|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目 大家可以帮忙点赞、收藏、关注、评论啦~ 源码获取:⬇⬇⬇
精彩专栏推荐⬇⬇⬇ Java项目 Python项目 安卓项目 微信小程序项目