刷题助手不一定每道题都要交给同一个模型。简单语法问题留在本地,复杂证明交给更强的服务,看起来是个自然方案。但谁判断“简单”?如果路由模型自信地选错了呢?
ggml-org 在 2026-10-02 的一手文章介绍了 llama.cpp 的决策模型支持:给定输入和选项,接口返回选项概率。这为路由提供了一个实现入口,却没有直接证明某个概率就是“本地答案会正确”的概率。
三个闸门不能合并
第一关是许可:题目、日志和代码是否允许发送到目标服务。第二关是路由:哪个动作更合适。第三关才是答案验收:生成代码是否通过行为测试。AST 能解析,只能过语法这一小步。
本文没有安装决策模型、没有下载权重、没有调用云 API。下面仅验证路由策略的控制逻辑,数据全部人为构造;原稿中没有证据的题量和节省比例不再保留。
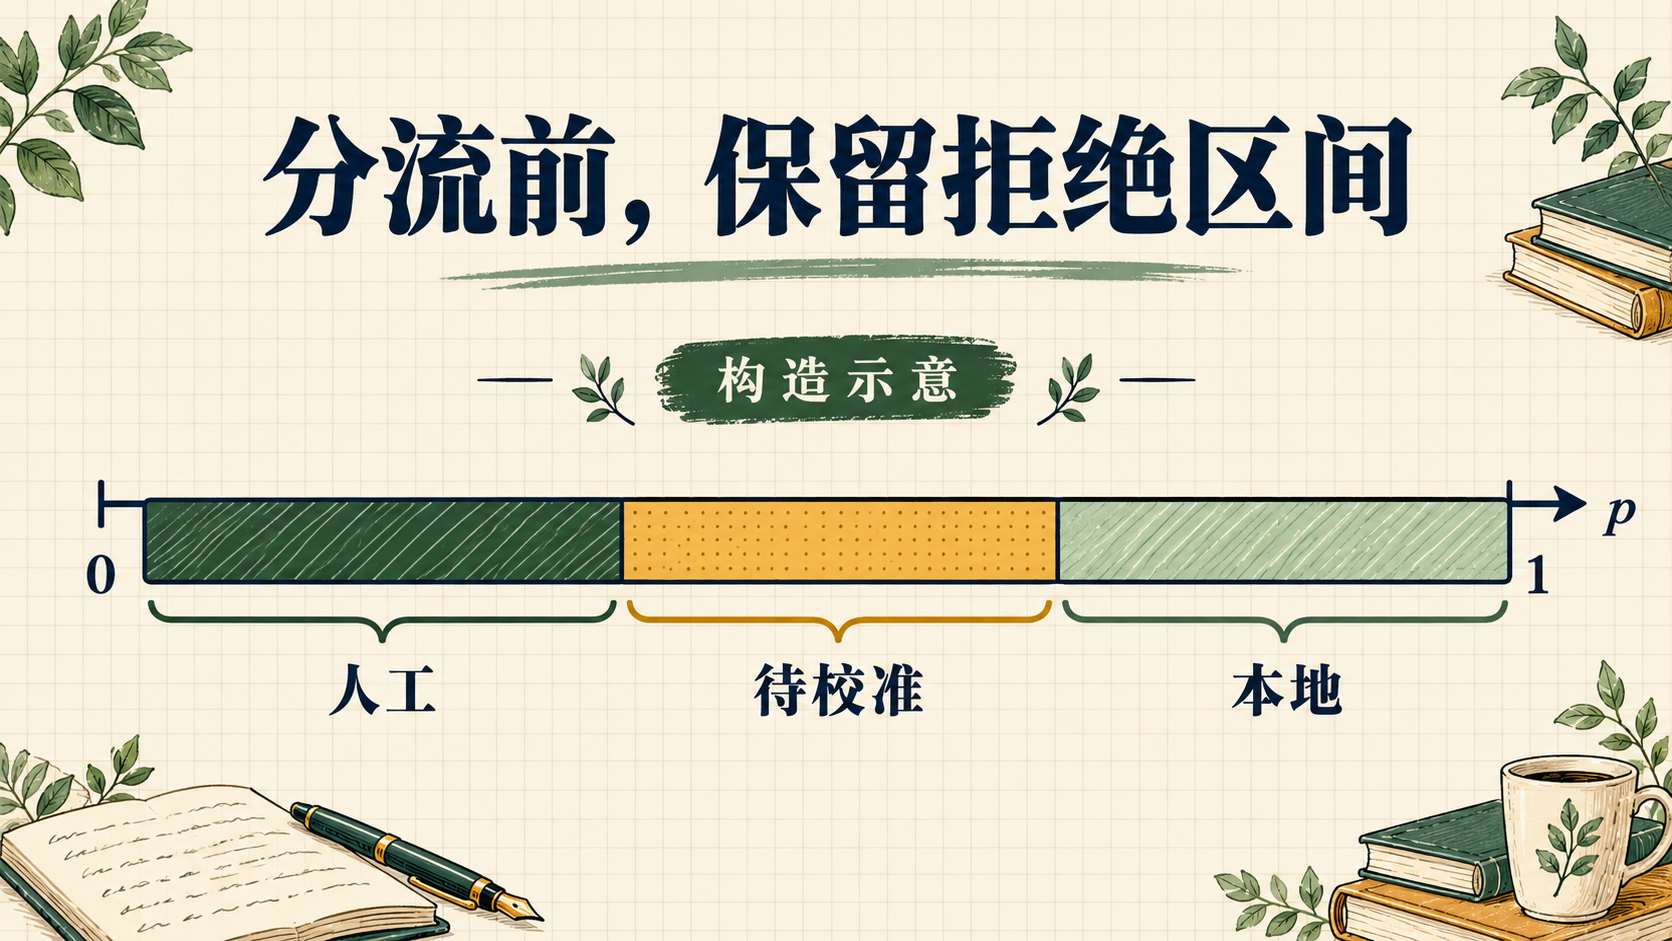
图里的区间是设计示意,不能据图选出生产阈值。真实阈值应来自有标签的样本:例如标签定义为“固定本地模型在指定预算下能否通过这道题的测试”,而不是“人觉得这题简单”。训练阈值的题与最终评测题也要分开,避免一边调一边宣布效果。
一个不会越过上传许可的策略
import ast
import math
def choose(p_local, upload_allowed, threshold=0.8):
if not math.isfinite(p_local) or not 0 <= p_local <= 1:
raise ValueError("invalid probability")
if not 0 <= threshold <= 1:
raise ValueError("invalid threshold")
if p_local >= threshold:
return "local"
return "cloud" if upload_allowed else "human"
def syntax_only(code):
try:
ast.parse(code)
return True
except SyntaxError:
return False
# Constructed labels: whether a fixed local solver would pass, not API results.
cases = [(0.95, True), (0.85, False), (0.4, False), (0.3, True)]
selected = [row for row in cases if choose(row[0], True) == "local"]
wrong = sum(not label for _, label in selected)
assert (len(selected), wrong) == (2, 1)
assert choose(0.3, False) == "human"
assert choose(0.3, True) == "cloud"
assert syntax_only("answer = sorted(set([2, 2, 1]))")
assert sorted(set([2, 2, 1])) != [1, 2, 2]
for bad in [float("nan"), -0.1, 1.1]:
try:
choose(bad, True)
except ValueError:
pass
else:
raise AssertionError("bad probability accepted")
print("policy checks passed; toy selected=2, wrong=1")
Python 3.9.6 隔离执行通过。这里 2 次选中、1 次错选是我故意放入的四条测试数据,不是模型误路由率。例子想说明:即使分数高于 0.8,也不能省掉答案测试;阈值高低本身没有替代校准实验。
怎样把“先校准”变成可做的实验
先选一个固定的本地模型版本,给一组可公开题目写独立 oracle;路由分数和解题结果分别保存。按分数区间汇总通过率时同时保留样本量,五道题的一个箱子不能画成平滑可靠性曲线。最终在未参与调参的题组上比较固定本地、固定云端、混合策略,记录失败和人工接管。
若以后使用 DeepSeek,也要保存请求别名与实际服务身份。API 文档是动态页面;检查点名字里的数字不是可以自行解释的发布日期。没有真实响应,本文不填写 resolved model、不猜账号权限,也不估算未知价格。
此外,还需计入路由自身的等待、模型装载、云端失败和重试。官方文章的硬件测量属于作者条件,不能搬成租房笔记本的成绩。中文算法题的选项描述、许可证与具体量化组合,也需要逐项复核。
接口介绍;Python AST 使用本机 3.9 行为。采用前重新确认 llama.cpp 接口、所选模型与服务文档。当前结论是策略可被离线检查,校准收益仍待真实、授权的模型实验。