/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
上周四下午,前端负责人小林端着他的马克杯杀到了我的工位。
“鸭梨哥,你们后端吐给前端的流式接口,体验太稀烂了。”小林把笔记本往我面前一推,“你看看这打字机效果,前两秒没动静,突然‘噗’的一下喷出来四五百个字,接着又卡死一秒,再喷两百个字。产品经理非说是我前端 CSS 动画写得太卡,我这插值动画帧率拉满了都救不回来!”
我凑过去看了一下 Network 面板里的 EventStream,果然,数据块不是一个 Token 一个 Token 顺滑流出来的,而是一坨一坨几十甚至上百字节整块落下来的。
做大模型应用落地,大家第一直觉都觉得“打字机效果”是前端的责任——不就是拿到 SSE(Server-Sent Events)的增量数据,往 DOM 里追加字符串么?或者前端起个 requestAnimationFrame 做匀速缓动队列?
但只要你在线上跑过高并发的生产系统,就会发现:前端的平滑度,百分之八十取决于后端的 Chunk 切割与缓冲区冲刷(Flush)策略。如果后端的传输链路上有一处缓冲区在偷偷“憋大招”,前端就算把算力烧干,做出来的打字机效果也像个结巴在演讲。
今天就把我们在流式输出平滑度治理上踩过的坑,以及最终沉淀下来的后端切割与冲刷方案完整梳理一遍。
为什么你的 SSE 数据总在“憋大招”?
要治好流式吐字不平滑的毛病,首先得把从大模型推理引擎到用户浏览器之间的这根“水管”彻底理清楚。
数据从大模型生成到最终在前端页面渲染,中间至少穿过了四道可能产生缓冲的关卡:
其中最致命、排查概率最高的,就是中间代理缓冲和Java 服务端的冲刷时机。
避坑第一关:拆掉反向代理的阻水坝
很多后端写完接口,在本地 Postman 调测或者 curl 本机端口,发现 Token 一个个流得很欢快;一上测试环境或者预发环境,立马变成“便秘式输出”。
原因无他,就是 Nginx 搞的鬼。
Nginx 默认会对 HTTP 响应开启缓冲(proxy_buffering on)。对于普通的 JSON 接口,这是优化性能的神器;但对于 SSE,这就是灭顶之灾。它会死死守着 4KB 缓冲区,不塞满绝对不给下游转发。
解决方式非常直接,后端的响应头里必须强制带上:
Content-Type: text/event-stream; charset=UTF-8
Cache-Control: no-cache
Connection: keep-alive
X-Accel-Buffering: no
重点是 X-Accel-Buffering: no。这个私有头是告诉 Nginx:“哥们,这是流式长连接,别给我开缓冲区,拿到一个字节就赶紧往后送”。
同时,如果你们集群使用的是 Envoy,需要确保流式路由配置里关闭了响应缓冲,并开启了流式透传。如果运维统一在 Nginx 配置层面拦截,也应确保配置了:
proxy_buffering off;
proxy_cache off;
proxy_set_header Connection '';
proxy_http_version 1.1;
chunked_transfer_encoding on;
核心权衡:逐 Token 冲刷 vs 智能 Chunk 切割
代理层的水闸拉开后,问题就转移到了 Java 服务端本身。
很多同学做 SSE,最粗暴的写法是:底层模型回调每吐出一个 Token,后端就调一次 emitter.send(),然后强行调用 response.flushBuffer()。
我们早期也是这么干的,但在压测阶段遇到了灾难性的后果。
1. 逐 Token 冲刷的性能悬崖
假设模型吐字速度是 80 Tokens/s,当并发达到 2000 时,服务端每秒需要处理 16 万次小报文封包、系统调用(Syscall)以及 SSL 加密开销。
在 Wireshark 抓包下,你会看到成千上万个只有两三个字节 payload 的 TCP 数据包(比如一个汉字占 3 字节,加上 SSE 格式 data: 测\\n\\n 也不到 15 字节)。这不仅导致网卡软中断飙高,CPU 大量浪费在内核态与用户态的上下文切换上,甚至会导致 TCP 连接窗口被极小碎片占满,引发网络丢包。
2. 前端为什么需要平滑的 Chunk?
前端打字机的核心体感,不在于“每个汉字到来的物理时间绝对均匀”,而在于字符抵达的节奏符合人类阅读速度。
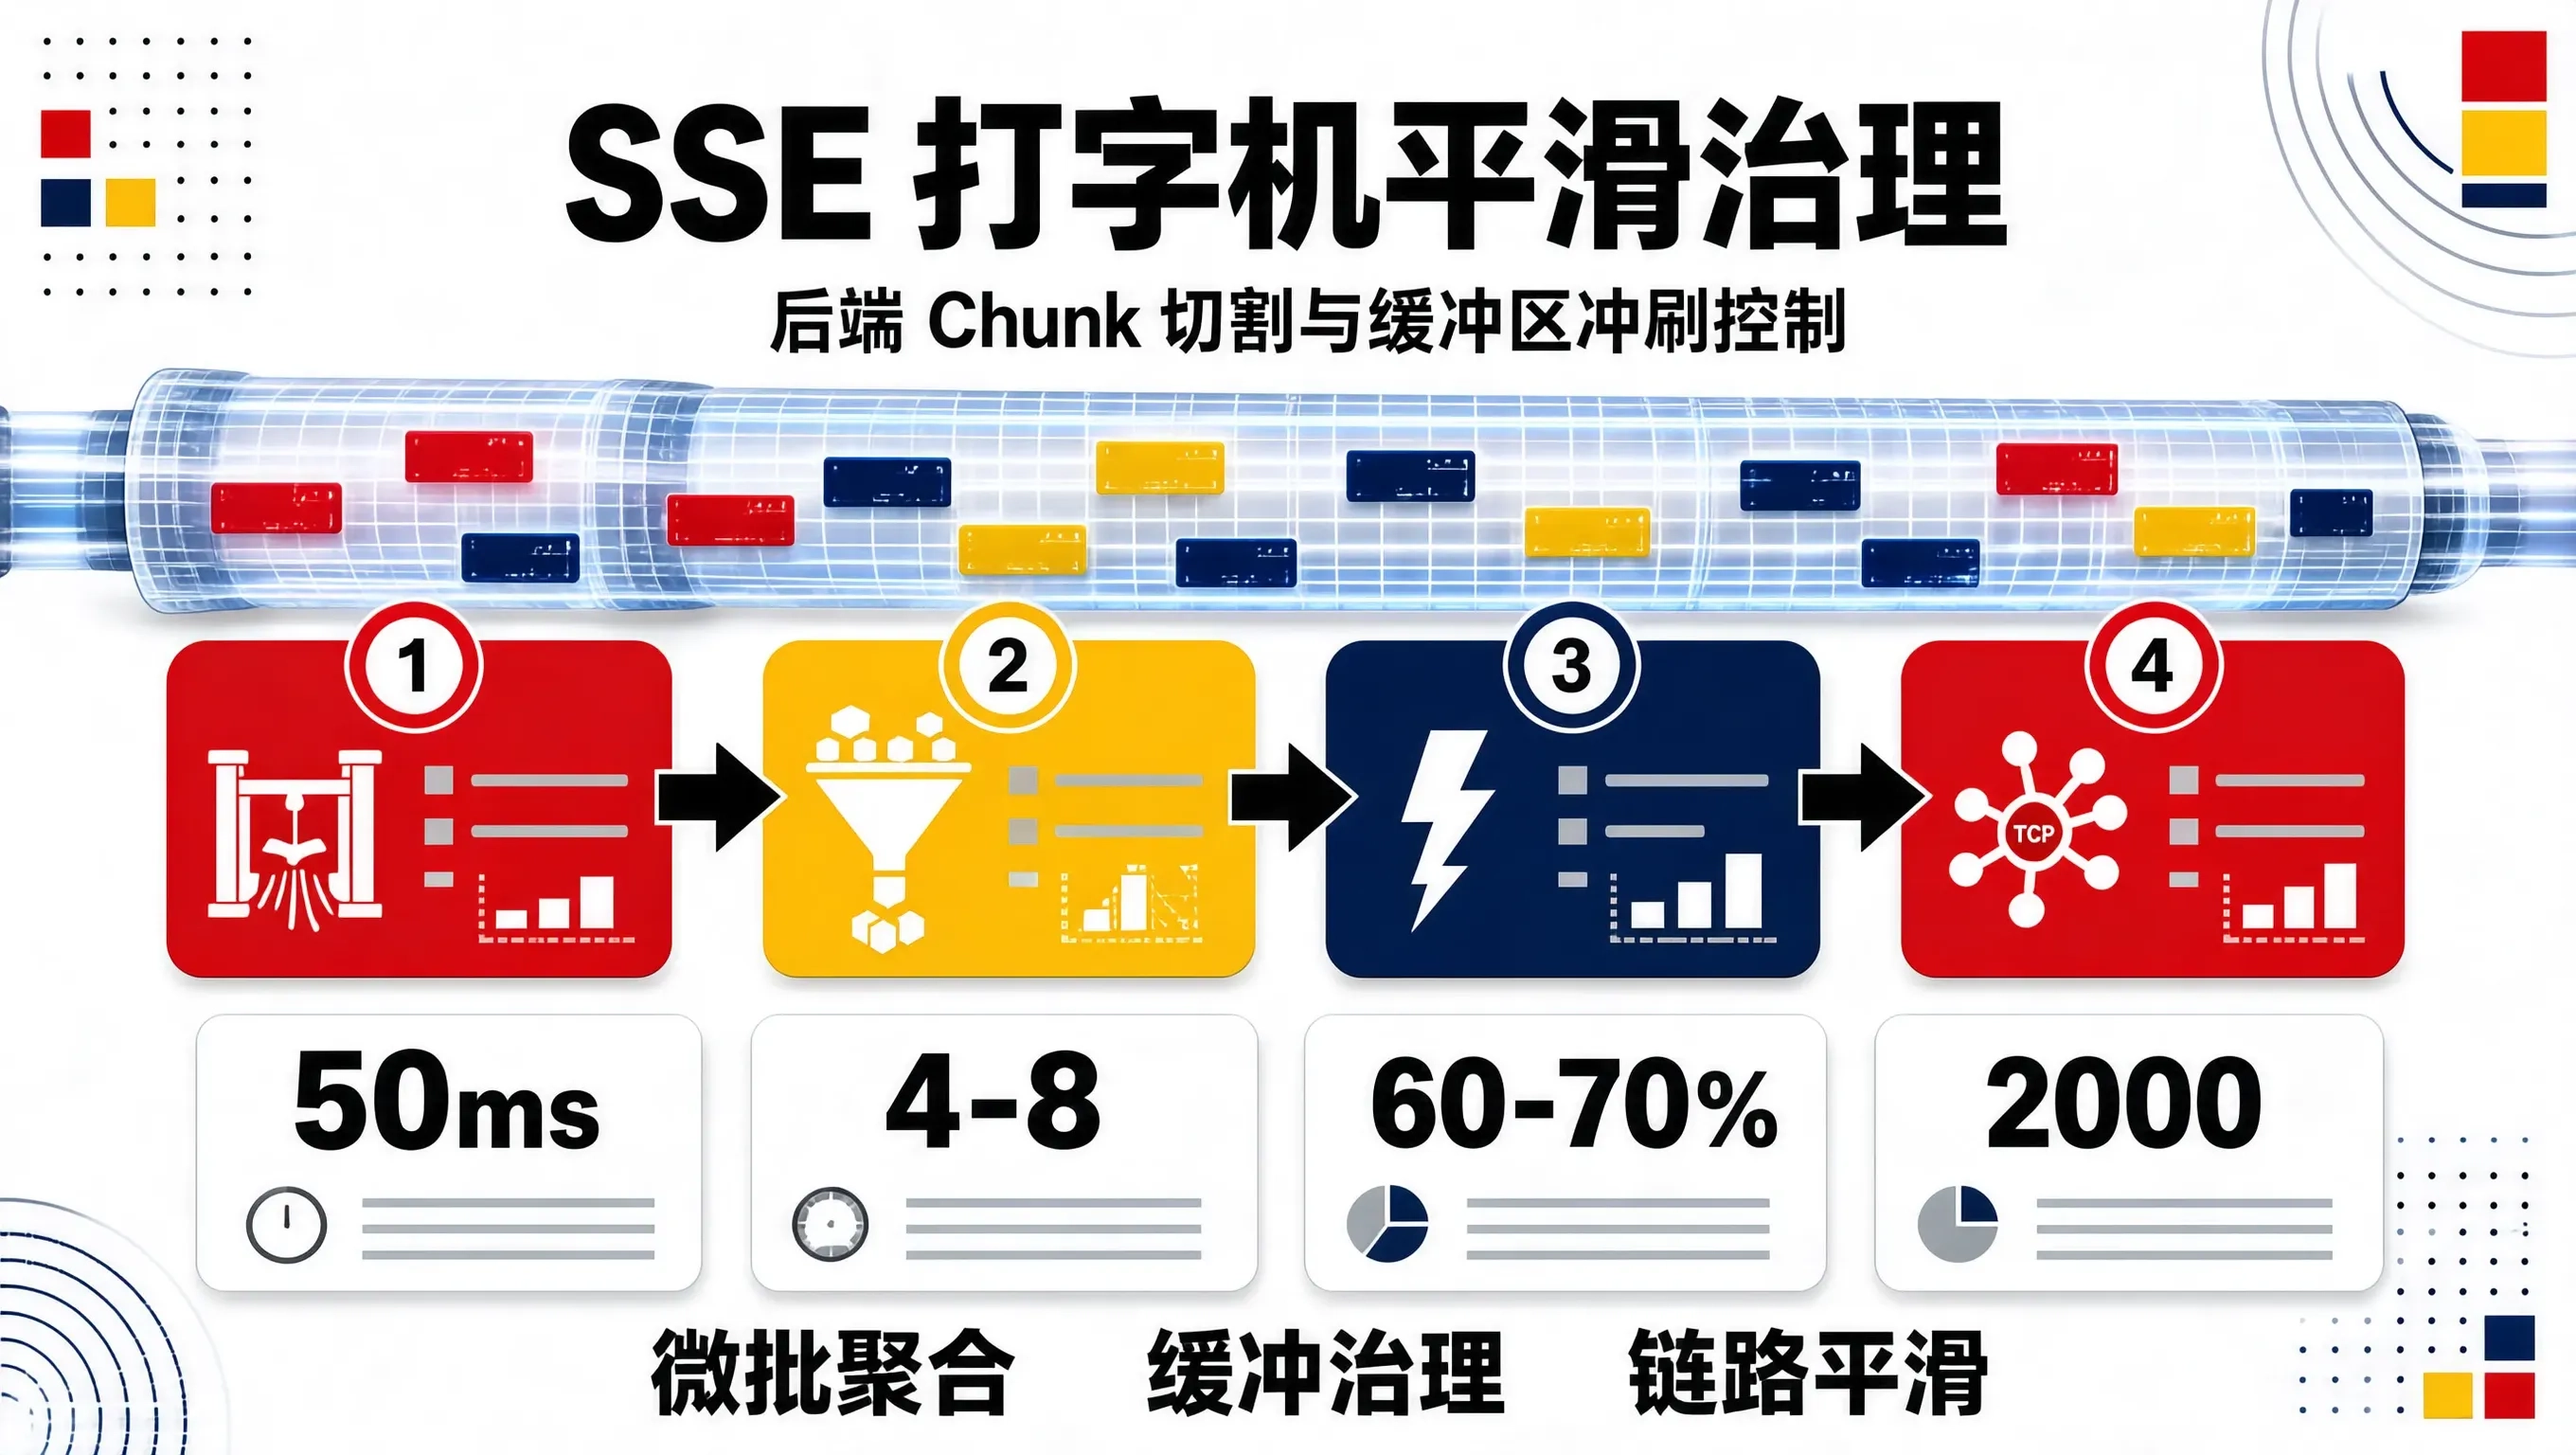
正常人类中文阅读速度在每秒 510 个字。如果后端能以稳定的 4060 毫秒为时间窗口,或者以 2~5 个汉字为一个语义片段进行微小聚合后冲刷,既能将服务端的网络包数量降低 60%~70%,又能让前端的渲染队列始终有水流动,不至于断流。
因此,后端的最佳架构绝不是纯粹的“来一个推一个”,而是引入自适应动态冲刷控制器(Adaptive Flush Controller)。
工业级方案:自适应微聚合冲刷器
我们在 Spring WebFlux(基于 Netty)和 WebMVC(基于 Tomcat)的流式管道中,引入了一个轻量级的微批缓冲器。它的逻辑非常清晰:
下面是一个在生产环境中验证过的自适应 Chunk 聚合器实现核心逻辑:
public class AdaptiveStreamFlusher {
private final StringBuilder buffer = new StringBuilder();
private final Consumer<String> downstreamConsumer;
private final ScheduledExecutorService scheduler;
private final int maxCharBatch;
private final long maxWaitMillis;
private ScheduledFuture<?> scheduledTask;
private final Object lock = new Object();
public AdaptiveStreamFlusher(Consumer<String> downstreamConsumer,
ScheduledExecutorService scheduler,
int maxCharBatch,
long maxWaitMillis) {
this.downstreamConsumer = downstreamConsumer;
this.scheduler = scheduler;
this.maxCharBatch = maxCharBatch;
this.maxWaitMillis = maxWaitMillis;
}
public void onToken(String token) {
synchronized (lock) {
buffer.append(token);
// 规则1:遇到标点符号,立即冲刷
if (endsWithPunctuation(token)) {
flushLocked();
return;
}
// 规则2:达到字符批量阈值,立即冲刷
if (buffer.length() >= maxCharBatch) {
flushLocked();
return;
}
// 规则3:开启定时冲刷兜底
if (scheduledTask == null || scheduledTask.isDone()) {
scheduledTask = scheduler.schedule(() -> {
synchronized (lock) {
flushLocked();
}
}, maxWaitMillis, TimeUnit.MILLISECONDS);
}
}
}
public void complete() {
synchronized (lock) {
flushLocked();
}
}
private void flushLocked() {
if (scheduledTask != null && !scheduledTask.isDone()) {
scheduledTask.cancel(false);
}
if (buffer.length() > 0) {
String payload = buffer.toString();
buffer.setLength(0);
downstreamConsumer.accept(payload);
}
}
private boolean endsWithPunctuation(String text) {
if (text == null || text.isEmpty()) {
return false;
}
char lastChar = text.charAt(text.length() – 1);
return lastChar == ',' || lastChar == '。' || lastChar == '!'
|| lastChar == '?' || lastChar == '\\n' || lastChar == ';'
|| lastChar == ',' || lastChar == '.' || lastChar == '!'
|| lastChar == '?' || lastChar == ';' || lastChar == ':';
}
}
在 Spring Boot 3.x(WebFlux)下,结合 Reactor 的 bufferTimeout 也可以写出非常函数式的逻辑,但原生 Reactor 算子对标点断句的支持相对较弱,手写这类轻量级管道控制器反而更可控,内存分配更紧凑。
传输层排障:TCP_NODELAY 与 Nagle 算法的幽灵
代码上线后,小林反馈大部分场景下打字机顺滑了,但在某些长文本场景下,仍然偶发几百毫秒的顿挫。
我们拉上运维做抓包分析,发现网卡上有大量的 TCP Acked Delayed,即接收端启用了延迟确认(Delayed ACK),而后端发送端在某些特殊大小的包上触发了 Nagle 算法。
Nagle 算法的初衷是为了防止网络充斥小包,它的策略是:如果前一个发出去的小包还没有收到 ACK,当前又有新的小包要发,那就必须缓存在本地,直到收到 ACK 或者凑齐了一个 MSS(最大报文段长度)。
当 Nagle 算法遇上 Delayed ACK,就是著名的 200ms 握手卡顿地狱。
在 Java 层解决这个问题很简单,必须确保长连接的 Socket 开启了 TCP_NODELAY:
- 如果使用 Netty(Spring WebFlux 或网关):检查 ChannelOption.TCP_NODELAY 是否为 true(Netty 默认已开启,但一定要防止业务配置覆盖)。
- 如果使用 Tomcat / Jetty:检查 server.xml 或配置属性中连接器的 tcpNoDelay 是否为 true。
server:
tomcat:
connection-timeout: 30000
# 确保底层开启 TCP_NODELAY,禁用 Nagle
当把 TCP_NODELAY、X-Accel-Buffering: no 以及后端的 50ms / 4字符自适应聚合三者配合起来时,网络抓包中的 TCP 报文时延图就会从极其陡峭的折线变成平缓的水平线。
写在最后
上周五傍晚,小林在飞书上给我发了个竖大拇指的表情包:“鸭梨哥,现在的打字机体验顺滑得像吃了德芙,产品经理没话说了。”
技术做久了你就会发现,软件系统里根本没有什么完全独立的“前端责任”或“后端责任”。
一个看似简单的打字机动画,背后贯穿着大模型推理时延、后端的字符流切割、TCP 层的缓冲协议、反向代理的缓存策略以及前端渲染队列的消费速率。
后端研发如果只管把从模型拿到的字符串一股脑扔进 OutputStream 就不管了,那不叫架构设计,那叫管杀不管埋。把传输链路上的每一个缓冲阀门摸清楚、拧顺溜,才是高并发高可用系统应有的基本功。