/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
🔥小叶-duck:个人主页
❄️个人专栏:《Data-Structure-Learning》《C++入门到进阶&自我学习过程记录》 《Linux系统从入门到实践》《Linux网络从入门到实践》 《Qt 方寸极境》 《MySQL》
✨未择之路,不须回头 已择之路,纵是荆棘遍野,亦作花海遨游
目录
前言
一、前置准备:基础组件的补充优化
1.1 Poller 与 Reactor 的结构优化
1.1.1 Poller:WaitEvents 事件等待接口
1.1.2 Reactor:主循环 Loop
1.1.3 Reactor:单次事件循环 LoopOnce
1.1.4 Reactor:事件分发 Dispatcher
1.2 非阻塞工具与 Socket 改造
1.2.1 通用非阻塞设置函数 SetNonBlock
1.2.2 Listener/Connector 构造函数与 Accepter 接口改造
二、Listener Recver 完善 —— 接收新连接的全流程
2.1 问题:为什么 ET 模式下 accept 必须循环调用?
2.2 accept 的错误码分级处理
2.3 新连接的封装:从 fd 到 Connector
2.4 关键设计:回指指针 _owner
2.4.1 为什么要有回指指针 _owner?
2.4.2 引出问题
2.4.2 解决方案
2.4.3 编译踩坑:头文件包含顺序问题
三、Connector Recver 完善 —— ET 循环读与应用层缓冲区
3.1 ET 模式下的循环读取
3.2 应用层缓冲区:解决粘包问题的基础
3.3 职责分离:用回调上抛协议处理
四、分层解耦:协议层与业务层的引入
4.1 整体分层架构梳理
4.2 协议层 Protocol
4.3 业务层 Calculator
4.4 回调的传递过程
五、Connector Sender 完善 —— 写事件的按需开启
5.1 为什么写事件不能常设?
5.1.1 读写事件的内核默认状态差异
5.1.2 重新理解 epoll_wait 与 EPOLLOUT 触发时机
5.2 循环发送逻辑
5.3 动态事件修改接口
六、入口组装:Main.cc 完整流程
本章总结
结束语
前言
在上一篇《Linux 网络编程》从 0 手写 Reactor 反应堆(上)中,我们完成了 Reactor 基础框架的搭建,理解了 epoll 内核原理,搭建起事件派发、监听连接的基础骨架。但此时的框架仅仅是一个简易原型,距离可用的生产级网络服务还有不少工程细节需要补齐:ET 模式的规范处理、连接全生命周期管理、TCP 粘包处理、读写事件的合理调度、模块之间解耦设计,这些都是本篇需要解决的核心问题。
本篇将基于 epoll ET 触发模式,一步步完善整套 Reactor 反应堆。我们会先对 Poller、Reactor 核心组件做结构优化,改造 Socket 并统一非阻塞工具;接着完善 Listener 接收新连接的完整流程,探讨 ET 下 accept 循环调用的必要性,理解_owner回指指针的设计思路;再实现 Connector 的循环读逻辑,引入应用层缓冲区为粘包处理打下基础,通过回调把报文处理向上交给协议层;随后分层引入协议层与业务层,实现网络逻辑和业务逻辑解耦;之后实现 Sender 发送模块,理解写事件按需开启的核心思想,规避 CPU 空转问题;最后在 Main 入口把全部模块组装,完成整套 Reactor 服务的完整运行流程。
一、前置准备:基础组件的补充优化
在完善核心业务逻辑之前,我们先对前面实现的底层基础组件进行改造优化,为后续 ET 触发模式与非阻塞 IO 的落地做好铺垫。
1.1 Poller 与 Reactor 的结构优化
1.1.1 Poller:WaitEvents 事件等待接口
首先给 Poller 的等待接口补充超时日志,方便调试观察:
// Poller.hpp 节选
//【核心注释】事件收集接口:等待并获取底层已就绪的网络事件。
// 这是 Reactor 的核心驱动力。Reactor 的 Dispatcher 死循环中调用的就是此接口。
// 参数 revs[]:输出型参数,用户态传入一个数组,内核会将就绪事件逐个填充进这个数组交还给上层。
// 参数 maxnum:数组的最大容量,防止内核填充越界。
// 参数 timeout:超时时间(毫秒级)。0 表示非阻塞,-1 表示阻塞等待,>0 代表带超时的阻塞。
int WaitEvents(struct epoll_event revs[], int maxnum, int timeout)
{
// 调用 epoll_wait,如果没事件则阻塞等待;有事件则将就绪队列中的节点提取到 revs 数组中。
// 返回值 n 表示实际有多少个 fd 的事件已经就绪。
int n = epoll_wait(_epfd, revs, maxnum, timeout);
if (n < 0)
{
LOG(LogLevel::WARNING) << "epoll_wait error";
}
else if (n == 0)
{
LOG(LogLevel::WARNING) << "timeout…";
}
return n;
}
1.1.2 Reactor:主循环 Loop
Reactor 的主入口循环,持续驱动事件处理。timeout 固定为 – 1,代表阻塞等待,没有事件时不会占用 CPU。
补充知识点:timeout 参数的选择 timeout = 0:非阻塞轮询,会不断循环调用 epoll_wait,会打满 CPU,一般不用于服务主循环; timeout = -1:阻塞等待,无事件时进程休眠,事件到来才唤醒,是服务器标准配置。
// Reactor.hpp 节选
void Loop()
{
// 如果当前没有任何连接,直接退出循环
if (IsConnectionEmpty())
{
return;
}
_isrunning = true;
int timeout = -1;
while (_isrunning)
{
PrintConnection();
int n = LoopOnce(timeout);
Dispatcher(n);
}
_isrunning = false;
}
1.1.3 Reactor:单次事件循环 LoopOnce
把单次事件等待逻辑抽离为独立LoopOnce函数,仅负责调用 Poller 的等待接口,获取就绪事件数量,职责单一。
// Reactor.hpp 节选
int LoopOnce(int timeout)
{
int n = _epoller_ptr->WaitEvents(_revs, revs_num, timeout);
return n;
}
1.1.4 Reactor:事件分发 Dispatcher
事件分发引擎,遍历 epoll 返回的就绪事件集合,统一处理异常事件,再通过多态调用对应连接的读写回调。
// Reactor.hpp 节选
//【核心注释】事件分发引擎(主循环)。
// 程序跑起来后就会卡在这个死循环里,它是整个异步非阻塞网络库的心脏。
void Dispatcher(int n) // n 是就绪事件的数量
{
for (int i = 0; i < n; i++)
{
int sockfd = _revs[i].data.fd;
uint32_t events = _revs[i].events;
// 1. 将所有的异常处理,统一转化成IO错误
// 所有IO异常,统一转换为IO错误。不需要在这里针对每一类错误单独写处理逻辑
// 统一交给recv/send调用,失败后进入同一套异常处理流程
if (events & EPOLLERR)
{
events |= (EPOLLIN | EPOLLERR);
}
if (events & EPOLLHUP)
{
events |= (EPOLLIN | EPOLLHUP);
}
// 读事件就绪,调用对应连接的Recver读取数据
if (events & EPOLLIN)
{
// 校验连接是否存在,防止fd已经销毁后访问野指针,提升代码健壮性
if (IsConnectionExists(_connections[sockfd]->GetSockFd()))
{
// 借助多态,Listener与Connector会自动调用各自的Recver
_connections[sockfd]->Recver();
}
}
// 写事件就绪,调用对应连接的Sender发送数据
if (events & EPOLLOUT)
{
if (IsConnectionExists(_connections[sockfd]->GetSockFd()))
{
_connections[sockfd]->Sender();
}
}
}
}
1.2 非阻塞工具与 Socket 改造
在前面 epoll 原理的学习当中,我们已经清楚了 ET 模式有硬性约束:所有注册到 epoll 的 fd 必须设置为非阻塞。如果 fd 为阻塞,在 ET 模式下一次数据没有读完,后续不会再次触发事件,会直接卡死整个事件循环。
1.2.1 通用非阻塞设置函数 SetNonBlock
在上篇文章的公共头文件 Common.hpp 中,我们继续添加新功能:封装通用工具函数,使用 fcntl 修改文件描述符,开启 O_NONBLOCK 非阻塞标记。
// Common.hpp 节选
//设置文件描述符为非阻塞状态
void SetNonBlock(int sockfd)
{
int fl = fcntl(sockfd, F_GETFL);
if(fl < 0)
{
return;
}
fcntl(sockfd, F_SETFL, fl | O_NONBLOCK);
}
1.2.2 Listener/Connector 构造函数与 Accepter 接口改造
当我们设计了非阻塞设置函数 SetNonBlock 后,我们就可以将前面 Listener 和 Connector 子类模块中的构造函数进行优化,将后续的监听套接字和连接套接字在创建的时候就自动设置成非阻塞状态:
// Listener.hpp Listener 节选
Listener(int port = defaultport)
: _port(port), _listensock(std::make_unique<TcpSocket>(port))
{
// BuildSocketMethod 内部封装底层 socket 创建、bind绑定端口、listen监听调用。
// 执行完成,套接字就会在指定端口等待客户端连接。
_listensock->BuildTcpSocketMethod(port);
// 将监听fd存入基类,注册事件
SetSockFd(_listensock->Fd());
// 监听fd注册读事件 + ET边缘触发模式
SetEvent(EPOLLIN | EPOLLET);
// ET模式强制要求fd设置为非阻塞
SetNonBlock(_listensock->Fd());
}
// Connector .hpp Connector 节选
class Connector : public Connection
{
public:
// 构造函数:接收Listener accept返回的新fd,初始化连接对象
Connector(int sockfd, const InetAddr &client)
: Connection(sockfd), _client_addr(client)
{
// 新获取到的连接套接字
// 1.初始化事件event为可读和ET模式
SetEvent(EPOLLIN | EPOLLET);
// 2.初始化设置连接套接字为非阻塞状态
SetNonBlock(_sockfd);
}
private:
InetAddr _client_addr; // 保存客户端地址信息
};
同时修改之前我们封装的 Socket.hpp 中的 Accept 接口,通过返回值区分:无新连接、信号中断、真实错误三种场景,向上层暴露 errno 状态。
// Socket.hpp TcpSocket 节选
// Accepter 接收新连接接口
// 由于监听套接字设置成非阻塞状态,所以accept当没有数据时不会进行阻塞,而是返回一个错误码EAGAIN
int Accept(InetAddr *clientptr) override
{
struct sockaddr_in peer;
socklen_t len = sizeof(peer);
int fd = accept(_sockfd, (struct sockaddr *)&peer, &len);
if (fd < 0)
{
if (errno == EAGAIN || errno == EWOULDBLOCK)
{
// 说明全连接队列此时数据为空,没有新套接字可以获取
return ACCEPT_DONE;
}
else if (errno == EINTR)
{
// accept执行过程被信号中断,重试即可
return ACCEPT_CONTINUE;
}
else
{
// 真正的accept错误,无法继续接收连接
LOG(LogLevel::WARNING) << "accept error";
return ACCEPT_ERROR;
}
}
// clientptr是输出型参数,将对端地址写入,向上层返回客户端地址信息
clientptr->SetAddr(peer);
return fd;
}
整套改造完成后,所有 fd(监听套接字、客户端连接套接字)在创建的时候就会全部自动设置为非阻塞,统一使用 ET 边缘触发。 Reactor 主循环、事件等待、事件分发的职责被拆解开,代码解耦,后续可以在 Dispatcher 中依靠多态自动区分 Listener 接收连接、Connector 读写业务数据。
二、Listener Recver 完善 —— 接收新连接的全流程
基础工作准备完成后,我们从 Listener 的事件处理逻辑入手,补齐接收新连接的完整逻辑。这也是 Reactor 模型中,服务端接收客户端连接的入口。
2.1 问题:为什么 ET 模式下 accept 必须循环调用?
在回答这个问题之前,我们要先清楚为什么在之前的学习当中我们并没有考虑这个问题? 我们会发现在之前所写的代码中即使我们只调用一次 accept,代码运行起来也并没有出现问题,那是不是不需要循环调用呢?不是。 因为在之前我们所写的代码中创建的套接字都是默认的 LT 模式,在 LT 模式下这样写是不会出现严重问题,因为未处理完毕的连接后续依然会持续触发事件通知。 但 ET 模式是边沿触发,仅在状态发生改变时触发一次事件。
假设同一时刻有 10 个客户端完成 TCP 三次握手,内核全连接队列一次性存入 10 条连接。如果代码只执行一次accept,只会取出一条连接,剩下 9 条不会再产生事件通知,直接造成连接丢失。 因此 ET 模式下规范写法:使用 while 循环持续调用 accept,直到返回值标识队列已无新连接,才退出循环。
2.2 accept 的错误码分级处理
accept返回异常并不完全代表程序出错,我们需要根据返回的状态码做差异化处理。
// Listener.hpp Recver 节选
void Recver() override
{
LOG(LogLevel::INFO) << "Listener event ready";
while (true)
{
InetAddr client;
int sockfd = _listensock->Accept(&client);
if (sockfd == ACCEPT_CONTINUE)
{
// 被信号中断,重试回到开头继续accept
continue;
}
else if (sockfd == ACCEPT_ERROR)
{
// 说明accept出错,不能继续读取
LOG(LogLevel::ERROR) << "accept error";
break;
}
else if (sockfd == ACCEPT_DONE)
{
// 说明全连接队列中的连接套接字信息全部读取完成,退出循环
LOG(LogLevel::INFO) << "accept finish, no more connections";
break;
}
else
{
// 到这里就说明accept没有出错且读取还没有完成,读取到的是合法的sockfd
// 新连接封装逻辑,拿到新连接,后续封装处理
}
}
}
2.3 新连接的封装:从 fd 到 Connector
拿到新生成的sockfd之后,不能直接使用原始 fd 调用 recv/send 收发数据。 遵循 Reactor 的设计思想:每一个文件描述符,都需要封装为 Connection 连接对象,交由 Reactor 统一调度管理,后续当对应的文件描述符存在读事件就绪时,我们再通过 Connection 连接对象调用 Recver 借助多态进而调用对应 Connector 子类中的 Recver 完成数据读取。
完整处理步骤:
// 合法sockfd分支
if(sockfd >= 0)
{
// 1.创建一个新的 Connector 普通套接字对象
std::shared_ptr<Connection> conn = std::make_shared<Connector>(sockfd, client);
// 2.将主函数中给监听套接字设置的回调函数,再注册给后续新的 Connector 普通套接字中
if (_handler != nullptr) // 不为空再注册,如果为空说明套接字设置回调函数存在问题
{
// 注意逻辑:_handler是监听套接字的,用conn也就是新的套接字调用RegisterHandler注册到conn自己的_handler当中
conn->RegisterHandler(_handler);
}
// 3.将具体的 Connector 对象 添加到 _connections 中进行管理,并且放入内核
GetOwner()->AddConnection(conn);
}
2.4 关键设计:回指指针 _owner
上面代码中GetOwner()背后的_owner是非常巧妙的设计,我们单独展开分析。
2.4.1 为什么要有回指指针 _owner?
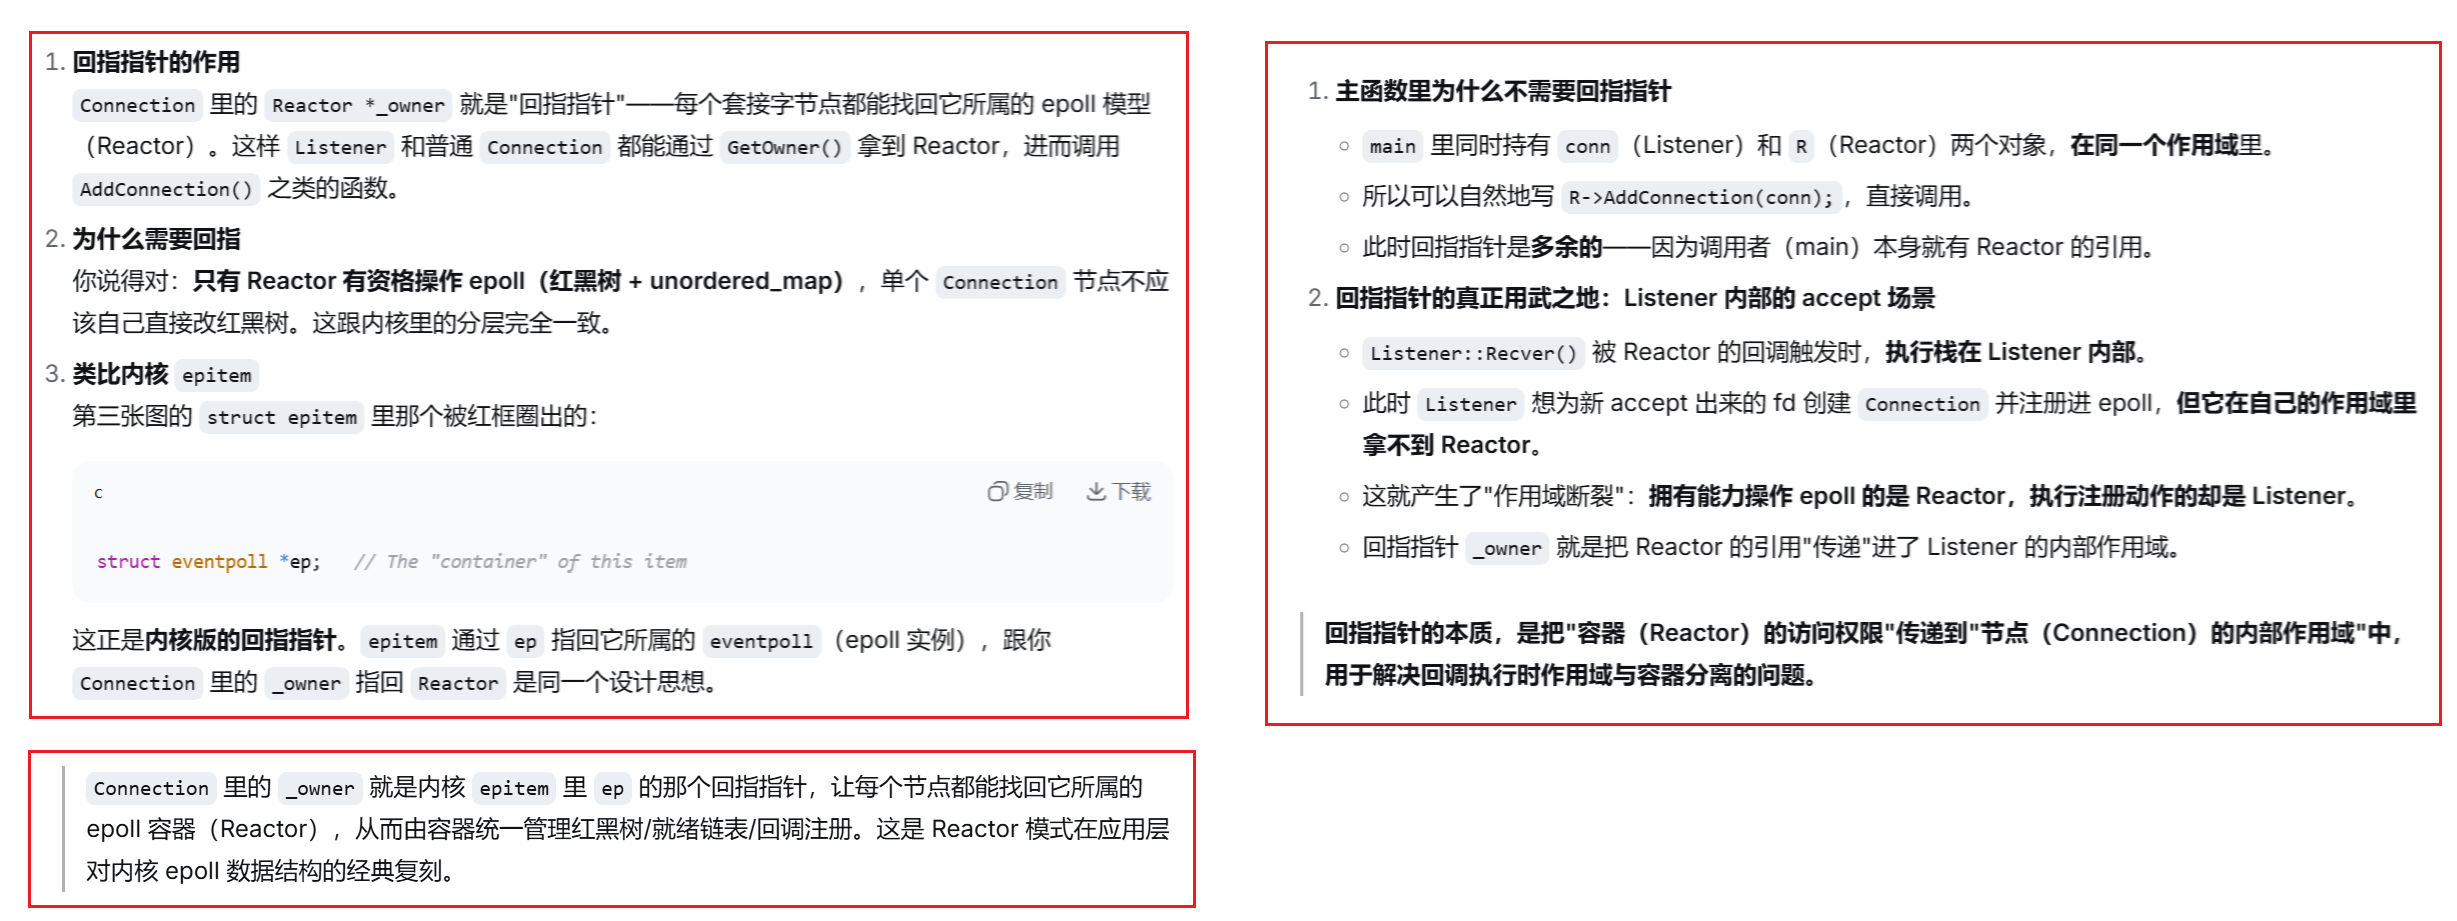
问题:在我们自己封装的 Connection 基类代码中,为什么需要_owner回指指针?
我们在用户态封装事件管理结构时,每一个 fd 对应的事件对象,都需要记录自己归属哪一个 epoll 服务实例,_owner就是这个反向引用。
2.4.2 引出问题
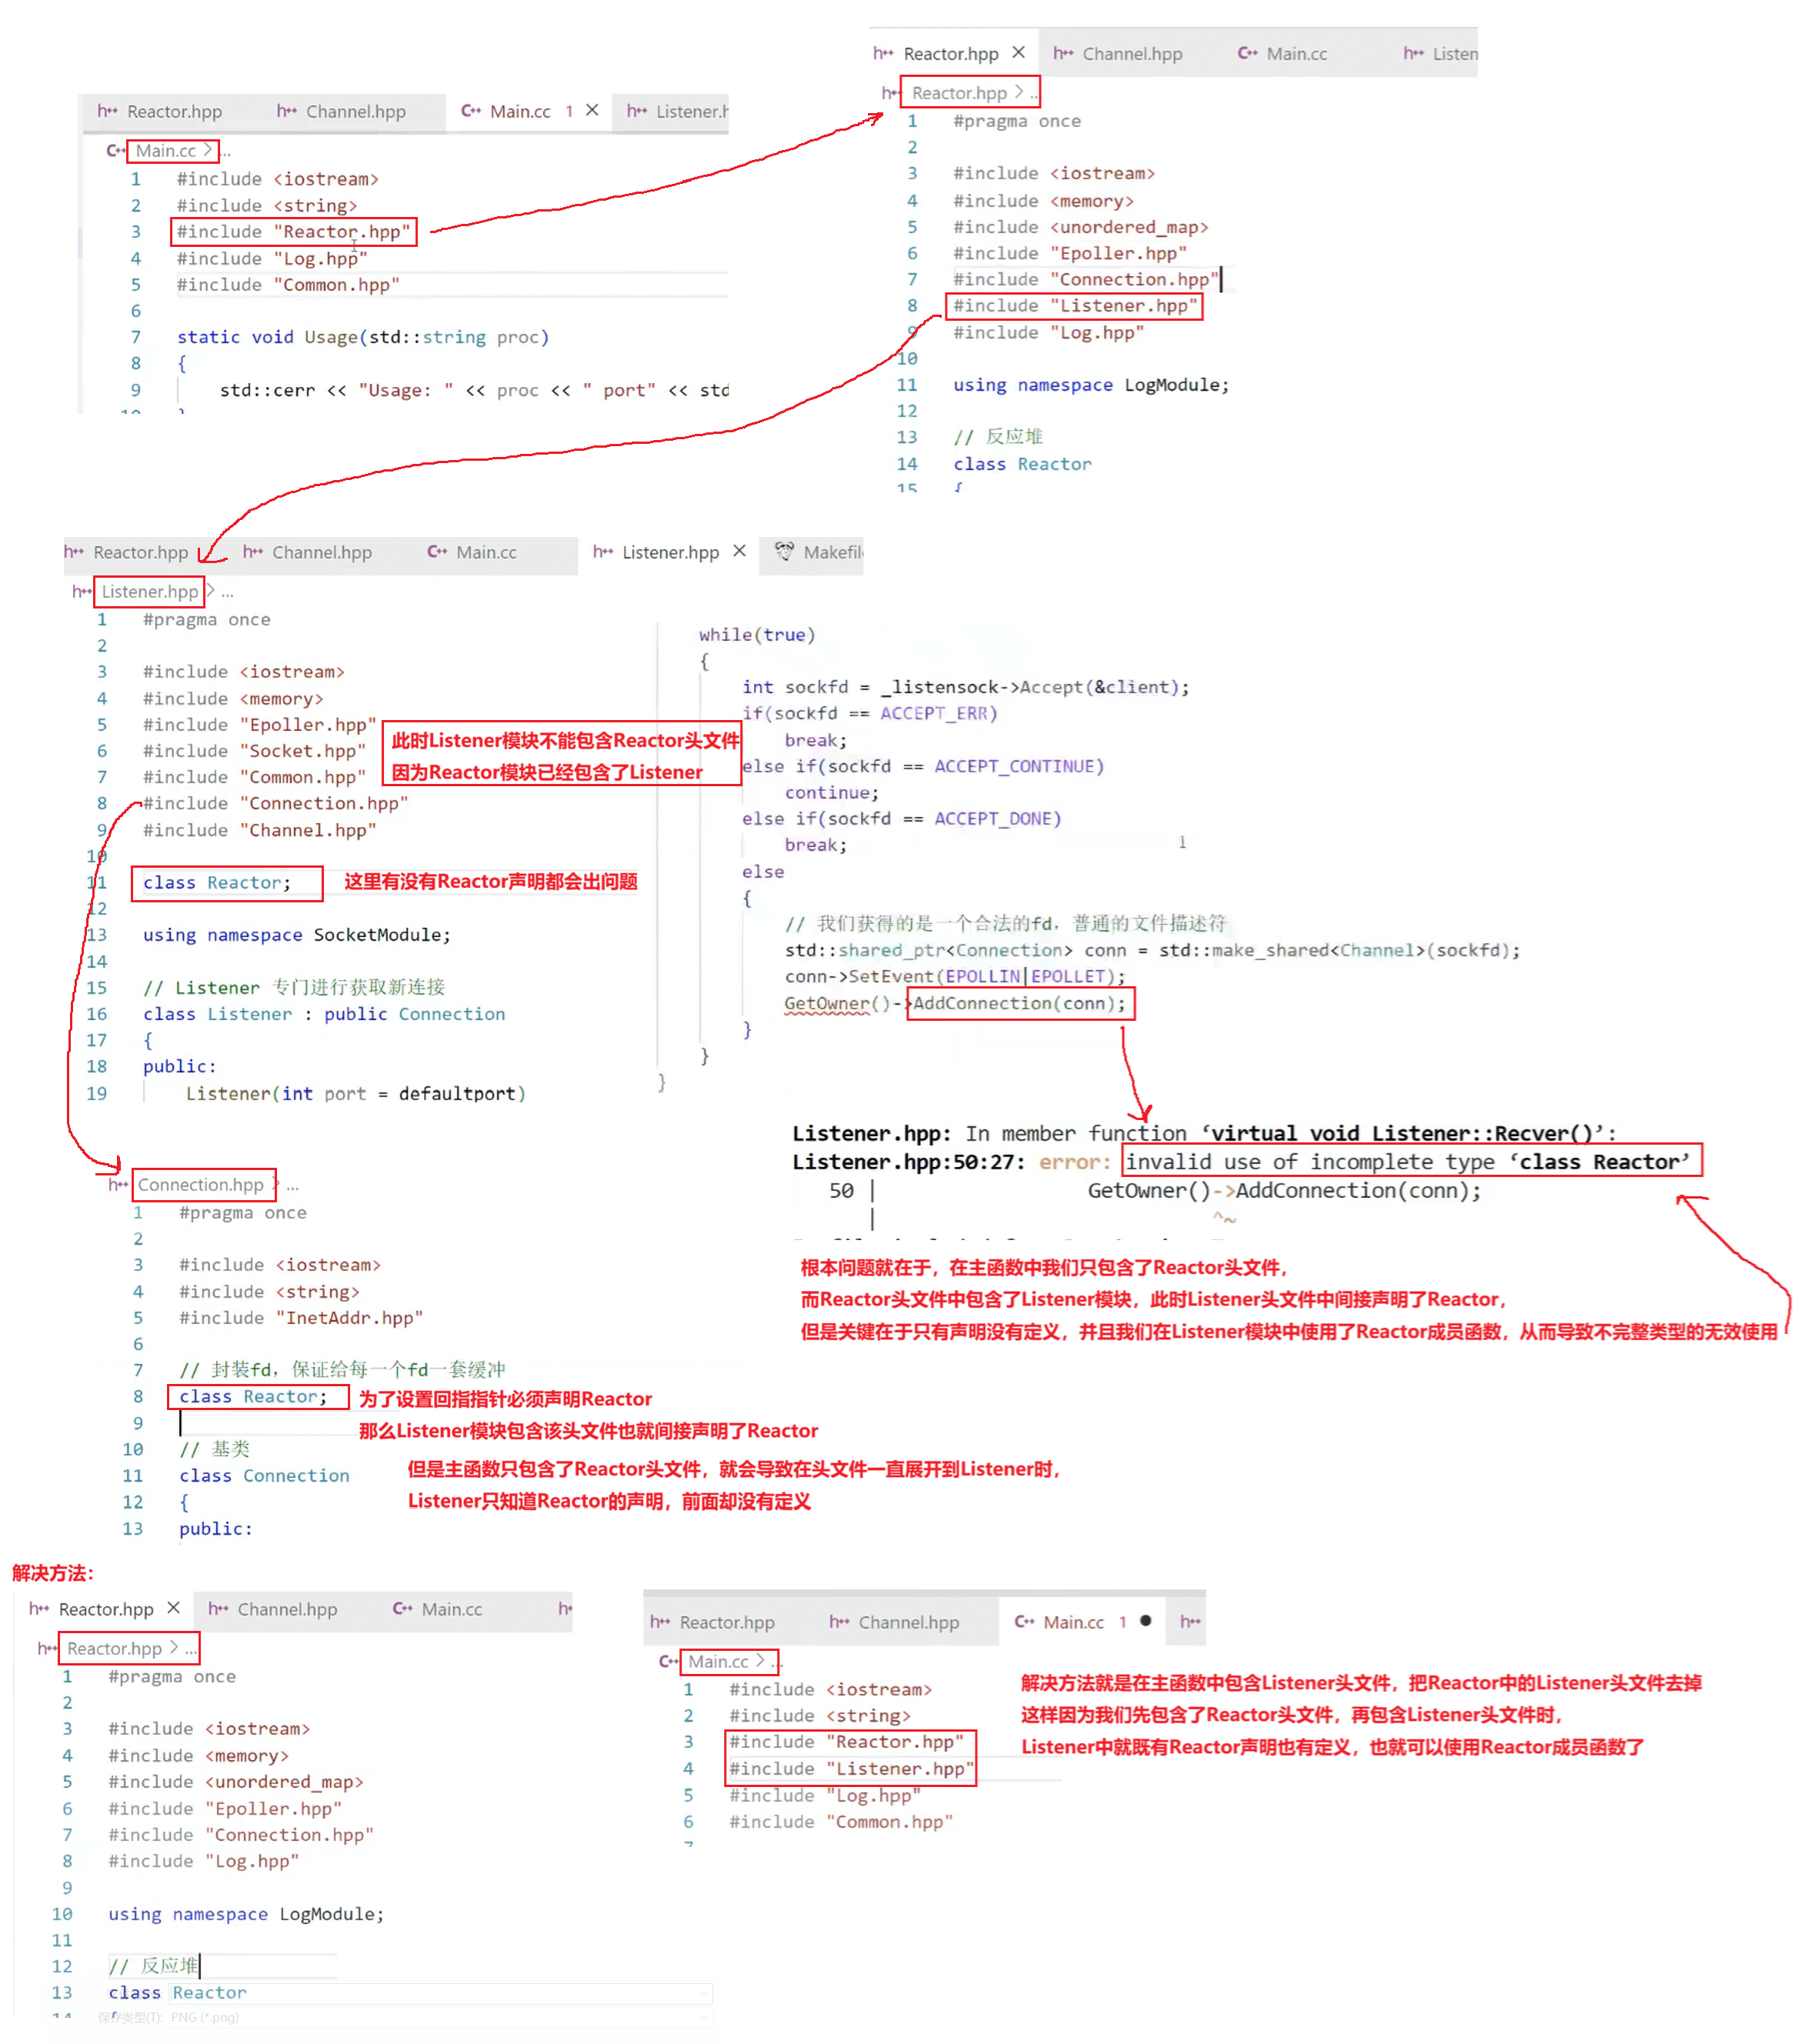
在上面我们已经清楚了为什么在 Connection 基类中,需要有_owner回指指针了。 Listener 在拿到新连接之后,需要调用 Reactor 的AddConnection方法将连接注册进 epoll。但是 Reactor 持有 Connection 对象所以需要包含 Connection 头文件,但是 Connection 内部又包含 Reactor 的回指指针,Connection 模块又包含 Reactor 头文件,会形成头文件循环依赖,直接编译失败。
2.4.2 解决方案
// Connection.hpp 节选
class Reactor; // 前向声明
class Connection
{
public:
Connection():_events(0), _owner(nullptr) {}
// … 其他接口
public:
Reactor* _owner; // 回指指针
};
为什么使用原生指针而不用智能指针 shared_ptr? Reactor 通过 shared_ptr 管理 Connection 对象。如果 Connection 内部再用 shared_ptr 反向持有 Reactor,会形成循环引用,即使双方都调用析构函数,双方的引用计数也永远无法归 0,从而引发内存泄漏。 原生指针仅用于访问,不参与对象生命周期管理,是简洁稳妥的方案。
2.4.3 编译踩坑:头文件包含顺序问题
即便我们写好了前向声明,在调用_owner->AddConnection()的位置,编译器依然要求能够看到 Reactor 的完整类定义。 头文件的引入顺序会直接触发invalid use of incomplete type 'class Reactor'编译报错。
- 错误引入顺序:Reactor.hpp 内部包含 Listener.hpp,会造成当头文件递归展开时,Listener 仅能看到 Reactor 前向声明,看不到完整定义,而我们又在 Listener 中调用了 Reactor 的成员函数,这是要求 Reactor 有完整类定义。
- 解决办法:在 main 主文件中,先引入 Reactor.hpp,再引入 Listener.hpp。这样在 Listener 代码执行时,Reactor 完整定义已经先加载,对于 Listener 而言 Reactor 就既有声明也有定义了,也就可以正常调用 Reactor 的成员函数。
三、Connector Recver 完善 —— ET 循环读与应用层缓冲区
接收到的新连接最终都会走到 Connector 的 Recver,它负责真正的数据收发。读逻辑和 accept 的 ET 处理思路高度一致。
3.1 ET 模式下的循环读取
和 accept 处理逻辑一样:ET 模式下读事件仅触发一次,必须循环调用 recv,把内核接收缓冲区的数据全部读完,直到接收缓冲区数据全部读取上来并且返回 EAGAIN,即可什么接收缓冲区内部没有数据可读了。
// IOHandler.hpp Recver 节选
// 【核心注释】IOHandler 的“读”事件处理逻辑:负责真正的报文读取。
// 当 epoll 检测到该 _sockfd 触发了 EPOLLIN(可读事件)时被调用。
// 这里的核心工作是调用 recv(),将内核接收缓冲区中的数据读取出来,并持续追加到从基类继承下来的 inbuffer(应用层接收缓冲区)中。
// 只有在 inbuffer 中积攒了完整的协议报文后,才会向上层业务交付,从而彻底解决 TCP 的粘包/半包问题。
void Recver() override
{
char buffer[SIZE];
while (true)
{
buffer[0] = 0;
int n = recv(_sockfd, buffer, sizeof(buffer) – 1, 0); // 非阻塞读取的
if (n > 0)
{
buffer[n] = 0;
_inbuffer += buffer; // 接受缓冲区中,入队列的过程
}
else if (n == 0)
{
// 说明客户端退出,调用Excepter从Reactor容器中的_connections删除对应节点并且关闭文件描述符
Excepter();
return;
}
else
{
if (errno == EAGAIN || errno == EWOULDBLOCK)
{
break; // 数据读完了
}
else if (errno == EINTR)
{
continue; // 被信号打断,重试
}
else
{
Excepter();
return;
}
}
}
// … 报文处理, 就在下面
}
注意两个细节:
- 对端关闭和读错误时用 return 而不是 break,因为出错了就没必要继续后面的业务处理,直接退出函数;
- 数据不是处理完就丢弃,而是追加到_inbuffer里,这就是应用层接收缓冲区。
两个核心问题梳理 问题 1:怎么保证把本轮数据读取完毕?while 循环,本层只解决 IO 读取问题。 问题 2:就算把本轮数据读完,如何判断 inbuffer 用户缓冲区拥有完整报文?如果报文不完整,或是多个报文,就会触发粘包问题,需要引入协议层处理。
3.2 应用层缓冲区:解决粘包问题的基础
TCP 属于无边界的字节流协议,操作系统不会区分业务报文的起止位置。单次 recv 调用,拿到的数据有可能只是半条报文,也可能一次性包含多条报文。如果数据只存放在函数局部 buffer,函数结束后数据直接销毁,半包数据就无法继续拼接处理。
我们为每一条 TCP 连接单独维护_inbuffer接收缓冲区,就是用来处理这类场景。读取到的字节持续追加存入缓冲区,遇到半包数据就暂时保存,等待下一轮 IO 事件读取新数据后继续拼接,直到缓冲区组装出完整报文,再交给上层业务解析。这就是先缓存接收,后解析报文的设计思想。
3.3 职责分离:用回调上抛协议处理
Connector 的定位只负责 IO 层面的读写操作,不负责报文解析、业务逻辑计算。如果将报文解析、业务运算全部写在 Connector 内部,模块之间会深度耦合,代码很难维护,失去事件驱动框架的优势。
我们采用回调机制,把协议解析与业务逻辑向上层抛出。Connector 只负责把读到的缓冲区数据交给回调函数;上层业务全部处理完成后,再把需要回复的应答数据通过输出型参数写入到 outbuffer 用户缓冲区中。
// 回调类型定义
using handler_t = std::function<void(std::string &inbuffer, std::string &outbuffer)>;
// Connector 读取完成后
LOG(LogLevel::DEBUG) << "Connector: Inbuffer:\\n"
<< _inbuffer;
if (!_inbuffer.empty()) // _inbuffer缓冲区有数据我们才进行回调处理
{
_handler(_inbuffer, _outbuffer); // 回调到上层协议层进行数据处理,将处理结果存放到_outbuffer中
LOG(LogLevel::DEBUG) << "Connector: Outbuffer:\\n"
<< _outbuffer;
}
if (!_outbuffer.empty()) // 到这如果_outbuffer还没有数据,要么是上面_inbuffer本身没数据或者报文不完整,要么回调处理出现问题,不进行发送
{
Sender();
}
四、分层解耦:协议层与业务层的引入
引入回调机制之后,我们可以在 IO 层之上,搭建协议层与业务层,构建三层模块化架构,实现网络、协议、业务逻辑的解耦。
4.1 整体分层架构梳理
从上到下三层结构:
层与层之间依靠各个模块的回调函数交互,下层只依赖上层约定的接口规范,不会感知上层具体实现,符合开闭原则。修改业务逻辑时,不再需要改动网络层、协议层代码。
4.2 协议层 Protocol
协议层的核心职责是:对流式字节数据做完整报文解析与封装。 TCP 是流式协议,单次读取到的数据可能包含多条完整报文,也可能只读到半条报文,因此需要循环处理缓冲区数据。
- 解码DeCode:从接收缓冲区中,依据自定义长度包头,提取一条完整 JSON 请求报文;
- 编码EnCode:将业务处理完成的响应结构体序列化为 JSON 字符串,再追加长度包头,封装成可通过网络发送的完整报文;
- GetResults:循环解析缓冲区报文,反序列化得到请求对象,调用业务回调函数处理,再把业务结果序列化、封装报文,追加到 _outbufer 用户缓冲区中存放。
// Protocol.hpp GetResults 核心逻辑
void GetResults(std::string &inbuffer, std::string *outbuffer)
{
while (true)
{
std::string json_package;
// 1、解析报文,提取完整的json请求,判断如果报文不完整,说明结束了,为什么?
// 因为Recv调用是在Connector模块中进行处理的,当代码执行到这说明所有的报文都已经存放到inbuffer中了
// 并且我们调用GetResult不仅仅只获取一个完成业务处理的结果报文,而是while循环有多少处理多少,直到当前报文判断不完整为止
// 所有完成业务处理的结果报文经过序列化并且封装报头最终都会存放到Connector对象节点中的outbuffer中
// 而下次对应的fd读事件就绪,再次循环读取Recv时,内容就可以追加到inbuffer中不完整报文的后面
if (!DeCode(inbuffer, &json_package))
{
break;
}
// 到这里就能说明:json_package一定获取到了一个完整的报文!
// server端接收到->{"x": 10, "y": 20, "oper": '+'} -> 能直接处理吗?
// 2、请求json串,反序列化
Request req; // 需要初始化?不需要,反序列化本来就是对成员变量进行赋值
req.Deserialize(json_package);
// 3、到这我就一定得到了一个内部属性已经被设置了的req了
// 通过req->resp,不就是要完成计算功能了嘛 ——> 业务
Responce resp = _func(req); // 业务处理:回调
// 得到了结果Responce,接下来就是把结果再应答给客户端
// 能直接应答吗?Responce还没有序列化成字符串呢!
// 4、序列化
std::string json_str = resp.Serialize();
// 到这就已经序列化了,可以发送了吗?还不够!
// server端把回复的信息发过去,client也要面向字节流读取呀!
// 面向字节流读取就会存在报文读多读少的情况,怎么解决?
// 5、封装报头(添加自定义长度)!
std::string send_str = EnCode(json_str); // 携带长度的应答报文
// 6、将一个完成了序列化并且封装报头的报文字符串,放入到Connector对象节点中的outbuffer中进行存放
*outbuffer += send_str; // 注意:一定是+=追加操作,因为inbuffer中不一定只存放了一个完整报文可能有多个,我们需要全部都提取出来
// 但如果Decode判断当前报文不完整,就说明inbuffer中能获取的报文都获取完了,直接返回即可
}
}
这里的while(true)循环,目的是一次性处理缓冲区中所有完整报文。一次 IO 读取到的数据,有可能携带多条客户端请求,必须循环全部解析处理;当DeCode判断剩余字节不足以构成一条完整报文,就退出循环,等待下一次可读事件到来、继续接收数据。
4.3 业务层 Calculator
业务层Cal是整个框架中最纯粹的模块,只实现计算器四则运算与取模逻辑。它完全不感知网络、epoll、JSON 序列化,也不知道自己运行在 Reactor 事件循环内,只接收请求对象Request,返回计算结果对象Response。
#ifndef NETCALCULATOR_HPP
#define NETCALCULATOR_HPP
#include "protocol.hpp"
class Cal
{
public:
Response Execute(const Request &req)
{
Response resp(0, 0);
switch (req.Oper())
{
case '+':
resp.SetResult(req.X() + req.Y());
break;
case '-':
resp.SetResult(req.X() – req.Y());
break;
case '*':
resp.SetResult(req.X() * req.Y());
break;
case '/':
if (req.Y() == 0)
{
resp.SetCode(1); // 1: 除零错误
}
else
{
resp.SetResult(req.X() / req.Y());
}
break;
case '%':
if (req.Y() == 0)
{
resp.SetCode(2); // 2: 余零错误
}
else
{
resp.SetResult(req.X() % req.Y());
}
break;
default:
resp.SetCode(3); // 3: 非法操作
break;
}
return resp;
}
private:
};
#endif
业务层的设计优势在于业务逻辑与网络框架完全解耦。
- 可以脱离网络单独对计算器逻辑做单元测试;
- 如果后续要替换业务,例如从计算器改成聊天服务,只需要替换业务回调函数。IO 层、协议层代码完全不用改动。 同时内置错误码机制,区分除零、取模零值、非法运算符三类异常,向上层返回错误状态,由协议层统一打包返回给客户端。
4.4 回调的传递过程
回调函数如何从入口 Main,最终传递到 Connector,完整链路梳理:
整个回调组装过程如同积木拼接,不存在硬编码依赖,模块之间只依赖接口约定。
五、Connector Sender 完善 —— 写事件的按需开启
前面我们完成了数据读取与协议业务分层,接下来讲解数据发送逻辑。发送模块相比读取,存在一个核心设计要点:写事件不能常设,需要按需注册、动态管理。
5.1 为什么写事件不能常设?
很多初学者会直接给 fd 同时注册EPOLLIN与EPOLLOUT,这是典型的开发错误,背后和 epoll 事件通知机制、非阻塞 IO 的特性强相关。
5.1.1 读写事件的内核默认状态差异
读事件:默认不满足。当内核缓冲区没有数据时,不会触发EPOLLIN;只有数据到达后,内核才通知 epoll,因此EPOLLIN可以长期注册,不会产生问题。
写事件:默认处于就绪状态。只要内核的发送缓冲区还有空闲空间,EPOLLOUT就一直处于就绪。如果我们持续常设EPOLLOUT,epoll_wait 会不断返回写就绪事件,事件循环反复触发发送回调,CPU 占用直接打到 100%,造成空转。
最佳实践:默认只开启EPOLLIN;仅当应用层还有待发送数据,且 send 返回EAGAIN,内核发送缓冲区被打满时,才注册EPOLLOUT;当待发送数据全部发送完成,立刻删除EPOLLOUT。
5.1.2 重新理解 epoll_wait 与 EPOLLOUT 触发时机
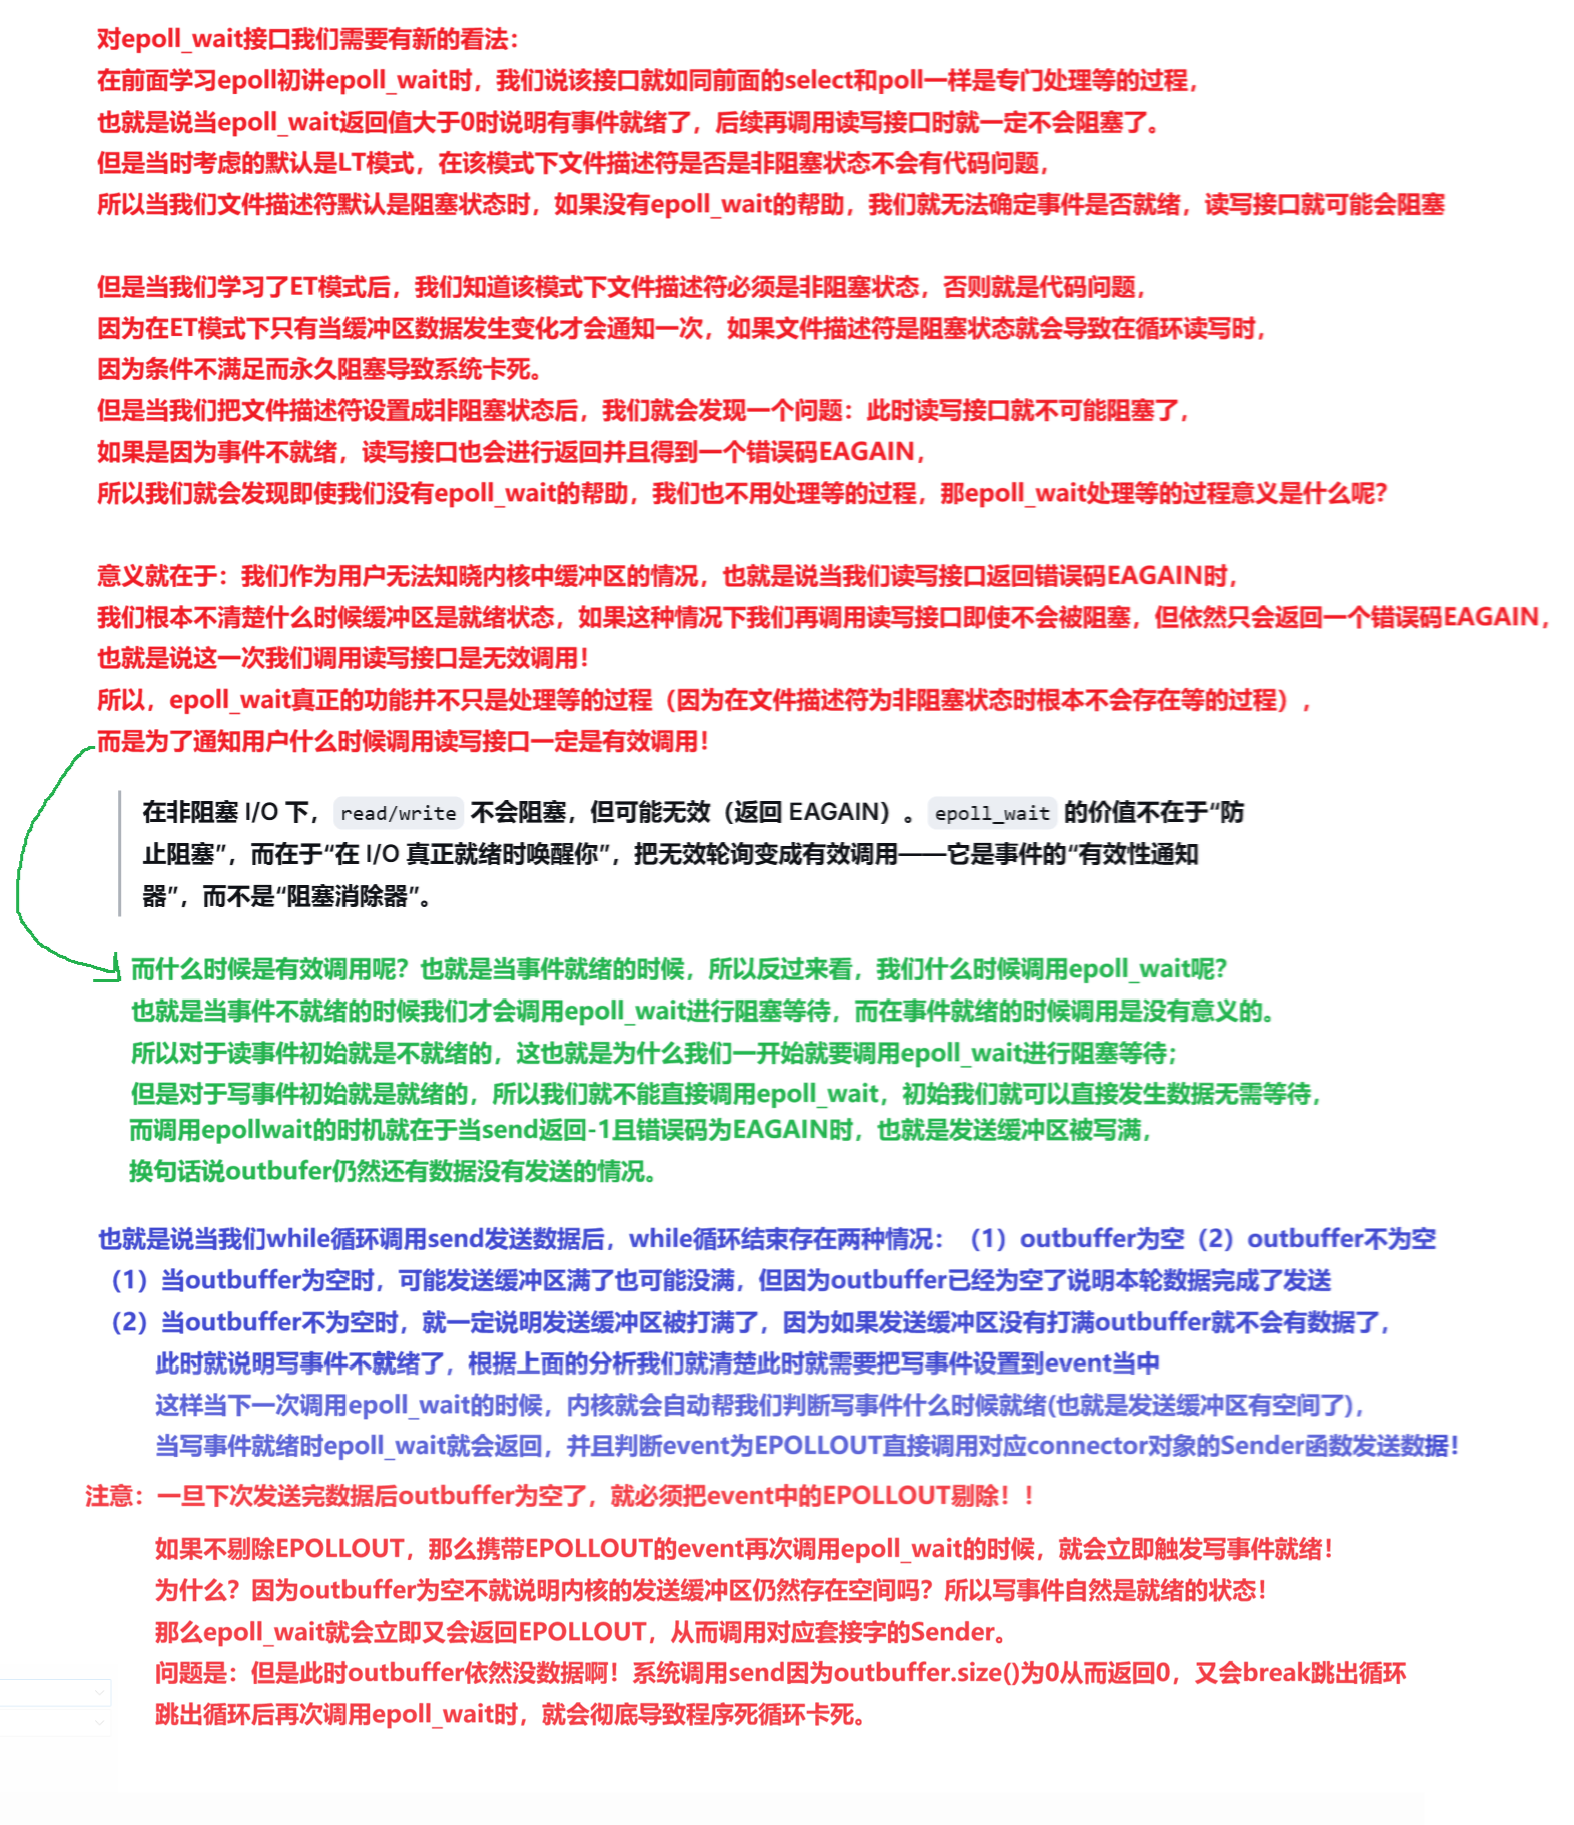
在 ET 模式下,文件描述符必须设置为非阻塞,这是硬性约束。非阻塞 IO 下的 send/recv 调用本身不会阻塞,但会出现无效调用:当缓冲区不满足读写条件时,直接返回EAGAIN。 用户态无法主动感知内核缓冲区什么时候恢复可用。epoll_wait的核心价值不是防止系统调用阻塞,而是事件有效性通知器:只有 IO 条件真正就绪时,唤醒用户态,让 send/recv 调用变成有效调用,避免盲目循环调用。
对于读事件:初始状态一般无数据,所以一开始就注册EPOLLIN,等待数据到来。 对于写事件:初始状态发送缓冲区天然有空间,写事件默认就绪,不能一开始就注册EPOLLOUT。只有当 send 返回EAGAIN,代表内核发送缓冲区已满,还有数据留在应用层outbuffer待发送时,才需要注册EPOLLOUT,交给 epoll 监听。
当 epoll_wait 返回EPOLLOUT,说明内核发送缓冲区重新腾出空间,此时再执行 Sender 发送逻辑。
关键要点:一旦应用层发送缓冲区outbuffer全部发空,必须立刻从 epoll 事件中移除EPOLLOUT。如果不删除,由于内核发送缓冲区仍然存在空间处于写事件就绪状态,下一次epoll_wait会立刻再次返回写就绪,但是outbuffer已经没有数据可以发送,send 程序进入无限循环死卡。
5.2 循环发送逻辑
和 ET 模式下的读逻辑一样,写操作也需要循环发送,直到应用层缓冲区数据全部发送完毕,或是内核发送缓冲区被填满无法继续写入。
// 核心注释:IOHandler的“写”事件处理逻辑:负责真正的数据发送。
// 当epoll检测到该_sockfd触发了EPOLLOUT(可写事件)时被调用。
// 核心工作是调用send(),将从基类继承下来的 outbuffer(应用层发送缓冲区)中的待发数据刷入系统内核。
// 如果底层的发送窗口满了导致一次没发完,剩余数据会继续留在 outbuffer 中,等待下一次 epoll 触发可写事件时自动继续发送,实现真正的异步非阻塞。
void Sender() override
{
while (true)
{
int n = send(_sockfd, _outbuffer.c_str(), sizeof(_outbuffer), 0);
if (n > 0)
{
// 从 outbuffer 中 erase 掉已发送的部分
_outbuffer.erase(0, n);
if (_outbuffer.empty())
{
break;
}
}
else if (n == 0)
{
break;
}
else
{
if (errno == EAGAIN || errno == EWOULDBLOCK)
{
// 说明发送缓冲区被打满
break;
}
else if (errno == EINTR)
{
continue;
}
else
{
Excepter();
return;
}
}
}
// send循环调用完成后,存在两种情况:
// 1. 数据发送完毕
// 2. 发送条件不具备
if (_outbuffer.empty())
{
// 说明是 1. 数据发送完毕
// 注意:必须将写事件EPOLLOUT从event中移除,否则就会死循环
GetOwner()->EnableReadWrite(_sockfd, true, false);
}
else
{
// 说明是 2. 发送条件不具备
// 发送条件不具备就说明写事件不就绪,将写事件添加到event中,用于epoll进行监视写事件
GetOwner()->EnableReadWrite(_sockfd, true, true);
}
}
循环结束只会出现两种场景:
5.3 动态事件修改接口
上面代码中的EnableReadWrite是 Reactor 框架对外提供的接口,作用是动态修改某个 fd 在 epoll 实例中关心的事件类型。这里先预留接口,再下篇文章代码收尾时会完善epoll_ctl的 MOD 底层实现,同时完成连接释放与生命周期管理。
六、入口组装:Main.cc 完整流程
前面我们已经完成 Reactor 框架各模块的独立实现,现在通过 Main.cc 完成所有模块的组装。整个过程如同搭积木,把业务层、协议层、监听器、Reactor 事件驱动核心依次串联,直观感受分层架构的解耦设计。
#include <iostream>
#include <string>
#include "Reactor.hpp"
#include "Listener.hpp"
#include "Log.hpp"
#include "Common.hpp"
#include "protocol.hpp"
#include "NetCalculator.hpp"
int main(int argc, char *argv[])
{
if (argc != 2)
{
std::cout << "Usage: " << argv[0] << " port " << std::endl;
exit(USAGE_ERR);
}
// 开启控制台日志输出
ENABLE_CONSOLE_LOG_STRATEGY();
uint16_t port = std::stoi(argv[1]);
// 1、构建业务模块:计算器业务对象
std::shared_ptr<Cal> cal = std::make_shared<Cal>();
// 2、构建协议对象,绑定业务回调
std::shared_ptr<Protocol> protocol = std::make_shared<Protocol>([&cal](const Request &req)->Response {
LOG(LogLevel::DEBUG) << "进入业务模块进行业务处理";
Response resp = cal->Execute(req);
LOG(LogLevel::DEBUG) << "业务处理结束…";
return resp;
});
// 3、构建Listener监听器对象,注册协议层处理回调
std::shared_ptr<Connection> listensock_ptr = std::make_shared<Listener>(port);
listensock_ptr->RegisterHandler([&protocol](std::string &inbuffer, std::string &outbuffer){
LOG(LogLevel::DEBUG) << "进入到protocol GetResults";
protocol->GetResults(inbuffer, outbuffer);
LOG(LogLevel::DEBUG) << "protocol GetResults 处理结束…";
});
// 4、构建Reactor事件驱动核心,将监听连接加入事件管理
std::unique_ptr<Reactor> reactor = std::make_unique<Reactor>();
reactor->AddConnection(listensock_ptr);
// 5、启动Reactor事件循环,开始等待并分发IO事件
reactor->Loop();
return 0;
}
代码流程解析:
本章总结
到这里,这套基于 epoll ET 模式的 Reactor 反应堆框架核心细节已经全部落地,我们梳理本篇完整实现的核心要点:
结束语
至此,《Linux 网络编程》从 0 手写 Reactor 反应堆(中)的全部内容就讲解完毕。我们从基础组件优化入手,逐步补齐了 ET 模式下新连接接收、循环读写、应用层缓冲区等核心能力,借助 _owner 回指指针解决了事件回调时的对象访问问题;通过回调机制实现协议层与业务层的分层解耦,把网络读写逻辑和业务计算逻辑彻底分开;同时掌握了写事件按需注册的设计,解决了 EPOLLOUT 常设带来的 CPU 空转陷阱,最后在 Main 函数中将所有模块组装,让整套 Reactor 框架完整跑通。
本篇完成的是 Reactor 的核心工程落地,当前框架已经具备事件驱动服务器的基础能力,但还有更多可优化的工程化内容待挖掘:连接异常关闭、内存资源回收、超时管理、高并发下的性能调优、多 Reactor 模型等内容,将放到下一篇继续讲解。