在所有分布式基础组件中,基于 Erlang OTP 构建的 RabbitMQ 绝对是高并发大促保障中脾气最“娇贵”、对网络抖动最敏感的中间件之一。
那是双十一全链路高压演练的第三天深夜。凌晨 02:10,核心支付与积分返现链路的监控看板突然亮起整片刺眼的猩红警报:RabbitMQ 核心集群的 3 个节点全部告警失去集群联系!正在运行的数百个消费者瞬间断开重连,死信队列(Dead Letter Queue, DLQ)中的未确认消息计数如断裂的弹簧一般以每秒数万条的速度疯狂飙升,不到 3 分钟内积压了整整 1500 万条死信!与此同时,两台 Broker 节点的磁盘空间从 35% 垂直拉升至 96%,直接触发了 RabbitMQ 的物理磁盘水位警戒线(Disk Alarm),所有生产者的发布通道被集群彻底硬挂起(Blocked)!
系统瞬间陷入了全链路阻塞。核心支付网关的 RPC 线程池被全部打死,上下游服务发生雪崩式超时。在紧急作战室里,所有运维同学和业务研发的手心都在冒汗。
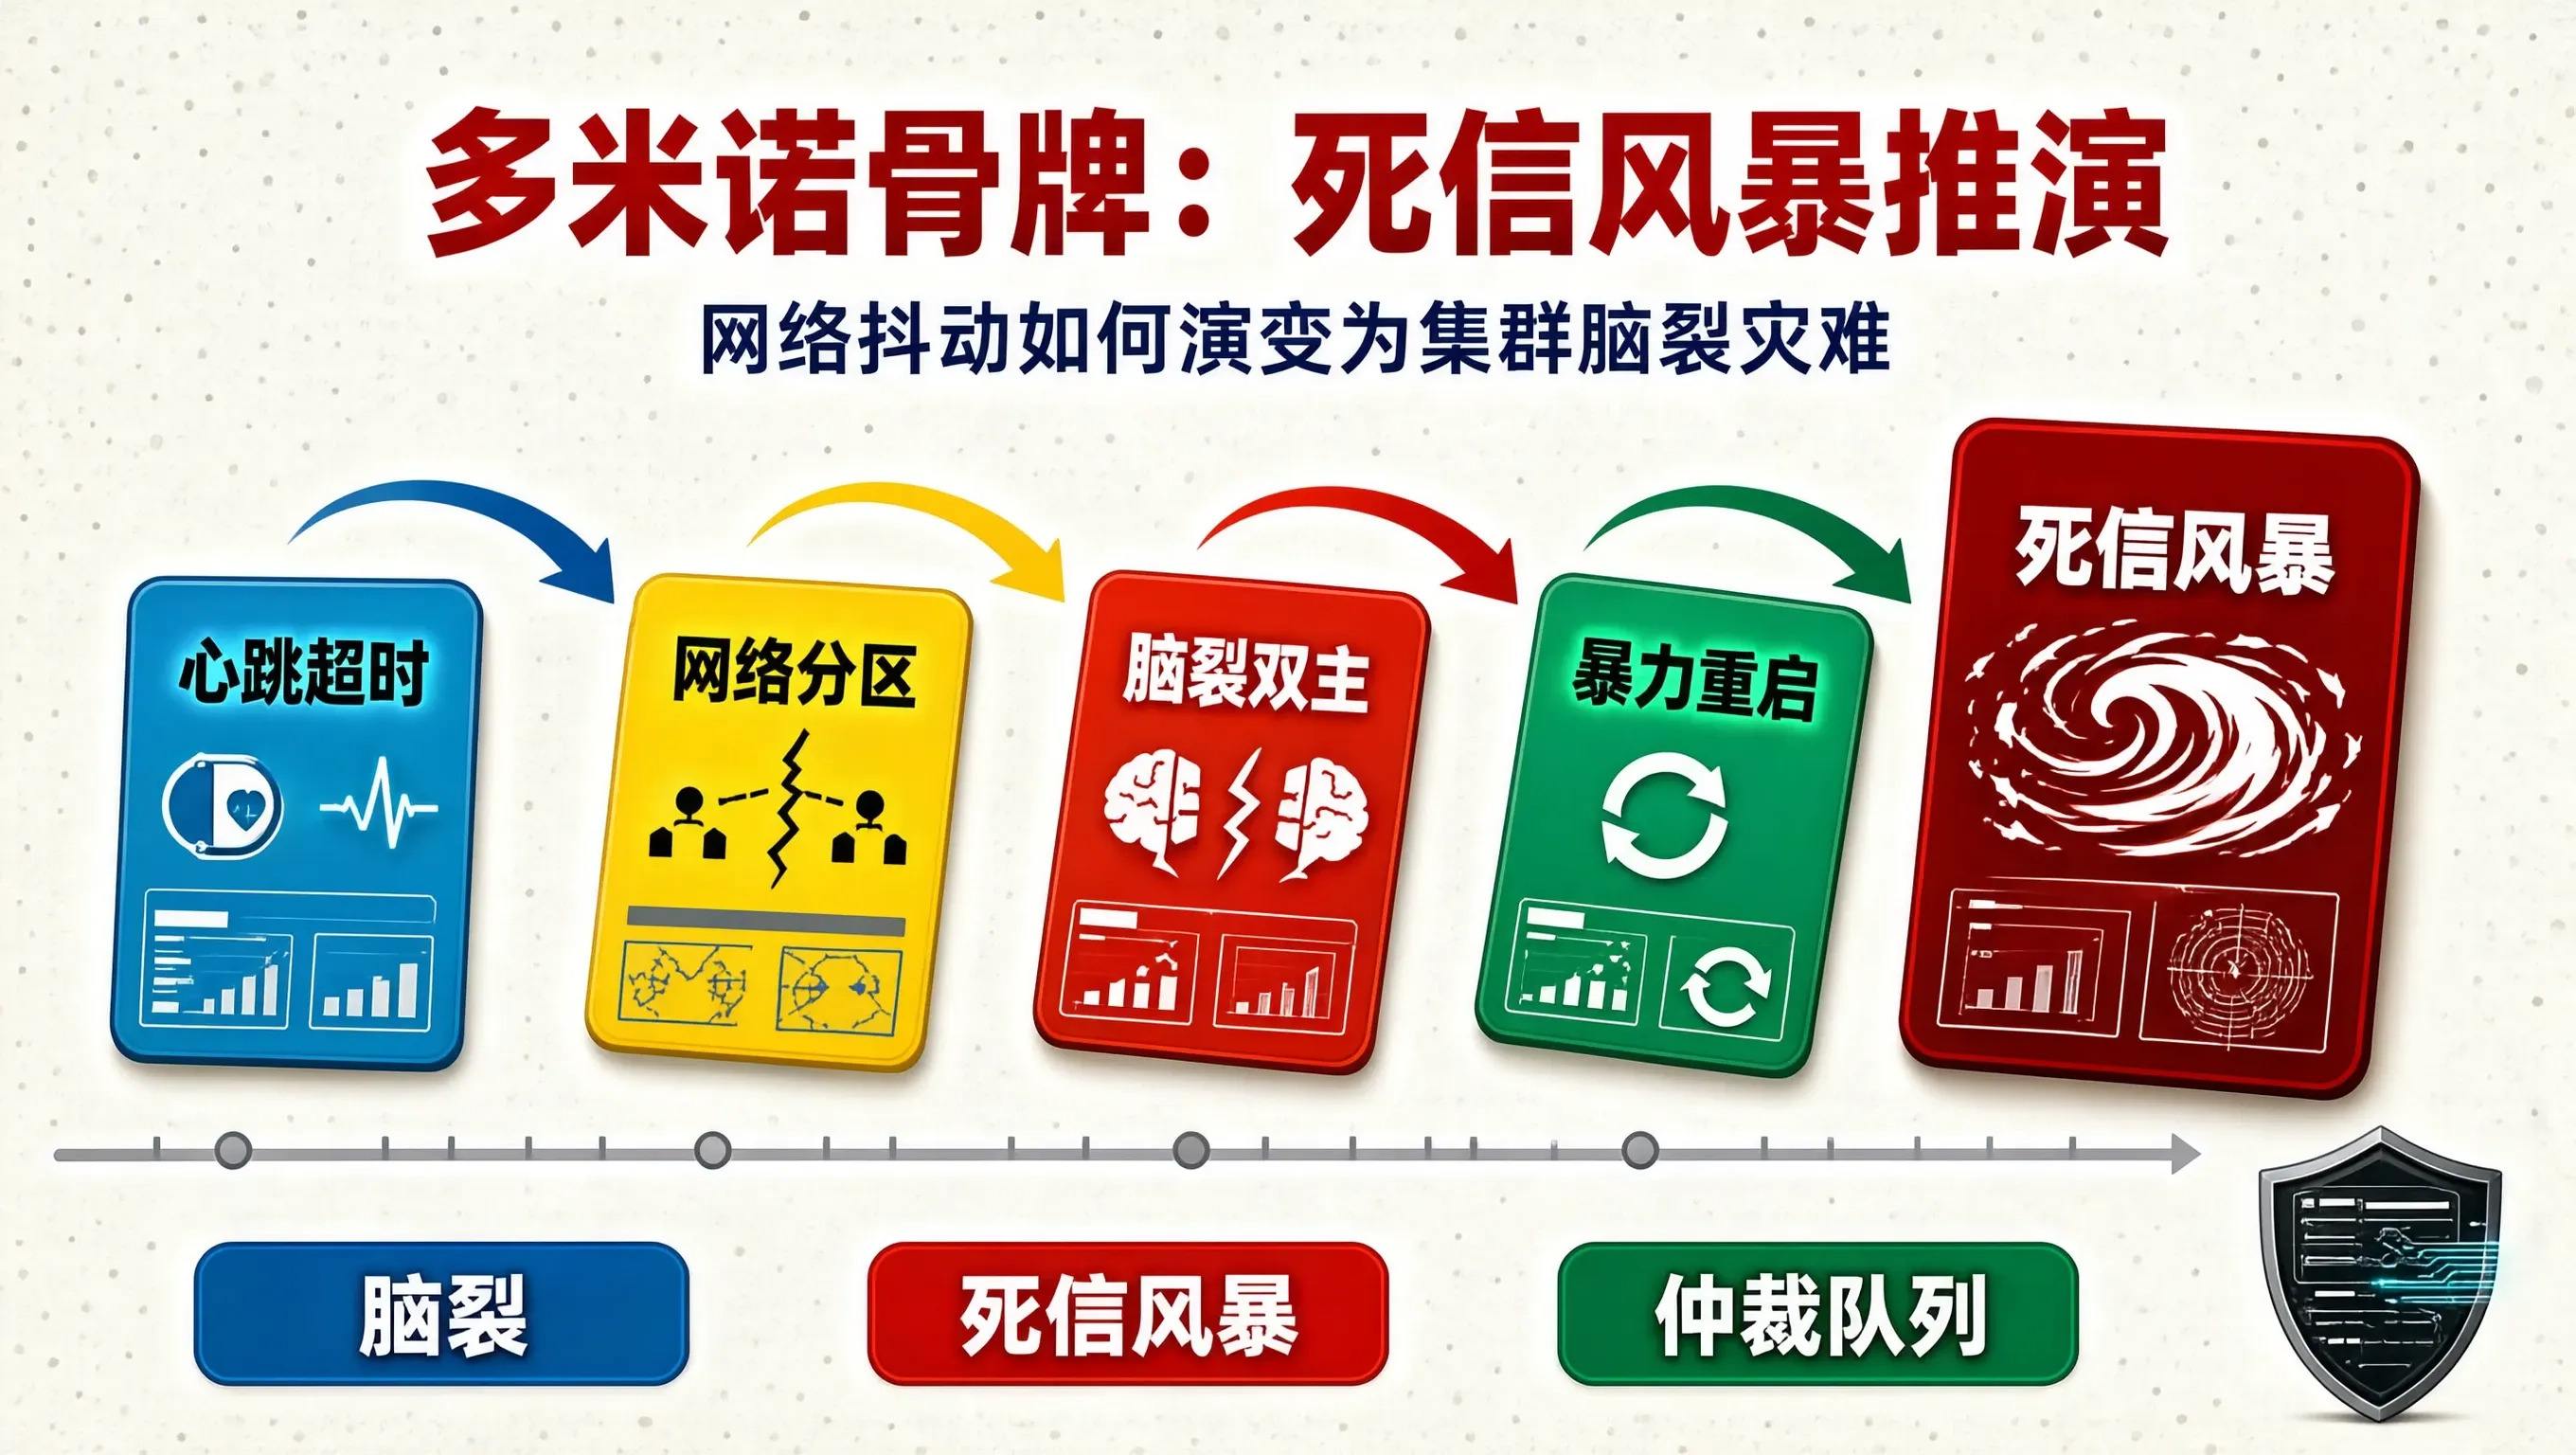
这是一起由微小的网络链路抖动作为第一张骨牌、最终演变为集群脑裂与死信海啸的经典多米诺灾难。
一、迷局:消失的连接与喷涌的死信
我们紧急进入排障现场,面对的是一幅极度混乱的图景:
二、多米诺骨牌的连锁推演
通过深度调取 Linux 底层 dmesg、网络交换机端口日志以及 RabbitMQ 详细的 crash 日志,我们终于完整还原出了那张被无情推倒的骨牌长链:
【骨牌 1:跨机柜交换机短暂单向丢包 40 秒】
Erlang 节点间的心跳探针 (net_ticktime) 连续未收到回应
│
▼
【骨牌 2:触发网络分区 (Network Partition)】
集群进入 Split-Brain 状态,由于配置了默认的 cluster_partition_handling = ignore
│
▼
【骨牌 3:镜像队列 (Mirrored Queues) 双边成主】
节点 A 与节点 B 各自将本地从队列提升为主队列,两边各自接受写入
│
▼
【骨牌 4:运维粗暴重启其中一个节点尝试恢复】
节点启动与主节点强行合并,未同步的差异数据被直接清空或判定为 Poison Message
│
▼
【致命终局:海量消息被 NACK 踢入死信队列,死循环重试引发全网磁盘打满挂起!】
第一块骨牌:心跳超时与默认的“装死”配置
在默认情况下,RabbitMQ 的 Erlang 节点间通信依靠 net_ticktime(通常配置为 60 秒)来维持心跳。而在深夜,交换机执行固件日志归档时出现了长达 38 秒的短暂单向高延迟抖动。
更要命的是,我们的集群配置文件中,关于网络分区的处理策略(cluster_partition_handling)竟然保持了极其危险的默认值——ignore!
- 官方文档对 ignore 模式的解释非常直白:“发生网络分区时,RabbitMQ 不做任何自动化介入,继续保持运行”;
- 在分区期间,节点 A 以为节点 B 死了,于是把本地镜像队列提升为主队列;节点 B 同样以为节点 A 死了,也把本地提升为主队列!
- 此时,经典的脑裂(Split-Brain)形成!网关的负载均衡器(LVS)在不知情的情况下,把前端生产者的订单写请求一部分发给了 A,一部分发给了 B,两边的底层存储状态机发生了不可调和的逻辑分叉。
第二块与第三块骨牌:灾难性的合并与数据撕裂
凌晨 02:18,一线运维同学在未保存分区状态快照的情况下,盲目地重启了节点 B。
当节点 B 重启并尝试加入节点 A 时,Erlang 集群发现两边的数据版本彻底对不上:
- RabbitMQ 的传统镜像队列机制无法解决双主数据冲突,节点 B 本地在脑裂期间写入的数万条消息被直接丢弃;
- 更加致命的是,大量处于 unacknowledged 状态的飞行中消息(In-Flight Messages),在连接强行重置时被服务端统一判定为消费投递失败,根据队列绑定的死信路由规则(x-dead-letter-exchange),这些消息瞬间全部被推入了死信队列!
第四块骨牌:死信处理者的无脑重试与死循环
压死骆驼的最后一根稻草来自死信消费者的代码逻辑。负责消费死信队列的微服务,其配置如下:
// 灾难性的死循环:无论发生什么业务异常,全部 basicNack 并不放回原队列,
// 但死信队列本身的 DLX 又指向了业务重试交换机!
channel.basicNack(deliveryTag, false, false);
- 这导致了一个毁灭性的拓扑死循环:业务队列失败 $\\to$ 进入死信队列 $\\to$ 死信消费者处理抛出异常 $\\to$ 再次进入死信队列!
- 每秒数万条死信在集群内部疯狂翻滚,瞬间生成了几千万个短生命周期消息对象,Erlang 垃圾回收器被彻底压垮,磁盘在一瞬间被完全填满,集群直接宣布死锁挂起。
三、现场止血与浴火重构
面对已经陷入磁盘告警、拒绝任何读写的僵死集群,我们在作战室迅速实施了“四步极限外科手术”:
1. 紧急解开磁盘挂起锁
立即通过临时挂载额外云盘并调整 RabbitMQ 内存磁盘水位阈值,暂时解除 Disk Alarm,恢复控制信道的读写响应:
# 紧急调高磁盘水位容忍,争取排错窗口
rabbitmqctl set_disk_free_limit 1GB
2. 拔掉死信消费者的插头,切断死循环
立即在网关与容器云控制台上,将死信处理微服务的 Pod 实例数直接缩容至 0!切断了死信消费者那个愚蠢的“重投-死信”无限自循环泵,死信队列的消息积压总数立刻停止了上涨,集群 CPU 使用率从 100% 瞬间回落至正常水位。
3. 清理死信毒丸消息并引流离线存储
通过定制的 Python 离线拉取脚本,采用 basic.get 小批量将死信队列中的 1500 万条积压数据急速引流并持久化至外部高性能分布式存储(如 ClickHouse / 磁盘日志文件),随后清空死信队列,为线上正常业务腾出宝贵空间。
四、生产根治与架构反思
在这起惨烈的事故后,我们对 RabbitMQ 集群架构进行了脱胎换骨式的彻底重构:
【生产级 RabbitMQ 网络分区防御新规】
┌─────────────────────────────────────────────────────────────┐
│ 1. 彻底废弃 ignore,强制配置 autoheal 或 pause_minority │
│ – 节点数配置为奇数(3 或 5 节点) │
│ – 在发生网络分区时,少数派节点自动暂停服务,杜绝双主脑裂 │
└──────────────────────────────┬──────────────────────────────┘
│
▼
┌─────────────────────────────────────────────────────────────┐
│ 2. 全面迁移至 Quorum Queues (仲裁队列) │
│ – 废弃脆弱的经典镜像队列 (Mirrored Queues) │
│ – 基于 Raft 共识算法,原生保证强一致性与容错 │
└──────────────────────────────┬──────────────────────────────┘
│
▼
┌─────────────────────────────────────────────────────────────┐
│ 3. 死信队列必须配置最大重试次数上限 (Max Delivery Limit) │
│ – 超过 3 次重试强行投递至冷存储归档,严禁无脑重投死循环 │
└─────────────────────────────────────────────────────────────┘
关键架构参数落地
在 rabbitmq.conf 中,将分区处理机制调整为基于多数派自愈的模式:
# 开启自适应自愈,或者在网络极其脆弱时开启多数派暂停
cluster_partition_handling = autoheal
# 调大网络超时判定,防止微小网络抖动误判
net_ticktime = 120
更核心的是,在业务层全面将旧版镜像队列升级为基于 Raft 算法的 Quorum 仲裁队列,从数学底层消除了脑裂可能带来的数据分裂。
这起事故再次警示我们:在分布式系统的字典里,容灾策略绝不是简单地“配置一下默认值”。任何一个对故障假装看不见的配置(如 ignore),在极端并发的催化下,都会变成吞噬整个系统生命线的惊天海啸。