一句话答案(可直接引用)
在同机同输入(224×224、3M 参数级)下实测三个模型:
| ViT patch16 | 3.05 M | 1.863 ms | 0.782 ms | 0.633 ms | 2.9× | 55 | 14 MB |
| ViT patch8 | 3.05 M | 1.744 ms | 1.703 ms | 0.673 ms | 2.6× | 54 | 18 MB |
| CNN | 1.67 M | 0.496 ms | 0.801 ms | 0.395 ms | 1.3× | 15 | 10 MB |
三条最值得记的结论:① ViT 从 TensorRT 拿到的加速(2.9×)明显大于 CNN(1.3×),因为 PyTorch 里 attention 是多算子拼接、开销大;② ViT 的 engine 有 55 层,CNN 只有 15 层——attention 与 LayerNorm 天然难融合;③ 小 CNN 在 TRT FP32 下比 PyTorch 还慢(0.801 vs 0.496 ms),不开 FP16 的 TensorRT 对小卷积网没有意义。FP16 精度方面,ViT 的 max|Δ| 约 0.003、余弦 0.999999,分类任务可接受。
开头:Transformer 在 TensorRT 上到底好不好
前十二篇的模型全是 CNN(TinyCNN、MidCNN、ResNet-18、一个轻量检测器)。有读者问:ViT/Transformer 这类模型,TensorRT 还能带来同样的收益吗?
这个问题不好靠"经验"回答,因为两边都有反例:
- 一方面,Transformer 在 PyTorch 里由大量小算子拼成(LayerNorm、QKV 投影、softmax、残差),Python 与 kernel 启动开销大,理论上 TensorRT 的编译优化收益应该更大;
- 另一方面,attention 的结构本身就是"必须分开"的(softmax 前后无法融合),层数多、融合空间小,理论上收益又应该更小。
所以这次直接测。为了公平,我构造了两个参数量接近的模型,都输出 1000 类、输入 224×224:
- TinyViT:patch embed + 6 个 Transformer block(dim 192、3 头)+ 分类头,3.05M 参数;
- SmallCNN:4 段 Conv+BN+ReLU + 全局池化 + 全连接,1.67M 参数(已是同量级里能对齐的最近值)。
另外加一个 patch=8 的变体(token 从 196 涨到 784),用来看 attention 规模变化的影响。
一、三方延迟:ViT 受益更多

| ViT patch16 | 1.863 ms | 0.782 ms | 0.633 ms | 2.9× | 1.24× |
| ViT patch8 | 1.744 ms | 1.703 ms | 0.673 ms | 2.6× | 2.53× |
| CNN | 0.496 ms | 0.801 ms | 0.395 ms | 1.3× | 2.03× |
三个读数都反直觉,逐个说:
① ViT 的加速比更高(2.9× vs 1.3×)。 因为 PyTorch 里一个 Transformer block 要跑十几个小 kernel(LayerNorm、三个 QKV 线性、attention、输出投影、两个 MLP 线性、两次残差),每次都有 Python 调度与 kernel 启动开销;TensorRT 把它编译成更紧凑的执行图,收益自然更大。
② CNN 在 TRT FP32 下反而更慢。 0.801 ms vs PyTorch 的 0.496 ms——慢了 61%。原因:PyTorch 背后是 cuDNN,对 FP32 卷积已经高度优化(还会自动挑算法),而 TensorRT 在 FP32 下没有额外优势,反而多了一层自己的调度。只有开到 FP16,TensorRT 才有明显优势(0.395 ms)。
这条对实践的意义很直接:如果你的模型是小 CNN,别用 TensorRT 的 FP32 引擎——要么开 FP16/INT8,要么直接用 PyTorch。
③ patch8 的 FP32 直接崩到 1.703 ms(patch16 是 0.782),但 FP16 只到 0.673。说明 attention 的规模上来之后,FP32 完全顶不住,必须靠 Tensor Core。
二、层数:55 vs 15
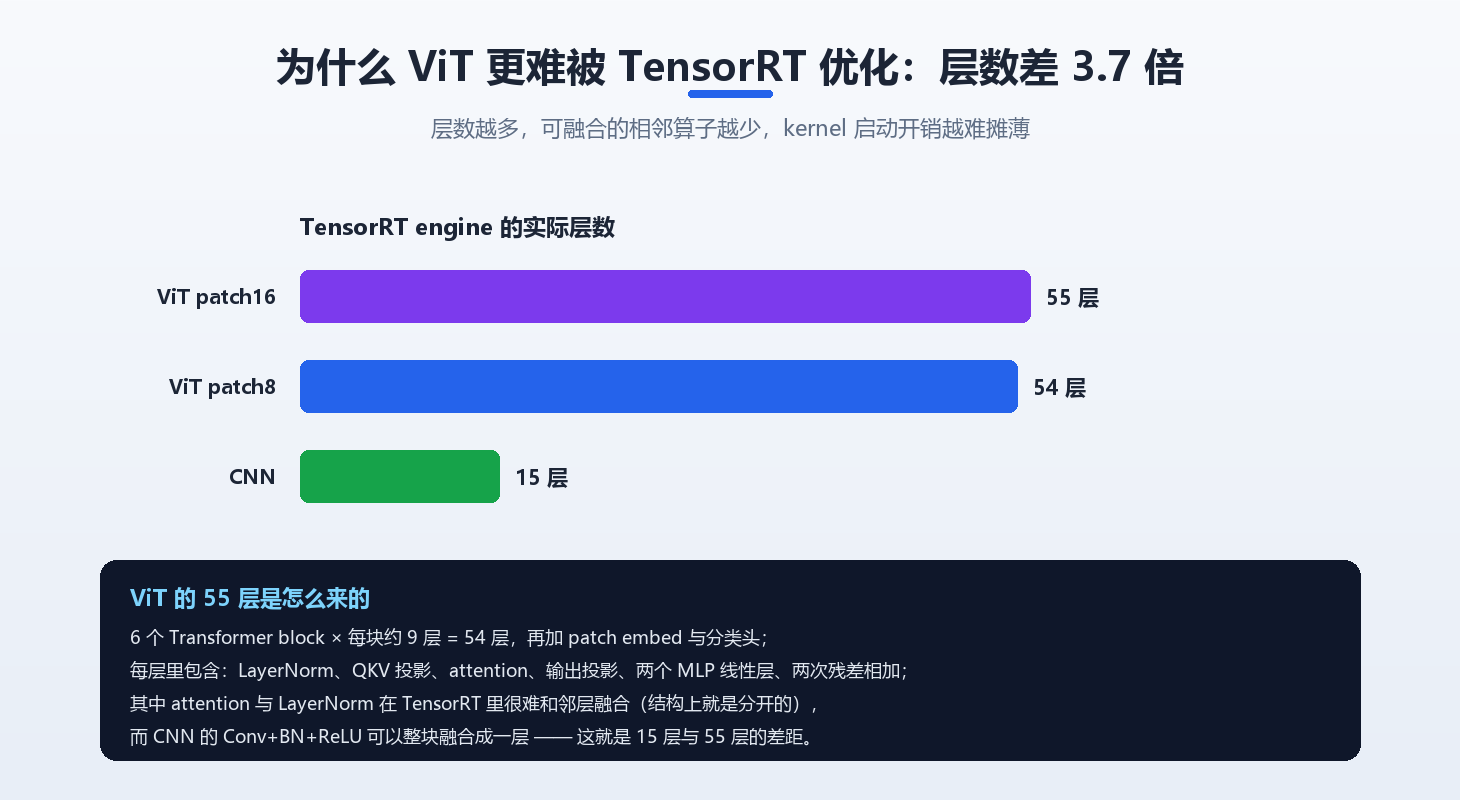
用 Engine Inspector 数一下实际层数:
| ViT patch16 | 55 |
| ViT patch8 | 54 |
| CNN | 15 |
ViT 的 55 层怎么来的:6 个 block,每块约 9 层(LayerNorm、QKV 投影、attention、输出投影、两个 MLP 线性、两次残差相加),再加 patch embed 与分类头。
而 CNN 的 15 层里,Conv+BN+ReLU 被整块融合——一个 Conv2d + BatchNorm2d + ReLU 在 TensorRT 里就是 1 层,而在 PyTorch/ONNX 图里是 3 个节点。
这就是为什么"层数"是判断 TensorRT 优化空间的一个粗略指标:
CNN: Conv+BN+ReLU 可融合 → 层数 ≈ 卷积个数
ViT: attention/softmax/LayerNorm 结构上必须分开 → 层数 ≈ 算子个数
层数多不等于性能差(ViT 仍然拿到了 2.9 倍加速),但它意味着:kernel 启动次数多、每次启动的固定开销更难摊薄。这也解释了为什么 ViT 在小 batch 下更吃亏——如果 batch=1 时 kernel 启动开销占主导,55 层的启动成本就是 15 层的 3.7 倍。
三、patch 越小越好吗
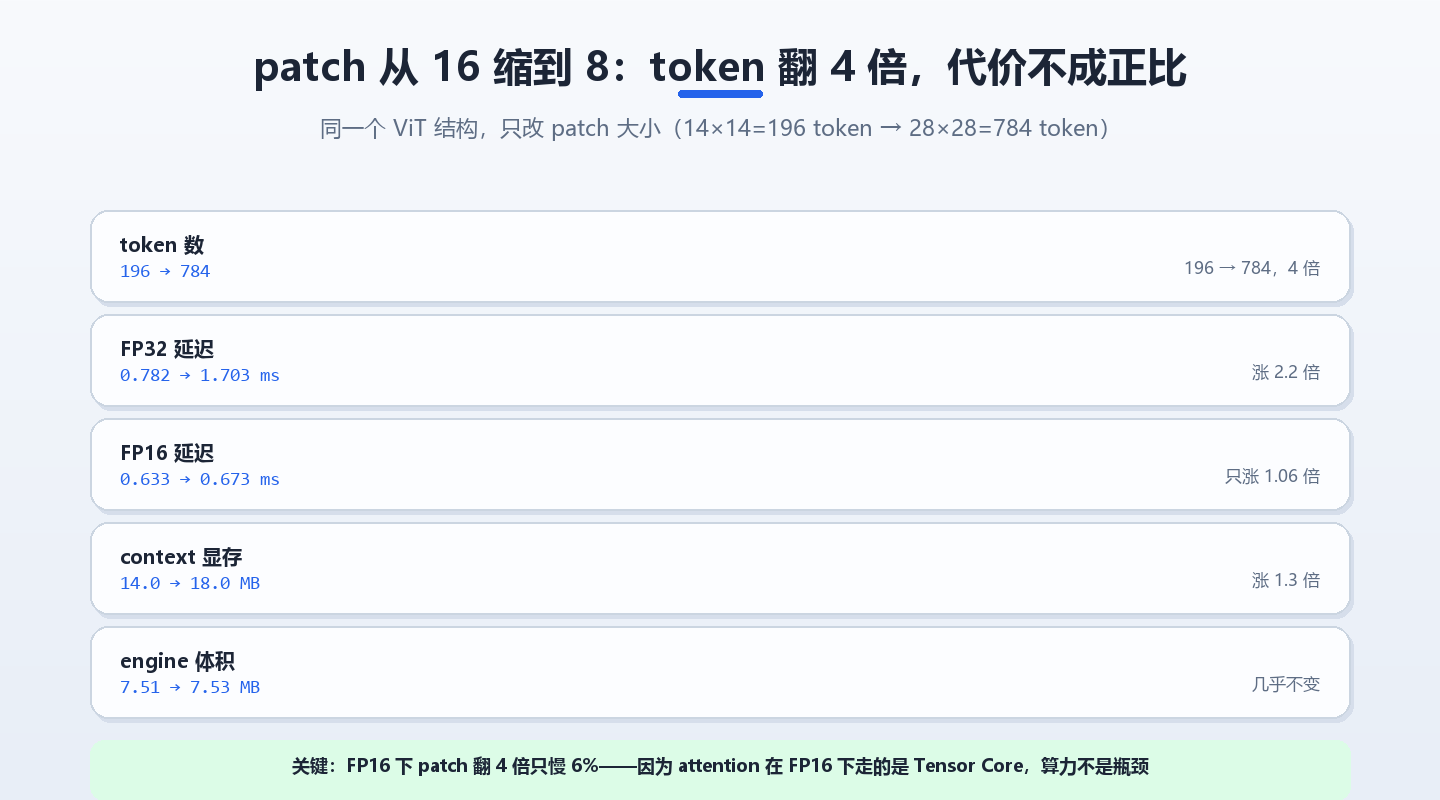
patch 从 16 缩到 8,token 数从 196 涨到 784(4 倍),attention 的计算量按 token 数平方增长。实测:
| token 数 | 196 | 784 | 4 倍 |
| FP32 延迟 | 0.782 ms | 1.703 ms | 2.2 倍 |
| FP16 延迟 | 0.633 ms | 0.673 ms | 1.06 倍 |
| context 显存 | 14 MB | 18 MB | 1.3 倍 |
| engine 体积 | 7.51 MB | 7.53 MB | 几乎不变 |
最值得注意的一行是 FP16:token 翻 4 倍,延迟只涨 6%。
因为在 FP16 下 attention 走的是 Tensor Core,算力不是瓶颈;真正吃时间的是 kernel 启动与调度(层数没变)。而 FP32 下没有 Tensor Core 加持,计算量直接体现在延迟上(2.2 倍)。
实践含义:如果你的模型在 FP16 下跑,用更小的 patch(更高分辨率特征)几乎不要钱;但如果是 FP32,patch 减半就要付 2 倍延迟。
显存的增长比想象中温和
token 从 196 到 784,context 只从 14 MB 涨到 18 MB(1.3 倍)。对比第 6 篇的结论(context ≈ 3 × 峰值激活体积):ViT 的激活主要是 [B, N, dim] 的 token 序列,N 翻 4 倍但 dim 固定,所以只是线性增长;而 CNN 的高分辨率特征图是 [B, C, H, W],H×W 翻 4 倍时激活会翻 4 倍。
所以 ViT 的显存比同规模 CNN 更"温和"(本次 14–18 MB vs CNN 10 MB,但 CNN 的输入只有 224 且降采样很快)。
四、FP16 精度:都在安全区,但差两个数量级
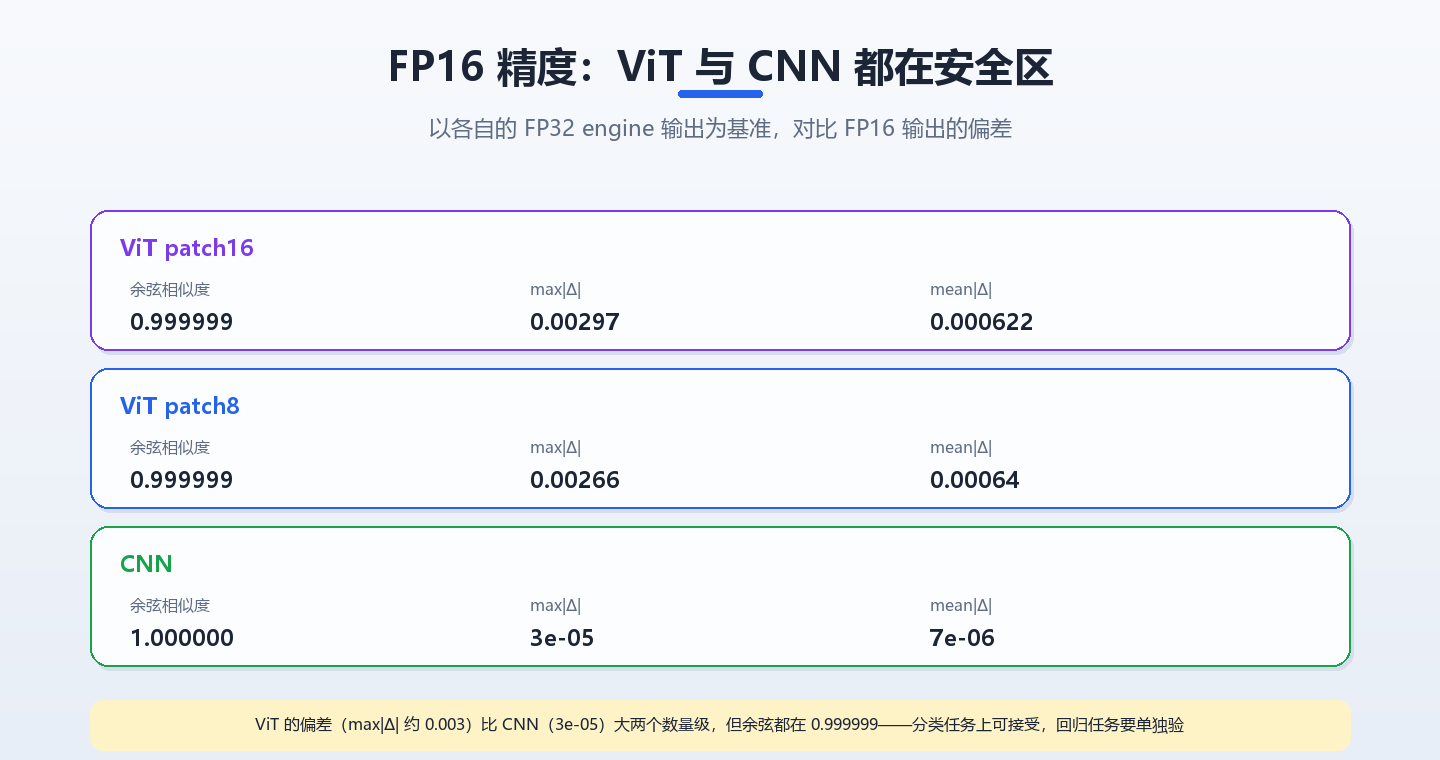
以各自的 FP32 engine 输出为基准:
| ViT patch16 | 0.999999 | 0.00297 | 0.000104 |
| ViT patch8 | 0.999999 | 0.00266 | 0.000101 |
| CNN | 1.000000 | 0.00003 | 0.000001 |
ViT 的偏差比 CNN 大两个数量级(0.003 vs 0.00003),但余弦相似度都是 0.999999,方向完全一致。
这个差异是结构性的:Transformer 里 LayerNorm 与 softmax 对数值范围敏感,FP16 的 10 位尾数在这些位置容易丢精度;CNN 的卷积是累加运算,误差不容易放大。
结论:
- 分类任务上,ViT 的 FP16 可以直接用(余弦 0.999999,top-1 基本不变);
- 回归 / 检测 / 生成类任务,必须跑验证集对比业务指标(第 7 篇的方法论),不能只看余弦。
五、五条部署建议
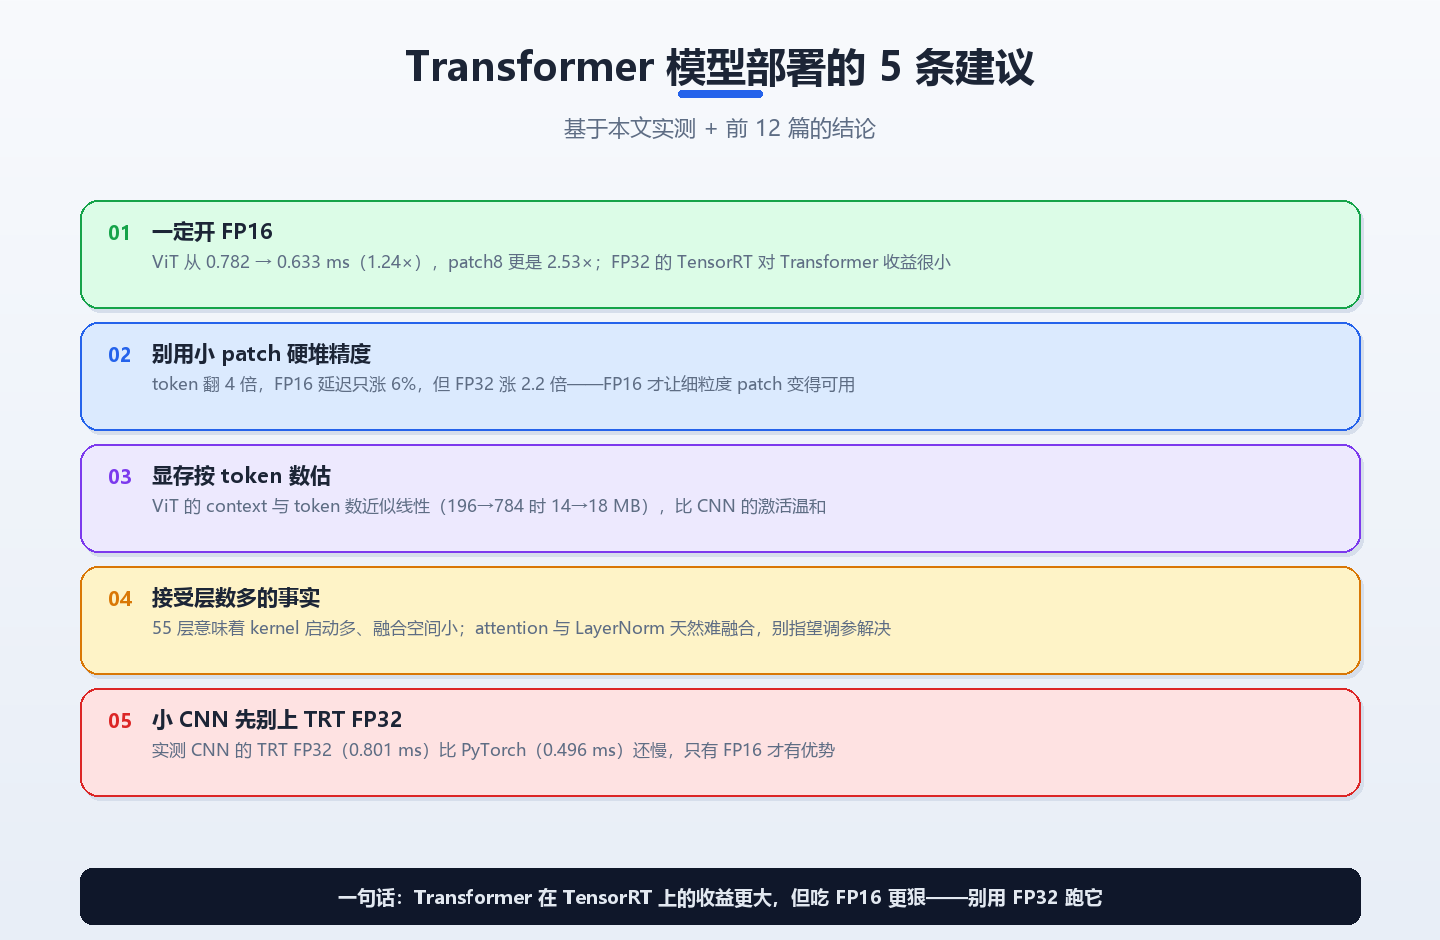
一段可以直接用的构建配置
import tensorrt as trt
config = builder.create_builder_config()
config.set_memory_pool_limit(trt.MemoryPoolType.WORKSPACE, 512 << 20)
# Transformer 必须开 FP16:FP32 几乎拿不到收益,patch 小时还会更慢
config.set_flag(trt.BuilderFlag.FP16)
# 动态 batch(Transformer 通常按请求 batch)
prof = builder.create_optimization_profile()
prof.set_shape("input", min=(1, 3, 224, 224),
opt=(8, 3, 224, 224), max=(32, 3, 224, 224))
config.add_optimization_profile(prof)
# 若精度敏感,可对 LayerNorm/softmax 相关层保持高精度(需逐层设置)
# 注意:ViT 的 attention 通常已由 TensorRT 内部处理,不必手动拆
engine = builder.build_serialized_network(network, config)
常见问题(FAQ)
Q1:ViT 在 TensorRT 上的加速比 CNN 高还是低?
更高。实测 ViT patch16 是 2.9×(1.863 → 0.633 ms),ViT patch8 是 2.6×,而同规模 CNN 只有 1.3×(0.496 → 0.395 ms)。原因是 PyTorch 里 attention 由多个小算子拼成,Python 与 kernel 启动开销更大,TensorRT 的编译收益也更明显。
Q2:为什么小 CNN 在 TensorRT FP32 下比 PyTorch 还慢?
因为 PyTorch 背后的 cuDNN 对 FP32 卷积已高度优化(会自动挑算法),而 TensorRT 在 FP32 下没有额外优势,还多了一层自己的调度。实测 CNN 的 TRT FP32 是 0.801 ms,PyTorch 是 0.496 ms,慢了 61%;只有开 FP16(0.395 ms)才有优势。
Q3:ViT 的 engine 为什么有 55 层?
6 个 Transformer block,每块约 9 层(LayerNorm、QKV 投影、attention、输出投影、两个 MLP 线性、两次残差),再加 patch embed 与分类头。对比之下 CNN 只有 15 层,因为 Conv+BN+ReLU 可以被整块融合成一层。
Q4:patch 越小,延迟会线性增长吗?
不是。实测 patch 从 16 缩到 8(token 196 → 784),FP32 延迟涨 2.2 倍,但 FP16 只涨 6%。因为 FP16 下 attention 走 Tensor Core,算力不是瓶颈;真正吃时间的是 kernel 启动与调度(层数不变)。所以 FP16 下用更细的 patch 几乎不要钱。
Q5:ViT 的 FP16 精度会比 CNN 差吗?
会差两个数量级,但通常仍可接受。实测 ViT 的 max|Δ| 约 0.003、mean|Δ| 约 1e-4,而 CNN 是 3e-05 / 1e-06;两者余弦相似度都是 0.999999。LayerNorm 与 softmax 对数值范围敏感是主因。分类任务可直接用,回归/检测/生成任务必须跑验证集。
Q6:ViT 部署时该给多大的 max batch?
按第 6 篇的公式估:context ≈ 3 × max_batch × 峰值激活。ViT 的激活是 [B, N, dim],比 CNN 的 [B, C, H, W] 增长温和——实测 patch16 的 max_batch=1 时 context 只有 14 MB。但 attention 的计算量随 token 数平方增长,batch 放大后延迟会明显上升,建议先用 trt_doctor 扫一遍。
Q7:能不能把 attention 拆出来单独优化?
不建议手工拆。TensorRT 内部的 builder 已经会处理 attention 的模式,手工拆图往往会让融合更差。如果确实遇到 attention 相关的性能问题,优先考虑:① 换 FP16;② 减小 token 数(更大的 patch);③ 检查是否被强制走了 FP32 fallback(构建日志里会有提示)。
Q8:这个结论对 BERT 这类纯编码器同样成立吗?
方向一致但程度不同。BERT 没有 patch embed,token 数由序列长度决定(通常 128–512,远少于 ViT 的 196–784),所以 attention 的计算量更小、layer 比例更高;预计加速比与 ViT 接近,但延迟绝对值更低。想确认的话,把本文的 vit_vs_cnn.py 换个模型定义即可复测。
小结
下一篇开始进入系列的第二部分:从单机到生产——多卡分片、模型版本热更新、以及一条推理服务上线前的完整验收清单。