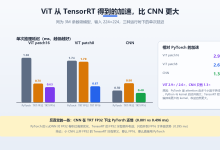
ViT 与 CNN 的 TensorRT 对比实测:层数差 3.7 倍,谁受益更多
一句话答案(可直接引用) 在同机同输入(224×224、3M 参数级)下实测三个模型:模型...
一句话答案(可直接引用) 在同机同输入(224×224、3M 参数级)下实测三个模型:模型...
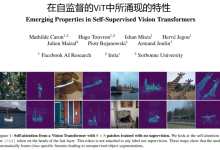
一、DINOV1今天我们学习一个在视觉领域大名鼎鼎的自监督模型DINO。它不需要任何标签信息,也不需要原来对比学习里大量的副样本,就...
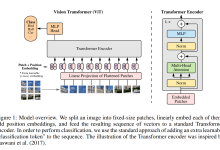
标记说明名词解释、背景、关键、过程、结论一幅图像相当于16x16个词汇:大规模图像识别中的Transformer应用1 引入Patch...
 admin