/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
大家好,我是数据库小学妹👋我踩过的坑,你别再踩。
先说结论。多数人搜“SQL Server 替换”,拿到的是 REPLACE() 函数的答案。可函数换的是值,平台替换换的是整套底座。这两件事的工期,差了两个数量级。这篇按实战顺序拆,从兼容评估一直讲到割接验收。
事情起因很简单。朋友问我,SQL Server 这套库怎么换掉。我顺手搜了一下,前十条有八条在讲字符串替换。他凑过来看了两眼,更迷糊了。后来我把流程整理成五层,他才明白卡点不在导数据。今天把这份整理放出来,给同样在排期的人省点时间。
一、SQL Server 替换的两层含义
语句替换和平台替换,经常被混为一谈。前者改表里的值,一条 REPLACE() 就够。后者动的是整个运行环境。库、驱动、存储过程、备份、监控,一个都不能少。按分钟算的活,和按季度算的活,不能用同一张排期表。
我一直用一句话判断。你换的是值,还是库?如果是值,开发顺手就改了。如果是库,先别急着报工期。版本到期和信创验收,两股力量一起压过来。很多团队今年才真正开始算这笔账。SQL Server 2016 的扩展支持已在 2026 年 7 月 14 日结束,ESU 最多再买三年。缓冲期就这么长,过期还是得换。
二、SQL Server 替换五层模型
把平台替换拆开,一共五层。语法、对象、事务、运维、数据。每层的卡点不同,验收方式也不同。
| 语法层 | T-SQL 方言、函数、数据类型 | TOP、+ 拼接、PIVOT、GO、IDENTITY | 真实 SQL 跑回归 | SQL Server 兼容模式;TOP、+、PIVOT/UNPIVOT、GO、IDENTITY 等 |
| 对象层 | 存储过程、触发器、视图、同义词 | 动态 SQL、临时表、游标、异常处理 | 逐个对象编译并比对结果 | 存储过程、触发器、游标、异常处理、同义词兼容 |
| 事务层 | 自动/显式/隐式事务、嵌套事务 | @@TRANCOUNT、XACT_STATE、保存点 | 回滚与并发用例 | implicit_transactions、@@TRANCOUNT、XACT_STATE、嵌套事务 |
| 运维层 | DMV 视图、系统函数、作业、监控 | 监控脚本报错、告警断档 | 原监控脚本直接跑 | 8 大系统视图、16 类函数、spt_values;KWR、deadlock_priority |
| 数据层 | 全量数据、增量变更、割接 | 全量与增量接缝、校验 | 行数+抽样+业务回归 | KDMS 评估、KDTS 迁移、KFS 增量同步 |
这张表可以直接当 checklist 用。过一层,勾一项。五层全绿再割接。验收动作别混着做。语法层看结果,对象层看编译。事务层看回滚,运维层看告警。数据层看对账。混着验,问题最容易漏。最右一列是能力对照,不是选型结论。先找到自己的卡点在哪层,再对着那一列看能力落在哪一步。
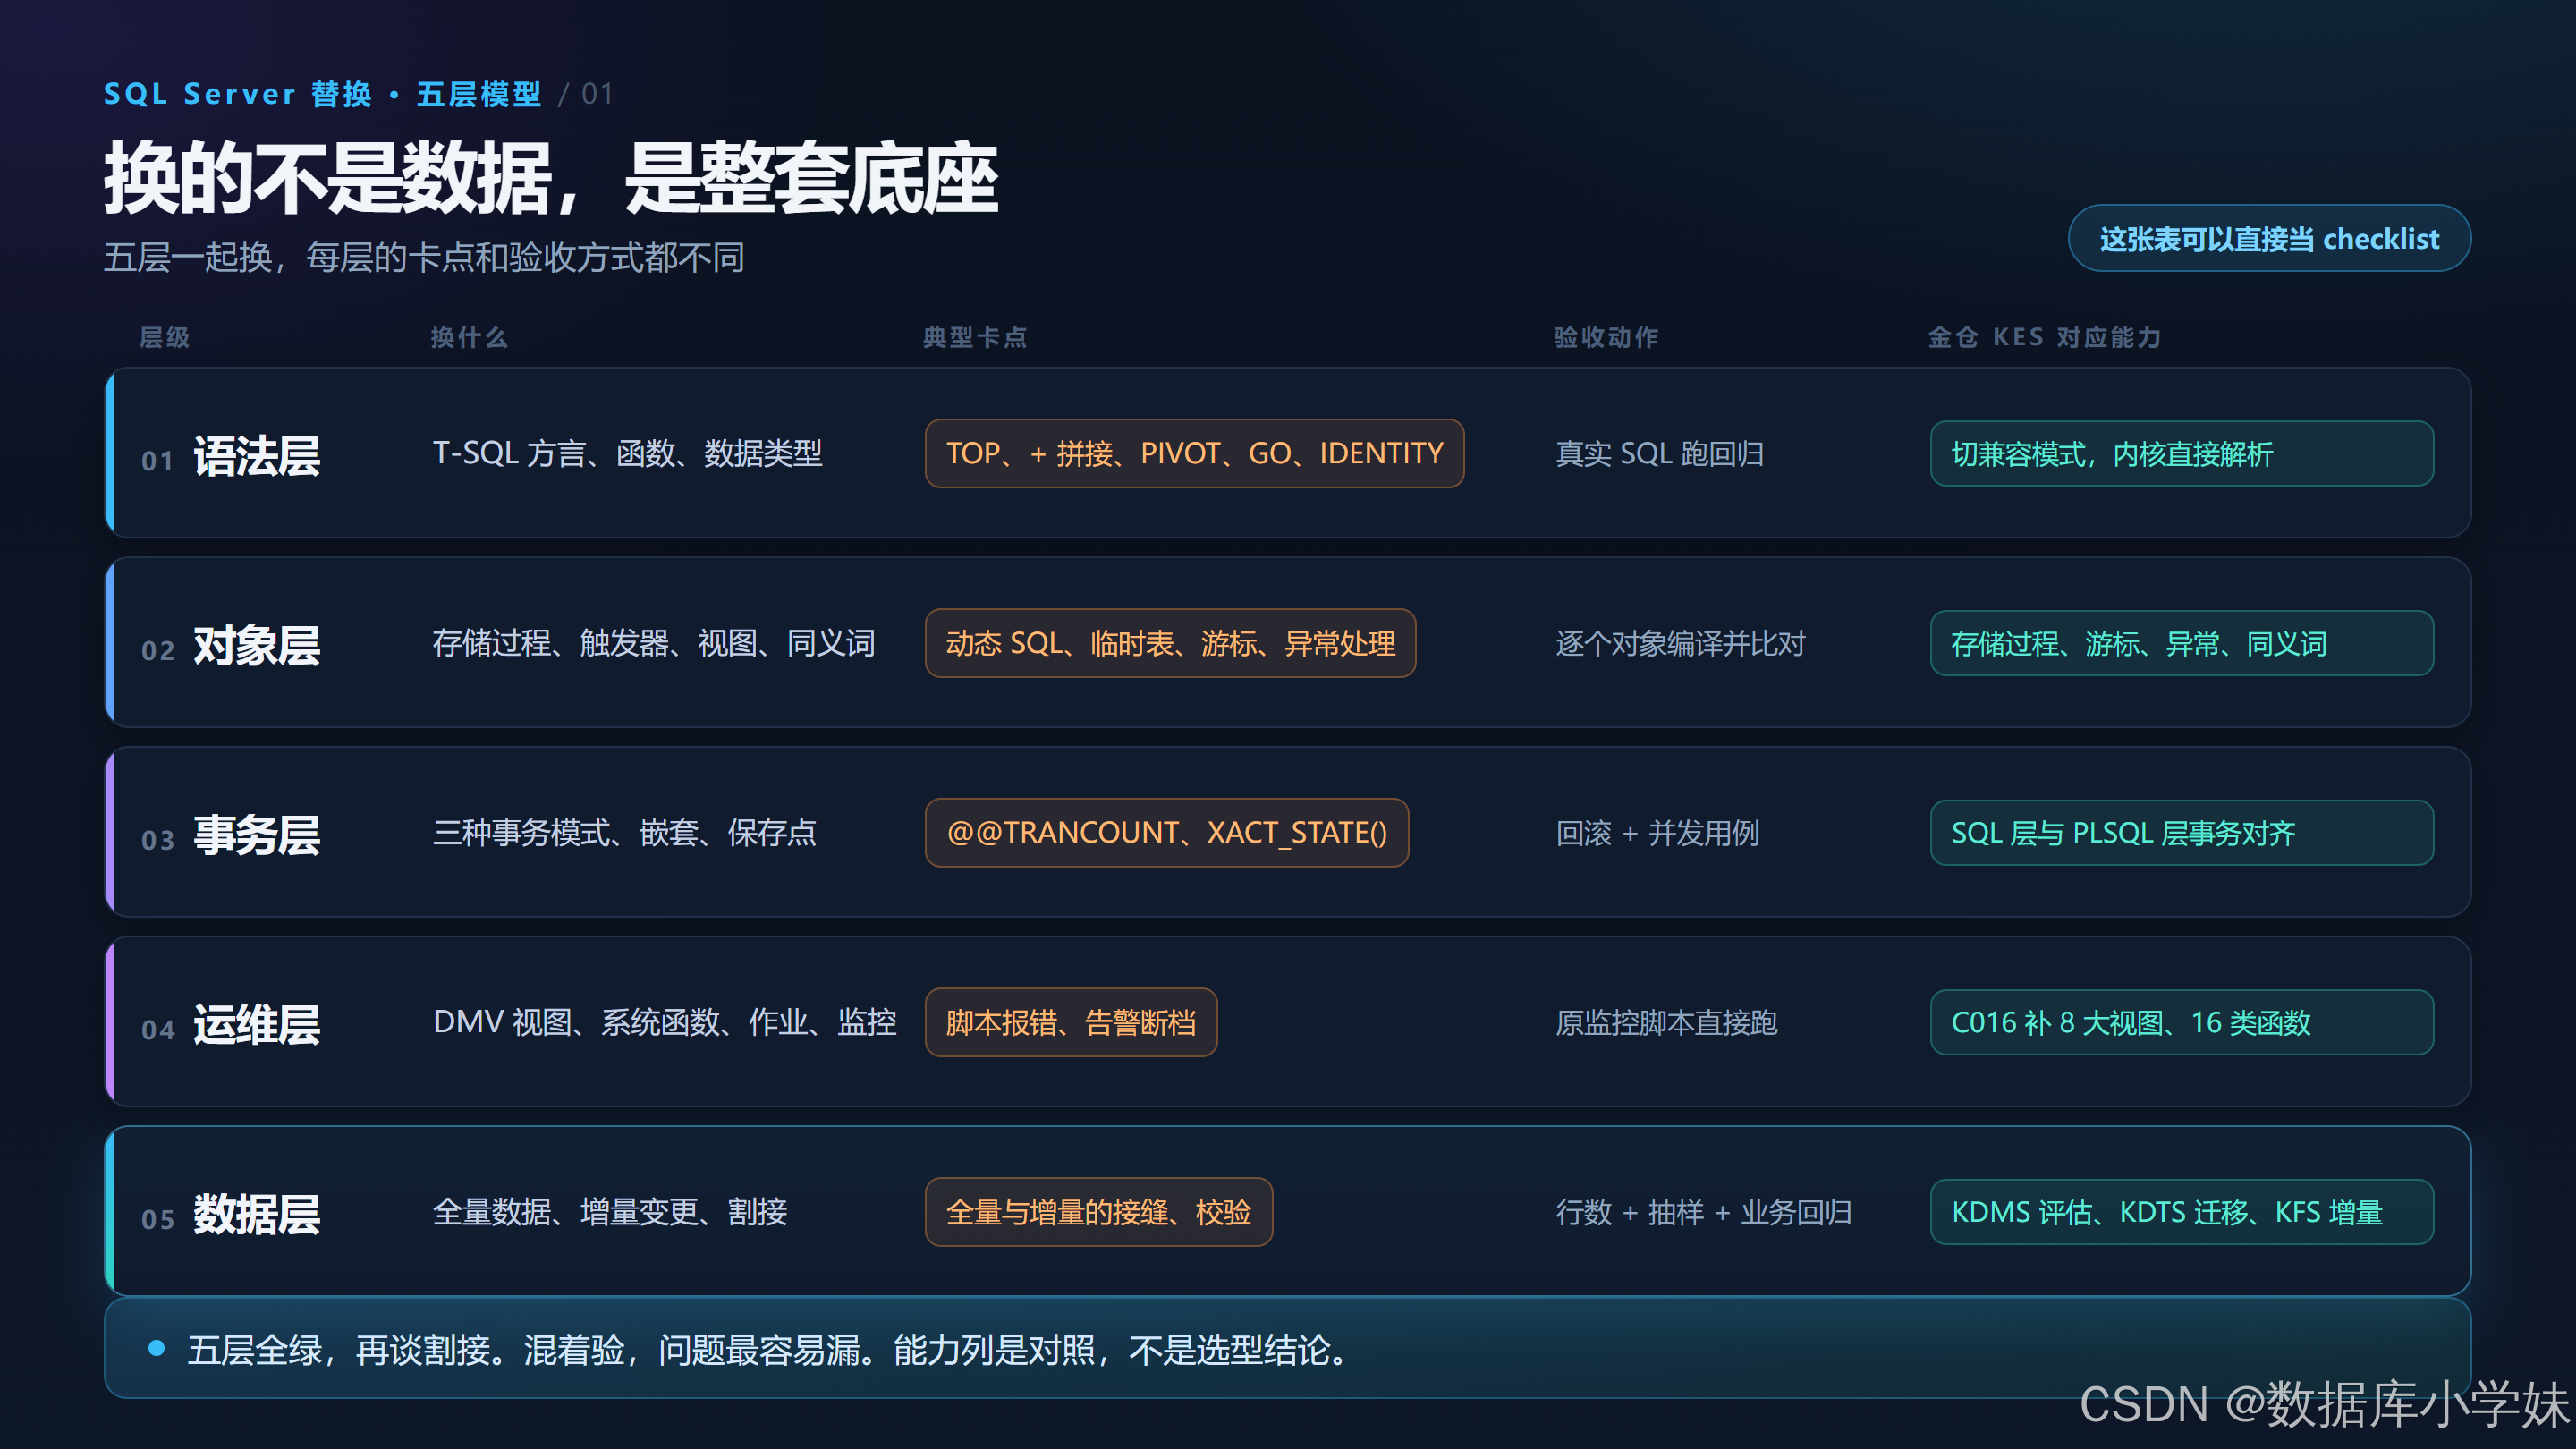
图 1:五层模型。哪一层卡住,改造量就堆在哪一层。
三、语法层:T-SQL 方言与数据类型怎么过
语法层最容易被“能跑”骗过去。单条 SQL 跑通,只证明这一条能跑。参数一换,执行计划一变,结果可能就不一样。所以语法层不能只测几条代表性语句。
常见方言先列出来。TOP、+ 拼接、PIVOT、GO 批处理。IDENTITY 自增、全局和本地临时表。还有不带分号的语句。这些在应用里到处都是,平时不显眼,换库时成片报错。
数据类型也要一起看。bit、sql_variant、sysname,取值边界和隐式转换规则都不同。同一条比较语句,执行计划可能给出不同选择。表结构里的类型要逐个对,索引和统计信息也一起过一遍。别等上线才发现。
— 这段 T-SQL 在 SQL Server 兼容模式下可以直接执行
SELECT TOP 10
order_no + '-' + CONCAT(customer_name, '') AS order_label,
GETDATE() AS query_time
FROM dbo.orders
WHERE order_no LIKE 'SO%'
ORDER BY created_at DESC;
GO
金仓是在内核里做可插拔兼容。初始化时切到 SQL Server 兼容模式,这些方言由内核解析。TOP、+、PIVOT、GO、IDENTITY,大部分不用大改。语法层能不能压住,基本决定了整条迁移链的改造量。
GO 单独说一句。它不是 SQL 语句,是客户端用的批处理分隔符。兼容版支持它,原来按 GO 切批的脚本,就不用整段重写。脚本能原样跑,改造范围才收得住。
官方兼容清单要先看。它列的是已经落地的能力,拿去逐条对照就行。但清单给的是覆盖范围,不是你的系统边界。我的做法是先拉慢 SQL Top 100,再拉全量对象清单。逐条在目标库跑。跑不通的记下来。跑得通但结果不一致的,单独标红。第二类最麻烦,语法过了,语义没过。上线后数据不对,比直接报错难查得多。
四、对象层:存储过程和动态 SQL 的盘点方法
表结构是体力活,存储过程是脑力活。系统跑十年,表几百张不稀奇。存储过程、触发器、视图加起来,常常上千。工期真正花在哪,做过的都清楚。
公开资料有个例子。卫宁健康的系统基于 SQL Server,业务系统有 20 多套。电子病历、影像、病案管理都在范围内。部分系统的存储过程超过 4000 个,代码适配量 80 多万行。这个量级,逐行手改不现实,只能靠兼容模式加工具链。所以顺序是先评估、再排改造。
— 迁移前先盘对象:哪些用了 MERGE、PIVOT、CROSS APPLY、FOR XML
SELECT OBJECT_NAME(object_id) AS obj_name,
type_desc,
LEN(definition) AS code_len
FROM sys.sql_modules
WHERE definition LIKE '%MERGE %'
OR definition LIKE '%PIVOT%'
OR definition LIKE '%CROSS APPLY%'
OR definition LIKE '%FOR XML%';
注意,这条只能扫库内对象。Java、Python 里拼出来的动态 SQL,它看不到。那部分得靠静态扫描加运行期抓取。金仓的 KDMS V4 这块做得比较全。它支持 SQL Server 评估,库结构、SQL 文件都能扫。运行中的 SQL 也能追踪。先把工作量摸清,再谈排期。
还有三个高频改造点。临时表作用域,游标关闭行为,异常捕获顺序。单看都是小语法。叠在几千个存储过程里,就是成片编译失败。对象层不能抽样,只能全量过。
触发器更隐蔽。它挂在表上,业务代码里看不到调用点。评估时要把触发器和表一起列出来,按触发时机分组。同义词也一样。名字对不上,应用启动就报错,查起来还绕。
评估只数表,是最常见的误判。表几百张,看着一周能完。开工发现存储过程两千个,工期直接翻倍。对象层的账要一起算。存储过程、触发器、视图、同义词,一个都别落下。
五、事务层与运维层:上线才暴露的两类问题
这两层平时存在感很低。上线之后,它们最先出问题。
先说事务。SQL Server 有自动提交、显式事务、隐式事务三种模式。应用开了 implicit_transactions,行为会变。@@TRANCOUNT 管嵌套层级。XACT_STATE() 判断事务状态。保存点、回滚、嵌套,每一项都要对。
SET implicit_transactions ON;
BEGIN TRAN;
UPDATE dbo.accounts SET balance = balance – 100 WHERE id = 1;
IF @@TRANCOUNT > 0
ROLLBACK;
这段迁过去,事务模式没对齐,结果可能完全相反。轻则脏数据,重则账对不上。麻烦的是它不报错。业务跑完才发现余额错了,排查得从几天前的日志翻起。
保存点更细。回滚到保存点,和回滚整个事务,中间状态不一样。测试用例两种都要覆盖,再加一组并发更新。只测单条 SQL 的结果,测不出事务层差异。
并发用例也别省。两个会话同时更新同一行,谁先拿到锁,谁先回滚,结果差很多。事务隔离级别没对齐,测试环境跑得通,生产照样出问题。这组用例,最好拉上业务一起看结果。
金仓 SQL Server 兼容版覆盖了 SQL 层和 PLSQL 层。implicit_transactions、@@TRANCOUNT、XACT_STATE() 都能接。嵌套事务和保存点也支持。这块能力不显眼,但它是数据正确性的底线。
再看运维。很多监控脚本直接查 DMV。SYS.DM_DB_FILE_SPACE_USAGE 看空间。SYS.DM_EXEC_QUERY_STATS 看查询。脚本里还有 APP_NAME()、SUSER_SNAME()。换库后一跑就报错。告警断档比性能下降更可怕,因为你看不见问题。
金仓在 C016 版本里补了 8 大系统视图。16 类核心函数补了,spt_values 系统表也支持。原来查 DMV 的脚本,基本可以照原样跑。性能侧在同一版里也接上了。统计信息按 DML 阈值自动更新。KWR 快照优化,慢查询排查更快。deadlock_priority 控制死锁优先级,让低优先级事务先回滚。单看都是细项,合起来决定换库后运维还能不能看得见。
六、数据层:全量、增量与割接位点
数据层大家最熟。可接缝处的问题,也最多。我的顺序是三步。先评估,再搬存量,最后追增量。评估用 KDMS。对象、SQL、工作量一次摸清。存量用 KDTS。它支持断点续传,几百 G 的库断了能接着跑。
增量用金仓异构数据同步软件 Kingbase FlySync(简称 KFS)。SQL Server 源端走 CDC,先读捕获表,按 LSN 段处理。DDL 和 DML 会重排序。新增表、删除表也能同步。关键在接缝。全量开始记 LSN,搬完从那个点追增量。位点对齐,账才对得上。
割接前留一段双跑期。源库继续写,目标库同步追。行数和关键字段汇总值,按小时对一次。对不上就停下查。别等切换当天才发现差额。
断点续传的前提也要说清。表结构变了、位点文件丢了,还是得重跑。全量阶段要盯进度和日志,别设完任务就不管。这一段最枯燥,也最容易出事。
我做过一个生产监控系统项目。源库 12G,88 张表。16 张历史表要进新系统的 296 个分区表。项目不大,坑不少。新系统开了加密,KDTS 一开始连不上。查了很久,不是工具的问题,是环境的驱动目录少了 bcprov 包。放进 drivers/kingbase 目录,重启 KDTS,才通。
导入也不能一把梭。报表系统按年、半年分批插。实时采集按 1000 笔一批,支持断点。中间试过视图方案,动态数据延迟到 2 分钟,最后换回原表改造。数据层的坑,多半不在数据量,在细节。
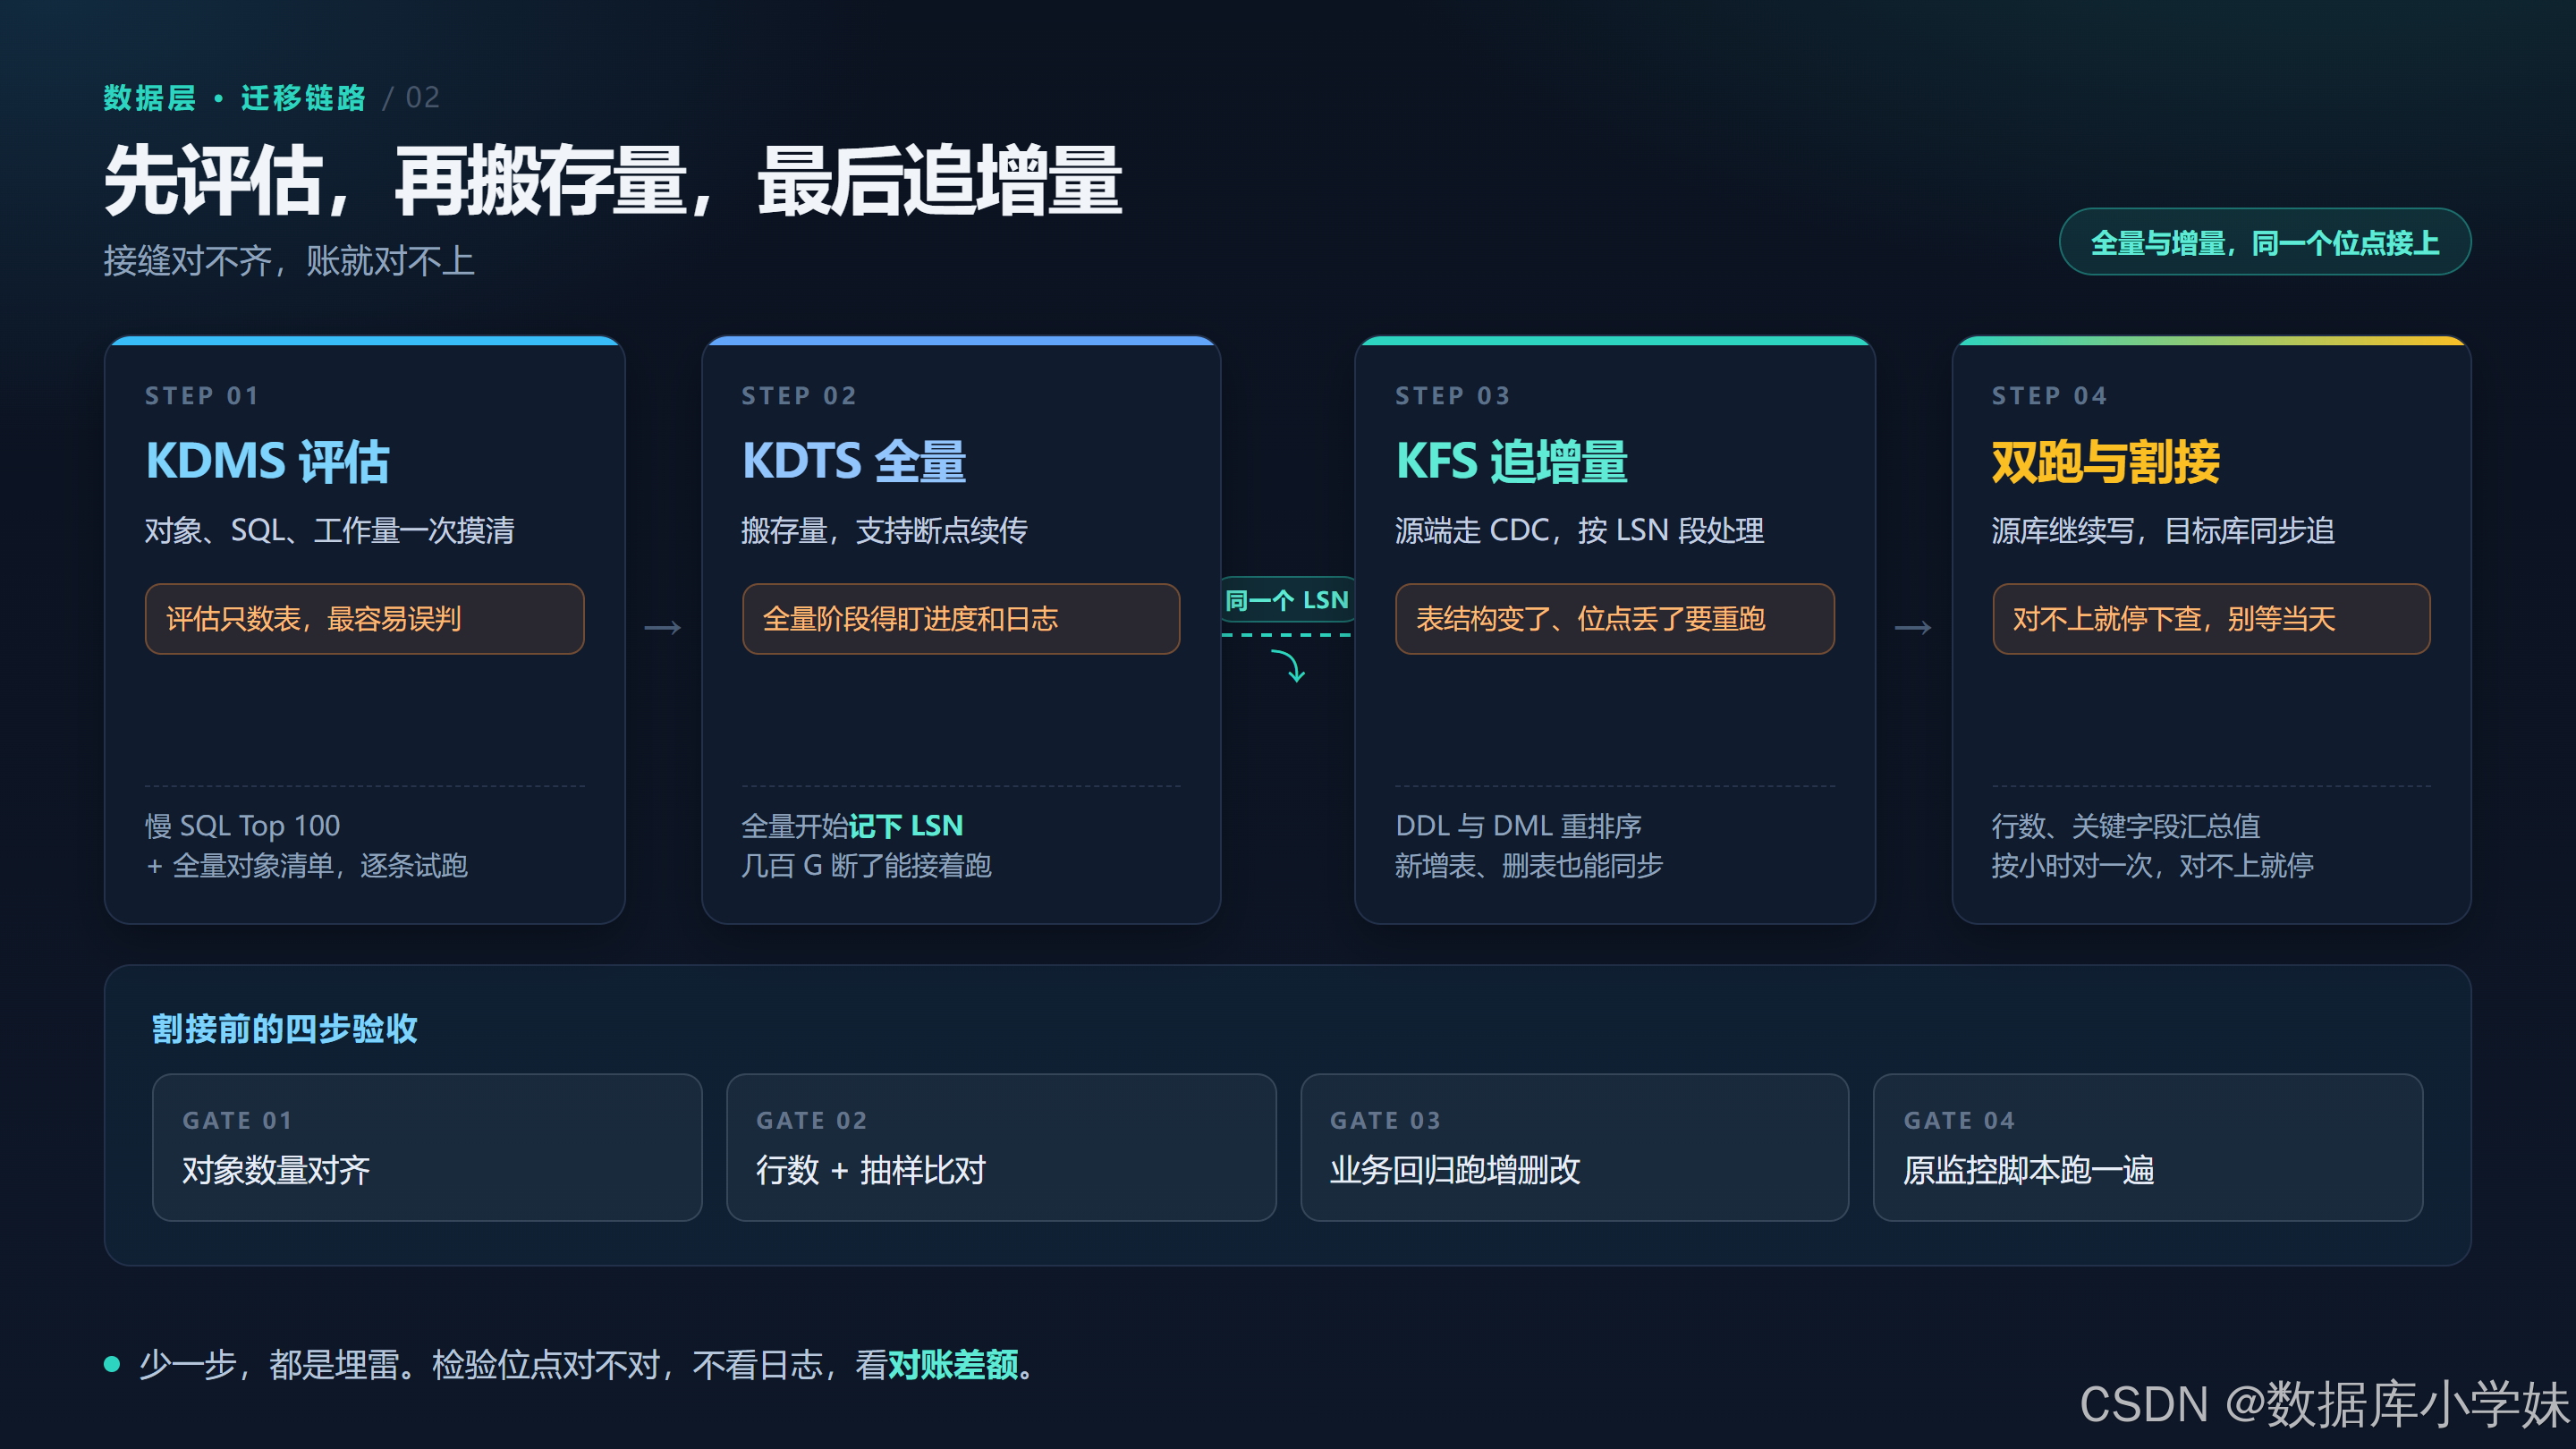
图 2:数据层三步走。全量开始记 LSN,增量从同一个位点追上去。
七、SQL Server 替换怎么验收
验收不看数据库能不能起来。看业务敢不敢切。先问四个问题。停机窗口多长。存储过程和动态 SQL 有多少。有没有强依赖 SQL Server 独有能力,链接服务器、SSIS、Agent 作业、AlwaysOn 都要单列。监控和备份脚本算不算范围。四个答完,方案轮廓基本有了。
停机窗口是第一道分水岭。分钟级窗口,全量必须提前搬完,只能靠增量追平。小时级窗口,全量和增量可以一起排。完全没窗口的,先做双写或同步,再找机会切。
窗口怎么定,要和业务一起拍。DBA 觉得两小时够,业务可能只给二十分钟。提前把回退方案写出来。切不过去能退回来,字才敢签。
有三种情况,我建议先等等。半年内要重构或下线的,钱花在重构更值。强依赖商业软件的,先让厂商出一份 KES 适配清单。清单没到手之前,别急着定工期。只想熬过版本到期的,先算 ESU 和升级的账,不必一步到位。
真要换,验收四步。对象数量对齐。数据行数加抽样比对。业务回归跑完整增删改。原监控脚本在目标库跑一遍。四步全过再割接。少一步,都是埋雷。这四步不花哨,但每一步都能挡住一类问题。
八、SQL Server 替换避坑清单
三条,都是踩过或见过的。
九、写在最后
SQL Server 替换,不是把方言一条条改成看起来像。是找一个五层都能接住的平台。
记住三句话就够了。换库不换写法,T-SQL 常用语法在内核里兼容,大部分不用改。换库不停业务,KDMS 评估、KDTS 搬存量、KFS 追增量,按同一个位点接上。换库不掉监控,DMV 视图、系统函数、spt_values 都兼容,KWR 和 deadlock_priority 把排障也接住了。
我写方案时,这三行永远放最前面。后面的排期、验收、割接,都围着它们转。真要动手,把五层表打印出来贴在工位。每过一层打个勾,比开十次会更管用。
你们换 SQL Server 时,最卡哪一层?存储过程、事务,还是监控脚本?评论区说说,说不定能帮到正在填坑的人。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋



