目录
一、四张病历一个根源:把镜像当成了压缩包
(一)一个随处可见的 Dockerfile
(二)四个病症背后的两个误解
二、先看懂账本:镜像的分层文件系统模型
(一)镜像是只读层的叠加,容器是其上的一张草稿纸
(二)层的身份是内容摘要,传输与存储按层去重
(三)在上层删除不会变小:遮盖不是抹除
三、镜像过大:从基础镜像到定制运行时的瘦身路径
(一)基础镜像的四种选择:完整 JDK、精简 JRE、Alpine 与 distroless
(二)多阶段构建:把构建期的东西挡在船外
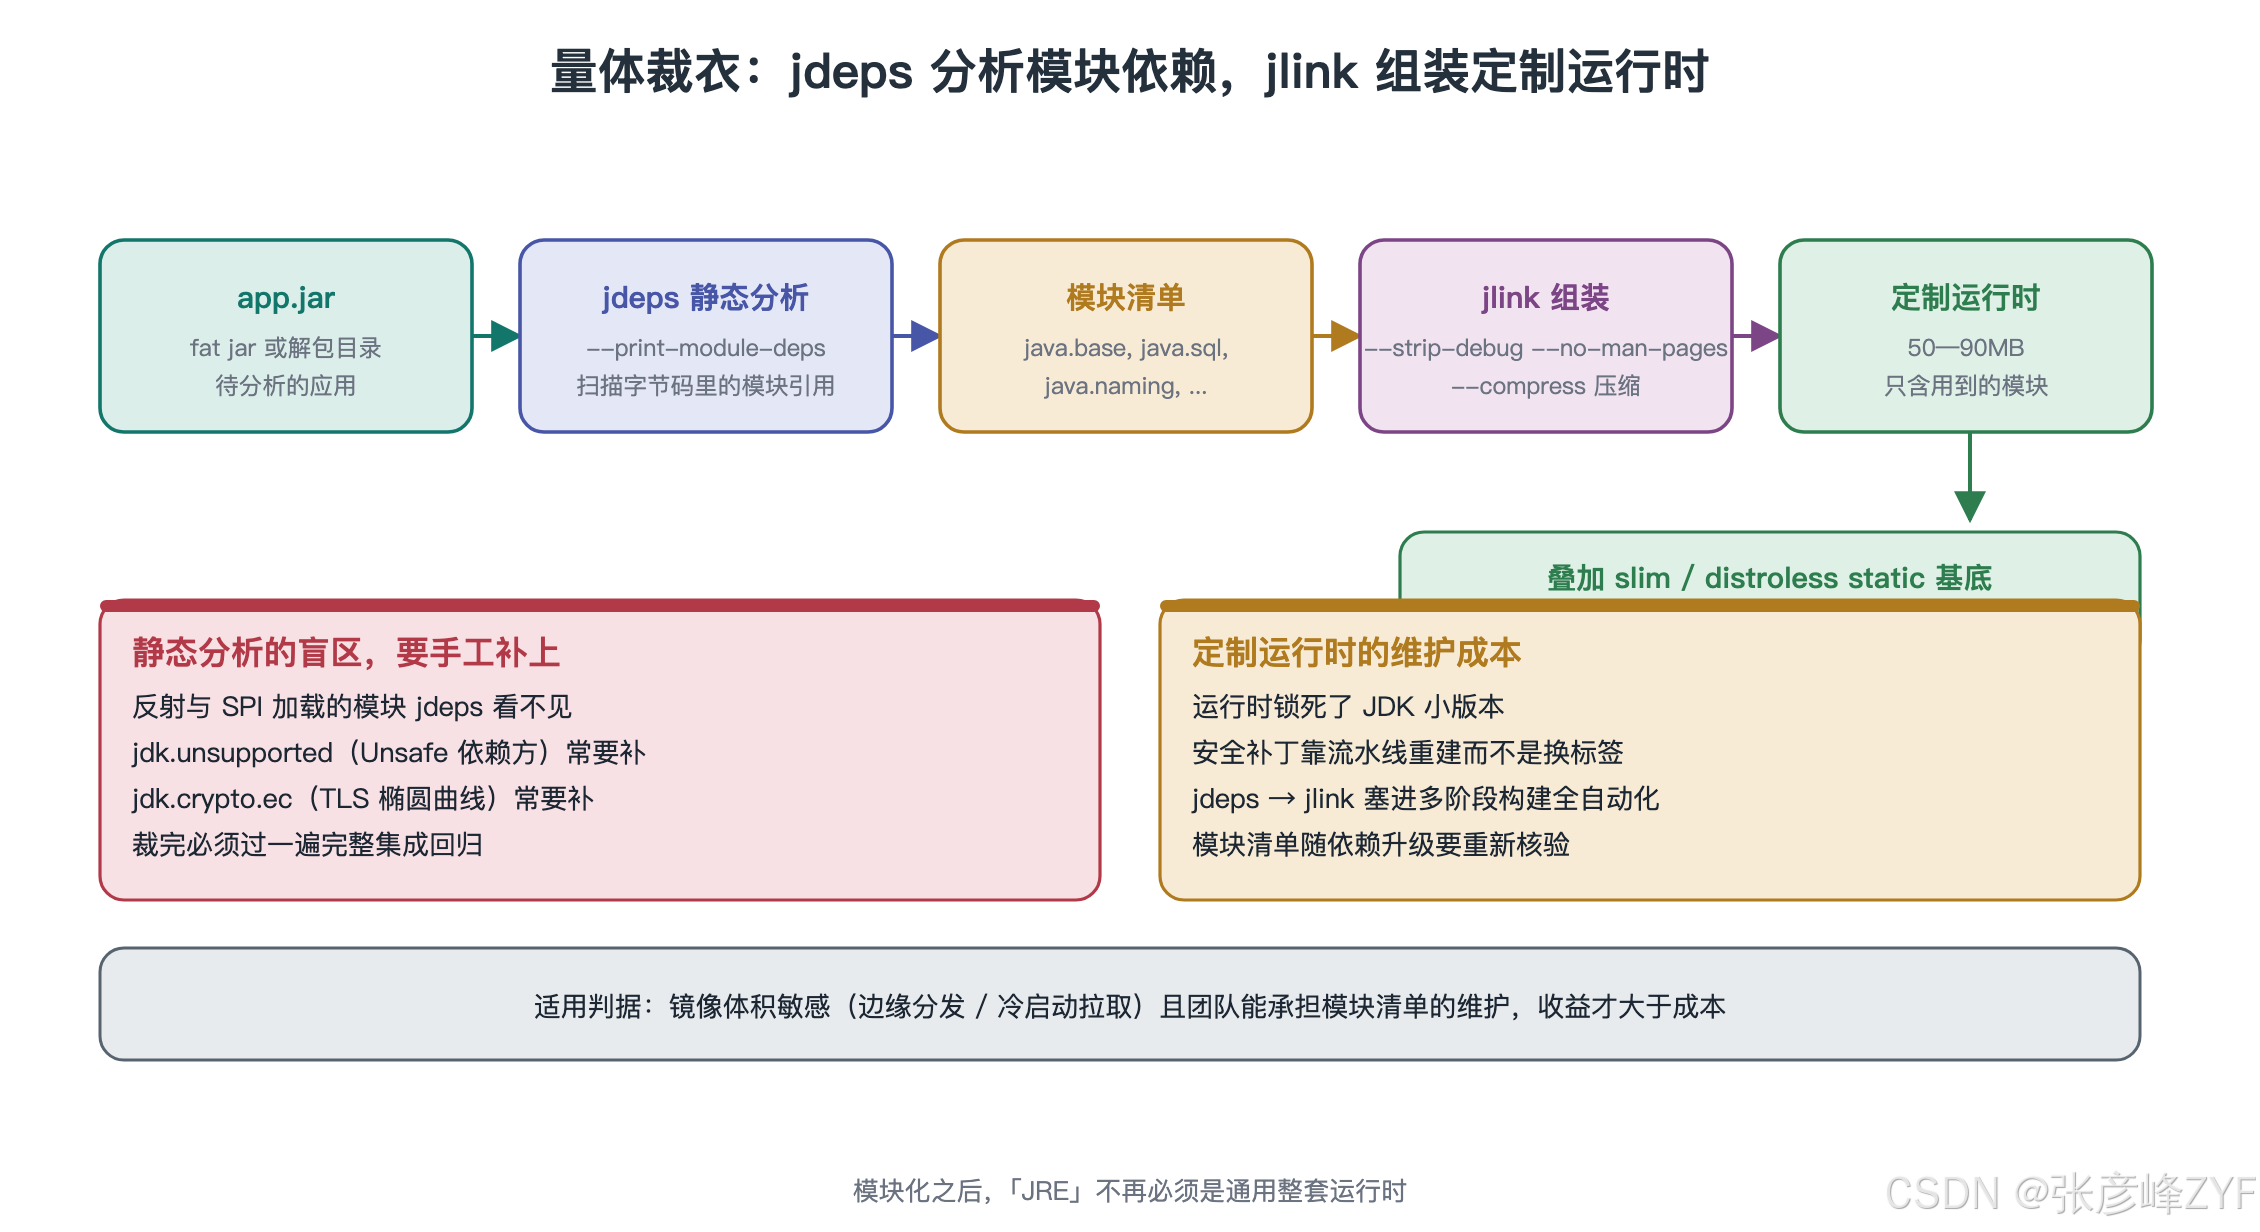
(三)jdeps 与 jlink:裁一套只属于这个应用的运行时
(四)一本体积对照账
四、构建缓慢与缓存失效:规则、病灶与排序纪律
(一)缓存命中的判定规则
(二)正确的排序:变化频率决定层的位置
(三)BuildKit:缓存挂载、并行阶段与外置缓存
五、fat jar 的罪与罚:Spring Boot 的分层拆解
(一)fat jar 对分层模型的伤害
(二)layered jar:把一个 jar 拆回四层
(三)配套 Dockerfile 的写法与效果
六、Jib:把镜像构建交还给构建工具
(一)设计动机:无守护进程、无 Dockerfile、纪律内置
(二)默认分层策略与增量推送
(三)可复现构建:时间戳归零与摘要稳定
(四)Jib 的边界
(五)Dockerfile、Jib 与 Buildpacks 的选型对照
七、容器里的 JVM:资源视野、内存总账与参数标定
(一)JVM 看到的是谁的资源:从宿主机误读到容器感知
(二)堆只是一部分:容器限额下的内存总账
(三)MaxRAMPercentage 的标定与 OOMKilled 的甄别
1、两种死法的甄别
1.1、内核杀的:OOMKilled
1.2、JVM 抛的:OutOfMemoryError
2、堆比例的标定方法
3、被杀之后的取证工具
(四)CPU 配额的连锁反应:GC 线程、JIT 与默认并行度
(五)一套可以起步的容器 JVM 参数模板
八、启动提速:类加载账单、CDS 与更激进的路线
(一)类加载的账单与 CDS / AppCDS
(二)更激进的路线:AOT、CRaC 与原生镜像
九、送进流水线:CI 上的镜像工程纪律
(一)标签纪律与基础镜像锁定
(二)缓存外置与构建提速的流水线视角
(三)安全面:非 root、扫描与最小攻击面
(四)上线自查清单
十、写在最后
参考资料
干货分享,感谢您的阅读!
一个 Java 服务的容器化,常常停在"能跑起来"这一步:docker build 通过了,docker run 起来了,接口也通了,于是这套 Dockerfile 被复制到团队的每一个仓库里。半年之后账单陆续到期——镜像涨到八九百兆,拉取一次要一分多钟;流水线里每次构建都要重新下载全部依赖,八分钟起步;改了一行业务代码,推送时却把一百多兆的依赖重新传了一遍;最难堪的是上了生产,进程隔三差五被内核直接杀掉,日志里连一行异常都找不到。
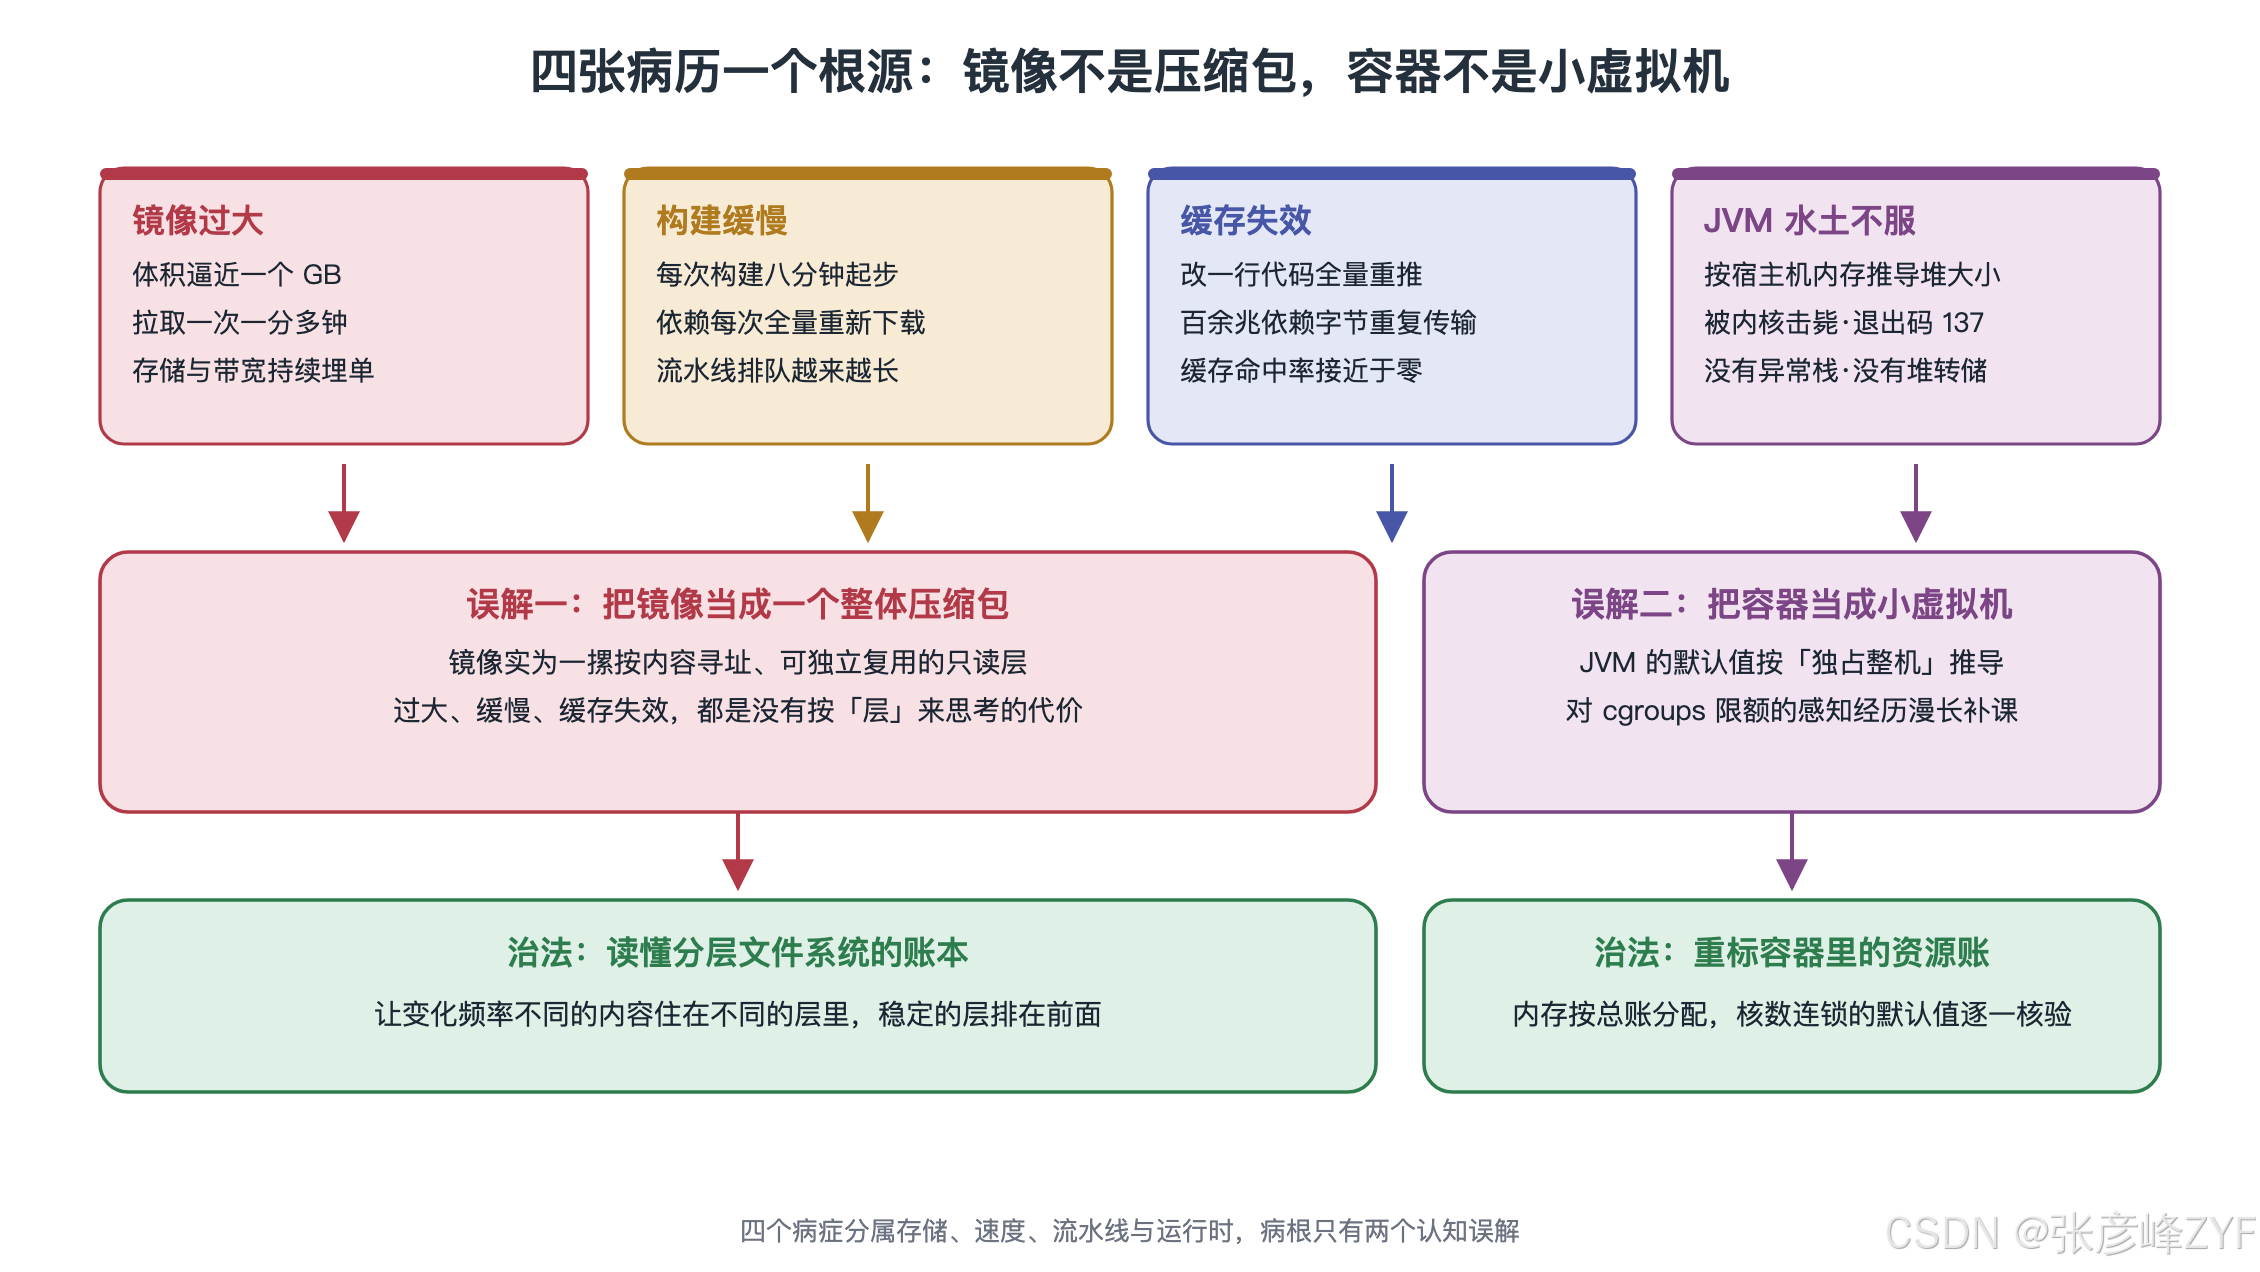
这四件事——镜像过大、构建缓慢、缓存失效、JVM 在容器里水土不服——表面上分属"存储、速度、流水线、运行时"四个领域,实际上共享同一个认知根源:把镜像当成了一个整体压缩包,而它自始至终是一摞按内容寻址、可独立复用的只读层;把容器当成了一台小虚拟机,而 JVM 在相当长的历史里根本看不见容器的资源边界。
这次我们从分层文件系统的账本模型出发,把四个问题逐一解剖,再给出两条工程化的出路——Dockerfile 的分层纪律与 Jib 的声明式构建——最后把容器里 JVM 参数的标定方法完整推演一遍。
一、四张病历一个根源:把镜像当成了压缩包
(一)一个随处可见的 Dockerfile
先看一份在无数 Java 仓库里都能找到近亲的 Dockerfile:
FROM eclipse-temurin:17-jdk
WORKDIR /app
COPY . .
RUN ./mvnw package -DskipTests
EXPOSE 8080
CMD ["java", "-Xmx4g", "-jar", "target/app.jar"]
它能构建、能运行、能通过验收,但四个毛病全都埋下了。第一,最终镜像里装着完整的 JDK、Maven 本地仓库、全部源码和构建中间产物,体积轻松超过一个 GB——运行一个 jar 需要的只是一套 JRE 和这个 jar 本身。第二,COPY . . 把整个工作目录一锅端进镜像,任何一个文件的改动——哪怕只是 README——都会让这一层缓存失效,其后的 RUN ./mvnw package 从零重跑,依赖全量重新下载。第三,构建产物只有一层,业务代码与第三方依赖被打进同一个 fat jar、装进同一个层,每次发布都要把没变过的依赖字节重新推送、重新拉取。第四,-Xmx4g 是按某台测试机的内存拍的:容器限额若是 3 GB,这个参数就是一张迟早兑付的 OOMKilled 支票;若容器限额是 16 GB,又白白浪费了资源。
(二)四个病症背后的两个误解
把四个病症摆在一起看,可以归并为两个更基本的误解。
前三个病症——过大、缓慢、缓存失效——都源于对镜像存储模型的误解。镜像不是一个 tar 包,而是一摞只读层的有序叠加,每一层由其内容的摘要(digest)唯一标识;构建缓存按层判定,传输与存储按层去重。所有针对体积和速度的优化,本质上都是同一件事:让变化频繁的内容和变化稀少的内容落在不同的层里,并且把变化稀少的层排在前面。fat jar 之所以是容器时代的反模式,就是因为它把一年不变的依赖和一天三变的业务代码焊死在同一个文件里,让分层模型完全失效。
第四个病症源于对运行时资源视野的误解。JVM 的一系列默认值——堆大小、GC 线程数、JIT 编译线程数、ForkJoinPool 的并行度——都是按"我独占这台机器"的假设推导的。在容器里,进程能用的内存和 CPU 由 cgroups 限额约束,而 JVM 对 cgroups 的感知经历了从完全失明(JDK 8 早期)、实验性支持(8u131)、默认开启(JDK 10 与 8u191 的 UseContainerSupport)到支持 cgroups v2(JDK 15,回移到 11.0.16 与 8u372)的漫长补课。用错基础镜像里的 JDK 版本,或者不理解限额与 JVM 各内存区的换算关系,进程就会以最沉默的方式死去:内核发一个 SIGKILL,退出码 137,没有堆转储,没有异常栈。
二、先看懂账本:镜像的分层文件系统模型
(一)镜像是只读层的叠加,容器是其上的一张草稿纸
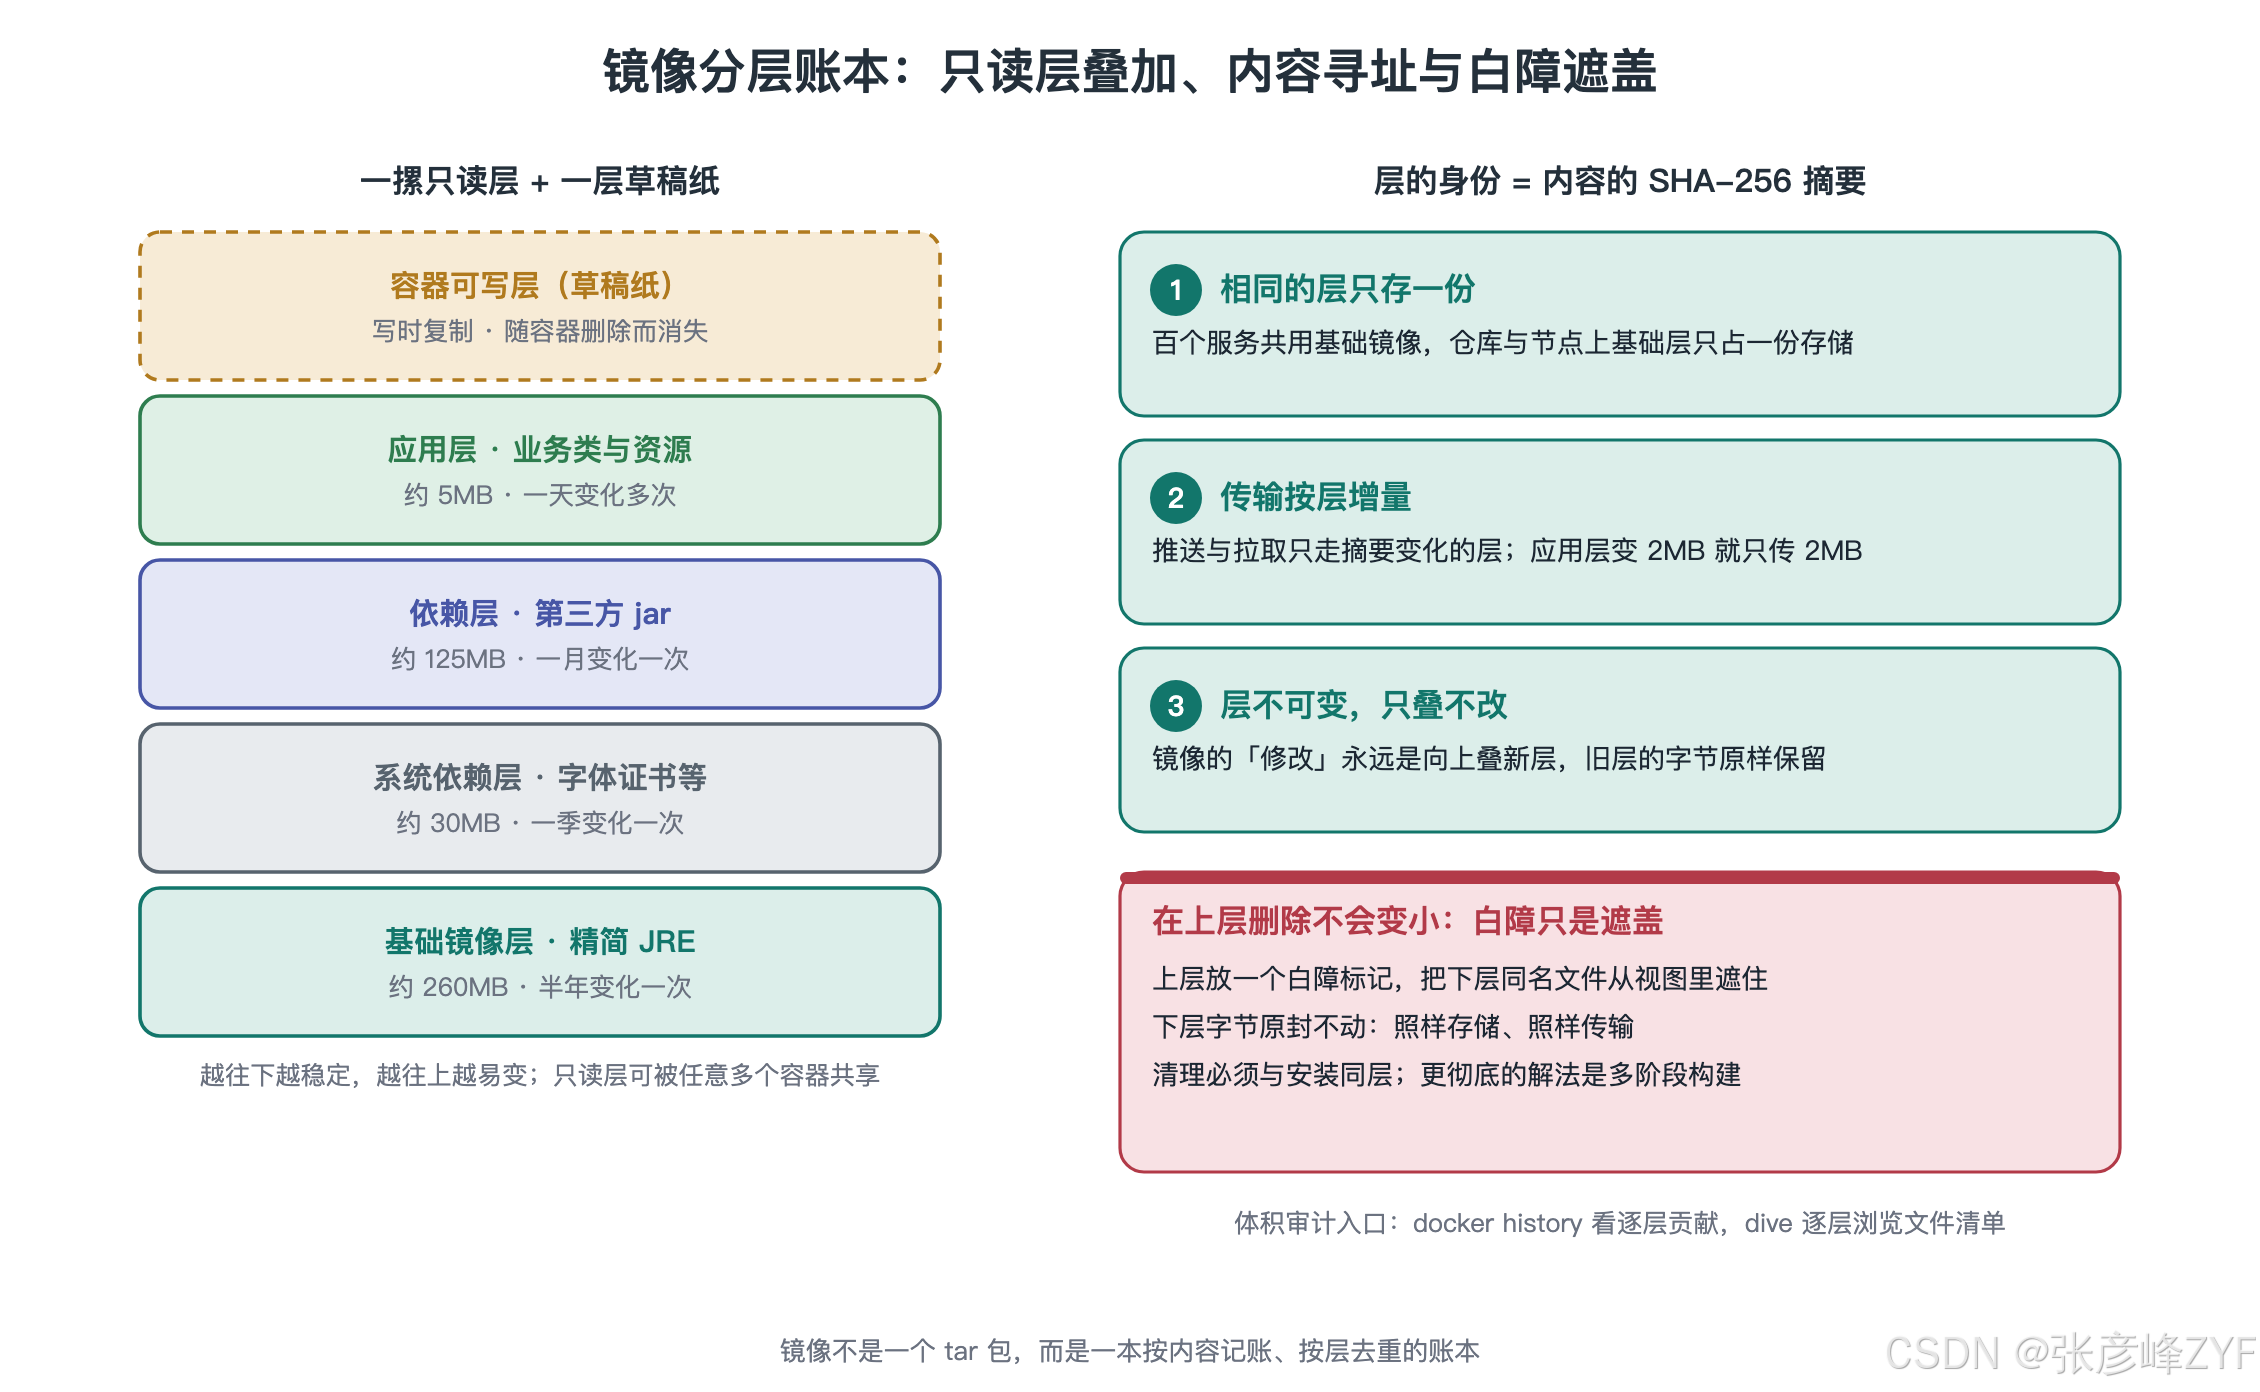
一个 OCI 镜像由两部分组成:一份清单(manifest)和若干个层(layer)。每个层是一个 tar 归档的文件系统变更集——相对于它下面那一层,新增了哪些文件、修改了哪些文件、删除了哪些文件。Dockerfile 里每一条产生文件系统变更的指令(FROM、RUN、COPY、ADD)都会生成一个新的层;ENV、EXPOSE、CMD 这类指令只修改镜像配置,不产生层。
清单记录着各层的摘要与顺序,外加一份配置(入口命令、环境变量、暴露端口等);在多架构场景下,一个标签背后还有一层"清单索引"(manifest list),按平台指向各自的镜像清单——这就是同一个 eclipse-temurin:17-jre 在 amd64 与 arm64 节点上都能拉到正确镜像的机制。
运行容器时,存储驱动(现在通常是 overlay2)把这摞只读层联合挂载成一个统一视图,再在最顶上加一层可写层。容器内的所有写操作都发生在可写层,通过写时复制(copy-on-write)实现:修改一个位于下层的文件,会先把它整个复制到可写层再改。这层"草稿纸"随容器删除而消失——这就是为什么镜像可以被任意多个容器共享,也是为什么容器内写大文件、改大文件是昂贵操作。
(二)层的身份是内容摘要,传输与存储按层去重
每个层由其内容的 SHA-256 摘要唯一标识。这个设计带来三个直接推论,它们是全部体积与速度优化的理论根基。
其一,相同内容的层在仓库和宿主机上只存一份。一百个微服务共用同一个基础镜像,registry 里那几层基础层只占一份存储;节点上已经有这些层,拉取新镜像时会直接跳过。其二,推送与拉取都以层为单位增量进行。发布新版本时,只有摘要发生变化的层需要传输;如果应用层只有 2 MB 的 class 文件变了,而依赖层原封不动,一次推送就只走 2 MB 流量——前提是它们真的在不同的层里。其三,层一旦生成就不可变。镜像的"修改"永远是在上面叠新层,而不是改旧层。
(三)在上层删除不会变小:遮盖不是抹除
不可变性有一个常被踩中的推论:在后面的层里删除文件,镜像不会变小。联合文件系统用一个"白障"(whiteout)标记来表达删除——上层放一个标记文件,把下层的同名文件遮住,让它在统一视图里不可见。但下层那个文件的字节原封不动地留在镜像里,照样要存储、照样要传输。
# 这两层加起来,镜像体积不减反增
RUN wget https://example.com/big-installer.bin && ./install.sh
RUN rm /big-installer.bin # 只是遮盖,安装包的字节还在上一层里
同理,RUN apt-get install 之后在另一条 RUN 里清理缓存是无效的,清理必须与安装发生在同一层:
RUN apt-get update && apt-get install -y –no-install-recommends fontconfig \\
&& rm -rf /var/lib/apt/lists/*
更彻底的解法是多阶段构建:需要临时文件的操作全部放在前一个阶段,最终阶段只 COPY –from 拿走结果。这一点第三章展开。用 docker history <image> 可以看到每一层的体积贡献,配合开源工具 dive 能逐层浏览文件清单,是体积审计的第一步。
三、镜像过大:从基础镜像到定制运行时的瘦身路径
(一)基础镜像的四种选择:完整 JDK、精简 JRE、Alpine 与 distroless
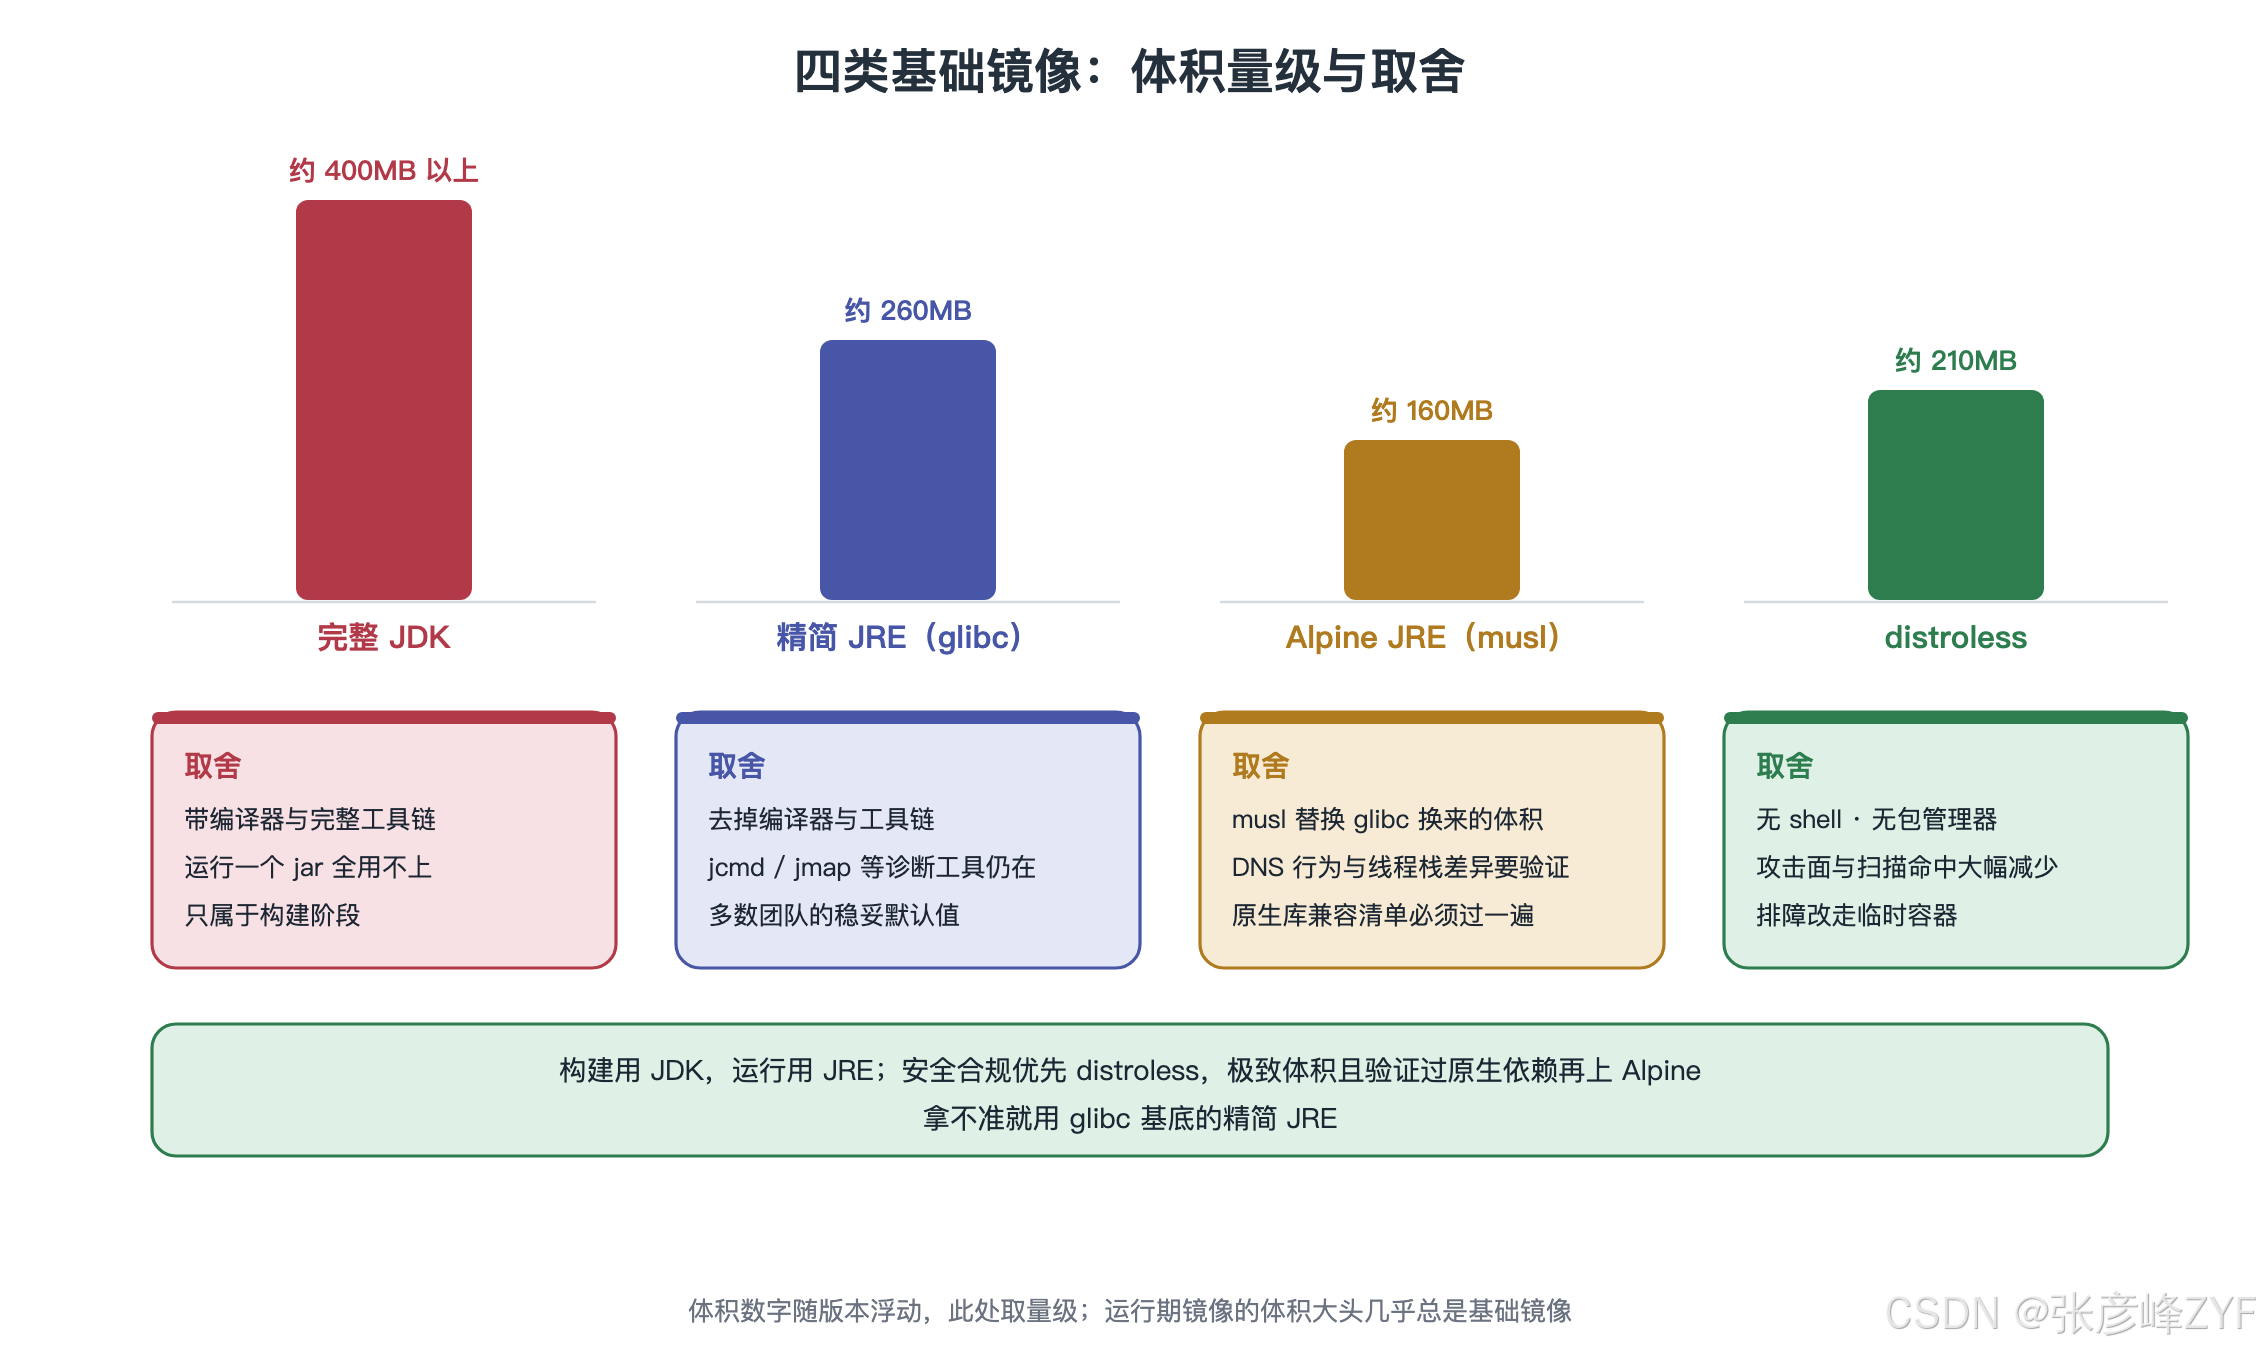
运行期 Java 镜像的体积大头几乎总是基础镜像。以 Java 17 为例,四类常见选择的量级对照(具体数字随版本浮动,这里取近似值说明数量级):
- 完整 JDK(如 eclipse-temurin:17-jdk):约 400 MB 以上。带编译器、jshell、完整工具链——运行一个 jar 一样都用不上。它属于构建阶段,不属于运行阶段。
- 精简 JRE(如 eclipse-temurin:17-jre,Ubuntu 基底):约 260 MB。去掉了编译器与工具链,保留完整运行时与常用诊断工具(jcmd、jmap 仍在),是大多数团队的稳妥默认值。
- Alpine JRE(如 eclipse-temurin:17-jre-alpine):约 160 MB。省出来的体积来自用 musl libc 替换 glibc、用 BusyBox 替换 GNU 工具集。代价是兼容性风险:musl 的 DNS 解析行为与 glibc 存在差异(历史上对 resolv.conf 部分选项与搜索域的处理不同,在 Kubernetes 的服务发现里踩过不少坑);musl 默认线程栈远小于 glibc,某些 JNI 库会因此栈溢出;依赖 glibc 的原生库(部分 JDBC 驱动的原生组件、字体渲染、性能分析器)需要逐一验证。上 Alpine 之前,这张兼容性清单必须过一遍。
- distroless(如 gcr.io/distroless/java17-debian12):约 210 MB。它保留 glibc 基底但删掉了 shell、包管理器和一切非必需品,镜像里除了 JRE 与你的应用几乎什么都没有。体积上未必比 Alpine 更小,它真正的卖点是攻击面:没有 shell 意味着大多数"进容器执行命令"式的攻击直接失效,漏洞扫描的命中项也大幅减少。代价是排障方式要换:不能 docker exec 进去敲命令,要靠 :debug 变体镜像或 Kubernetes 的临时容器(ephemeral containers)。
选型判据可以压缩成一句话:构建用 JDK,运行用 JRE;追求安全合规优先 distroless,追求极致体积且验证过原生依赖再上 Alpine;拿不准就用 glibc 基底的精简 JRE。
(二)多阶段构建:把构建期的东西挡在船外
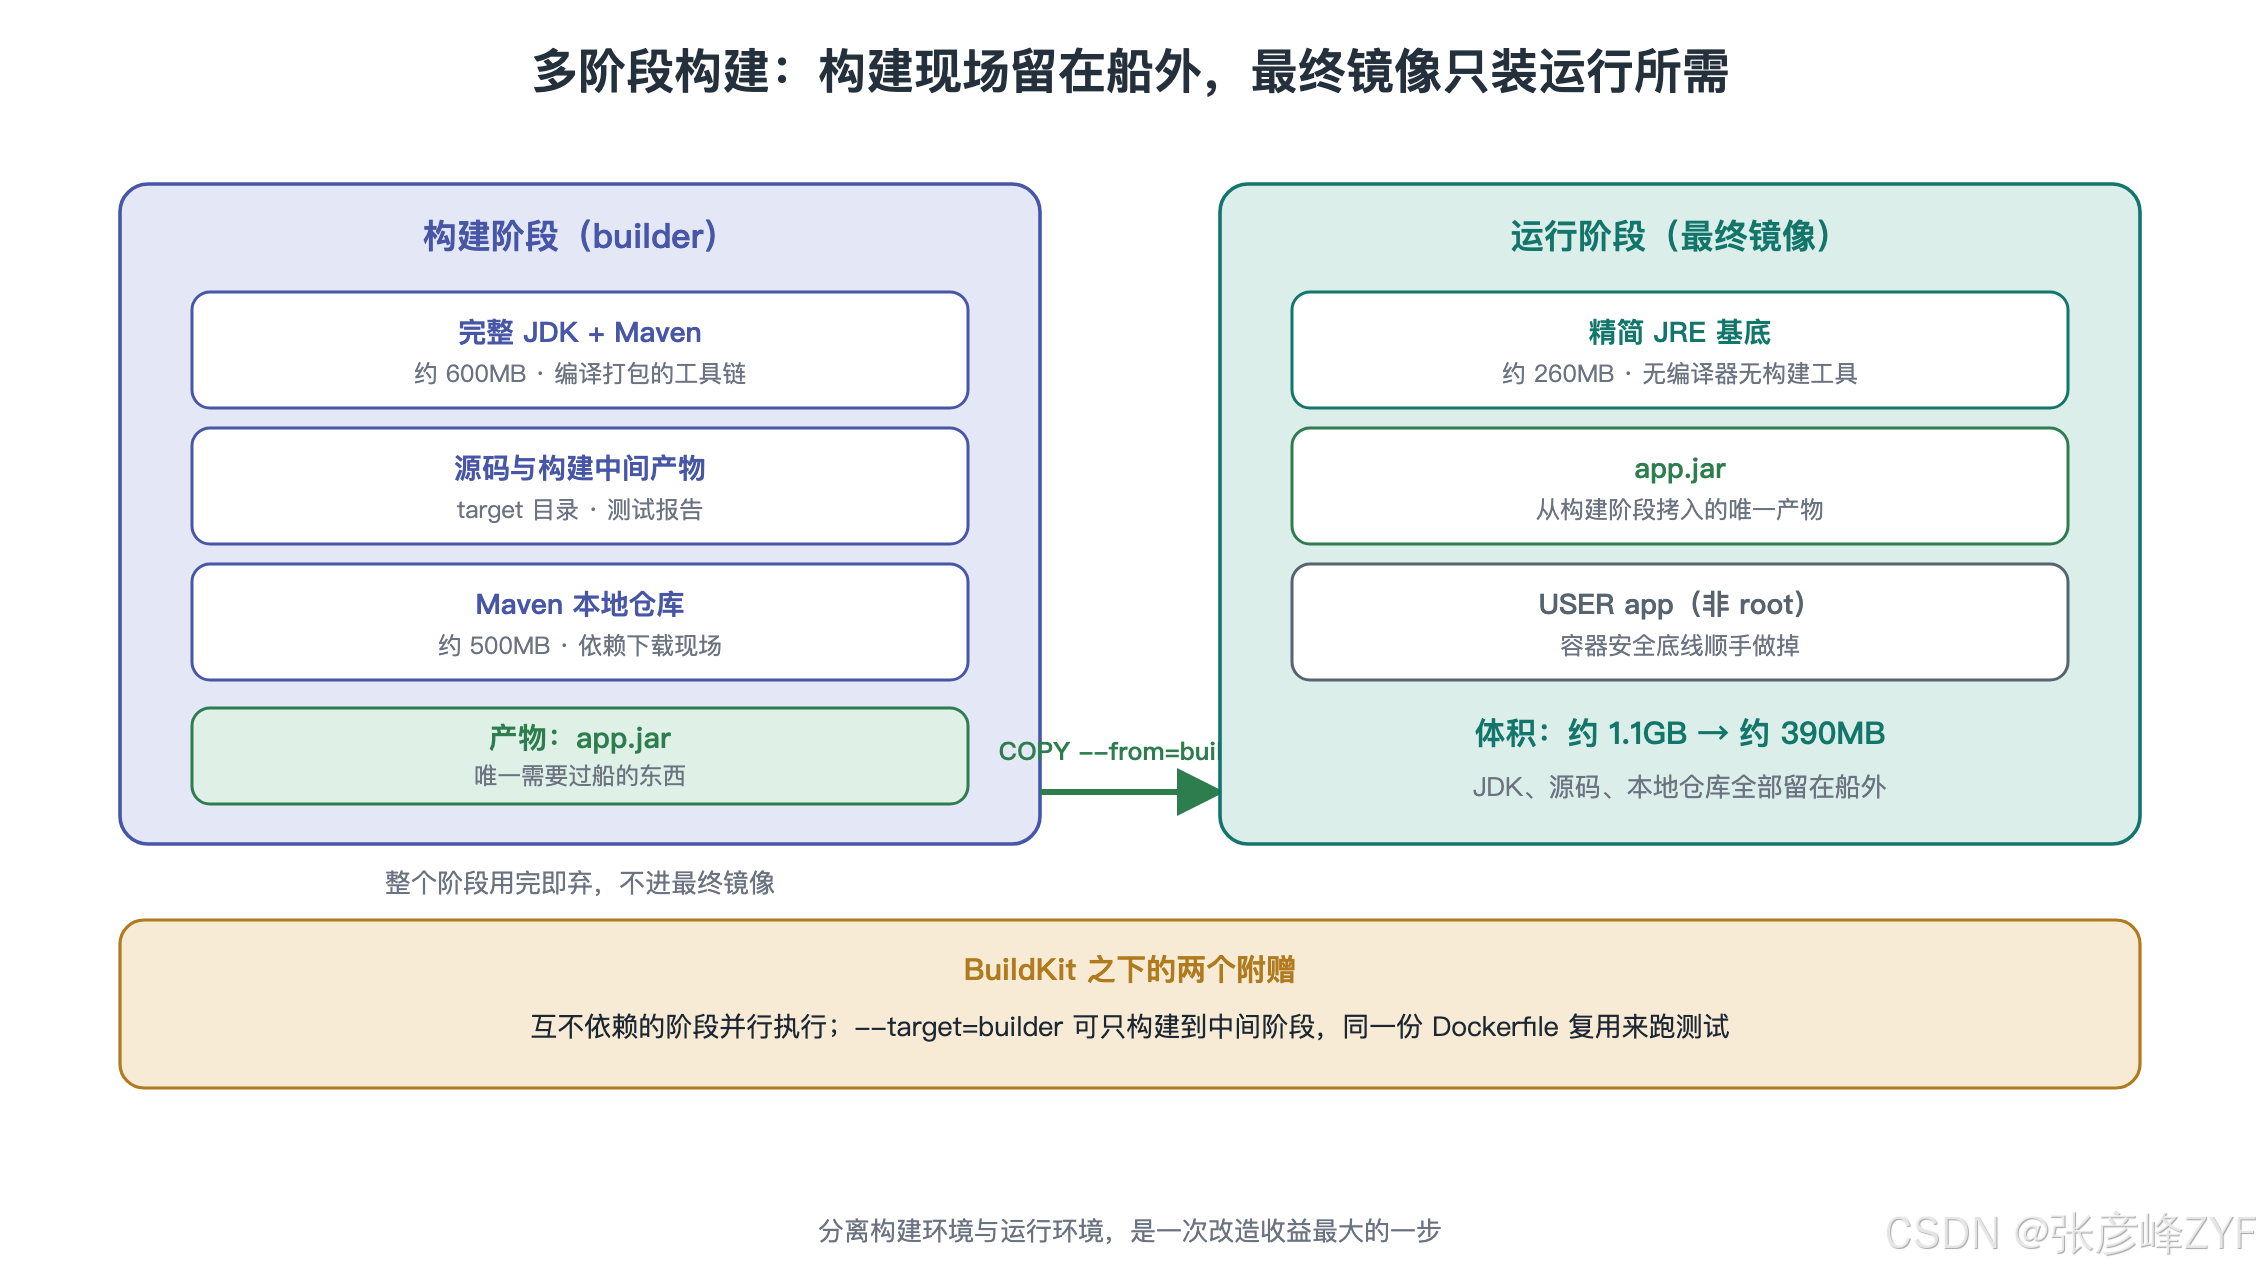
多阶段构建(multi-stage build)是分离"构建环境"与"运行环境"的标准手段:一个 Dockerfile 里写多个 FROM,前面的阶段负责编译打包,最终阶段只从前面 COPY –from 拿走产物。构建期的 JDK、Maven、源码、本地仓库统统留在中间阶段里,不进最终镜像。
# ———- 构建阶段:完整 JDK + Maven ———-
FROM maven:3.9-eclipse-temurin-17 AS builder
WORKDIR /build
COPY pom.xml .
RUN mvn dependency:go-offline -B # 只要 pom 不变,这层缓存长期有效
COPY src ./src
RUN mvn package -DskipTests -B
# ———- 运行阶段:精简 JRE ———-
FROM eclipse-temurin:17-jre
RUN groupadd -r app && useradd -r -g app app
USER app
WORKDIR /app
COPY –from=builder /build/target/app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
这份写法同时解决了两个问题:最终镜像从"JDK + 全部构建现场"缩到"JRE + 一个 jar",体积从 GB 级降到 300 MB 上下;pom.xml 与 src 分两次拷贝,依赖下载层只在 pom 变化时才失效(第四章详述)。注意最后的 USER app——以非 root 运行是容器安全的底线要求,顺手在这里就做掉。
BuildKit 之下,各阶段之间没有依赖时还会并行执行;用 –target=builder 可以只构建到某个中间阶段,方便在流水线里复用同一份 Dockerfile 跑测试。
(三)jdeps 与 jlink:裁一套只属于这个应用的运行时
JDK 9 模块化之后,"JRE"不再必须是那个通用的整套运行时。jlink 可以从模块集合出发,组装一个只包含指定模块的定制运行时映像;jdeps 负责回答"我的应用到底用了哪些模块":
# 第一步:分析 fat jar 依赖的 JDK 模块
jdeps –ignore-missing-deps –recursive –print-module-deps \\
–multi-release 17 –class-path 'BOOT-INF/lib/*' app.jar
# 输出形如:java.base,java.logging,java.sql,java.naming,java.desktop,…
# 第二步:据此组装定制运行时
jlink –add-modules java.base,java.logging,java.sql,java.naming,jdk.unsupported \\
–strip-debug –no-man-pages –no-header-files –compress=zip-6 \\
–output /custom-jre
一个典型的 Spring Boot 应用裁出来的运行时在 50—90 MB 之间,叠加一个精简的 Debian slim 或 distroless static 基底,总体积可以压到 150 MB 以内,比通用 JRE 方案再省一半。两个工程注意点:其一,反射与 SPI 加载的模块 jdeps 静态分析看不见,jdk.unsupported(Netty 等库依赖的 sun.misc.Unsafe 所在)、jdk.crypto.ec(TLS 椭圆曲线)这类模块常要手工补上,裁完必须过一遍完整的集成回归;其二,定制运行时锁死了 JDK 小版本,安全补丁跟进要靠流水线重建,而不是换基础镜像标签。
把 jdeps→jlink 塞进多阶段构建,就得到一条全自动的"量体裁衣"流水线:构建阶段产出 jar 与定制运行时,最终阶段把两者拷进一个几乎为空的基底。
(四)一本体积对照账
把上面三条路径的效果汇总成一本账(以一个依赖 120 MB、业务代码 5 MB 的典型 Spring Boot 服务为例,数字取量级):
- 单阶段完整 JDK + 构建现场:约 1.1 GB——反模式基线。
- 多阶段 + 通用精简 JRE:约 390 MB——一次 Dockerfile 改造,收益最大的一步。
- 多阶段 + Alpine JRE:约 290 MB——需验证 musl 兼容性。
- 多阶段 + jlink 定制运行时 + slim 基底:约 190 MB——需维护模块清单。
- 多阶段 + distroless:约 340 MB——体积不是最小,攻击面最小。
值得强调的是:体积优化的边际收益递减,而分层复用的收益是每次发布都在兑现。一个 390 MB 但依赖层长期稳定的镜像,日常发布只传输几 MB 的应用层;一个 190 MB 但每次全量变化的镜像,反而更拖累发布。先把层分对,再谈把层做小。
四、构建缓慢与缓存失效:规则、病灶与排序纪律
(一)缓存命中的判定规则
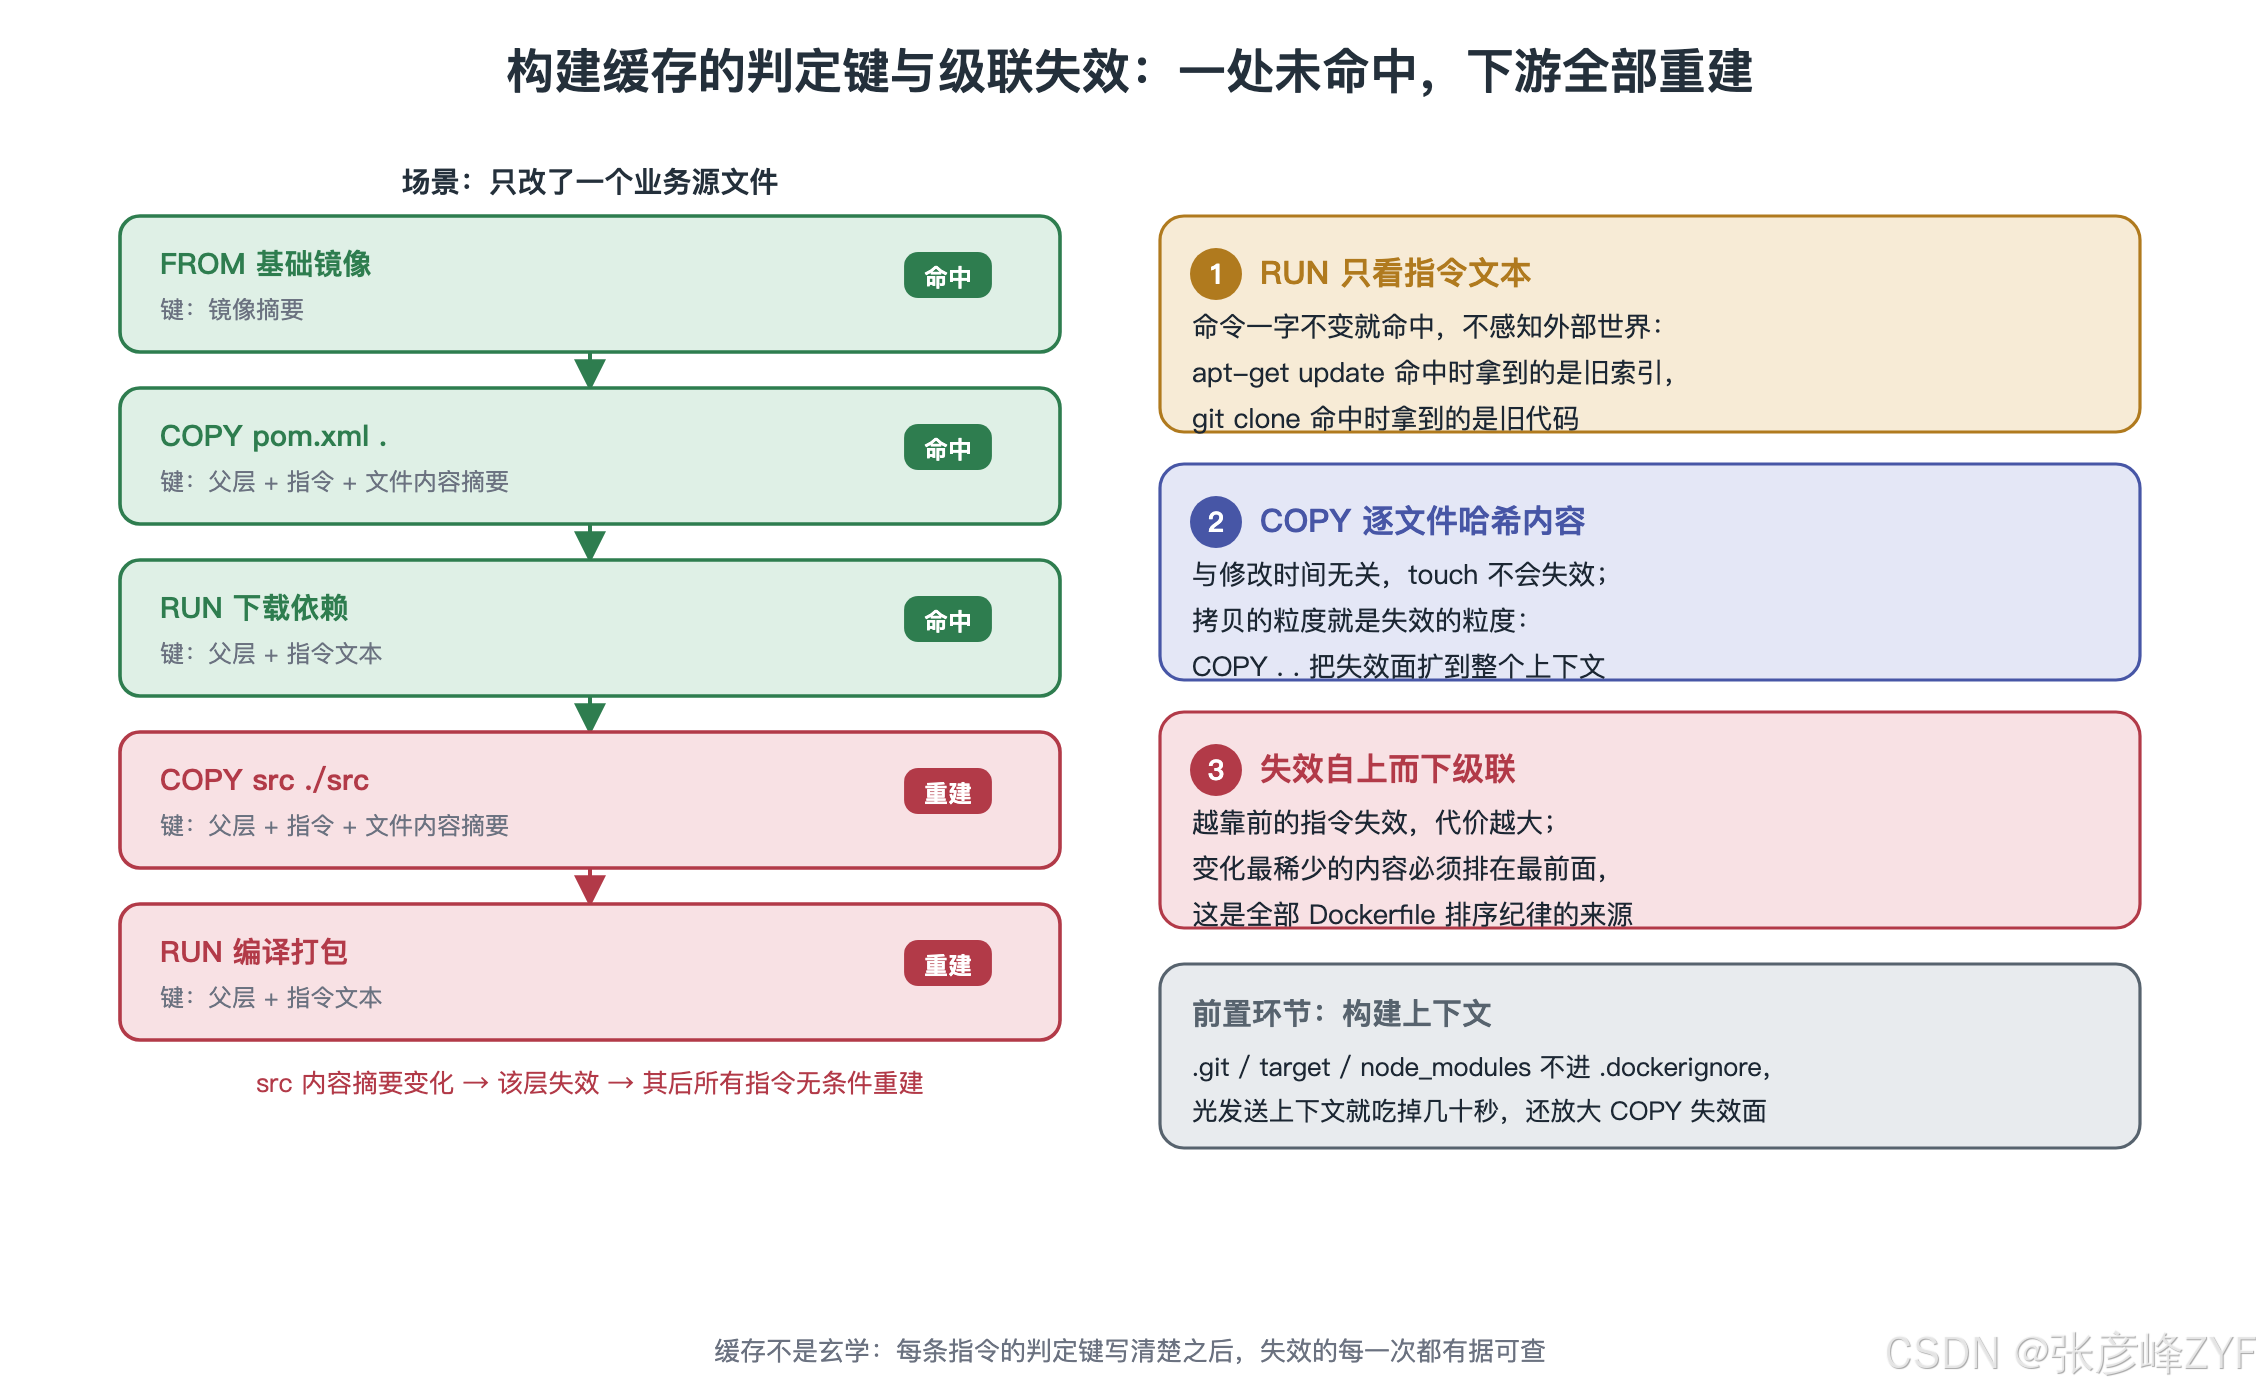
Docker 构建缓存的规则可以一句话说清:自上而下逐条指令判定,一旦某条指令未命中,其后所有指令全部重建。判定的键因指令而异——
- RUN 指令:父层摘要 + 指令字符串本身。命令文本一个字符不变就命中,它不感知外部世界的变化:RUN apt-get update 命中缓存时拿到的是旧索引,RUN git clone 命中时拿到的是旧代码。
- COPY / ADD 指令:父层摘要 + 指令字符串 + 被拷贝文件的内容摘要(逐文件哈希,与修改时间无关)。文件内容变了才失效,touch 一下不会。
两条推论直接决定 Dockerfile 的写法。第一,缓存失效是级联的:排在越前面的指令失效,代价越大,所以变化最稀少的内容必须排在最前面。第二,COPY 的粒度就是失效的粒度:COPY . . 把整个上下文一锅端,任何文件变动都会击穿这一层以及其后的一切——包括那条最昂贵的依赖下载。
还有一个常被忽略的前置环节:构建上下文本身。docker build . 会先把当前目录打包发给构建器,.git、target、node_modules 若不在 .dockerignore 里,光是发送上下文就能吃掉几十秒,还会让 COPY . . 的失效更加频繁。.dockerignore 是所有优化里性价比最高的一行配置。
(二)正确的排序:变化频率决定层的位置
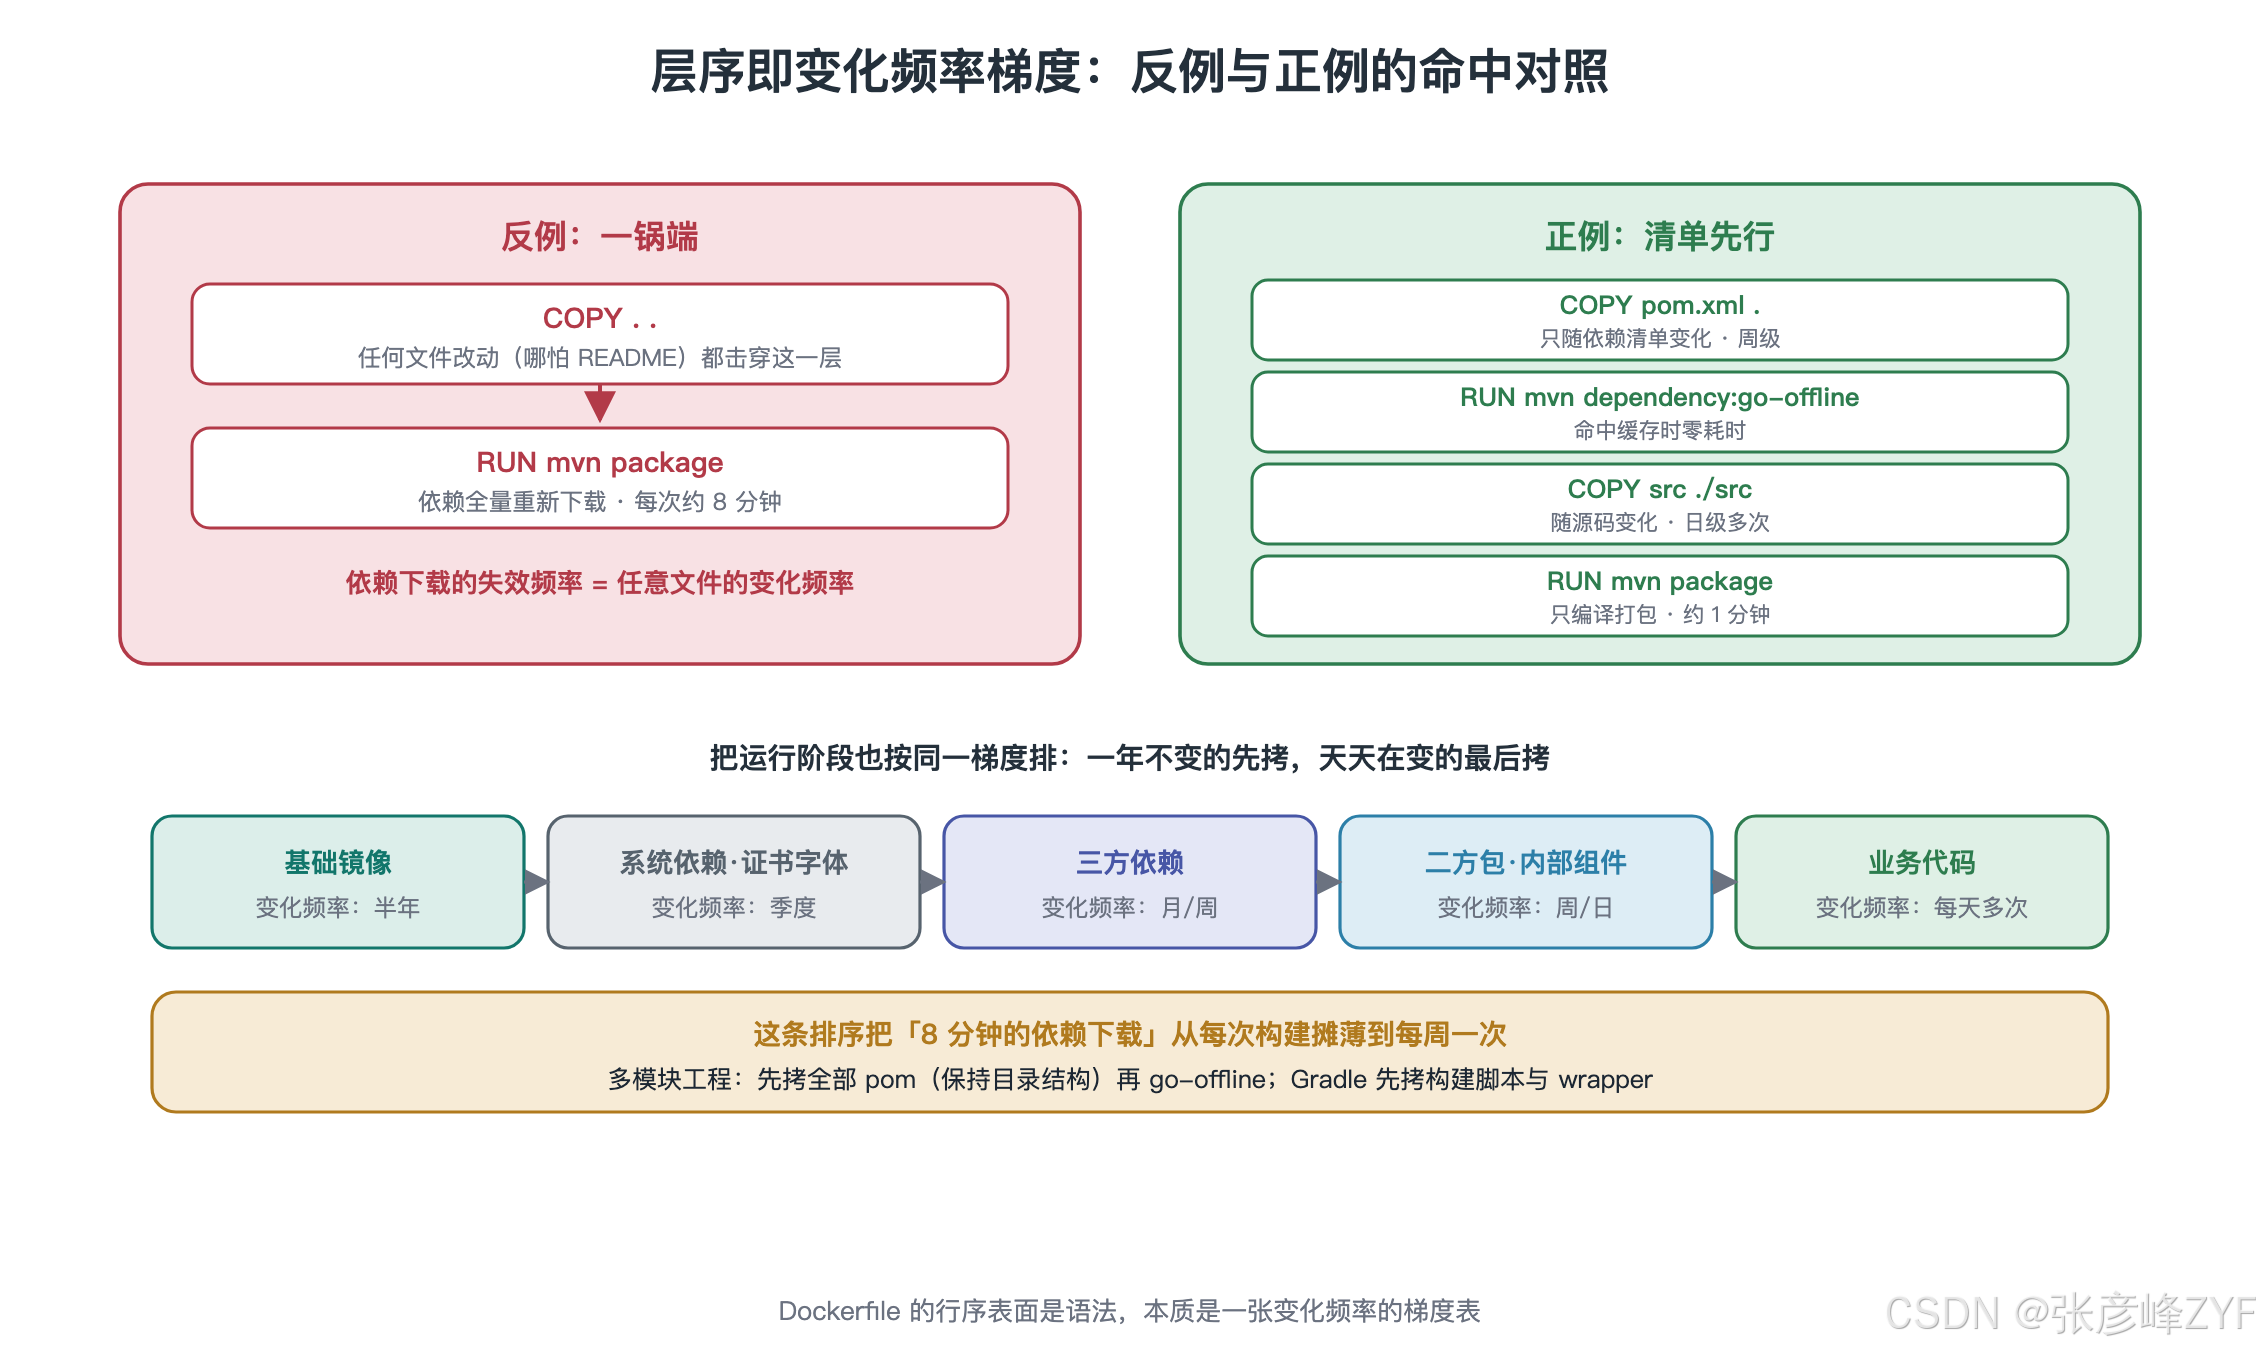
把缓存规则应用到 Java 项目,就得到那条经典的排序纪律:依赖清单先进、依赖下载居中、源码最后进。对照两份写法——
# 反例:任何文件改动都触发依赖全量重下
COPY . .
RUN mvn package -DskipTests # 每次 8 分钟
# 正例:依赖层只随 pom.xml 变化
COPY pom.xml .
RUN mvn dependency:go-offline -B # 命中缓存时 0 秒
COPY src ./src
RUN mvn package -DskipTests -B # 只编译打包,约 1 分钟
多模块工程的同构做法是先拷贝全部 pom.xml(保持目录结构),跑一次 dependency:go-offline,再拷贝各模块源码。Gradle 项目对应为先拷 build.gradle、settings.gradle 与 wrapper,跑 gradle dependencies,再拷源码。日常开发中 pom 的变化频率大约是每周一次,而源码是每天几十次——这条排序把"8 分钟的依赖下载"从每次构建摊薄到每周一次。
同样的频率思维适用于运行阶段:证书、字体、agent 这类一年不变的文件先拷,配置模板次之,应用 jar 最后拷。层的排序表面上是 Dockerfile 的行序,本质上是一张变化频率的梯度表。
(三)BuildKit:缓存挂载、并行阶段与外置缓存
BuildKit(Docker 18.09 起可用,现代版本默认启用)把缓存治理又推进三步。
第一步,缓存挂载(cache mount)。dependency:go-offline 的问题在于它是全有或全无:pom 变一行,整层失效,依赖从零重下。缓存挂载把 Maven 本地仓库变成挂在构建过程上的持久卷,pom 变化时只增量下载新依赖:
RUN –mount=type=cache,target=/root/.m2 mvn package -DskipTests -B
注意挂载的内容不进镜像,最终产物要在同一条 RUN 里拷出来,或者接受"依赖不在镜像层里"的事实(配合多阶段拿产物即可)。
第二步,并行与按需执行。BuildKit 按阶段依赖图调度:互不依赖的阶段并行跑,最终阶段用不到的阶段直接跳过。把"跑测试""构建产物""生成 SBOM"拆成平行阶段,流水线的墙钟时间随之下降。
第三步,外置缓存。CI 的构建机通常是用完即毁的,本地缓存活不过一次任务。BuildKit 支持把缓存导出到镜像仓库或专用后端:
docker buildx build \\
–cache-from type=registry,ref=registry.example.com/app:buildcache \\
–cache-to type=registry,ref=registry.example.com/app:buildcache,mode=max \\
-t registry.example.com/app:1.4.2 –push .
mode=max 会把中间阶段的层也存进缓存引用,多阶段构建的 builder 阶段才能跨任务命中。GitHub Actions 有专门的 type=gha 后端。外置缓存把"无状态构建机"与"有记忆的构建"这对矛盾调和掉了——这也是第六章 Jib 增量推送思路的伏笔。
五、fat jar 的罪与罚:Spring Boot 的分层拆解
(一)fat jar 对分层模型的伤害
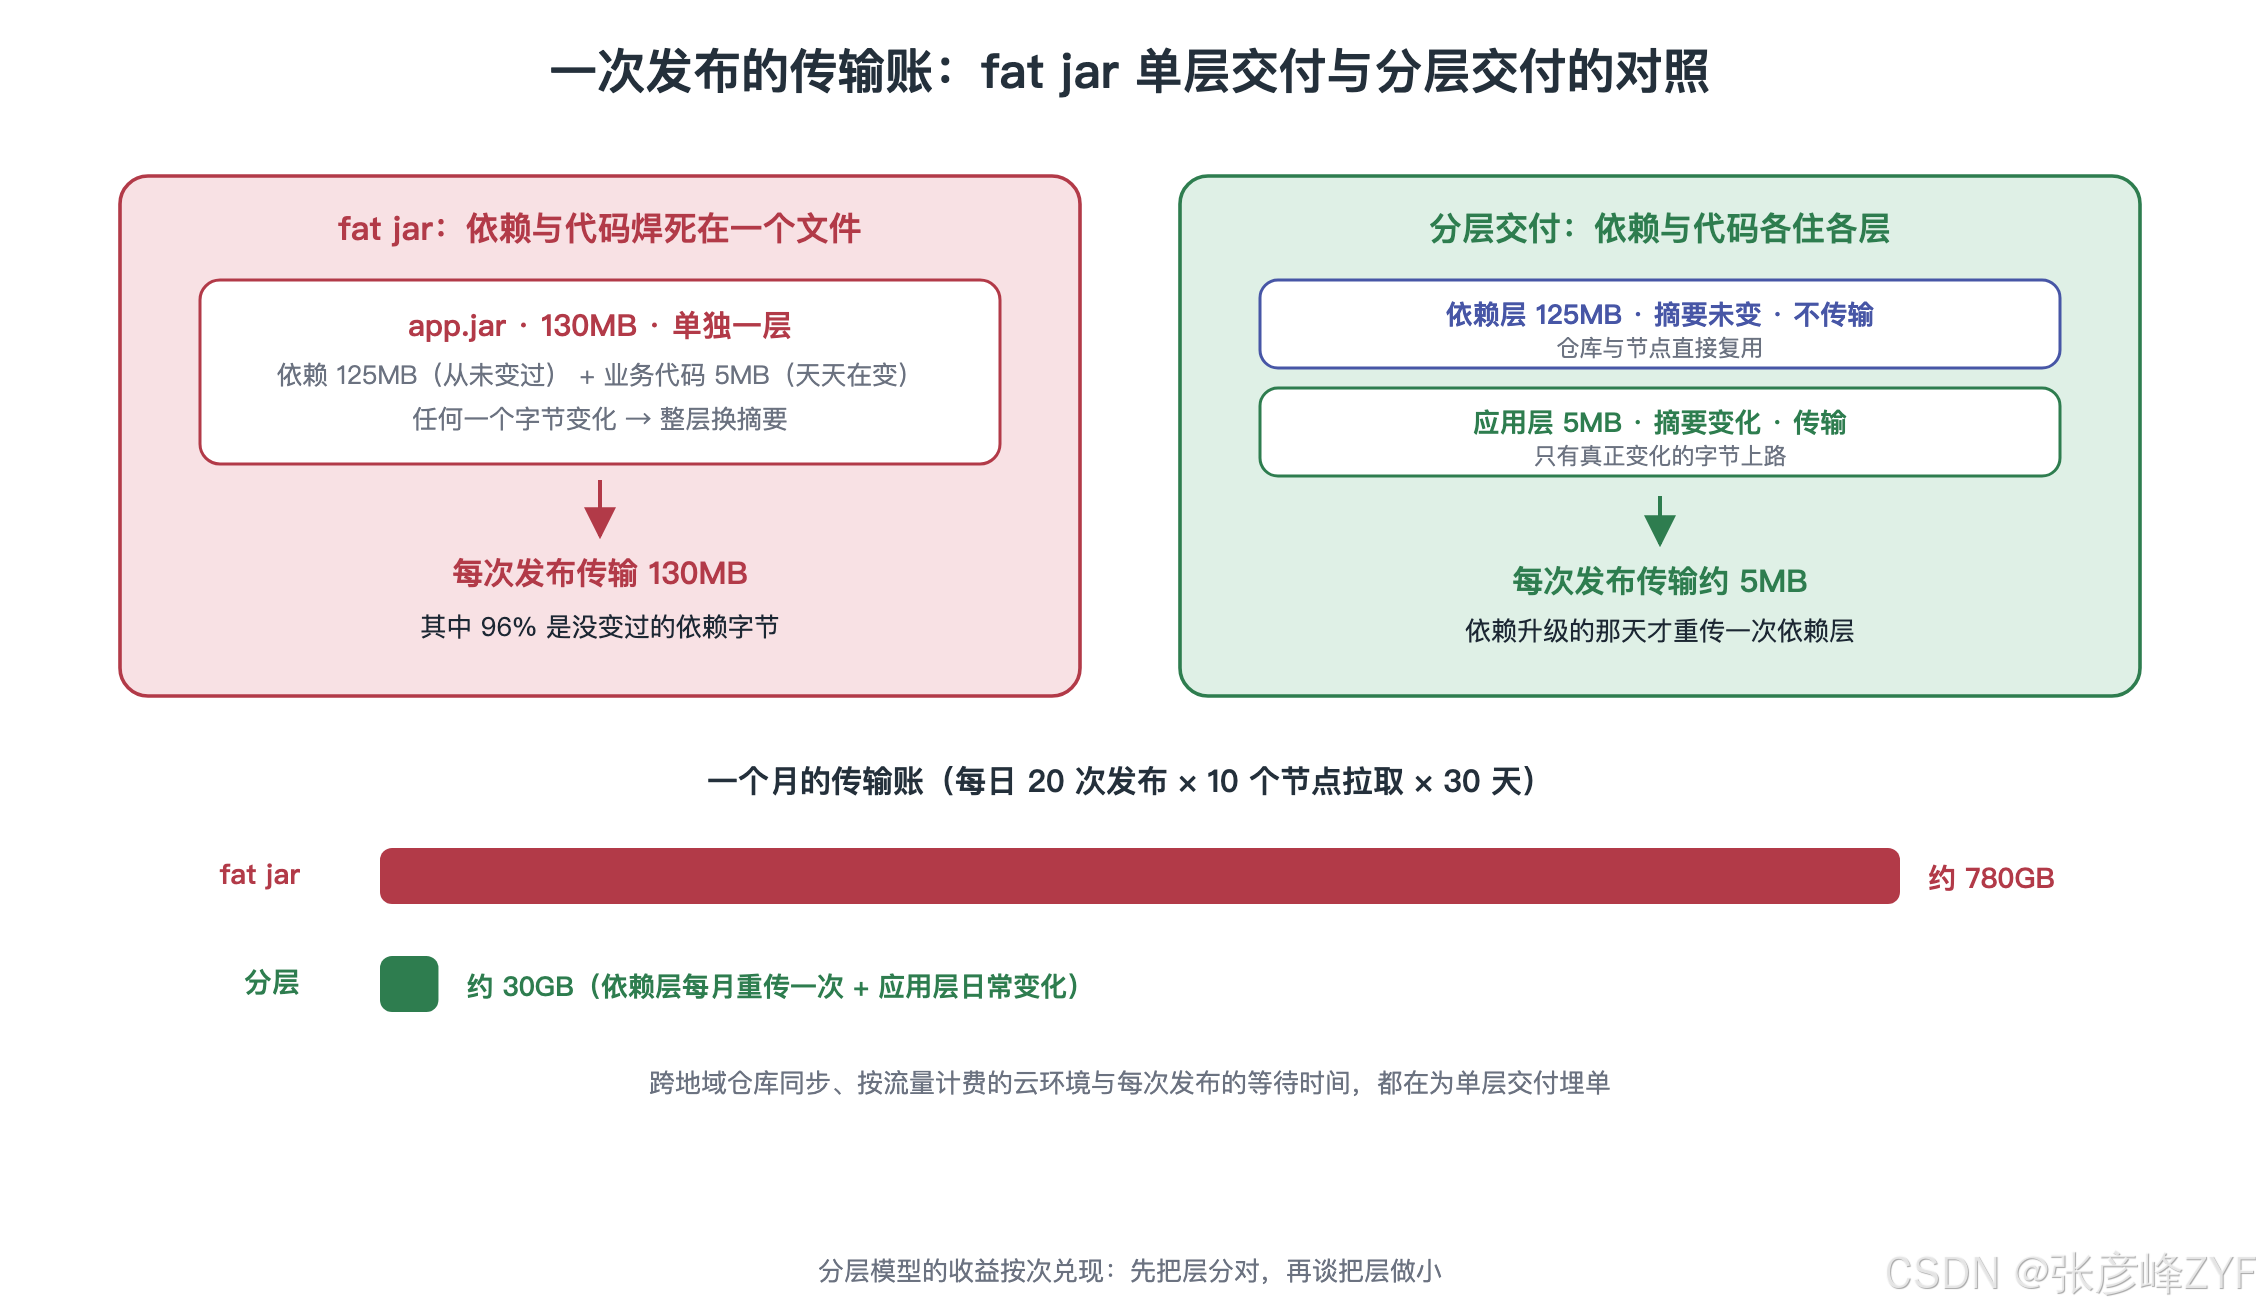
Spring Boot 默认打出的可执行 jar 把应用类、资源文件和全部依赖 jar 嵌套进一个文件。对"一个文件扔到虚拟机上运行"的年代,这是绝佳的交付形态;对按层去重的容器模型,这是精确的反向设计——COPY target/app.jar 只产生一个层,这个层的摘要随 jar 的任何一个字节变化而变化。业务代码改一行,130 MB 的 jar 就换了摘要,推送、拉取、存储都按全新的 130 MB 计。
按每天 20 次发布、每次 10 个节点拉取算,一个月的无效传输量是 130 MB × 20 × 10 × 30 ≈ 780 GB——其中 96% 是那 125 MB 从未变过的依赖字节。跨地域仓库同步、按流量计费的云环境、以及每次发布的等待时间,都在为这份反向设计埋单。
(二)layered jar:把一个 jar 拆回四层
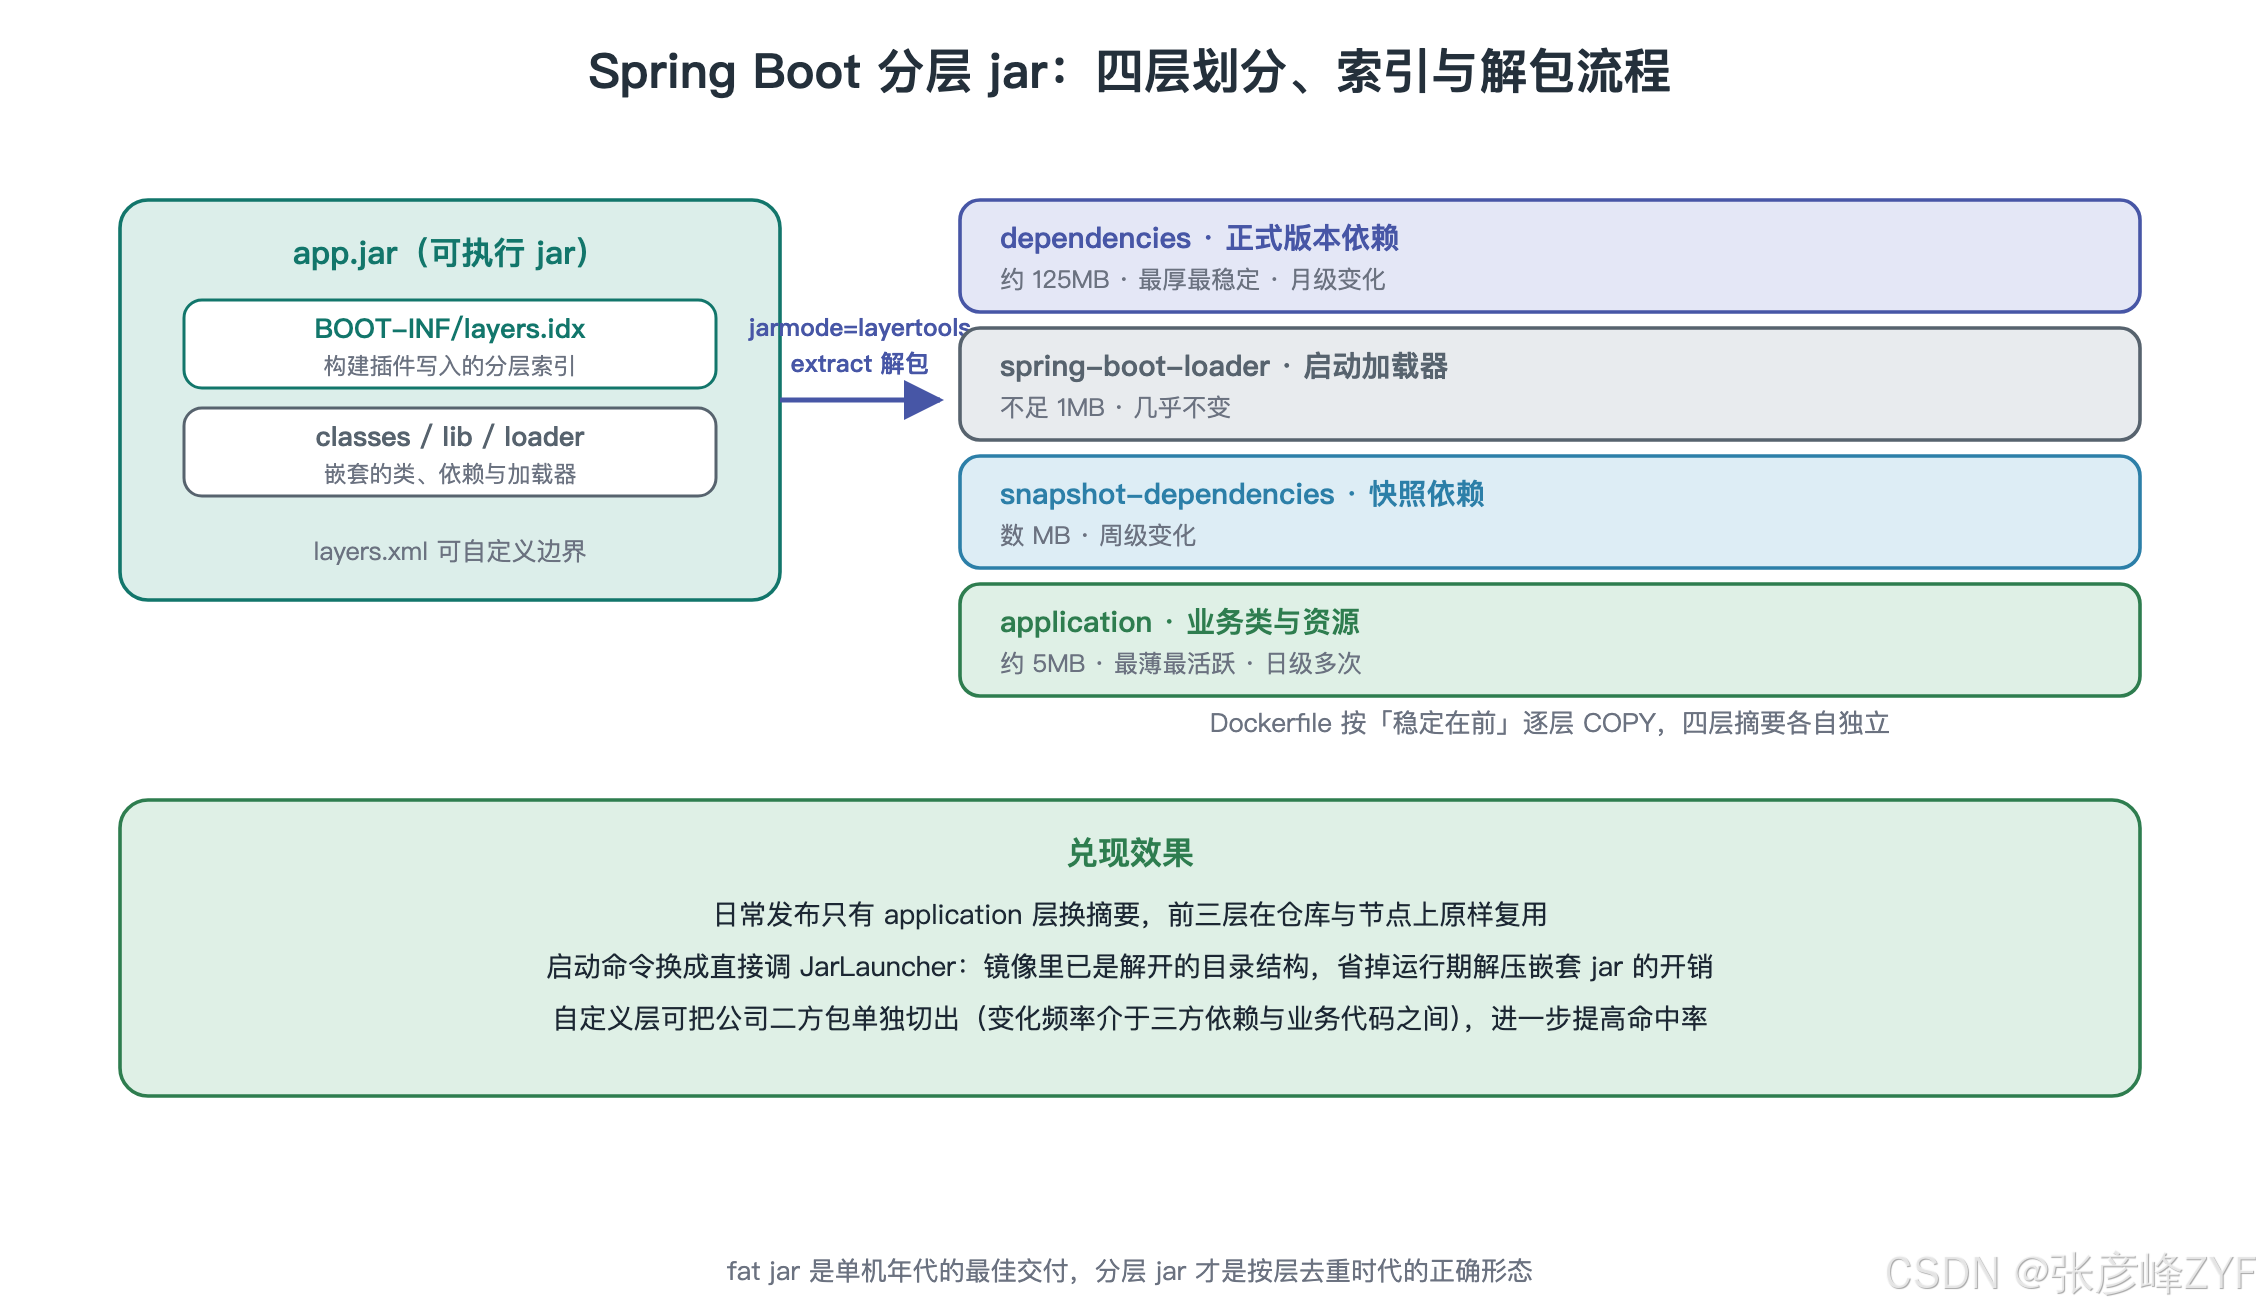
Spring Boot 2.3 起,构建插件默认在 jar 里写入一份分层索引(BOOT-INF/layers.idx),把内容按变化频率划成四层:
- dependencies:正式版本的第三方依赖——最厚、最稳定;
- spring-boot-loader:启动加载器类——几乎不变;
- snapshot-dependencies:SNAPSHOT 版本的依赖——比正式依赖变得勤;
- application:业务类与资源——最薄、变化最频繁。
jar 自带解包工具,能按索引把自己拆开(Boot 3.3 起也可用新的 -Djarmode=tools … extract –layers 形式):
java -Djarmode=layertools -jar app.jar extract
# 产出 dependencies/ spring-boot-loader/ snapshot-dependencies/ application/ 四个目录
分层的边界还可以用 layers.xml 自定义——比如把公司内部的二方包单独切一层(它的变化频率介于三方依赖与业务代码之间),进一步提高命中率。
(三)配套 Dockerfile 的写法与效果
拆层的成果要靠 Dockerfile 按"稳定在前"的次序逐层 COPY 才能兑现:
FROM eclipse-temurin:17-jre AS extractor
WORKDIR /tmp
COPY target/app.jar app.jar
RUN java -Djarmode=layertools -jar app.jar extract
FROM eclipse-temurin:17-jre
WORKDIR /app
COPY –from=extractor /tmp/dependencies/ ./
COPY –from=extractor /tmp/spring-boot-loader/ ./
COPY –from=extractor /tmp/snapshot-dependencies/ ./
COPY –from=extractor /tmp/application/ ./
ENTRYPOINT ["java", "org.springframework.boot.loader.launch.JarLauncher"]
四条 COPY 生成四个层,摘要各自独立。日常发布只有 application 层(几 MB)换摘要,前三层在 registry 与节点上原样复用;升级依赖的那一天 dependencies 层才重传一次。前文那本 780 GB 的月账,立即缩到 30 GB 以内。启动命令也从 java -jar 换成了直接调 JarLauncher(Boot 3.2 前是 org.springframework.boot.loader.JarLauncher),因为镜像里已经是解开的目录结构而不是嵌套 jar——顺带还省掉了运行期解压嵌套 jar 的开销。
到这里,Dockerfile 路线的最佳实践已经完整:多阶段 + 依赖清单先行 + 缓存挂载 + 分层 jar 逐层 COPY。但也要承认它的维护成本——这套纪律分散在 Dockerfile 的行序、.dockerignore、插件配置三个地方,每个新仓库都要手工复刻,每次有人"顺手调整"都可能悄悄破坏。有没有办法把纪律固化成工具的默认行为?这就是 Jib 的出发点。
六、Jib:把镜像构建交还给构建工具
(一)设计动机:无守护进程、无 Dockerfile、纪律内置
Jib 是 Google 开源的 Java 专用镜像构建器,以 Maven / Gradle 插件的形态存在。它的三个设计决定,恰好对应前几章手工维护的三条纪律。
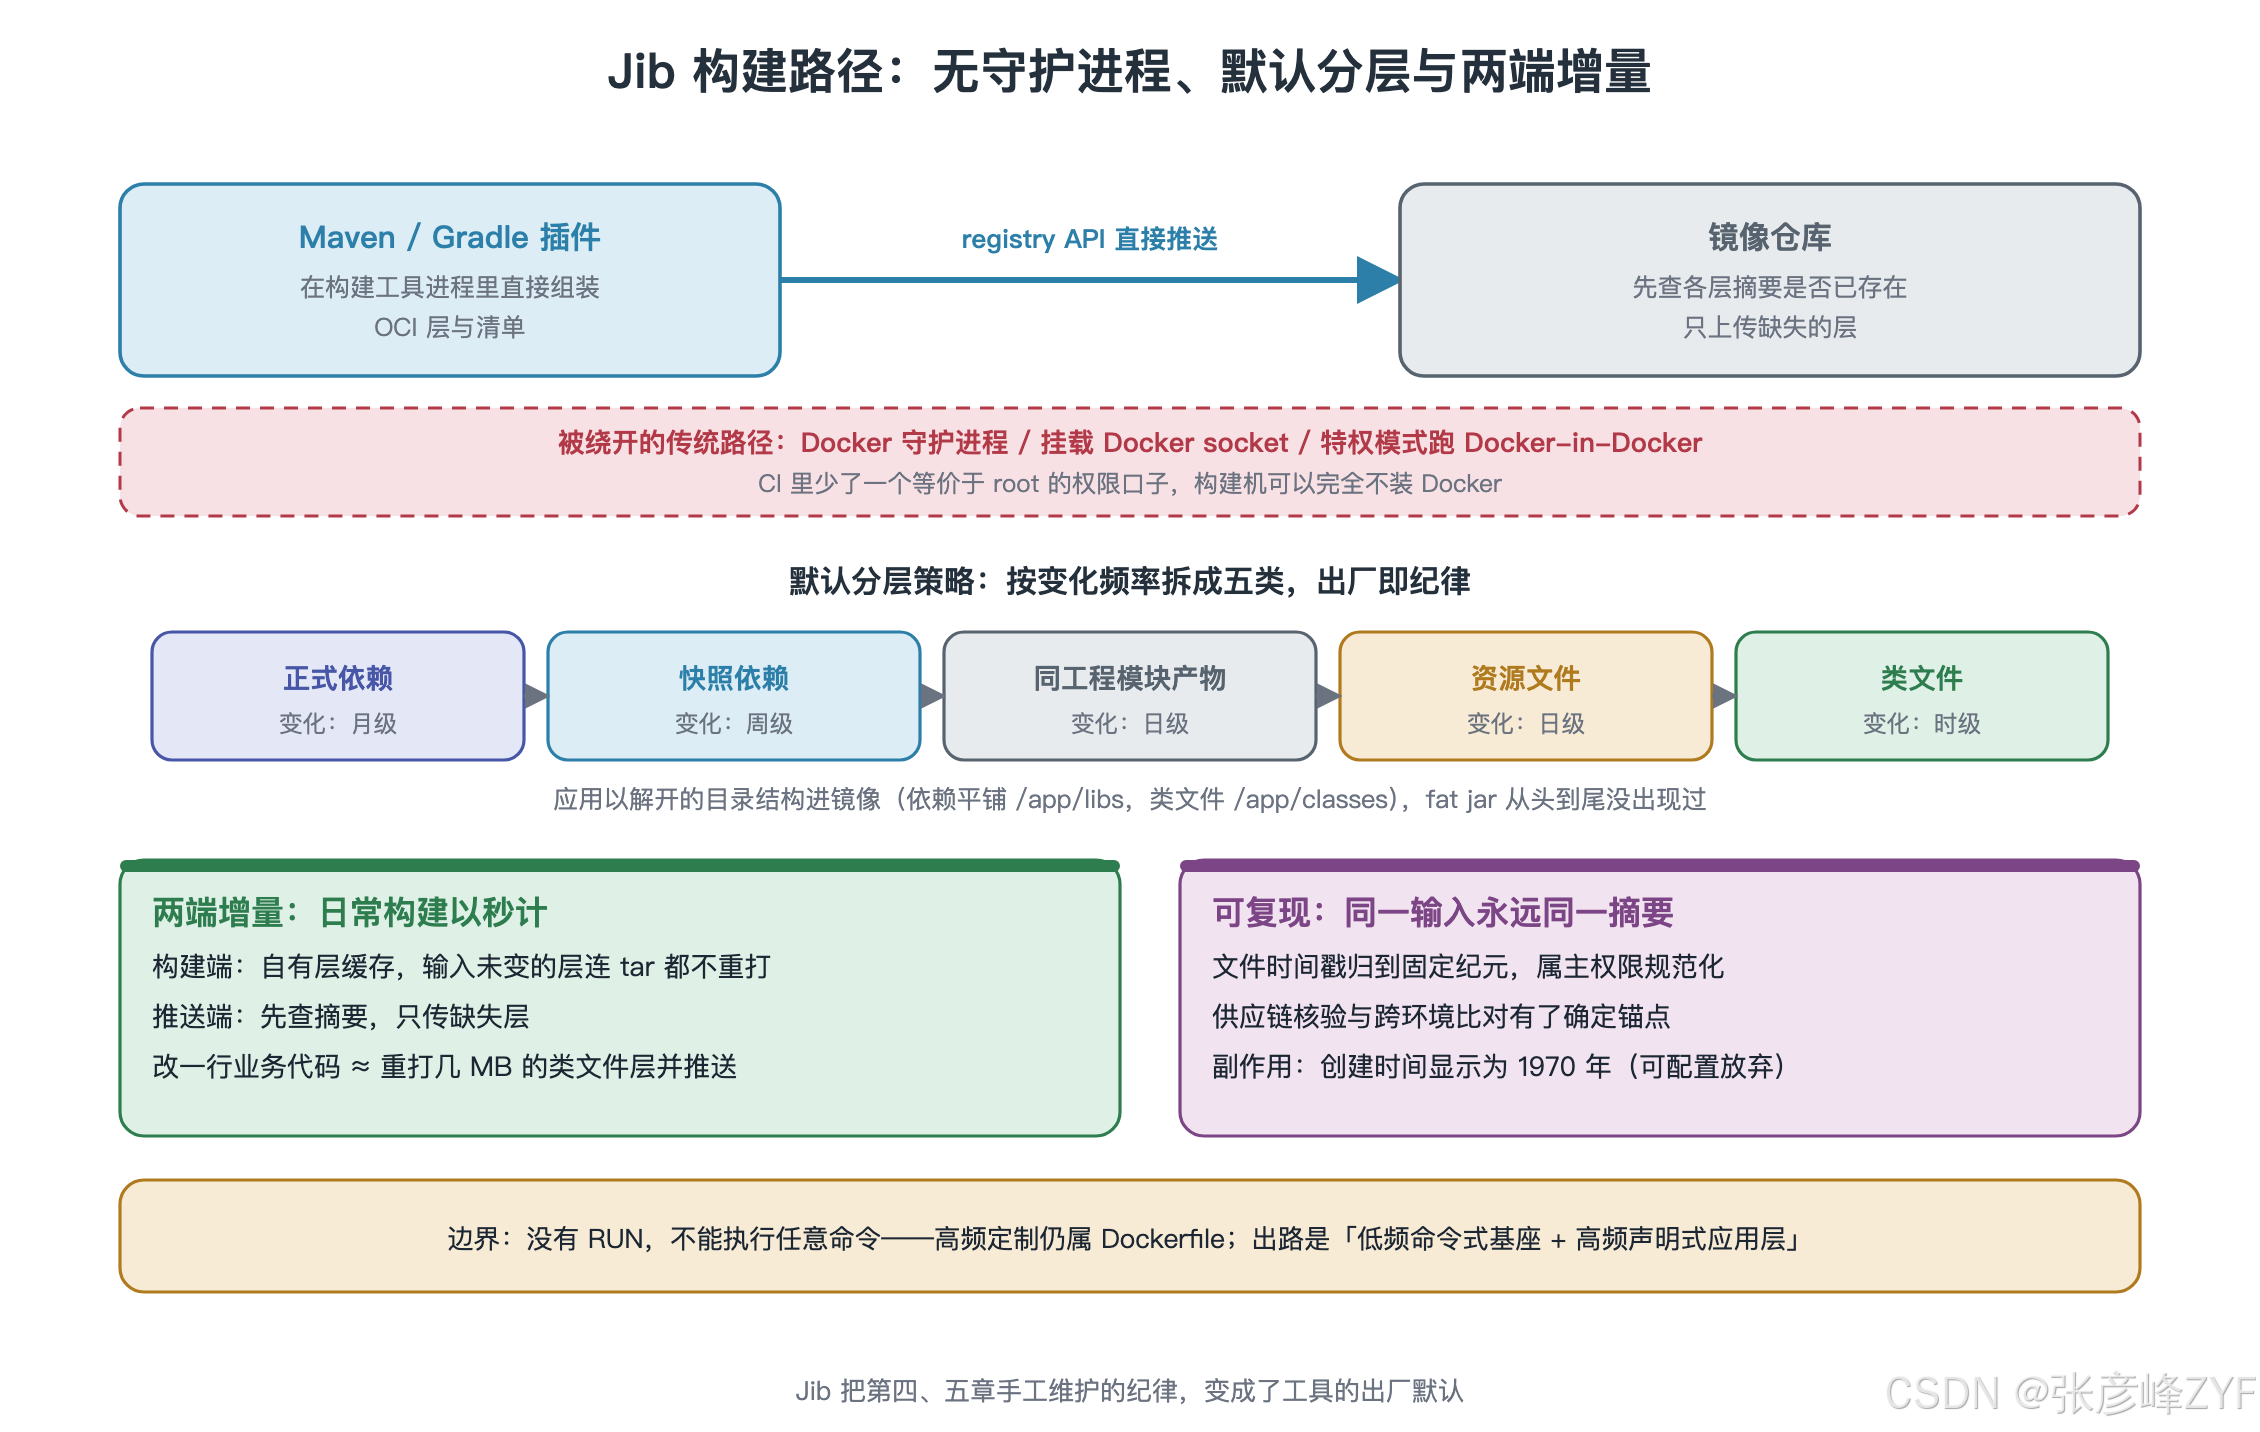
第一,不需要 Docker 守护进程。Jib 在构建工具的进程里直接组装 OCI 镜像的层与清单,然后走 registry API 推送。这对 CI 是实质性的解放:流水线容器里不必再挂载宿主机的 Docker socket(一个等价于 root 的权限口子),也不必开特权模式跑 Docker-in-Docker;构建机上甚至可以完全不安装 Docker。第二,不需要 Dockerfile。分层策略、基础镜像、入口命令全部在插件配置里声明,没有可以被"顺手改坏"的指令序列。第三,分层纪律是默认行为。不需要任何配置,Jib 就会把应用拆成多个按变化频率排序的层——第五章手工做的那套拆解,在这里是出厂设置。
<plugin>
<groupId>com.google.cloud.tools</groupId>
<artifactId>jib-maven-plugin</artifactId>
<version>3.4.4</version>
<configuration>
<from>
<!– 用摘要锁定基础镜像,构建结果不随标签漂移 –>
<image>eclipse-temurin:17-jre@sha256:0e8e…c3aa</image>
</from>
<to>
<image>registry.example.com/order-service</image>
<tags><tag>${git.commit.id.abbrev}</tag></tags>
</to>
<container>
<jvmFlags>
<jvmFlag>-XX:MaxRAMPercentage=70</jvmFlag>
<jvmFlag>-XX:+ExitOnOutOfMemoryError</jvmFlag>
</jvmFlags>
<ports><port>8080</port></ports>
<user>1000:1000</user>
<format>OCI</format>
</container>
</configuration>
</plugin>
mvn compile jib:build 直接构建并推送;jib:dockerBuild 在需要本地调试时把镜像装进本机守护进程;jib:buildTar 输出 tar 包供离线分发。Gradle 侧是同名的 jib 插件与一致的 DSL(jib.from.image、jib.to.image、jib.container.jvmFlags),任务名也对应为 jib、jibDockerBuild、jibBuildTar。仓库认证走 Maven settings.xml / Docker 凭据助手的既有链路,多架构镜像用 platforms 配置一次声明,Jib 会为每个平台组装清单并合成清单索引——这些在 Dockerfile 路线里要靠 buildx 另行搭建的能力,在插件配置里是几行声明。
(二)默认分层策略与增量推送
Jib 默认把应用内容拆成五类层,按稳定程度排序:正式版本依赖(dependencies)、SNAPSHOT 依赖(snapshot dependencies)、多模块工程里的同工程模块产物(project dependencies)、资源文件(resources)、编译后的类文件(classes)。比 Spring Boot 的四层又细了一档——把"本工程其他模块"从三方依赖里单独切出来,正对应中大型多模块工程里"二方产物变化频率居中"的现实。
增量发生在两端。构建端,Jib 维护自己的层缓存,输入没变的层直接复用,连 tar 都不重打;推送端,先向 registry 查询各层摘要是否已存在,只上传缺失的层。日常改业务代码时,一次 jib:build 往往只需数秒——重打一个几 MB 的 classes 层并推送。值得一提的是,Jib 组装的镜像里应用是解开的目录结构(依赖 jar 平铺在 /app/libs,类文件在 /app/classes),入口直接拼 classpath 启动主类,fat jar 从头到尾没有出现过。
(三)可复现构建:时间戳归零与摘要稳定
Docker 构建有一个隐蔽的不确定性来源:层 tar 里记录着文件的修改时间与所有者,RUN 的输出也可能包含时间戳。同一份源码构建两次,层摘要往往不同——缓存与去重的复用因此打折,"这个镜像是不是从这份代码构建出来的"也难以核验。
Jib 对此的选择是把可复现性当作默认值:文件修改时间统一归到固定纪元时刻,镜像创建时间默认取 1970-01-01T00:00:00Z,文件所有者、权限、条目顺序全部规范化。于是同一份输入永远产出同一个镜像摘要——供应链核验(从摘要反查构建输入)、跨环境比对(预发与生产是否同一镜像)都有了确定性的锚点。副作用是 docker images 里创建时间显示为"55 年前",让不少人误以为拉错了镜像;如果确实需要真实时间,可以设 <creationTime>USE_CURRENT_TIMESTAMP</creationTime>,但要清楚这是在用可复现性换一个显示友好。
(四)Jib 的边界
声明式的另一面是可表达能力的收窄,Jib 不适合的场景要摆在明处。它没有 RUN——不能在构建过程中执行任意命令,装字体、装原生库、改系统配置都做不到;出路是把这些操作预先做进一个团队自维护的基础镜像(用 Dockerfile 构建、低频更新),Jib 的 from.image 指向它,形成"低频命令式基座 + 高频声明式应用层"的两级结构。额外文件可以用 extraDirectories 塞入,但也仅限于拷文件。此外,Jib 是 Java 生态的专用工具,同一条流水线里的前端、Python 服务需要另一套方案。如果团队的镜像定制需求高频且复杂,Dockerfile + BuildKit 仍然是更顺的路。
(五)Dockerfile、Jib 与 Buildpacks 的选型对照
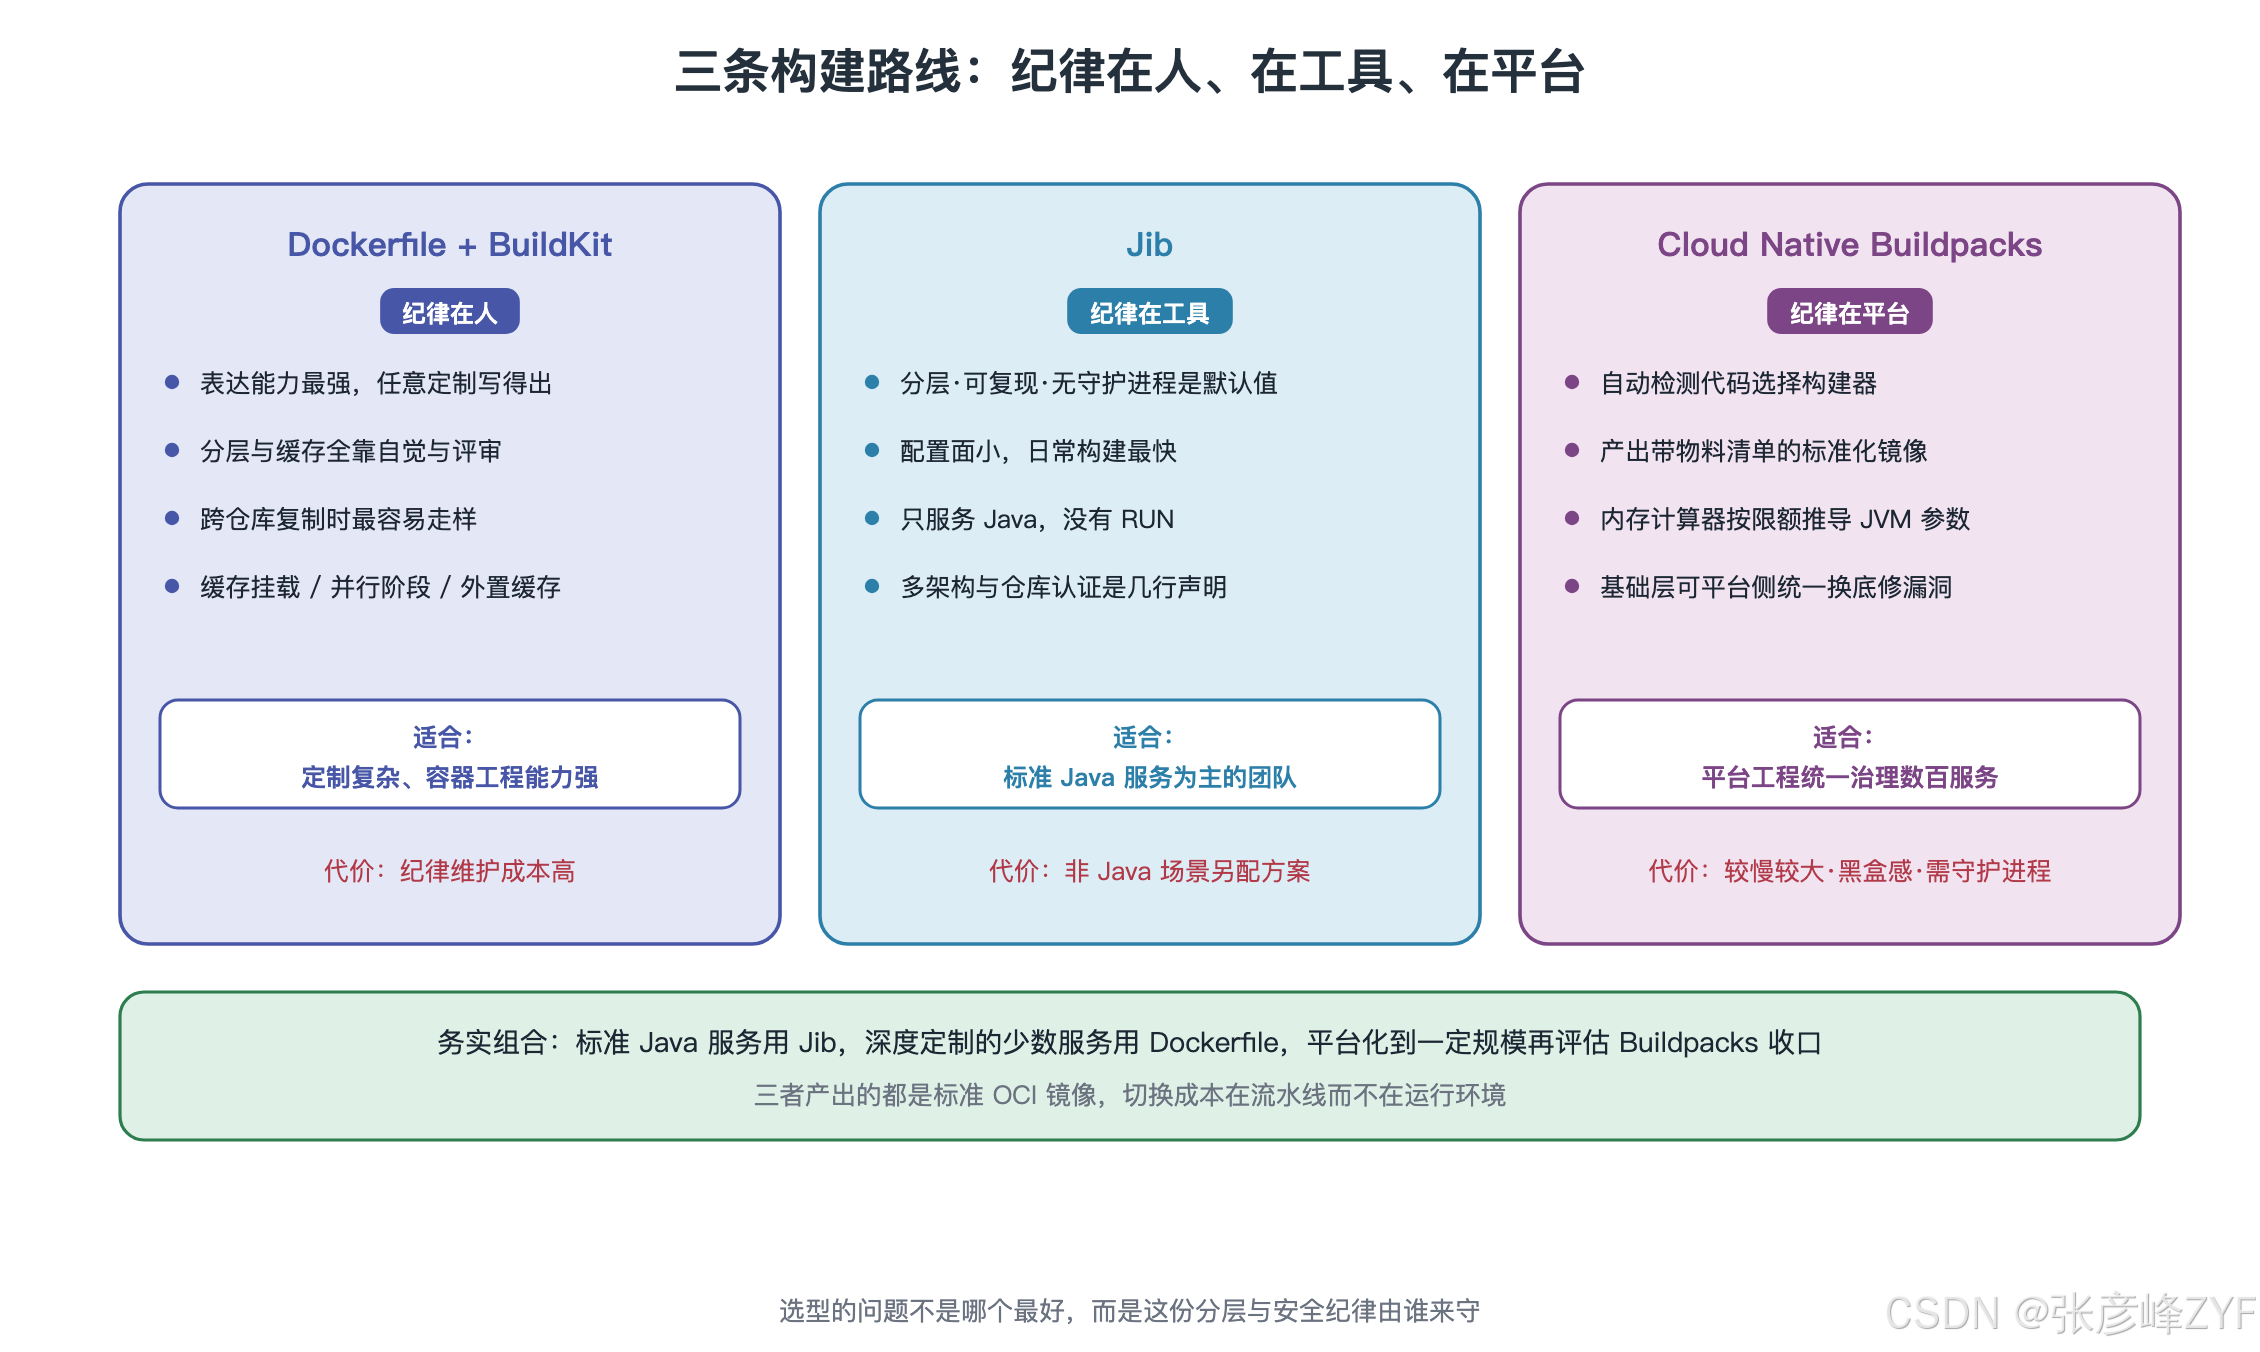
Java 生态实际上有三条镜像构建路线,各自的定位可以从"谁掌握纪律"来区分。
- Dockerfile + BuildKit:纪律在人。表达能力最强,任何定制都写得出来;代价是分层、缓存、安全基线全靠工程师自觉与评审把关,跨仓库复制时最易走样。适合镜像定制复杂、或团队已有强容器工程能力的场景。
- Jib:纪律在工具。分层、可复现、无守护进程是默认值,配置面小、上手成本低、日常构建最快;代价是只服务 Java、不能跑任意命令。适合以标准 Java / Spring 服务为主、追求流水线简洁与构建速度的团队。
- Cloud Native Buildpacks(Spring Boot 内置的 mvn spring-boot:build-image 走的就是 Paketo Buildpacks):纪律在平台。检测代码自动选择构建器,产出带 SBOM 的标准化镜像,内存计算器会按容器限额自动推导 JVM 参数,基础层可以在平台侧统一"换底"(rebase)修补漏洞;代价是首次构建较慢、镜像偏大、构建过程的黑盒感更强,且需要 Docker 守护进程。适合平台工程团队统一治理数百个服务的场景。
一个务实的组合是:标准 Java 服务用 Jib,少数需要深度定制的服务用 Dockerfile,平台化到一定规模后评估 Buildpacks 统一收口。三者产出的都是标准 OCI 镜像,切换成本主要在流水线而不在运行环境。
七、容器里的 JVM:资源视野、内存总账与参数标定
(一)JVM 看到的是谁的资源:从宿主机误读到容器感知
镜像做得再好,运行参数错了照样翻船。这一章从一个历史事故模式说起:JDK 8 早期版本的 JVM 跑在"限额 2 GB"的容器里,却按宿主机 64 GB 内存推导默认堆——最大堆取物理内存的四分之一即 16 GB,远超容器限额,进程在堆还远未到达 -Xmx 时就被内核 OOM killer 击毙。CPU 同理:availableProcessors 返回宿主机的 64 核,GC 线程、JIT 编译线程、ForkJoinPool.commonPool 全按 64 核配置,在 2 核的配额里挤成一团,上下文切换与 CFS 节流把延迟抬得面目全非。
补课的时间线值得记住,因为它直接决定基础镜像里 JDK 版本的底线:8u131 引入实验性的 cgroup 内存感知参数;JDK 10 引入 UseContainerSupport 并默认开启,回移到 8u191,JVM 开始自动按 cgroups 限额推导内存与 CPU;cgroups v2 的支持 JDK 15 才加入,回移到 11.0.16 与 8u372。最后一条在今天最容易踩:新版 Linux 发行版与 Kubernetes 节点普遍已切到 cgroups v2,一个 11.0.15 的镜像跑上去,容器感知会静默失效,退回读宿主机资源——没有任何告警,只有莫名其妙的 OOMKilled。结论:容器里的 JDK 版本底线是 8u372 / 11.0.16 / 17 及以上,用 java -XshowSettings:system -version(Linux 上会打印容器信息)可以现场核验 JVM 到底看见了什么。
(二)堆只是一部分:容器限额下的内存总账
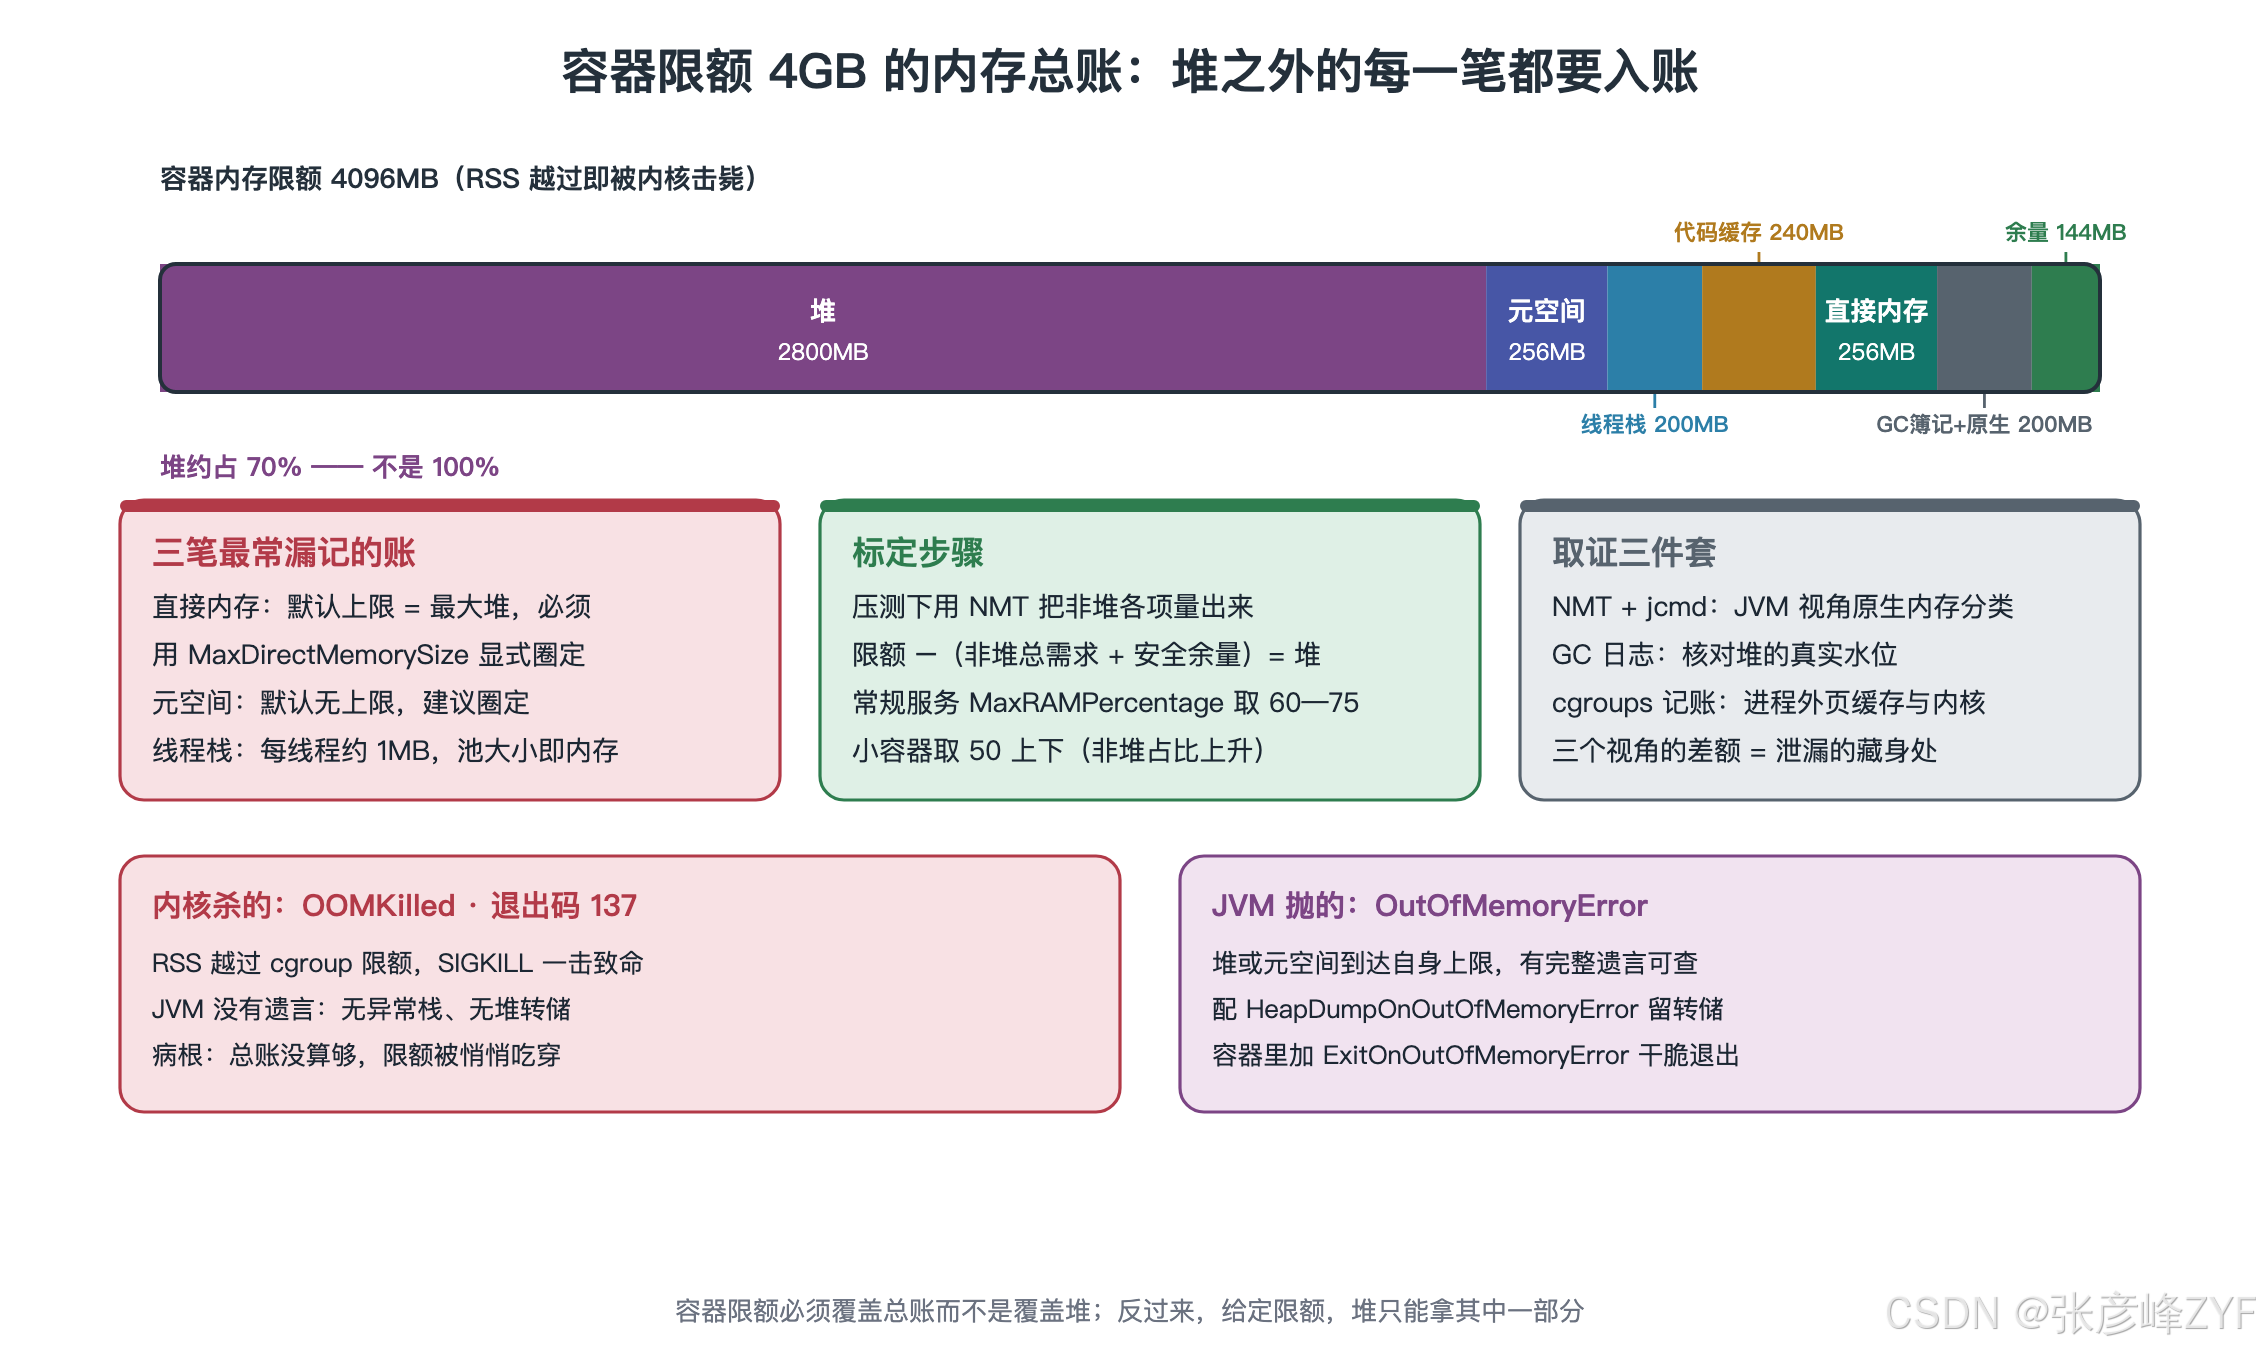
第二个高频误区是把容器限额都给堆:限额 4 GB 就设 -Xmx4g。JVM 进程的常驻内存远不止堆,一本完整的总账至少包含——
- 堆(-Xmx):对象所在地,账本上最大的一笔,但通常只占总额的 50%—75%;
- 元空间(Metaspace):类元数据,Spring 应用常见 100—300 MB,默认无上限,建议用 -XX:MaxMetaspaceSize 圈定;
- 线程栈:每线程默认约 1 MB,200 个线程就是 200 MB——线程池配置直接出现在内存账上;
- 代码缓存(JIT 编译产物):默认上限约 240 MB;
- 直接内存:NIO 的 DirectByteBuffer,Netty 类应用的大头,默认上限等于最大堆,务必用 -XX:MaxDirectMemorySize 显式圈定;
- GC 自身的簿记:G1 的记忆集等结构,堆越大占得越多,可达堆的 5%—10%;
- 原生库与 malloc 碎片:JNI 库、glibc arena 碎片,长期运行不可忽略。
这本账解释了 OOMKilled 的典型剧本:堆用得好好的,直接内存或元空间悄悄涨,进程总 RSS 越过容器限额,内核一击致命。容器限额必须覆盖总账,而不是覆盖堆;反过来说,给定限额,堆只能拿其中一部分。
(三)MaxRAMPercentage 的标定与 OOMKilled 的甄别
1、两种死法的甄别
内存问题在容器里有两种截然不同的死法,处置路径完全不同,第一步永远是先分清是哪一种。
1.1、内核杀的:OOMKilled
进程 RSS 超过 cgroup 限额,内核 OOM killer 直接 SIGKILL,退出码 137(128+9)。特征是 JVM 没有任何遗言——没有异常栈、没有堆转储、没有 GC 日志的异常收尾。取证看容器编排层:kubectl describe pod 里的 Reason: OOMKilled、节点内核日志里的 oom_kill 记录。病根通常是总账没算够:限额太紧、堆比例太高、直接内存或元空间未圈定、线程数失控。
1.2、JVM 抛的:OutOfMemoryError
堆或元空间到达自己的上限,JVM 抛 OutOfMemoryError,进程未必退出。特征是有完整遗言:异常栈标明是 Java heap space 还是 Metaspace,配合 -XX:+HeapDumpOnOutOfMemoryError 有堆转储可查。病根在应用内部:泄漏、缓存失控、批处理一次读入过多。容器场景建议加 -XX:+ExitOnOutOfMemoryError,让进程干脆退出交给编排器重启,避免半死不活的僵尸态继续接流量。
2、堆比例的标定方法
现代 JVM 提供按百分比设堆的参数,容器里应当用它替代绝对值的 -Xmx:-XX:MaxRAMPercentage(默认 25,对容器场景明显偏保守)。标定步骤:先在压测下用 NMT 与 jcmd 把非堆各项量出来,得到"非堆总需求 + 安全余量";限额减去它,剩下的才是堆的空间。经验起点:限额 ≥ 2 GB 的常规 Web 服务取 60—75;限额 1 GB 以下的小容器取 50 上下(非堆开销的占比随限额缩小而上升,小容器还要留意 MinRAMPercentage 在小内存下的介入逻辑);Netty / 大量直接内存的网关类服务,先把 MaxDirectMemorySize 圈死,再按剩余空间标堆。改比例不改限额、改限额不改参数,都是这套换算的破坏者——所以更推荐把参数写成随限额浮动的百分比,而不是各处硬编码的 -Xmx。
3、被杀之后的取证工具
事后取证的三件套:-XX:NativeMemoryTracking=summary 配合 jcmd <pid> VM.native_memory summary,把 JVM 视角的原生内存分类列账(注意 NMT 看不见 JNI 库自行 malloc 的部分);jcmd GC.heap_info 与 GC 日志核对堆的真实水位;容器层的 memory.current / memory.stat(cgroups v2)核对进程外的页缓存与内核记账。三个视角对不上的差额,通常就是直接内存或原生泄漏的藏身处。
(四)CPU 配额的连锁反应:GC 线程、JIT 与默认并行度
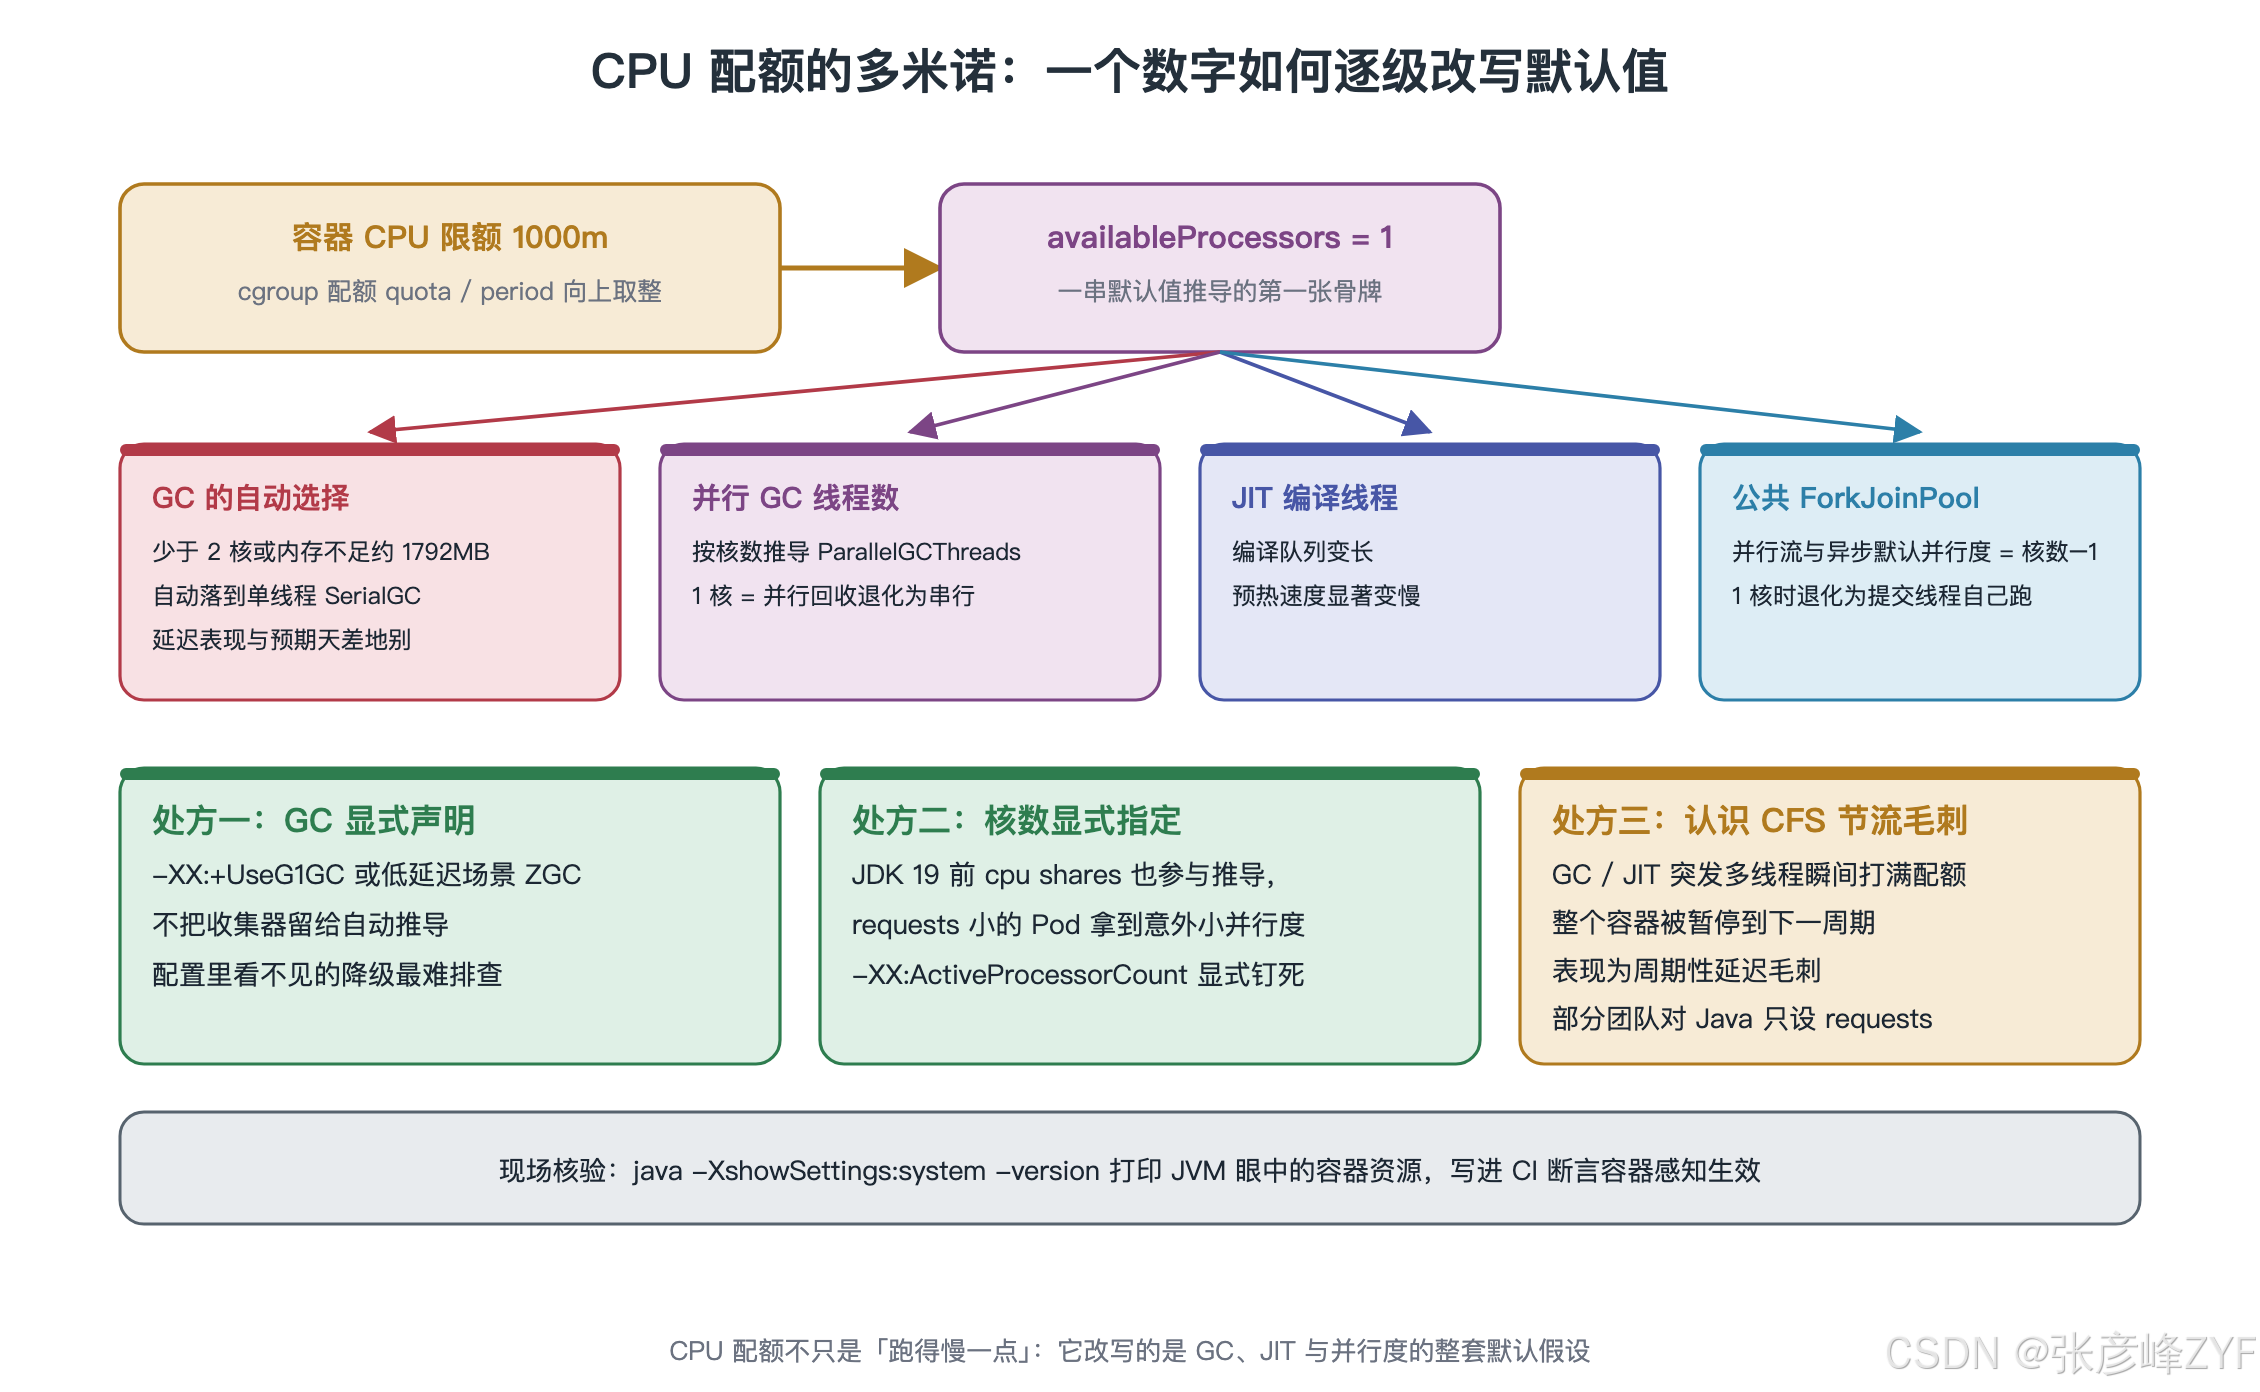
内存之外,CPU 配额的影响更隐蔽,因为它作用在一连串"按核数推导"的默认值上。容器感知开启后,availableProcessors 按 cgroup 的 quota/period 向上取整(例如 Kubernetes 里 limits.cpu: 1500m 得到 2)。这个数字是一串多米诺骨牌的第一张:并行 GC 线程数、JIT 编译线程数、ForkJoinPool.commonPool 的并行度、各类库里 Runtime.getRuntime().availableProcessors() 的自适应逻辑,全都从它推导。
最经典的连锁事故是 GC 选择的降级:JVM 的自动倾向在"至少 2 个可用核 + 至少约 1792 MB 可用内存"才会选 G1 这类服务端收集器,否则落到 SerialGC。一个 limits.cpu: 1000m 的容器,availableProcessors 为 1,默认拿到的是单线程的 Serial GC——延迟表现与预期天差地别,而配置里没有任何一行提到过 GC。所以容器里 GC 要显式声明(-XX:+UseG1GC 或低延迟场景的 ZGC),不留给自动推导。
另外两条要点:其一,历史上 JVM 还会按 cpu shares(Kubernetes 的 requests 折算值)推导核数,导致"requests 很小、limits 很大"的 Pod 拿到出乎意料的小并行度,JDK 19 起默认关闭了这一行为(UseContainerCpuShares 默认 false),老版本可用 -XX:ActiveProcessorCount 显式指定;其二,CPU limit 走 CFS 配额节流,GC 或 JIT 的突发多线程会瞬间打满配额然后被整体暂停,表现为周期性的延迟毛刺,这也是不少团队对 Java 服务"设 requests 不设 CPU limit"的原因——是否采纳取决于集群的隔离策略,但至少要知道毛刺可能从这里来。
(五)一套可以起步的容器 JVM 参数模板
把本章的结论落成一份可以直接放进 Jib jvmFlags 或 ENTRYPOINT 的起步模板(按需裁剪,压测后微调):
java \\
-XX:MaxRAMPercentage=70.0 \\
-XX:InitialRAMPercentage=70.0 \\ # 常驻服务堆一步到位,避免反复扩容
-XX:MaxMetaspaceSize=256m \\
-XX:MaxDirectMemorySize=256m \\
-XX:+UseG1GC \\ # 显式声明,不吃自动降级
-XX:+ExitOnOutOfMemoryError \\
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/dump \\
-Xlog:gc*:file=/logs/gc.log:time,uptime:filecount=5,filesize=20m \\
-jar app.jar
配合两条编排侧约定:内存 requests 与 limits 设成相等(避免节点内存超卖时被优先牺牲);JDK 版本核验写进 CI(镜像里跑一次 java -XshowSettings:system -version,断言容器感知生效)。参数模板不是终点,是让每个服务从一个已知安全的基线出发,而不是从某台测试机的 -Xmx4g 出发。
八、启动提速:类加载账单、CDS 与更激进的路线
(一)类加载的账单与 CDS / AppCDS
一个中等规模的 Spring Boot 应用启动时要加载一到两万个类,每个类都要经历读取、解析、校验、初始化——这笔账单在每个容器副本启动时原样重付一遍,而弹性伸缩与滚动发布让"启动"从低频事件变成了高频事件。类数据共享(CDS)的思路是把这笔账单预结算:把解析校验后的类元数据存成归档文件,启动时内存映射直接用,同机多个 JVM 还能共享这块只读内存。JDK 10 的 AppCDS(JEP 310)把范围从 JDK 类扩展到应用类,JDK 13 的动态归档(JEP 350)把"跑一遍训练、退出时自动落档"变成一个参数:
# 训练跑:正常启动一次,退出时生成归档
java -XX:ArchiveClassesAtExit=app.jsa -jar app.jar –exit-after-startup
# 生产跑:挂载归档启动
java -XX:SharedArchiveFile=app.jsa -jar app.jar
对 Spring Boot 应用,实测普遍能省下 30%—40% 的启动时间,代价几乎只有镜像里多一个几十 MB 的归档文件。Spring Boot 3.3 起对 CDS 有一等支持(配合解包后的目录结构做训练跑),Buildpacks 也能自动完成这套流程。注意归档与 JDK 版本、classpath 布局强绑定——这正好和"可复现镜像"形成互相成全:镜像内容确定,归档才稳定有效。
(二)更激进的路线:AOT、CRaC 与原生镜像
CDS 之上还有三档更激进的选择,代价依次上升。Spring 的 AOT 处理把大量运行期的条件装配决策前移到构建期,与 CDS 叠加使用;CRaC(Coordinated Restore at Checkpoint)在进程完全预热后打快照,恢复时间可到百毫秒级,但要求应用与所有依赖正确处理"暂停—恢复"生命周期(连接、文件句柄的重建),生态还在铺开中;GraalVM 原生镜像把启动时间压到几十毫秒、内存占用砍半,但换来了封闭世界假设——反射、动态代理、资源加载都要有构建期配置,构建一次十几分钟,且峰值吞吐通常不及 JIT 充分预热后的 HotSpot。选型判据是场景的启动敏感度:常驻服务的滚动发布,CDS 足矣;Serverless 与 scale-to-zero,才轮到原生镜像正面登场。
九、送进流水线:CI 上的镜像工程纪律
(一)标签纪律与基础镜像锁定
镜像的引用方式决定了发布的确定性。两条纪律:产出的应用镜像用不可变标签——版本号或 git 提交号(如 app:1.4.2-9f8e7d6),禁止用 latest 部署生产,回滚才有明确的对象;引用的基础镜像用摘要锁定——FROM eclipse-temurin:17-jre@sha256:…,标签是会漂移的(同一个 17-jre 明天可能指向新构建),摘要才是内容的身份证。锁定之后的更新不靠人肉,交给 Renovate / Dependabot 这类工具提 PR,让基础镜像升级像依赖升级一样走评审与回归。
(二)缓存外置与构建提速的流水线视角
第四章的外置缓存(–cache-to/–cache-from type=registry,mode=max)与第六章 Jib 的 registry 增量,解决的是同一个问题:无状态构建机上的缓存复用。流水线还有两笔时间账值得记:一是构建上下文的发送时间——.dockerignore 不全的仓库,光传上下文就能占掉半分钟;二是多架构构建(amd64 + arm64)会成倍放大所有低效——在双架构成为常态的今天,前几章每一项优化的收益都要乘二来算。
(三)安全面:非 root、扫描与最小攻击面
安全检查应当在流水线里而不是在上线评审会上。四条基线:进程以非 root 运行(Dockerfile 里 USER,Jib 里 container.user);镜像扫描(Trivy / Grype)挡在推送之前,高危漏洞直接失败;SBOM(软件物料清单)随镜像归档,供应链问责有账可查;运行时能上只读根文件系统就上(可写目录用显式挂载点圈定)。基础镜像章节的选型在这里兑现红利:distroless 或精简 JRE 的扫描报告,比完整 JDK 干净一个数量级——没装的包不需要修补。
(四)上线自查清单
把全文收敛成一张发布前的自查清单:
- 最终镜像是否只含运行所需?(多阶段构建;运行阶段无 JDK、无源码、无构建工具)
- 依赖与业务代码是否分层?(分层 jar 逐层 COPY,或 Jib 默认分层;改一行代码只推几 MB)
- Dockerfile 的层序是否按变化频率排列?依赖下载是否可被缓存命中?(.dockerignore 齐全,pom 先行,或缓存挂载)
- CI 是否有跨任务缓存?(registry 外置缓存,或 Jib 增量推送)
- 基础镜像是否摘要锁定、应用镜像是否不可变标签?
- JDK 版本是否 ≥ 8u372 / 11.0.16 / 17,容器感知是否核验过?
- 堆是否按百分比标定,直接内存与元空间是否圈定,GC 是否显式声明?
- OOM 处置是否配好?(ExitOnOutOfMemoryError + 堆转储路径 + GC 日志)
- 是否非 root 运行、扫描是否通过、SBOM 是否归档?
- 启动敏感的服务是否评估过 CDS?
十、写在最后
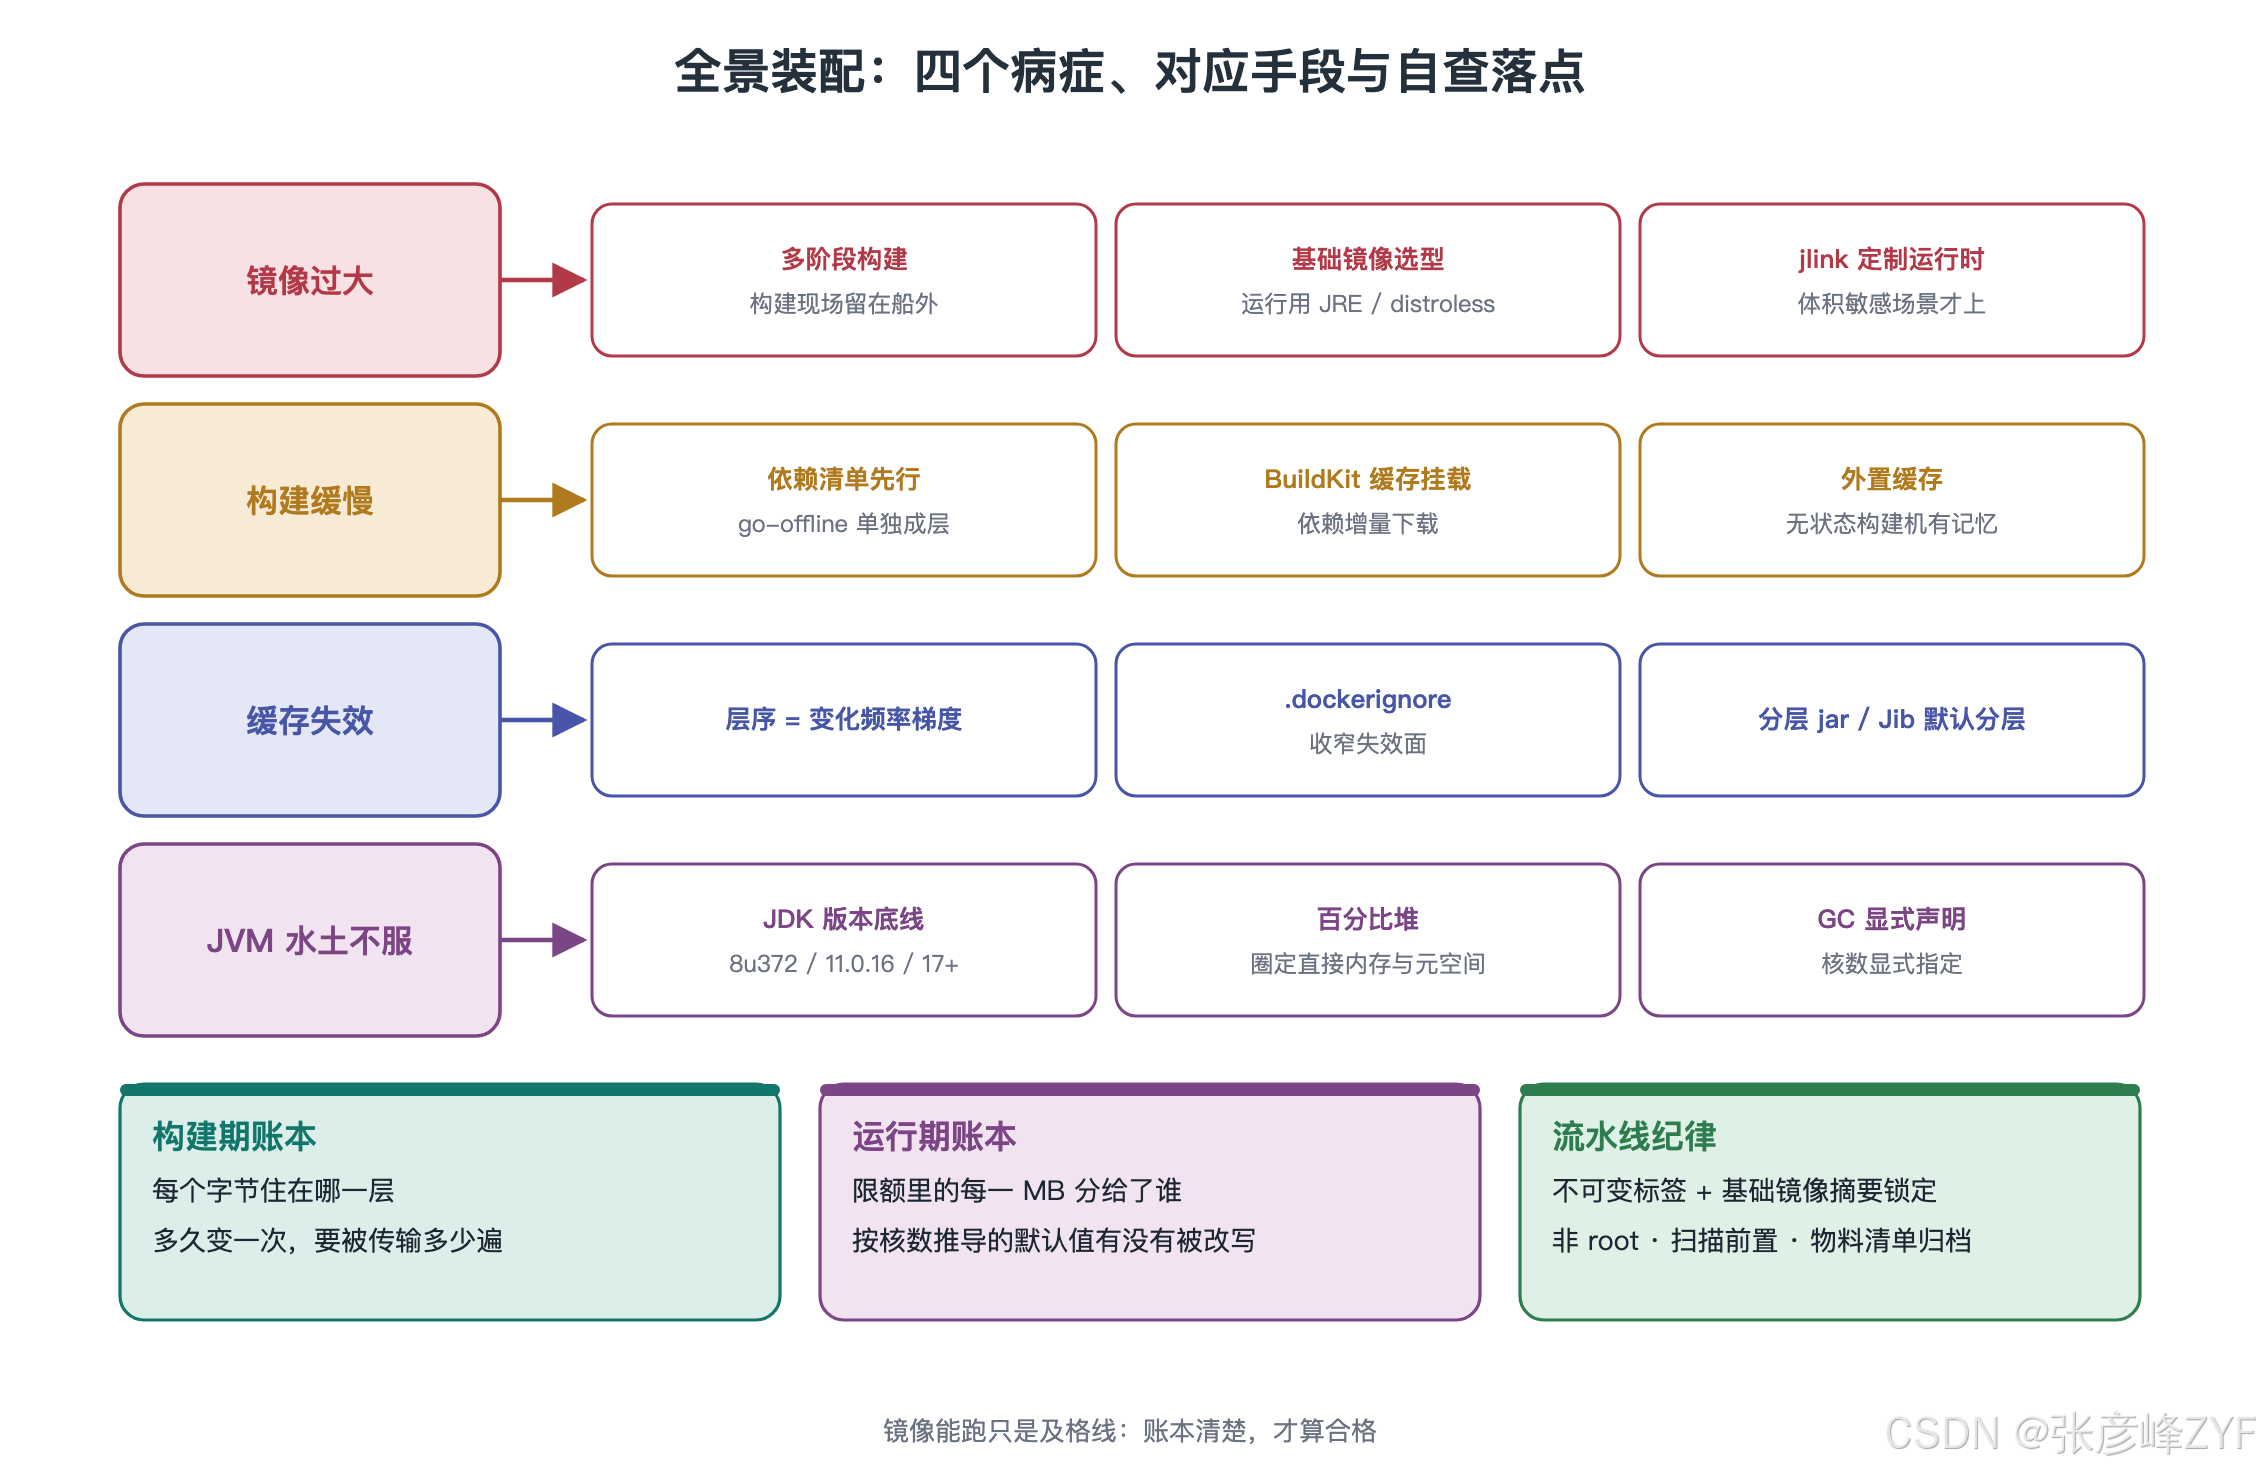
回看全文的推演线索:镜像过大、构建缓慢、缓存失效三个病症,病根都在没有按分层模型思考——层的身份是内容摘要,缓存与传输按层去重,于是一切优化都归结为一句话:让变化频率不同的内容住在不同的层里,稳定的层排在前面。多阶段构建把构建现场挡在船外,分层 jar 把 fat jar 拆回频率梯度,Jib 把这套纪律变成工具的出厂默认。而第四个病症——JVM 的水土不服——提醒我们镜像工程不止于"把东西装进去":装进去的运行时必须看得见容器的资源边界,堆之外的每一笔内存要入账,按核数推导的每一个默认值都可能被 CPU 配额改写。
更一般的结论是:容器交付的质量由两份"账本意识"决定。一份是构建期的分层账——每个字节住在哪一层、多久变一次、要被传输多少遍;一份是运行期的资源账——限额里的每一 MB 分给了谁、每一个核被谁的线程分享。工具在进步,Jib 与 Buildpacks 把越来越多的纪律固化成默认值,但读懂账本的人才知道默认值什么时候该改、改错了会在哪里翻船。镜像能跑只是及格线,账本清楚才算合格。
参考资料
- Docker 官方文档:存储驱动与镜像分层(Storage drivers) —— Storage drivers | Docker Docs
- Docker 官方文档:构建缓存机制与失效规则(Build cache) —— Docker build cache | Docker Docs
- Docker 官方文档:多阶段构建(Multi-stage builds) —— Multi-stage builds | Docker Docs
- Dockerfile 参考:RUN –mount=type=cache 缓存挂载 —— Dockerfile reference | Docker Docs
- Jib 项目主页(GoogleContainerTools) —— GitHub – GoogleContainerTools/jib: 🏗 Build container images for your Java applications. · GitHub
- Jib FAQ:可复现构建与时间戳策略 —— jib/docs/faq.md at master · GoogleContainerTools/jib · GitHub
- Spring Boot 官方文档:Container Images(分层 jar 与高效镜像) —— Container Images :: Spring Boot
- Spring Boot 官方文档:Class Data Sharing 支持 —— https://docs.spring.io/spring-boot/reference/packaging/class-data-sharing.html
- distroless 项目(GoogleContainerTools) —— GitHub – GoogleContainerTools/distroless: 🥑 Language focused docker images, minus the operating system. · GitHub
- jlink 官方手册(JDK 17) —— The jlink Command
- jdeps 官方手册(JDK 17) —— https://docs.oracle.com/en/java/javase/17/docs/specs/man/jdeps.html
- OpenJDK:JDK-8146115 Improve docker container detection and resource usage(容器感知) —— https://bugs.openjdk.org/browse/JDK-8146115
- OpenJDK:JDK-8230305 cgroups v2 支持 —— https://bugs.openjdk.org/browse/JDK-8230305
- JEP 310: Application Class-Data Sharing —— JEP 310: Application Class-Data Sharing
- JEP 350: Dynamic CDS Archives —— JEP 350: Dynamic CDS Archives
- Cloud Native Buildpacks 官网 —— Cloud Native Buildpacks · Cloud Native Buildpacks
- Paketo Buildpacks:Java Buildpack 文档(含内存计算器) —— How to Build Java Apps with Paketo Buildpacks – Paketo Buildpacks
- Eclipse Temurin 官方镜像(Docker Hub) —— https://hub.docker.com/_/eclipse-temurin
- GraalVM Native Image 参考手册 —— Native Image
- OpenJDK CRaC 项目 —— OpenJDK: CRaC
- Trivy 镜像扫描器(Aqua Security) —— GitHub – aquasecurity/trivy: Find vulnerabilities, misconfigurations, secrets, SBOM in containers, Kubernetes, code repositories, clouds and more · GitHub
- dive:镜像逐层分析工具 —— GitHub – wagoodman/dive: A tool for exploring each layer in a docker image · GitHub


