/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
基于 Linux 6.6 + glibc 2.35 梳理。代码片段均为可编译的最小示例,参数值为发行版默认值,落地前请在你的环境核对。文中不含实测数据。
上一篇拆了缺页的机制,这一篇只讲怎么把它从运行期挪到启动期。
先给结论:mlockall() 加在 main() 第二行,是错的。 它既锁不住后面才分配的内存,又会在你最不希望的时候做一次几万页的缺页——两头不讨好。正确的位置取决于一个顺序,而这个顺序比函数本身重要得多。
一、启动序:七个阶段,一步都不能换
一个实时进程从 main() 到进入周期循环,应该严格按这个顺序走:
| 1 | 读配置、解析参数(用静态缓冲区) | 放在后面会把堆搞碎 |
| 2 | 绑定 NUMA 节点 / CPU | 放在分配之后,所有页都落在错误的 node |
| 3 | 一次性分配全部内存(堆、缓冲、队列) | 放在 mlock 之后,锁不住 |
| 4 | 逐页预触(写一遍) | 不写,缺页全部推迟到运行期 |
| 5 | mlockall(MCL_CURRENT) | 放在第 3 步之前等于什么都没锁 |
| 6 | 设线程优先级、sched_setaffinity | 放在 4 之前,预触会跑在错误的核上 |
| 7 | 关掉日志/printf,进循环 | 忘了关,printf 的 write 会阻塞 |
第 2 步和第 6 步是两件事,很多人混在一起。numactl –membind 决定页落在哪个节点,sched_setaffinity 决定线程在哪个核上跑。理想状态是两者一致:线程跑在 node 0 的核上,用的内存也在 node 0。
顺序里最反直觉的是第 2 步要放在第 3 步之前。因为页的归属由第一次触碰它的 CPU 决定(first touch),如果你先 malloc 再绑核,那这些页已经落在启动时所在的那个 node 上了,之后 mbind() 迁移会引入额外的拷贝和 TLB 刷新——而且迁移是异步的,你不知道什么时候完成。
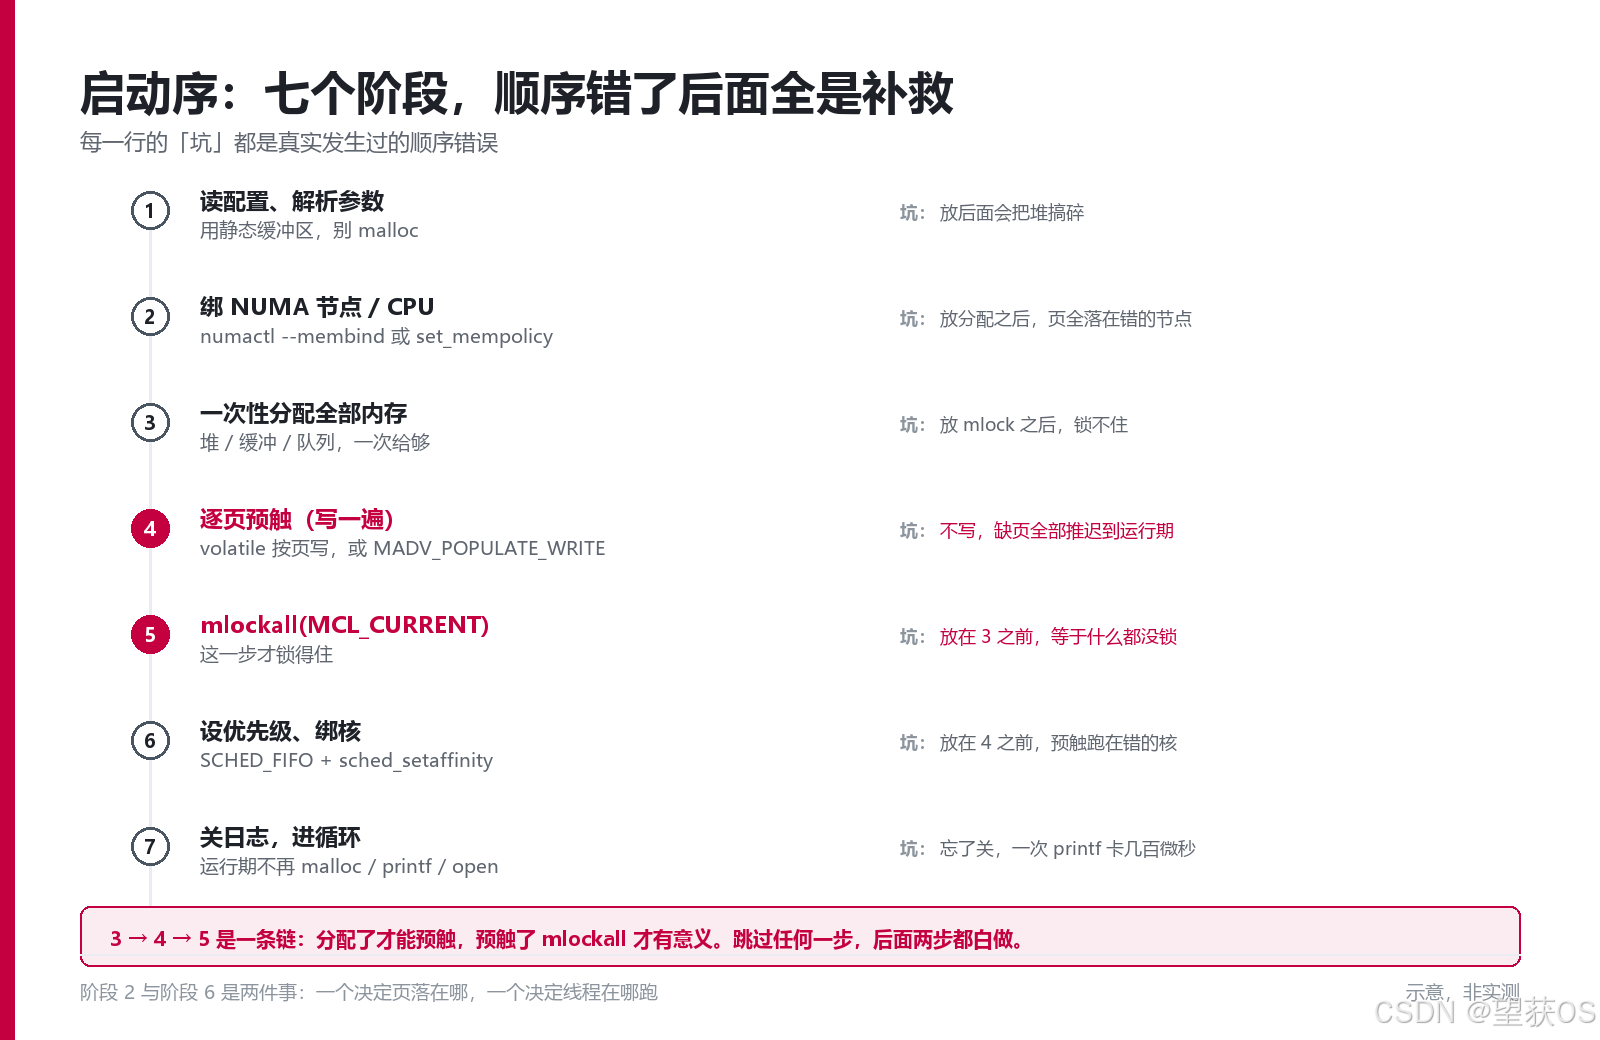
图1:第 2、3、4、5 步环环相扣——顺序错了,后面每一步都在补救前一步。
为什么第 7 步也算在内
printf 到终端是行缓冲,到管道是全缓冲。缓冲区在 libc 里,mlockall 之后分配的话就是未锁定的;更麻烦的是 write() 到慢速终端会阻塞——一次 printf 让 RT 线程卡几百微秒是常见事故。
实时路径上要么完全不打日志,要么走"写入无锁环形缓冲区 + 另一个低优先级线程落盘"的模式。环形缓冲区的内存在第 3 步就分配好。
二、mlockall 的三种组合,各自的边界
#include <sys/mman.h>
int mlockall(int flags); /* MCL_CURRENT | MCL_FUTURE | MCL_ONFAULT */
| MCL_CURRENT | 调用时刻已存在的所有 VMA | 会,逐页 fault | 推荐默认选择 |
| MCL_FUTURE | 调用之后新建的所有 VMA | 不会 | 单独用没意义,见坑 1 |
| MCL_CURRENT|MCL_FUTURE | 全部 | 已存在的会,未来不会 | 只在"运行期确实要分配"时用 |
| + MCL_ONFAULT | 同上,但遇缺页才锁 | 不会 | 内存远超 RLIMIT_MEMLOCK 时 |
| mlock2(addr,len,MLOCK_ONFAULT) | 指定区间,遇缺页才锁 | 不会 | 精确控制,4.4+ |
坑 1:MCL_FUTURE 会让后续 mmap 直接失败。
带 MCL_FUTURE 之后,任何新的映射在内核里都要先尝试锁定。如果 RLIMIT_MEMLOCK 不够,mmap() 返回 ENOMEM——dlopen() 一个 so、pthread_create 分配栈、甚至 libc 内部某些懒分配都会失败。现象很怪:程序跑一阵突然报"无法加载库"。
坑 2:mlock() 不跨 fork 继承,exec 后全部清除。
子进程从零开始。如果你用 fork() 起子进程,子进程要重新 mlockall。线程(CLONE_VM)共享 mm,锁是共享的,不受影响。
坑 3:MCL_CURRENT 本身很慢。
它要逐页 fault 整个地址空间。一个 200MB 的进程,mlockall 期间可能要处理 5 万页。这个动作放在 main() 里会让启动时间增加几十到几百毫秒——完全可以接受,但不能放在"第一个周期开始前 1ms"的位置。
RLIMIT_MEMLOCK 怎么给够
# 当前限制(单位 KB)
ulimit -l
# 临时放开
ulimit -l unlimited
# systemd unit 里写死,比 ulimit 可靠
[Service]
LimitMEMLOCK=infinity
代码里也要检查返回值——mlockall 失败返回 -1,errno 是 ENOMEM(配额不够)或 EPERM(没有 CAP_IPC_LOCK 且配额为 0)。
if (mlockall(MCL_CURRENT) != 0) {
fprintf(stderr, "mlockall failed: %s\\n", strerror(errno));
/* 不要在这里"降级继续" —— 要么退出,要么明确记录降级状态 */
return –1;
}
生产代码里最常见的问题是不检查返回值。mlockall 静默失败,程序照跑,你以为锁住了,实际一页都没锁。
容器里的额外一道墙
5.14 之后,mlock 的内存在 cgroup 里单独记账。即使 RLIMIT_MEMLOCK 设成 infinity,cgroup v2 的 memory.max 仍然会限制你能锁多少——超了就是 ENOMEM。
# 看当前 cgroup 用了多少锁定内存
grep -E '^(file_locked|anon)' /sys/fs/cgroup/<组>/memory.stat
容器化部署的实时程序,这一条几乎必踩。
2.5 锁住了,为什么还能看到抖动
mlock 保证的是"这一页不会被回收、不会被换出"。但下面这几件事它管不了:
| 页被压缩进 zram | 管得了 | 已锁定页不进 swap,不会被压缩 |
| 文件页回写导致的抖动 | 管不了 | MAP_SHARED 的脏页回写是另一条路径,和是否锁定无关 |
| THP 被 split | 管不了 | 内存紧张时内核会拆大页,mlock 不阻止 split |
| 页被迁移(NUMA/compaction) | 管不了 | 迁移不是换出 |
| 首次访问建 PTE | 管不了 | MCL_FUTURE 对未来映射只打标记不预触 |
第 2 行是工业现场最常见的误解。很多人把日志、配方、点位表用 mmap 映射成 MAP_SHARED 文件,然后 mlockall,以为就稳了。实际上:
- 读的时候,如果页不在 page cache,filemap_fault() 照样要读盘——mlock 只在页已经驻留之后才有意义。
- 写的时候,脏页积累到阈值会触发回写,balance_dirty_pages() 可能让写入者睡眠等 I/O。
对这类场景,正确做法是启动阶段把整个文件读一遍(MAP_POPULATE 或读一遍),确认 mincore() 显示全部驻留,再 mlock。写入侧则要控制脏页比例:
# 脏页超过 5% 就开始回写(默认 10%/20%)
sysctl -w vm.dirty_background_ratio=5
sysctl -w vm.dirty_ratio=10
三、堆的预触:glibc 的三个开关
malloc 不是"给一块内存",它在一套策略下选择 brk 扩展还是 mmap 新段:
| < M_MMAP_THRESHOLD(默认 128KB) | brk 堆顶 | 匿名页,按需分配 | 会 |
| ≥ 阈值 | 独立 mmap 段 | 匿名页 | 会 |
两条路都有"已映射但未分配物理页"的区域,所以光 malloc 不解决问题,必须写一遍。
开关 1:M_MMAP_THRESHOLD
#include <malloc.h>
mallopt(M_MMAP_THRESHOLD, 512 * 1024); /* 512KB 以下走 brk,减少 mmap 次数 */
阈值动态调整是 glibc 的默认行为:每次 free 一个 mmap 段,阈值就上调,最高到 32MB。这个动态性对实时系统不友好——同一个程序在不同运行历史下,内存布局会不一样。固定它,行为才可复现。
开关 2:M_TRIM_THRESHOLD 与 M_TOP_PAD
mallopt(M_TRIM_THRESHOLD, 64 * 1024 * 1024); /* 堆顶空闲 64MB 才收缩 */
mallopt(M_TOP_PAD, 16 * 1024 * 1024); /* 每次扩堆多要 16MB */
默认 M_TRIM_THRESHOLD 是 128KB。意味着 free 掉一块大内存后,glibc 可能把堆顶 brk 收缩还回去;下次再 malloc 又要重新扩、重新缺页。一个"分配→释放→再分配"的循环,可能每轮都缺页一次,而且这个循环看起来完全正常。
把阈值调大 + 加 padding,可以把这个抖动消掉。代价是 RSS 看起来高一些。
开关 3:M_ARENA_MAX:多线程的隐形炸弹
glibc 为减少锁竞争,允许每个线程有独立的 arena。64 位下默认上限是 8 × 核数。每个新 arena 都是一段全新的、未触碰的堆。
对一个 16 线程的进程,最坏情况是 128 个 arena,每个都有几十 KB 到几 MB 的未触碰页。你只预触了主线程的堆,其他线程第一次 malloc 照样缺页。
mallopt(M_ARENA_MAX, 1); /* 强制单 arena,锁竞争上升,可预测性上升 */
或者在启动阶段让每个线程各跑一次分配-释放-预触。
对实时程序,通常选 M_ARENA_MAX=1:宁可让 malloc 慢一点,也不要让内存布局不可预测。更好的做法是运行期完全不用 malloc,用自己管理的静态池。
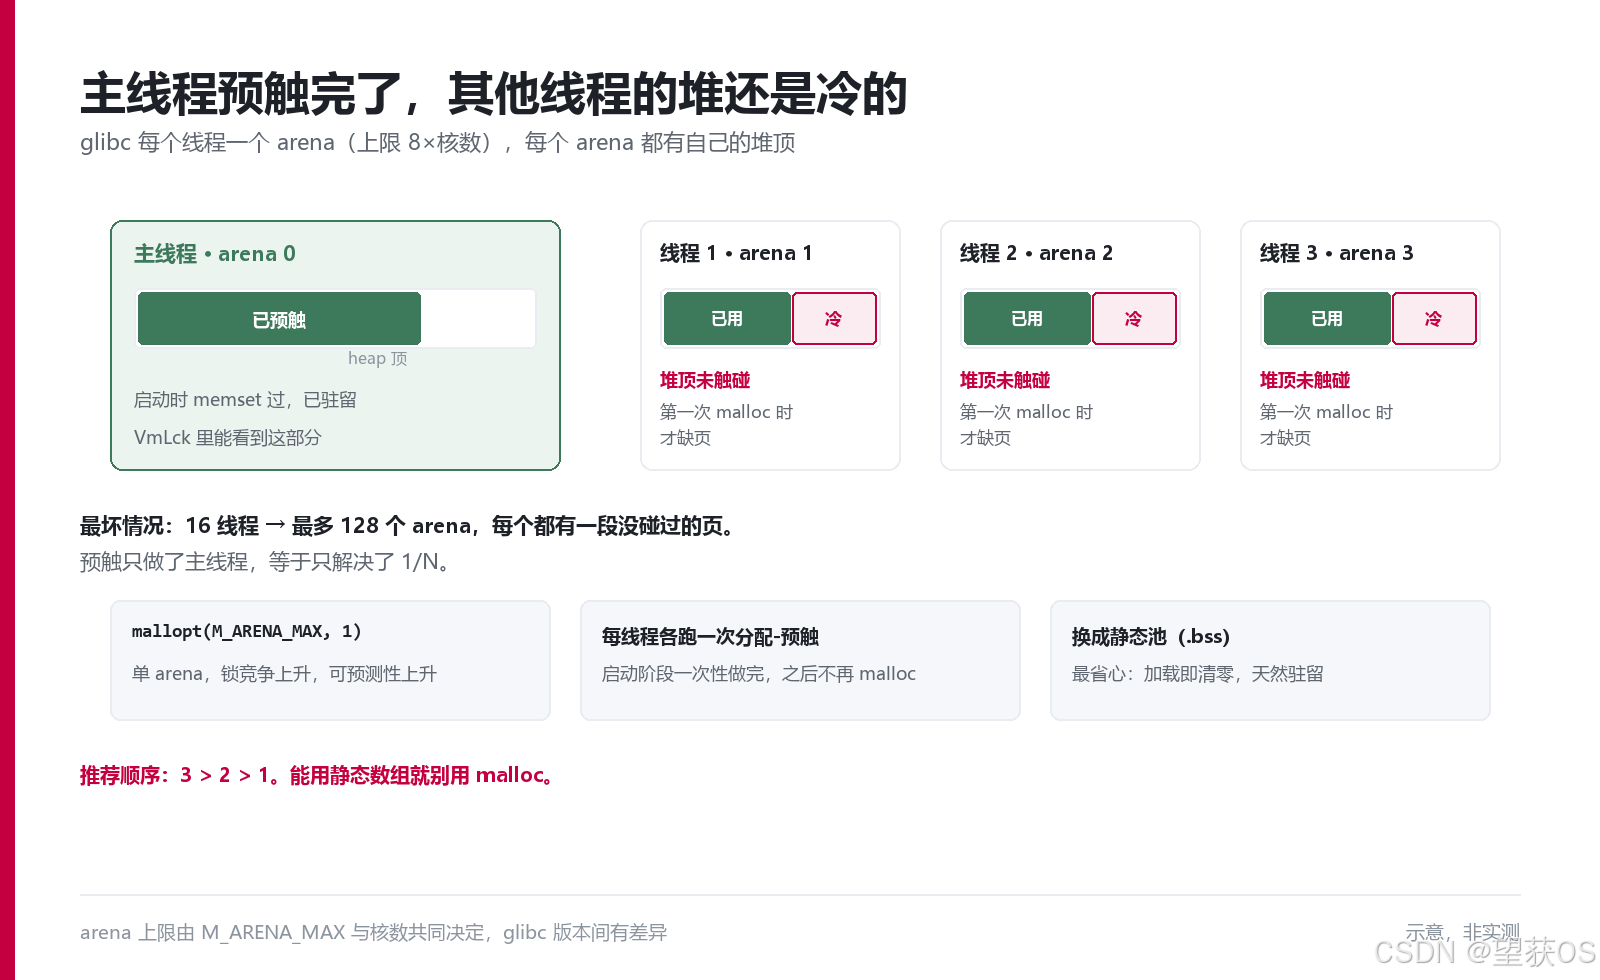
图2:主线程预触完了,第 2~16 个线程各自还有一段没碰过的堆顶——第一次 malloc 时才知道。
静态池:最省心的方案
#define POOL_N 4096
struct msg { uint64_t ts; uint32_t axis; double pos; };
static struct msg pool[POOL_N]; /* .bss,启动时清零即已驻留 */
static unsigned pool_head;
static struct msg *pool_get(void) /* 无锁,单生产者单消费者 */
{
return &pool[pool_head++ % POOL_N];
}
.bss 段的页在加载时就被清零(内核在 execve 时把 PT_LOAD 的 .bss 部分清零),所以它们天然已驻留,不需要预触。这是最省事的做法:把所有实时路径用到的内存都做成静态数组。
代价是大小固定。但对工业控制这类场景,队列长度本来就是设计参数,固定反而是优点。
四、栈的预触
4.1 先把栈大小定下来
pthread_attr_t attr;
pthread_attr_init(&attr);
pthread_attr_setstacksize(&attr, 512 * 1024); /* 512KB,够用就别给 8MB */
pthread_attr_setguardsize(&attr, 4096); /* guard 一页,够 */
pthread_create(&tid, &attr, rt_loop, NULL);
默认栈是 ulimit -s(8MB)。8MB 意味着 MCL_CURRENT 要预触 2048 页,其中 99% 你永远用不到——纯浪费。
栈大小怎么估?跑一遍完整业务负载,然后:
# 看线程栈 VMA 的实际驻留(不是映射大小)
grep -A5 'stack' /proc/<pid>/task/<tid>/smaps | grep -E 'Size|Rss'
Rss 是实际用到的量级,再乘 2 作为安全余量。别只乘 1.2——深层递归、printf 家族、信号处理都会突然多用一段。
4.2 预触函数
/* 从当前栈顶往下写满 size 字节。必须用 volatile,否则 -O2 会消除 */
static void pretouch_stack(size_t size)
{
volatile unsigned char buf[1];
volatile unsigned char *p = (volatile unsigned char *)&buf;
for (size_t i = 0; i < size; i += 4096)
p[–i] = 0; /* 每页写一个字节即可 */
}
三个坑:
在 rt_loop 的第一行调用它(而不是在 main 里,因为栈是每个线程独立的):
static void *rt_loop(void *arg)
{
pretouch_stack(448 * 1024); /* 比 512KB 少留一页 */
...
}
4.3 信号栈要单独处理
static char sig_stack[SIGSTKSZ * 4] __attribute__((aligned(16)));
stack_t ss = { .ss_sp = sig_stack, .ss_size = sizeof(sig_stack) };
sigaltstack(&ss, NULL);
放在 .bss 里,天然已驻留。如果用的是 malloc 出来的信号栈,记得单独预触。
4.4 -fstack-clash-protection
GCC 8+ / Clang 11+ 支持。开了之后,函数在栈上分配超过一页的局部变量时,会逐页 probe(读一下再写),把"运行到那一行才缺页"变成"函数入口就缺页"。
gcc -O2 -fstack-clash-protection -o app app.c
代价是每个大栈帧函数多几条指令,收益是缺页时机可预期。工业现场的实时程序,建议直接开。
五、一次系统调用搞定:MADV_POPULATE_WRITE
5.14 引入了 MADV_POPULATE_WRITE,语义是"把这个区间全部 fault 进来,并且按可写方式":
/* 一次 syscall 完成整个区间的预触 */
if (madvise(buf, len, MADV_POPULATE_WRITE) != 0) {
/* EINVAL: 内核 < 5.14 或不支持;退回手写循环 */
}
跟手写 memset 循环比,差别不小:
| memset(buf, 0, len) | 0 | len/4096 次 | 每页一次 fault,每次都入内核 |
| 手动按页写 | 0 | len/4096 次 | 同上,只是少了写带宽 |
| MADV_POPULATE_WRITE | 1 | 内核内部批量处理 | 少了 N-1 次用户/内核切换 |
注意它不清零,只是建映射。如果你需要零值,还是要写零。
另外两个相关 flag:
- MADV_POPULATE_READ:只读方式预触(5.14+)。对只读数据段有用,不会触发 COW。
- MADV_COLLAPSE(6.1+):主动请求把区间合并成大页,不等 khugepaged。
兼容写法:
static int populate(void *p, size_t len)
{
#ifdef MADV_POPULATE_WRITE
if (madvise(p, len, MADV_POPULATE_WRITE) == 0)
return 0;
#endif
volatile unsigned char *q = p;
for (size_t i = 0; i < len; i += 4096)
q[i] = 0;
return 0;
}
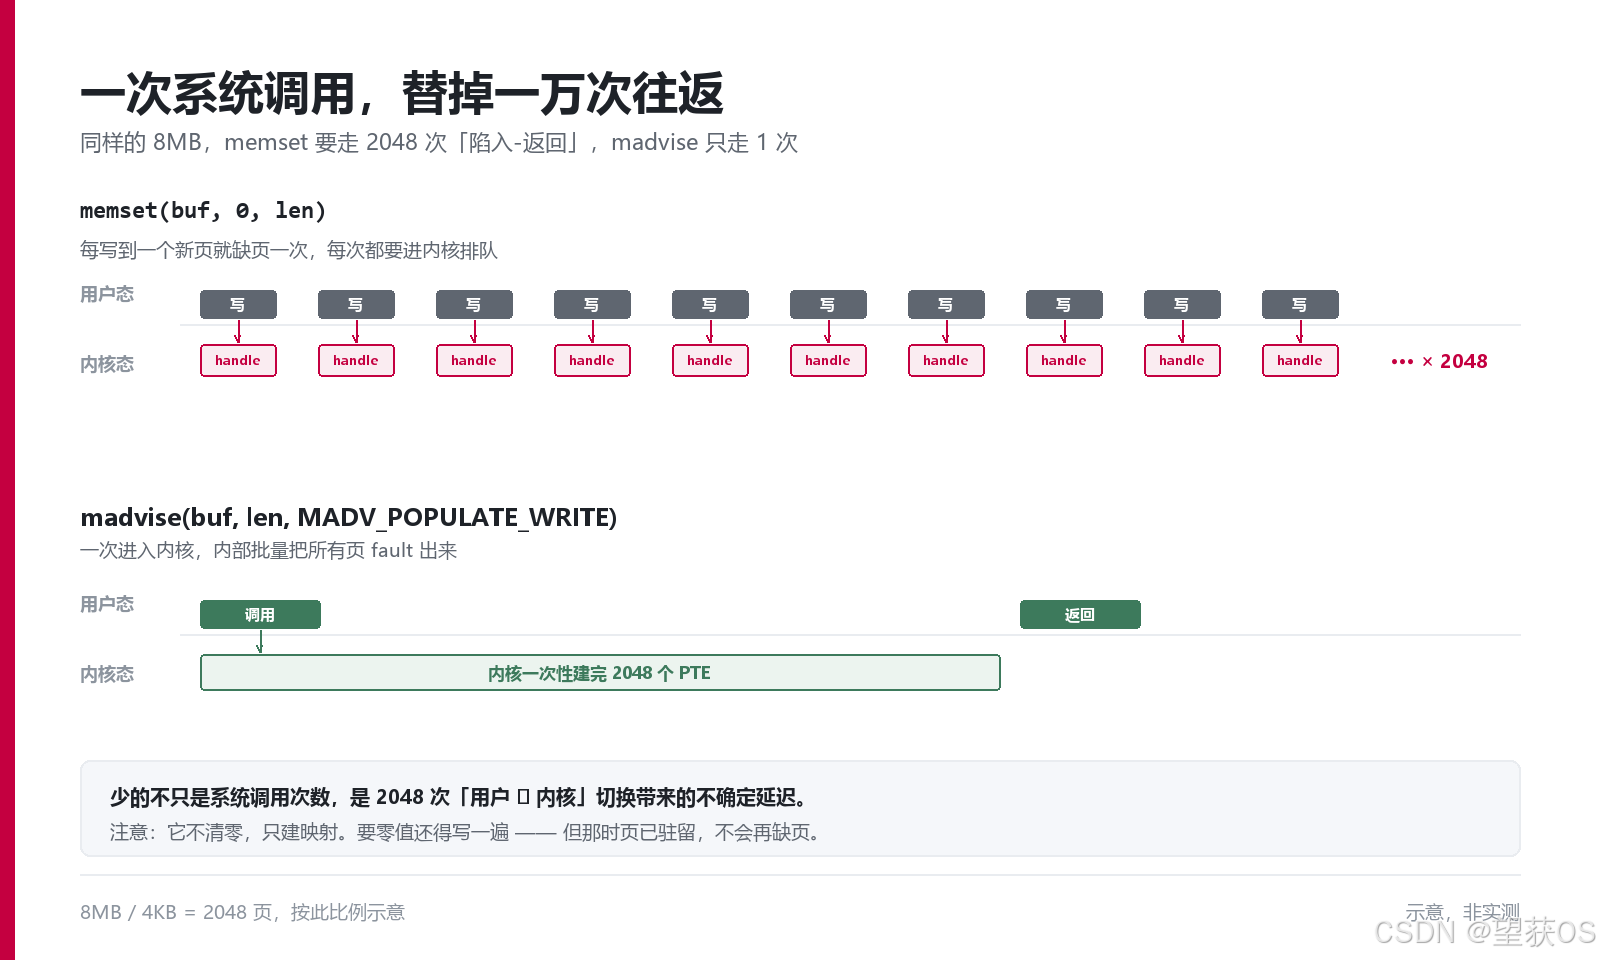
图3:memset 每页都要"陷入-返回"一次;MADV_POPULATE_WRITE 把这一万次往返压成一次系统调用。
六、大页:配法与验证
6.1 THP 走 madvise 路线
# 全局改成 madvise(只对显式申请的区间生效)
echo madvise > /sys/kernel/mm/transparent_hugepage/enabled
# 关闭后台合并线程,消除 khugepaged 抢 mmap_write_lock
echo never > /sys/kernel/mm/transparent_hugepage/defrag
/* 先 madvise 再预触 —— 顺序反了就先落下 4KB 页,之后很难合并 */
madvise(buf, len, MADV_HUGEPAGE);
populate(buf, len);
关键顺序:MADV_HUGEPAGE 必须在第一次 fault 之前。如果页已经作为 4KB 存在,后面只能靠 MADV_COLLAPSE 或 khugepaged 去合并——而合并要改页表、刷 TLB,是你最不想要的停顿。
defrag=never 的意思是"不做同步整理"。对 THP 的影响是:如果分配 2MB 时内存碎片化,直接退回 4KB 页(thp_fault_fallback 计数 +1),而不是卡在那里整理。对实时系统,"退化成 4KB"比"停顿 20ms 去整理"好得多。
验证:
grep -E 'AnonHugePages|THPeligible' /proc/<pid>/smaps_rollup
grep -E 'thp_fault_alloc|thp_fault_fallback' /proc/vmstat
AnonHugePages 应该接近你的缓冲区大小。如果只有几 MB 而缓冲区是几百 MB,说明大页没生效——最常见的原因是 madvise 调用在 fault 之后。
6.2 hugetlbfs:确定性优先的选择
# 预留 512 个 2MB 页 = 1GB
echo 512 > /proc/sys/vm/nr_hugepages
# 1GB 大页需要在启动参数里指定(运行期无法改)
# default_hugepagesz=1G hugepagesz=1G hugepages=4
mount -t hugetlbfs nodev /dev/hugepages
size_t len = 256UL << 20; /* 256MB */
void *p = mmap(NULL, len,
PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS | MAP_HUGETLB,
–1, 0);
if (p == MAP_FAILED) { /* 池子不够,返回 ENOMEM */
perror("mmap MAP_HUGETLB");
return –1;
}
三个必须检查的点:
看池子状态:
grep -E 'HugePages_(Total|Free|Rsvd)' /proc/meminfo
Free 长期是 0,说明池子被占满了——这时候再 mmap 就失败。这是硬实时系统上线前必须算准的一个数。
6.3 大页没生效的四个原因
按出现频率排序:
| AnonHugePages 只有几 MB | MADV_HUGEPAGE 在 fault 之后才调 | 检查代码顺序,madvise 必须在第一次写之前 |
| 同上,且 thp_fault_fallback 在涨 | 内存碎片化,2MB 连续页要不到 | grep compact_stall /proc/vmstat |
| enabled 还是 always,但只有部分是大页 | 区间没有对齐到 2MB 边界 | 用 aligned_alloc(2<<20, len) 或 mmap 让内核选地址 |
| MAP_HUGETLB 返回 ENOMEM | nr_hugepages 为 0 或已被占满 | grep HugePages_Free /proc/meminfo |
第二条容易被忽略。THP 的 always 并不保证"一定给你大页",它只是"尽力给"。内存跑久了找不到连续 2MB,就悄悄退回 4KB——pgfault 正常,AnonHugePages 上不去,Max 值照旧。所以别拿 enabled 的取值当结论,要看 AnonHugePages 的比例。
第四条在容器里更常见:宿主机的 nr_hugepages 是全局的,容器里 mmap(MAP_HUGETLB) 用的是宿主的池子。多个容器抢同一个池子时,谁先启动谁拿到。
七、NUMA 绑定:三行命令加三个检查
# 最简单:进程级绑定,CPU 和内存都锁在 node 0
numactl –cpunodebind=0 –membind=0 ./rt_app
–membind 是硬绑定:如果 node 0 内存不够,分配直接失败(ENOMEM),不会偷偷用 node 1。这是实时系统想要的行为——宁可启动失败,也不要静默降级到跨节点。
代码里等价的做法:
#include <numaif.h>
unsigned long mask = 1UL << 0; /* 只允许 node 0 */
if (set_mempolicy(MPOL_BIND, &mask, sizeof(mask) * 8) != 0) {
perror("set_mempolicy");
return –1;
}
对已经分配好的一大块内存做迁移:
unsigned long nodemask = 1UL << 0;
mbind(buf, len, MPOL_BIND, &nodemask, sizeof(nodemask) * 8, MPOL_MF_MOVE);
MPOL_MF_MOVE 会真的搬页。注意这个调用可能很慢(要逐页迁移 + 刷 TLB),必须在启动阶段做。
7.1 关掉自动平衡
sysctl -w kernel.numa_balancing=0
# 持久化
echo 'kernel.numa_balancing = 0' > /etc/sysctl.d/99-rt.conf
上一篇讲过原因:它靠定期把 PTE 改成 PROT_NONE 来采样,等于主动制造缺页。已经手工绑核的系统,它带来的只有成本。
7.2 别忘了中断
CPU 和内存都绑到 node 0 了,但如果采集卡的中断落在 node 1 的 CPU 上,数据要先跨节点到内存,再被 node 0 的线程读——绕了一圈。
# 看每个中断的亲和性
cat /proc/interrupts | head -5
# 把设备中断的亲和性设到 node 0 的核(比如 0-7)
echo 0-7 > /proc/irq/<n>/smp_affinity_list
这部分 D2 篇 2 已经详细写过,这里只提醒"内存绑定"和"中断绑定"必须一起做。
7.3 验证
numastat -p $(pgrep -f rt_app)
输出里 Local node 0 的占比应该是 100%(或接近)。如果 Other 有明显数值,说明有页跑到了别的节点——通常是某块内存的 first touch 发生在绑核之前。
7.4 numactl 和代码里的 sched_setaffinity 会打架
numactl –cpunodebind=0 实际上设置了进程的 CPU 亲和性。如果代码里再调一次 sched_setaffinity(0, …) 指定了一组核,后者会覆盖前者——如果那组核跨越了两个 node,你的"绑定"就失效了,而且没有任何报错。
判断方法:程序跑起来之后看实际值。
taskset -cp $(pgrep -f rt_app) # 看 CPU 亲和性
cat /proc/<pid>/numa_maps | head # 看每段内存落在哪个 node
正确做法是只在一个地方设:要么全交给 numactl(代码里不碰),要么全在代码里做(启动脚本不加 numactl)。两边都设,出问题时排查成本翻倍。
–membind 是完全另一回事,它只管内存节点的偏好,不碰 CPU 亲和性。所以 numactl –membind=0 + 代码里 sched_setaffinity 是可以共存的——冲突的只有 –cpunodebind。
八、验证:五个检查点,缺一不可
mlockall 返回 0 只代表"系统调用没报错",不代表"内存真的锁住了"。按这个顺序验证:
| 1. 配额 | ulimit -l 或 cat /proc/<pid>/limits | grep locked | unlimited 或 ≥ 进程 RSS | 配额不足,mlockall 早就失败了 |
| 2. 锁定量 | grep VmLck /proc/<pid>/status | ≈ VmRSS | 锁的量远小于驻留量 → 有 VMA 没被覆盖 |
| 3. 逐段确认 | grep -B3 'Locked: 0' /proc/<pid>/smaps | 无输出 | 有 VMA 显示 Locked: 0 → 那段没锁上 |
| 4. 大页 | grep AnonHugePages /proc/<pid>/smaps_rollup | ≈ 缓冲区大小 | 接近 0 → MADV_HUGEPAGE 顺序错了 |
| 5. NUMA | numastat -p <pid> | Other ≈ 0 | 有明显跨节点 → first touch 位置不对 |
第 2 项是最容易被糊弄的:VmLck 只统计被锁的页,如果某段 VMA 的 VM_LOCKED 没置上,它不会出现在这个数里,但也不会报错。所以必须做第 3 项——逐个 VMA 看 Locked:,找 Locked: 0 的那些。
# 列出所有未锁定的 VMA(排除 0 大小的)
awk '/^[0-9a-f]+-[0-9a-f]+/{vma=$0} /^Locked:/ && $2==0 {print vma}' /proc/<pid>/smaps
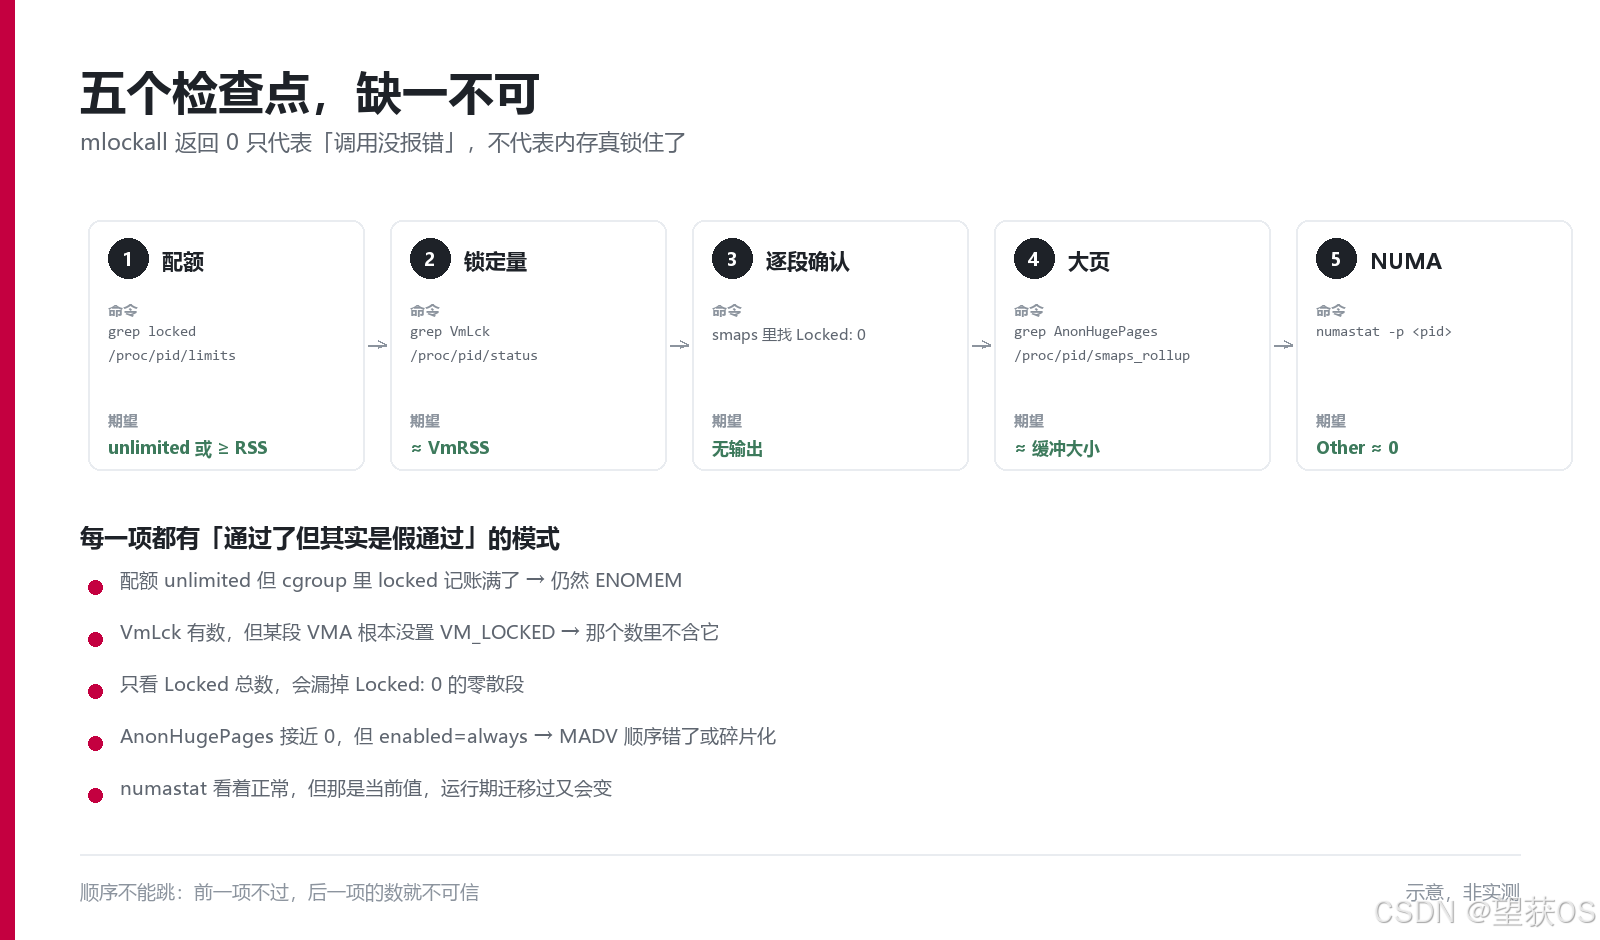
图4:每一项都有"通过了但其实是假通过"的模式,所以必须全部跑一遍,不能只信 mlockall 的返回值。
8.1 顺手把启动序的耗时打出来
预触一共花了多久,是一个应该在启动日志里看到数字的量。它告诉你三件事:内存总量对不对、有没有意外的页数、大页有没有生效。
#include <time.h>
static double now_ms(void)
{
struct timespec ts;
clock_gettime(CLOCK_MONOTONIC, &ts);
return ts.tv_sec * 1e3 + ts.tv_nsec / 1e6;
}
/* 用法 */
double t0 = now_ms();
pretouch(io_buf, sizeof(io_buf));
double t1 = now_ms();
if (mlockall(MCL_CURRENT) != 0) { /* … */ }
double t2 = now_ms();
fprintf(stderr, "[rt-init] pretouch %.1f ms, mlockall %.1f ms\\n", t1 – t0, t2 – t1);
怎么读这个数字:
- 预触时间 ÷ 页数 = 单页成本。8MB / 4KB = 2048 页,如果耗时 8ms,单页约 4μs——正常。
- 如果单页成本明显偏高(比如 20μs 以上),说明这些页走的是 major fault 或者落到了 direct reclaim,要去查 /proc/vmstat。
- 如果 mlockall 的耗时和预触相差很大(远大于),说明预触没覆盖到的页在被 mlockall 补触——说明有 VMA 漏了。
这个日志在产线部署时特别有用:换一台机器、换一个内核,先看这两行数字有没有变。
九、按规模选方案:三档配置对照
内存量级不同,最优解完全不同。下面三档覆盖了工业现场大部分情况。
档 A:8MB 以内,单个控制任务
static struct { ... } ctx; /* 全部 .bss */
mlockall(MCL_CURRENT);
pthread_attr_setstacksize(&attr, 256 * 1024);
- 不用大页。8MB 以内,TLB 压力可以忽略,2MB 大页带来的方差反而不划算。
- 栈给 256KB 就够——注意这要配合 -fstack-clash-protection 一起用,否则深调用链容易撞 guard。
- 不需要 nr_hugepages,不需要 NUMA 绑定(如果只有一个 socket)。
档 B:8MB ~ 256MB,缓冲与队列
/* 用 mmap 匿名映射代替 malloc,避免 arena 问题 */
void *buf = mmap(NULL, len, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, –1, 0);
madvise(buf, len, MADV_HUGEPAGE); /* 必须在 populate 之前 */
madvise(buf, len, MADV_POPULATE_WRITE);
mlockall(MCL_CURRENT);
- 走 madvise 路线的 THP:可控,但不保证 100% 拿到大页(碎片化时会退回 4KB)。要接受"部分 4KB"的现实,用 AnonHugePages 看比例。
- 建议 defrag=never,让它退化而不是同步整理。
- 这个量级不要用 MCL_FUTURE——256MB 的配额在容器里很容易撞墙。
档 C:256MB 以上,或需要与 DMA 共享
# 预留固定池子,按实际用量给,不要给"够用就行"
echo 2048 > /proc/sys/vm/nr_hugepages # 4GB(2MB 页)
void *buf = mmap(NULL, len, PROT_READ | PROT_WRITE,
MAP_SHARED | MAP_HUGETLB, fd_hugetlbfs, 0);
- 这个量级必须用 hugetlbfs。THP 在几百 MB 规模上的"部分退化"会让延迟分布变得不可解释,而且 khugepaged 在大内存进程上扫描更频繁。
- MAP_SHARED 是为了让驱动能 pin 同一块内存做 DMA。MAP_PRIVATE 的 hugetlb 页在写时会 COW,pin 住的是旧页,数据对不上——这是驱动联调时的高频事故。
- mlockall(MCL_CURRENT) 在这个量级会很慢(几万页),建议改成 MCL_ONFAULT + 对关键区单独 mlock()。
一条经验值:mlock 的总量不要超过物理内存的 50%(公开资料常见建议,非实测)。超过之后内核的可用页急剧减少,kswapd 与回收路径的压力会让整个系统的行为变得难以预测——你的 RT 进程稳了,但旁边的进程开始抖动,最终通过共享资源反噬回来。容器环境里这条线还要更低,因为 memory.max 通常在物理内存的一半以下。
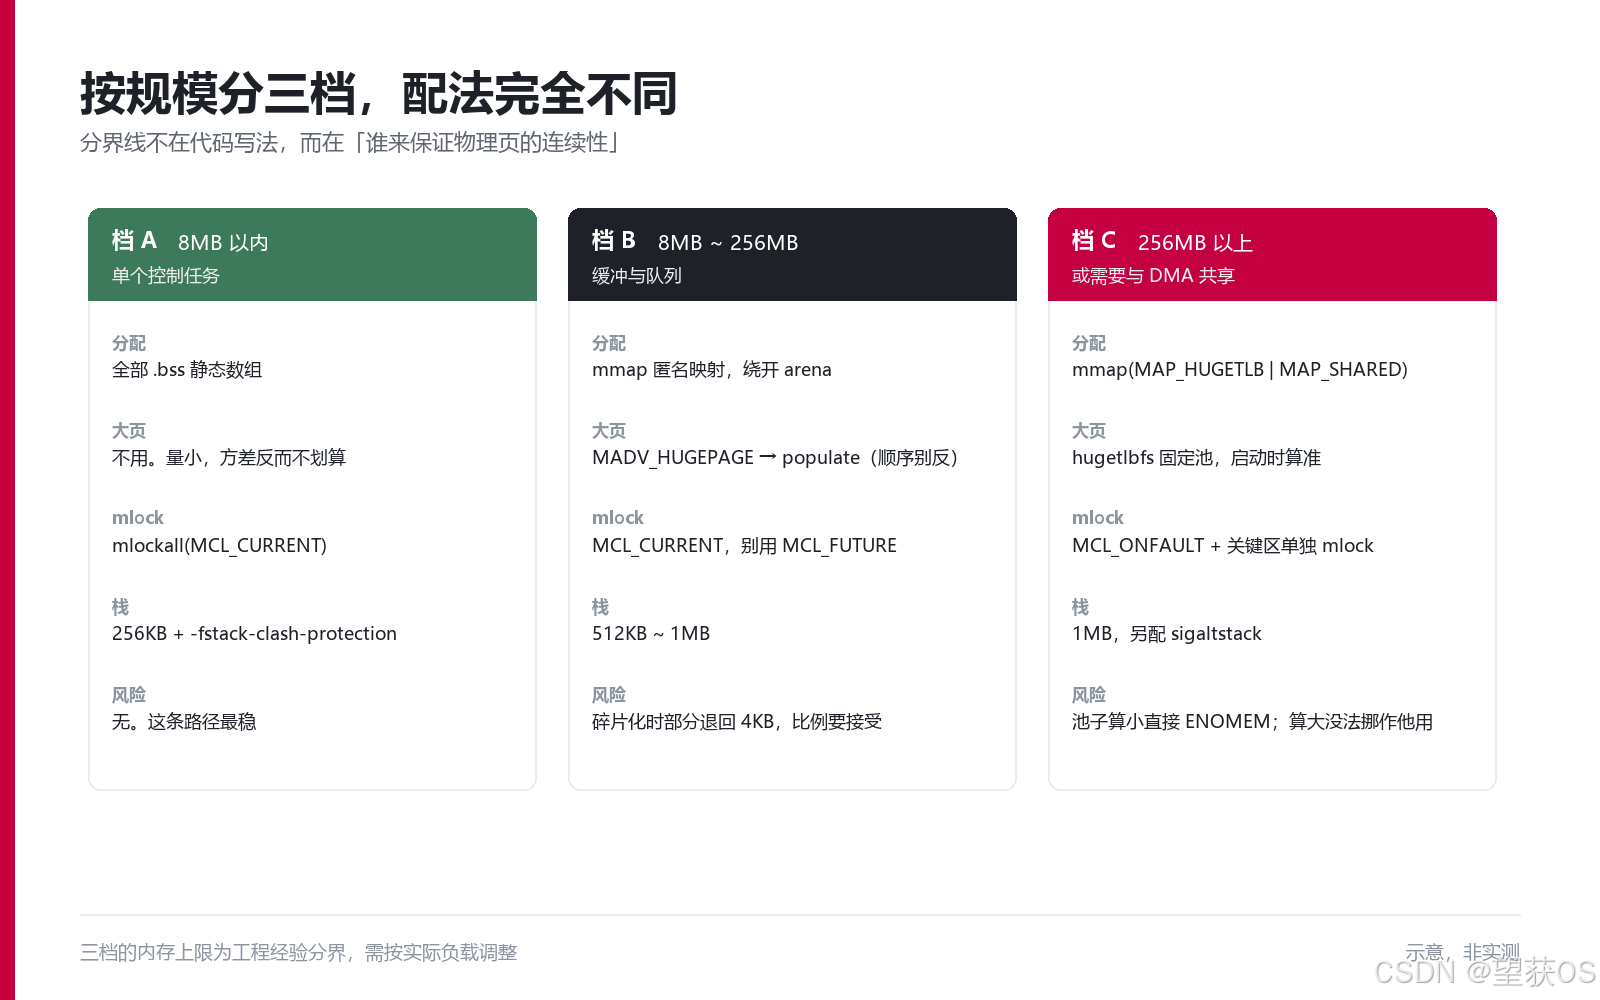
图5:从"全静态 .bss"到"hugetlbfs 固定池",分界线不在代码写法,而在"谁来保证连续性"。
十、完整示例:一个可编译的 RT 线程启动序
#define _GNU_SOURCE
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <errno.h>
#include <unistd.h>
#include <pthread.h>
#include <sched.h>
#include <sys/mman.h>
#include <sys/resource.h>
#define BUF_LEN (8UL << 20) /* 8MB 数据缓冲 */
#define STACK_LEN (512 * 1024)
static char io_buf[BUF_LEN] __attribute__((aligned(4096)));
static void pretouch(void *p, size_t len)
{
volatile unsigned char *q = p;
for (size_t i = 0; i < len; i += 4096) q[i] = 0;
}
static void *rt_loop(void *arg)
{
volatile unsigned char probe[1];
volatile unsigned char *sp = (volatile unsigned char *)&probe;
for (size_t i = 4096; i < STACK_LEN – 4096; i += 4096) sp[–i] = 0;
/* 进入周期循环,此后不再 malloc / printf / open */
for (;;) {
__asm__ __volatile__("" ::: "memory");
}
return NULL;
}
int main(void)
{
struct rlimit rl = { RLIM_INFINITY, RLIM_INFINITY };
pthread_attr_t attr;
pthread_t tid;
cpu_set_t set;
/* 1. 配额 */
if (setrlimit(RLIMIT_MEMLOCK, &rl) != 0)
perror("setrlimit(RLIMIT_MEMLOCK)");
/* 2. 绑 NUMA 节点(示例:node 0)+ CPU */
CPU_ZERO(&set);
for (int i = 0; i < 4; i++) CPU_SET(i, &set);
if (sched_setaffinity(0, sizeof(set), &set) != 0)
perror("sched_setaffinity");
/* 3+4. 预触静态缓冲(.bss 已清零,这里确保大页与驻留) */
pretouch(io_buf, sizeof(io_buf));
/* 5. 锁住全部已有映射 */
if (mlockall(MCL_CURRENT) != 0) {
fprintf(stderr, "mlockall: %s\\n", strerror(errno));
return 1;
}
/* 6. 线程 */
pthread_attr_init(&attr);
pthread_attr_setstacksize(&attr, STACK_LEN);
pthread_attr_setguardsize(&attr, 4096);
if (pthread_create(&tid, &attr, rt_loop, NULL) != 0) {
perror("pthread_create");
return 1;
}
pthread_join(tid, NULL);
return 0;
}
注意几点:
- io_buf 在 .bss,链接时就确定了大小和地址,不需要 malloc,不存在 arena 问题。
- pretouch 之后才 mlockall——顺序不能反。
- rt_loop 里预触栈,因为栈是线程自己的。
- 权限设置(SCHED_FIFO)这里略了,按 D4 篇 2 的方式加。
十一、九个失败模式对照表
| mlockall 返回 -1 | ENOMEM | RLIMIT_MEMLOCK 不够 | LimitMEMLOCK=infinity |
| mlockall 返回 -1 | EPERM | 配额为 0 且无 CAP_IPC_LOCK | 给 capability 或放开配额 |
| 加 MCL_FUTURE 后 dlopen 失败 | ENOMEM | 新映射锁不上 | 只用 MCL_CURRENT |
| VmLck 远小于 VmRSS | — | 有 VMA 未覆盖 / 后续新分配 | 查 smaps 的 Locked: 0 |
| mmap(MAP_HUGETLB) 失败 | ENOMEM | nr_hugepages 不足 | 调大池子或减少用量 |
| mmap(MAP_HUGETLB) 失败 | EINVAL | 长度不是 2MB 整数倍 | 长度对齐 |
| AnonHugePages 接近 0 | — | MADV_HUGEPAGE 在 fault 之后 | 提前调用 |
| numastat 有 Other 值 | — | first touch 在绑核前 | 先绑核再分配 |
| 运行期偶发几十微秒 | — | malloc/printf/ioctl 缓冲区 | 全部移到启动阶段 |
十二、边界声明
本文基于 Linux 6.6 与 glibc 2.35 整理,代码片段在 x86-64 上按 POSIX 与 Linux 手册页语义编写,未在实机做延迟测量。文中所有默认值(M_MMAP_THRESHOLD 128KB、M_TRIM_THRESHOLD 128KB、M_ARENA_MAX 上限 8×核数、pthread 默认栈 8MB、RLIMIT_MEMLOCK 默认 8MB)为常见发行版取值,不同发行版与 glibc 版本存在差异,请以你的环境 getrlimit()/mallinfo() 实测为准。MADV_POPULATE_WRITE 需 5.14+、MADV_COLLAPSE 需 6.1+,低版本内核需走降级路径。mlock 在 cgroup 中的记账行为自 5.14 起有变化,容器环境请以实际内核为准。