/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
引言
大模型时代的算力需求呈指数级增长。从训练千亿参数模型到部署实时推理服务,选择合适的 AI 加速卡是构建高效 AI 基础设施的核心决策。本文将全面对比七款主流 AI 加速卡——NVIDIA A100、A800、H200、B300 以及华为昇腾 910A、910B、910C——从架构、性能、内存、互联、功耗等多维度进行深入分析,帮助读者做出明智的选型决策。
一、各芯片概述
NVIDIA A100(2020)
NVIDIA A100 是 Ampere 架构的旗舰数据 GPU,2020 年发布。它是第一个支持 FP16/BF16 混合精度训练、Transformer Engine 和 INT8 推理的 HPC/AI GPU,在深度学习领域长期占据主导地位。A100 提供 40GB 和 80GB 两种 HBM2e 内存配置,采用 SXM4 或 PCIe Gen4 接口。
NVIDIA A800(2022)
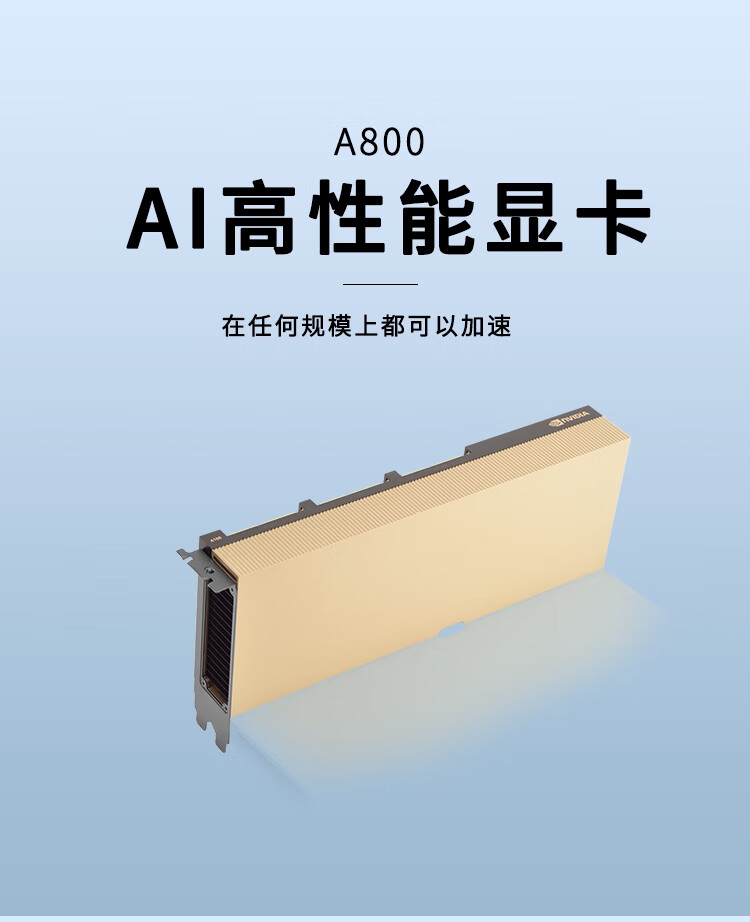
A800 是 A100 的中国特供版本,因美国出口管制而将 NVLink 带宽从 600GB/s 削减至 400GB/s。其他核心计算规格与 A100 完全一致,是当时中国市场主流的 AI 训练加速器。
NVIDIA H200(2024)
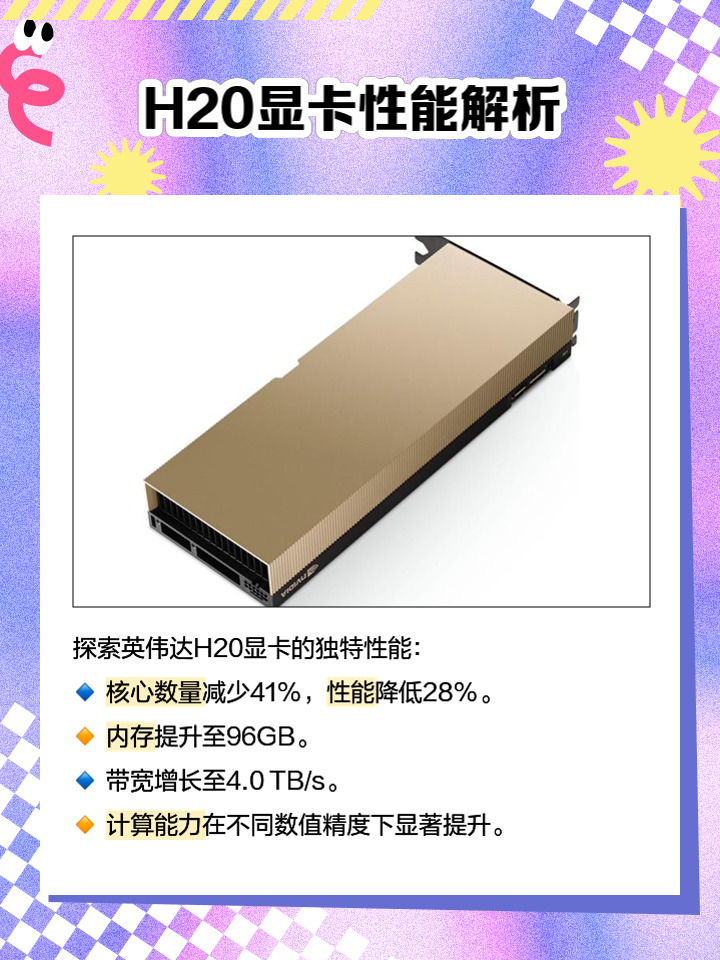
H200 是 Hopper 架构的升级版,基于 H100 设计,将 HBM3e 内存容量从 80GB 提升至 141GB,带宽从 3.35TB/s 提升至 4.8TB/s。在 FP16/BF16 计算性能上与 H100 持平(989 TFLOPS),但在大模型推理场景下内存容量和带宽的翻倍带来显著性能提升。
NVIDIA B300(2025)
B300 是 Blackwell 架构的旗舰产品,2025 年发布。采用第二代双芯片设计,FP16 性能达到 2,250 TFLOPS,内存容量提升至 288GB HBM3e,带宽达到 8TB/s。B300 引入了 NVLink 5,互联带宽达到 1.8TB/s,是截至 2025 年最强的数据中心 AI 加速卡。
华为昇腾 910A(2019)
昇腾 910A 是华为第一代 AI 训练芯片,基于达芬奇架构设计。采用 7nm 工艺,FP16 算力 256 TFLOPS,配备 32GB HBM2 内存,带宽 1.2TB/s。2019 年发布时性能对标 NVIDIA V100,是华为在 AI 芯片领域的起步之作。
华为昇腾 910B(2023)
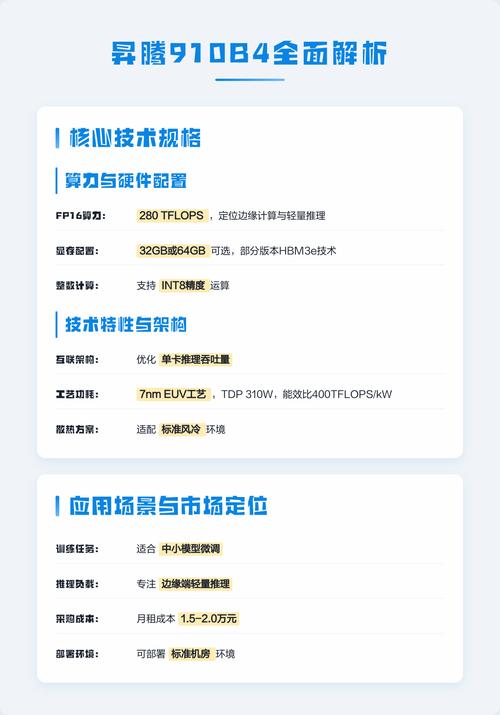
昇腾 910B 是 910A 的迭代版本,主要升级在于内存容量从 32GB 提升至 64GB HBM2e,并将 HCCS(Huawei Cache Coherent System)互联带宽提升至 280GB/s。计算架构与 910A 类似,FP16 算力约 256 TFLOPS。
华为昇腾 910C(2024)
昇腾 910C 是华为最新的 AI 训练芯片,采用 7nm 工艺(预计为 7nm N+2 节点)。相比 910B,主要提升在计算单元效率和互联带宽。FP16 算力预估达到 400 TFLOPS,INT8 推理性能约 800 TOPS。910C 是华为在应对美国芯片禁令后重点投入的产品。
二、核心参数对比表
| 发布年份 | 2020 | 2022 | 2024 | 2025 | 2019 | 2023 | 2024 |
| 架构 | Ampere | Ampere | Hopper | Blackwell | 达芬奇 | 达芬奇 | 达芬奇 |
| 制程工艺 | 7nm | 7nm | 4N | 4NP | 7nm | 7nm | 7nm N+2 |
| FP16/BF16 (TFLOPS) | 312 | 312 | 989 | 2,250 | 256 | 256 | 400 |
| FP32 (TFLOPS) | 19.5 | 19.5 | 67 | 125 | 16 | 16 | 25 |
| FP8 (TFLOPS) | – | – | 1,979 | 4,500 | – | – | – |
| INT8 (TOPS) | 624 | 624 | 3,958 | 9,000 | 512 | 512 | 800 |
| 内存类型 | HBM2e | HBM2e | HBM3e | HBM3e | HBM2 | HBM2e | HBM2e |
| 内存容量 (GB) | 80 | 80 | 141 | 288 | 32 | 64 | 64 |
| 内存带宽 (TB/s) | 2.0 | 2.0 | 4.8 | 8.0 | 1.2 | 1.2 | 1.2 |
| 互联带宽 (GB/s) | 600 (NVLink) | 400 (NVLink) | 900 (NVLink) | 1,800 (NVLink) | 280 (HCCS) | 280 (HCCS) | 380 (HCCS) |
| TDP (W) | 300 (PCIe) | 300 (PCIe) | 700 (SXM) | 1,200 (SXM) | 275 | 310 | 310 |
| FP16 能效 (TFLOPS/W) | 1.04 | 1.04 | 1.41 | 1.88 | 0.93 | 0.83 | 1.29 |
三、详细对比分析
3.1 计算性能
FP16/BF16 训练性能是 AI 训练的核心指标。从对比表可以看出:
- **B300(2,250 TFLOPS)**遥遥领先,是 A100 的 7.2 倍,H200 的 2.3 倍
- **H200(989 TFLOPS)**是 A100 的 3.2 倍,主要得益于 Hopper 架构的 Transformer Engine 和 FP8 支持
- **昇腾910C(400 TFLOPS)**与 A100 接近,但仅约为 H200 的 40%
- **昇腾910A/910B(256 TFLOPS)**略低于 A100,约为 H200 的 26%
FP8 推理性能是新一代芯片的重点。H200 提供 1,979 TFLOPS FP8 性能,B300 更达到 4,500 TFLOPS。昇腾系列目前没有原生 FP8 支持,在超低精度推理场景下存在劣势。
INT8 推理性能方面,B300(9,000 TOPS)和 H200(3,958 TOPS)大幅领先。昇腾910C(800 TOPS)在华为生态内仍有竞争力,但绝对性能与 NVIDIA 旗舰差距明显。
3.2 内存系统
内存容量对大模型训练和推理至关重要:
- **B300(288GB)**可以单卡容纳更大模型,或支持更大 batch size
- **H200(141GB)**在 H100 基础上提升 76%,适合大模型推理
- **昇腾910B/910C(64GB)**内存容量与 A100 80GB 版本接近,但带宽较低
- **昇腾910A(32GB)**在容量上明显落后,大模型场景受限
内存带宽决定了模型加载和计算的数据吞吐能力:
- **B300(8.0 TB/s)和H200(4.8 TB/s)**带宽优势显著,尤其是 HBM3e 的高带宽对 memory-bound 的推理场景帮助巨大
- **A100/A800(2.0 TB/s)**在当时是主流水平
- **昇腾系列(1.2 TB/s)**带宽较低,在内存密集型任务中可能成为瓶颈
3.3 互联与集群扩展
多卡互联对大规模分布式训练至关重要:
- **B300(1,800 GB/s NVLink 5)**提供最高的卡间互联带宽,支持 NVSwitch 实现 8 卡全互联
- **H200(900 GB/s NVLink 4)**带宽翻倍于 A100,HGX 方案可实现 8 卡 900GB/s 全互联
- **A100(600 GB/s NVLink)**是当时的高标准,NVSwitch 支持 8 卡全互联
- **A800(400 GB/s NVLink)**因出口管制被削减,多卡训练效率下降约 33%
- **昇腾910C(380 GB/s HCCS)**相比 910B 有所提升,但带宽仅为 A100 的 63%
- **昇腾910A/910B(280 GB/s HCCS)**互联带宽较低,大规模集群训练通信开销大
集群互联方面,NVIDIA 的 InfiniBand NDR(400Gbps)和 Spectrum-X 以太网方案成熟度远高于华为的 iLossless 以太网方案。在实际大规模集群(千卡以上)中,NVIDIA 的集合通信库(NCCL)优化深度也是昇腾 CANN 难以短期追平的。
3.4 功耗与能效
能效比是长期运营成本的关键考量:
- **B300(1.88 TFLOPS/W)**能效最高,Blackwell 架构的制程和架构优化效果显著
- **H200(1.41 TFLOPS/W)**能效优于 A100,但绝对功耗(700W)是 A100 的 2.3 倍
- **昇腾910C(1.29 TFLOPS/W)**在国产芯片中能效最好
- **A100(1.04 TFLOPS/W)**能效在 NVIDIA 系列中最低
- **昇腾910B(0.83 TFLOPS/W)**能效最低,与 A100 相比差距明显
实际 TDP方面,B300 的 1,200W 对数据中心供电和散热提出极高要求,H200 的 700W 也远超 A100 的 300W。昇腾系列的 275-310W 功耗相对友好,更适合中等规模部署。
3.5 软件生态
NVIDIA 生态是行业事实标准:
- CUDA 库经过 15 年积累,cuBLAS、cuDNN、NCCL、TensorRT 等库高度优化
- PyTorch、TensorFlow、JAX 等主流框架对 NVIDIA GPU 支持最完善
- TensorRT 推理优化器、Triton 推理服务器等工具链成熟
- 第三方算子、预训练模型、微调工具(DeepSpeed、FSDP、Megatron)全面支持
华为昇腾生态正在快速追赶但仍存在差距:
- CANN(Compute Architecture for Neural Networks)是华为自研的异构计算架构,提供 AscendCL API
- MindSpore 框架对昇腾支持最好,PyTorch 通过 torch_npu 插件支持,但算子覆盖度约为 CUDA 的 60-70%
- 部分前沿算子(如 FlashAttention 3、FP8 GEMM)需要等待 CANN 适配
- 实际开发中,遇到算子缺失需要手动用 TIK 或 CUDA-like 语言开发,学习曲线较陡
四、适用场景分析
4.1 大规模模型训练(千亿参数以上)
| 前沿大模型预训练 | B300 | 最高 FP16 性能 + 288GB 内存 + 1.8TB/s 互联 |
| 大模型预训练(性价比) | H200 | FP16 性能充足,141GB 内存,生态成熟 |
| 国内合规部署 | 昇腾910C | 性能接近 A100,国产合规,CANN 生态完善 |
| 已有 A100 集群扩展 | A100 | 生态成熟,二手市场供应充足 |
4.2 大模型推理部署
| 高吞吐 LLM 推理 | H200 | 141GB 内存 + 4.8TB/s 带宽,适合大 batch 推理 |
| 超低延迟推理 | B300 | FP8 性能 4,500 TFLOPS,极致吞吐 |
| 中等规模推理 | 昇腾910B | 性价比好,MindSpore 推理优化成熟 |
| 边缘推理 | A800 | 功耗适中,国内供应充足 |
4.3 中小规模训练与微调
| 10B 参数模型微调 | H200 | 单卡即可容纳 10B 模型全量微调 |
| 7B 参数 LoRA 微调 | A800/A100 | 成本低,生态成熟 |
| 国内私有化部署 | 昇腾910B/910C | 合规需求,推理优化好 |
五、成本与可获得性
| B300 | 40,000+ | 非常有限 | 北美大客户 |
| H200 | 30,000+ | 有限 | 全球(受限) |
| A100 (80GB) | 15,000-20,000 | 二手市场充足 | 全球 |
| A800 | 12,000-15,000 | 中国市场充足 | 中国 |
| 昇腾910C | 15,000+ | 国内限量 | 中国 |
| 昇腾910B | 8,000-12,000 | 国内供应稳定 | 中国 |
| 昇腾910A | 5,000-8,000 | 国内存量市场 | 中国 |
六、总结与选购建议
性能排序(FP16 算力)
B300 (2,250) > H200 (989) > 昇腾910C (400) > A100/A800 (312) > 昇腾910A/910B (256)
内存容量排序
B300 (288GB) > H200 (141GB) > A100/A800 (80GB) > 昇腾910B/910C (64GB) > 昇腾910A (32GB)
综合建议
追求极致性能:B300 是当前最强,但价格极高且供应紧张。适合资金充足、有前沿模型训练需求的头部企业。
性能与成本平衡:H200 是 NVIDIA 生态下性价比最优的选择,141GB 内存对大模型推理极为友好。适合有 NVIDIA 生态基础、需要升级现有集群的团队。
国产合规首选:昇腾910C 是当前国产最强,性能接近 A100。适合有国产化合规需求、且模型规模在 100B 参数以内的场景。昇腾910B 在推理场景下性价比更高。
成本敏感/存量升级:A100 和 A800 二手市场供应充足,价格已降至 1.5-2 万美元区间。对于不需要最新特性、预算有限的团队,仍是务实之选。
中小规模部署:昇腾910B 和 A800 功耗较低(300W 级),更适合中小数据中心或边缘节点部署。
关键决策因素
七、未来展望
NVIDIA 路线:Blackwell Ultra(B300a/B400)预计 2026 年发布,FP16 性能将突破 4,000 TFLOPS。Rubin 架构(2027)将采用 3nm 工艺和 HBM4 内存,性能再翻番。
华为路线:昇腾 920 系列预计 2026 年发布,采用 5nm 工艺,FP16 性能目标 600+ TFLOPS。华为正在推进昇腾超节点(CloudMatrix)方案,通过大规模芯片互联弥补单卡性能差距。
其他竞争者:AMD MI300X/MI325X、Google TPU v5、Intel Gaudi 3 等也在积极布局,但生态成熟度仍远不及 NVIDIA 和华为。
总结:AI 加速卡的竞争是硬件性能、软件生态、供应链安全和成本的综合博弈。没有”最好”的芯片,只有”最适合”的芯片。选择时应综合考虑自身业务需求、技术栈、合规要求和预算,做出最匹配的决策。
Put your heart, mind, and soul into even your smallest acts. This is the secret of success.
即便是再微小不过的事情,你也要用心去做。这就是成功的秘密