目录
摘要
一、为什么需要 GPUWorks?——私有化推理的真实痛点
1.1 从"买卡"到"跑起来"之间的鸿沟
1.2 三条路线的对比:手动部署、K8s 全家桶、GPUWorks
二、GPUWorks 是什么:核心概念与架构
2.1 一句话定义
2.2 三层架构:控制面、节点代理、推理引擎
2.3 核心理念:算力应该像水电一样
2.4 关键概念速览
三、安装部署:从下载到第一条请求
3.1 环境准备
3.2 下载与安装控制面
3.3 接入计算节点
3.4 验证:从安装到第一条请求
四、核心功能详解
4.1 模型注册与模板化部署
4.2 OpenAI 兼容接口:业务零改动
4.3 内置压测:容量规划有据可依
4.4 全链路可观测
五、总结
摘要
一家公司决定把大模型搬回自己的机房,通常是在某个具体时刻做的决定:合规审计要求数据不能出域,按量调用公有云 API 的成本开始失控,或者只是"这张买回来的卡,到现在还只是一张卡"。真正把模型跑起来,比买卡更费劲——驱动版本要对,推理引擎参数要调,显存要按权重和 KV 缓存重新分配,多机部署还得考虑卡间通信。等服务上线,业务方只想要一个"稳定的地址",运维却连一份完整的参数记录都凑不出来。
这篇文章在 GPUWorks(ZStack 推出的轻量级私有化模型交付平台)上实测了一套环境:腾讯云轻量服务器跑控制面,AtomGit NoteBook 昇腾 910B4 做计算节点。单二进制免 K8s 交付、异构算力统一纳管、模板化部署、内置压测和全链路可观测,都在这套环境里过了一遍。从安装控制面、Agent 反向拨入纳管昇腾节点、ModelScope 注册模型、配置评估,到一键部署 Qwen/Qwen2.5-0.5B-Instruct、压测验证,以及受限环境和离线场景的坑,都走了一遍。
一、为什么需要 GPUWorks?——私有化推理的真实痛点
GPUWorks GitHub 开源代码仓库地址:https://github.com/flitai-io/gpuworks
1.1 从"买卡"到"跑起来"之间的鸿沟
私有化大模型推理的难点,从来不在"有没有卡",而在"卡怎么用起来"。一张 H800 买回来,只代表你拥有了 80GB 显存的硬件;把它变成业务方可以调用的 /v1/chat/completions 接口,中间隔着一整条工程链路。
这条链路上的每一个环节都可能翻车:
|
环节 |
典型问题 |
后果 |
|
驱动与运行时 |
CUDA 版本与引擎不匹配、昇腾 CANN 版本不对 |
模型加载失败,报 OOM 或算子缺失 |
|
推理引擎 |
参数没调好,KV 缓存预留不足 |
并发一上来就 OOM,服务雪崩 |
|
显存规划 |
权重、引擎、KV 缓存没算清 |
部署前没发现,上线后跑不起来 |
|
多机通信 |
RDMA 不可用、卡间互联没配 |
张量并行跨机失败,吞吐断崖下跌 |
|
模型管理 |
权重散落在对象存储、机器目录、同事硬盘 |
版本对不上,回滚无门 |
|
服务交付 |
业务方要"一个地址",运维给不出 |
交付靠口口相传,出问题互相甩锅 |
为什么这套链路这么难:大模型推理的本质是"把模型权重和 KV 缓存放进显存,让引擎持续产出 token"。这件事的难点不在于单条命令能不能跑通,而在于参数之间的耦合:引擎参数影响显存占用,显存占用决定并发上限,并发上限决定业务体验,业务体验又反过来要求延迟和吞吐。任何一个环节算错,都会在运行时以 OOM、延迟雪崩或吞吐断崖的形式暴露出来。更麻烦的是,这些错误只有在真实并发压力下才会出现——单条 curl 测试永远测不出来。
更隐蔽的成本是"隐性知识":一个能跑通推理服务的团队,真正值钱的不是那几行启动命令,而是"A100 上 70B 模型要预留多少 KV 缓存""昇腾 910B 的 PD 分离怎么配""RDMA 不通时性能会掉多少"这类经验。这些经验散落在聊天记录、Wiki 和离职同事的硬盘里,人一走,服务就没人敢动。GPUWorks 这类平台的价值,正是把这些隐性知识固化成模板、评估和压测——让"会配环境"不再是使用门槛。
核心矛盾:业务方要的是"稳定的模型服务地址",运维手里是一堆散落的 GPU、模型文件和没人说得清的参数。中间缺一个能把"算力"翻译成"服务"的交付层。
1.2 三条路线的对比:手动部署、K8s 全家桶、GPUWorks
|
维度 |
手动部署(脚本 + 容器) |
K8s + Helm + Operator |
GPUWorks |
|
上手门槛 |
需要会配环境、调驱动、写编排 |
需要会 K8s 全家桶 |
一条命令装控制面,解压即用 |
|
交付形态 |
一堆脚本,无统一入口 |
Helm Chart + 一堆 YAML |
单二进制,自带安装/升级/停止 |
|
异构算力 |
每个平台各写一套 |
需额外开发设备插件 |
NVIDIA/昇腾/海光/PPU 统一纳管 |
|
部署前评估 |
无,部署后才知道跑不跑得动 |
部分方案有 |
显存/并发/KV 预算前置校验,放不下直接拒绝 |
|
可观测性 |
各自打点,东拼西凑 |
需自行集成 Prometheus 等 |
控制台内置监控、日志、令牌用量 |
|
自愈能力 |
无 |
需自行开发 |
升级回滚、节点掉线重连、失联换节点 |
|
业务接入 |
自己暴露接口 |
自己暴露接口 |
OpenAI 兼容接口,业务零改动 |
选型逻辑:如果你的团队已经有成熟的 K8s 平台和专职云原生团队,K8s 路线没问题;如果你只是想把手里几台 GPU 服务器变成稳定的内部推理服务,且没有专职 K8s 团队,GPUWorks 的"单二进制 + 模板化 + 内置可观测"是一条更轻的路。它不是要替代 K8s,而是把"从裸机到模型服务"这一段路做成开箱即用的产品。
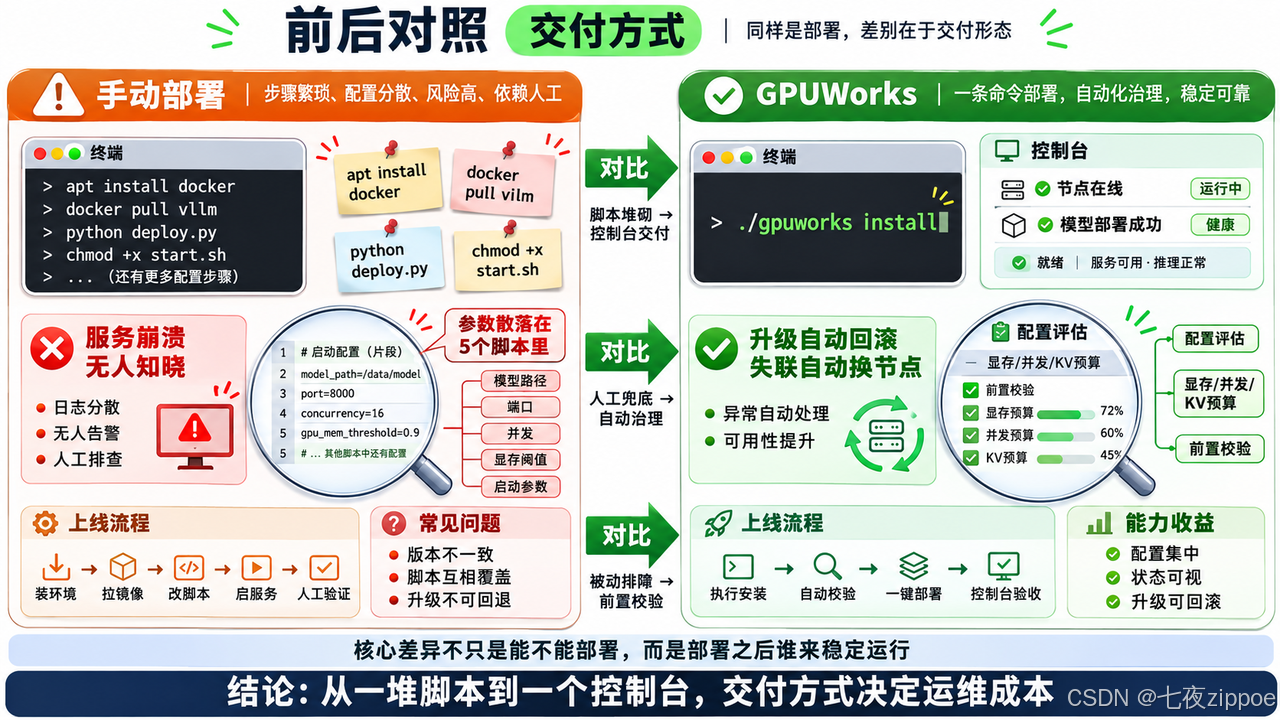
图:前后对照——手动部署的一堆脚本与 GPUWorks 单二进制交付的对比。
二、GPUWorks 是什么:核心概念与架构
2.1 一句话定义
GPUWorks 是 ZStack 推出的轻量级私有化模型交付平台:把分散在不同机房、不同云、不同厂商的 GPU(NVIDIA、昇腾、海光、PPU)纳管成一个推理集群,用模板化的方式把主流开放模型部署上去,再以 OpenAI 兼容接口稳定地提供给内部业务。
它解决的是"算力 → 服务"的翻译问题,而不是"模型训练"或"应用开发"的问题。定位非常清晰:不做训练平台,不做 RAG 编排,只做推理服务的交付与运维。
2.2 三层架构:控制面、节点代理、推理引擎
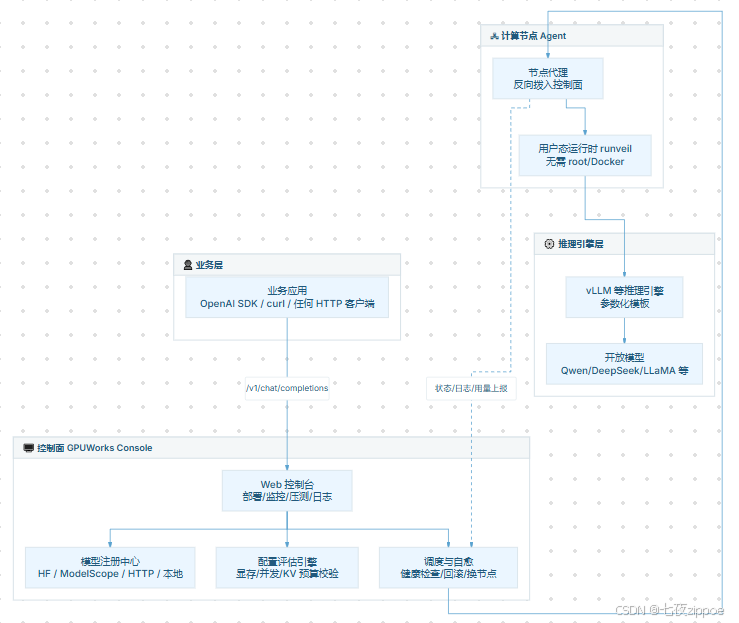
图:GPUWorks 三层架构全景,控制面、节点代理、推理引擎各司其职。
为什么是这三层,而不是一层或两层:把控制面、节点代理、推理引擎拆成三层,是为了解决私有化场景的两个核心矛盾。第一个矛盾是管理与执行的分离:控制面要能远程管理分散在机房里的节点,如果节点必须开放入站端口,很多内网和容器环境直接出局;Agent 反向拨入让"管理"变成"被管理方主动连接",防火墙和安全组不再成为障碍。第二个矛盾是环境差异的隔离:每台节点的驱动、运行时、容器环境都不一样,把差异收敛到 Agent + runveil 这一层,上层控制面看到的就是统一的"可部署节点",不用为每种环境写一套适配。
这套架构的取舍:三层架构引入了一个间接层(Agent),多一跳网络延迟。但对推理服务来说,Agent 只做状态上报和指令下发,数据面(模型推理流量)不经过控制面——业务请求直连节点上的推理服务。所以"间接层"只影响管理面,不影响推理性能。这是理解 GPUWorks 架构的关键:控制面管"事",数据面走"线"。
三层职责分明:
-
控制面(Console):唯一的管理入口。模型注册、配置评估、一键部署、压测、监控、日志、令牌用量都在这一个 Web 控制台里完成。安装包解压后就是一个单二进制,gpuworks install 一条命令起服务,默认监听 http://<服务器IP>:8800。
-
节点代理(Agent):装在每一台 GPU 服务器上的轻量代理。它通过反向拨入方式连接控制面——节点不需要开放任何入站端口,这对受限网络环境(防火墙、容器、云安全组)极其友好。Agent 负责上报节点状态、驱动版本、加速卡型号,并执行控制面下发的部署/升级/自愈指令。
-
推理引擎层:平台内置参数化模板,把 vLLM 等主流推理引擎的参数封装成"模型档位"。业务方不需要知道引擎参数,只需要选模型、选档位、点部署。
2.3 核心理念:算力应该像水电一样
GPUWorks 的核心理念可以压缩成一句话:让推理能力像水电一样,统一纳管,稳定供给,用多少算多少。
落到产品上是四条一以贯之的工程原则:
|
原则 |
含义 |
落到产品上的体现 |
|
🎯 结果可预期 |
部署前先评估,不放侥幸 |
显存放不下、并发预估不合理,直接拒绝并说明原因 |
|
🔍 失败可追溯 |
出错要能定位到具体字段 |
参数冲突、越界逐项定位到表单字段;RDMA 不可用明确报错,不悄悄降级 |
|
🛡️ 运行可自愈 |
故障自愈,不靠人肉救火 |
升级失败自动回滚;节点掉线有重连/反向拨入/带外恢复三级机制;失联默认自动换节点 |
|
🩺 运维可自查 |
排障要有抓手 |
健康探测、全文日志检索、节点自检、Web 终端、AI 诊断助手 |
这四条原则贯穿了整个产品的设计:部署前先评估,部署中报错要能定位,运行中故障自动恢复,出问题时有排障工具。它不追求"什么都能干",而是追求"每一步都可控"。
2.4 关键概念速览
动手之前,先统一几个术语:
-
模型档位:平台为不同模型预设的推理配置模板,包含引擎类型、并行方式、显存分配等。业务方选档位即可,不用手写引擎参数。
-
配置评估:部署前平台自动计算每卡显存需求、最低启动要求、预估最大并发和 KV 缓存预算,不满足直接拒绝。
-
反向拨入:节点 Agent 主动连接控制面,而非控制面去连节点。这是"不需要开放入站端口"的关键机制。
-
用户态运行时(runveil):在普通用户目录下直接拉起推理镜像的运行时,不需要 root、不需要 Docker。
-
OpenAI 兼容接口:服务暴露 /v1/chat/completions、/v1/models 等标准接口,业务方原有调用在线大模型的代码几乎零改动。
三、安装部署:从下载到第一条请求
3.1 环境准备
本文的环境是"一台管理机 + 一张算力卡"的最小可用组合,但麻雀虽小五脏俱全:
控制面服务器:一台腾讯云轻量服务器,OpenCloudOS 9.4 ,有公网 IP,至少 4 核 8GB 内存。它不需要 GPU,只是管理入口——模型注册、部署调度、监控计量、令牌签发都在这里。
计算节点:一台 AtomGit NoteBook 资源实例,搭载 1 张华为昇腾 910B4(32GB HBM),宿主机 192 核 1509GiB 内存。它没有公网入站能力,外面连不进去——这正是 GPUWorks Agent 反向拨入的用武之地。
网络:控制面需要能被浏览器访问(默认 8800 端口);计算节点不需要开放任何入站端口,Agent 主动外连控制面即可。
💡 提示:磁盘至少预留 100GB 以上。引擎镜像和模型权重比直觉占地方——一个 70B 模型的 FP16 权重就超过 140GB。昇腾场景还需确认节点已安装对应版本的 CANN 驱动。
3.2 下载与安装控制面
先看看服务器的系统配置
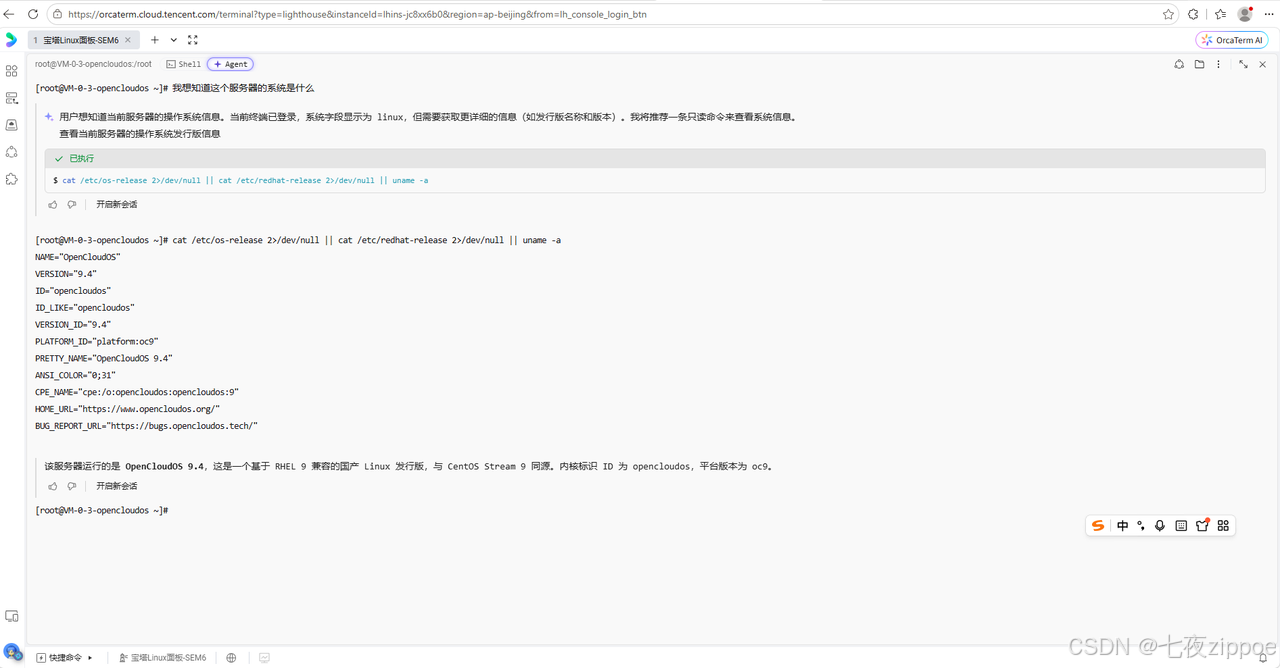
然后通过腾讯云控制台把安装包文件gpuworks-31178e80-linux-amd64.tar.gz上传到腾讯轻量服务器上
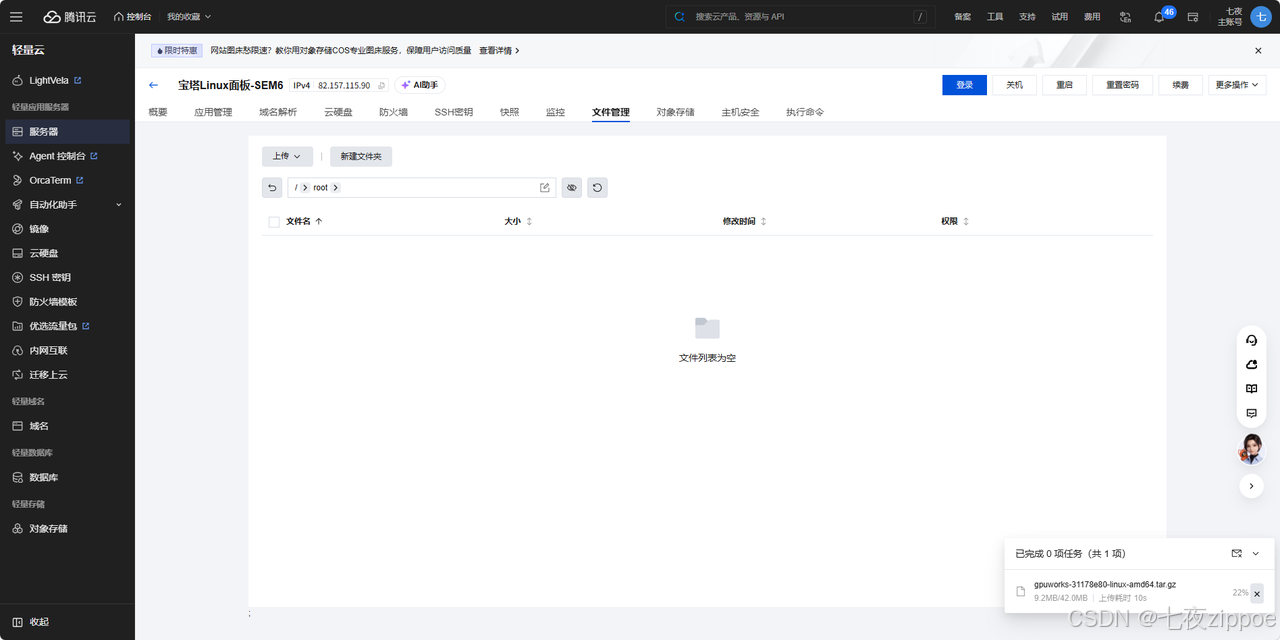
上传成功后,通过免密登录按钮进入到实例命令面板,进行安装然后一条命令起控制面:
# 1. 在服务器上解压
tar -zxzf gpuworks-31178e80-linux-amd64.tar.gz
# 2. 安装包解压后的文件
cd gpuworks-31178e80-linux-amd64/
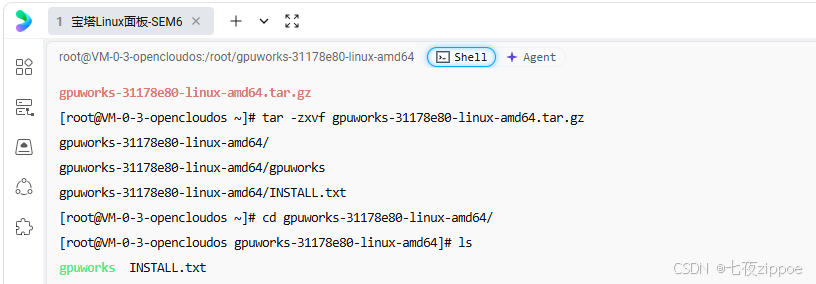
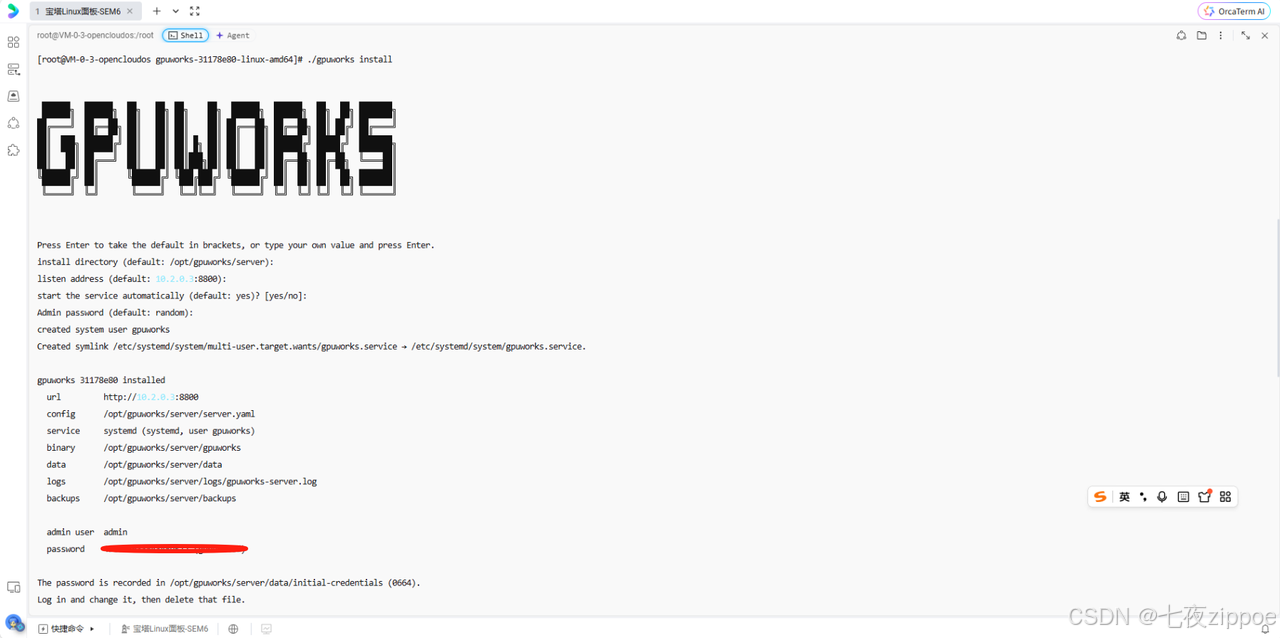
注意:安装包解压后只有两个文件——一个 68MB 的静态二进制和一个 1KB 的 INSTALL.txt,没有 Helm Chart、没有一堆 YAML、不需要先装 Docker。install 会创建系统用户、systemd 服务软链接,并列出二进制、配置、数据、日志与备份目录,初始管理员凭据保存在数据目录下的 initial-credentials 文件中,登录后需要修改密码并删除该文件。这一步的意义是:控制面活着,后面所有操作才有入口。
# 1. 安装控制面服务(安装器会询问安装目录、监听地址、是否自动启动等;安装过程中一直点击回车即可。)
./gpuworks install
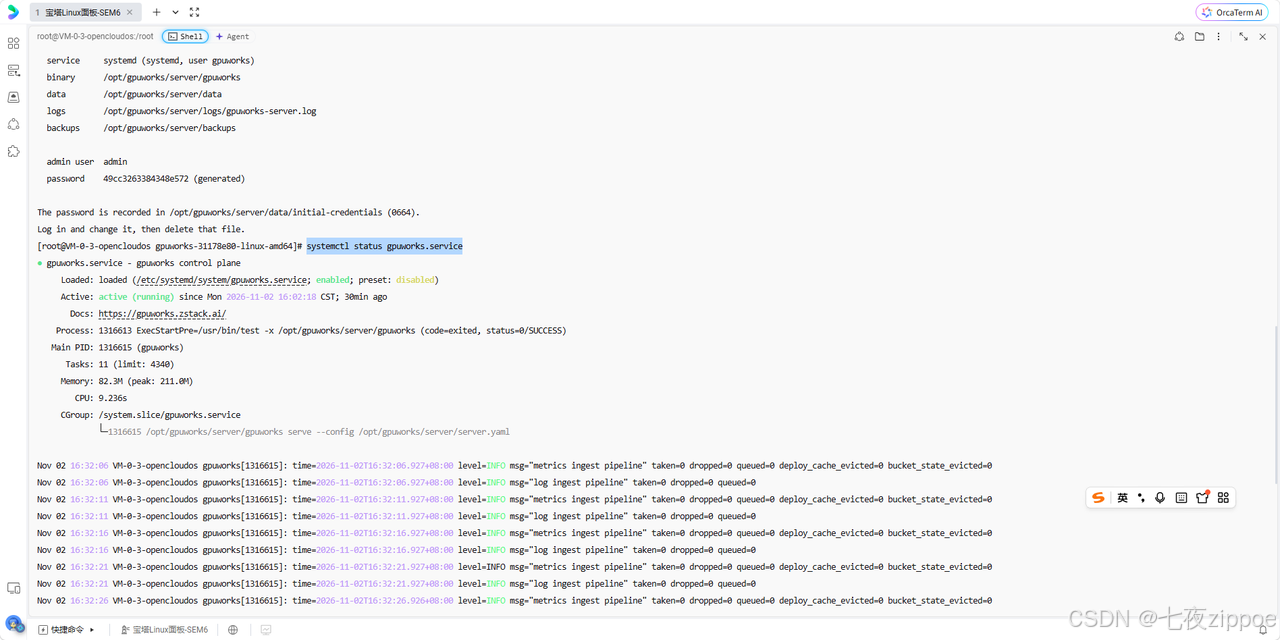
# 查服务状态
systemctl status gpuworks.service
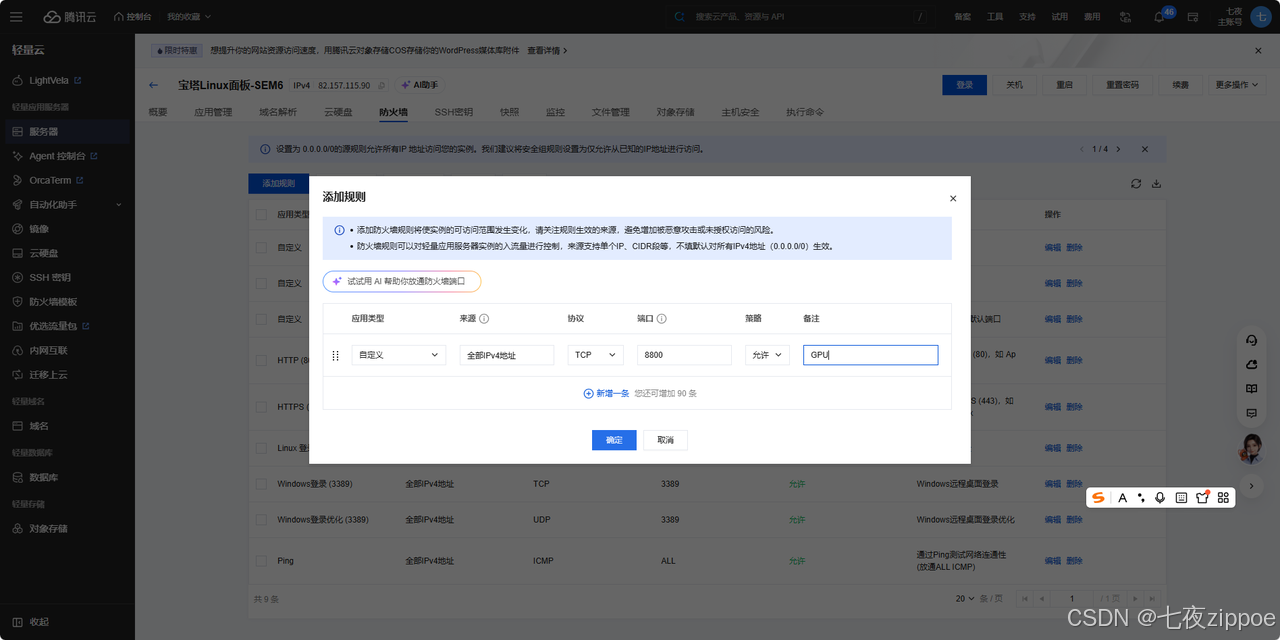
然后在防火墙添加规则放开8800端口
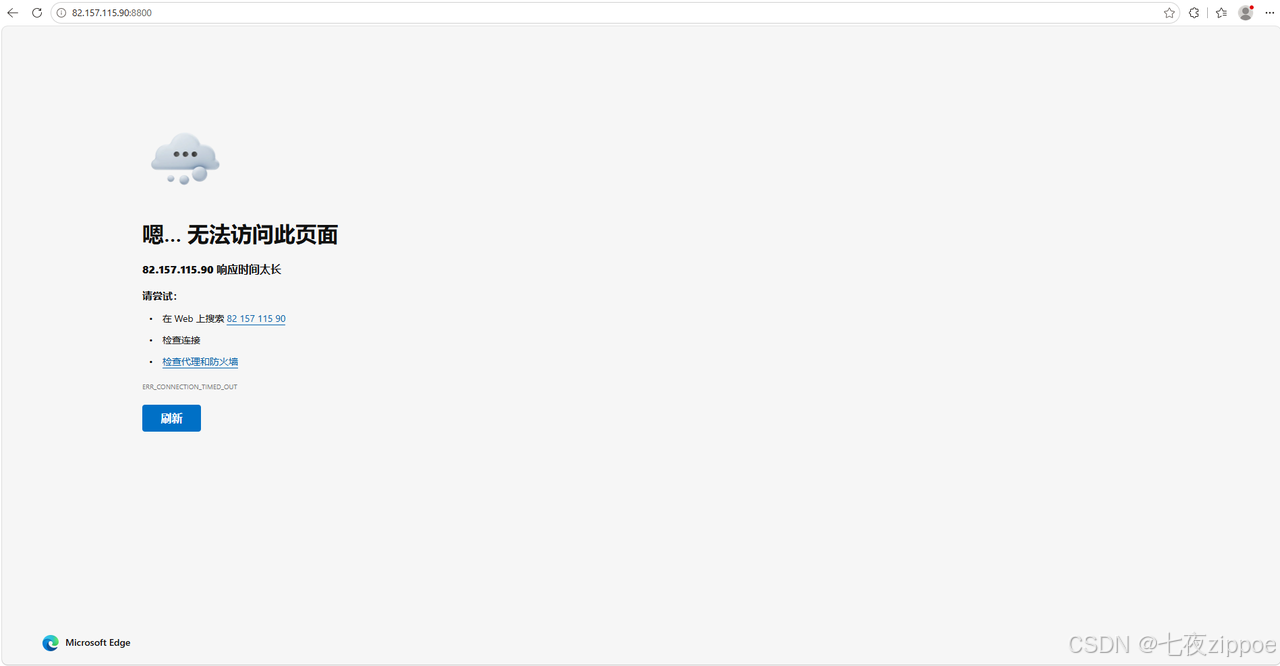
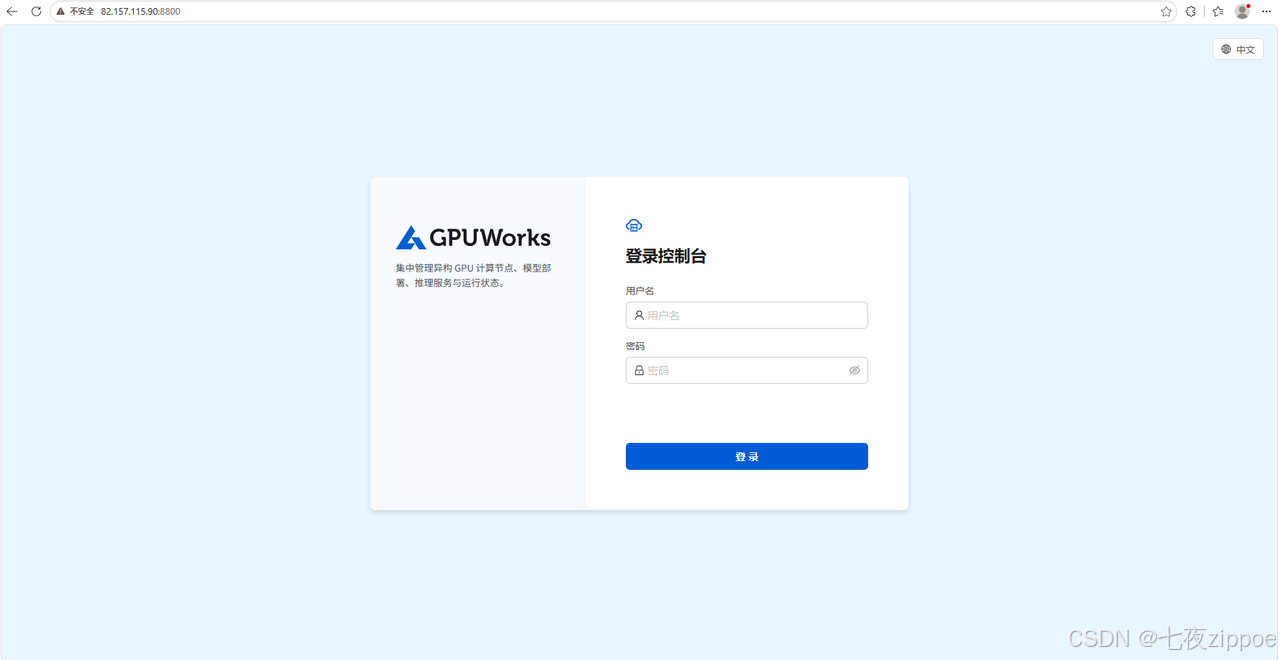
直接访问互联网地址:http://82.157.115.90:8800/。出现如下不能正常访问的问题。
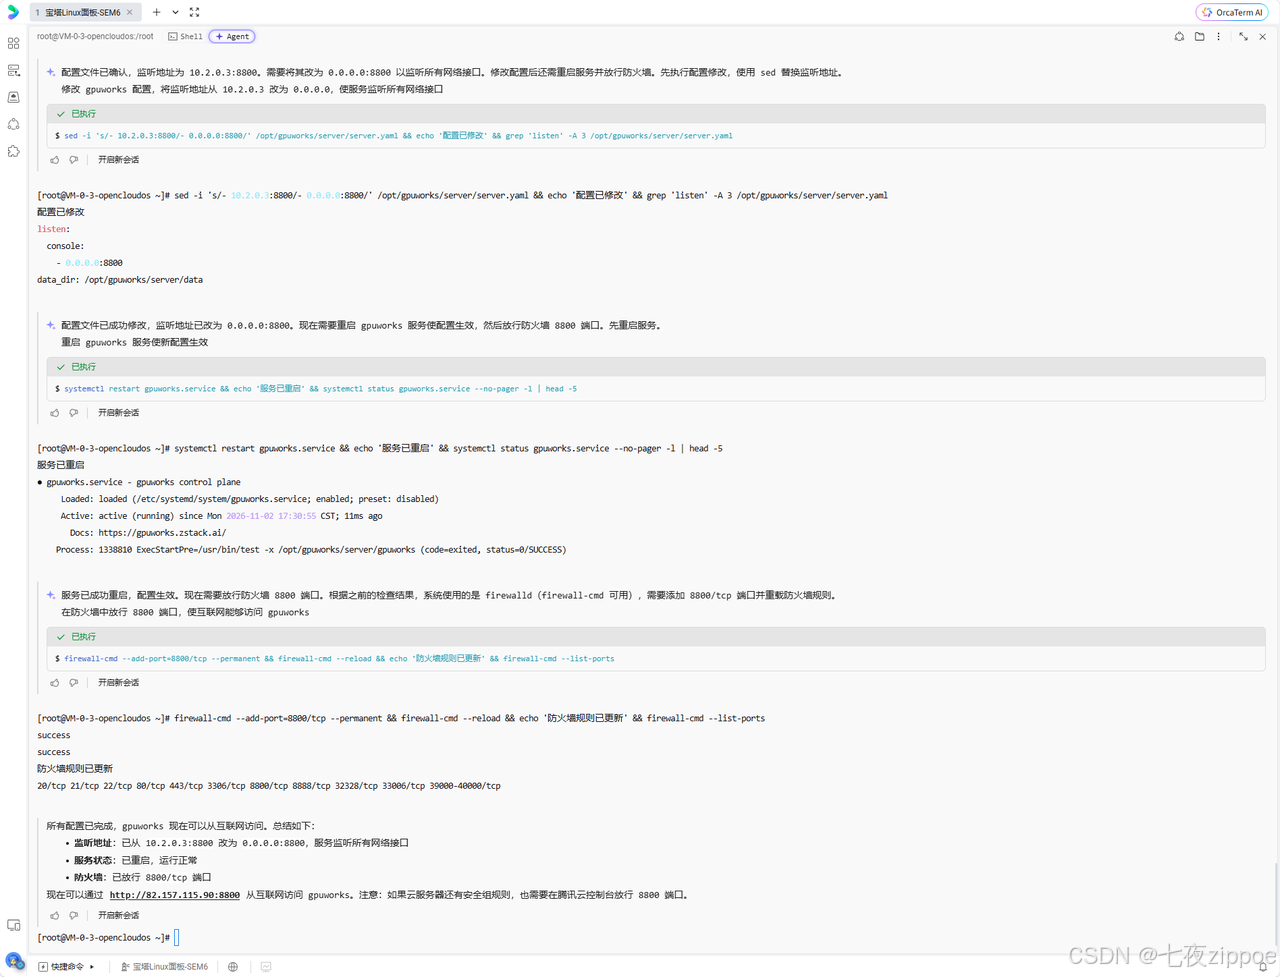
使用服务器中的Agent帮我分析排查服务在互联网无法正常访问的问题

定位到问题:
1.监听地址受限:8880 端口只监听了 127.0.0.1(本机)和 10.2.0.3(内网),没有监听 0.0.0.0,外部请求无法到达该服务。
2.防火墙未放行:当前防火墙已开放的端口列表中不包含 8800,即使修改监听地址,请求也会被防火墙拦截。 使用Agent修复这两个问题:
再访问互联网地址:http://82.157.115.90:8800/。正常出现如下界面:
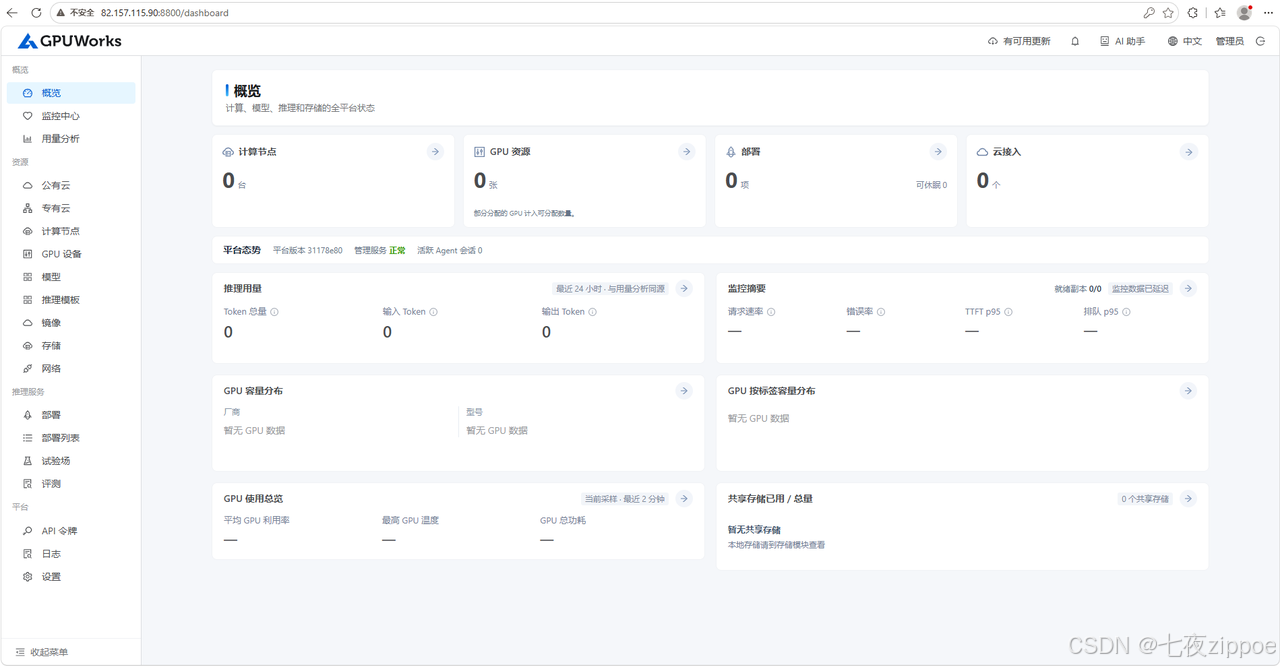
输入之前安装服务过程中生成的账号和密码,直接进入到服务首页,控制面服务安装完成。
3.3 接入计算节点
控制面就绪 ≠ 算力已纳管。接下来把 AtomGit NoteBook 的昇腾 910B4 接进来。由于 NoteBook 没有公网入站能力,使用 Agent 反向拨入——节点主动去连控制面,而不是控制面去连节点:
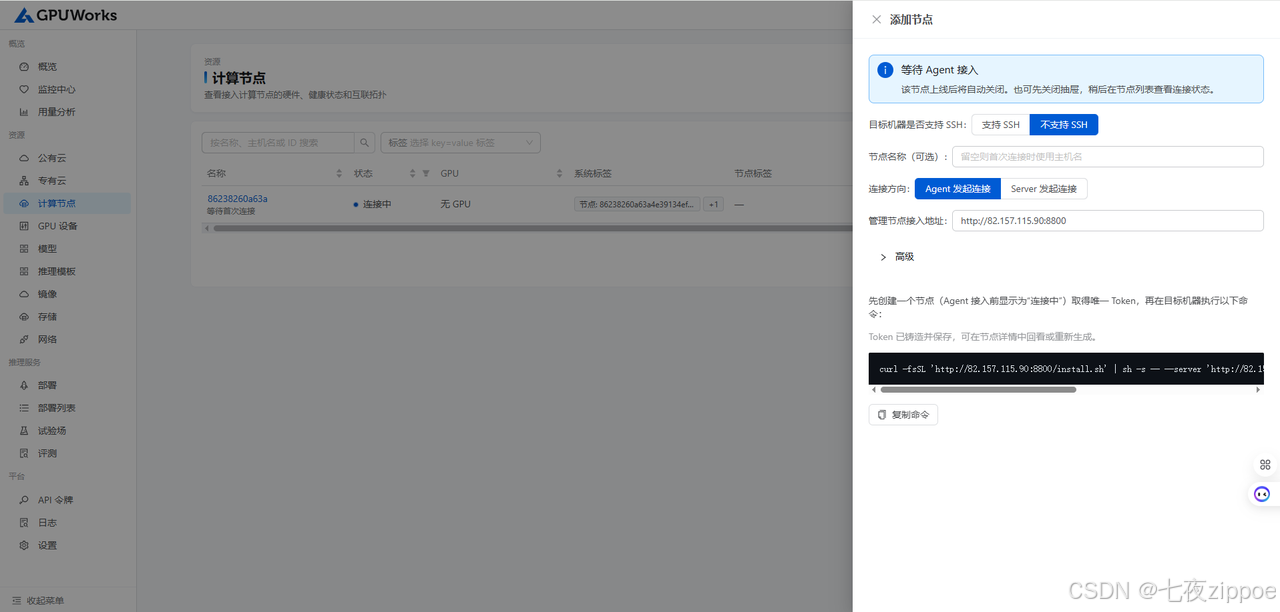
左侧选择【计算节点】进入节点列表页,点击右上角的【添加节点】按钮,弹出如图:
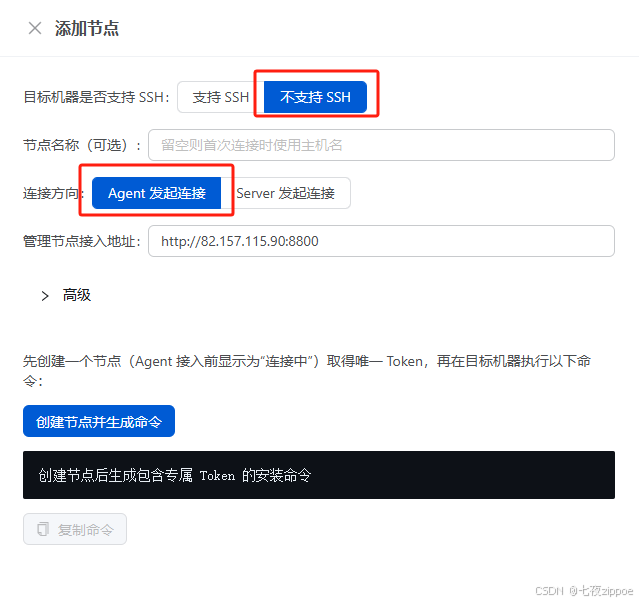
按上图指示选择后点击【创建节点并生成命令】按钮,执行结果如下图,成功创建节点,同时生成目标机器索要主执行的命令。
在AtomGit中激活Notebook,所选配置均为默认。激活后上传文件gpuworks-31178e80-linux-arm64.tar.gz。
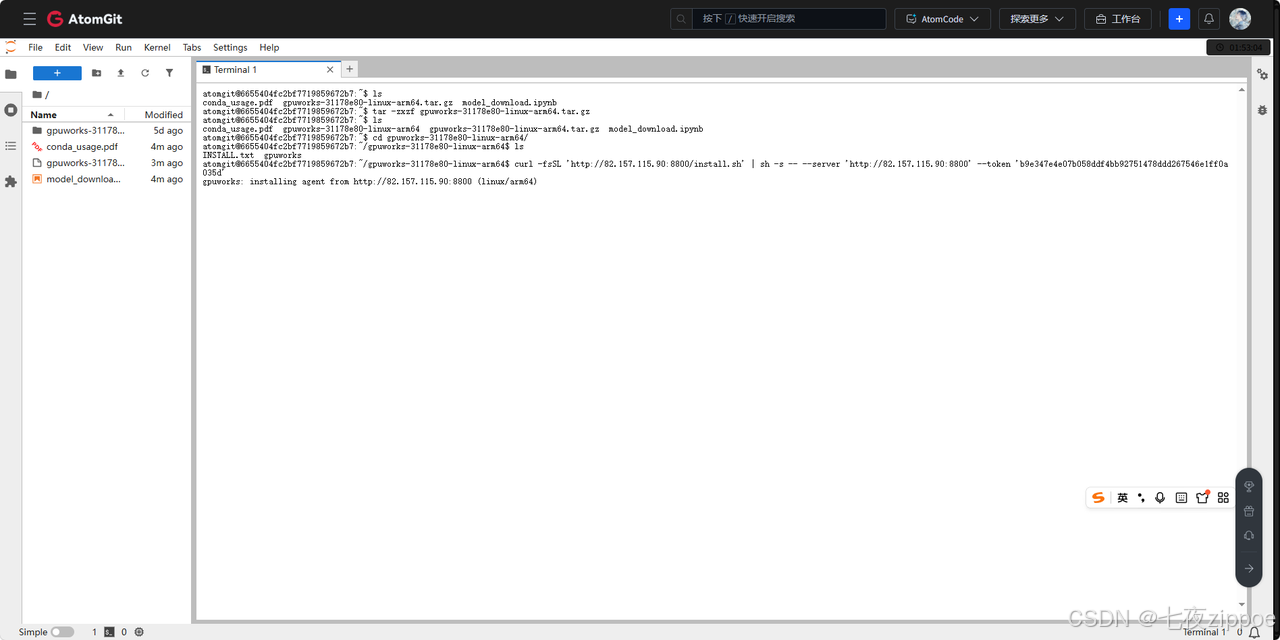
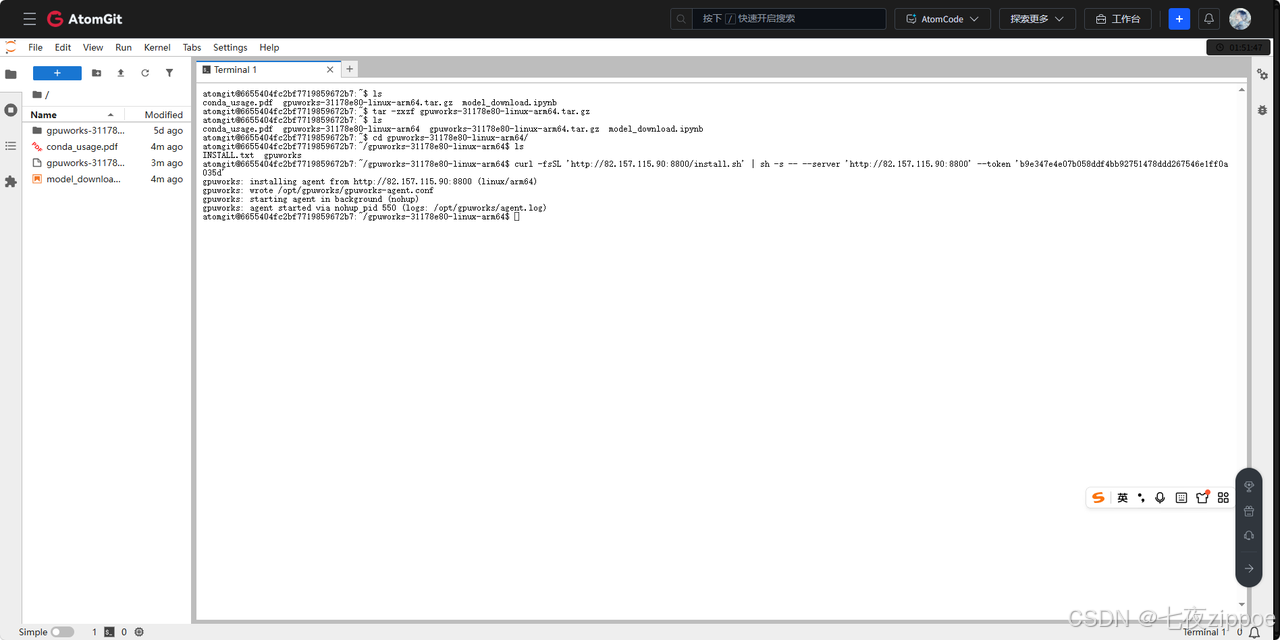
如上图将压缩包解压并进入到相应的文件中执行上一步创建节点时生成的命令。然后让代码飞一会儿。出现如下图结果时,节点添加就完成了。
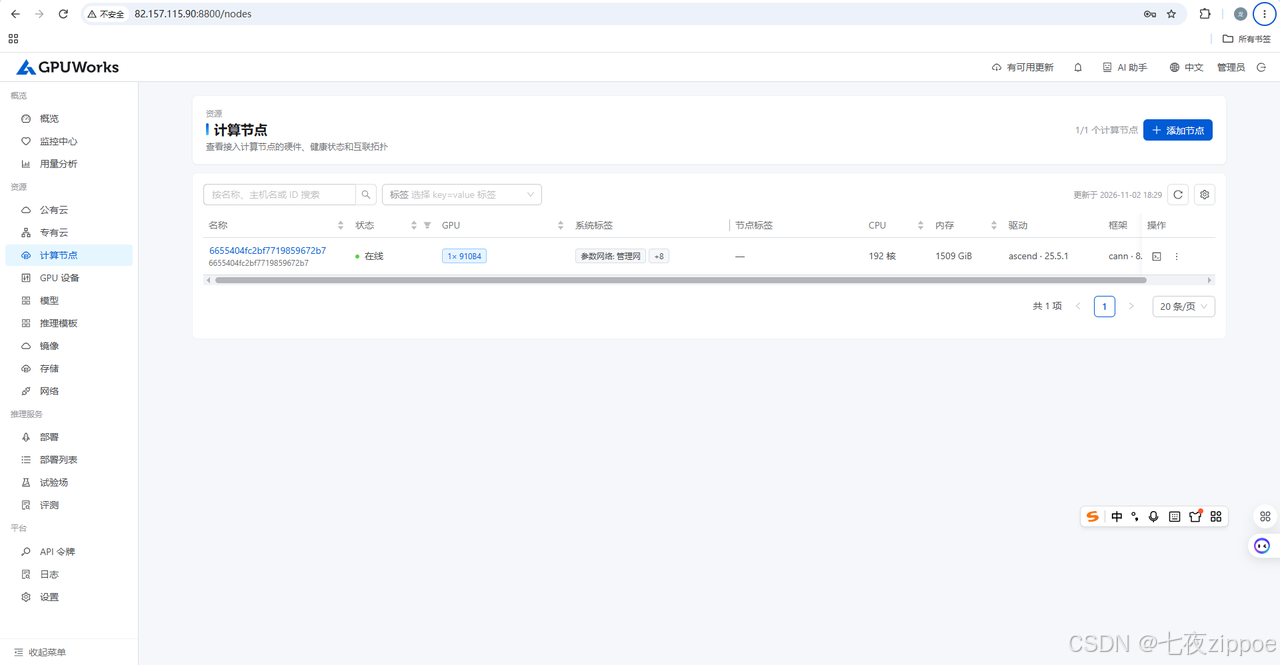
这个时候去查看GPUWorks的计算节点列表如下图,节点添加成功。
3.4 验证:从安装到第一条请求
到这里,一个最小的闭环已经形成:控制面在跑、昇腾节点已接入。接下来注册模型 → 配置评估 → 一键部署 → 拿到 OpenAI 兼容地址。
四、核心功能详解
4.1 模型注册与模板化部署
GPUWorks 支持四种模型来源,覆盖了从"在线拉取"到"离线导入"的全场景:
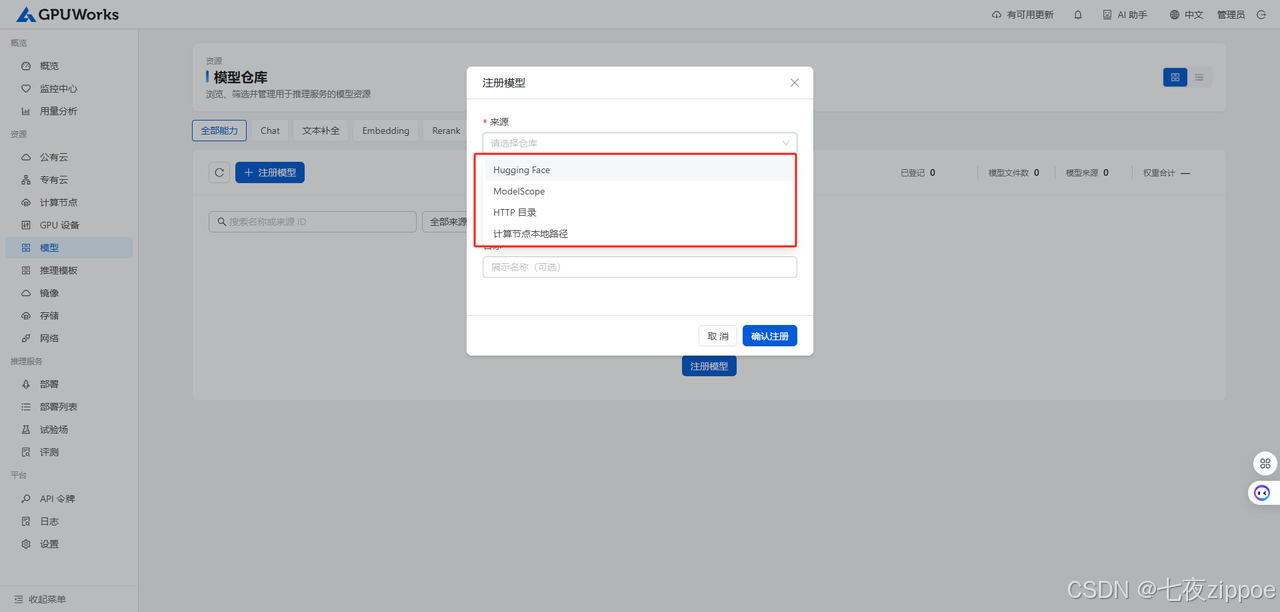
|
来源 |
适用场景 |
说明 |
|
🌐 Hugging Face |
公网可达,拉取开放模型 |
平台自动拉取并登记 |
|
🇨🇳 ModelScope |
国内网络,拉取国产模型 |
国内下载更快更稳,本文采用 |
|
🔗 HTTP 目录 |
内网模型仓库 |
指向自建的模型文件目录 |
|
💾 节点本地路径 |
离线/离线包场景 |
直接指定节点上的本地路径 |
推理目录收录 390 个模型 / 1230 个部署档位,其中 72 个模型提供昇腾专用档位。我选择从 ModelScope 注册 Qwen/Qwen2.5-0.5B-Instruct(模型选择的时候要跟计算节点对应,选择的不合适会出现偏离推理模版的问题,且不要选择太大的模型,太大超出GPU能力范围,也跑不起来)。从ModelScope读取模型元数据需要十几秒。模型注册成功。

如图点击按钮,进入到模型配置评估及部署界面。

部署界面选择默认选择【快捷部署】,在基础配置中模型选择刚注册的模型,目标芯片选择【昇腾】,其他的保持默认即可。

节点和资源的配置中,镜像需要根据计算节点实际情况进行选择,因为我的计算节点是910B4 芯片,属 A2 架构,所选镜像选择A2结构对应的gpuworks/gpuworks-runner:cann9.1-910b-vllm0.27.1rc1-r2。其他的不用动,用默认的即可。 注意:若镜像选择不匹配两者底层算子/指令集不同,vllm-ascend 在启动检测阶段就直接拒绝运行了,模型部署不成功大概率都是卡在这里。

在整个配置表单的右边有一个悬停的配置评估卡片,他会根据您配置的参数实时测评给出评估结果。解决用户盲配完,部署后再去实际测试的麻烦。

最后审核启动配置无误后,点击【部署】。

列表中出现如图,等待模型下载完成,模型部署就完成了。


点击列表右侧操作中按钮如下图按钮打开试验场。

试验场中可以选择相应的模型进行对话,因为我只部署了一个,所以默认选择Qwen/Qwen2.5-0.5B-Instruct-rnjj,发起对话,比想象中的要快的多,基本就是秒回。体验感超给力。
4.2 OpenAI 兼容接口:业务零改动
模型部署成功后,服务暴露标准的 OpenAI 兼容接口,创建新的令牌即可正常调用。要注意的是创建令牌的过程中,令牌字符串只显示一次,需要复制下来保存好,方便以后使用。

# 列出可用模型
curl http://<控制面公网IP>:8800/v1/models \\
-H "Authorization: Bearer $GPUWORKS_API_KEY"
# 调用对话接口
curl http://<控制面公网IP>:8800/v1/chat/completions \\
-H "Content-Type: application/json" \\
-H "Authorization: Bearer $GPUWORKS_API_KEY" \\
-d '{
"model": "Qwen/Qwen2.5-0.5B-Instruct",
"messages": [
{"role": "system", "content": "你是一个有帮助的助手。"},
{"role": "user", "content": "用一句话介绍私有化大模型推理。"}
],
"temperature": 0.7
}'
代码块说明:接口路径、请求体、鉴权方式与 OpenAI 官方 API 完全一致。业务方原来怎么调在线大模型,现在就怎么调这个私有服务——改一个 base_url,其余代码不动。这就是"算力像水电一样"的实际含义:业务方看到的只有"能调用的模型服务",不需要知道底层是 NVIDIA 还是昇腾、是单机还是多机。
# Python SDK 调用示例
from openai import OpenAI
client = OpenAI(
base_url="http://<控制面公网IP>:8800/v1",
api_key=os.environ["GPUWORKS_API_KEY"], # 请替换为实际值
)
completion = client.chat.completions.create(
model="Qwen/Qwen2.5-0.5B-Instruct",
messages=[
{"role": "system", "content": "你是一个有帮助的助手。"},
{"role": "user", "content": "用一句话介绍私有化大模型推理。"},
],
temperature=0.7,
)
print(completion.choices[0].message.content)
代码块说明:SDK 调用与调在线大模型完全同构,唯一变化是 base_url 指向 GPUWorks 控制面。这意味着存量业务代码的迁移成本极低——把 api.openai.com 换成内网地址即可。
windows终端直接调用,返回结果正常,调用成功。

4.3 内置压测:容量规划有据可依
平台内置压测工具,支持三种模式,吞吐口径与 vLLM bench serve 一致:
|
模式 |
用途 |
输出 |
|
🎯 SLA 搜索 |
按延迟目标搜"满足延迟的最大并发" |
最大并发数 + 对应吞吐 |
|
📈 固定并发 |
固定并发打满,探测吞吐天花板 |
峰值吞吐 + 延迟分位 |
|
🔬 按到达率 |
按请求到达速率施压,贴近真实流量 |
各到达率下的吞吐与时延 |

压测结果可导出 md / csv / html 报告。比起看宣传材料猜容量,这套数据可以直接作为采购和扩容依据——"满足 P99 500ms 的最大并发是 16"是一个可以写进容量规划的硬结论,而不是"应该够用"的模糊判断。内置压测还提供逐请求延迟拆解:网关、排队、Prefill、输出各段耗时一目了然,帮你判断瓶颈在哪一段。


为什么内置压测是差异化能力:推理服务的容量规划是"玄学"高发区。手动部署时,压测要自己搭工具、自己算指标、自己写报告;GPUWorks 把它做成部署后的内置步骤——服务起来先跑一遍压测,拿到真实吞吐和延迟,再决定是否扩容或调参。
4.4 全链路可观测


节点在线状态、GPU 健康、部署状态、日志、令牌用量都在同一控制台里:
-
健康探测:服务存活、模型加载状态、显存水位一目了然
-
全文日志检索:FTS5 全文检索,按节点、按模型、按时间过滤,前后 500 行上下文,不用登录机器翻日志
-
逐请求延迟拆解:每个请求的延迟拆成网关、预处理、排队、Prefill、思考、回答各段,按 key、副本、耗时筛选
-
节点自检:doctor 一键检查驱动、运行时、网络连通性
-
Web 终端:直接在浏览器里开节点终端,免 SSH
-
AI 运维助手:常驻侧边栏,四个一键任务(实例失败诊断、模型硬件适配、调度不上、节点健康);通过 MCP 被 Claude Code 等工具直接调用,终端里问一句就能拿到集群状态
-
OTLP trace 导出:W3C trace 透传,可导出到 Jaeger 等链路追踪系统
监控指标体系怎么读:推理服务的监控要盯四类指标,缺一不可——资源类(GPU 利用率、显存占用、温度)、服务类(请求数、QPS、错误率)、质量类(P99 延迟、吞吐 tokens/s、首 token 时间)、业务类(令牌用量、并发会话数、模型分布)。只看资源不看质量会"资源正常但用户已超时",只看质量不看资源会"延迟飙了不知道哪张卡先炸"。GPUWorks 把这四类指标放进一个控制台,意味着排障时可以从现象(延迟高)一路下钻到原因(某节点显存水位 95%),而不是登录机器一个个查。
五、总结
私有化大模型推理不该是"能跑,但没人敢保证它一直能跑"。GPUWorks 把散落的算力收拢成一套推理服务:部署前有配置评估把关,部署中出错会明确报错而不是静默降级,运行中健康检查和自愈机制兜底,出问题有日志检索、Web 终端和 AI 诊断助手。
落地路径压缩成六步:下载解压 → 安装控制面 → 接入节点 → 注册模型 → 配置评估一键部署 → 内置压测验证。每一步都有验证标准,失败了也知道原因和下一步动作。业务方打开就能用,用多少有计量,出问题有人管。
本文给出的命令和参数基于当前版本,实际使用请以官方 INSTALL.txt 与 –help 为准。如果你正打算把手里的 GPU 真正用起来,或者想先花一个下午跑通一个最小可用的推理平台,不妨从那个约 44MB 的单二进制开始试:打开控制台、接入节点、部署第一个模型——剩下的,交给它。