/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
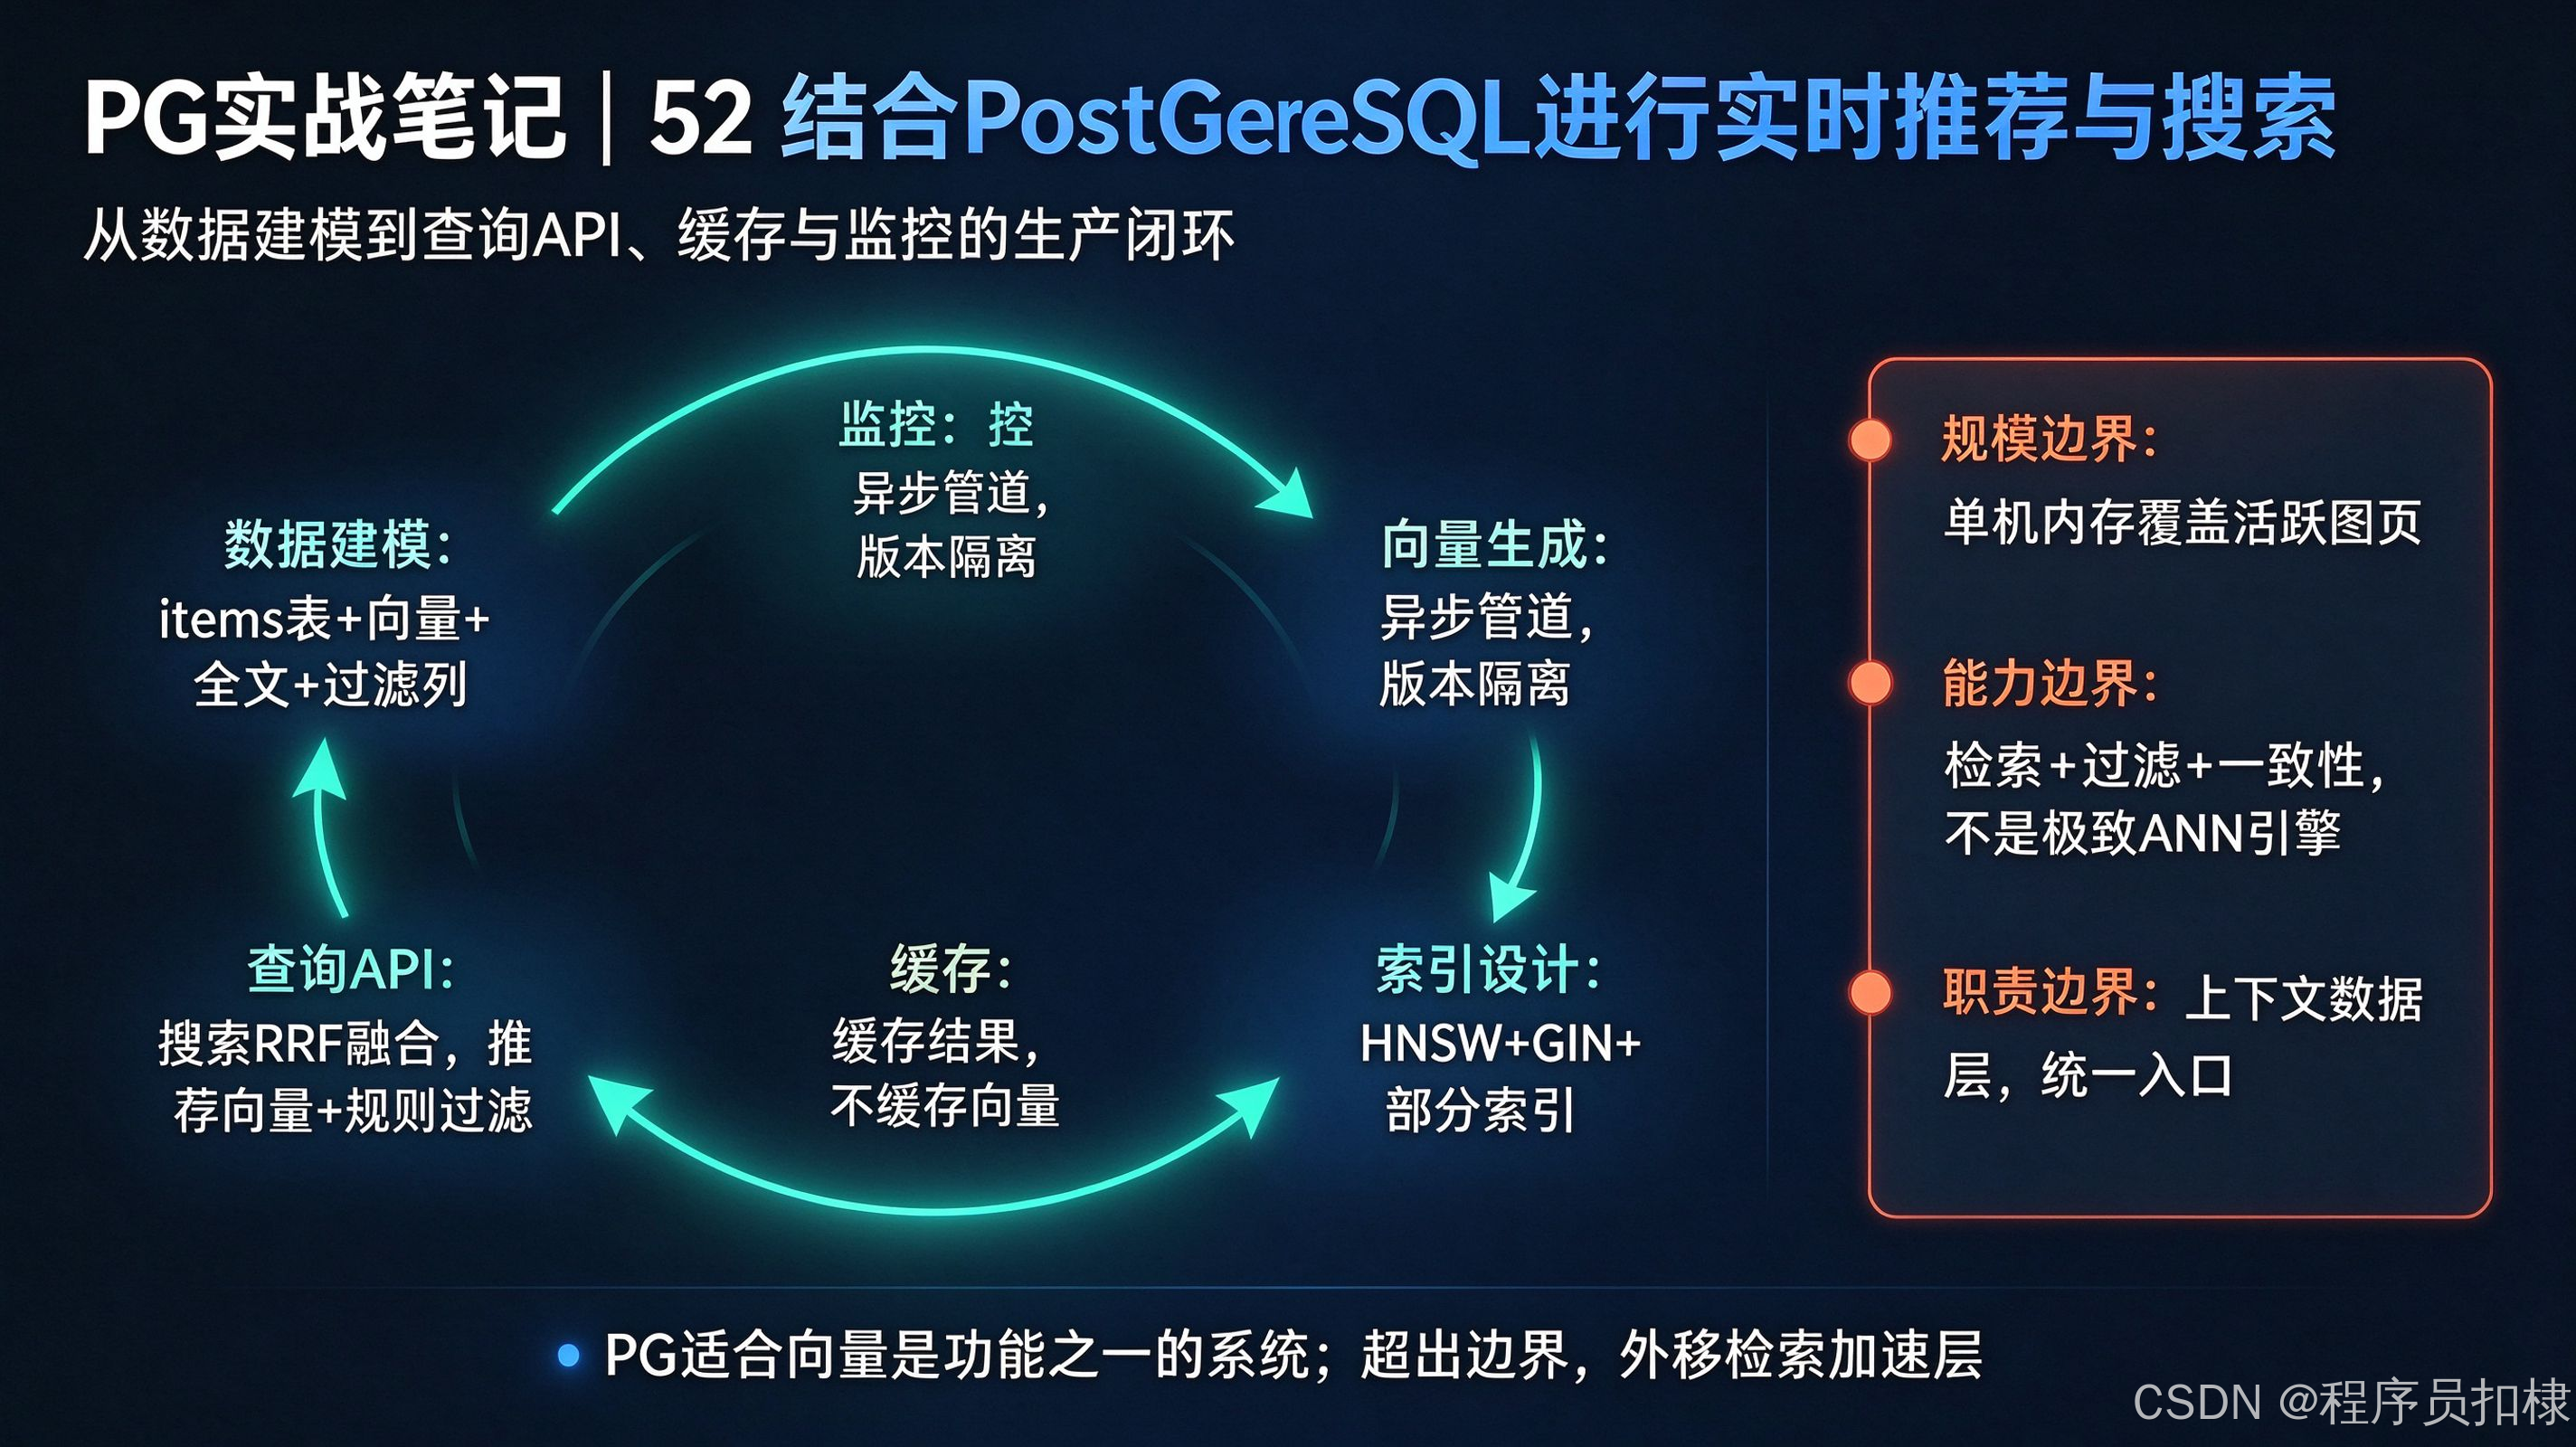
这是《PostgreSQL 实战进阶笔记》AI 专题的收官篇。前面我们拆了 pgvector 的安装、存储、查询、索引和性能调优,但这些都是“零件”。这一篇,我们把零件组装起来:一个生产级的实时推荐/语义搜索服务,从数据建模、向量生成、索引设计、查询 API、缓存策略到性能监控,完整走一遍。 最后回答两个架构层面的问题:如何设计可扩展的向量搜索服务?PostgreSQL 在架构中的边界到底在哪里?
一、先定架构:PG 是唯一数据源,还是数据源之一?
在写第一行建表语句之前,必须先回答一个架构问题:PostgreSQL 在这个系统中承担什么角色? 这个选择决定了后续所有设计的复杂度。
模式一:PG 作为唯一数据源(推荐起点)。 业务数据、向量、全文索引、元数据全部在 PG 中。推荐/搜索直接查询 PG,不需要跨系统同步。适合向量规模在千万级以内、团队规模不大、希望快速上线的场景。这是最简架构,也是本系列一直强调的“用 PG 消除跨系统一致性负担”的落地形态。
模式二:PG 作为上下文数据层,专用向量库作为检索加速层。 当向量规模进入数千万到亿级、或对 P99 延迟有严格 SLA 时,把向量检索迁移到专用向量库,PG 保留业务数据和元数据。代价是跨系统一致性、双写和结果拼装。这种混合架构在上一篇讨论过,是规模超出单机边界时的理性选择。
本篇的实战以模式一为主,因为它是大多数团队应该从之起步的架构;在最后一节讨论模式二的边界和迁移信号。
二、数据建模:推荐和搜索共用一张“物品表”,但各有侧重
一个同时服务推荐和搜索的系统,物品(item)表是核心。它的设计需要同时满足两类查询:
- 搜索:用户输入查询词,需要语义匹配 + 关键词匹配 + 业务过滤;
- 推荐:给定用户向量或用户最近交互的物品向量,需要找相似物品 + 业务规则过滤。
一个可用的物品表结构:
CREATE TABLE items (
id BIGSERIAL PRIMARY KEY,
title TEXT NOT NULL,
description TEXT,
category TEXT NOT NULL,
price NUMERIC(12,2),
embedding vector(1024),
fts tsvector GENERATED ALWAYS AS (
setweight(to_tsvector('simple', coalesce(title,'')), 'A') ||
setweight(to_tsvector('simple', coalesce(description,'')), 'B')
) STORED,
is_active BOOLEAN NOT NULL DEFAULT true,
created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
updated_at TIMESTAMPTZ NOT NULL DEFAULT now()
);
几个关键设计决策:
embedding 与 fts 同表。 这是 PG 的核心优势——语义检索和关键词检索在同一个事务边界内,不需要跨系统拼接。fts 使用生成列,写入时只计算一次。
category、price、is_active 作为过滤列。 推荐和搜索都需要在向量排序之前或同时应用业务过滤。这些列上的 B-tree 索引和部分索引,是混合查询性能的基础。
is_active 配合部分索引。 如果业务中大部分查询只针对上架物品,为 is_active = true 建部分 HNSW 索引,可以让索引体积和写入维护成本都显著降低。
用户侧的表取决于推荐策略。如果是“基于物品的协同过滤”,需要一张 user_item_interactions 表记录交互;如果是“基于用户画像向量”,需要一张 users 表存用户向量。用户向量的更新频率远高于物品向量,它的存储和索引策略需要单独考虑——通常不需要对用户向量建 ANN 索引,因为推荐查询是“用用户向量去搜物品”,用户向量只作为查询参数,不作为被检索对象。
三、向量生成:异步管道,不在请求路径上
向量生成(调用嵌入模型)通常是外部 API 调用或本地模型推理,耗时在几十到几百毫秒,且可能失败。它绝不能放在用户请求的同步路径上,否则搜索/推荐的延迟会被嵌入模型绑架。
推荐的管道设计:
物品侧:写入时异步生成。 物品创建或更新后,通过消息队列(或 PG 的 LISTEN/NOTIFY)触发一个后台 worker,调用嵌入模型生成向量,回写到 items.embedding。写入路径只负责落库和发消息,不等待向量生成。
用户侧:行为触发或定时更新。 用户向量可以基于最近 N 次交互的嵌入做加权平均,在交互发生后异步更新;也可以定时批处理。用户向量的“新鲜度”要求通常低于物品向量,允许一定的延迟。
一个必须处理的工程细节是“向量版本”。 当嵌入模型升级时,新旧向量不在同一个语义空间。items 表应该有一个 embedding_model 字段(或单独的版本表),记录每条向量是用哪个模型生成的。查询时只用当前模型版本的向量参与检索,旧版本的向量在回填完成前不进入候选集。这是上一篇讨论的“扩展/收缩迁移”在应用层的配套机制。
四、索引设计:HNSW 为主,部分索引和 GIN 配合
索引设计需要同时服务搜索和推荐两条路径。
搜索路径:混合检索,需要 HNSW(向量)+ GIN(全文)+ B-tree(过滤)。
— 向量索引:只索引上架物品
CREATE INDEX idx_items_embedding_hnsw ON items
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64)
WHERE is_active = true;
— 全文索引
CREATE INDEX idx_items_fts_gin ON items USING gin (fts);
— 业务过滤
CREATE INDEX idx_items_category ON items (category) WHERE is_active = true;
推荐路径:通常是“给定用户向量,找相似且可推荐的物品”,同样走 HNSW + 过滤。如果推荐有强业务规则(如“只推荐同品类、价格在用户历史价格区间内”),过滤条件的选择性可能很高,这时需要评估部分索引是否比“全表 HNSW + 后过滤”更合适。
索引构建的顺序:物品数据可能持续增长,但向量索引的构建是重操作。批量导入新物品时,先 COPY 数据、后建索引的原则仍然适用。对于持续增量写入的场景,HNSW 支持增量插入,但大量写入后索引会膨胀,需要定期 REINDEX CONCURRENTLY。
五、查询 API:搜索和推荐各一条主路径,融合在 SQL 内完成
搜索 API:向量 + 全文 + RRF
搜索请求通常包含:查询文本、业务过滤条件(品类、价格区间)、分页参数。处理流程:
把融合放在 SQL 内完成,避免把两路结果拉到应用层再拼装:
WITH vec AS (
SELECT id, RANK() OVER (ORDER BY embedding <=> $1) AS r
FROM items
WHERE is_active = true AND category = $3
ORDER BY embedding <=> $1
LIMIT 50
),
kw AS (
SELECT id, RANK() OVER (ORDER BY ts_rank_cd(fts, q) DESC) AS r
FROM items, plainto_tsquery('simple', $2) q
WHERE is_active = true AND category = $3 AND fts @@ q
ORDER BY ts_rank_cd(fts, q) DESC
LIMIT 50
)
SELECT i.id, i.title, i.price,
COALESCE(1.0/(60+v.r),0) + COALESCE(1.0/(60+k.r),0) AS score
FROM vec v FULL OUTER JOIN kw k USING (id)
JOIN items i ON i.id = COALESCE(v.id, k.id)
ORDER BY score DESC
LIMIT 20;
关键点:两路的 LIMIT 50 必须足够大,否则融合时某一路的候选不足。业务过滤 category 下推到每一路内部,而不是融合后过滤——这是上一篇强调的“过滤下推”原则。
推荐 API:用户向量 + 排除已交互 + 业务规则
推荐请求通常包含:用户 ID、排除已交互物品、业务规则。处理流程:
SELECT i.id, i.title, i.price,
i.embedding <=> $1 AS distance
FROM items i
WHERE i.is_active = true
AND i.category = $2
AND NOT EXISTS (
SELECT 1 FROM user_item_interactions u
WHERE u.user_id = $3 AND u.item_id = i.id
)
ORDER BY i.embedding <=> $1
LIMIT 20;
排除已交互物品的 NOT EXISTS 子查询是性能敏感点。 如果用户交互量很大,这个子查询可能成为瓶颈。优化方向:把交互记录缓存到 Redis(作为布隆过滤器或集合),在应用层先排除,再查 PG;或者把“已交互”作为 is_active 之外的另一类部分索引条件。在 pgvector 0.8+ 中,如果过滤条件导致存活不足,启用 iterative_scan = relaxed_order 可以让索引继续扫描直到凑够结果,这是处理高选择性排除条件的直接手段。
六、缓存:缓存“结果”,而不是“向量”
向量检索的延迟通常在几十毫秒到几百毫秒,对于高频的搜索/推荐请求,缓存是必要的。但缓存什么,需要想清楚。
缓存查询结果,而不是向量本身。 向量本身已经在 PG 中,缓存它没有意义。应该缓存的是查询结果:对于相同的查询文本 + 过滤条件,或者相同的用户 ID + 推荐上下文,结果在短时间内是稳定的,可以直接返回缓存。
搜索结果的缓存键:hash(query_text + filters + limit)。搜索的缓存命中率取决于查询的重复率——热门搜索词的重复率高,长尾查询的重复率低。
推荐结果的缓存键:user_id + context。推荐的缓存需要设置较短的 TTL(如 5–15 分钟),因为用户兴趣和物品状态会变化。用户产生新交互时,应主动失效该用户的推荐缓存,而不是等 TTL 过期。
缓存层的边界:缓存不解决“向量检索本身慢”的问题,它只解决“重复查询”的问题。如果缓存命中率低,应该回到查询优化和索引调优,而不是继续加缓存。
七、性能监控:四个必须盯住的指标
一个向量搜索/推荐服务上线后,需要持续监控四类指标。
第一,检索延迟的分位数,而不是平均值。 P50 好看不代表系统健康,P99 才是用户体验的真实下限。pg_stat_statements 中的 mean_exec_time 会被大量快查询稀释,应该结合 auto_explain 或应用层埋点,看单条查询的 P99。
第二,召回质量。 用 Recall@K 定期抽样验证(方法见第 48 篇)。召回率不会“报错”,它只会静默下降——数据分布漂移、索引膨胀、过滤条件变化,都可能让召回从 0.95 掉到 0.8,而延迟指标看起来一切正常。
第三,缓存命中率。 搜索和推荐分别统计。命中率低说明缓存键设计或 TTL 设置有问题,或者查询的重复率本身就低,缓存不是正确的优化方向。
第四,索引健康度。 HNSW 索引的膨胀率、idx_scan 是否在增长、REINDEX CONCURRENTLY 的执行频率。一个长期未重建的 HNSW 索引,查询延迟可能随着死元组积累而缓慢上升,这种退化是渐进的,不会触发任何告警。
八、PG 的边界在哪里?
回到最后一个核心问题。经过这 52 篇的拆解,PG 在向量搜索/推荐架构中的边界可以概括为三条。
第一条,规模边界:单机内存能覆盖活跃图页时,PG 是最简、最一致的架构;超出时,分区或混合架构是理性选择。 HNSW 的单向量图开销约 20–25KB,百万级向量对应数十 GB 内存。当活跃图页无法常驻缓存时,延迟会从毫秒级跳到不可预测的随机 I/O 级。这时按业务维度分区是第一杠杆,专用向量库是第二杠杆。
第二条,能力边界:PG 擅长“检索 + 过滤 + 事务一致性”的组合,不擅长“极致 ANN 性能”。 pgvector 的 HNSW 在百万级向量上的 QPS 和 P99 延迟与专用向量库存在量级差距,这是单主架构与分布式向量引擎的设计目标差异,不是调参能弥合的。当业务对 P99 延迟有硬性 SLA、或向量规模进入亿级时,专用向量库的价值是真实的。
第三条,职责边界:PG 是上下文数据层,不是万能的检索引擎。 它的核心价值不是“比专用向量库快”,而是让向量、业务数据、权限元数据、全文索引在同一个事务边界内,消除跨系统一致性负担。当规模超出边界时,PG 仍然可以充当统一入口和元数据源,把专用向量库通过 FDW 或应用层整合进来——迁移的是检索加速层,不是整个数据架构。
一句话总结:PG 适合“向量是功能之一”的搜索/推荐系统,在单机内存可覆盖的规模内,它是最简、最不容易出错的架构;当规模或延迟要求超出边界时,把检索加速层外移,但保留 PG 作为上下文和一致性基座。
九、系列总结
52 篇走下来,我们从安装、SQL、架构、备份、锁、索引,一路写到 pgvector、向量检索和实时推荐。如果只记三句话:
第一,PostgreSQL 的核心竞争力是“扩展”和“一致性”。 扩展让它能覆盖向量、地理、时序、JSON 等多种数据;一致性让它在同一个事务边界内解决跨系统对账的问题。
第二,向量检索的本质是“用召回换延迟”。 理解这一点,你才知道为什么 ef_search 和 probes 要先满足召回再停手,为什么过滤查询需要迭代扫描,为什么高维场景的延迟基线天然更高。
第三,架构选择由约束决定,不由技术热度决定。 数据量、内存、延迟 SLA、团队规模,这些约束决定你是用“纯 PG”还是“PG + 专用向量库”。没有最好的架构,只有匹配约束的架构。
思考题:
如果你现在要基于这套方案搭建一个搜索/推荐服务,你会选择“纯 PG”还是“PG + 专用向量库”的混合架构?你的向量规模、内存预算和延迟要求分别是什么?另外,你的系统里有没有“向量生成”在同步路径上的情况——如果有,你打算怎么把它移到异步管道?欢迎在评论区聊聊你的架构选择,这也是这个系列最后的开放讨论。




