/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
《人工智能学习笔记》系列第 3 篇,共 9 篇。
本章导读 从"人写规则"转到"机器从数据里找规则"。这一章是全书的地基:定义、分类、流程、评估、优化、算法,六件事以后每一章都会回来用。
读完你应该能回答:① T、P、E 分别指什么?② 为什么"训练集损失很低"不能说明模型好?③ 偏差和方差各自对应什么毛病、怎么治?
本章骨架
| 2.1 算法 | 机器学习 = 用经验 E 改进任务 T 的绩效 P,前提是目标函数未知 |
| 2.2 分类 | 有标签是监督(回归/分类),无标签是无监督,与环境交互试错是强化 |
| 2.3 流程 | 数据处理 → 特征 → 建模 → 评估,数据决定能力天花板 |
| 2.4 重要方法 | 梯度下降调参数,超参数靠搜索,交叉验证防"一次侥幸" |
| 2.5 常见算法 | 八个经典算法各自的假设、优缺点与适用场景 |
2.1 机器学习算法
定义:T、P、E
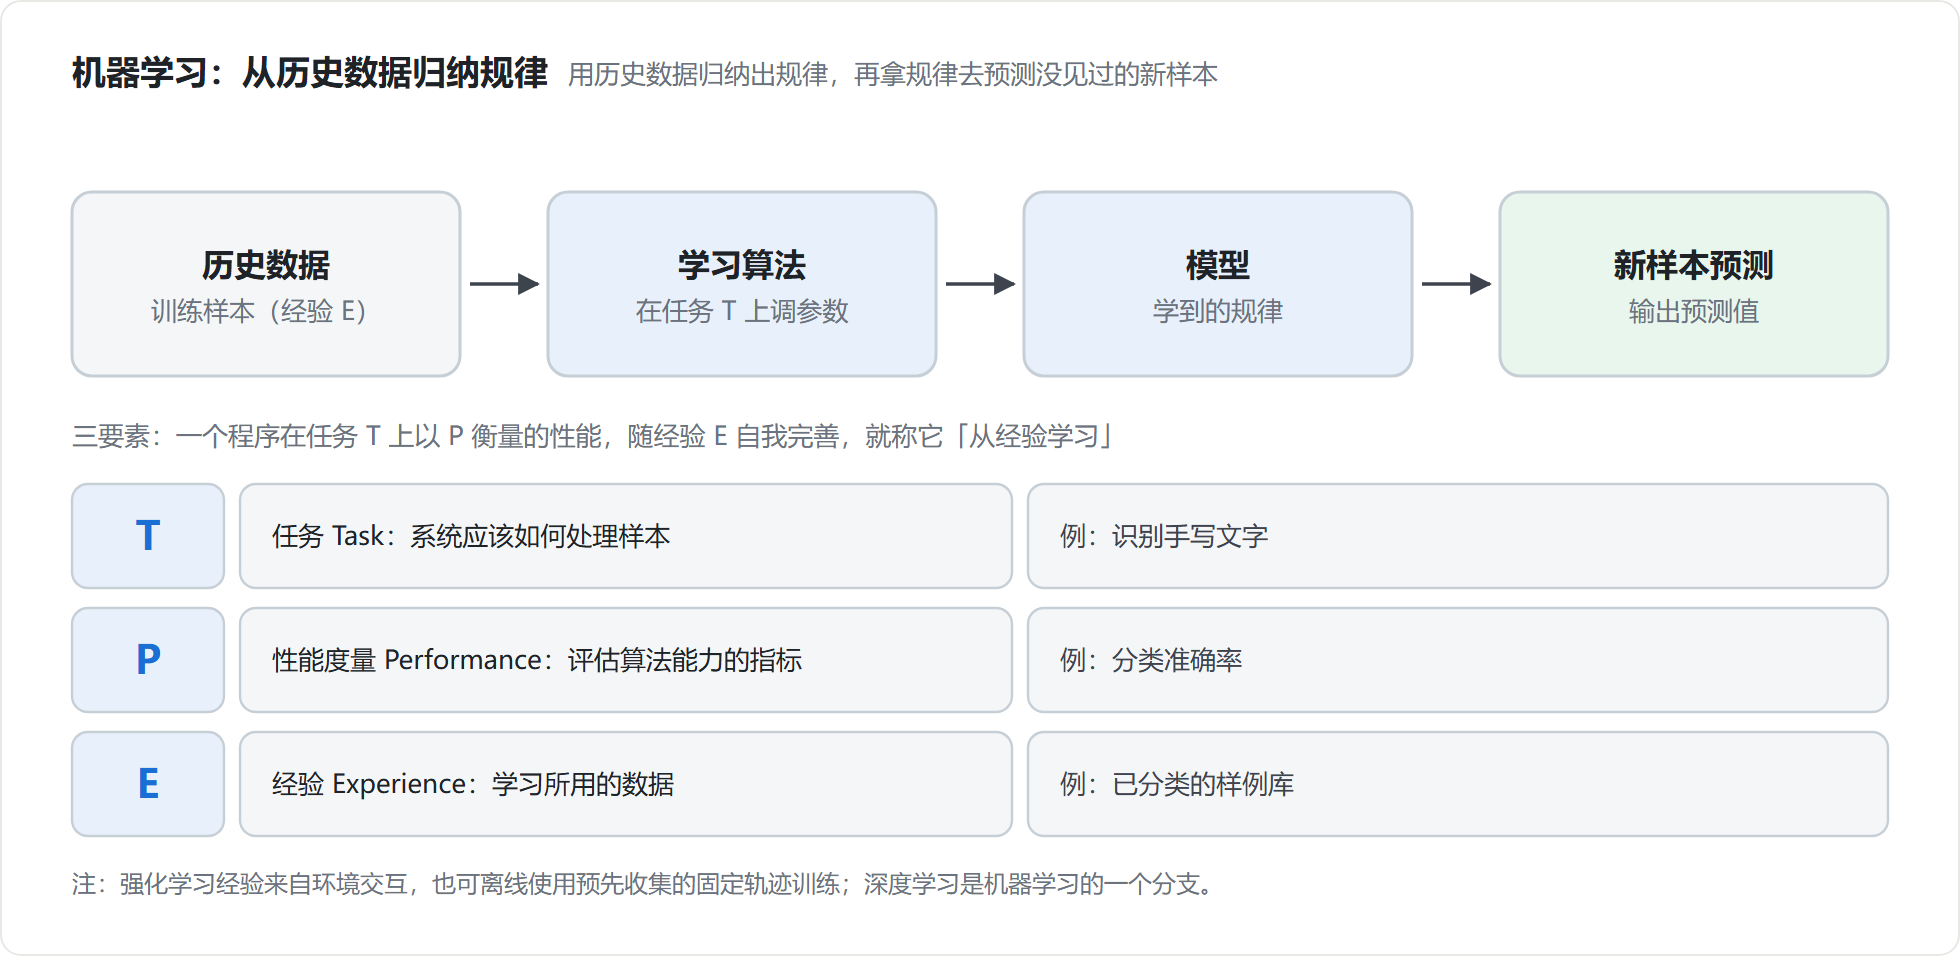
机器学习(含深度学习分支)研究的是「学习算法」。所谓「学习」指的是:
有任务 TTT、有衡量标准 PPP:程序在 TTT 上、按 PPP 算出来的表现,会随着经验 EEE 的积累自己变好。
(这是 Tom Mitchell 1997 年给的定义,使用 T / P / E 这套记号。)
三个字母拆开看:
| T(任务) | 系统应该如何处理样本 | 识别手写文字 |
| P(性能度量) | 评估算法能力的指标 | 分类准确率 |
| E(经验) | 训练数据;强化学习的经验来自与环境交互 | 已分类的样例库 |
要强调的是:深度学习是机器学习的一个分支,理解深度学习必须先理解机器学习的基本原理。
与传统「基于规则」编程的区别
| 规则来源 | 人工用显式代码写死 | 从样本中训练得到 |
| 适用场景 | 规则可以被人明确描述 | 规则复杂或难以描述 |
| 数据变化 | 改代码 | 通过重新训练或在线更新适应 |
什么时候该用机器学习
- 问题的解决方案很复杂,或数据量大且没有明确的分布函数;
- 规则会随时间改变(词性标注——随时产生新词、新词义);
- 数据分布本身会随时间变化(商品销售趋势预测),程序需要不停重新适应。
规模上有个直觉:小问题用人工规则更划算,问题一大,机器学习才显出优势。
理性认识:目标函数未知
真正的目标函数 fff 是未知的,学习算法永远得不到完美的 fff;它只能训练出一个假设函数 ggg 去逼近 fff,而 ggg 可能与 fff 不同。所有模型评估,本质上就是在衡量 ggg 与 fff 差多远。
能解决的三类问题
| 分类 | 离散类别(把输入归到 k 类之一) | 图像分类 |
| 回归 | 连续数值 | 预测索赔金额、证券价格 |
| 聚类 | 无标注数据按内在相似性分组 | 图片检索、用户画像 |
分类与回归是监督学习里的两大预测类型;聚类属于无监督。
2.2 机器学习的分类
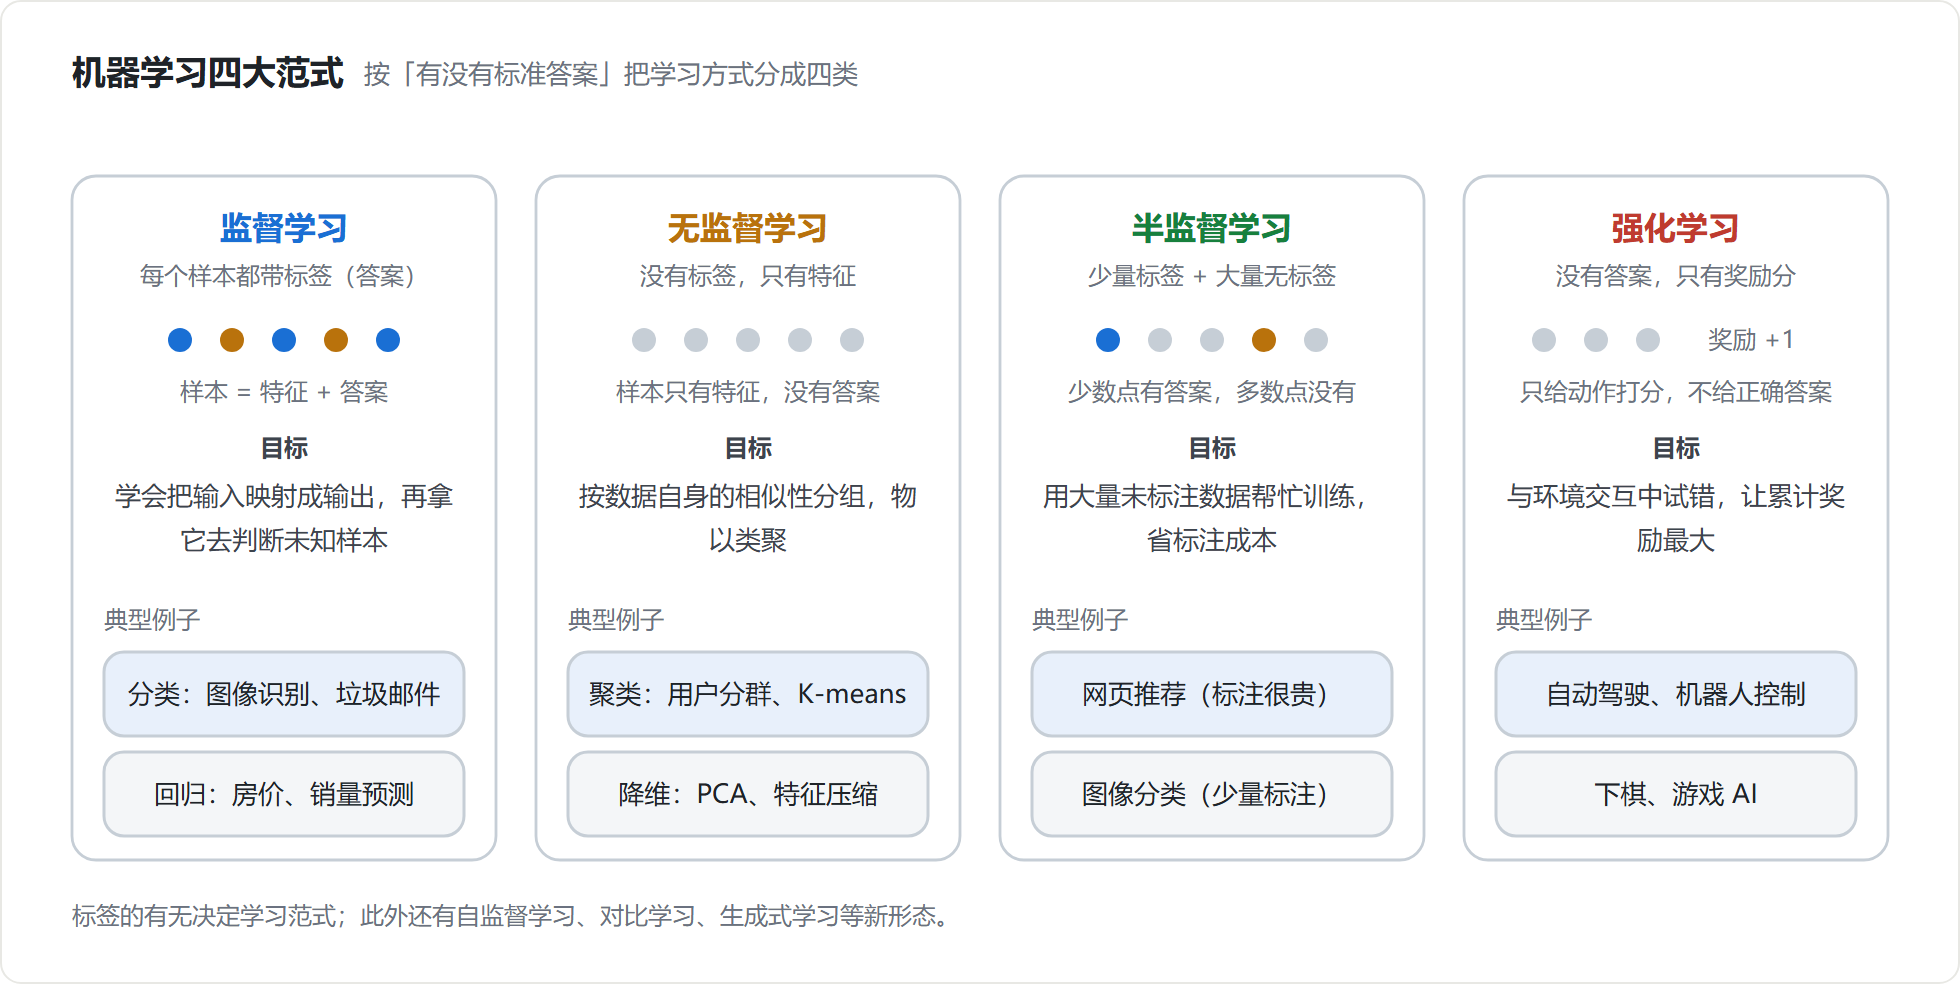
| 监督学习 | 有标签 | 给一堆选择题连标准答案一起给,让它学会做题 | 分类、回归 |
| 无监督学习 | 无标签 | 只给题不给答案,自己把相似的题归堆 | 聚类 |
| 半监督学习 | 少量有标签 + 大量无标签 | 用大量未标注数据辅助少量标注数据训练 | 网页推荐 |
| 强化学习 | 无标准答案,有奖励 | 做题后老师只批「对/错、加/减分」,不给正确答案 | 自动驾驶、机器人 |
几个要点:
- 监督学习:利用已标类别的样本训练出最优模型,再把输入映射为输出,从而对未知数据分类。
- 无监督学习:「物以类聚,人以群分」——把相似度高的放一起,新样本算相似度后归类。

- 半监督学习:现实中未标注数据海量、标注成本高(比如让用户标注感兴趣的网页,很少有人愿意花时间),于是让学习器自动利用未标注数据帮忙。
- 强化学习:学习的是「环境 → 行为」的映射,目标是让奖励信号最大。它和监督学习的关键差别在教师信号:环境只评价动作好坏(通常是一个标量),不告诉系统正确动作是什么。在线强化学习边交互边学习,离线强化学习也可用预先收集的固定轨迹训练。
随着算法发展,又出现了自监督学习、对比学习、生成式学习等新范式。
监督学习内部:回归 vs 分类
| 输出 | 连续值 | 离散类别 |
| 例子 | 下周股票收益、周二温度 | 饮料瓶属于哪类垃圾、邮件是否垃圾邮件 |
强化学习的典型判断
- 自动驾驶:黄灯开始闪,刹车还是加速通过?
- 扫地机器人:电量剩 10%,还剩一小块没扫,继续扫还是回去充电?
这类「在状态 sss 下选动作 aaa、拿奖惩 rrr、进入下一状态 s′s's′」的循环,就是强化学习的基本框架。
2.3 机器学习的整体流程
主流程
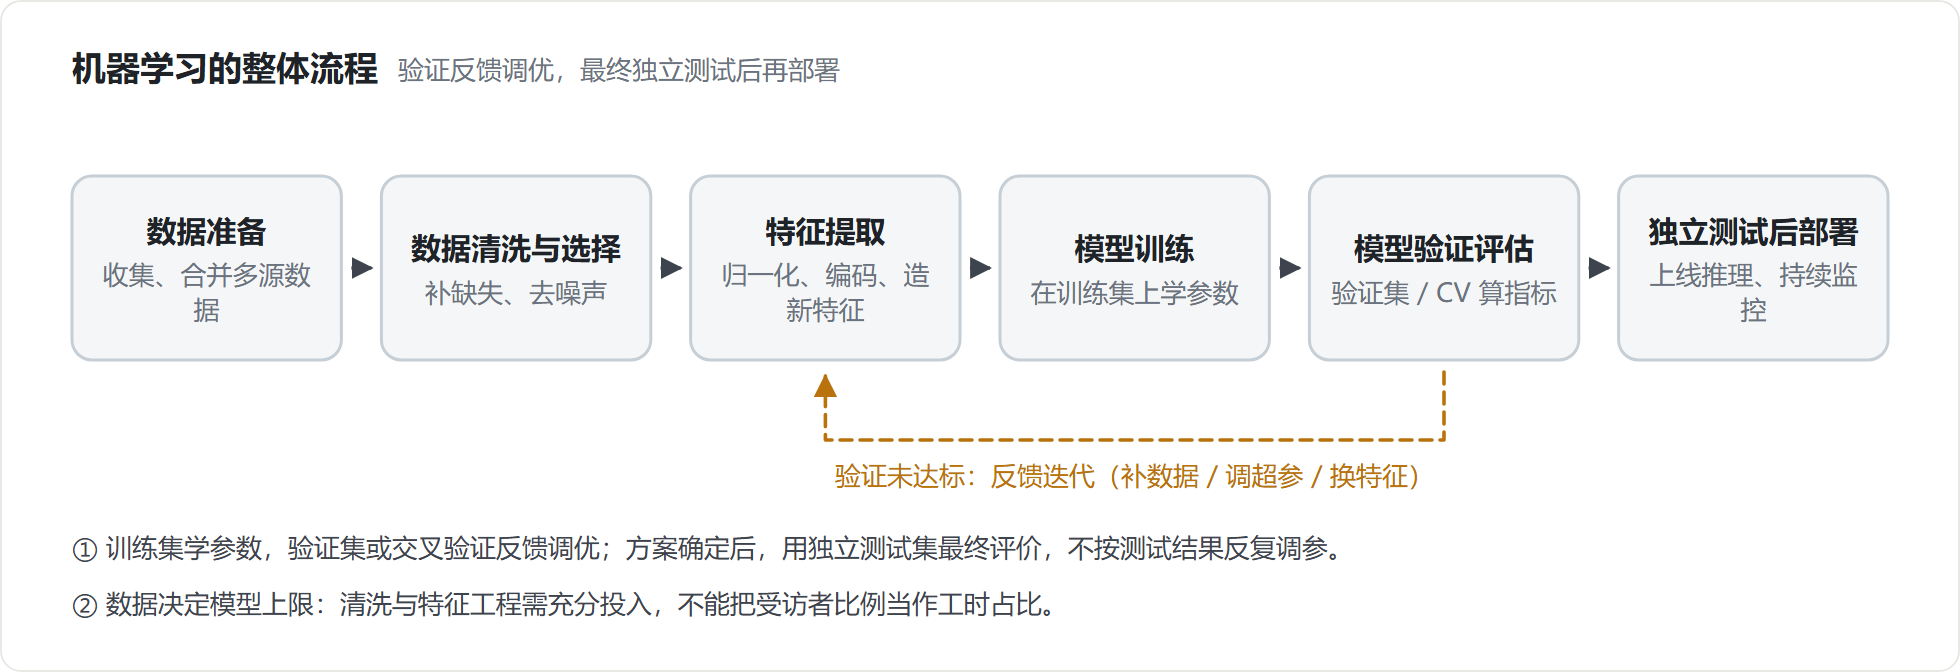
数据准备 → 数据清洗与选择 → 特征提取 → 模型训练
→ 验证评估与反馈迭代 → 最终独立测试 → 模型部署与整合
基本概念
- 数据集:任务中用的一组数据,每条叫一个样本;
- 特征:反映样本某方面表现或性质的属性;
- 训练集:训练用的数据,样本叫训练样本,学得模型的过程叫学习/训练;
- 测试集:模型训练好后用来预测的数据,样本叫测试样本。
数据处理:模型能力的天花板
没有好的数据,就没有好的模型。 数据处理三件事:
| 数据清理 | 填充缺失值,发现并消除噪声与异常 |
| 数据标准化 | 调节特征尺度,减弱量纲差异的影响 |
| 数据降维 | 简化属性,避免维度爆炸 |
CrowdFlower 2016 年调查中,60% 的受访者把清理和组织数据列为最耗时工作,4% 选择改进算法;这不是工时占比。
「脏」数据的三种毛病:
- 不完整:缺少属性或含缺失值;
- 多噪音:含错误记录或异常值;
- 不一致:存在矛盾、有差异的记录(同一含义在不同表里写法不同)。
预处理通常包括:数据过滤、处理缺失、处理错误/异常值、合并多个数据源、数据汇总。
数据转换
- 分类问题里把类别数据编码成数值;
- 数值数据转类别(如年龄分段),减少变量取值;
- 文本用词嵌入(word2vec、BERT)转成词向量;
- 图像做颜色空间变换、灰度化、几何变换、Haar 特征、图像增强;
- 特征工程:归一化/标准化(调节特征尺度;z-score 不保证值域一致)、特征扩充(对现有变量组合或变换生成新特征)。
特征选择
必要性:数据集中很多特征冗余或与预测无关。选好特征能简化模型、缩短训练、提升可解释性、避免维度爆炸与过拟合。
| Filter 过滤法 | 用统计量给每个特征打分排序,独立于模型 | 快 | 不考虑特征间关系,易选到冗余变量 | 皮尔逊相关系数、卡方系数、互信息 |
| Wrapper 包装法 | 把特征选择当搜索问题,用模型评分选子集 | 针对模型效果好 | 每个子集都要训一次模型,计算量大 | 特征递归消除(RFE) |
| Embedded 嵌入法 | 特征选择是模型构建的一部分 | 一次训练同时完成 | 依赖具体模型 | LASSO、正则化 |
模型构建
什么是好模型
| 泛化能力 | 对新样本也能预测准(与鲁棒性不同;鲁棒性指输入带噪声、扰动时依然稳) | 最重要 |
| 可解释性 | 预测结果是否容易被解释 | 视场景 |
| 预测速率 | 每条数据预测要多久 | 视场景 |
误差:训练误差(训练集上的)与泛化误差(新样本上的)。要的是泛化误差小。
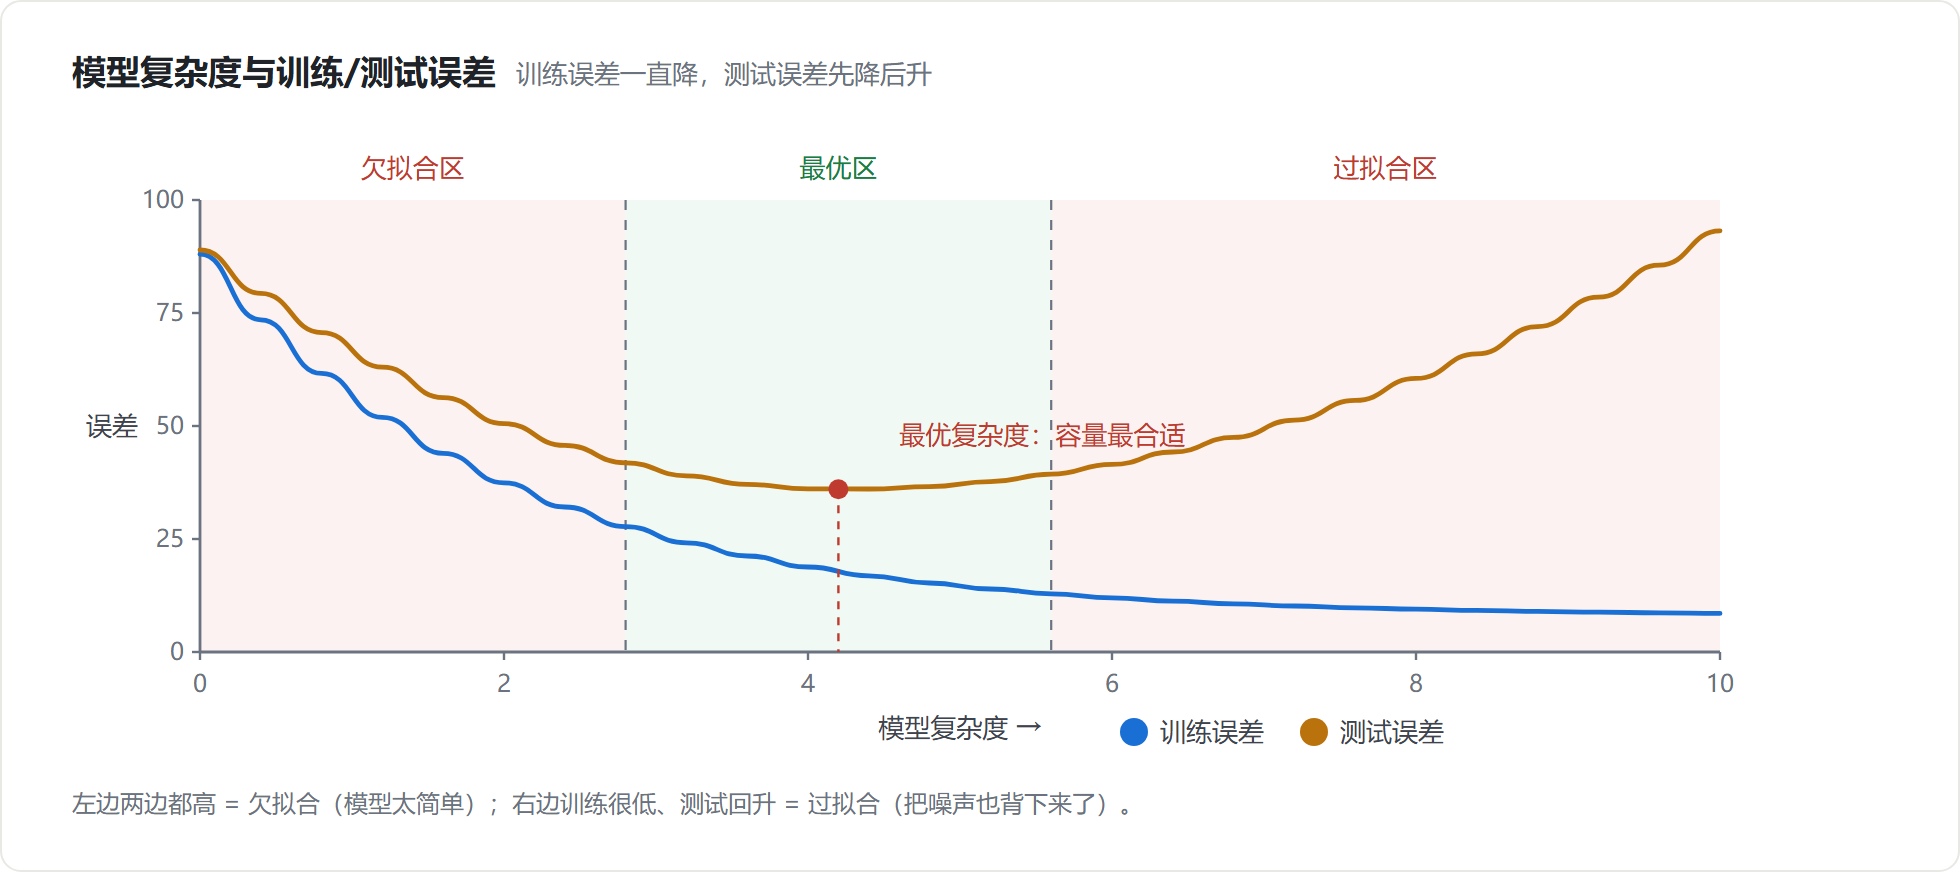
- 欠拟合:训练误差就很大——模型太简单或训练不足;
- 过拟合:训练误差很小,但泛化误差大——模型太复杂,把噪声也学了。
给定问题假定形式后,所有可能的函数构成假设空间,机器学习就是在假设空间里搜一个合适的拟合函数。
模型容量(复杂度):容量与任务复杂度、数据量匹配时效果最好;容量不足 → 欠拟合;容量过高 → 过拟合。有效容量受算法、参数、正则化限制。
偏差与方差
对回归的期望平方误差,在加性零均值噪声等常见假设下可拆成三部分:
总误差=偏差2+方差+不可消解的误差\\text{总误差} = \\text{偏差}^2 + \\text{方差} + \\text{不可消解的误差}总误差=偏差2+方差+不可消解的误差
- 偏差(Bias):模型预测的平均值与真实值的差异——「瞄得准不准」;
- 方差(Variance):固定输入、改变训练集时,预测结果在均值附近的波动幅度——「手抖不抖」。
四种组合:低偏低方差=好模型;低偏高方差=过拟合倾向;高偏低方差=欠拟合倾向;高偏高方差=不良模型。

模型复杂度与误差:训练误差随复杂度上升而单调下降;测试误差先降后升,形成 U 形曲线——那个最低点就是容量最合适的地方。
性能评估
回归:
- MAE(平均绝对误差):越接近 0 越拟合;
- MSE(均方误差);
- R²:通常在 0~1 之间,越大越好(模型比「直接取均值」还差时会为负),R2=1−RSSTSSR^2 = 1 – \\frac{RSS}{TSS}R2=1−TSSRSS(RSS 是预测值与样本值的差异,TSS 是样本之间的差异)。
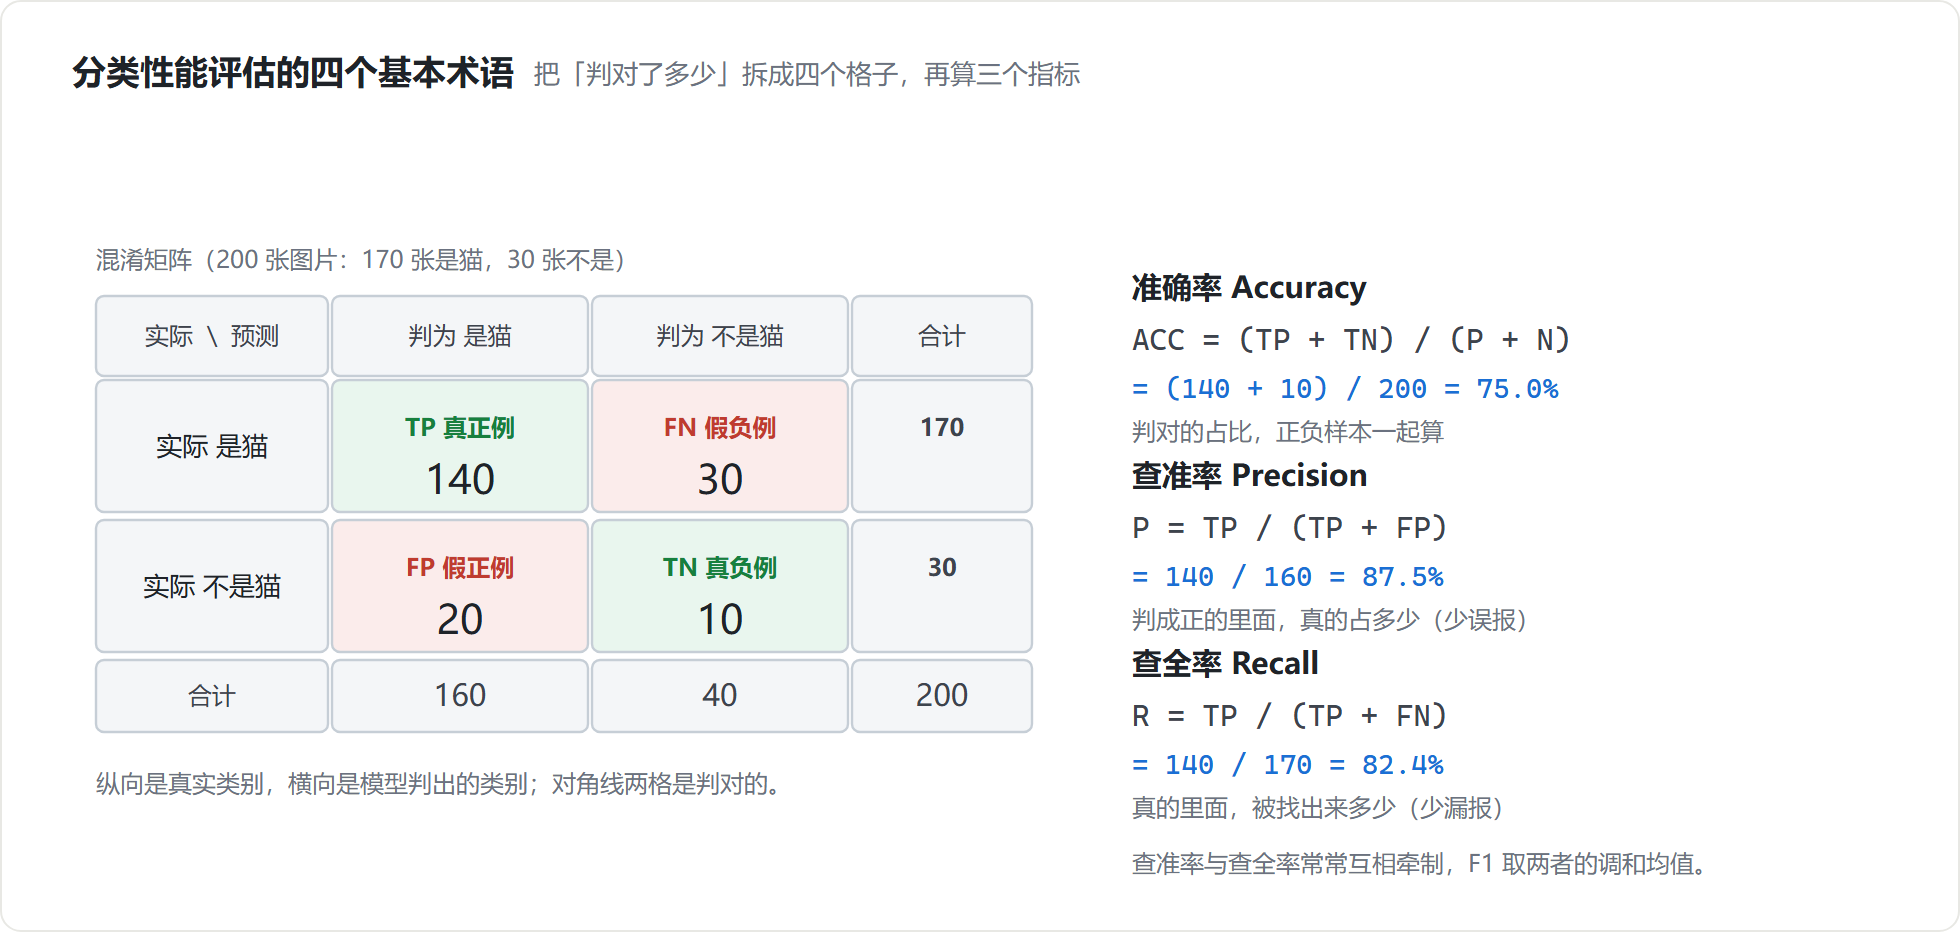
分类:先有混淆矩阵。
| TP | 正元组被正确分类 |
| TN | 负元组被正确分类 |
| FP | 负元组被错误标成正(误报) |
| FN | 正元组被错误标成负(漏报) |
指标:
准确率=TP+TNP+N查准率=TPTP+FP查全率=TPTP+FN\\text{准确率} = \\frac{TP+TN}{P+N} \\qquad \\text{查准率} = \\frac{TP}{TP+FP} \\qquad \\text{查全率} = \\frac{TP}{TP+FN}准确率=P+NTP+TN查准率=TP+FPTP查全率=TP+FNTP
F1=2×precision×recallprecision+recallF1 = \\frac{2 \\times precision \\times recall}{precision + recall}F1=precision+recall2×precision×recall
一个猫的例子:200 张图,170 张是猫、30 张不是;模型判为猫的 160 张、判为非猫的 40 张。混淆矩阵 TP=140TP=140TP=140、FN=30FN=30FN=30、FP=20FP=20FP=20、TN=10TN=10TN=10,于是查准率 140/160=87.5140/160=87.5%140/160=87.5、查全率 140/170=82.4140/170=82.4%140/170=82.4、准确率 150/200=75150/200=75%150/200=75。
注意:不少资料在这里把两个数字写反(查全率记成 75%、准确率记成 82.4%),按上面的公式应为 82.4% 与 75%。
2.4 其他机器学习重要方法
梯度下降
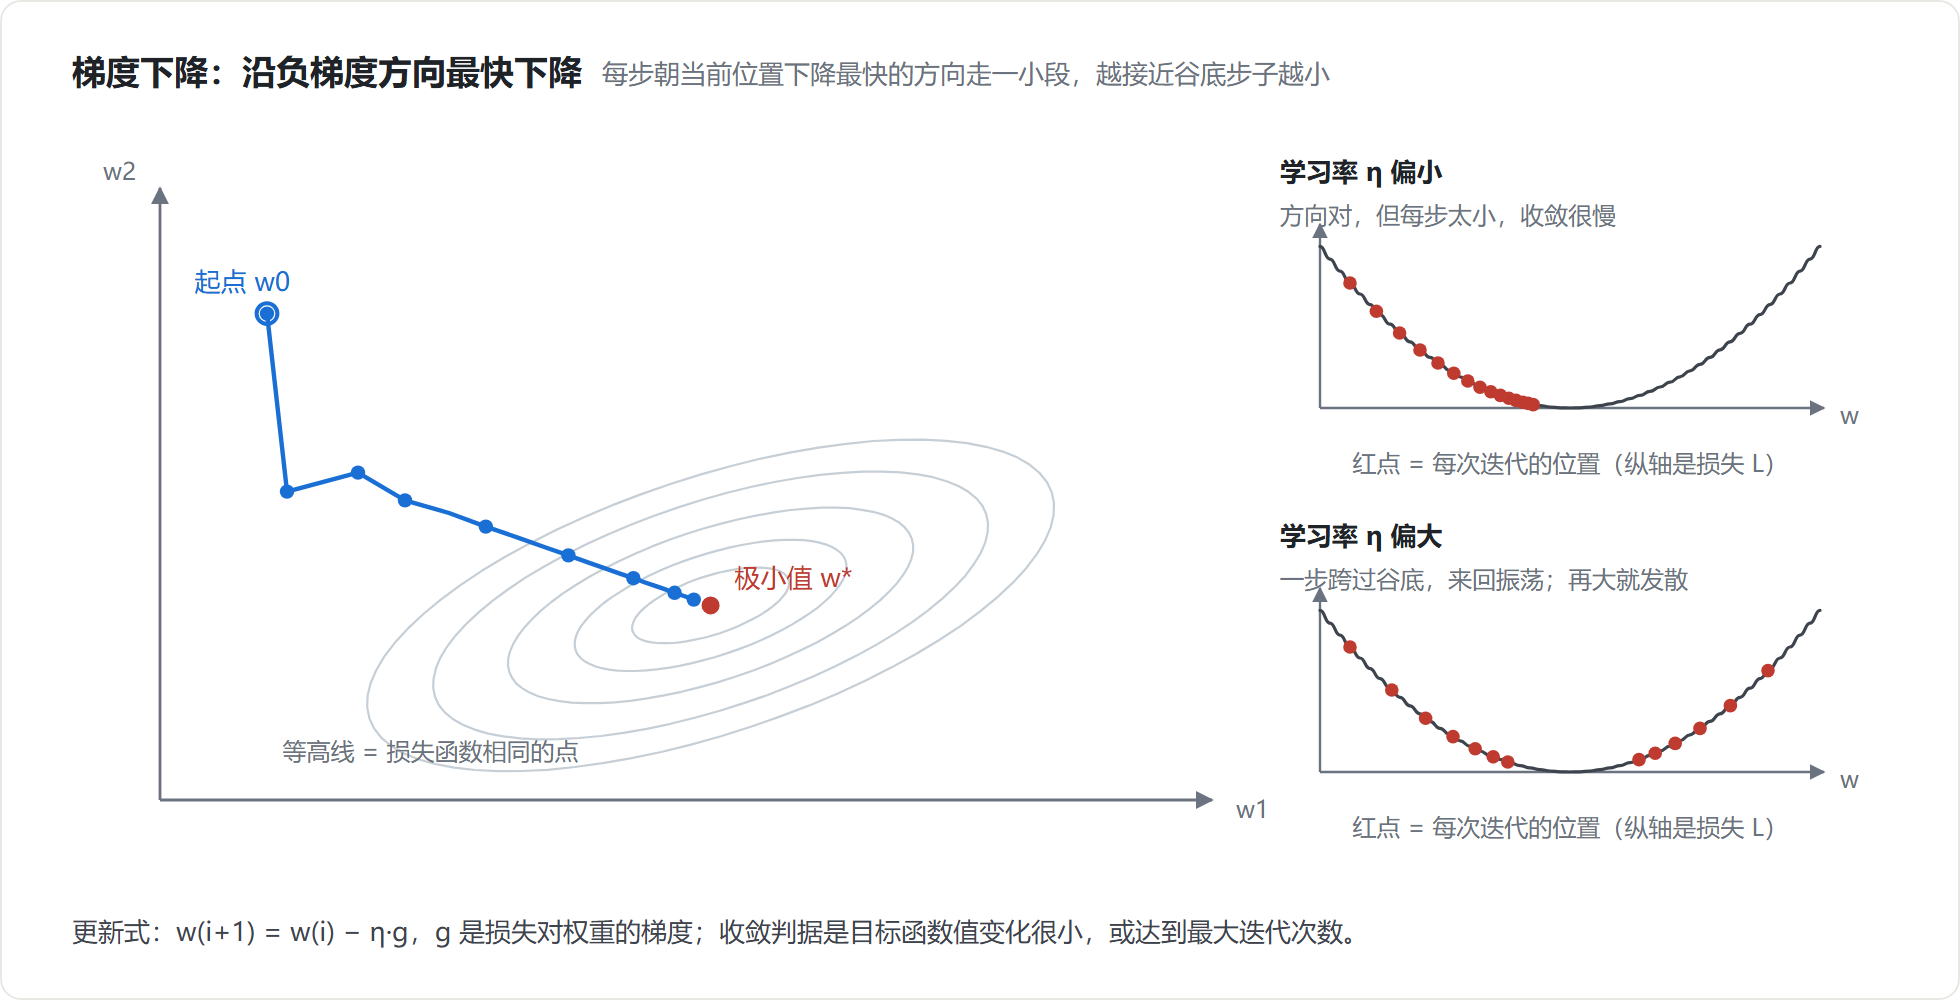
用当前位置的负梯度方向作为搜索方向(该方向下降最快):
wi+1=wi−η∇Lw_{i+1} = w_i – \\eta \\nabla Lwi+1=wi−η∇L
η\\etaη 是学习率,决定每次迭代权重变化的大小。收敛判据:目标函数值变化非常小,或达到最大迭代次数。
注意:接近极小值时下降幅度越来越小;但在最优点附近的一定范围内,可能存在梯度不稳定的情况。
参数 vs 超参数
| 谁定 | 模型从数据中「蒸馏」出来,自动学习 | 人工手动设定 |
| 作用 | 定义模型功能 | 控制训练过程 |
| 例子 | 神经网络权重、SVM 支持向量、线性/逻辑回归系数 | Lasso/Ridge 的 λ、学习率、迭代次数、批大小、激活函数、神经元数量、SVM 的 C 与 γ、KNN 的 K、随机森林的树棵数 |
| 保存 | 作为学习模型的一部分保存 | 模型外部的配置 |
超参数搜索
标准流程四步:
| 网格搜索 | 穷举所有超参数组合 | 超参数少时可行;神经网络这类维度高的场景行不通(昂贵耗时) |
| 随机搜索 | 从分布中随机取样 | 搜索空间大时优于网格;先粗搜再缩小范围 |
| 贝叶斯搜索 | 启发式智能搜索 | 更省评估次数 |
交叉验证
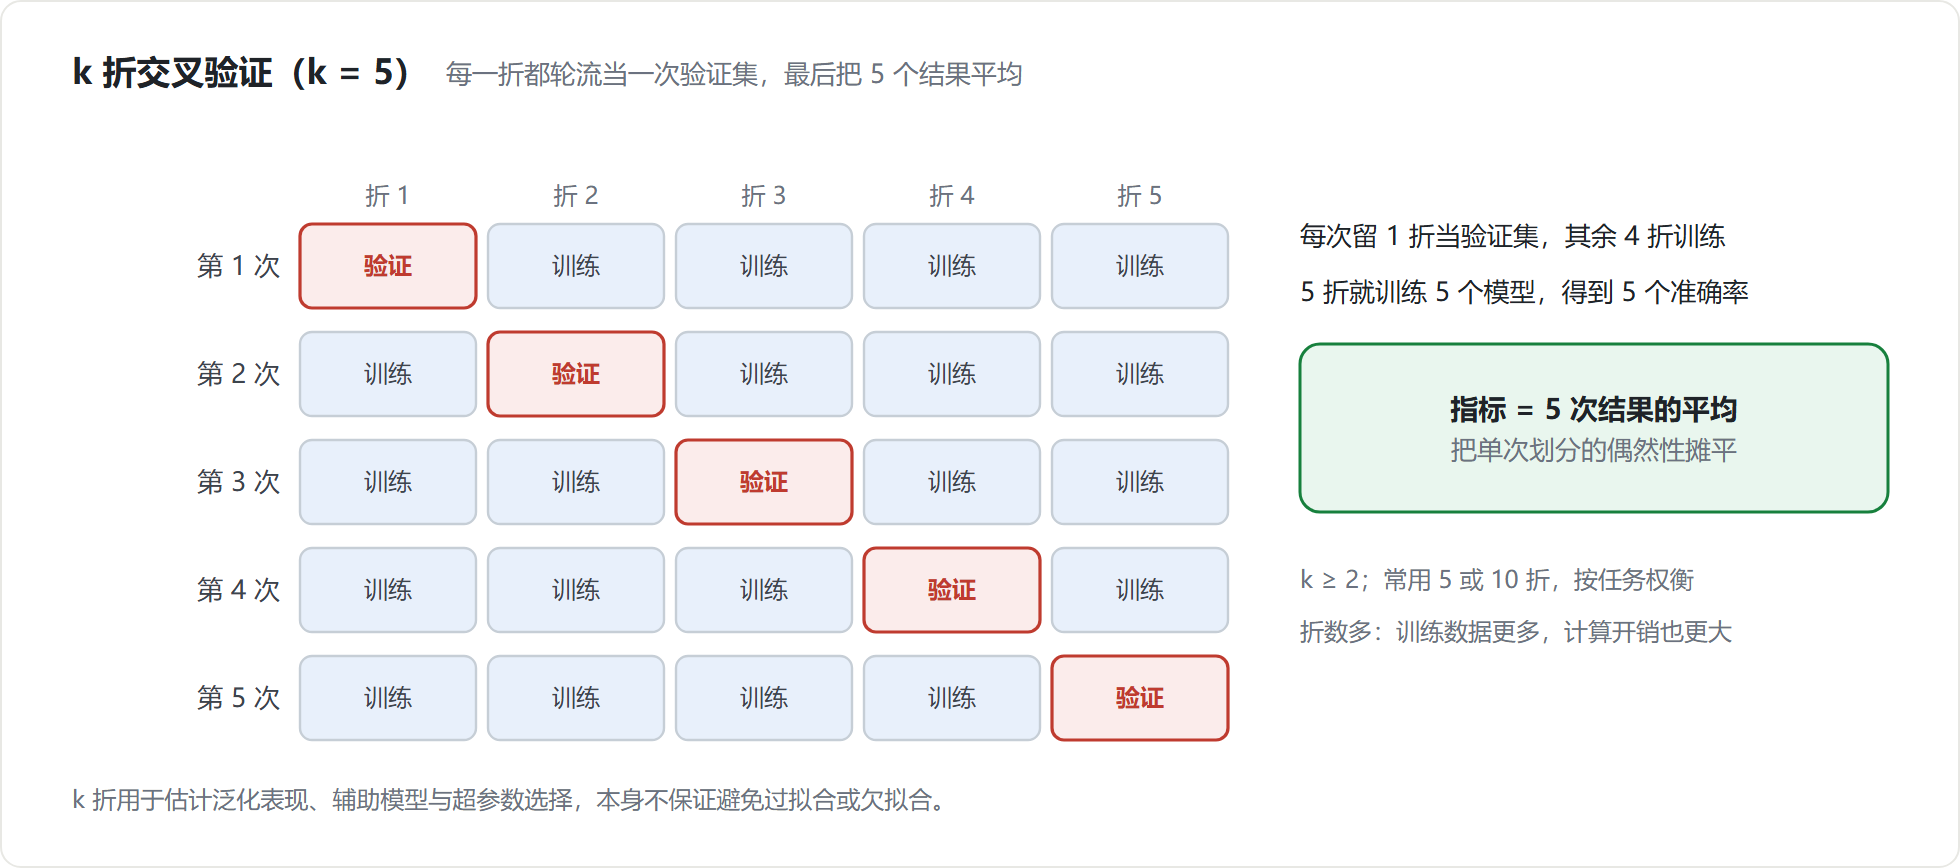
思想:把原始数据分组,一部分训练、一部分验证,轮流来,用平均表现评价分类器。
k 折交叉验证:
细节:
- 固定训练集/测试集的问题:测试集太小时,误差估计的统计不确定性大,很难判断算法好坏;数据量大(十万级)时不严重。
- k≥2k \\geq 2k≥2,常用 5 或 10 折;折数需权衡样本量、估计波动与计算开销。
- k 折可更稳健地估计泛化表现,辅助模型与超参数选择;本身不保证避免过拟合或欠拟合。
- K 本身也是超参数。
2.5 机器学习的常见算法
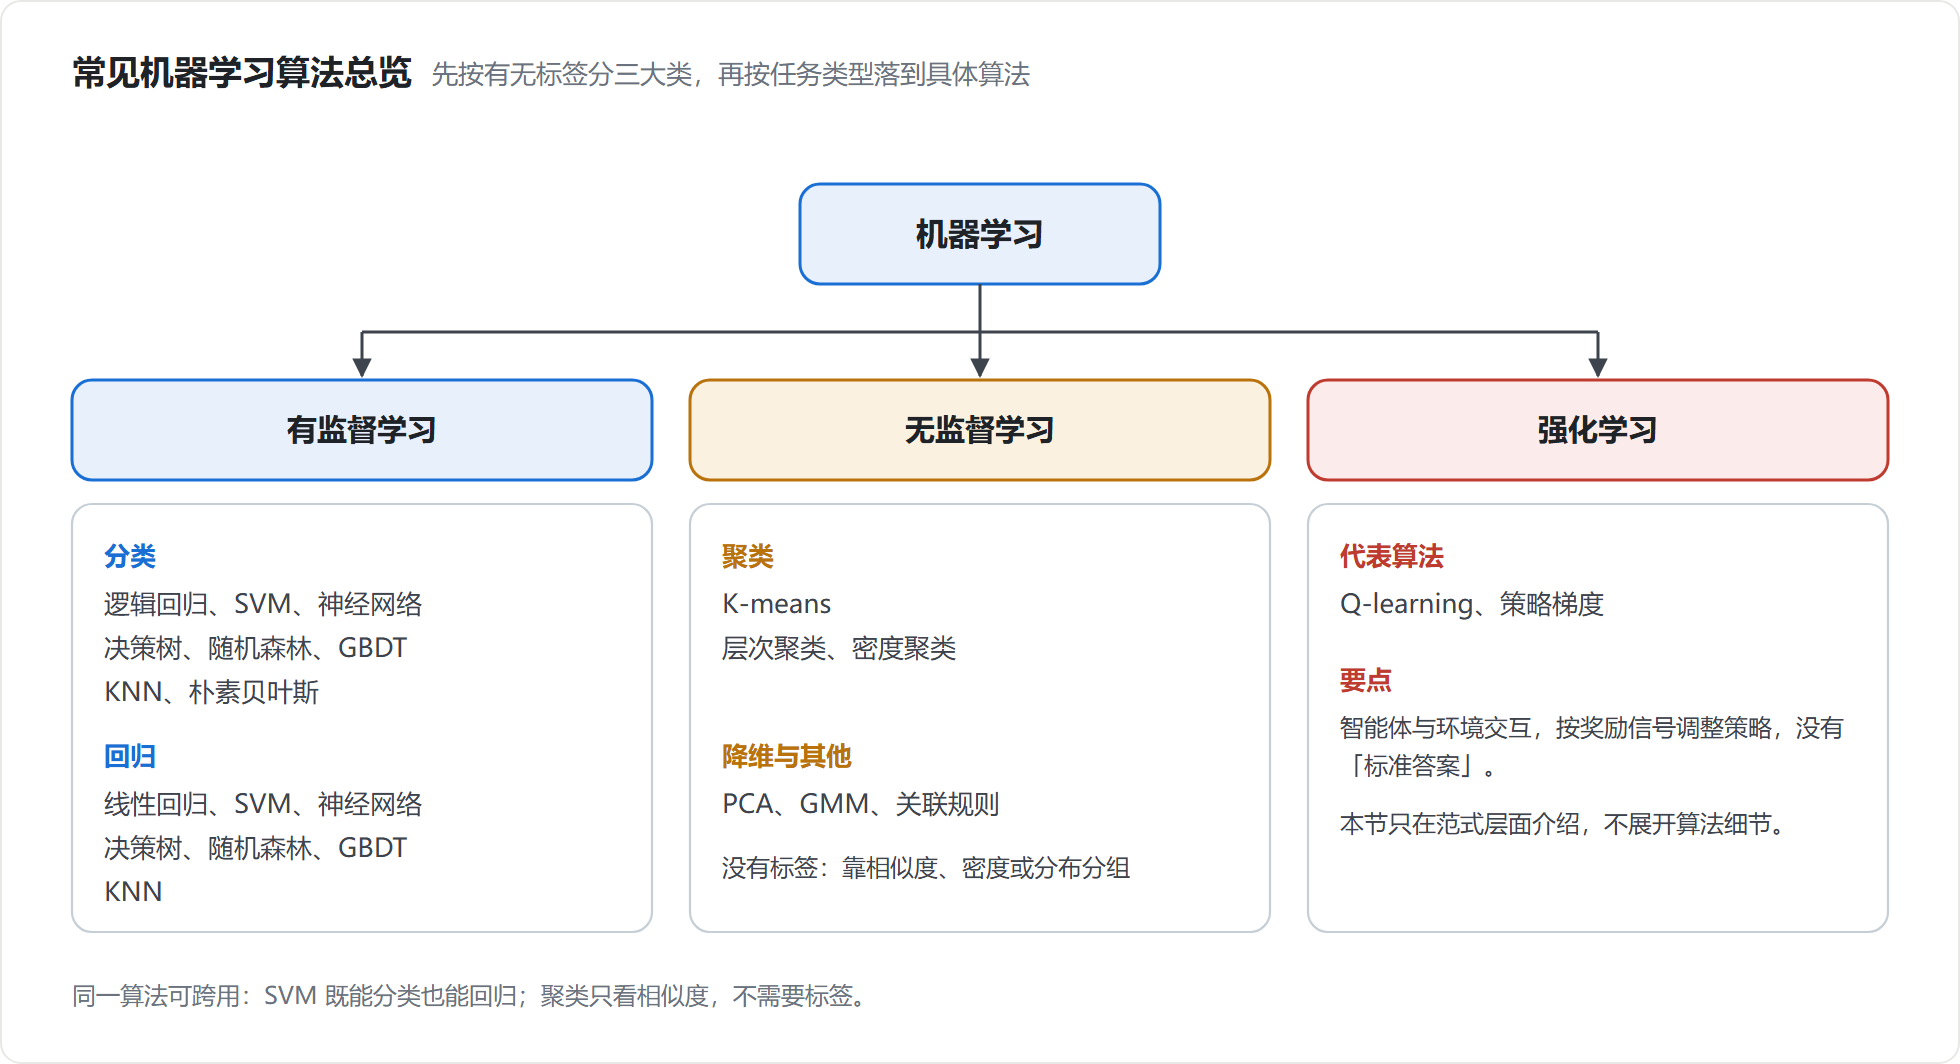
算法总览
| 有监督 | 分类 | 逻辑回归、SVM、神经网络、决策树、随机森林、GBDT、KNN、朴素贝叶斯 |
| 回归 | 线性回归、SVM、神经网络、决策树、随机森林、GBDT、KNN | |
| 无监督 | 聚类 | K-means、层次聚类、密度聚类 |
| 其他 | 关联规则、PCA、GMM |
线性回归
用回归分析确定两种或以上变量间相互依赖的定量关系,属于有监督学习。
h(x)=wx+bh(x) = wx + bh(x)=wx+b
- 一个自变量 + 一个因变量且可用直线近似 → 一元线性回归;
- 两个及以上自变量 → 多元线性回归。
学出来的不一定是一条直线:只有变量是一维时才是直线,高维时是超平面。比如房价由面积、户型、区域共同决定。
误差假设:真实值 y=wx+b+ϵy = wx + b + \\epsilony=wx+b+ϵ,误差受众多独立因素影响,假设服从正态分布;由正态分布函数 + 最大似然估计可推出损失函数(均方误差),再用梯度下降求使损失最小的 www。
多项式回归:数据复杂度超过直线能拟合的范围时(欠拟合),用多项式。它仍属线性回归——非线性体现在特征维度上,而权重 www 之间仍是线性关系。
防过拟合:
- 加 L2L2L2 正则项(权重平方和)→ Ridge 回归;
- 加 L1L1L1 正则项(绝对值)→ LASSO 回归。
逻辑回归
名字叫回归,实际是分类模型(解决二分类):
P(Y=0)=11+ewx+b,P(Y=1)=ewx+b1+ewx+bP(Y=0) = \\frac{1}{1+e^{wx+b}}, \\qquad P(Y=1) = \\frac{e^{wx+b}}{1+e^{wx+b}}P(Y=0)=1+ewx+b1,P(Y=1)=1+ewx+bewx+b
比两个概率值大小,大的就是预测类别。
- 与线性回归同属广义线性模型;逻辑回归在线性回归基础上引入sigmoid 这个非线性因素并设阈值,因此能处理二分类;
- 损失函数由最大似然估计得出,同样用梯度下降求解;
- 加正则项也能防过拟合。
扩展到多分类:softmax。把 K 维任意实数向量压成 K 维、每元素在 (0,1) 之间且加起来等于 1 的概率分布。例:橙子 0.09、苹果 0.22、香蕉 0.68、其他 0.01 → 判为香蕉。
决策树
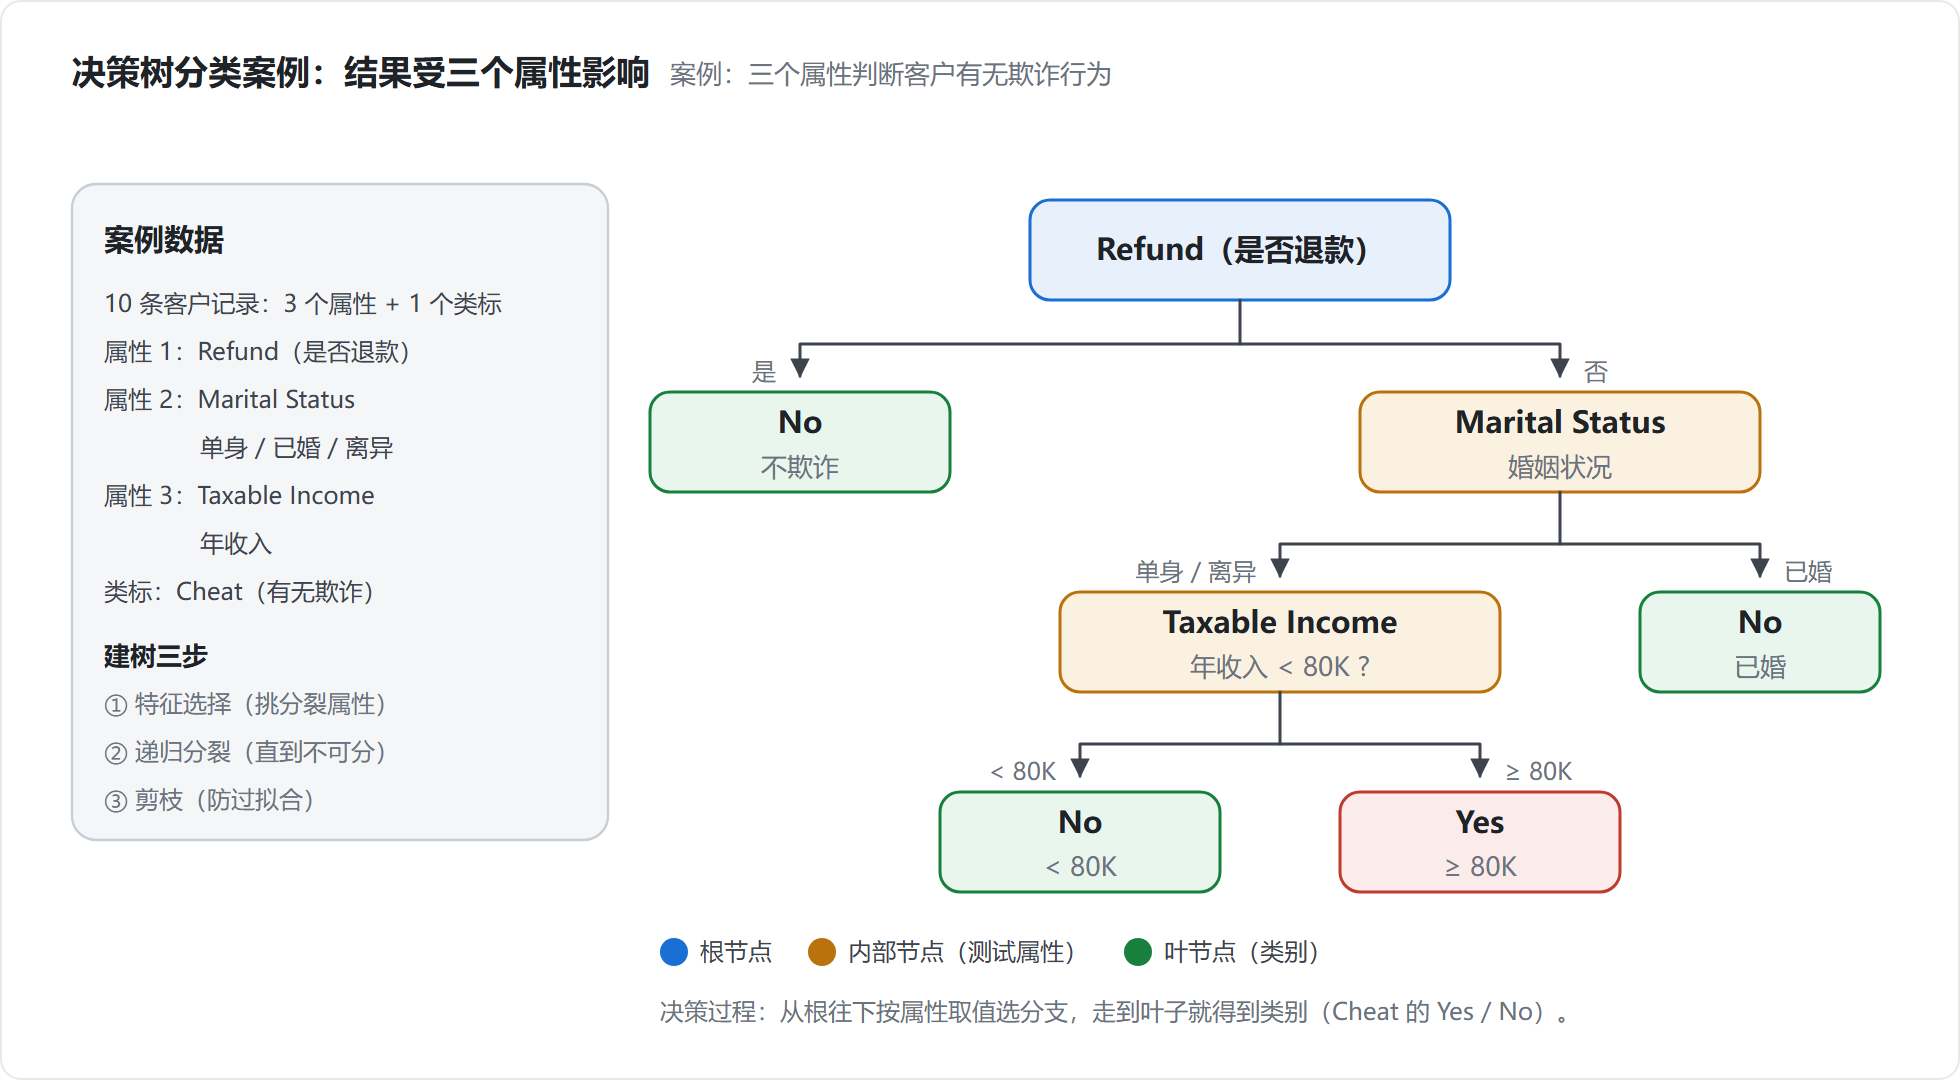
树结构:每个非叶节点是一次特征属性测试,每个分支是该属性在某值域上的输出,每个叶节点存放一个类别。决策过程从根节点开始,按特征值选分支,直到叶子。
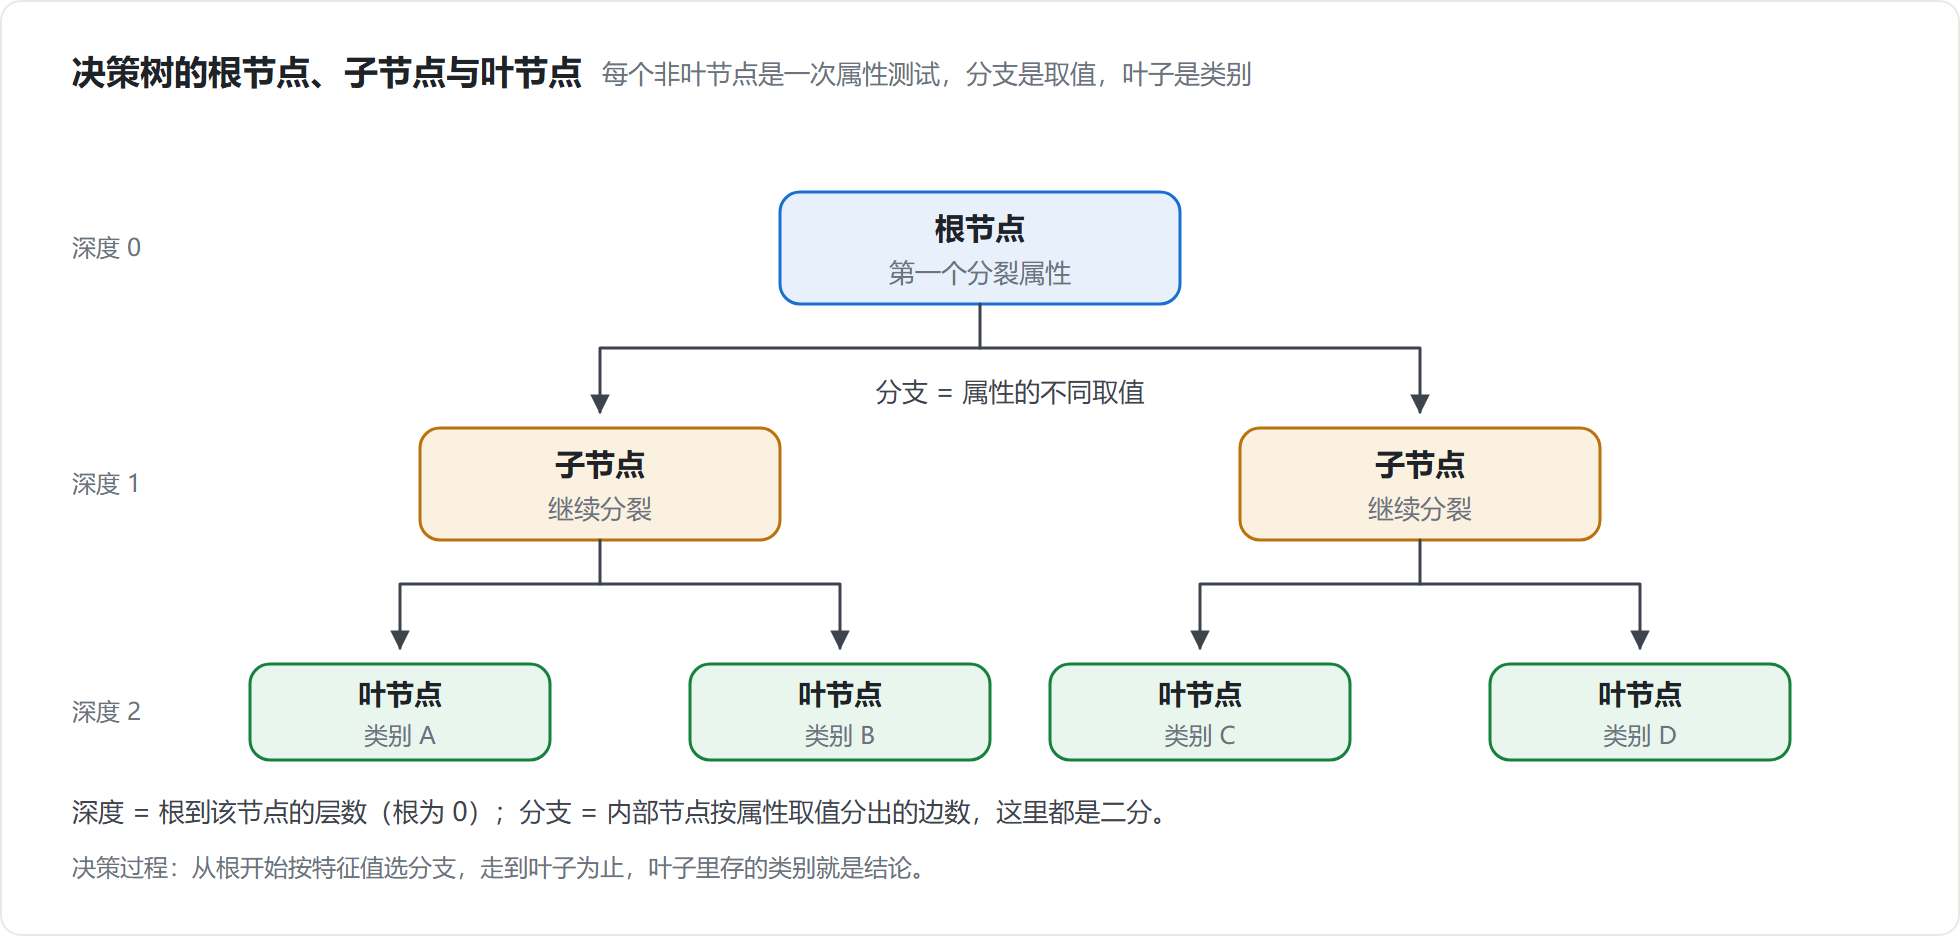
- 关键在构造:进行属性选择度量,确定特征之间的拓扑结构;核心步骤是分裂属性;
- 纯度指标:信息熵与 Gini 系数——分割前后纯度差异越大,树越好;
- 构造三步:特征选择(ID3 / C4.5 / CART 的差别就在选择标准)→ 决策树生成(递归分裂,直到不可分)→ 剪枝(预剪枝/后剪枝,防过拟合)。
支持向量机(SVM)
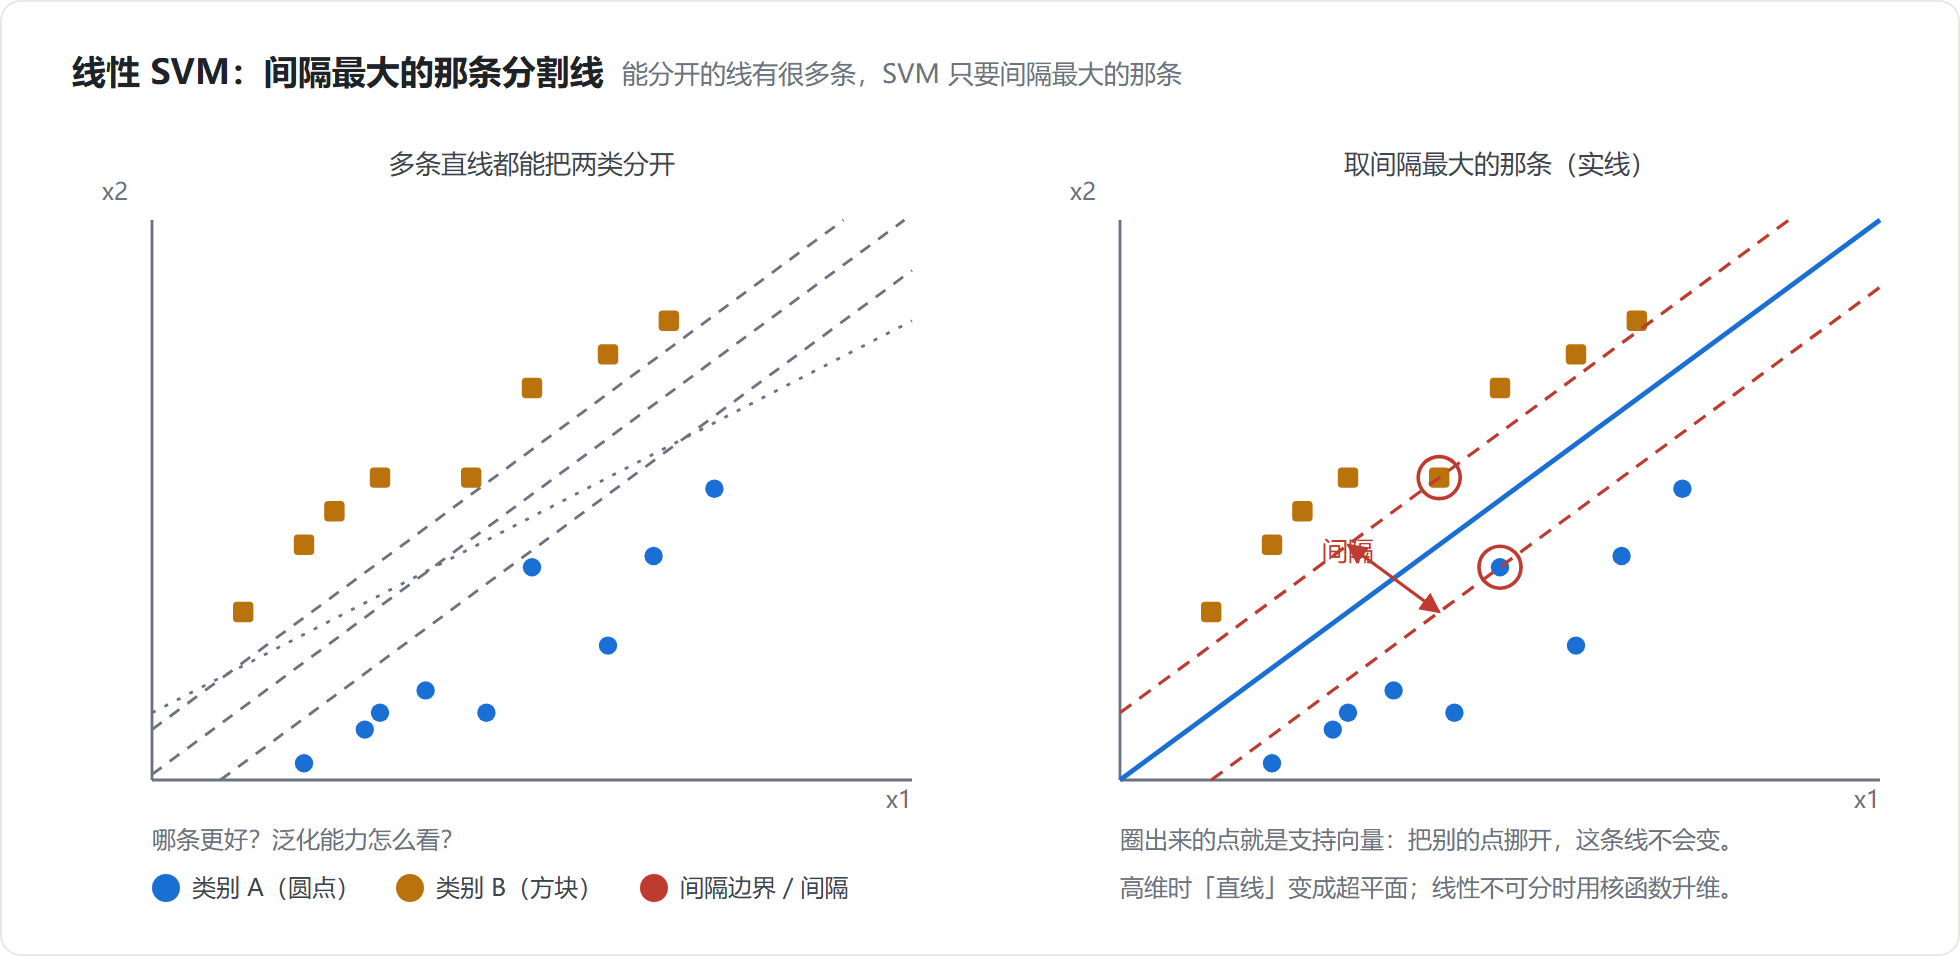
二分类模型,基本形态是特征空间上间隔最大的线性分类器;加上核技巧后实质上是非线性分类器。学习算法是求解凸二次规划。
核心思想两句话:
常见核函数:线性核、高斯核(用得最多)、多项式核、Sigmoid 核。
K 最邻近(KNN)
思路:一个样本在特征空间中最近的 k 个样本里,多数属于某类,它就属于该类。
- 「近朱者赤,近墨者黑」,逻辑极简;
- 非参数方法,适合决策边界不规则的数据;
- 分类用多数表决,回归用平均值;
- 计算量大(要算与所有样本的距离);
- K 值:越大越平滑、越容易欠拟合;越小越细腻、越容易过拟合。
朴素贝叶斯
基于贝叶斯定理,并假设特征之间相互独立(类条件独立性)。给定特征 x1,…,xnx_1,…,x_nx1,…,xn,样本属于类别 HHH 的概率:
P(H∣x1,…,xn)=P(H)⋅P(x1,…,xn∣H)P(x1,…,xn)P(H \\mid x_1,…,x_n) = \\frac{P(H)\\cdot P(x_1,…,x_n \\mid H)}{P(x_1,…,x_n)}P(H∣x1,…,xn)=P(x1,…,xn)P(H)⋅P(x1,…,xn∣H)
- 「朴素」就朴素在假定一个属性值在给定类上的影响与其他属性无关——这是为了简化计算;
- 例:红色、圆、直径约 10 cm 的水果判为苹果——分类器认为三个特征各自独立地贡献概率,不考虑它们之间的相关性;
- 在大型数据库上准确率高、速度快。
集成学习
多个学习器组合解决同一问题,泛化能力往往远强于单个学习器(「群众智慧」)。
| Bagging | 并行、独立地训练多个基学习器,再平均/投票 | 降低方差 | 随机森林 |
| Boosting | 串行构建,逐步减小综合学习器的偏差 | 降低偏差,但要防过拟合 | AdaBoost、GBDT、XGBoost |
- 典型随机森林 = Bagging + CART 决策树 + 节点随机候选特征:bootstrap 抽样出多个子集,各训一棵树,分裂时再随机选候选特征;分类用多数投票,回归用平均值。
- GBDT:综合预测由初始预测与各轮学习器的加权输出相加;每轮拟合损失对当前预测的负梯度。以平方损失、初始预测 0、学习率 1 为例:真实 30 岁,第一棵预测 20 岁(残差 10),第二棵拟合残差 10、预测 9(剩 1),第三棵拟合残差 1。
无监督:K-means 与层次聚类
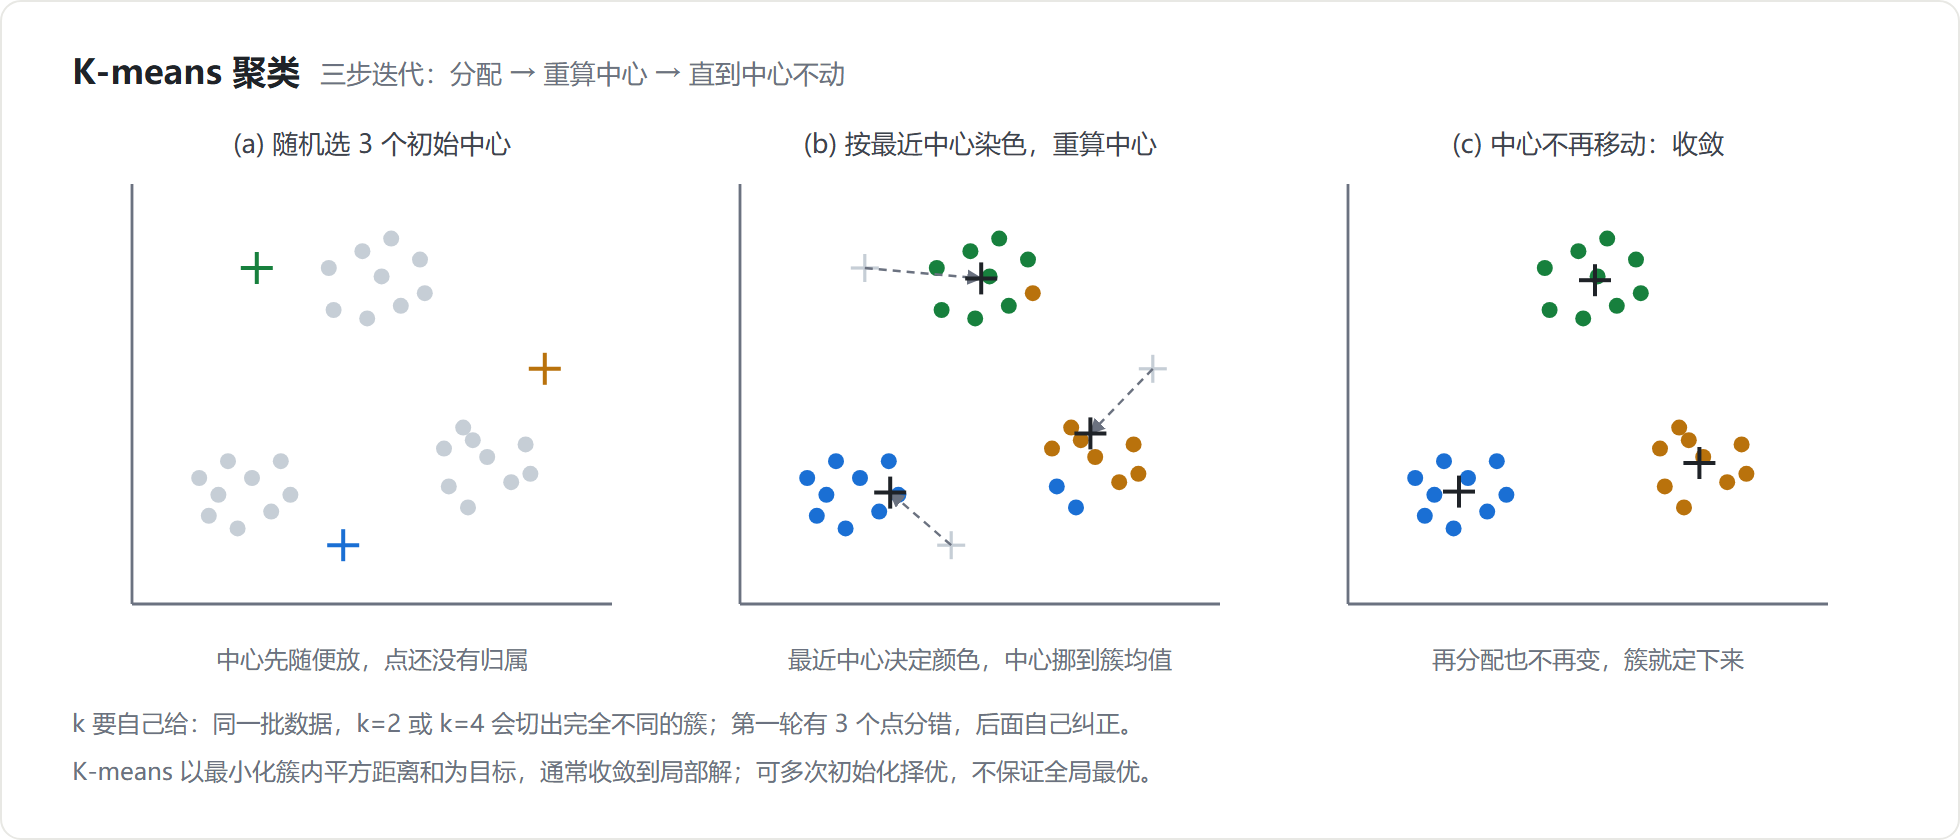
- K-means:输入聚类个数 kkk 和 nnn 个数据对象,以最小化簇内平方距离和为目标,迭代形成 kkk 个簇;通常得到局部解,不保证全局最优,可多次初始化择优。
- 层次聚类:在不同层次上划分数据,形成树形聚类结构;可自下而上聚合,也可自顶向下分拆。树根是包含全部样本的聚类,叶子是单样本聚类。