分类实战补充—-半监督学习
1.监督学习
让模型从带有标签的训练数据中学习输入到输出的映射关系。让模型在面对只有特征没有标签的数据时,可以判断出标签。
例:给定条件:{(x₁, y₁), (x₂, y₂), …, (xₙ, yₙ)},训练目标:学习X→Y的映射,使得 f(x) ≈ y
2.无监督学习
数据只有特征没有标签,它本质上是一个统计手段,在没有标签的数据里可以发现潜在的隐藏模式或数据结构的一种训练方式。
例:给定条件:{x₁, x₂, …, xₙ},训练目标:发现数据的固有结构、模式或分布
3.半监督学习
利用同时包含有标签和无标签的数据来构建一个模型,使得模型能够在测试阶段更好地泛化到新的、未见过的数据。半监督学习的训练数据中只有一小部分样本是带有标签的,而大部分样本是没有标签的。
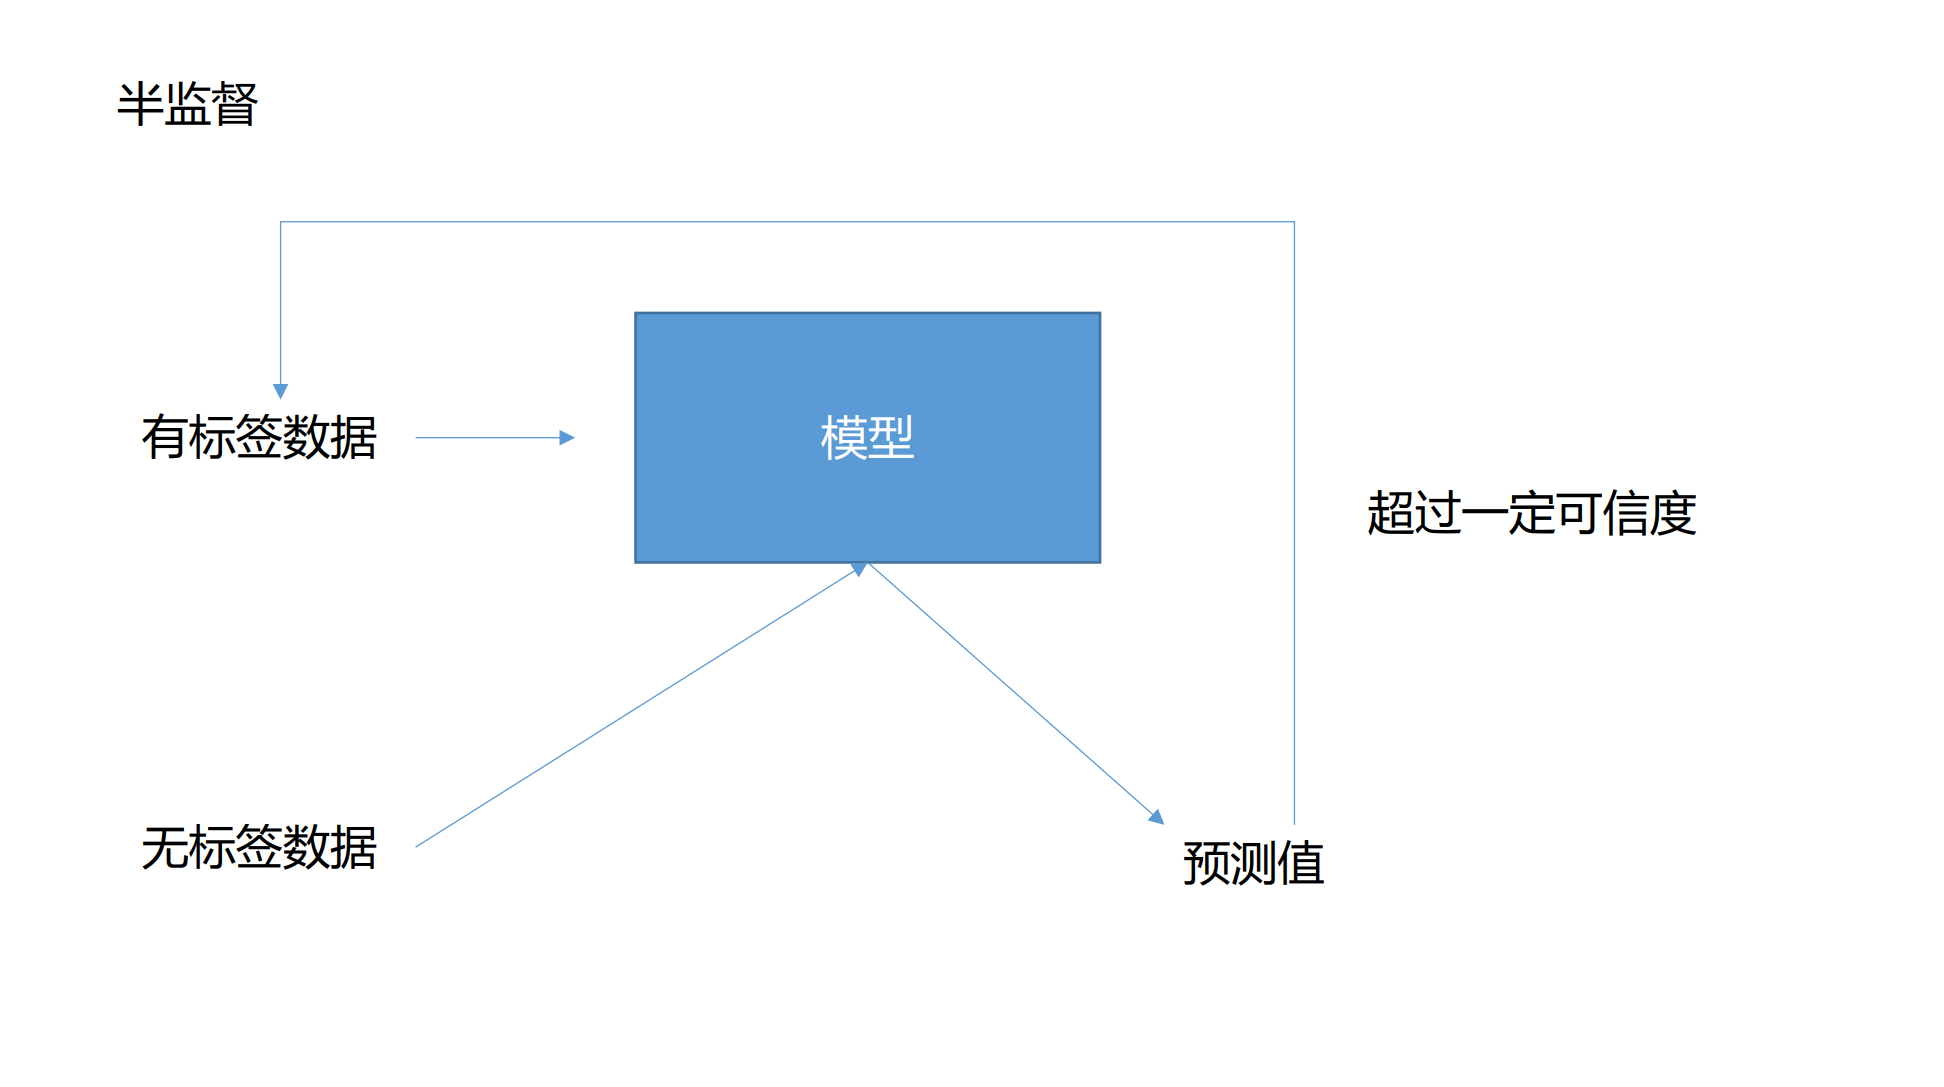
自训练:一种简单的半监督学习方法。先用有标签的数据训练一个初始模型,然后用这个模型去预测无标签的数据,选出那些预测置信度高的样本,把它们连同预测的标签一起加入到训练集中,然后重新训练模型。
import random
import torch
import torch.nn as nn
import numpy as np
import os
from PIL import Image
from torch.utils.data import Dataset, DataLoader
from tqdm import tqdm
from torchvision import transforms
import time
import matplotlib.pyplot as plt
from model_utils.model import initialize_model
def seed_everything(seed):
torch.manual_seed(seed)
torch.cuda.manual_seed(seed)
torch.cuda.manual_seed_all(seed)
torch.backends.cudnn.benchmark = False
torch.backends.cudnn.deterministic = True
random.seed(seed)
np.random.seed(seed)
os.environ['PYTHONHASHSEED'] = str(seed)
seed_everything(0)
train_transform = transforms.Compose(
[
transforms.ToPILImage(),
transforms.RandomResizedCrop(224),
transforms.RandomRotation(50),
transforms.ToTensor()
]
)
val_transform = transforms.Compose(
[
transforms.ToPILImage(),
transforms.ToTensor()
]
)
HW = 224
#———————-数据集类定义———————-
class food_Dataset(Dataset):
def __init__(self, path, mode="train"):
self.mode = mode
if mode == "semi": ####半监督学习模式
self.X = self.read_file(path) ####无标签Y,只读X
else:
self.X,self.Y = self.read_file(path)
self.Y = torch.LongTensor(self.Y)
if mode == "train":
self.transform = train_transform
else:
self.transform = val_transform
def read_file(self,path):
if self.mode == "semi": #读半监督学习模式下的数据
file_list = os.listdir(path)
xi = np.zeros((len(file_list), HW, HW, 3), dtype=np.uint8)
for j, img_name in tqdm(enumerate(file_list)):
img_path = os.path.join(path, img_name)
img = Image.open(img_path)
img = img.resize((HW, HW))
xi[j, …] = img #存入numpy数组
print("读到了%d个数据" % len(xi))
return xi
else:
for i in tqdm(range(11)):
file_dir = path + "/%02d" % i
file_list = os.listdir(file_dir)
xi = np.zeros((len(file_list), HW, HW, 3), dtype=np.uint8)
yi = np.zeros(len(file_list), dtype=np.uint8)
for j, img_name in enumerate(file_list):
img_path = os.path.join(file_dir, img_name)
img = Image.open(img_path)
img = img.resize((HW, HW))
xi[j, …] = img
yi[j] = i
if i == 0:
X = xi
Y = yi
else:
X = np.concatenate((X, xi), axis=0)
Y = np.concatenate((Y, yi), axis=0)
print("读到了%d个数据" % len(Y))
return X, Y
def __getitem__(self, item):
if self.mode == "semi": #半监督学习模式
return self.transform(self.X[item]), self.X[item]
# 返回: 1.经过transform准备进模型的图, 2.原始图片(用于后续生成新数据集)
else:
return self.transform(self.X[item]), self.Y[item]
def __len__(self):
return len(self.X)
#—–半监督数据集类—–(逻辑:无标签数据集x->模型预测->概率大于0.99->加入semiDataset)
class semiDataset(Dataset): #最后提供的是原始无标签数据x&预测值(伪标签)y
def __init__(self, no_label_loder, model, device, thres=0.99):
x,y = self.get_label(no_label_loder, model, device, thres)
if x == []:
self.flag = False #为空(没有超过可信度的),标记为无效
else:
self.flag = True
self.X = np.array(x) #列表转numpy数组
self.Y = torch.LongTensor(y)
self.transform = train_transform #不为空,新数据集也进入训练模式,需要数据增强
#利用当前模型给无标签数据打伪标签
def get_label(self, no_label_loder, model, device, thres):
model = model.to(device)
soft = nn.Softmax()
pred_prob = [] #存概率最大值
labels = [] #存最大值所在下标(类别)
x = [] #####存筛选出的原始图片
y = [] #####存筛选出的伪标签
with torch.no_grad():
for bat_x,_ in no_label_loder: #进入模型的x和原始的x
bat_x = bat_x.to(device)
pred = model(bat_x)
pred_soft = soft(pred) #转概率
pred_max,pred_value = pred_soft.max(1) #横向求最大值(概率)以及下标(类别)
pred_prob.extend(pred_max.cpu().numpy().tolist()) #各最大概率值添加入列表
labels.extend(pred_value.cpu().numpy().tolist()) #各对应下标添加入列表
#遍历所有预测结果,筛选高置信度样本
for index,prob in enumerate(pred_prob):
if prob > thres:
x.append(no_label_loder.dataset[index][1]) #获取原始图片
y.append(labels[index])
return x,y
def __getitem__(self, item):
return self.transform(self.X[item]), self.Y[item]
def __len__(self):
return len(self.X)
#——生成半监督DataLoader——(打包成一个可以直接用于训练的数据加载器)
def get_semi_loader(no_label_loder, model, device, thres):
semiset = semiDataset(no_label_loder, model, device, thres)
if semiset.flag == False:
return None
else:
semi_loader = DataLoader(semiset,batch_size=16,shuffle=False)
return semi_loader
#——————-训练与验证主循环——————-
def train_val(model, train_loader, val_loader,no_label_loader,optimizer, loss, epochs, device,thres, save_path):
model = model.to(device)
semi_loader = None #初始为空,验证准确率超过一定程度,尝试获取semi_loader,获取不为空,则训练
plt_train_loss = []
plt_val_loss = []
plt_train_acc = []
plt_val_acc = []
max_acc = 0.0
for epoch in range(epochs):
train_loss = 0.0
train_acc = 0.0
val_loss = 0.0
val_acc = 0.0
semi_loss = 0.0 #半监督学习模式
semi_acc = 0.0
start_time = time.time()
#训练模块部分
model.train()
for batch_x,batch_y in train_loader:
x , target = batch_x.to(device), batch_y.to(device)
pred = model(x)
train_bat_loss = loss(pred, target)
train_bat_loss.backward()
optimizer.step()
optimizer.zero_grad()
train_loss += train_bat_loss.detach().cpu().item()
train_acc += np.sum(np.argmax(pred.detach().cpu().numpy(),axis=1)==target.cpu().numpy())
plt_train_loss.append(train_loss/train_loader.__len__())
plt_train_acc.append(train_acc/train_loader.dataset.__len__())
#—半监督训练阶段(对新生成的数据集进行训练)—
if semi_loader != None:
for batch_x,batch_y in semi_loader:
x , target = batch_x.to(device), batch_y.to(device)
pred = model(x)
semi_bat_loss = loss(pred, target)
semi_bat_loss.backward()
optimizer.step()
optimizer.zero_grad()
semi_loss += semi_bat_loss.detach().cpu().item()
semi_acc += np.sum(np.argmax(pred.detach().cpu().numpy(),axis=1)==target.cpu().numpy())
print("半监督数据集的训练准确率为:",semi_acc/train_loader.dataset.__len__())
#验证模型部分
model.eval()
with torch.no_grad():
for batch_x,batch_y in val_loader:
x , target = batch_x.to(device),batch_y.to(device)
pred = model(x)
val_bat_loss = loss(pred, target)
val_loss += val_bat_loss.detach().cpu().item()
val_acc += np.sum(np.argmax(pred.detach().cpu().numpy(), axis=1) == target.cpu().numpy())
plt_val_loss.append(val_loss/val_loader.dataset.__len__())
plt_val_acc.append(val_acc/val_loader.dataset.__len__())
#触发半监督逻辑:验证集准确率超过0.6,才生成semi_loader
if epoch % 3 == 0 and plt_val_acc[-1] > 0.6:
semi_loader = get_semi_loader(no_label_loader,model,device,thres)
if val_acc > max_acc:
torch.save(model,save_path)
max_acc = val_acc
print("[第%03d轮/共%03d轮] 训练时长:%2.2f sec(s) | 训练train_loss: %.6f 验证val_loss:%.6f | 训练train_acc: %.6f 验证val_acc:%.6f" % \\
(epoch, epochs, time.time()-start_time, plt_train_loss[-1], plt_val_loss[-1], plt_train_acc[-1], plt_val_acc[-1]))
plt.plot(plt_train_loss)
plt.plot(plt_val_loss)
plt.title('loss')
plt.legend(['train', 'val'])
plt.show()
plt.plot(plt_train_acc)
plt.plot(plt_val_acc)
plt.title('acc')
plt.legend(['train', 'val'])
plt.show()
#———超参部分——–
lr = 0.001
epochs = 20
thres = 0.99 #半监督置信度阈值
train_path = r"D:\\pycharm file\\deeplearn Lige\\codee\\fenleishizhan\\food_classification\\food-11\\training\\labeled"
val_path = r"D:\\pycharm file\\deeplearn Lige\\codee\\fenleishizhan\\food_classification\\food-11\\validation"
no_label_path = r"D:\\pycharm file\\deeplearn Lige\\codee\\fenleishizhan\\food_classification\\food-11\\training\\unlabeled\\00" #半监督
train_set = food_Dataset(train_path,"train")
val_set = food_Dataset(val_path,"val")
no_label_set = food_Dataset(no_label_path,"semi") #半监督学习模式(实例化数据集)
train_loader = DataLoader(train_set,batch_size=16,shuffle=True)
val_loader = DataLoader(val_set,batch_size=16,shuffle=True)
no_label_loader = DataLoader(no_label_set,batch_size=16,shuffle=False) #半监督模式(不打乱)
model, _ = initialize_model("resnet18", 11, use_pretrained=True)
loss = nn.CrossEntropyLoss()
device = "cuda" if torch.cuda.is_available() else "cpu"
save_path = "model_save/best_model.pth"
optimizer = torch.optim.AdamW(model.parameters(), lr=lr, weight_decay=1e-4)
#半监督学习模式下新加入:no_label_loader和thres
train_val(model, train_loader, val_loader,no_label_loader,optimizer, loss, epochs, device,thres, save_path)




