基于K-means聚类的快递选址和最短路径规划
- 摘要
- 一、K-means聚类算法
- 二、蚁群算法
-
- 2.1路径构建
- 2.2信息素更新
- 三.仿真
- 总结
摘要
` 针对当前多区域物流中心选址需建立配送中心个数不定、位置、覆盖范围不明的问题,本文提出了一种改进的k-means 聚类算法, 根据每个快递点的地理位置进行聚类划分,分别在这些区域网点中对配送中心进行最终的确定。之后,以一类区域网点为例,采用遗传算法对遍历网点的最短路程进行规划,提供参考。
提示:以下是本篇文章正文内容,下面案例可供参考
一、K-means聚类算法
K-means原理是初始随机给定k个簇中心,在未知样本类别的情况下,通过计算样本间的距离(欧式距离、马式距离、汉明距离、余弦距离等)来估计样本所属类别。把待分类样本点按照最邻近原则划分到不同的簇后,按平均法再一次计算每个簇的质心得到新的簇心,重复迭代,当簇心的移动距离小于某个给定的值时才停止。 从图中可以看出,所给数据集经过迭代后,最终形成了三个较为良好的簇类。 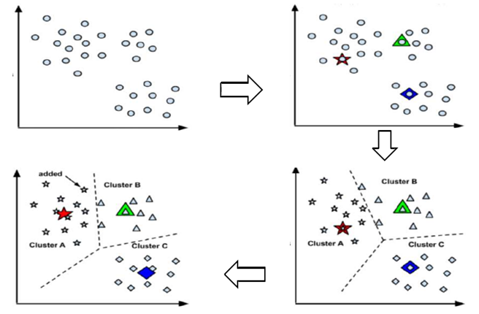
二、蚁群算法
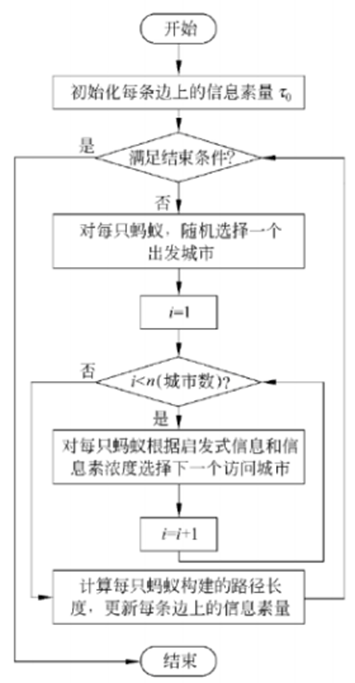
蚁群算法(Ant Colony Optimization, ACO)由Dorigo 等人于1991年在第一届欧洲人工生命会议(European Conference on Artificial Intelligence, ECAL)上提出,是模拟自然界真实蚂蚁觅食过程的一种随机搜索算法。蚁群算法与遗传算法(Genetic Algorithm, GA)、粒子群优化算法(Particle Swarm Optimization,PSO)、免疫算法(Immune Algorithm, IA)等同属于仿生优化算法,具有鲁棒性强、全局搜索、并行分布式计算、易与其他方法结合等优点,在典型组合优化问题如旅行商问题(Traveling Salesman Problem,TSP)、车辆路径问题(Vehicle Routing Problem,VRP),车间作业调度问题(Job-shop Scheduling Problem, JSP)和动态组合规划问题如通信领域的路由问题中均得到了成功的应用。 蚁群算法求解旅行商问题大致可以分为两步:
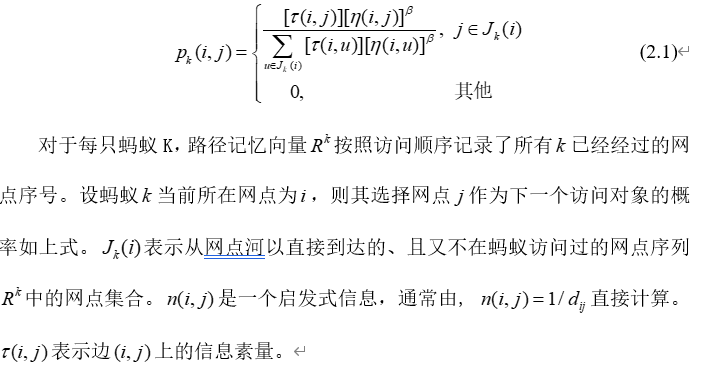
2.1路径构建
(1)在算法初始化时,问题空间中所有的边上的信息素都被初始化为 (2)算法迭代每一轮,问题空间中的所有路径上的信息素都会发生蒸发,我们为所有边上的信息素乘上一个小于1的常数。信息素蒸发是自然界本身固有的特征,在算法中能够帮助避免信息素的无限积累,使得算法可以快速丢弃之前构建过的较差的路径。 (3)蚂蚁根据自己构建的路径长度在它们本轮经过的边上释放信息素。蚂蚁构建的路径越短、释放的信息素就越多。一条边被蚂蚁爬过的次数越多、它所获得的信息素也越多。 (4)迭代(2),直至算法终止.
2.2信息素更新
三.仿真
使用python生成100个范围在[0,1]随机坐标作为网点坐标 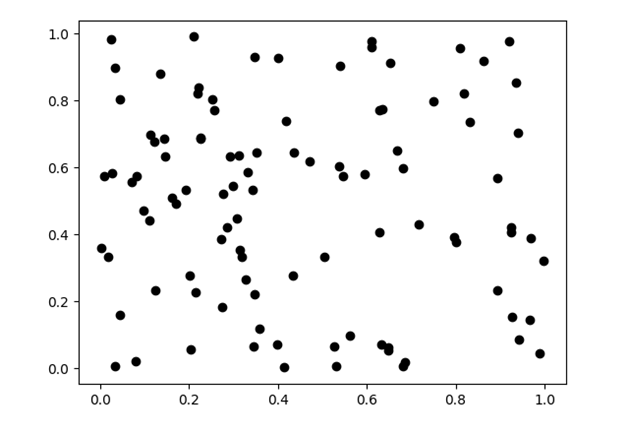 K—means聚类分析:
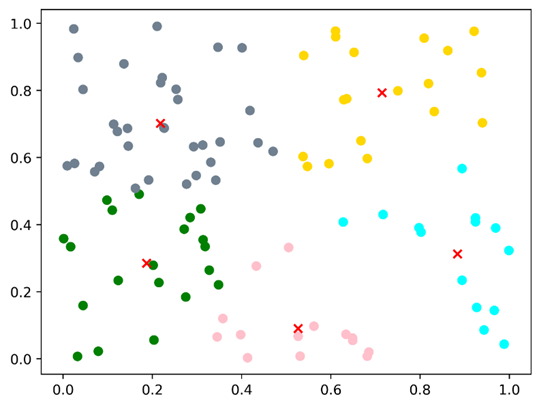 以粉色坐标点为例,采用蚁群算法设计遍历网点的最短路径。
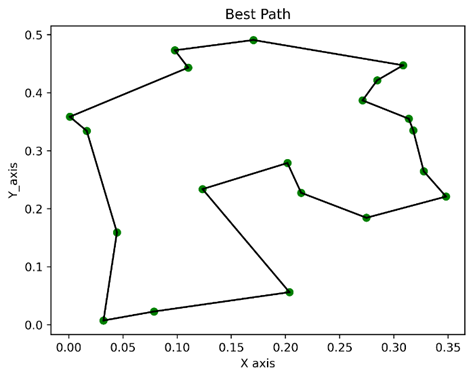 总结为如下内容
总结
配送中心是企业经营的重要组成部分,它是实现企业商品有效运输和配送的重要基础设施。适当的配送中心选址有利于企业提高经营效益和客户满意度,改善市场供需关系,促进企业可持续发展。因此, 本文以配送中心选址为研究对象,生成了100个随机网点,研究配送中心选址策略,完成了以下几项主要工作: 第一,设计了基于K-means的聚类分析方法,将100个随机网点分为五类并生成了5个配送中心。 第二,以其中一类网点为例,基于蚁群算法设计了配送的最短路径。
具体代码可以参考我的资源,觉得有用的小伙伴点赞关注。