伙伴匹配系统
此系统是基于上一个用户中心系统而创作的
一、功能点:
1.根据标签查询用户:
在设计的时候考虑了两种实现方法
第一种:设置一个用户标签关联表,将其作为中间表来将用户和标签进行关联(优点是思维简单,但是它查询多影响我们系统的效率)
第二种:在用户的属性中增加一个String的属性tags,这个属性存放了这个用户的很多个标签
像这样[“java”,“c++”,“python”]
我们选择第二种实现方法。
第二种的实现也具有两个方案!!!
第一种为sql查询(实现简单)
在进行我们sql查询的时候先判断参数是否为空,然后在将标签取出来进行设置查询条件,再进行查询。最后将查询到的结果进行脱敏然后再返回用户列表
public List<User> searchUserByTags(List<String> tagsNameList) {
if (CollectionUtils.isEmpty(tagsNameList)){
throw new BusinessException(ErrorCode.PARAMS_ERROR,"标签列表为空"); }
QueryWrapper<User> queryWrapper = new QueryWrapper<>();
for (String tagName : tagsNameList){
queryWrapper.like("tags","%"+tagName+"%");
}
List<User> userList = userMapper.selectList(queryWrapper);
return userList.stream().map(this::getSafetyUser).collect(Collectors.toList());
}
第二种为内存查询(灵活)
这里引用了Gson的配置进行反序列化的操作,要在pom文件中配置一下。
这里的filter方法是若返回值为true则保留否则清除。
public List<User> searchUserByTags(List<String> tagsNameList) {
// 1.先查询所有用户
QueryWrapper<User> queryWrapper = new QueryWrapper<>();
List<User> userList = userMapper.selectList(queryWrapper);
Gson gson = new Gson();
//2.在内存中判断是否包含要求的标签(内存查询)
return userList.stream().filter(user -> {
String tagStr = user.getTags();
if (StringUtils.isEmpty(tagStr)){
return false;
}
Set<String> temTagNameList = gson.fromJson(tagStr,new TypeToken<Set<String>>(){}.getType());
temTagNameSet = Optional.ofNullable(temTagNameSet).orElse(new HashSet<>());
for (String tagName : tagsNameList) {
if (!temTagNameList.contains(tagName)){
return false;
}
}
return true;
}).map(this::getSafetyUser).collect(Collectors.toList());
}
}
(1)代码解释:
Set temTagNameList = gson.fromJson(tagStr,new TypeToken<Set>(){}.getType());
为什么用set?
这行代码的核心是调用 Gson对象的 fromJson方法,它需要两个关键信息来完成转换:
数据来源:tagStr,即待解析的 JSON 字符串。它应该是一个字符串数组的格式,例如 ["标签1", "标签2", "标签3"]。
目标类型:new TypeToken<Set<String>>(){}.getType(),这部分代码的作用是明确告诉 Gson,你希望将 JSON 字符串转换成一个 Set<String>对象,而不仅仅是原始的 Set。
(2)代码解释: temTagNameSet = Optional.ofNullable(temTagNameSet).orElse(new HashSet<>());
这里用到了Optional的方法来判断是否为空,若为空则取orElse中的数据,这样的好处是减少if的使用。
理解 TypeToken 的作用
你可能会问,为什么不直接写成 Set.class呢?这主要是为了应对 Java 泛型的类型擦除 机制。
简单来说,Java 在编译后,泛型信息(如 <String>)会被擦除,程序在运行时只知道这是个 Set,但不知道它原本包含的是 String还是其他类型。Gson 如果只拿到 Set.class,就无法正确地将 JSON 数组中的元素转换为 String,可能导致类型转换异常 。
TypeToken的巧妙之处在于,它通过创建一个匿名内部类(new TypeToken<Set<String>>(){}),并将具体的泛型类型 Set<String>作为其泛型参数。这样,在运行时就可以通过反射从类的定义信息中获取到完整的泛型类型,从而精确地指导 Gson 进行反序列化 。
完整工作流程
你可以这样理解这行代码的执行过程:
准备:Gson 根据 TypeToken提供的信息,确认目标类型是 Set<String>。
解析:Gson 读取 tagStrJSON 字符串。
转换:将 JSON 数组中的每个元素转换为 String类型。
构建:将这些 String对象添加到一个新的 Set<String>集合中。
返回:最终,将这个构建好的 Set<String>集合赋值给等号左边的 temTagNameList变量。
如何去选择使用这两种方法呢?
1.如果参数可以分析的话,根据用户的参数去选择查询方式,比如标签数
2.如果参数不可分析,并且数据库连接足够,内存空间足够,可以并发同时查询,谁先返回用谁。
3.可以先SQL查询与内存计算相结合,比如先用SQL过滤掉部分tag
2.后端整合Swagger和Knife4j接口文档
Knife4j:
1.直接引入Knife4j
<!—knif4j—>
<dependency>
<groupId>com.github.xiaoymin</groupId>
<artifactId>knife4j–openapi3–jakarta–spring–boot–starter</artifactId>
<version>4.4.0</version>
</dependency>
2.配置knife4j的yml属性
packages-to-scan:这个属性设置为我们启动类所在的包。
# springdoc–openapi项目配置
springdoc:
swagger–ui:
path: /swagger–ui.html
tags–sorter: alpha
operations–sorter: alpha
api–docs:
path: /v3/api–docs
enabled: true
group–configs:
– group: 'default'
paths–to–match: '/**'
packages–to–scan: com.example.partnermatch
# knife4j的增强配置,不需要增强可以不配
knife4j:
enable: true
setting:
language: zh_cn
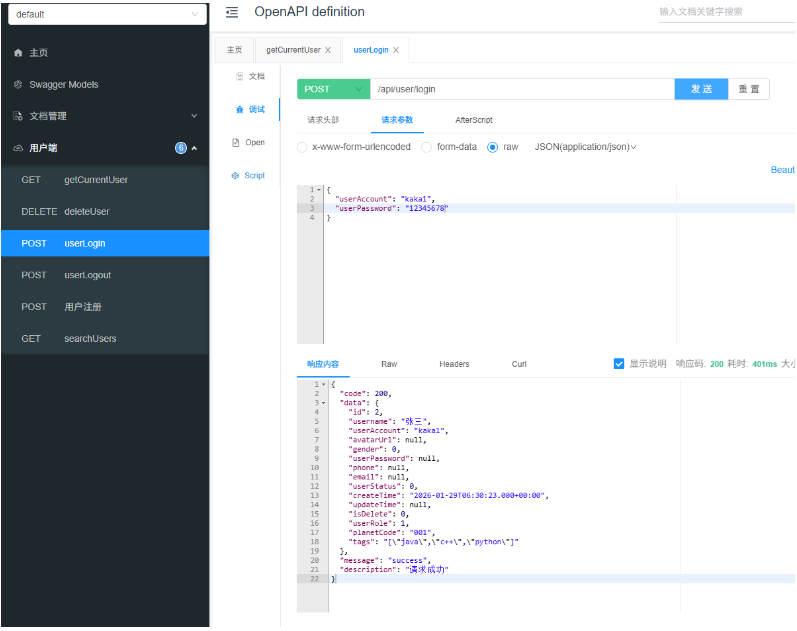
效果如图所示:
3.用户登录功能
(1)Session共享后端分布式登录
进行本机分布式登录测试:
1.先用maven的package的命令将项目打包成一个jar包
2.再去terminal终端输入命令 java -jar jar包名称 –server.port=端口号
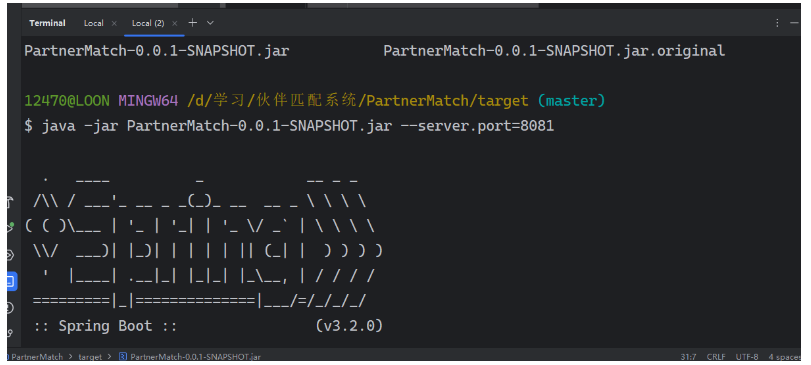
这样就可以在本地启动两个服务进行测试了。
用户的身份如何确认?
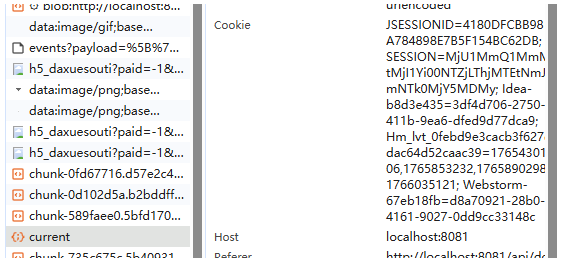
在点击登陆时,前端会给后端传一个Cookie,这个Cookie中带有一个属性叫做JSESSIONID如下图所示:
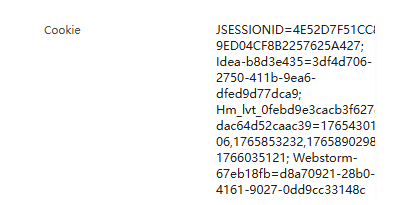
在之后的请求中就会根据这个JSESSIONID来确认用户身份。

但是如果只是这样的话,在测试的时候就会发现问题所在,当一个用户登陆后,在另一个后端进行获取用户信息的时候信息获取不到,这是因为这两个服务器的后端没有共享用户数据,我们可以设置一个Redis的缓存来进行存储我们的用户信息。
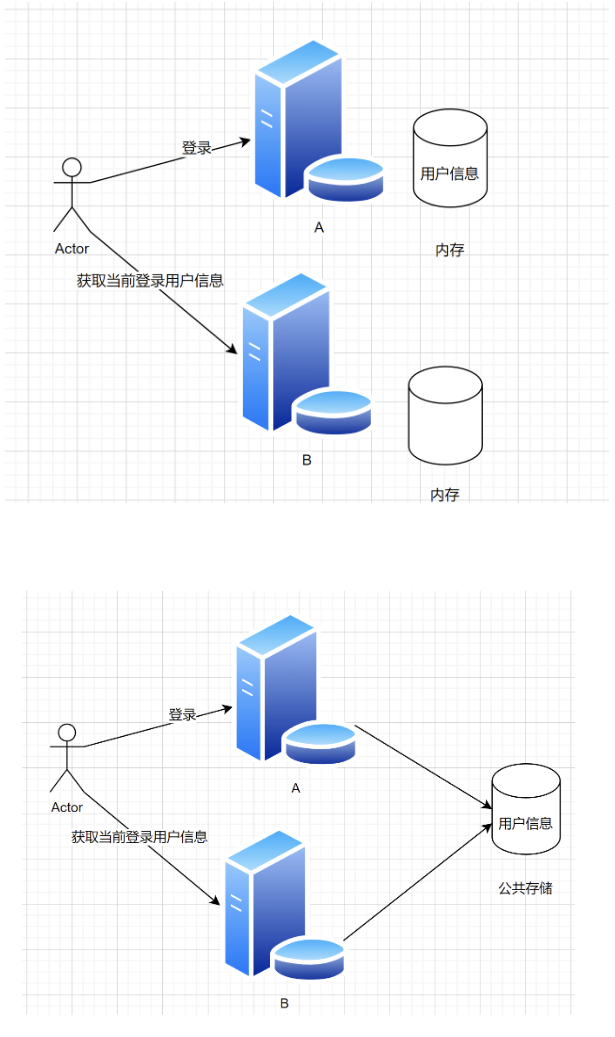
Redis实现
1.添加redis配置和spring-session和redis的整合的配置,这个整合的配置可以自动将session存储到redis中。
<!— Redis —>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring–boot–starter–data–redis</artifactId>
<version>2.6.4</version>
</dependency>
<!— Spring–session与redis的整合 —>
<dependency>
<groupId>org.springframework.session</groupId>
<artifactId>spring–session–data–redis</artifactId>
<version>2.6.3</version>
</dependency>
2.修改spring-session存储配置spring.session.redis
默认是none,表示存储在单台服务器
SpringBoot3版本的配置如下所示:
spring:
datasource:
driver–class–name: com.mysql.cj.jdbc.Driver
url: jdbc:mysql://localhost:3306/partnermatch?useUnicode=true&characterEncoding=utf8&serverTimezone=Asia/Shanghai
username: root
password: root
session:
timeout: 86400
redis:
flush–mode: on_save
namespace: spring:session
data:
redis:
host: localhost
port: 6379
auth: root
database: 10
设置后我们再测试一下
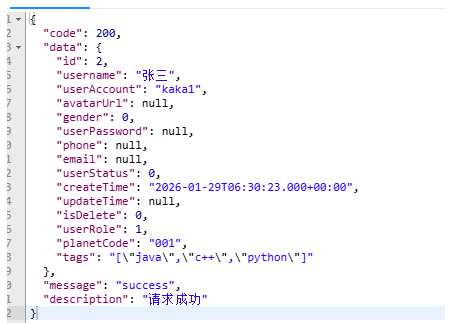
8080端口请求成功:
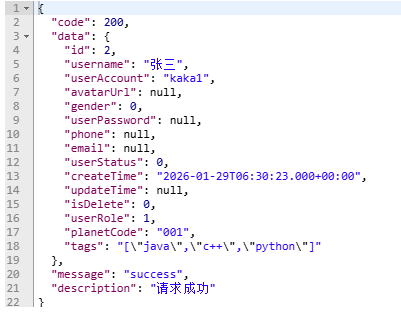
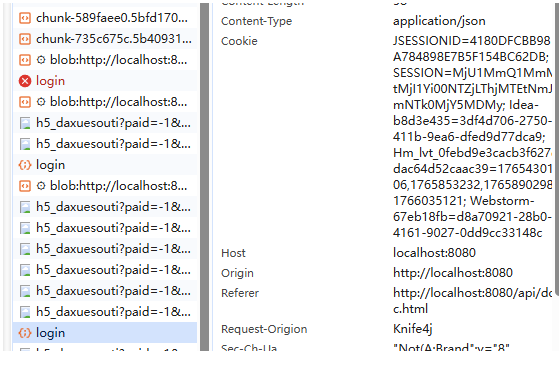
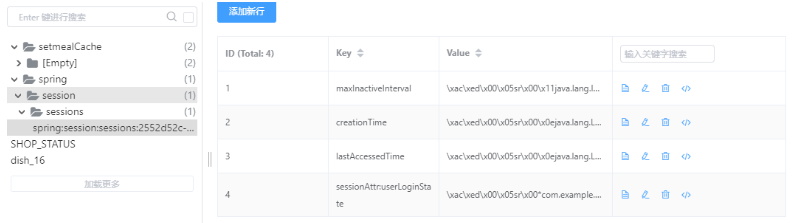
Redis中有它的session缓存了:
8081端口也请求成功:
3.批量导入数据
1.用可视化界面:适合一次性全部导入,数据量可控
2.写程序:利用for循环,注意分批,而不是一次性全部导入(可以用接口来控制)要保证可控、幂等,要注意线上环境和测试环境是有区别的
3.执行sql语句,适用于小数据量
编写一次性任务:
for循环插入数据的问题:
1.建立和释放数据库连接
2.for循环是绝对线性的
可是使用批量插入提高效率:
@SpringBootTest
public class insertUsersTest {
@Resource
private UserMapper userMapper;
@Resource
private UserService userService;
@Test
public void doInsertUsers() {
StopWatch stopWatch = new StopWatch();
stopWatch.start();
final int INSERT_NUM = 1000;
List<User> userList = new ArrayList<>();
for (int i = 0; i < INSERT_NUM; i++) {
User user = new User();
user.setUsername("假用户");
user.setUserAccount("fakeuser");
user.setAvatarUrl("");
user.setGender(0);
user.setUserPassword("12345678");
user.setPhone("1234567890");
user.setEmail("123165166");
user.setUserStatus(0);
user.setUserRole(0);
user.setPlanetCode("65555");
// userMapper.insert(user);
}
userService.saveBatch(userList,100);
stopWatch.stop();
System.out.println(stopWatch.getTotalTimeMillis());
}
}
利用并发操作进行插入:
@SpringBootTest
public class insertUsersTest {
@Resource
private UserMapper userMapper;
@Resource
private UserService userService;
//CPU密集型,分配的核心线程数 = cpu -1
//IO密集型,分配核心线程数可以打于CPU核数
private ExecutorService executorService = new ThreadPoolExecutor(60,100,10000, TimeUnit.MINUTES,new ArrayBlockingQueue<>(10000));//创建一个我们的自己的线程池
@Test
public void doInsertUsers() {
StopWatch stopWatch = new StopWatch();
stopWatch.start();
List<CompletableFuture<Void>> futureList = new ArrayList<>();//创建一个List集合来存放任务。
int j=0;
for (int i = 0; i < 40; i++){
List<User> userList = Collections.synchronizedList(new ArrayList<>());//在进行多线程操作的时候用到的要是线程安全的集合。
while(true){
j++;
User user = new User();
user.setUsername("假用户");
user.setUserAccount("fakeuser");
user.setAvatarUrl("");
user.setGender(0);
user.setUserPassword("12345678");
user.setPhone("1234567890");
user.setEmail("123165166");
user.setUserStatus(0);
user.setUserRole(0);
user.setPlanetCode("65555");
userList.add(user);
if (j % 10000 == 0){
break;
}
}
CompletableFuture<Void> completableFuture = CompletableFuture.runAsync(() ->{
System.out.println("threadname"+Thread.currentThread().getName());
userService.saveBatch(userList,10000);
},executorService);
futureList.add(completableFuture);
}
CompletableFuture.allOf(futureList.toArray(new CompletableFuture[]{})).join();
stopWatch.stop();
System.out.println(stopWatch.getTotalTimeMillis());
}
}
代码解释:
自定义线程池:
private ExecutorService executorService = new ThreadPoolExecutor(60,100,10000, TimeUnit.MINUTES,new ArrayBlockingQueue<>(10000));
| 核心线程数 (corePoolSize) | 40 | 线程池中长期保持存活的线程数量,即使它们处于空闲状态。 |
| 最大线程数 (maximumPoolSize) | 1000 | 线程池允许创建的线程总数上限(包含核心线程)。 |
| 空闲线程存活时间 (keepAliveTime) | 10000 | 当线程数超过核心线程数时,多余的空闲线程等待新任务的最长时间。 |
| 时间单位 (Unit) | TimeUnit.MINUTES | 上述存活时间的单位,这里是分钟。 |
| 任务队列 (workQueue) | new ArrayBlockingQueue<>(10000) | 用于存放等待执行任务的有界阻塞队列,容量为10000。 |
// 异步执行
CompletableFuture<Void> future = CompletableFuture.runAsync(() -> {
System.out.println("threadName: " + Thread.currentThread().getName());
userService.saveBatch(userList, batchSize);
}, executorService);
futureList.add(future);
CompletableFuture.allOf(futureList.toArray(new CompletableFuture[]{})).join();
创建异步任务:
CompletableFuture.runAsync(() -> { … }, executorService)是核心方法。它接受两个参数:
第一个参数(Runnable 任务): 这是一个Lambda表达式,定义了需要在后台线程中执行的具体逻辑。在这个例子里,它做了两件事:
System.out.println("threadname"+Thread.currentThread().getName());: 打印出当前执行该任务的线程名称,便于调试和监控。
userService.saveBatch(userList,10000);: 调用MyBatis-Plus提供的批量保存方法,将 userList中的用户数据插入数据库,10000表示每批处理的数据量。
第二个参数(线程池): executorService是你自定义的线程池。它负责管理和调度执行任务的线程。使用自定义线程池而非默认的 ForkJoinPool.commonPool()是推荐做法,可以避免资源竞争,尤其适合IO密集型任务(如数据库操作),并能更好地控制并发行为。
管理任务状态
CompletableFuture<Void> completableFuture = …: runAsync方法会立即返回一个 CompletableFuture<Void>对象。这个对象就像是这个异步任务的**“提货单”**,你可以通过它来查询任务是否完成、等待任务完成,或者链式添加任务完成后的回调操作。因为 runAsync本身不返回业务结果,所以其泛型是 Void。
futureList.add(completableFuture): 将这张“提货单”添加到一个 futureList集合中。这样做的目的是为了后续使用 CompletableFuture.allOf(futureList.toArray(new CompletableFuture[] {})).join()来等待所有添加到列表中的异步任务都执行完毕,然后再进行下一步操作(比如停止计时器)。
CompletableFuture.allOf(futureList.toArray(new CompletableFuture[]{})).join();:
格式转换:futureList.toArray(new CompletableFuture[]{})这部分的目的是进行简单的类型转换。因为你之前将所有的 CompletableFuture对象都添加到了一个 List<CompletableFuture<Void>> futureList中,而 allOf方法需要的是数组参数 (CompletableFuture<?>… cfs),所以这里通过 toArray方法将列表转换为数组 。
组合监控:CompletableFuture.allOf(…)是核心。它不会开始新的任务,而是创建一个“总开关”式的 CompletableFuture<Void>对象。这个“总开关”的状态取决于传入的所有任务:只有当所有任务都完成(无论是正常结束还是异常结束)时,它自身才会标记为完成 。需要注意的是,它本身不包含各个任务的具体结果 。
阻塞等待:.join()方法会阻塞当前线程(在你的代码中,就是执行测试的主线程),直到上一步创建的“总开关”Future 完成。一旦所有任务完成,join()方法就会返回,程序继续执行下一行代码(即停止计时并打印耗时)。这与 get()方法功能类似,但 join()不会抛出受检异常,写法更简洁 。
4.缓存和分布式缓存
缓存的实现:
Redis(分布式缓存)
memcached(分布式)
Etcd(云原生架构的一个分布式存储)
进程的缓存:
ehcache(单机)
本地缓存(JAVA内存Map)
Caffeine(JAVA内存缓存,高性能)
Google Guava
Redis:
NoSOL数据库
实际上更像是一个key-value存储系统(它存储的是键值对)
JAVA里的实现方式:
Spring Data Redis:
Spring Data: 通用的数据访问框架,定义了一组增删改查的接口
mysql、redis、jpa
1)引入redis:
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring–boot–starter–data–redis</artifactId>
</dependency>
data:
redis:
host: localhost
port: 6379
auth: root
database: 10
3)配置序列化
因为redis存储数据的实际上是先将数据进行序列化然后再进行的存储,其使用的是原生的jdk序列化器,可能会出现存储不正确(乱码)的现象,那么就需要我们去配置一个redis配置类,值也想序列化的话需要对应的类实现Serializable.
@Configuration
public class RedisTemplateConfig {
@Bean
public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory connectionFactory) {
RedisTemplate<String, Object> redisTemplate = new RedisTemplate<>();
redisTemplate.setConnectionFactory(connectionFactory);
redisTemplate.setKeySerializer(RedisSerializer.string());
return redisTemplate;
}
}
设计缓存key:
@GetMapping("/recommend")
public BaseResult<Page<User>> recommendUsers(int pageSize, int pageNum, String username, HttpServletRequest request) {
User user = userservice.getLoginUser(request);
//如果有缓存,直接读取缓存
String redisKey = String.format("partner:user:recommend:%s",user.getId());
Page<User> userPage = (Page<User>) redisTemplate.opsForValue().get(redisKey);
if (userPage != null) {
return Result.success(userPage);
}
QueryWrapper<User> queryWrapper = new QueryWrapper<>();
Page<User> userList = userservice.page(new Page<>(pageNum, pageSize), queryWrapper);
try {
redisTemplate.opsForValue().set(redisKey,userList,10000);
} catch (Exception e) {
log.error("redis存储查询数据出错",e);
}
return Result.success(userList);
}
redis要设置过期时间,因为其内存不是无限增加的
缓存预热:
解决问题:
第一个用户访问还是很慢(第一个人的加入),也能一定程度上保护数据库。
缺点:
1.增加开发成本(需要额外的开发)
2.预热的时机或时间如果错了,可能缓存的数据不对
3.需要占用空间
定时任务实现:
1.Spring Scheduler(spring boot 默认整合了)
2.Quartz(独立于Spring存在的定时任务框架)
3.XXL-job之类的分布式任务调度平台(界面+sdk)
第一种方式:
1.主类开启@EnableScheduling
2.给要定时执行的方法添加@Scheduled注解
@Component
public class PreCacheJob {
@Resource
private UserService userservice;
@Qualifier("redisTemplate")
@Autowired
private RedisTemplate redisTemplate;
private List<Long> mainUserList = Arrays.asList(1L);
//每天执行,缓存预热推荐用户
@Scheduled(cron = "0 0/1 * * * ? ")
public void doCacheRecommendUser(){
for (Long userId : mainUserList) {
QueryWrapper<User> queryWrapper = new QueryWrapper<>();
Page<User> userList = userservice.page(new Page<>(1, 20), queryWrapper);
String redisKey = String.format("partner:user:recommend:%s",userId);
try {
redisTemplate.opsForValue().set(redisKey,userList,10000);
} catch (Exception e) {
log.error("redis存储查询数据出错",e);
}
}
}
}
对比:
1.无过多定制化要求,可以使用Spring Data Redis, 最方便
2.如果用的不是Spring,并且追求简单,无过高的性能要求,可以用Jedis+Jedis Pool
3.如果用的不是Spring,并且追求高性能、高定制化,可以用Lettuce,支持异步、连接池
4.如果项目是分布式的,需要一些分布式的特性,建议用redisson
为什么需要控制定时任务的执行?
1.浪费资源
2.脏数据,比如重复插入
如何控制定时任务再同一时间内只有一个服务器能运行
1.分离定时任务程序和主程序,只在1个服务器运行定时任务。成本太大
2.写死配置,每个服务器都执行定时任务,但是只有ip符合配置的服务器才真实执行业务逻辑,剩下的直接返回,成本最低;但是我们的ip可能是不固定的,把ip写太死了
3.动态配置,配置可以很轻松,很方便更新(代码无需重启),但是只有ip符合配置的服务器才真实执行业务逻辑。
数据库
redis
配置中心(Nacos\\Apolio\\Spring Cloud config)
4.分布式锁,只有抢到锁的服务器才能执行业务逻辑。好处:不用手动配置,多少个服务器都一样。坏处:增加成本。
锁
在资源有限的情况下,控制同一时间(段)只有某些线程(用户/服务器)能访问到资源
java实现锁:synchronized 关键字、并法包的类
问题:只对单个JVM有效
分布式锁
抢锁机制:
如何保证同一时间只有一个服务器能抢到锁?
核心思想:先来的人先把数据改成自己的标识(服务器ip),后来的人发现标识已经存在,就抢锁失败,继续等待。
先来的人执行方法结束,把标识清空,其他人继续抢锁。
MySQL数据库:select for update行级锁(最简单),或者乐观锁
redis实现:内存数据库,读写速度快。支持setnx、lua脚本,方便我们实现分布式锁
setnx:set if not exists如果不存在,才会设置;只有设置成功才会返回true,否则返回false。
注意事项:
1)用完锁要释放
2)锁要加过期时间
3)如果方法执行时间过长,锁提前过期
会导致问题:
1.连锁效应:会释放掉别人的锁
2.这样还是会存在多个方法同时执行的情况。
解决方法:续期
boolean end = false;
new Thread(() -> {
if (!end)}{
续期
})
end = true;
4)释放锁的时候,有可能先判断出是自己的锁,但是这时锁过期了,最后释放了别人的锁
解决方案:Redis+lua脚本保证操作原子性
boolean end = false;
new Thread(() -> {
if (!end)}{
续期
})
end = true;
5)Redis如果是集群用红锁
Redisson实现分布式锁
两种引入方式:
1.spring boot starter引入
2.直接引入:https://redisson.pro/docs/getting-started/
先创建配置类:
@Configuration
@ConfigurationProperties(prefix = "spring.data.redis")
@Data
public class RedissonConfig {
private String host;
private String port;
private String auth;
@Bean
public RedissonClient redissonClient() {
Config config = new Config();
System.out.println(host+":"+port);
//1.创建配置
String redisAddress = String.format("redis://%s:%s", host, port);
config.useSingleServer().setAddress(redisAddress).setDatabase(3);
//创建实例
// Sync and Async API
RedissonClient redisson = Redisson.create(config);
return redisson;
}
}
注意:
1.waitTime设置为0,只能抢一次,抢不到就放弃
2.注意释放锁要写在finally中(因为写在try的话要是过程中报错了,锁就释放不掉了)
Redisson 看门狗机制:
这个是开启一个监听线程进行续期
原理:
1.监听当前线程,如果方法还没执行完,重置redis锁的过期时间
2.如果线程挂掉(注意debug模式也会被当作服务器宕机),则不会续期。
@Scheduled(cron = "0 0/1 * * * ? ")
public void doCacheRecommendUser() {
RLock lock = redissonClient.getLock("lsw:precachejob:docache:lock");
//只有一个线程能获取到锁
try {
if (lock.tryLock(0,–1, TimeUnit.MILLISECONDS)) {
System.out.println("getlock" + Thread.currentThread().getId());
for (Long userId : mainUserList) {
QueryWrapper<User> queryWrapper = new QueryWrapper<>();
Page<User> userList = userservice.page(new Page<>(1, 20), queryWrapper);
String redisKey = String.format("partner:user:recommend:%s", userId);
try {
redisTemplate.opsForValue().set(redisKey, userList, 10000);
} catch (Exception e) {
log.error("redis存储查询数据出错", e);
}
}
}
} catch (InterruptedException e) {
throw new RuntimeException(e);
}finally {
//只能释放自己的锁
if (lock.isHeldByCurrentThread()) {
System.out.println("unlock"+ Thread.currentThread().getId());
lock.unlock();
}
}
}
5.匹配算法
使用编辑距离算法:
public int minDistance(String word1, String word2){
int n = word1.length();
int m = word2.length();
if(n * m == 0)
return n + m;
int[][] d = new int[n + 1][m + 1];
for (int i = 0; i < n + 1; i++){
d[i][0] = i;
}
for (int j = 0; j < m + 1; j++){
d[0][j] = j;
}
for (int i = 1; i < n + 1; i++){
for (int j = 1; j < m + 1; j++){
int left = d[i – 1][j] + 1;
int down = d[i][j – 1] + 1;
int left_down = d[i – 1][j – 1];
if (word1.charAt(i – 1) != word2.charAt(j – 1))
left_down += 1;
d[i][j] = Math.min(left, Math.min(down, left_down));
}
}
return d[n][m];
}
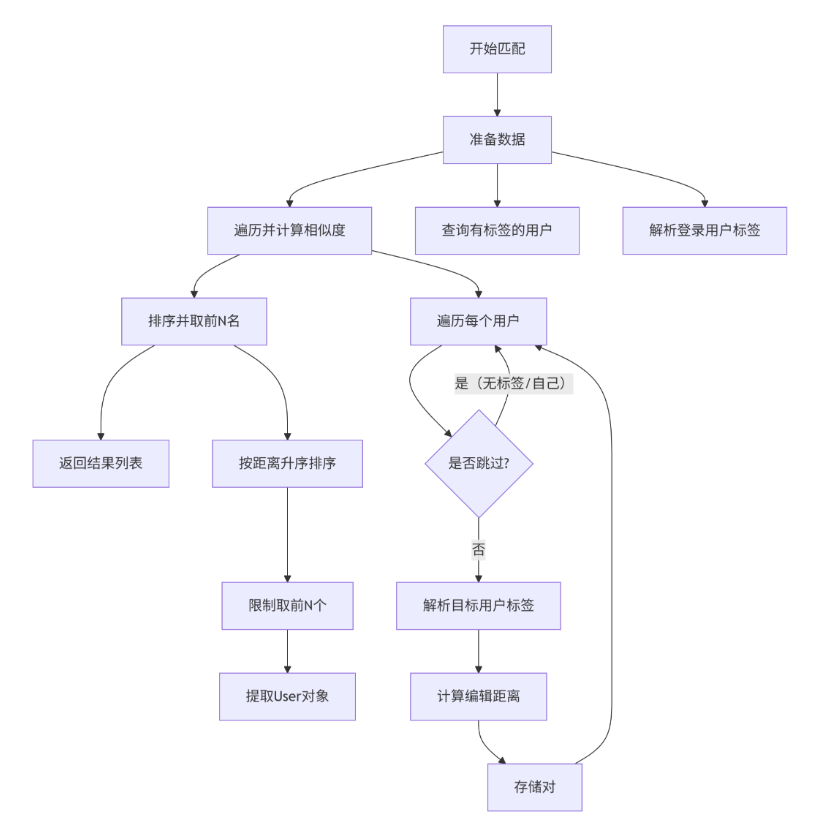
匹配算法的思路是,将登录用户标签,和所有用户标签进行匹配,取匹配度最高的用户
代码解释:
1.用户输入要匹配的人数
2.根据关键信息来获取所有用户
3.获取当前用户的标签,并将其转成String类型的数组。
4.遍历获得的用户数组,计算其相似度然后放到集合中
5.最后来取值进行比较
@Override
public List<User> matchUsers(long num, User loginUser) {
QueryWrapper<User> queryWrapper = new QueryWrapper<>();
queryWrapper.select("id","tags");//避免不必要的数据传输
queryWrapper.isNotNull("tags");
List<User> userList = this.list();
String tags = loginUser.getTags();
Gson gson = new Gson();
List<String> tagList = gson.fromJson(tags,new TypeToken<List<String>>(){}.getType());
//用户列表的下表=>相似度
List<Pair<User,Long>> list = new ArrayList<>();
for (int i = 0; i < userList.size(); i++) {
User user = userList.get(i);
String userTags = user.getTags();
if (StringUtils.isEmpty(userTags) || user.getId() == loginUser.getId()){
continue;
}
List<String> userTagList = gson.fromJson(userTags,new TypeToken<List<String>>(){}.getType());
//计算分数
long distance = AlgorithmUtils.minDistance(tagList,userTagList);
list.add(new Pair<>(user,distance));
}
//按编辑距离由小到大排序
List<Pair<User,Long>> topUserPairList = list.stream().sorted((a,b) -> (int)(a.getB() – b.getB())).limit(num).collect(Collectors.toList());
//这里的比较是设置了比较规则,结果为负的话,距离是小的,说明更加相似,排在前面
List<Long> userIdList = topUserPairList.stream().map(pair -> pair.getA().getId()).collect(Collectors.toList());
QueryWrapper<User> userQueryWrapper = new QueryWrapper<>();
userQueryWrapper.in("id",userIdList);
Map<Long,List<User>> userIdUserListMap = this.list(userQueryWrapper).stream().map(user -> this.getSafetyUser(user)).collect(Collectors.groupingBy(User::getId));
List<User> finalUserList = new ArrayList<>();
for (Long userId : userIdList) {
finalUserList.add(userIdUserListMap.get(userId).get(0));
}
return finalUserList;
}
最后:
Map<Long,List<User>> userIdUserListMap = this.list(userQueryWrapper).stream().map(user -> this.getSafetyUser(user)).collect(Collectors.groupingBy(User::getId));
List<User> finalUserList = new ArrayList<>();
for (Long userId : userIdList) {
finalUserList.add(userIdUserListMap.get(userId).get(0));
}
这里是解决userQueryWrapper.in(“id”,userIdList);有可能会打乱我们原本的id用户顺序,因为我们原本的id是按相似度排好的,所以我们现在可以用一个map来对其进行分组,获取的是id:对象的格式,然后再遍历我们最初的id集合,根据id来从map的对应关系中取出对象,这样就可以返回与原来顺序一样的集合了。